
大语言模型:下一代 DSL 编写者
向前沿大语言模型索要 Python 代码,你就会得到 Python 代码。向它索要团队自定义的标记语言,你得到的只会是“貌似”标记的东西:凭空发明的关键字、猜出来的参数名以及规范中从未出现过的语法结构——而模型输出这些内容时还一副笃定无误的样子。人们下意识的补救办法是使用更多的提示词、更长的上下文和更好的检索手段。真正的治本之策是在大模型接触到你的语言之前就敲定设计方案:从一开始就不要使用外部语法。这个方案有个名字:类型化领域锚定(Typed Domain Grounding,TDG)。它可以用你现有的类型系统马上落地实现。
流利度即频率
大模型能熟练编写 Kotlin、TypeScript、Python 和 SQL 代码,最主要的原因是:这些语言在训练数据中出现了数百万次。粗略来看,语法能力本质上是训练数据出现频次的函数——代码大模型基准测试直接记录了这种关系:按频率和流行度对语言分类,结果显示低资源语言对应的模型表现性能会随之下降[8]。语料密集之处,生成结果更为可靠;语料稀疏之处,生成结果会退化为东拼西凑的模仿,但输出语气不变,看起来依旧信心十足。正因为没有明显的失败信号,这种失败才如此容易被忽略。
从大模型的视角来看,每一门全新设计的外部领域特定语言,其精确语法在训练语料中的出现频次都等于零。尽管如此,大模型通常仍能从它见过的、语法相近的文法、API 和标记符号中继承可迁移的先验知识。但这种迁移并不能解决问题;恰恰相反,它正是下文所说的插值失效背后的根源。
当模型遇到陌生的标记语法时,并不会直接抛出明显的错误,而是会做插值推断。它会悄悄挪用 Mermaid 或 PlantUML 里的箭头语法;调用你的 API “理应存在”但实际并不存在的 addRelation 或 withLabel;或是给只接受两个入参的结构传入三个参数——只因为某个语法相近的同类语法是三参数的。每一处错误都是大模型基于语料算出的最高概率补全,但被用在了语料库里从未出现过的语言上。输出的文本行文流畅、缩进工整,但却是错的。
传统领域特定语言的一个优点反而让这个问题变得更糟:宽松容错。绘图工具与配置解析器在设计上本就具备容错性——遇到无法识别的代码行就直接跳过,按最优猜测进行渲染,对拼写错误不会抛出报错。对人类使用者而言,这是友好的特性;但对于 AI 来说,这就是一个陷阱门。
大模型生成了一张包含十个类的图,其中有一个凭空发明的关系关键字。解析器跳过了那一行。最终进入设计文档的是一张看起来专业、实则缺少一条关联关系的图。
人类如果输入错误,会察觉到问题,因为人类本意就是要建立这个关联关系。但大模型不存在任何意图;下游工程师被九个正确的类和整洁的排版所麻痹,根本不会怀疑这张图是不完整的。
锚定语言,而不仅仅是事实
在日常的大模型工程中,“锚定”几乎已经成了 RAG 的同义词。检索相关文档,放入上下文,大模型的输出就能锚定在真实来源上。这是数据空间层面的锚定,用来约束模型对客观世界的描述。但这对我们的问题毫无帮助:即便大模型上下文中的事实完美无误,它仍然可能生成语法凭空捏造的 DSL 语句。
在没有检索的情况下被要求绘制支付系统图,大模型可能让支付服务直接写入账本,而实际上两者之间存在消息队列——语法无可挑剔,内容却是错的。检索可以修复这个问题。但当文档已经放进上下文后,大模型虽然能够正确描述队列这一组件,却会用一种一知半解的标记语法来表达。在这种情况下,内容是对的,标记语法却是错的。再多的检索也无济于事,因为问题根源在于模型对目标语言的掌握能力上,而不在于它的知识。
类型化领域锚定的是另一个维度。它不是把答案的内容锚定在检索到的数据中,而是把标记符号锚定在模型本就懂得如何生成的结构之中——也就是锚定能力空间。两者是正交的,可以很好地组合在一起:通过 RAG 检索事实,再通过类型化、编译器检查的 DSL 来表达它们。
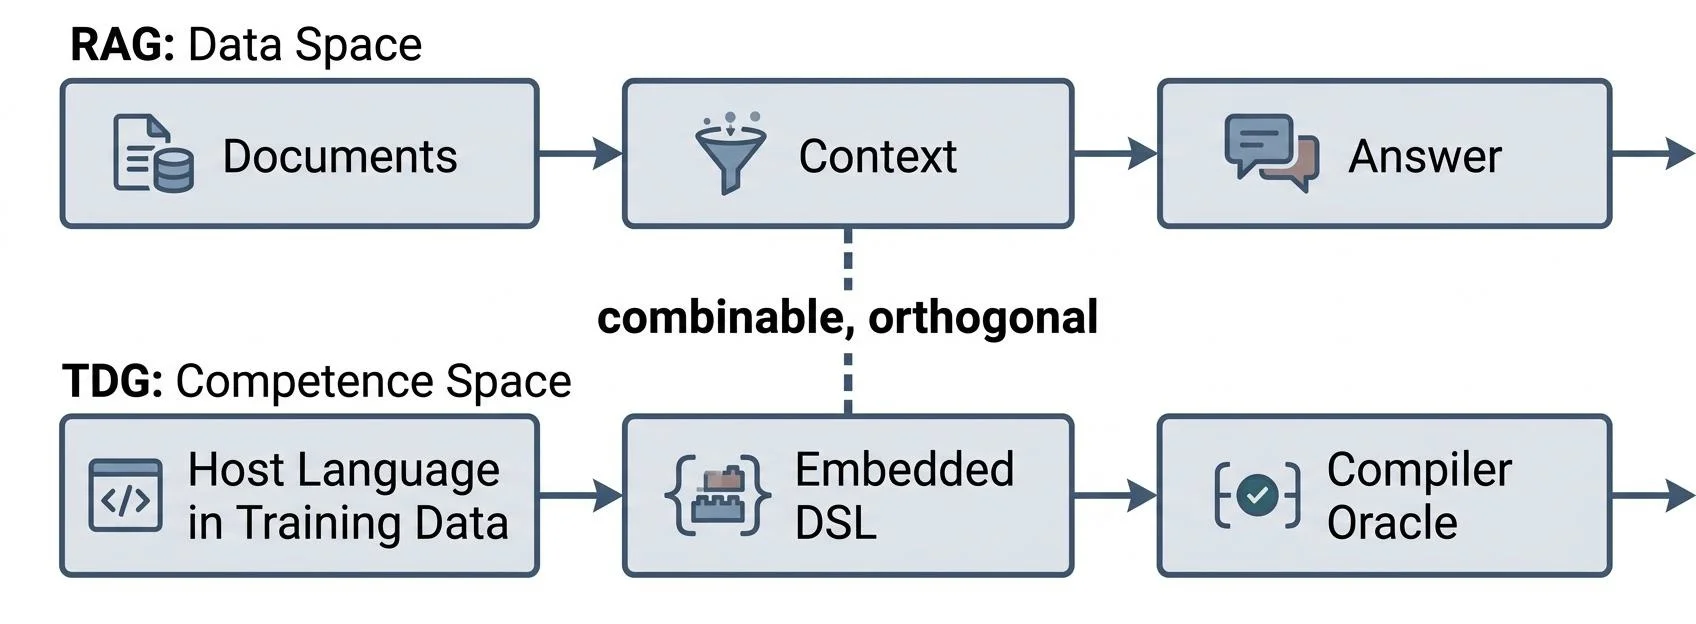
图 1. 两个锚定空间。(