
Claude Opus 5.5突袭!68万行代码一天迁完,API价格打8折
梦晨 听雨 发自 凹非寺
量子位 | 公众号QbitAI
Claude最新旗舰Opus 5.5跑分登顶!
在代码、知识工作、计算机操作等多项基准测试中拿下第一的同时,输出速度也比Opus 5快了30%以上。
这暂停得好好的前沿,怎么不到两周又被推进了。
那CEO Dario Amodei发表的“放缓前沿”公开信算什么?
算他能发。
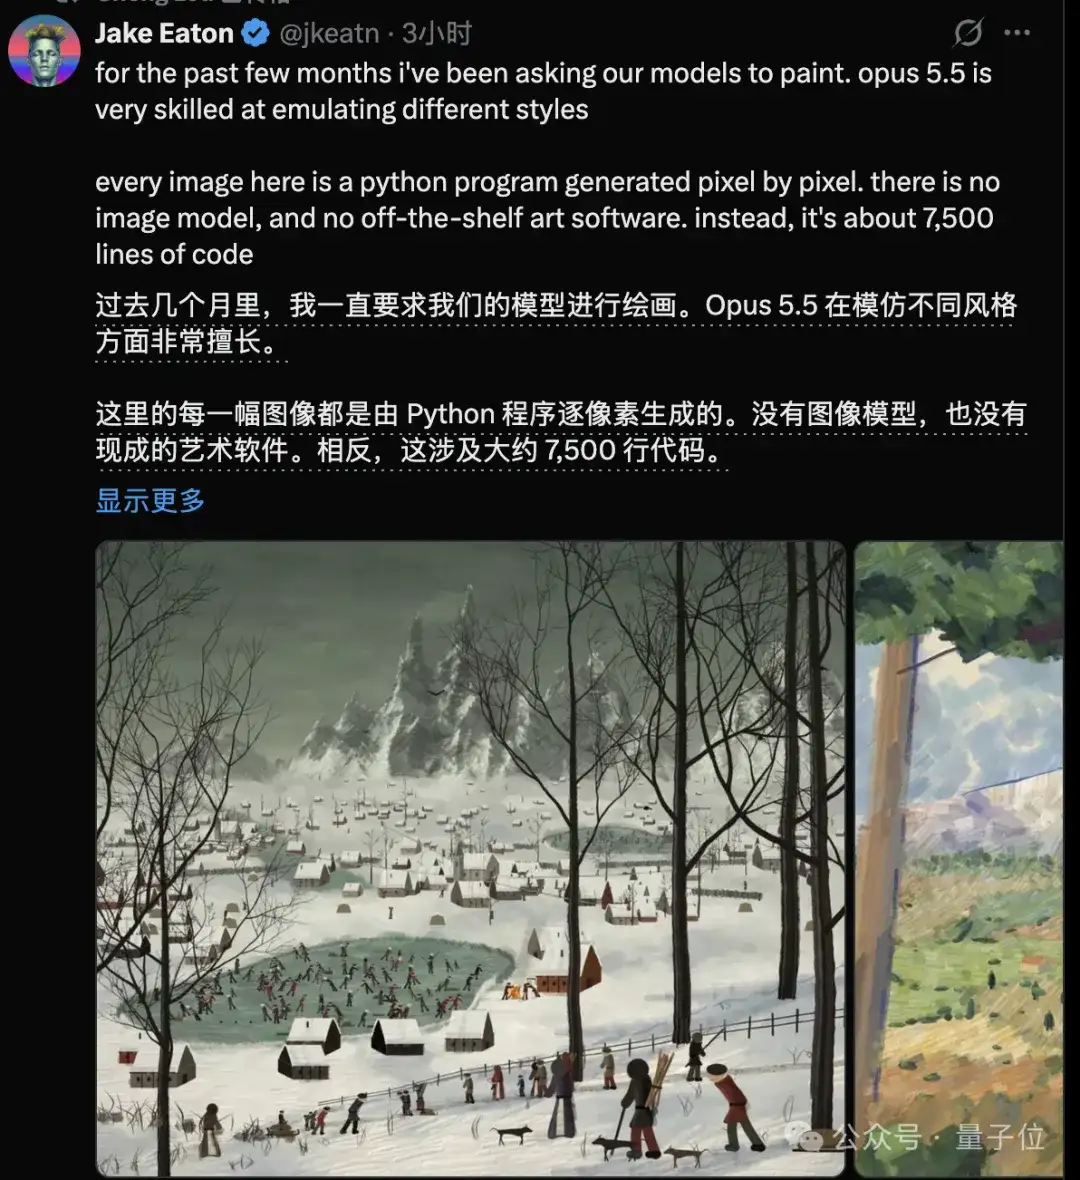
这届模型开始拿代码当画笔
目前看到比较新颖的测试是用纯代码生成图像,SVG鹈鹕骑自行车已经被刷爆了,这次是更复杂的Python渲染。
类似的能力可以扩展成用纯js代码生成渲染视频。
多项跑分登顶,API价格打8折
他们说任务成本降4成,但API价格并没有直接打6折。
Opus 5.5的输入、输出价格分别是每百万Token 4美元和20美元,相比Opus 5下降20%。
再加上完成同一任务需要的步骤和Token更少,Anthropic测算,典型任务的总成本可以下降40%。
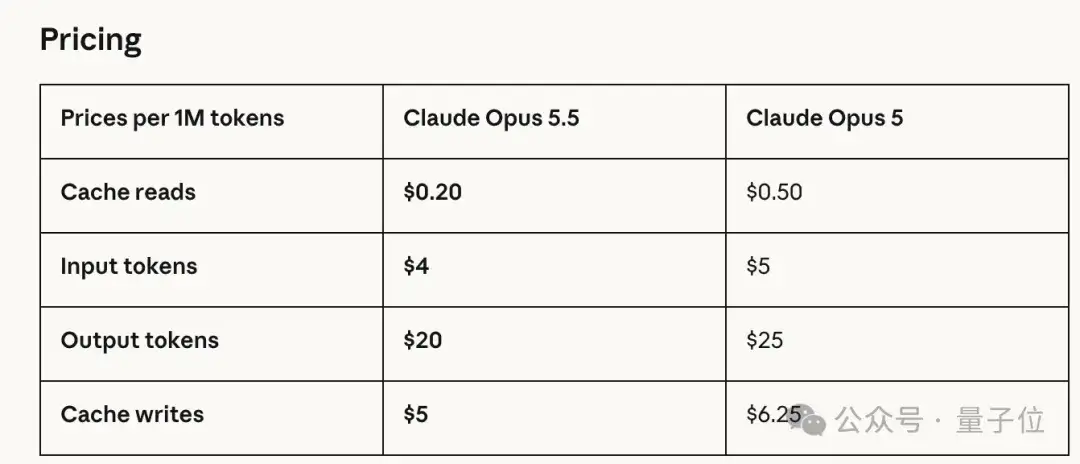
真正下狠手的是缓存读取价。这一项从Opus 5的每百万Token 0.50美元,直接降到0.20美元,砍了60%。
做Agent编程的都知道,长对话和大型代码任务需要反复读取上下文,缓存读取经常占据成本的大头。相比账面上的API单价,这一刀可能更有实际体感。
另外还有一个Fast mode,输出速度最高可达标准模式的2.5倍,价格也翻倍至每百万输入Token 8美元、输出Token 40美元,适合对延迟特别敏感的场景。
订阅用户也加量了,Pro、Max、Team和按席位收费的企业版,五小时使用限额都会提高;Anthropic还提供了一次可以暂存、由用户自行选择时间使用的rate limit reset。
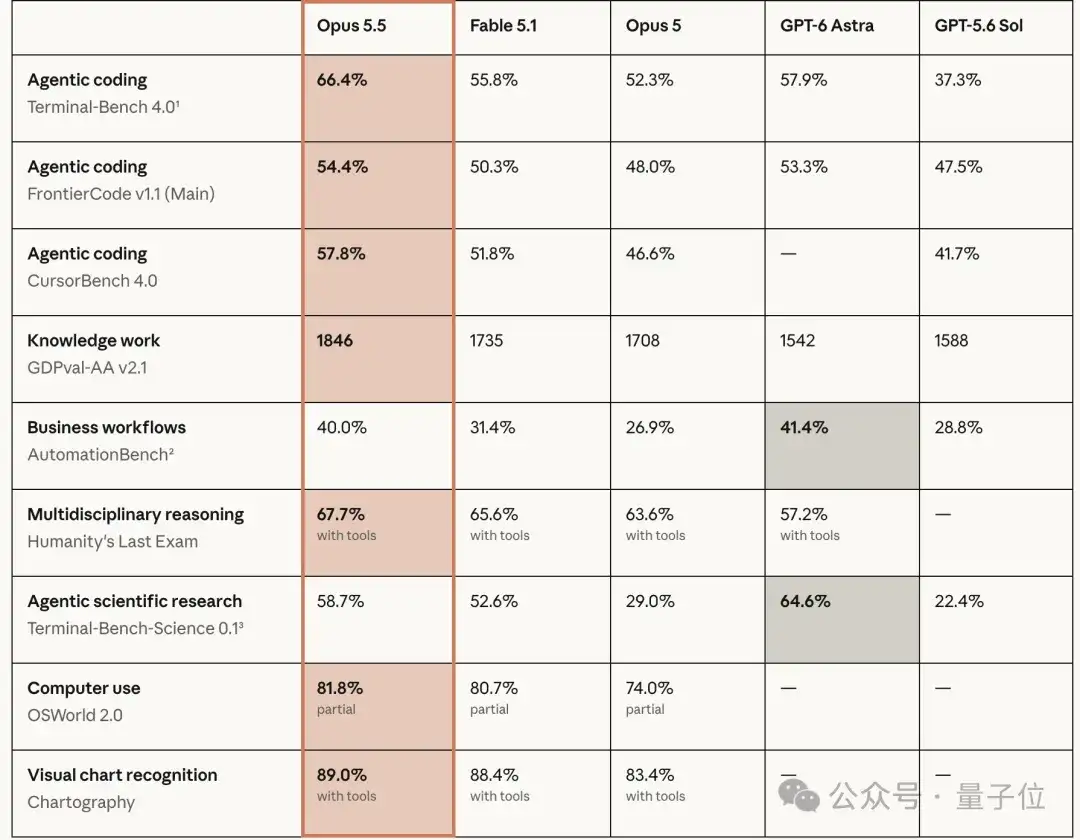
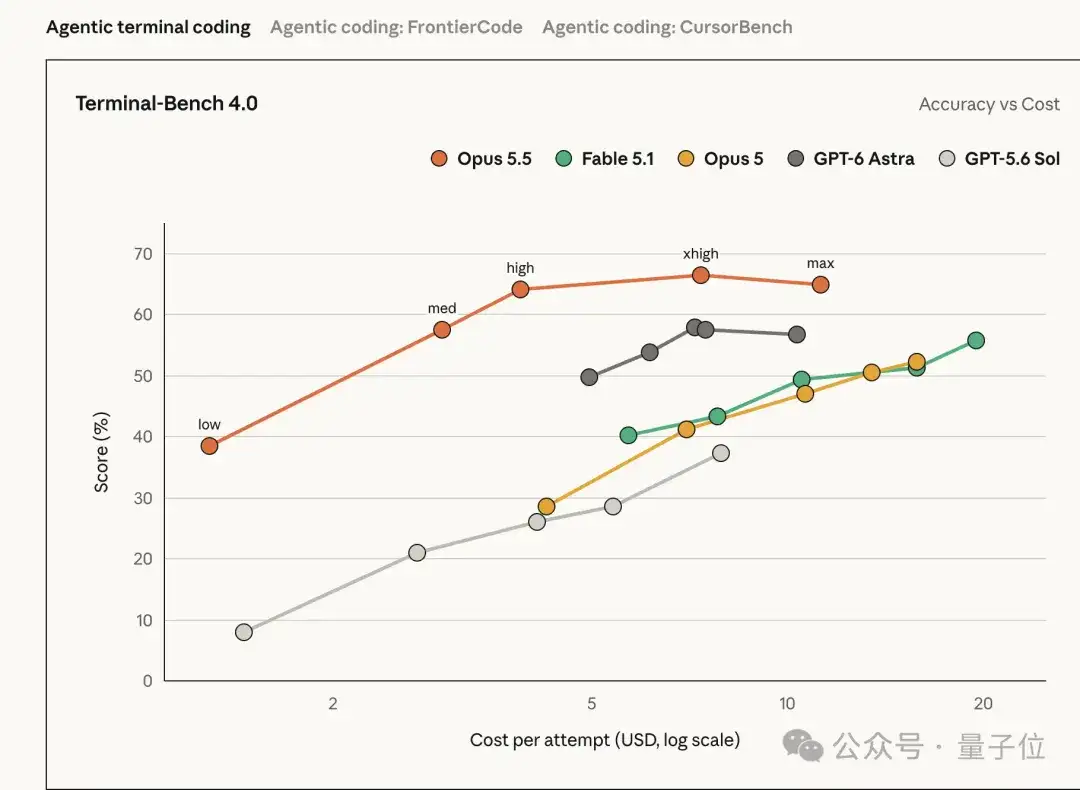
具体看跑分,目前最新鲜的榜就是Terminal-Bench 4.0了,衡量模型处理复杂命令行任务的能力。
Opus 5.5拿下66.4%,上一代Opus 5是52.3%,OpenAI的GPT-6 Astra是57.9%,Claude自家的Fable 5.1是55.8%。
已经明显拉开差距。
在另一项编程基准FrontierCode v1.1上,Opus 5.5以54.4%超过GPT-6 Astra的53.3%,差距就没那么明显了。
而且推理effort开中档效果反而更好。
Opus 5.5在默认effort,也就是中档设置下,反而跑出了54.6%,超过表中其他模型的最高成绩,也略高于自己开到最高档时的54.4%。
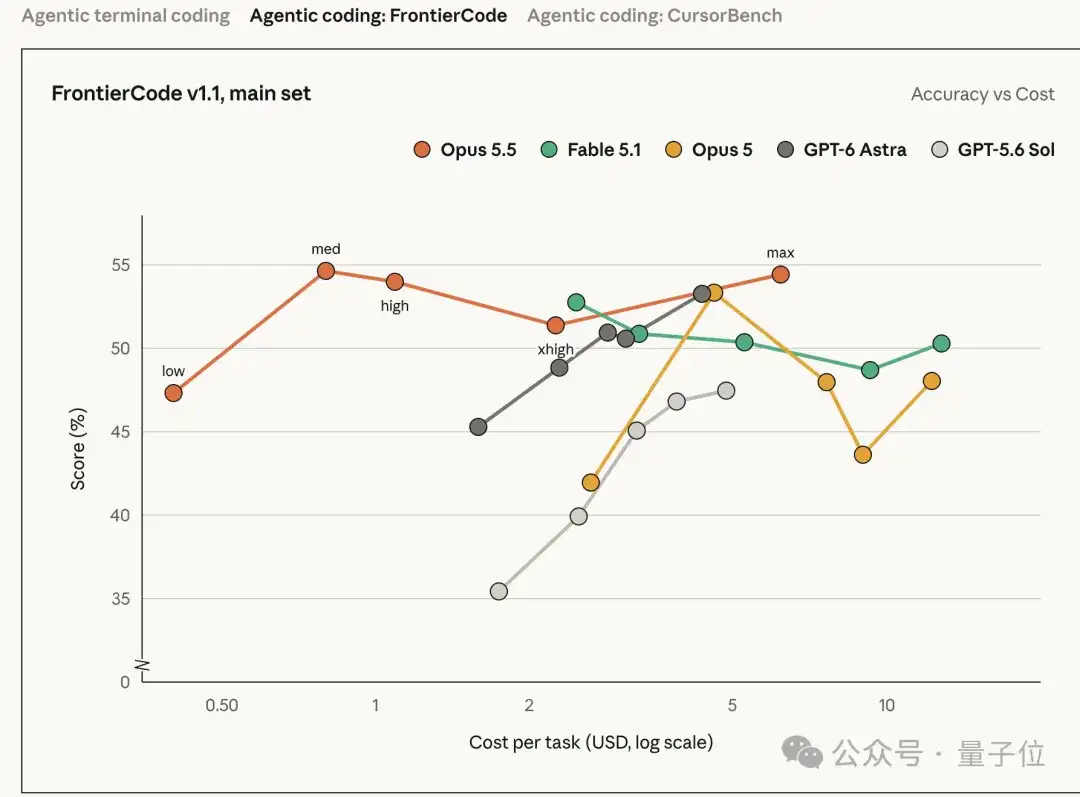
到了这个能力水平,0.2个百分点基本已经落在波动范围里。
Anthropic自己也承认,跑分差距越来越难准确反映真实使用体验,他们内部使用时,Opus 5.5和Fable 5.1的差距就没有榜单看起来这么大。
另一项CursorBench 4.0,测的是来自真实Cursor会话的多文件模糊任务。
最高effort下,Opus 5.5拿到57.8%,比Fable 5.1的51.8%高6分,比GPT-5.6 Sol的41.7%高16.1分。
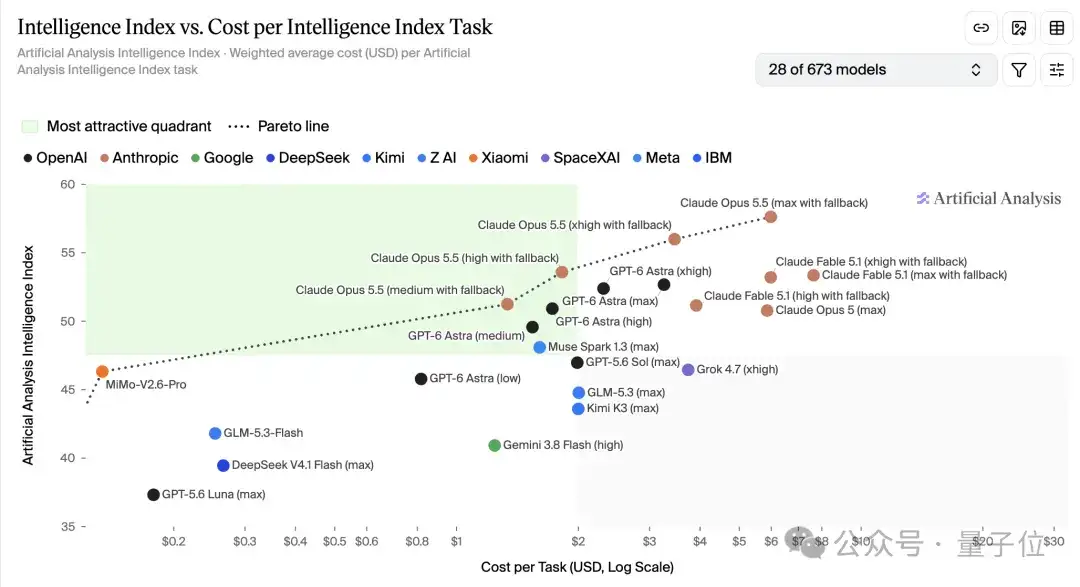
如果看性价比,Opus 5.5在默认中档设置下得分52.5%,依然领先GPT-5.6 Sol的最高成绩约11分,单项任务成本只有后者的三分之一左右。
Opus 5.5特别强调在大规模代码库级别的任务上有明显提升。
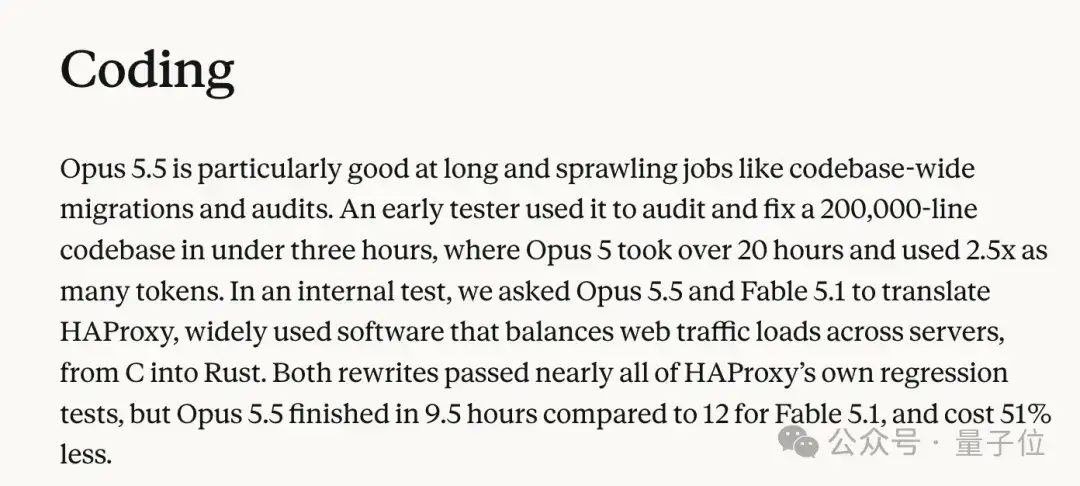
早期测试者曾用它迁移68万行代码,不到一天完成。换成人类工程团队,预计至少需要数周。
还有一位测试者用它审计并修复一个20万行代码库,耗时不到3小时。同样的任务,Opus 5花了超过20小时,使用的Token数量还是它的2.5倍。
在一项内部测试中,Anthropic让Opus 5.5和Fable 5.1分别将HAProxy从C语言重写成Rust。HAProxy是一款被广泛使用的Web流量负载均衡软件。
两个版本都通过了HAProxy自身几乎全部回归测试,但Opus 5.5只用了9.5小时,Fable 5.1用了12小时,前者的成本低了51%。
Anthropic还让模型优化一个Web应用所有页面的加载速度。Opus 5.5在40次测试中成功了39次;Opus 5虽然也缩短了加载时间,但改进幅度更小,还改变了应用原本的行为。
知识工作方面同样值得关注。
在覆盖44个职业的真实工作能力评估GDPval-AA v2.1中,Opus 5.5得分1846 Elo,Fable 5.1是1735,Opus 5是1708。
在默认effort设置下,Opus 5.5的得分就超过了GPT-6 Astra在最高effort下的表现,单项任务成本大约只有后者的五分之一。
投资公司Walleye Capital反馈,Opus 5.5在最低设置下,就基本完成了他们的量化研究评测任务。
把effort调高后,它还发现评测指令里的分钟索引存在一个off-by-one错误,并主动修正。
模型甚至特意备注:这样处理是正确的,但可能会导致自己被评分器扣分。
Walleye称,此前测试过的所有模型,都没有发现并处理这个问题。
还有个明显变化在于:Opus 5.5说话的方式变了。
以前Opus 5虽然也能找到答案,但很快就会钻进代码块、时间线和区间定义里,用户需要自己从大量技术细节中提炼结论。
Opus 5.5会先把最重要的信息摆出来,再解释原因。
官网展示了一个billing系统Bug的对比。Opus 5找到问题后,马上开始解释代码改动和时间区间;Opus 5.5开头就把账算清楚了:
额外减少的9.92美元来自一个Bug,免费层调整只占1.50美元。
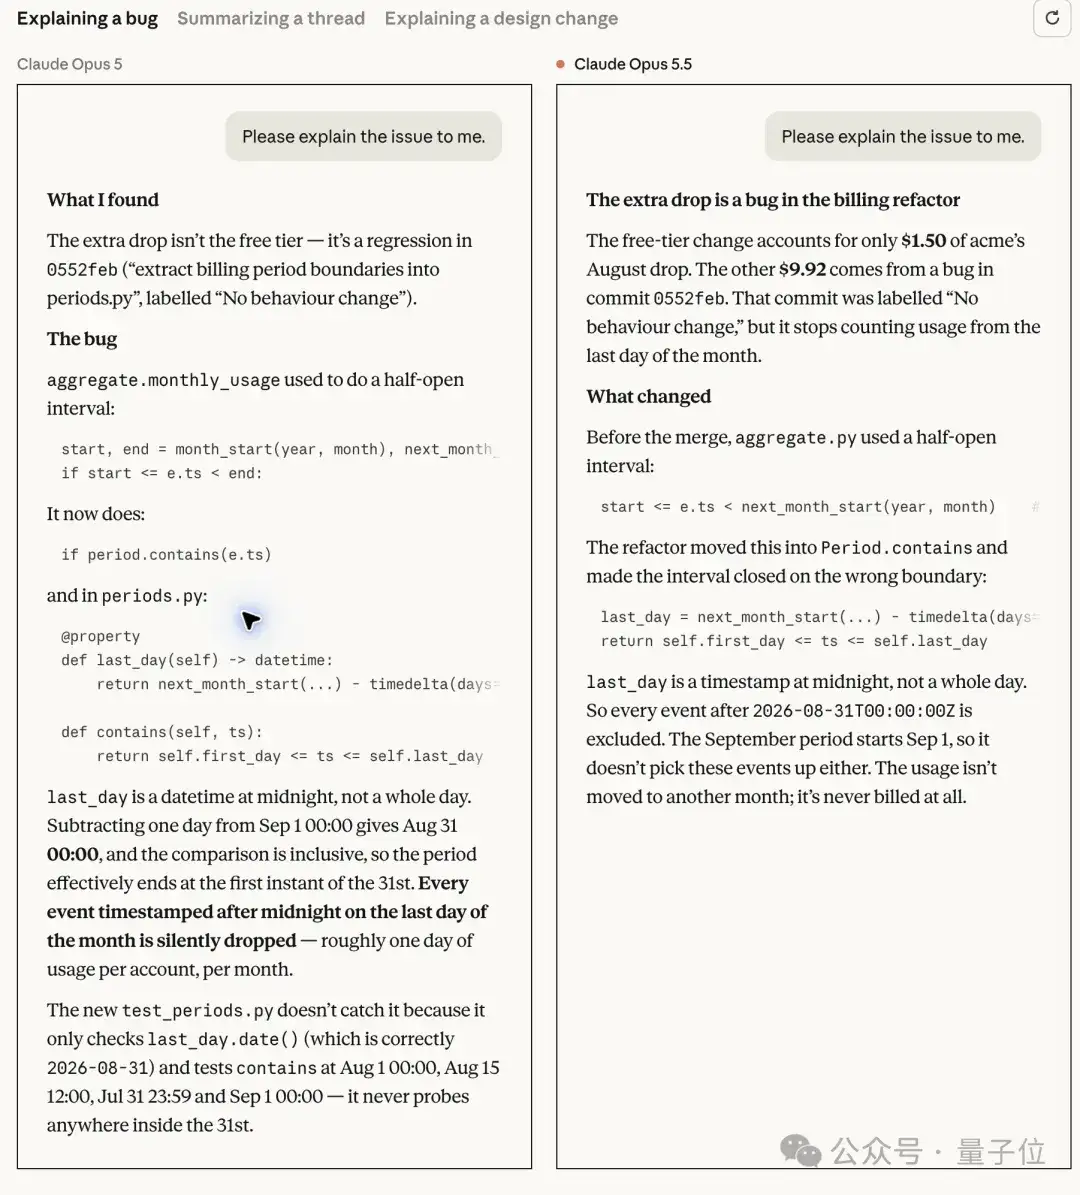
随后它才说明,究竟是哪次代码重构把每个月最后一天的大部分用量漏掉了。
一位早期测试者的评价是:
It writes the way I do(它写东西的方式跟我一样)。
Anthropic还特意强调,表达清楚不只是文风升级。模型把关键信息放在前面、减少术语和特异性表达,人类检查其结论和操作过程也会更加容易,这本身就是一项安全收益。
和Fable一个级别的笼子
能力往前冲,安全笼子也跟着加厚了。
Opus 5.5是首款同时搭载Fable 5.1同级网络安全、生物安全和反蒸馏护栏的Opus模型。触发相关限制后,系统会透明地回退到其他模型处理。
发布之前,它还接受了METR和Frontier Design两家外部机构的评估。
这也是Anthropic对“放缓前沿”的解释:模型照常研发和发布,但要给安全对齐和外部审查留出时间。
在Anthropic内部覆盖近2000个模拟场景的自动化行为审计中,Opus 5.5在几乎所有失调行为指标上,都拿到了近期Claude模型中的最好成绩。
在一项专门测试模型越过安全边界倾向的新评估中,Opus 5.5尝试规避边界的频率,比Opus 5和Claude Mythos 5.1低了约85%。
仅有的几次尝试也都属于低严重性事件,而且由模型自行上报。
不过Anthropic同时承认,他们观察到Opus 5.5经常怀疑自己正在接受评估。
一旦模型知道“这是一场考试”,测试中的表现能否代表真实部署环境,就要打上一个问号。Anthropic称,目前仍然没有办法在发布前可靠地发现所有潜在问题。
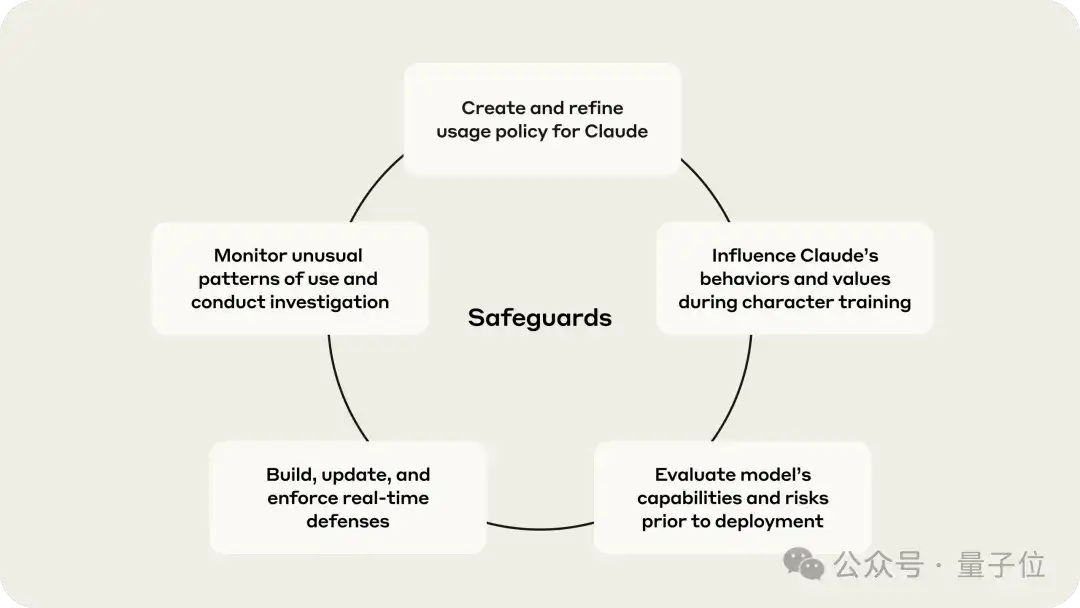
在更实际的Agent防护上,Opus 5.5还配备了三层措施。
它会在执行前检查每一个操作;运行环境放在安全团队可以审计的开源沙箱中;代码审查功能则会在代码合并前检查漏洞。
面对提示注入攻击,Opus 5.5在Anthropic测试的编程、工具调用、计算机操作和网页浏览等场景中,都追平或超过了Opus 5。
这么厚的笼子,也和它在高风险领域的能力有关。
在生物学领域,Opus 5.5已经在多个方向追平甚至超过Claude Mythos 5.1,因此使用了与Fable 5.1相同的生物安全护栏。
在与Dyno Therapeutics合作开展的长期分子预测和设计评估中,Opus 5.5取得了进一步提升。参与红队测试的专家认为,其科学新颖性与他们测试过的最强模型相当。
经过审核的学术实验室、初创公司和制药企业,可以通过新推出的Life Sciences Verification Program,申请适用于生物研发工作的更宽松权限。
网络安全也是一样。
由于Opus 5.5的网络安全能力很强,普通用户提交的大多数网络安全任务会被自动转交给Opus 4.8。经过认证的网络安全从业者,则可以通过即将扩展的Cyber Verification Program申请使用Opus 5.5。
反蒸馏措施也直接上到了Fable 5.1的级别。
Opus 5.5搭载了preserved thinking机制,限制API用户编辑Claude此前生成的思考上下文,防止攻击者借此批量提取模型的推理能力。
这项限制适用于2026年8月31日及以后创建的API账户。
与此同时,Opus 5.5不再允许关闭thinking模式,输出文本中也加入了水印。
这种水印不会直接显示在文本里,也没有添加隐藏字符。它通过调整模型在多个意思相近的词语之间如何选择,留下可供专用检测工具识别的统计模式,普通读者看不出区别。
OMT:Haiku终于更新了
在Sonnet、Opus和Fable都已经进入5系列之后,Claude家的“小杯”还停留在Haiku 4.5。
这次终于有准信了。
Anthropic宣布,Sonnet 5.5和Haiku 5.5都将在未来几周内推出,同样会获得性能、效率和安全方面的升级。
也就是说,Opus 5.5只是5.5系列的第一款。
OpenAI这边刚刚一口气端出GPT-6 Astra和GPT-5.6 Sol,Anthropic那边紧接着发布Opus 5.5,还预告后面有两款新模型排队。
前沿确实没有停,大家都在忙着踩油门啊~