
数百亿向量怎么搜?Pinterest 抛弃“内存大户”HNSW,转向量化 SPANN
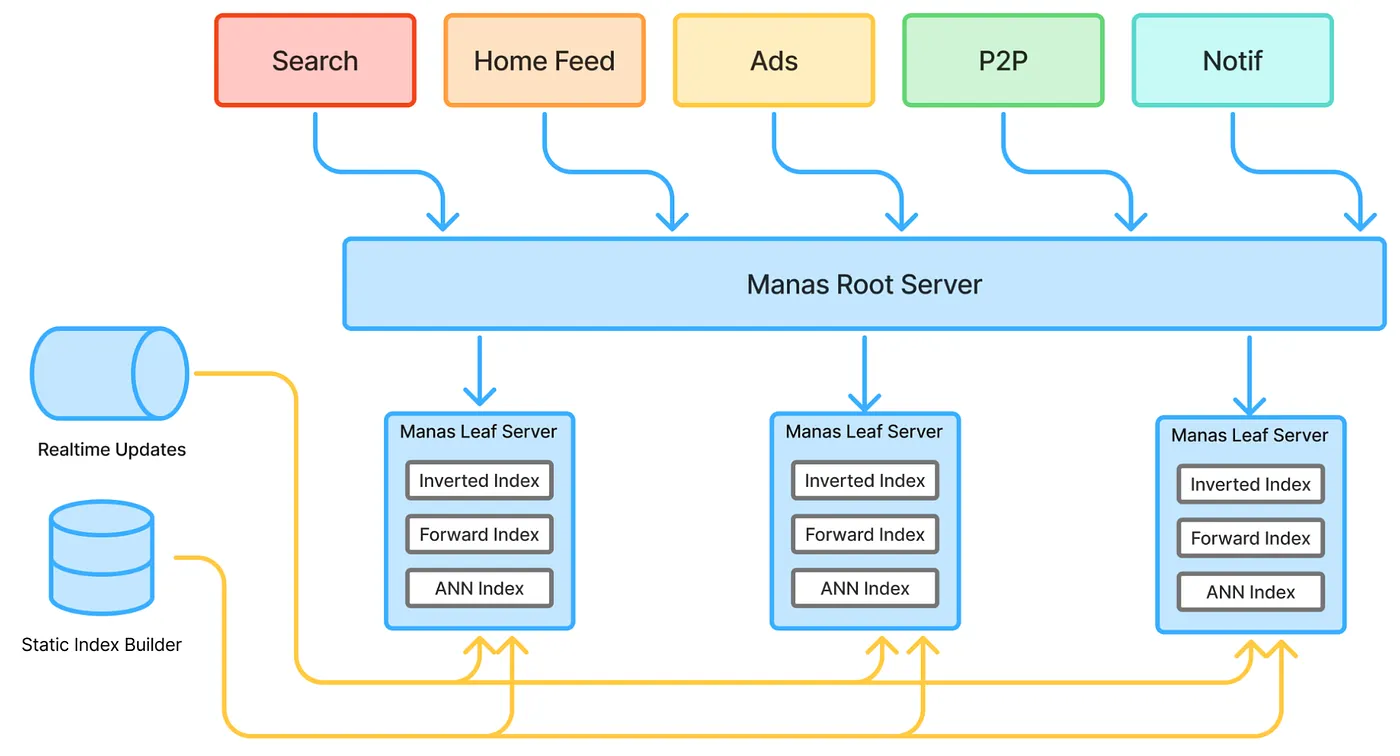
Pinterest 工程团队持续演进其分布式搜索平台 Manas,通过量化、基于 SPANN 的 SSD 服务和后期交互检索,处理数百亿个嵌入向量。Manas 已部署在 80 个集群中,为首页信息流、搜索、相关 Pin、广告和通知等核心内容发现体验提供支持。随着底层语料库迅速扩展到数十亿个条目,标准 HNSW 等内存占用较高的传统向量搜索算法,在成本、硬件资源分配和基础设施灵活性方面面临越来越大的挑战。
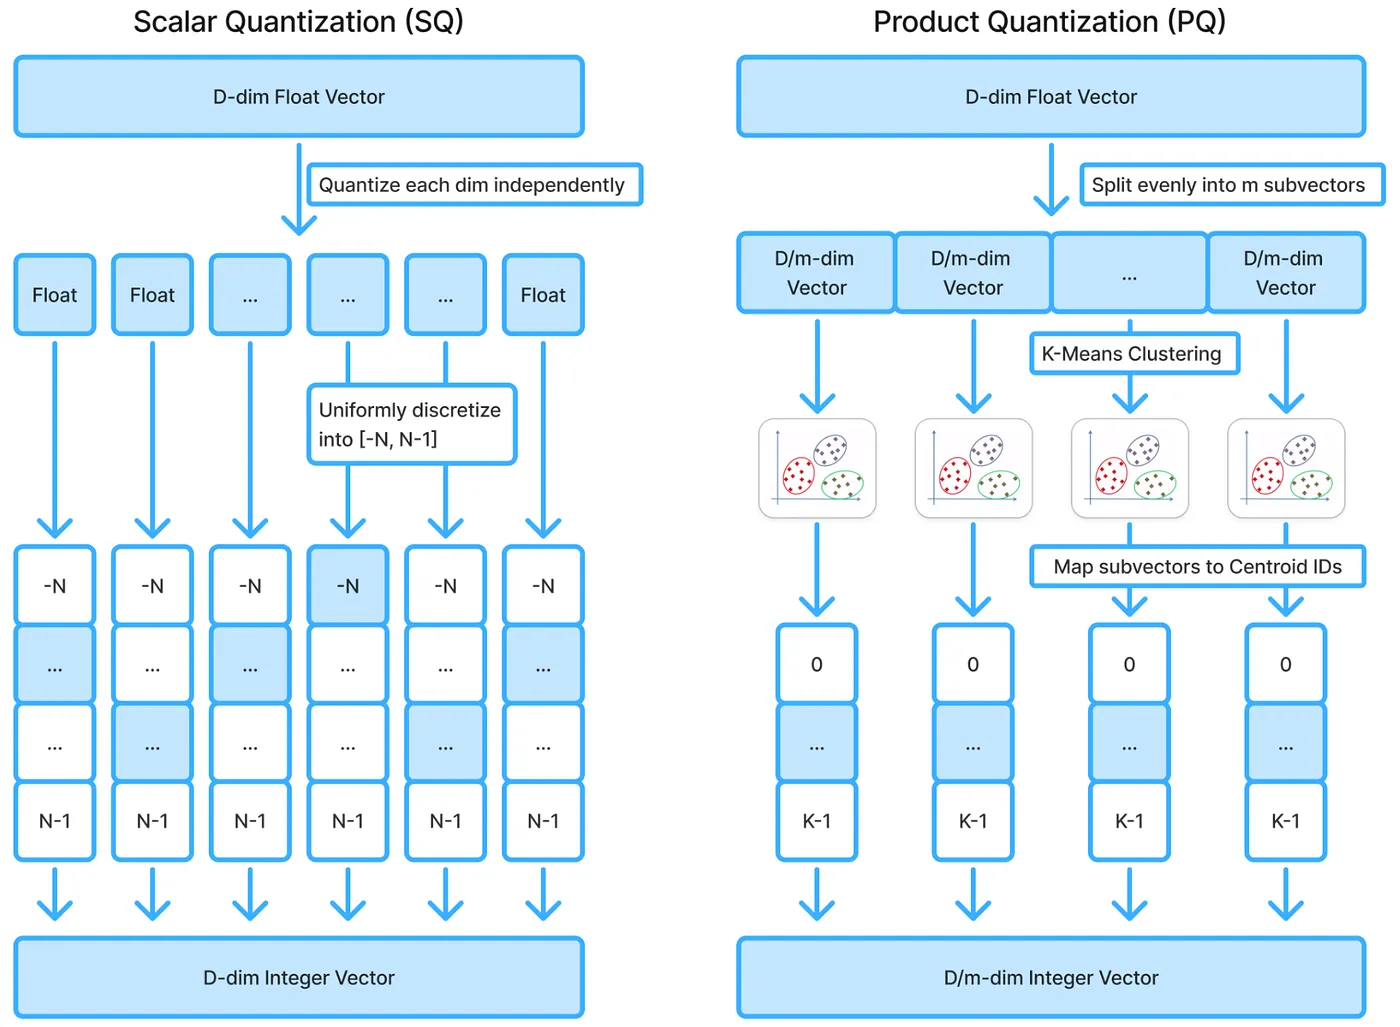
为了应对这些扩展难题并显著减少内存占用,Pinterest 团队在一个包含 1 亿个嵌入向量的 GraphSage 数据集上实现了标量量化(SQ)和乘积量化(PQ)。PQ 将原始浮点向量表示压缩为紧凑的字节编码,使 HNSW 索引缩小 74%,倒排文件(IVF)索引缩小 93%,召回率达到 70%~80%。相比之下,SQ 将向量分量压缩为低比特整数,使 HNSW 索引缩小 59%,IVF 索引缩小 75%,同时在各种工作负载中始终保持 90% 以上的召回率。
离线基准测试揭示了不同配置和索引规模之间的取舍。基准 HNSW 索引的大小为 121 GB,Recall@100 为 93.72%,吞吐量为 302.5 QPS。采用 HNSW 加 PQ 后,索引大小降至 32 GB,Recall@100 为 77.25%,吞吐量为 276.4 QPS。
采用 HNSW 加 SQ 后,索引大小为 50 GB,Recall@100 达到 92.92%,吞吐量为 305.2 QPS。基准 IVF 索引的大小为 97 GB,Recall@100 为 91.69%,吞吐量为 1659.8 QPS。采用 IVF 加 PQ 后,索引被压缩至 6.8 GB,Recall@100 为 76.00%,吞吐量为 1747.9 QPS。
采用 IVF 加 SQ 后,索引大小为 25 GB,Recall@100 达到更高的 95.71%,吞吐量为 1588.8 QPS。转换为低比特表示通常需要在计算距离前执行解码。为解决这一 CPU 瓶颈,团队使用 SIMD 内建函数实现了线性缩放 SQ,将查询所需的计算资源减少了 10%~15%。
在线实验成功上线了 SQ 和 PQ,使生产工作负载的服务成本降低了 20%~30%。在 SSD 服务方面,Pinterest 对 DiskANN 和 SPANN进行了评估。结果发现,采用 PQ 的 SPANN 吞吐量是 DiskANN 的 3 倍,延迟仅为其三分之一,而召回率只下降了 5%。
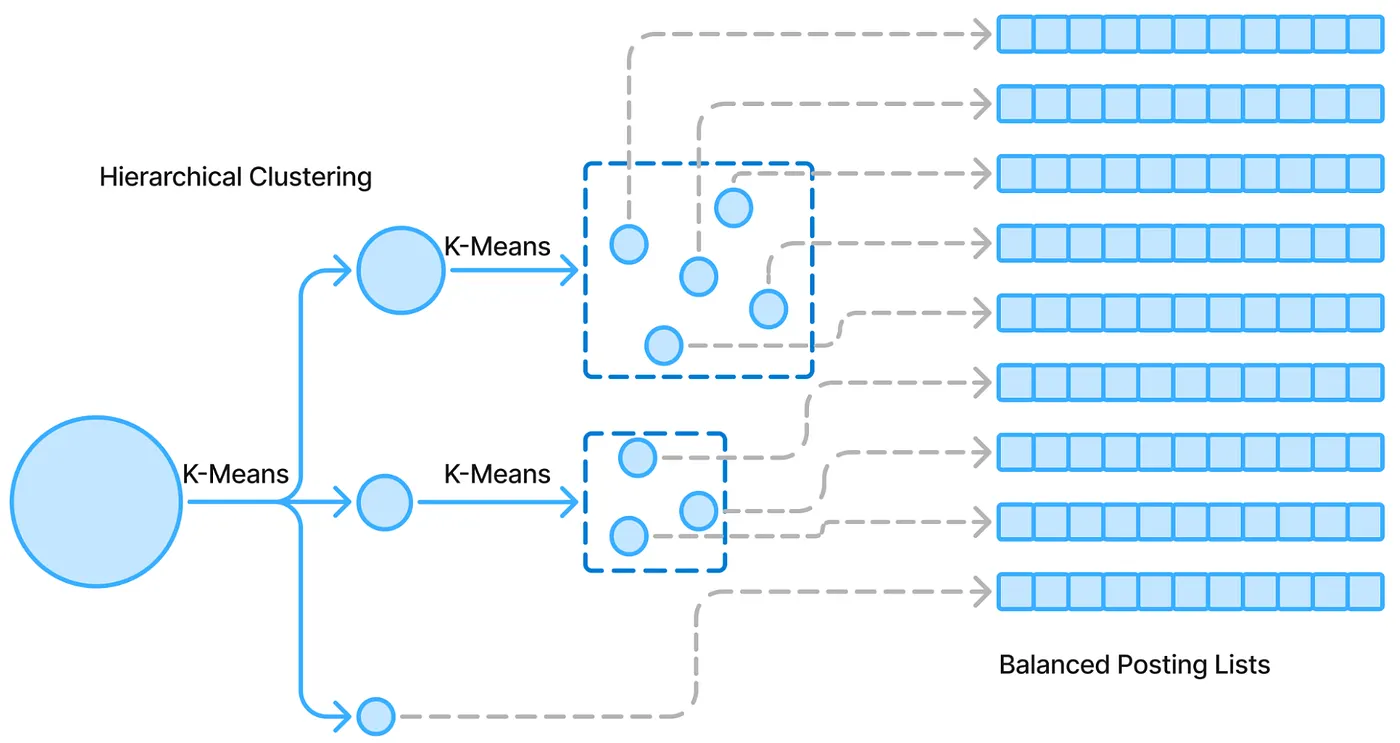
为了将索引存储迁移到高吞吐量 SSD 上,进一步降低内存成本,Pinterest 对 DiskANN 和 SPANN 进行了评估。结果显示,SPANN 与 PQ 结合后,吞吐量达到 DiskANN 的 3 倍,延迟仅为其三分之一,而召回率只小幅下降了 5%。Pinterest 定制的 SPANN 架构在内存中保留一个小型、高速的质心索引,用于定位相关分区,同时将大型倒排列表存储在 SSD 上,从而优化 IOPS 并保证搜索效率。在一项为超过 50 亿个嵌入向量建立索引的 Pin 推荐评估中,与完全驻留内存的 HNSW 相比,SPANN 为生产查询节省了超过 40% 的 CPU 时间。
为了突破单向量双塔模型的表达能力限制,Pinterest 正在转向 ColBERT 等多向量后期交互模型,通过 MaxSim 求和评分优化 Token 之间的细粒度相关性匹配。要在 Manas 中实现这一功能,需要更新查询解析器,将包含多个 Token 的查询拆分为多个向量嵌入,并在不同索引上同时执行 ANN 搜索。目前,Pinterest 正与一个内部客户团队开展试点上线,在真实生产环境中测试高级多嵌入查询支持。