
AIAgent自己出了故障,运维该查什么?
凌晨3点12分,你被电话吵醒。
"老大,Agent炸了。"
你迷迷糊糊问:"什么Agent?"
"自动化运维Agent。本来让它帮我们批量重启几个异常Pod,结果它在5分钟内执行了247次kubectl delete,现在整个测试环境都没了。"
你瞬间清醒,打开电脑。Slack群里已经炸开了锅:
- Agent调用OpenAI API超时,重试了89次
- Token用量从昨天的2万飙到今天的180万
- MCP工具调用返回400错误,但Agent仍在循环
- 某个LangChain workflow卡在第3步,已经运行了2小时17分钟
你盯着屏幕,脑子里只有一个问题:
我TM从哪儿开始查?
这不是梦幻场景。当你把AI Agent部署到生产环境,让它自动处理告警、执行变更、分析日志时——
谁来运维这个运维系统?
一、Agent故障和传统故障完全是两回事
你可能会说:"不就是个应用吗?查日志、看监控、抓调用链,老一套不就行了?"
不行。
传统应用的故障路径通常是线性的:
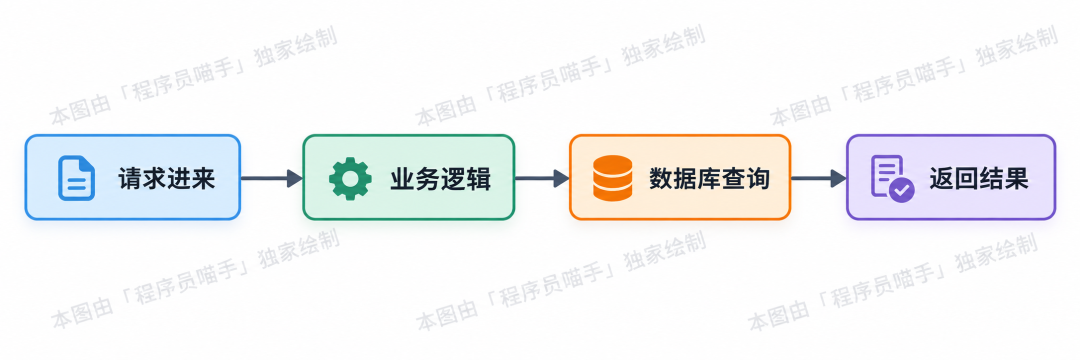
哪一步慢了、错了、卡了,基本能定位。
但AI Agent的执行路径是这样的:
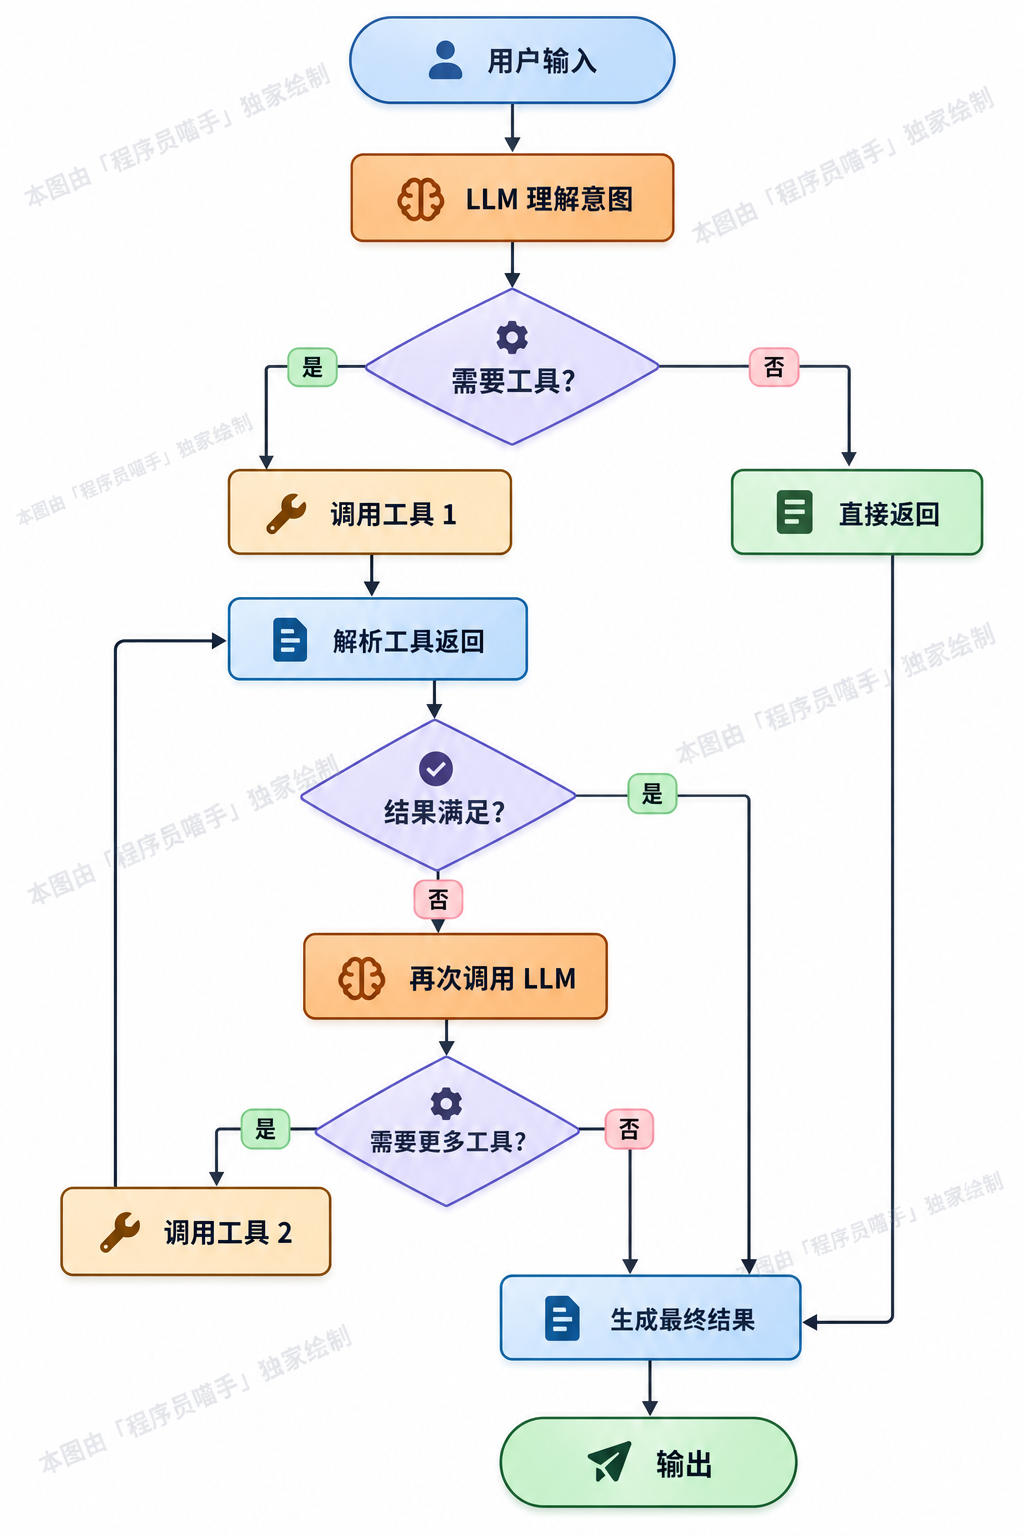
你面对的是:
非确定性的执行路径
同样的输入,Agent可能:
- 第一次调用3个工具
- 第二次调用7个工具
- 第三次进入死循环
不可预测的成本
- 一次正常查询:500 tokens,0.02元
- 一次异常查询:45000 tokens,2.3元
- 一次死循环:根本停不下来
复杂的依赖链
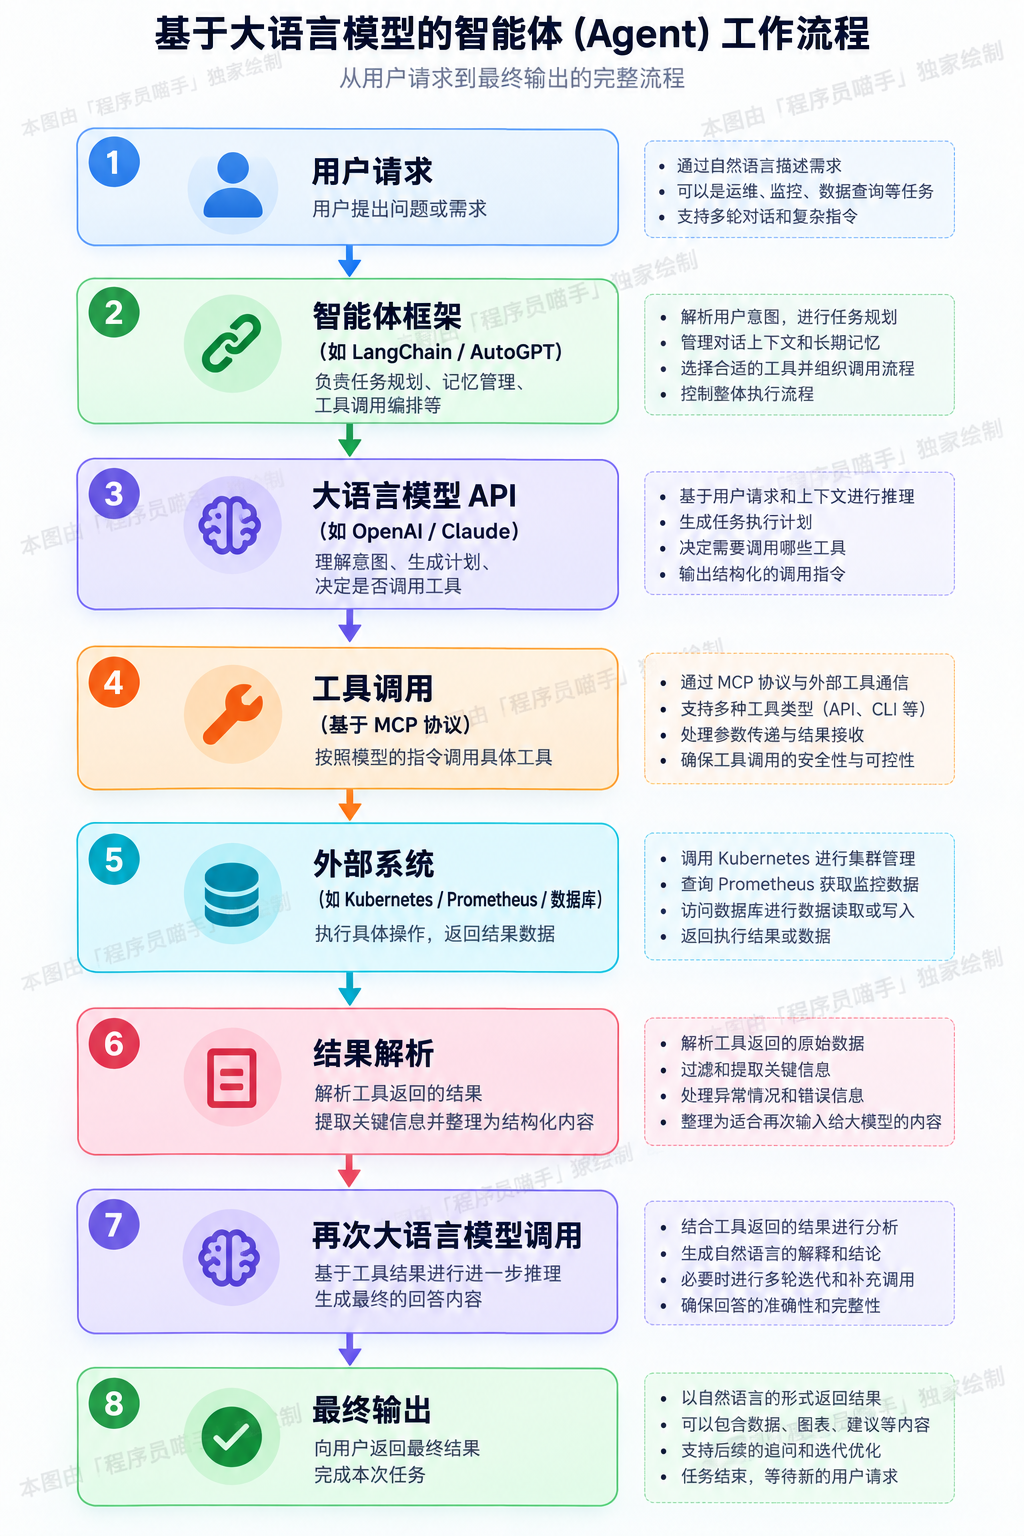
任何一层出问题,都可能导致:
- Agent卡住不动
- 无限重试
- 返回错误结果
- Token爆炸
- 用户等待超时
而你的监控系统里,可能只显示:
"HTTP 200, 响应时间127秒"
二、Agent故障背后的真正问题是什么?
表面上看,Agent执行慢、调用失败、成本飙升——这些都是症状。
真正的问题是:
传统可观测性体系根本看不到Agent的"思考过程"
你的Prometheus能告诉你:
- API响应时间
- 错误率
- QPS
但它不知道:
- Agent为什么选择了这个工具?
- LLM推理用了多少步?
- 哪次Tool Call的结果让Agent产生了困惑?
- Agent是在第几轮对话时开始偏离预期?
假设一个典型场景:
用户问:"帮我查一下订单服务最近1小时的错误率。"
正常情况下,Agent应该:
- 理解意图(查询错误率)
- 调用Prometheus查询工具
- 解析返回数据
- 格式化输出
但实际发生了什么:
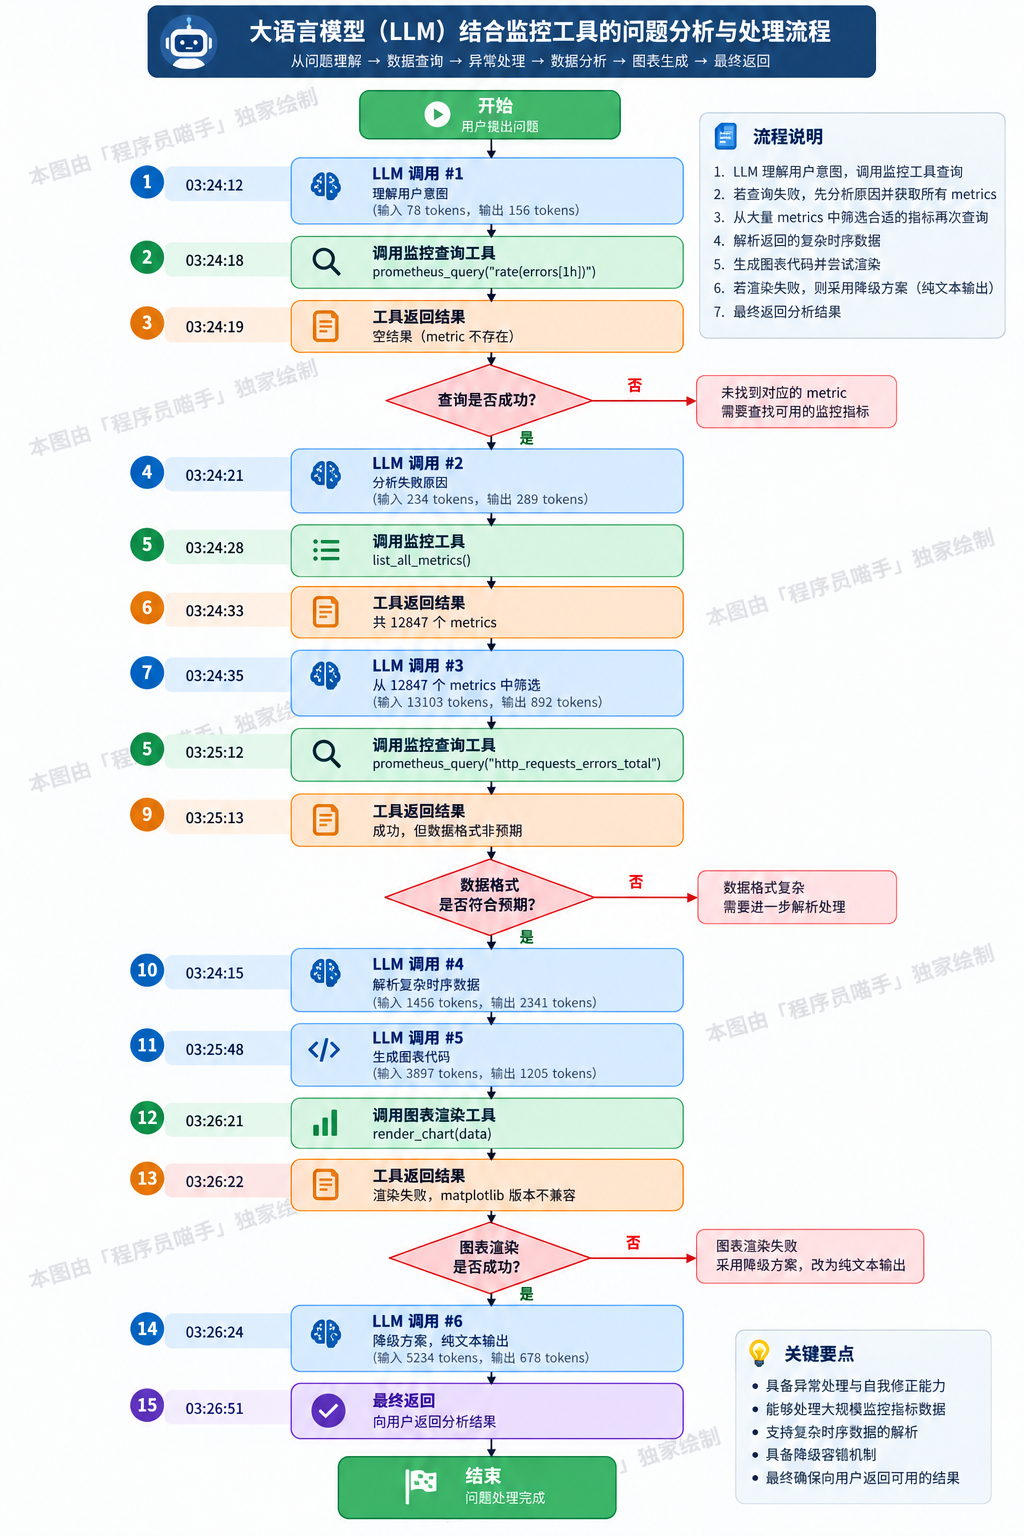
总耗时: 2分39秒总Token数: 29,173 总成本: ¥1.87
用户体验:"怎么这么慢?"
传统监控显示:"HTTP 200, 响应时间159秒,一切正常。"
但真相是:
- Agent选错了metric名称(第1次Tool Call失败)
- 被迫拉取全量metric列表(13k+ tokens)
- 解析时序数据时产生了大量Token消耗
- 最后渲染图表还失败了
你需要的不是"这个请求用了159秒",而是"Agent在第2步走偏了,导致后续5次不必要的LLM调用"。
三、OpenTelemetry怎么让Agent"可观测"?
去年开始,OpenTelemetry社区专门为AI应用设计了语义约定(Semantic Conventions)。
核心思路很简单:
把Agent的每次LLM调用、每次Tool执行、每次决策,都变成一个Span。
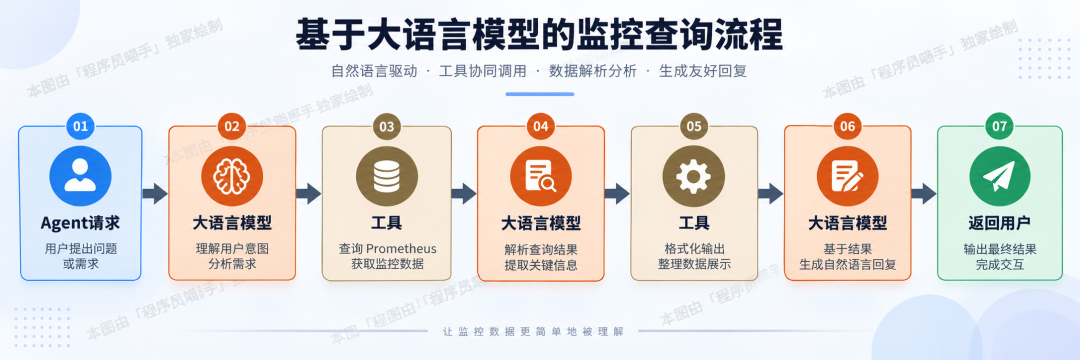
每个Span记录:
LLM调用Span
gen_ai.system: "openai"gen_ai.request.model: "gpt-4"gen_ai.request.temperature: 0.7gen_ai.usage.input_tokens: 234gen_ai.usage.output_tokens: 289gen_ai.request.max_tokens: 2000- 实际prompt内容(可选)
- 实际response内容(可选)
Tool调用Span
tool.name: "prometheus_query"tool.parameters: {"query": "rate(errors[1h])"}tool.result.status: "success" / "error"tool.result.size: 1247 bytestool.execution.duration: 0.89s
Agent决策Span
agent.iteration: 3agent.thought: "需要查询更多metrics"agent.action: "call_tool"agent.action.reason: "previous result was empty"
有了这些数据,你就能:
1. 看清完整执行路径
不再是一个黑盒的159秒,而是:
├─ 理解意图: 6.2s (156 tokens)
├─ Tool Call #1: 1.1s (失败)
├─ 分析失败原因: 7.3s (289 tokens)
├─ Tool Call #2: 5.2s (返回13k metrics)
├─ 筛选metrics: 37.8s (892 tokens) ← 瓶颈
├─ Tool Call #3: 1.2s (成功)
├─ 解析数据: 33.4s (2341 tokens) ← 瓶颈
├─ 生成图表代码: 27.1s (1205 tokens)
├─ Tool Call #4: 0.3s (失败)
└─ 降级输出: 26.7s (678 tokens)
一眼就能看出:第5步和第7步的LLM推理消耗了65秒。
2. 识别异常模式
正常查询:
- 2-3次LLM调用
- 1-2次Tool调用
- 总Token < 2000
- 响应时间 < 10s
异常查询:
- 6次以上LLM调用 ← 可能陷入循环
- Tool调用失败后重试 ← 工具配置问题
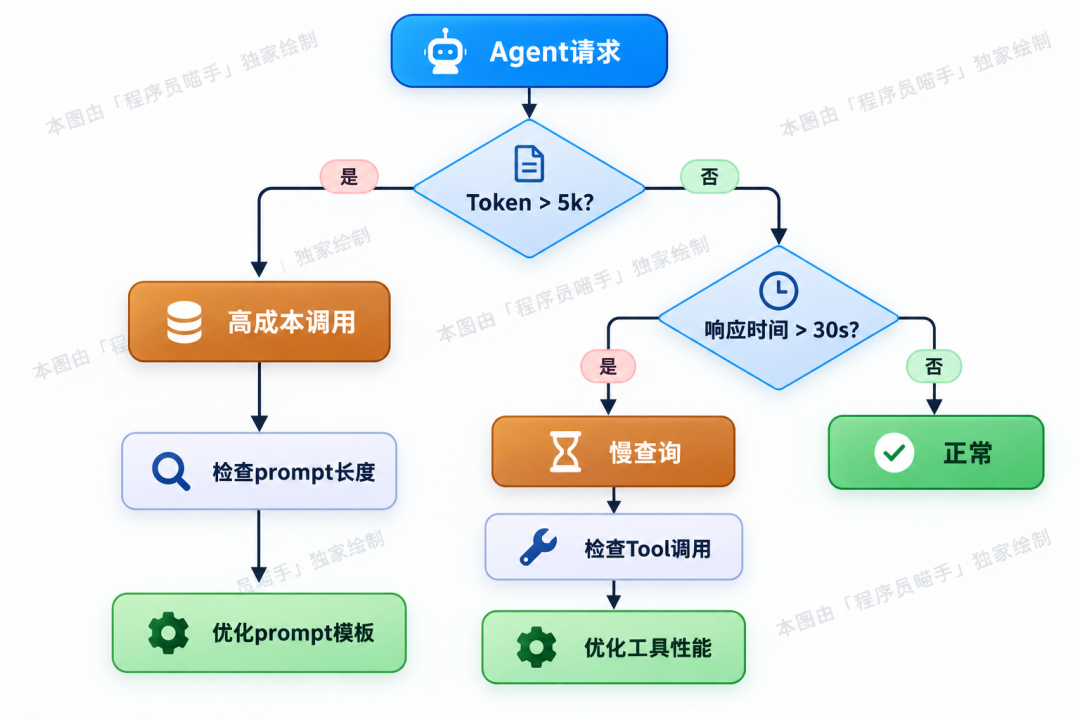
- 单次Token > 10k ← prompt设计问题
- 响应时间 > 60s ← 需要优化
3. 关联成本和性能
你可以直接在Grafana里看到:
Top 10 最贵的Agent调用
| 请求ID | Token数 | 成本 | 响应时间 | 问题 |
|---|---|---|---|---|
| req_892 | 45,231 | ¥2.89 | 4m 12s | 无限循环 |
| req_734 | 38,907 | ¥2.34 | 3m 47s | Tool返回了全量数据 |
| req_561 | 29,173 | ¥1.87 | 2m 39s | 多次LLM推理 |
4. 建立告警规则
# Agent执行异常
agent.llm.calls > 5 in single request

# Token爆炸
agent.tokens.total > 10000 in single request

# Tool调用失败率
rate(agent.tool.errors[5m]) > 0.1

# Agent响应慢
histogram_quantile(0.95, agent.duration) > 30s

# 成本异常
sum(rate(agent.cost[1h])) > 100 CNY/hour
四、一次真实的Agent故障复盘
我们模拟一个常见的生产场景。
3:47 - 用户提交任务
某个SRE通过Agent执行:"帮我把staging环境所有CPU > 80%的Pod重启一下。"
3:47:15 - Agent开始执行
OpenTelemetry trace显示:
Span 1: LLM理解意图
  - 输入: 用户原始请求 + 系统prompt (412 tokens)
  - 输出: 执行计划JSON (89 tokens)
  - 耗时: 3.2s
  - 决策: 需要调用kubernetes_list_pods工具
3:47:19 - 第一次Tool调用
Span 2: Tool - kubernetes_list_pods
  - 参数: namespace="staging", label=""
  - 返回: 247个Pod
  - 耗时: 1.3s
  - 状态: 成功
3:47:21 - LLM分析Pod列表
Span 3: LLM过滤高CPU Pod
  - 输入: 247个Pod的完整信息 (23,847 tokens) ← 问题开始
  - 输出: 需要重启的Pod列表 (1,205 tokens)
  - 耗时: 41.2s
  - Token成本: ¥1.52
第一个异常信号: 单次LLM调用消耗23k+ tokens。
3:48:03 - Agent决定执行重启
Span 4: LLM生成执行计划
  - 输入: 待重启Pod列表 + 安全检查规则 (2,341 tokens)
  - 输出: kubectl delete命令列表 (687 tokens)
  - 耗时: 8.7s
  - 决策: 逐个执行重启
3:48:12 - 开始批量重启
Agent创建了89个并行Tool调用Span:
Span 5.1: Tool - kubectl_delete_pod(pod=web-7d8f9c, namespace=staging)
Span 5.2: Tool - kubectl_delete_pod(pod=api-4k2m1x, namespace=staging)
...
Span 5.89: Tool - kubectl_delete_pod(pod=worker-9s8d2, namespace=staging)
3:48:47 - 部分Tool调用超时
Tool返回:
- 成功: 34个
- 超时: 23个 ← Kubernetes API限流
- 失败: 32个 (Pod already terminating)
3:48:50 - Agent陷入重试循环
trace显示:
Span 6: LLM分析失败原因
  - 输入: 55条错误信息 (8,903 tokens)
  - 输出: "需要重试失败的Pod" (234 tokens)
  - 耗时: 15.3s

Span 7: Tool - kubectl_delete_pod (重试 #1)
  23个Pod,18个仍然超时

Span 8: LLM再次分析
  - 输入: 上下文 + 新错误 (12,456 tokens)
  - 输出: "继续重试" (198 tokens)
  - 耗时: 22.1s

Span 9: Tool - kubectl_delete_pod (重试 #2)
  18个Pod,11个仍然超时

Span 10: LLM第三次分析
  - 输入: 累积上下文 (18,792 tokens) ← Token持续累积
  - 输出: "增加等待时间后重试" (276 tokens)
  - 耗时: 31.4s
3:51:23 - 告警触发
[CRITICAL] Agent token usage spike
  - 1分钟内消耗89,234 tokens
  - 预估成本 ¥5.67
  - 超过阈值10倍

[WARNING] Agent execution timeout
  - 请求已运行3分36秒
  - 仍在进行中
  - 用户等待超时
3:51:45 - 人工介入
SRE看到告警,打开trace:
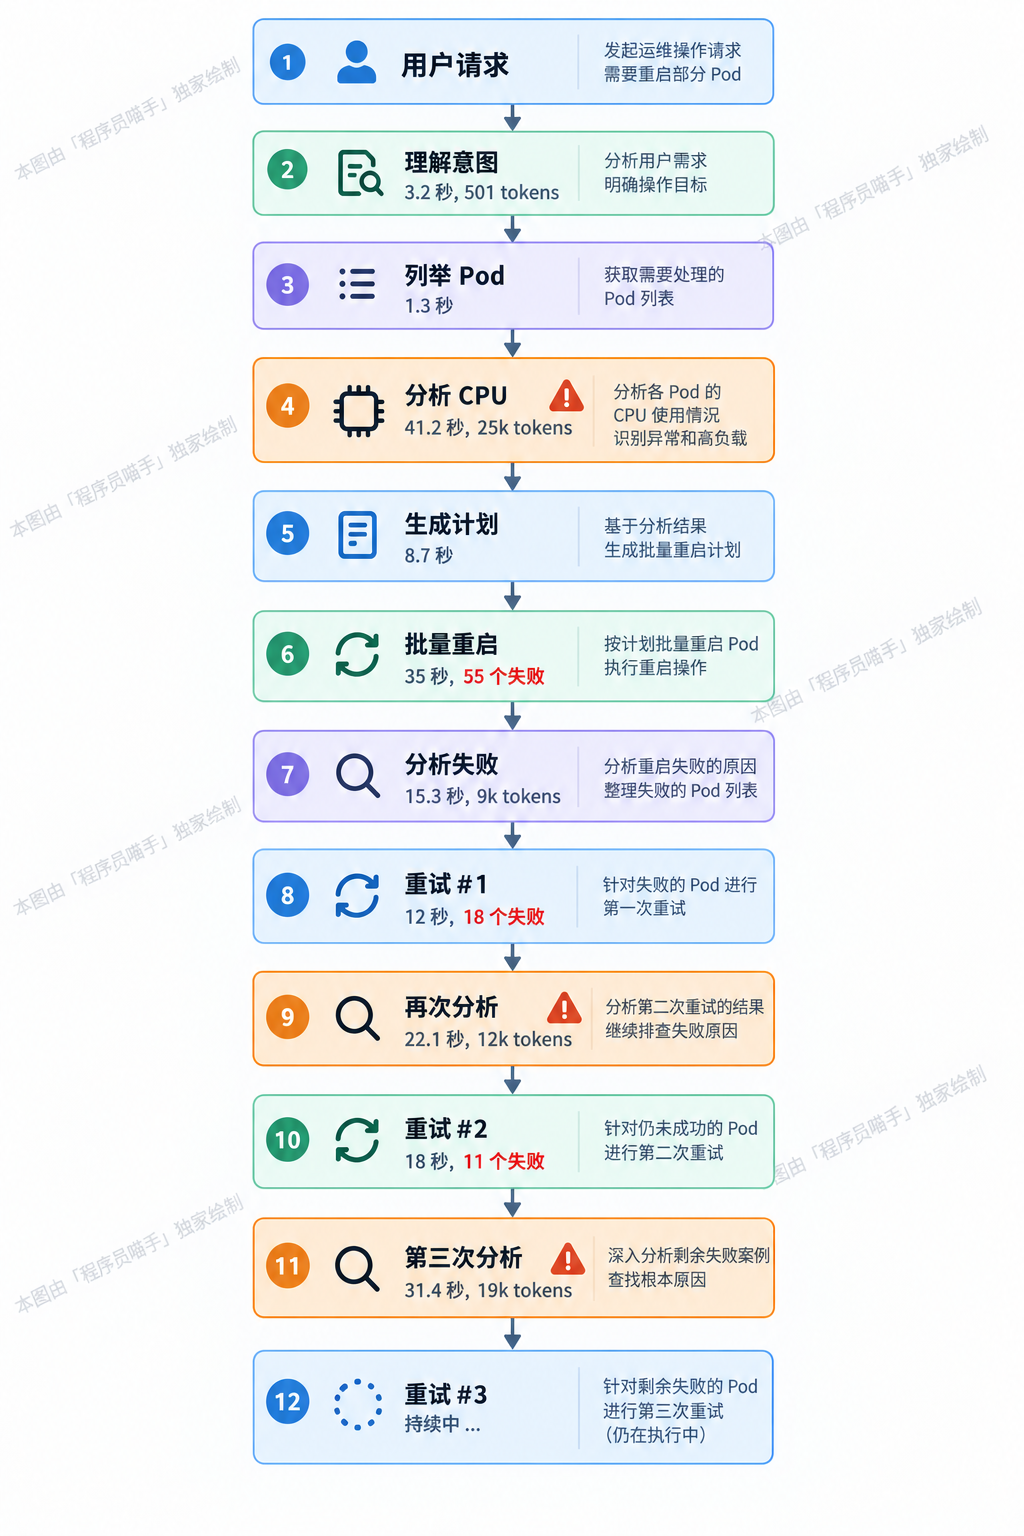
根因一眼就看出来了:
- 工具设计问题:
kubernetes_list_pods返回了完整Pod信息,导致第一次LLM推理就消耗25k tokens - 重试逻辑缺陷: Agent没有退避策略,失败后立即重试,遇到API限流后进入死循环
- 上下文累积: 每次重试都把之前的错误信息带入prompt,导致Token持续膨胀
修复方案
# 修复1: 工具只返回必要字段
def kubernetes_list_pods(namespace, filter_cpu=None):
    pods = k8s.list_pods(namespace)
    return [{
        "name": p.name,
        "cpu_usage": p.cpu_usage,
        "status": p.status
    } for p in pods if not filter_cpu or p.cpu_usage > filter_cpu]

# 修复2: 增加重试退避
@retry(max_attempts=3, backoff=ExponentialBackoff(base=2))
def tool_call_with_retry(tool, params):
    return tool.execute(params)

# 修复3: 限制上下文长度
def prepare_llm_context(history, max_tokens=4000):
    if estimate_tokens(history) > max_tokens:
        return summarize_history(history, target=max_tokens)
    return history
修复后:
- 响应时间: 159s → 8.3s
- Token消耗: 89k → 1.2k
- 成本: ¥5.67 → ¥0.08
- 成功率: 38% → 100%
五、很多人理解错了一件事
大部分人觉得Agent可观测性就是:"记录一下LLM调用,看看花了多少钱。"
错。
Agent可观测性真正要解决的问题是:
理解Agent为什么做出这个决策。
传统应用的逻辑是确定的:
if cpu > 80:
    restart_pod()
你不需要"观测"这个if条件,因为它是写死的。
但Agent的逻辑是推理出来的:
如果最后执行错了,你需要知道:
- LLM是在哪一步推理错的?
- 是Tool返回的数据有问题?
- 还是prompt没有给足够的上下文?
- 或者温度参数设置不当,导致输出不稳定?
OpenTelemetry让你能回溯Agent的"思考过程",而不只是看到最终结果。
这才是AI时代可观测性的核心价值。
六、企业应该怎么落地Agent可观测性?
不要一上来就问"我们要不要做Agent可观测性?"
先问:
"我们部署了哪些Agent?它们在做什么?"
第一步: 盘点Agent类型
先搞清楚你的环境里有哪些Agent:
| Agent类型 | 作用 | 风险等级 |
|---|---|---|
| 自动化运维Agent | 响应告警,执行预定义操作 | 高 |
| 日志分析Agent | 帮助SRE快速定位问题 | 中 |
| 知识问答Agent | 查询文档和历史事故 | 低 |
| 变更审批Agent | 分析变更风险,辅助决策 | 高 |
| 成本优化Agent | 推荐资源调整方案 | 中 |
高风险Agent优先接入可观测性。
第二步: 选择合适的接入方式
三种主流方案:
方案A: 使用框架内置支持
如果你用的是LangChain、LlamaIndex等成熟框架:
from langchain.callbacks import OpenTelemetryCallback

agent = initialize_agent(
    tools=tools,
    llm=llm,
    callbacks=[OpenTelemetryCallback()]
)
优点: 零代码接入
缺点: 只能记录框架层面信息
方案B: 手动插桩
如果Agent是自研的:
from opentelemetry import trace

tracer = trace.get_tracer(__name__)

def agent_execute(user_input):
    with tracer.start_as_current_span("agent.execute") as span:
        span.set_attribute("user.input", user_input)

        # LLM调用
        with tracer.start_as_current_span("llm.call") as llm_span:
            llm_span.set_attribute("gen_ai.system", "openai")
            llm_span.set_attribute("gen_ai.request.model", "gpt-4")
            response = llm.generate(prompt)
            llm_span.set_attribute("gen_ai.usage.input_tokens", response.usage.input)
            llm_span.set_attribute("gen_ai.usage.output_tokens", response.usage.output)

        # Tool调用
        with tracer.start_as_current_span("tool.call") as tool_span:
            tool_span.set_attribute("tool.name", "kubectl_get_pods")
            result = execute_tool("kubectl_get_pods", params)
            tool_span.set_attribute("tool.result.status", "success")

        return result
优点: 完全可控
缺点: 需要开发投入
方案C: 使用专门的LLM observability平台
如Langfuse、Helicone、Arize AI:
优点: 开箱即用,UI友好
缺点: 供应商锁定
第三步: 建立关键指标
不要试图监控所有东西,先关注这6个核心指标:
1. Agent调用量
   rate(agent_requests_total[5m])

2. 平均响应时间
   histogram_quantile(0.95, agent_duration_seconds)

3. LLM调用次数分布
   histogram(agent_llm_calls_per_request)

4. Token消耗速率
   rate(agent_tokens_total[1h])

5. Tool调用成功率
   rate(agent_tool_success_total) / rate(agent_tool_calls_total)

6. 单位时间成本
   sum(rate(agent_cost_total[1h]))
第四步: 设置合理告警
# 告警规则示例
groups:
  - name: agent_health
    rules:
      # Token爆炸
      - alert: AgentTokenSpike
        expr: rate(agent_tokens_total[1m]) > 10000
        for: 2m
        annotations:
          summary: "Agent Token usage异常"

      # 执行超时
      - alert: AgentExecutionTimeout
        expr: agent_duration_seconds > 60
        annotations:
          summary: "Agent执行超过60秒"

      # 循环调用
      - alert: AgentLoopDetected
        expr: agent_llm_calls_per_request > 10
        annotations:
          summary: "Agent可能陷入循环"

      # 成本异常
      - alert: AgentCostAnomaly
        expr: rate(agent_cost_total[5m]) > 10
        annotations:
          summary: "5分钟成本超过10元"
第五步: 建立故障分析流程
当Agent出问题时:
第六步: 持续优化
每周review这些数据:
Agent效率看板
本周Agent调用: 23,847次
平均响应时间: 8.3s (↓ 2.1s vs上周)
P95响应时间: 24.7s (↓ 8.3s vs上周)
总Token消耗: 2.3M (↑ 12% vs上周)
总成本: ¥187 (↑ 12% vs上周)
Tool成功率: 94.2% (↑ 3.1% vs上周)

需要优化的Top 3场景:
1. 多Pod重启操作 (平均45s, 12k tokens)
2. 全量日志分析 (平均67s, 23k tokens)
3. 复杂告警关联 (平均38s, 8k tokens)
七、一份可以带走的checklist
在部署Agent可观测性之前,先确认这8个问题:
□ 我们清楚有哪些Agent在运行?它们的作用和风险等级?

□ Agent调用的LLM API是否已经接入trace?

□ Agent执行的Tool调用是否记录了参数和返回值?

□ 是否能追踪单次Agent请求的完整执行路径?

□ 是否建立了Token消耗和成本的监控?

□ 是否设置了Agent执行超时、循环、成本异常的告警?

□ 当Agent出错时,是否能回溯它的推理过程?

□ 是否定期review Agent的性