
9月22日,全球AI大模型排行榜前30
1
引言
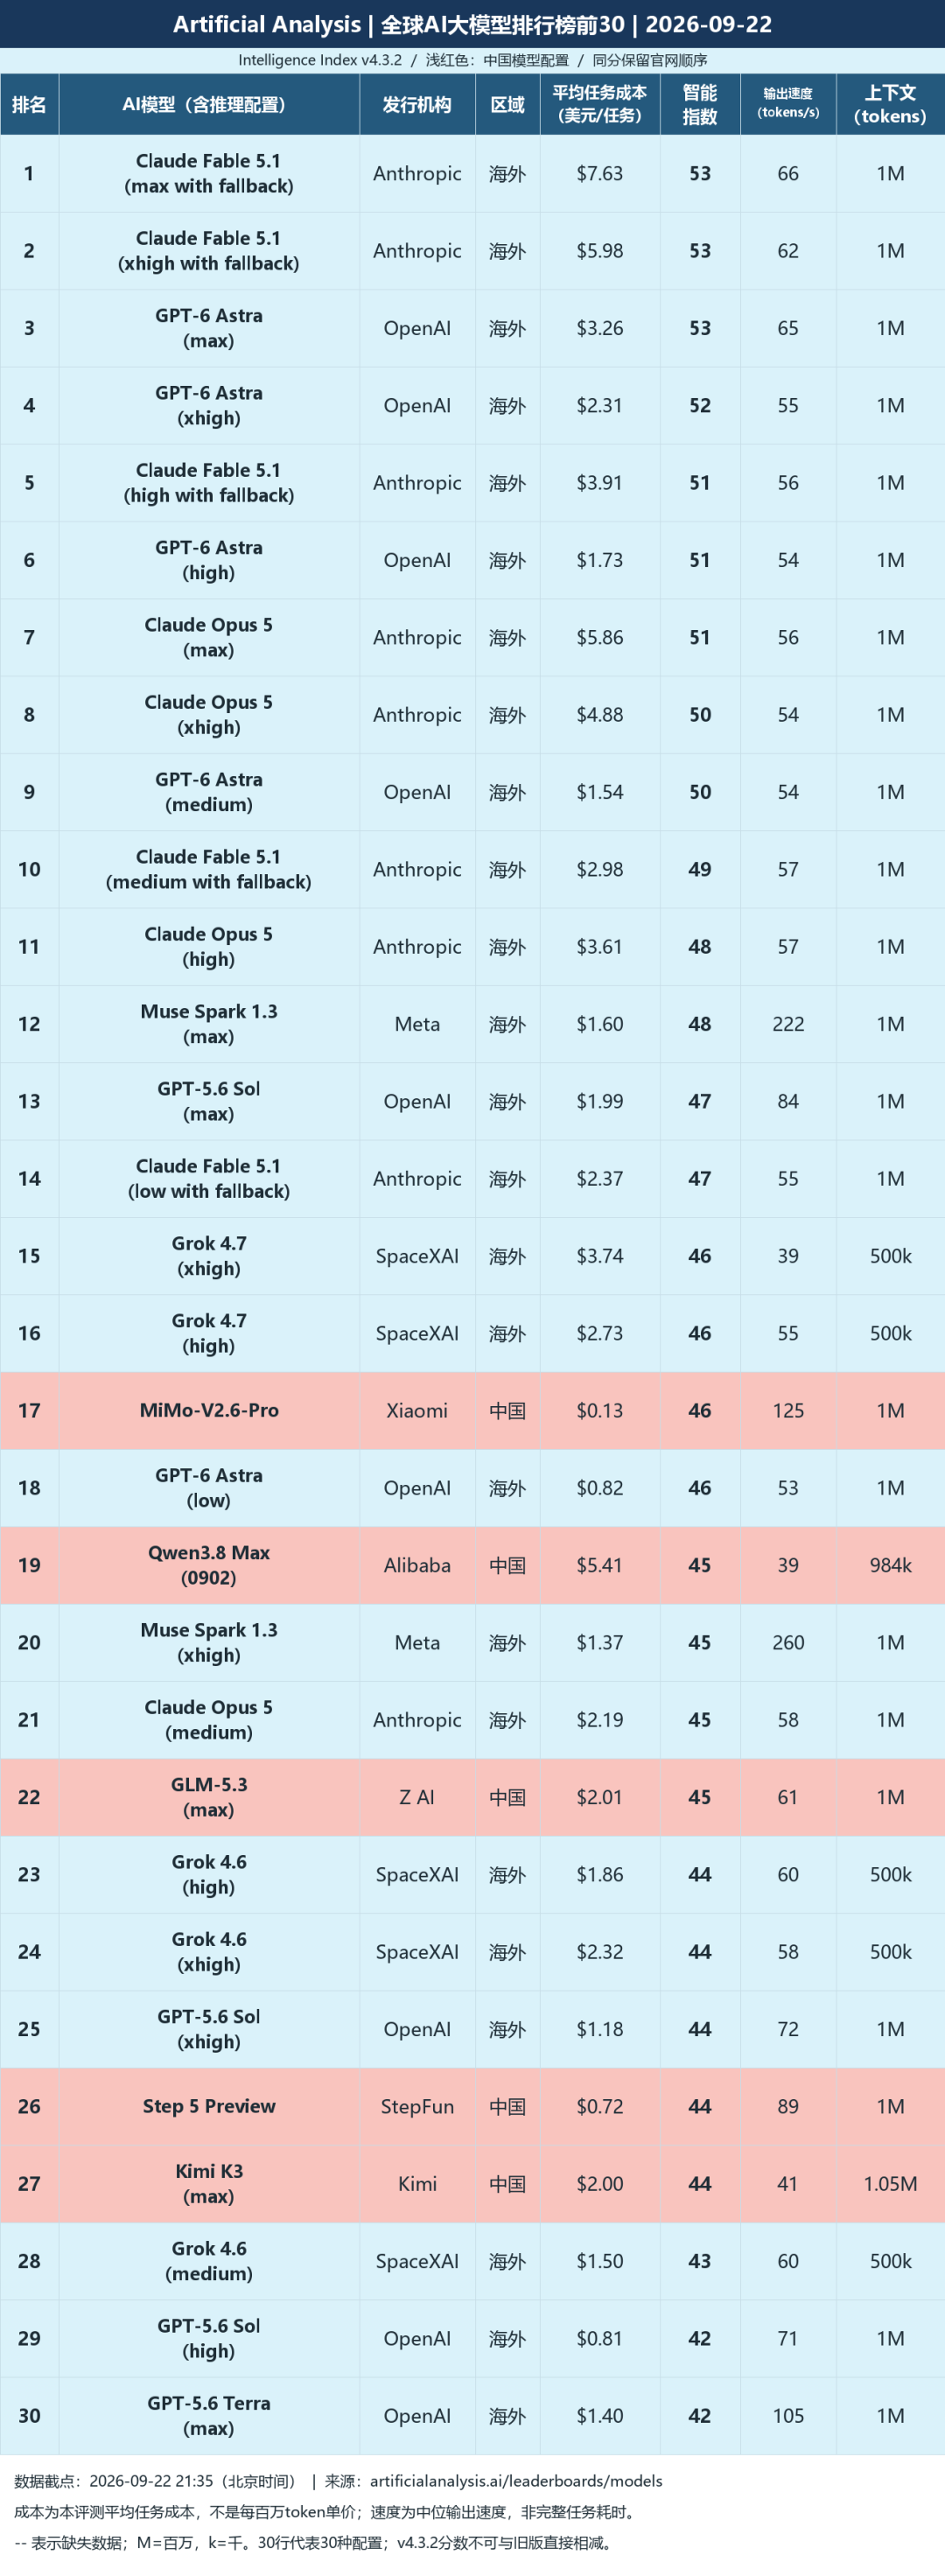
9月22日,Artificial Analysis榜单前三位仍是Claude Fable 5.1的max、xhigh配置和GPT-6 Astra(max),均为53分。本期中段多了几张新面孔:Grok 4.7两个档位进入前16,小米MiMo-V2.6-Pro排第17,Step 5 Preview排第26。完整榜单如下,浅红色标出中国模型配置。
2
Top 30完整榜单
3
今天有哪些信息值得注意?
MiMo排第17,任务成本只有0.13美元
小米MiMo-V2.6-Pro拿到46分,平均每项评测任务成本0.13美元,中位输出速度125 tokens/s,上下文长度100万tokens。这几列放在一起,比单独一个“第17名”更值得看。相关结果见[MiMo官方评测页](https://artificialanalysis.ai/models/mimo-v2-6-pro)。
在本期前30中,它的平均任务成本最低。同为46分的GPT-6 Astra(low),任务成本为0.82美元;按当前表格计算,MiMo约为它的16%。当然,相同的综合分数并不意味着两者在每项任务上都一样。
对需要批量处理材料的人,这提供了一个值得测试的候选。但0.13美元是Artificial Analysis评测任务的平均花费,不是“处理一篇论文”的报价,更不能据此推算所有科研任务的成本。
Grok 4.7:两档都是46分,high更省
Grok 4.7的xhigh排第15,high排第16,显示分数都是46。xhigh每项任务3.74美元,high为2.73美元,后者低约27%;输出速度分别为39和55 tokens/s。两个档位的上下文窗口均为50万tokens。参见[Grok 4.7评测页](https://artificialanalysis.ai/models/grok-4-7)。
这次表格给出的信号很具体:增加推理预算,并没有让xhigh的显示总分超过high,却提高了成本。同分项沿用官网顺序,因此第15和第16的先后,不应被解读成明确的能力差距。
如果自己的任务对推理深度很敏感,仍需分别测试两个档位;如果尚未测到xhigh的额外收益,就不必只因档位更高而默认选它。
Qwen与Step的新结果,定位并不相同
Qwen3.8 Max(0902)排第19,45分,平均任务成本5.41美元,输出速度39 tokens/s,上下文98.4万tokens。官方日志在9月15日记录了这一版本的评测结果。这里特意保留“0902”,避免与上一期未带版本后缀的Qwen3.8 Max混为一谈。参见[Qwen评测页](https://artificialanalysis.ai/models/qwen3-8-max)。
Step 5 Preview排第26,44分,平均任务成本0.72美元,输出速度89 tokens/s,上下文100万tokens。它与当前Qwen版本相差1个显示分数,任务成本则低得多。参见[Step评测页](https://artificialanalysis.ai/models/step-5)。
仅凭这1分,不能断言哪款更适合论文分析。对预算有限的读者,Step值得加入候选;对已有Qwen工作流的读者,更需要确认自己实际调用的版本,再谈迁移或升级。
数据来源:Artificial Analysis LLM Leaderboard
https://artificialanalysis.ai/leaderboards/models
评测方法:Artificial Analysis Intelligence Index v4.3.2
https://artificialanalysis.ai/methodology/intelligence-benchmarking
数据截点:2026年9月22日