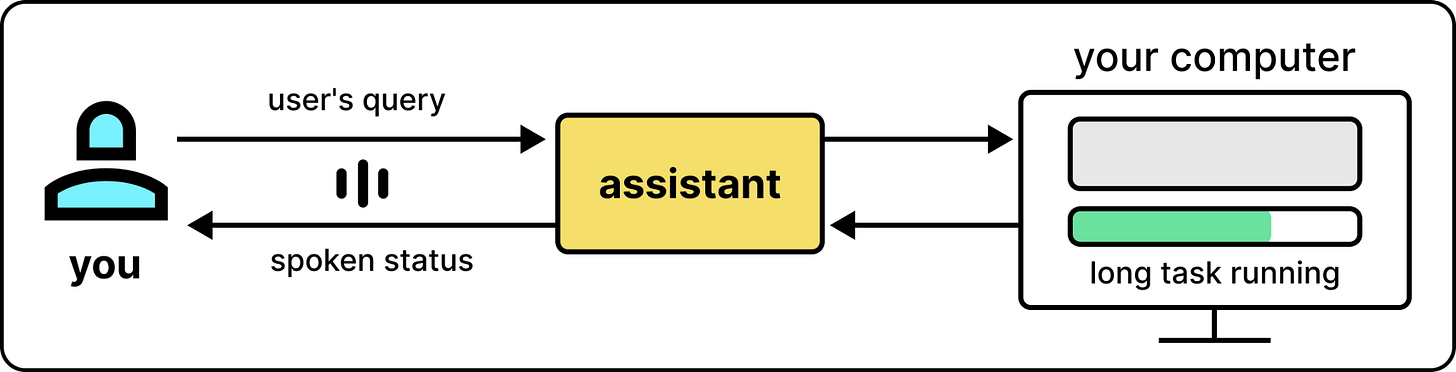
OpenAI 是如何构建 GPT-Live 的
当性能成为关键因素时,该如何优化 AI?又该如何将 AI 应用于性能领域,使其比以往任何时刻都更高效、更便捷?这正是在 P99 CONF 上,来自各行业的 3 万名工程师将要共同探讨的核心议题。以下是部分重磅演讲内容预览
Lovable 中的沙盒极限操作:在 1 秒内为每个提示词创建沙盒
自治性能代理:Netflix 的生产实践案例
构建面向 AI 智能体的极速开源基础设施的经验教训
为集群赋能 AI:大规模性能工程的 AI 实践
管理 5000 亿+文件以应对 AI 工作负载
利用 AI 优化缓存算法的方法
额外福利:注册参会者可立即获得 O'Reilly 完整图书库的 30 天访问权限,参会者还有机会赢取 500 份限量周边礼包之一。
如果你使用过语音助手,很可能经历过这种令人沮丧的情况:你正在与系统对话,刚停顿片刻寻找合适的词汇,它就开始插话了。为了继续表达,你不得不打断它。这种体验之所以普遍,是因为大多数语音模型要么处于“听”的模式,要么处于“说”的模式,无法同时做到。
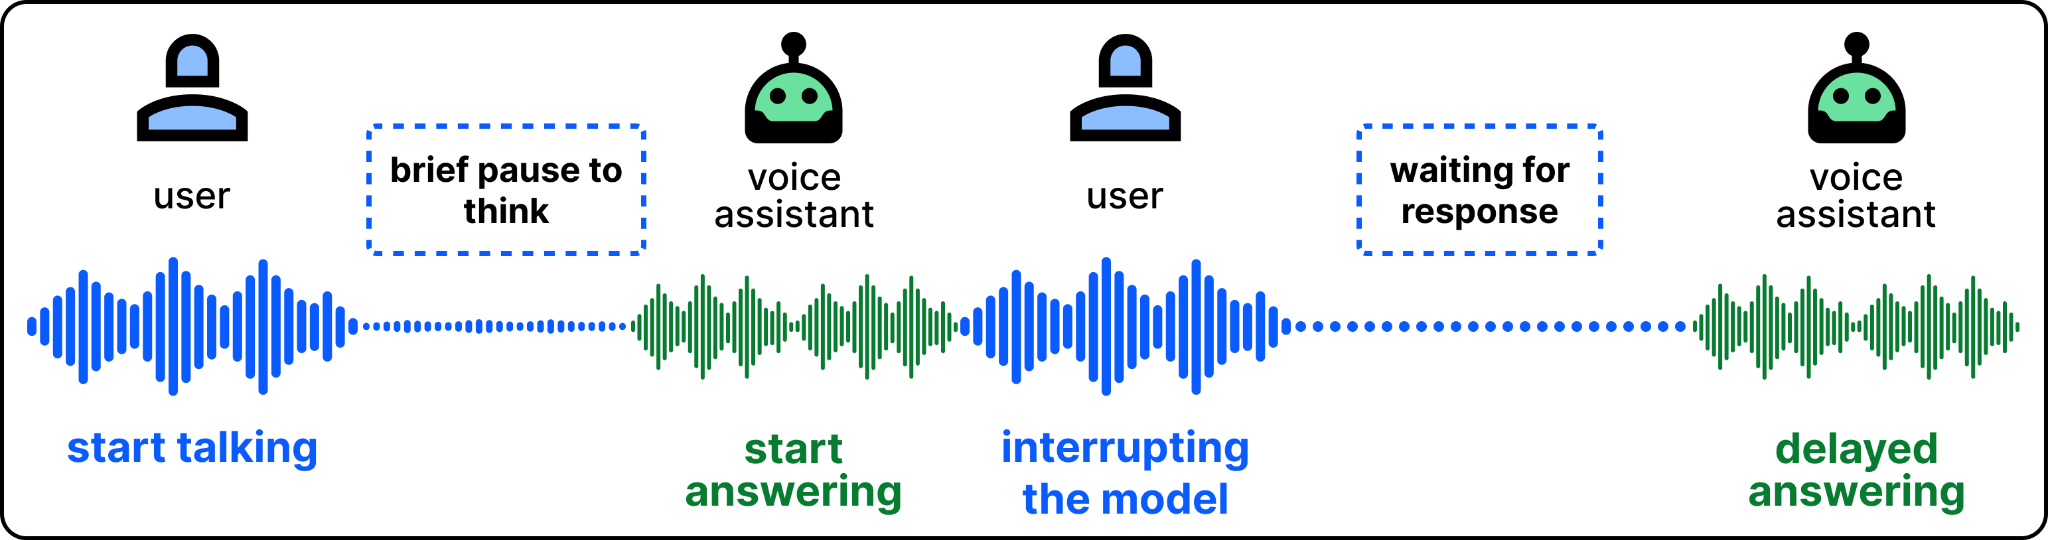
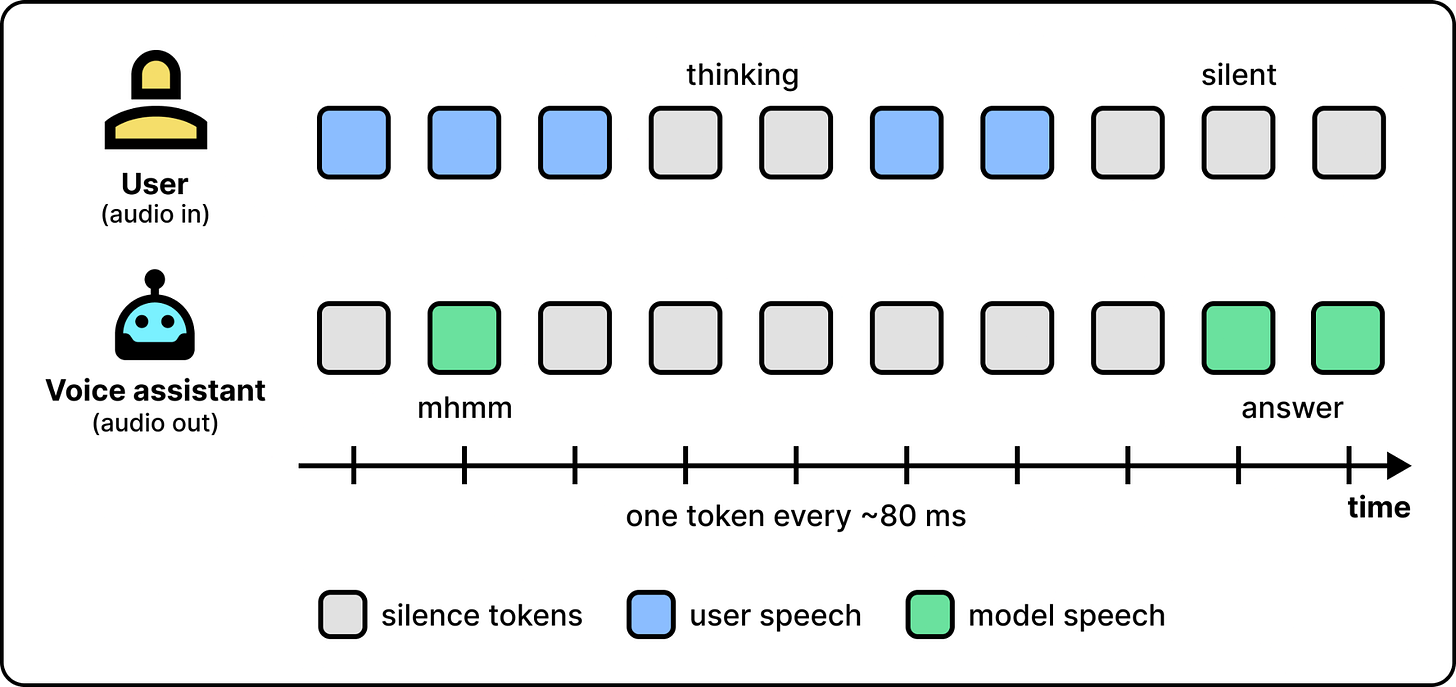
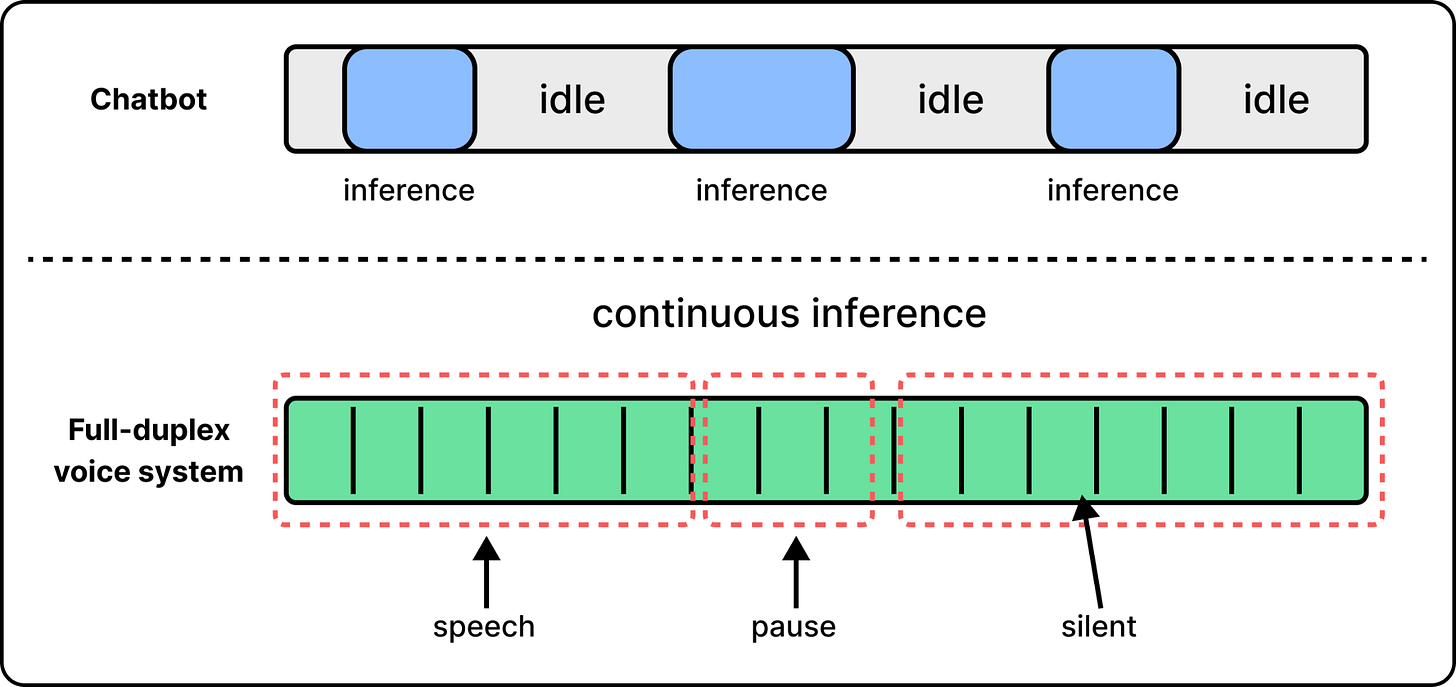
像 OpenAI 的 GPT-Live-1 这样的新一代语音模型改变了这一现状,它们能够边听边说。模型会持续判断当前应该保持安静、进行打断还是开始说话。这种机制让对话流程更加自然,大幅减少了非预期的打断。
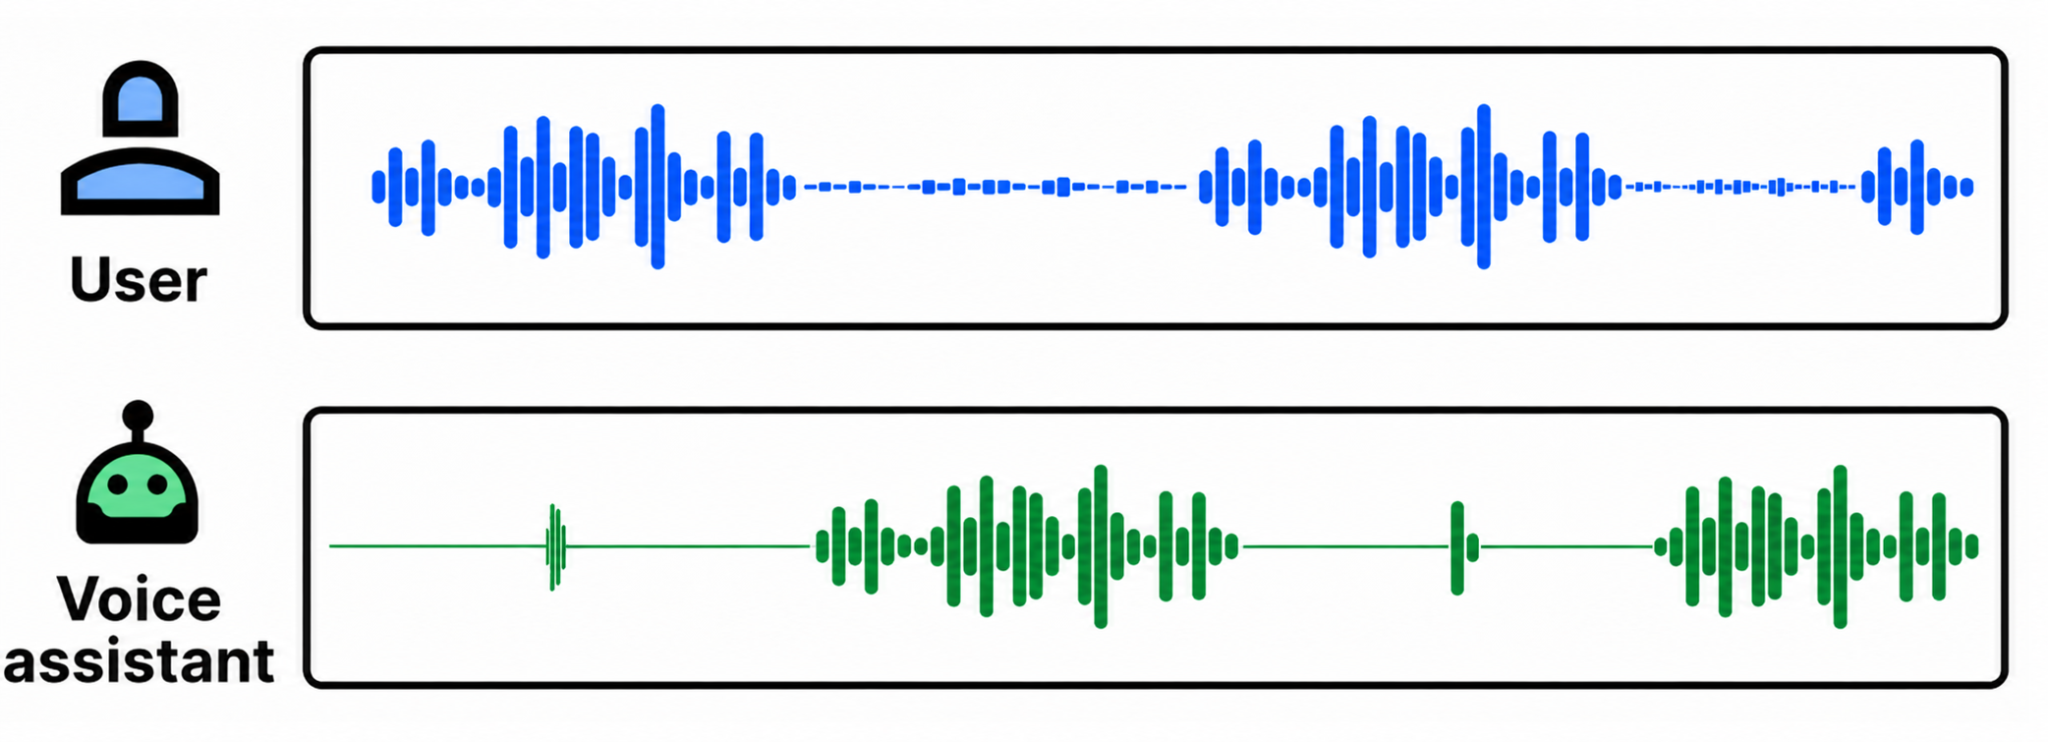
底层来看,这些系统将新一代语音模型架构与为低延迟优化的服务系统相结合。为了理解其端到端的工作原理,我们采访了 GPT Voice 团队的工程师 Zahan Malkani 和 Justin Uberti(WebRTC 的创造者)。感谢他们与我们分享这些细节。
在这篇文章中,你将会了解到:
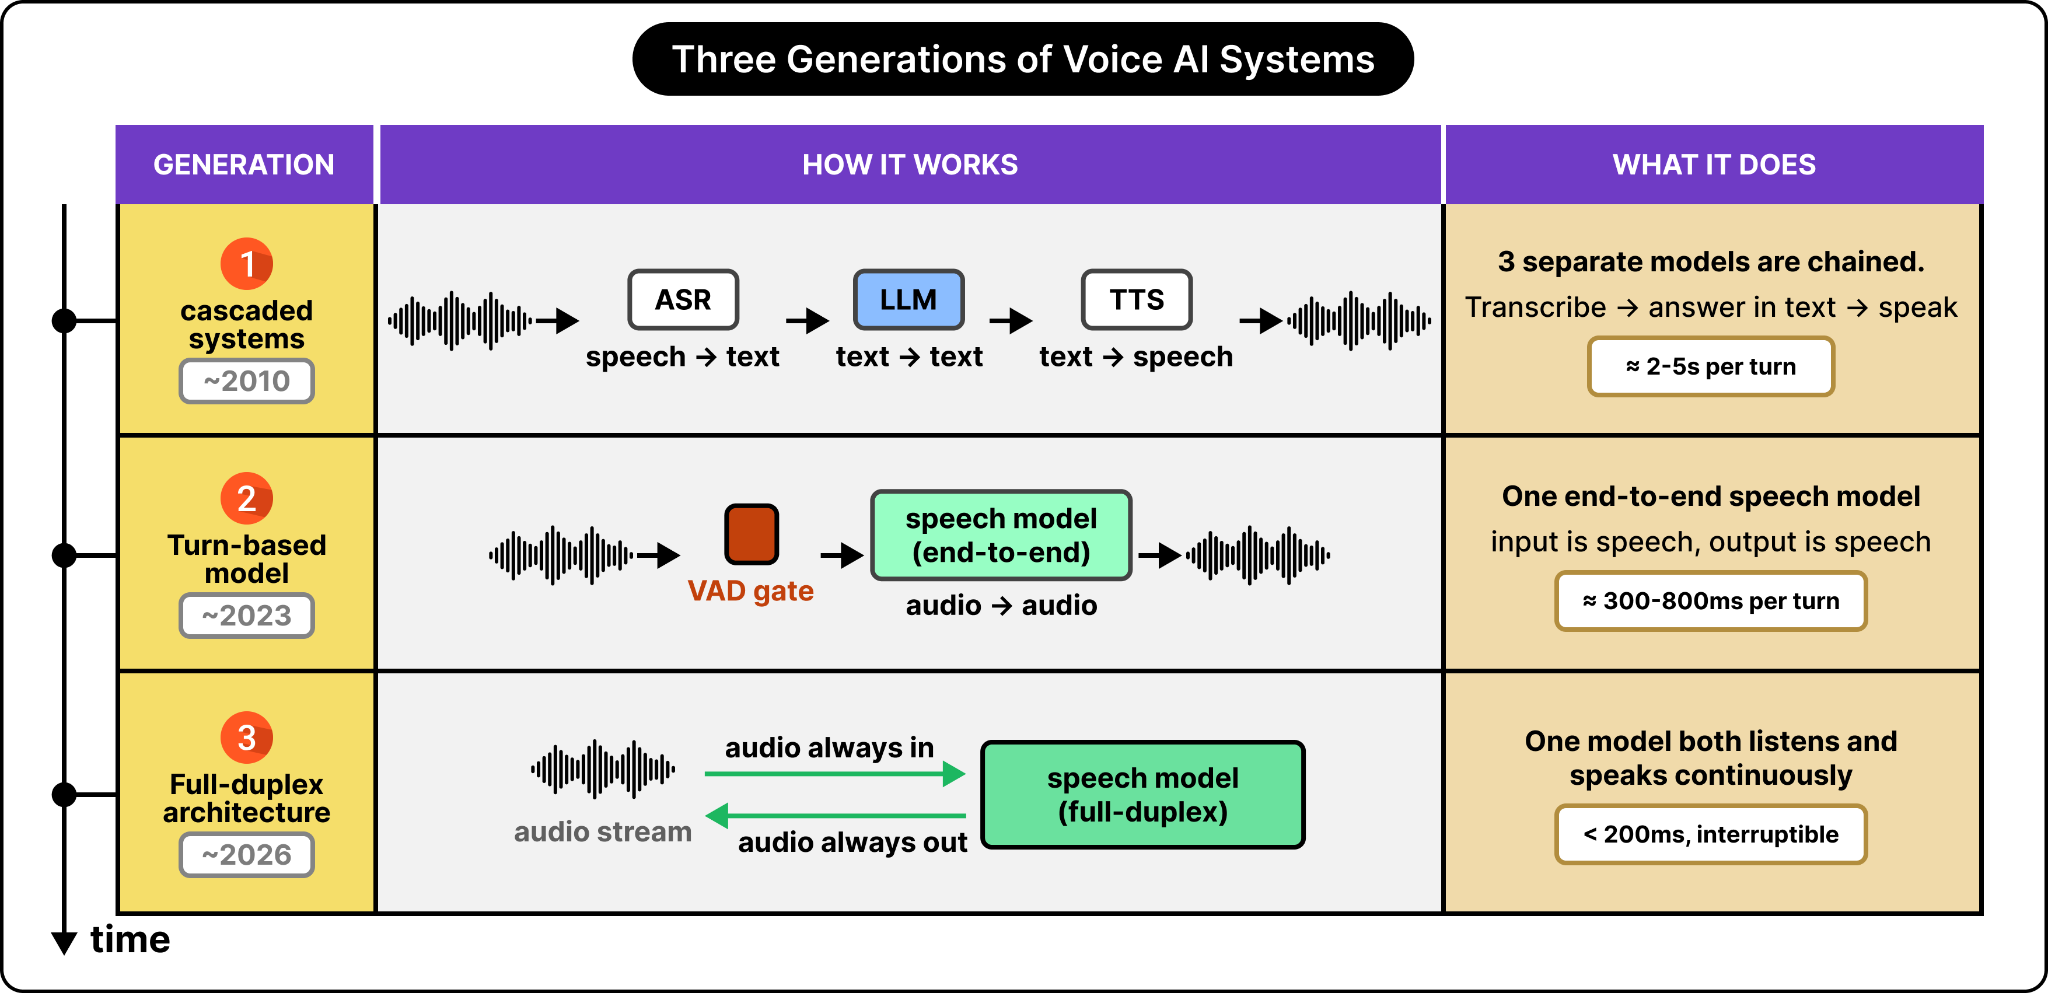
三代语音系统,包括级联管道、轮询式端到端模型和全双工模型
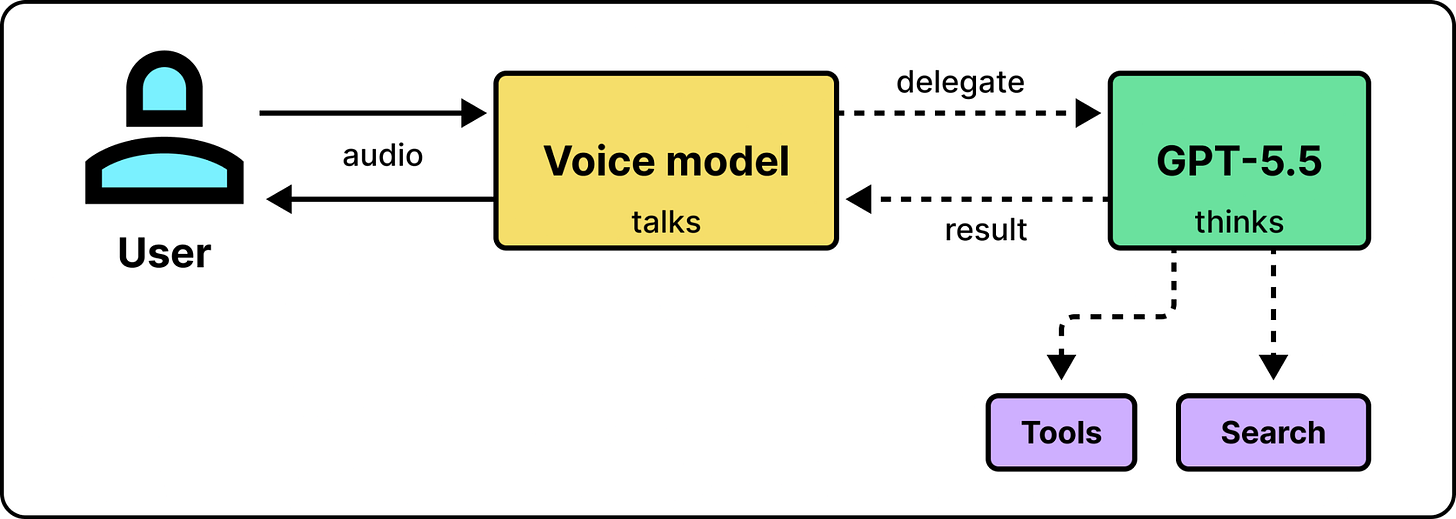
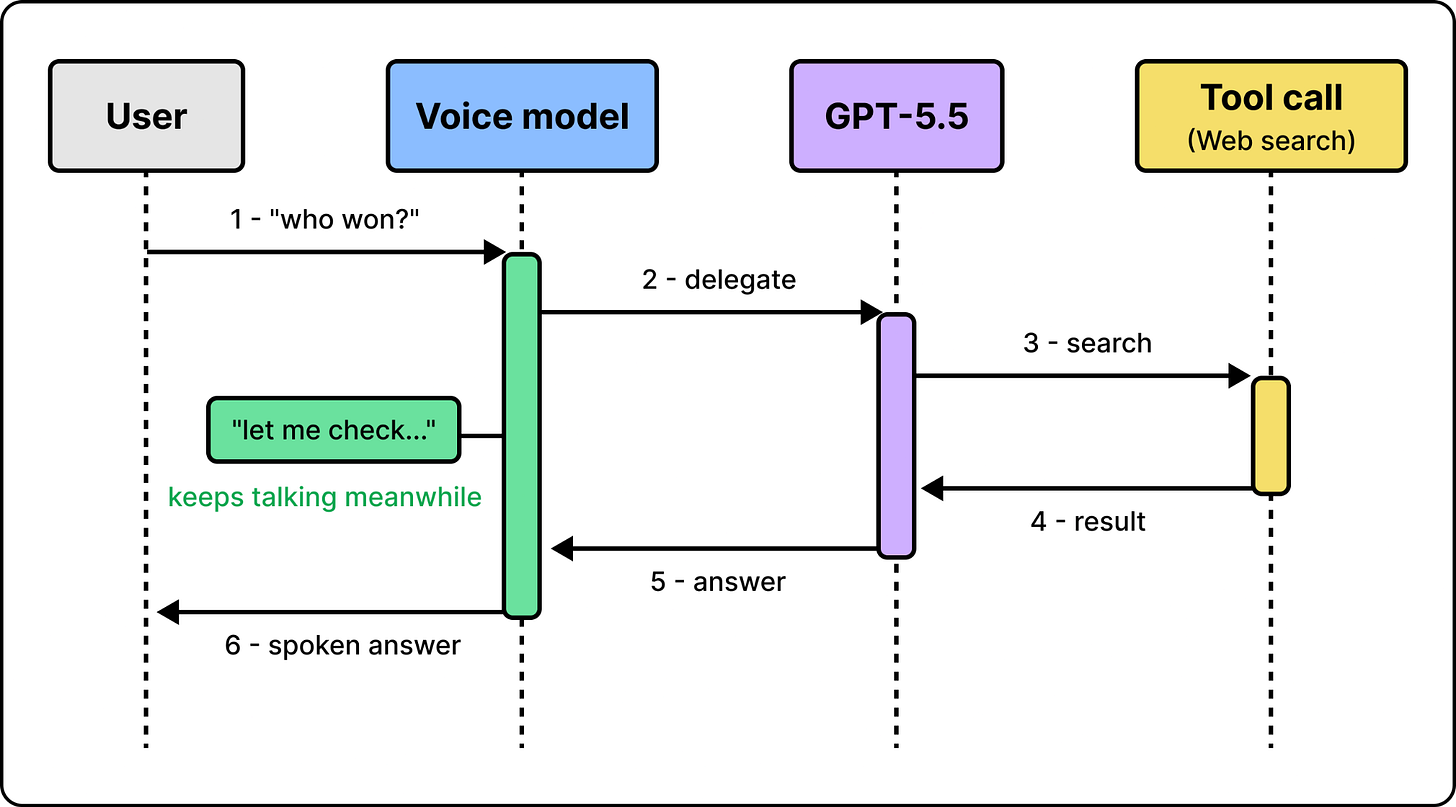
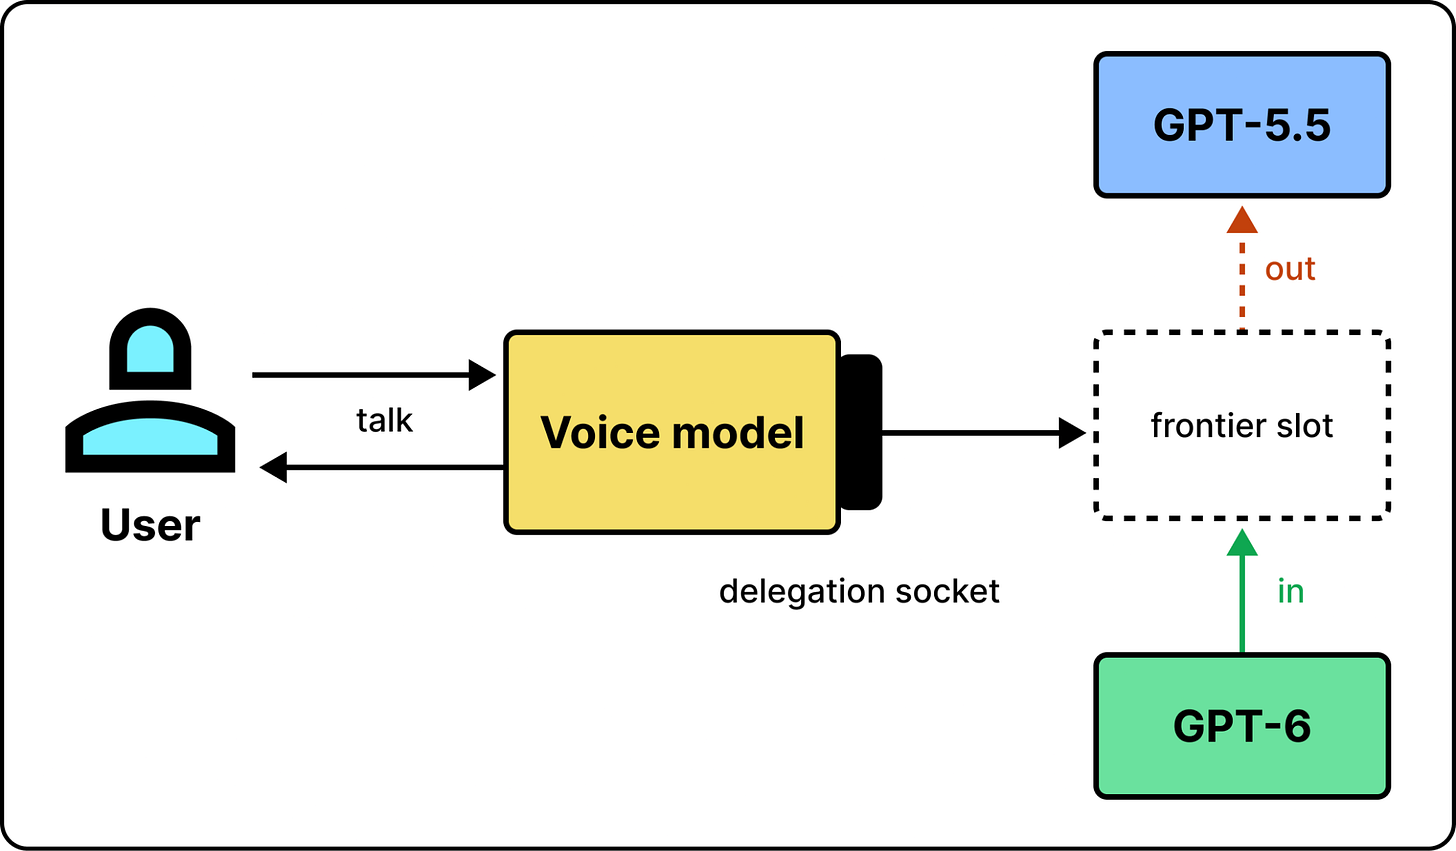
将思考与说话解耦,这是 GPT-Live 的核心思想
服务系统的工程实现,包括实时路径和异步路径
全双工语音系统中评估方式的不同之处
构建实时系统的工程经验以及语音技术的未来方向
构建并扩展胜利的 AI 智能体策略(赞助)
把 Agent 部署上线不难,难的是让它们长期保持可靠、可控并持续改进——大多数企业 AI 项目正是卡在了这一步。
顶尖团队是怎么做的?他们采用 Agentic Operating Model(AOM,智能体运营模型),这是一套循序渐进的框架,用来对齐人员、流程和技术,让企业级 Agent 在规模扩大的同时不断进化。
在 LangChain 的最新指南中,你将了解到:
为什么 AI Agent 的故障模式与传统软件不同
覆盖 Agent 全生命周期工程技术栈
如何从“构建并部署”转向“运营并持续改进”
语音系统的三代架构
语音系统的输入是用户的音频,输出是播放给用户的音频回复。虽然输入输出始终是音频,但中间的处理过程取决于系统设计。语音系统经历了三代架构:
级联式设计
基于回合的 End-to-End 架构
全双工架构
下面逐一详细介绍。
1. 级联式设计
级联式设计将三个独立模型串联起来:先用自动语音识别(ASR)模型把用户语音转成文字,再由 LLM 生成文字回复,最后由文字转语音(TTS)模型朗读给用户。
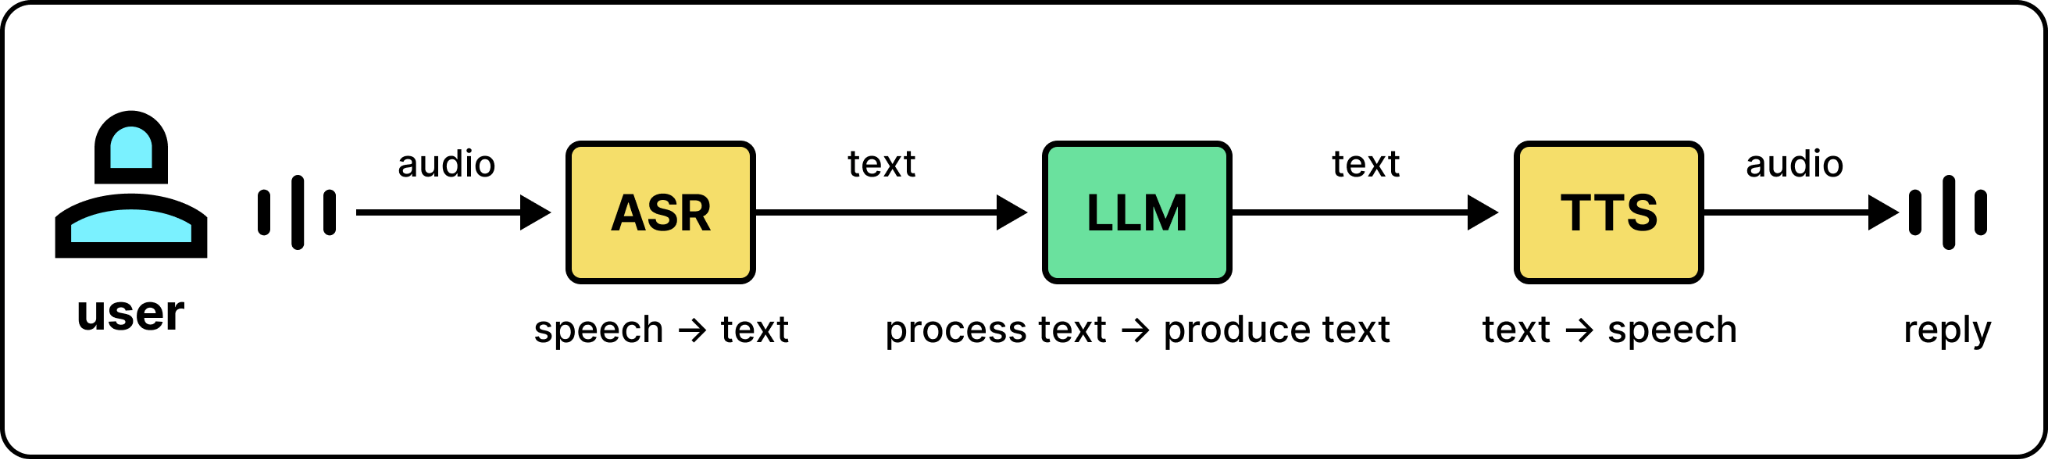
该设计中的每个模型都专注于其擅长的任务。ASR 擅长将语音转换为文本,它不具备 LLM 那样的知识,因此只负责语音转写。随后,LLM 利用其能力理解用户查询并生成相应回复。最后,当 LLM 输出文本后,TTS 模型仅将其合成为听起来自然的语音。
级联设计在实践中可行,但存在两个主要问题。首先是信息丢失。LLM 只能看到文本转录,因此语调、情感等声音信息对模型而言是不可见的。
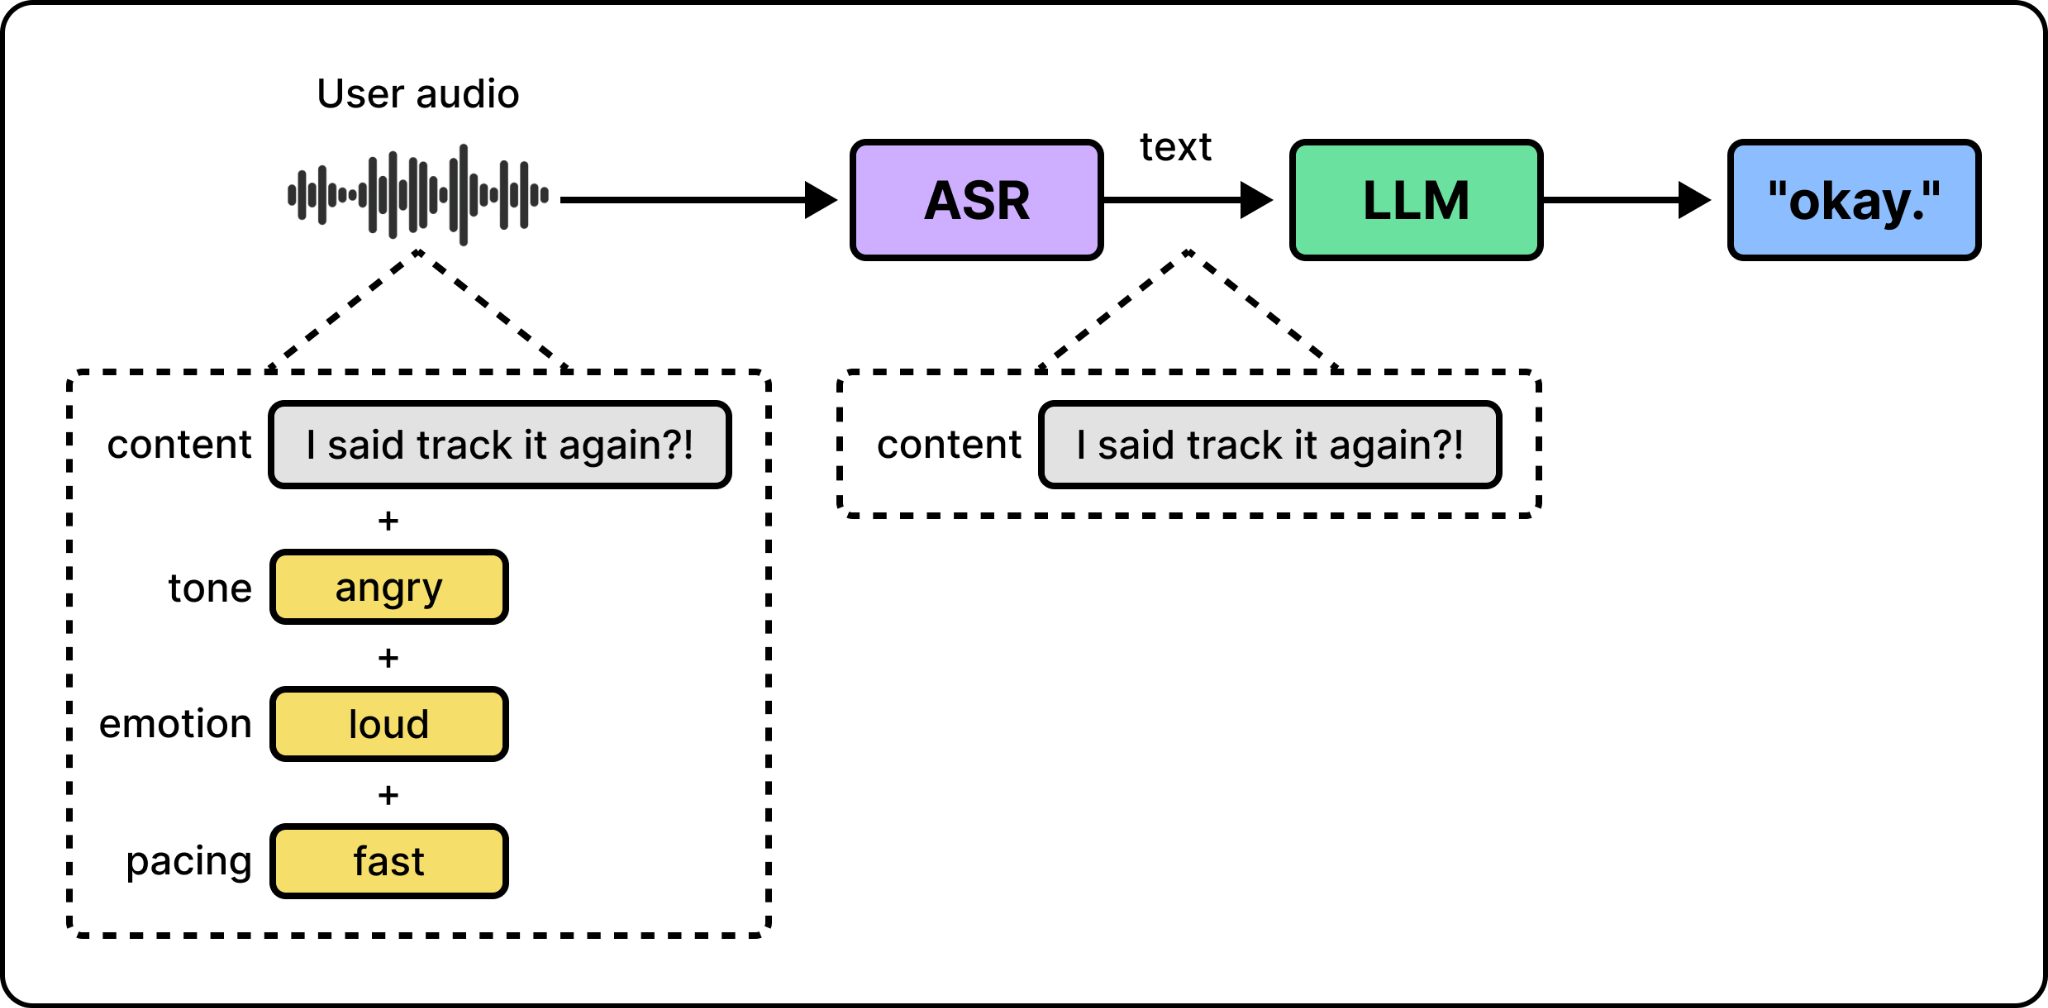
第二,系统复杂且延迟高。由于三个阶段是串行执行的,它们的延迟会叠加,用户必须等待所有阶段完成才能获得结果。此外,运行三个模型意味着需要构建、部署和扩展三套独立系统,实际操作中非常复杂。
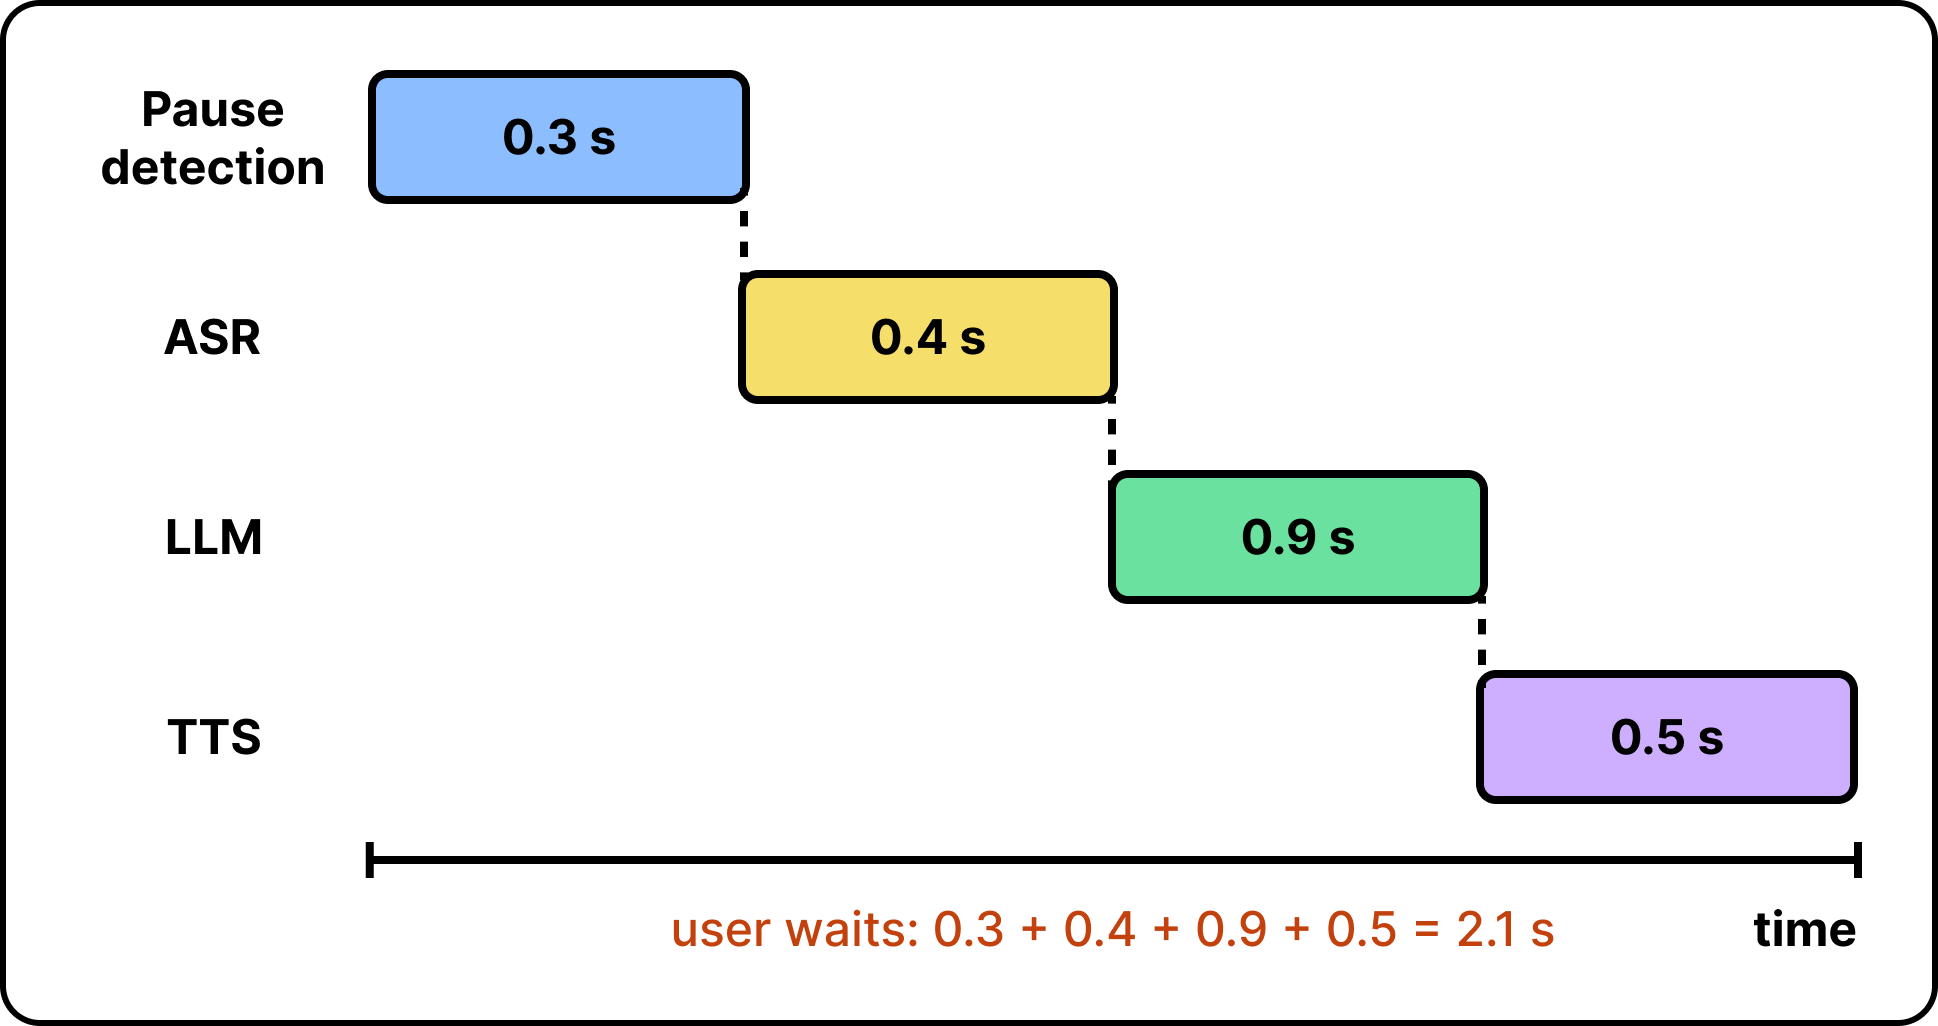
为了克服上述局限,第二代语音系统应运而生:基于轮次的语音到语音模型(turn-based speech-to-speech models)。
2. 基于轮次的语音到语音模型
第二代系统引入了一种端到端语音模型,这是一个单一模型,专门训练用来以音频为输入,直接输出音频。
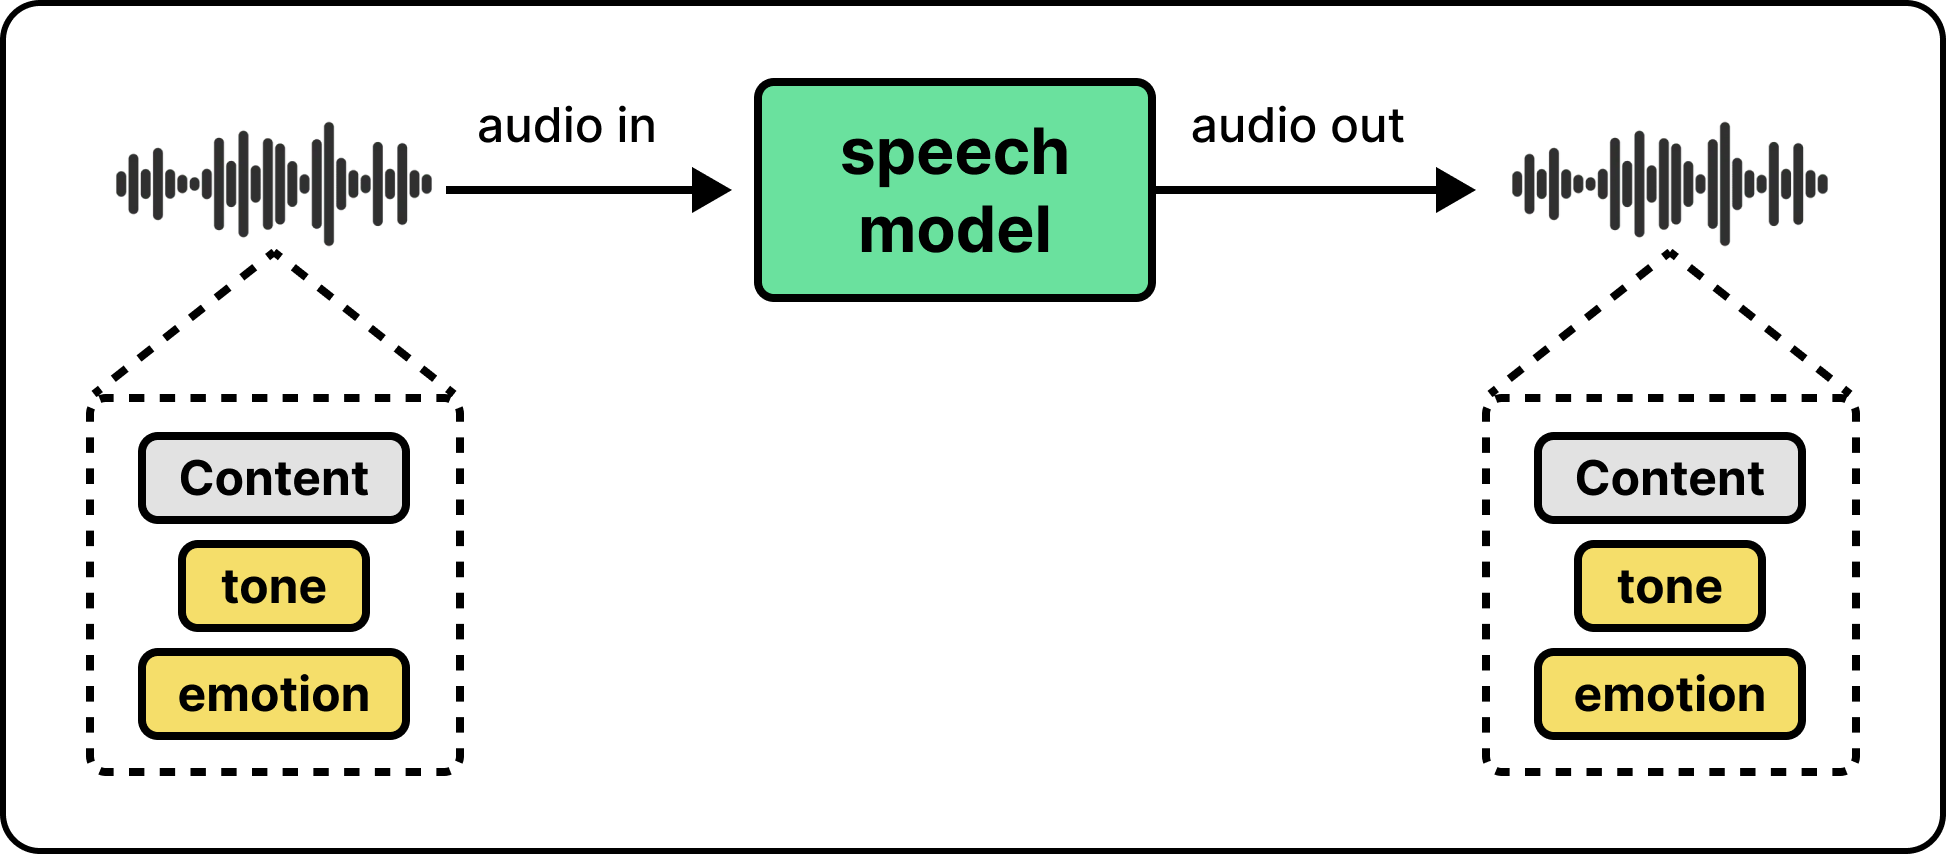
这种设计解决了级联系统的核心缺陷:由于模型直接处理音频,它能够充分感知并利用语音中的韵律信息。
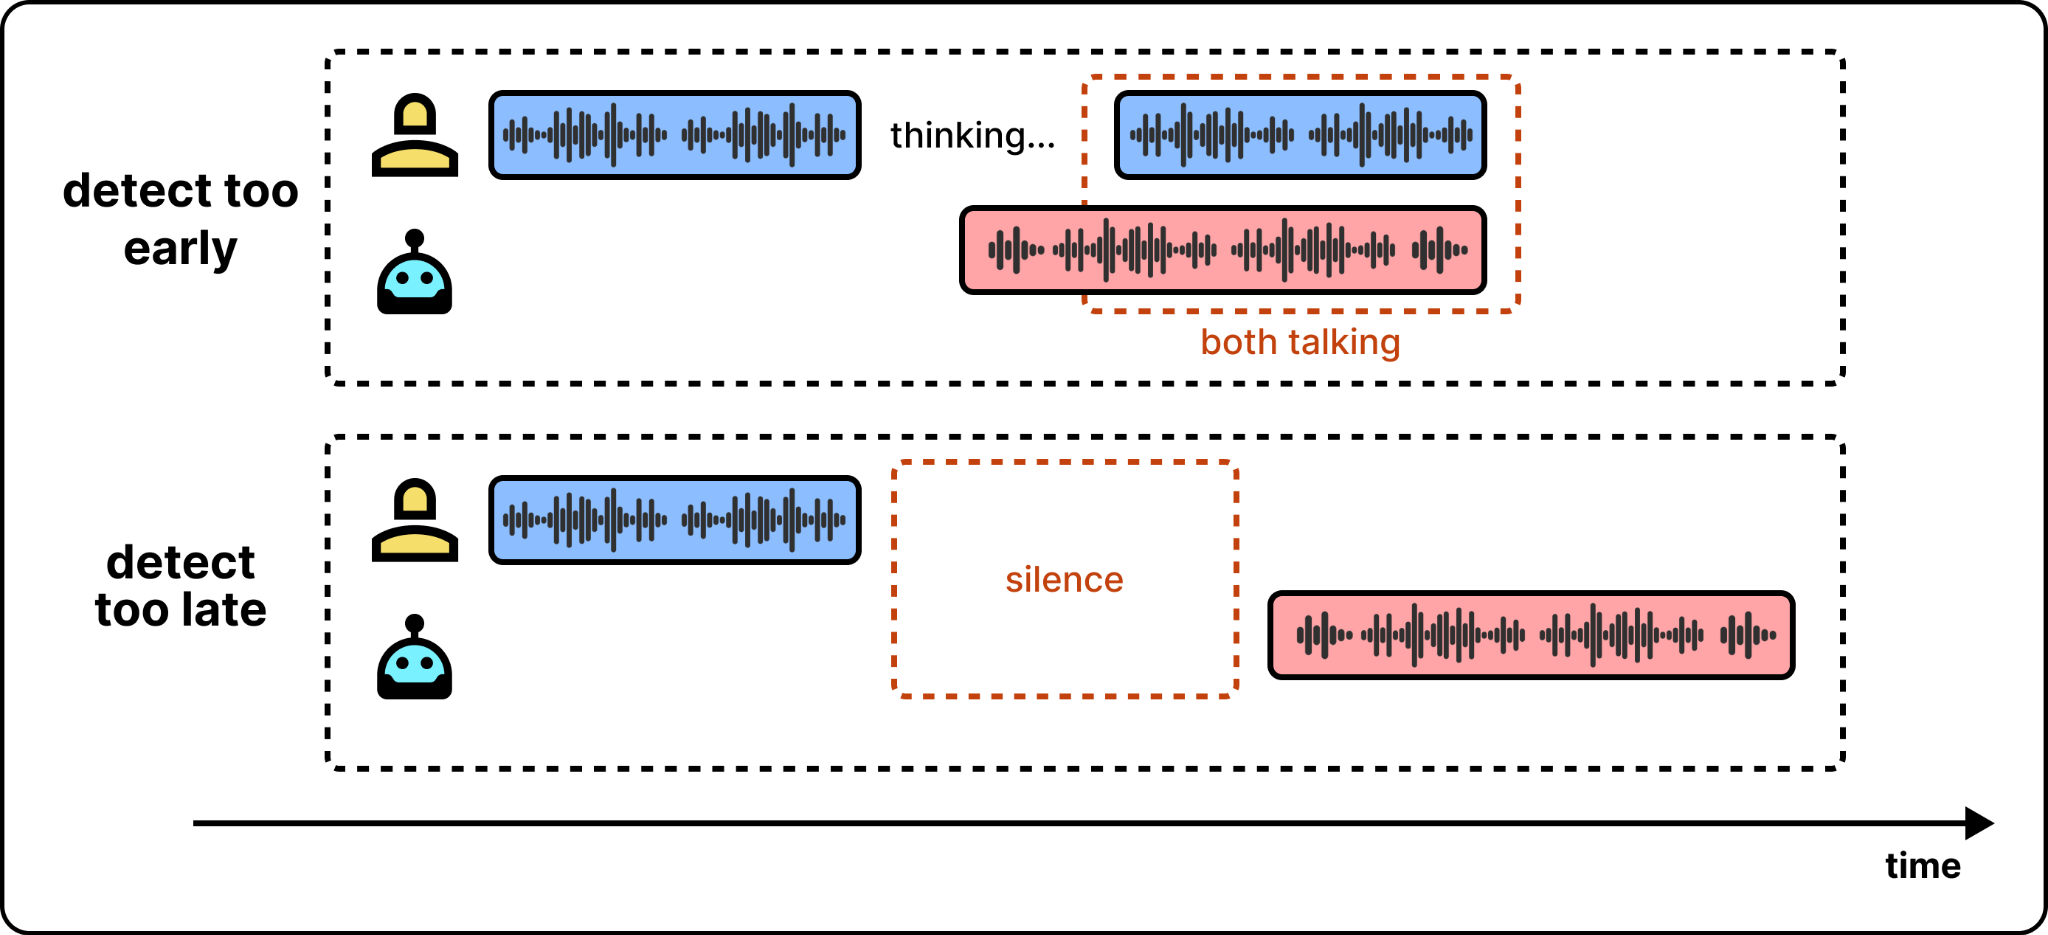
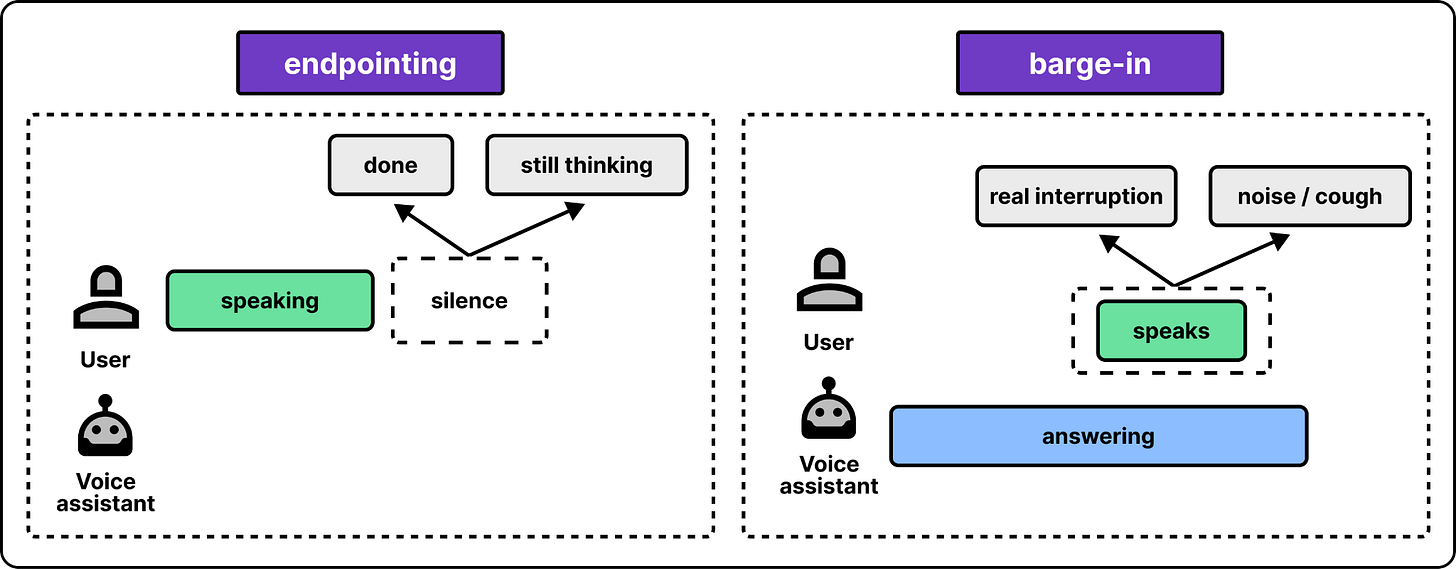
尽管这是一个重要改进,但交互方式仍然基于轮次。系统中仍有一个小型的“轮次检测器”(turn detector),由它来判断用户是否说完,之后主语音模型才开始工作。轮次检测器并非新概念,级联架构中的停顿检测步骤就是同一个组件。两代系统都依赖它,而这种基于轮次的设计正是交互显得不自然的主要原因。
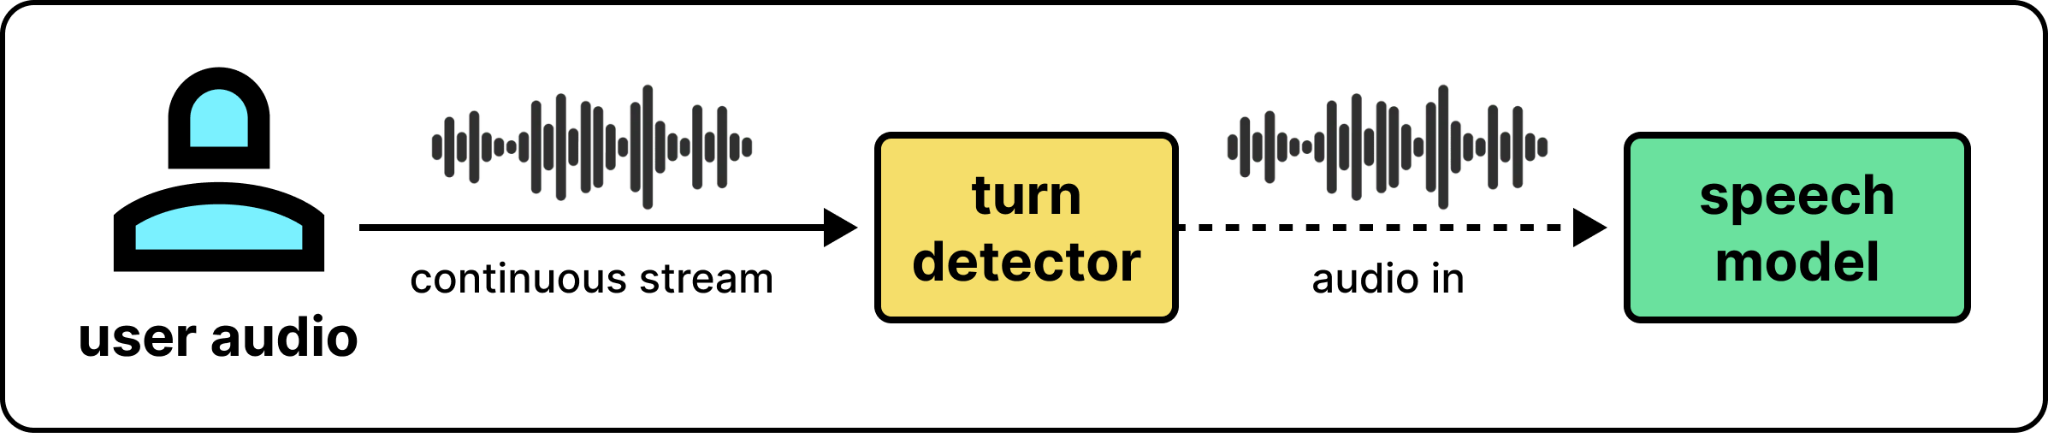
检测器的任务相当棘手:判断得太早,会在用户话说到一半时打断;判断得太晚,用户又会遇到尴尬的停顿。打断处理也面临同样的难题。当用户在语音系统说话中途插话时,需要一套独立的机制来停止音频并清空缓冲区。如果打断检测太敏感,背景噪音就可能触发误打断;如果太保守,打断响应就会变慢、显得迟钝,甚至完全漏掉“嗯”“对”这类简短的插话。Justin 认为,正是这套机制决定了早期语音系统为什么听起来不自然。