
使用 OpenTelemetry 实现 vLLM 的监控与可观测性
vLLM 是一个需要自己部署的推理服务器,通过 OpenAI 兼容的 API 提供模型服务。它有两种健康上报方式:HTTP 端点上的 Prometheus 指标,以及每个请求的 OpenTelemetry trace。本指南会把两者都发送到 SigNoz。
这些指标能回答一些只有服务器自己才知道答案的问题:GPU 每秒能产出多少 token?键值缓存(存放活跃请求注意力状态的内存池)占用有多满?队列里有多少请求在等待?
这是服务端的遥测数据。LLM observability 中描述的 gen_ai.* span 来自调用模型的应用侧,而 vLLM 上报的是服务器本身的行为。两者互为补充,大多数团队会同时采集。
如果你用的是自托管的 SigNoz?大部分步骤都一样,只需按 Cloud to Self-Hosted 的说明修改 endpoint 并移除 ingestion key 请求头。
前提条件
- 一个可以重启的 vLLM 服务器
- 一个能访问 vLLM 主机的 OpenTelemetry Collector,参见 Install the OpenTelemetry Collector
- 一个 SigNoz 实例(Cloud 或 Self-Hosted)
将 vLLM 指标发送到 SigNoz
第 1 步:确认指标端点
vLLM 在与 API 相同的端口上的 /metrics 提供 Prometheus 指标,无需任何参数即可开启。先确认该端点可以正常响应:
curl -s http://localhost:8000/metrics | head如果你改过端口,请用实际端口替换 8000。
第 2 步:向 Collector 添加抓取任务
把下面的抓取任务追加到你现有的 otel-collector-config.yaml 中,不要替换整个文件。
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: vllm
          scrape_interval: 30s
          static_configs:
            - targets: ['<vllm-host>:8000']
          metric_relabel_configs:
            # Drop the Prometheus _created timestamp series, which carry no signal.
            - source_labels: [__name__]
              regex: '.*_created'
              action: drop
请确认以下参数:
<vllm-host>:运行 vLLM 的机器主机名或 IP 地址。
保留 metric_relabel_configs 块。vLLM 在每个 counter 和 histogram 旁边都会暴露一个 _created 时间序列,记录指标首次被观测到的时间。在默认服务器配置下,这 111 条序列占总共 405 条暴露序列的比例不小。丢弃这些序列可去除约四分之一的采集数据,且不会丢失任何信号。
接着,将接收器添加到你的指标管道中:
otel-collector-config.yamlservice:
pipelines:
metrics:
receivers: [prometheus] # 在你的现有 receivers 列表中追加 prometheus
processors: [batch]
exporters: [otlphttp]步骤 3:重启 Collector
重启 Collector 以加载新的抓取任务,然后监控日志中的抓取错误。
VMDockerKubernetesWindowsCopysudo systemctl restart otelcol-contrib
sudo journalctl -u otelcol-contrib -f如需了解更多关于安装和配置 Collector 的信息,请参见在 VM 上安装 OpenTelemetry Collector。
Copydocker compose up -d
docker compose logs -f如需了解更多关于安装和配置 Collector 的信息,请参见在 Docker 上安装 OpenTelemetry Collector。
Copykubectl rollout restart deployment/<release>-k8s-infra-otel-deployment -n <collector-namespace>
kubectl logs -f deployment/<release>-k8s-infra-otel-deployment -n <collector-namespace>SigNoz K8s Infra chart 会安装两个 Collector。请将抓取任务添加到负责集群范围抓取的 Deployment 中,而不是添加到按节点运行的 <release>-k8s-infra-otel-agent DaemonSet 中。请将 <release> 替换为你的 Helm release 名称,并将 <collector-namespace> 替换为运行它的命名空间。如果你使用其他名称运行自己的 Collector,请改用该名称。
如需了解更多关于安装和配置 Collector 的信息,请参见安装 SigNoz K8s Infra chart。
MSI 安装包会将 Collector 安装为名为 otelcol-contrib 的 Windows 服务,显示名称为 OpenTelemetry Collector。在 PowerShell 中执行以下操作:
Restart-Service -Name otelcol-contrib
Get-EventLog -LogName Application -Source otelcol-contrib -Newest 20有关安装和配置 Collector 的详细信息,请参阅 在 VM 上安装 OpenTelemetry Collector。
向 vLLM 发送一个请求,以便服务器有内容可上报。
导出请求链路追踪(可选)
Metrics 反映服务器整体行为。Traces 展示单个请求内部的时间消耗。Traces 直接从 vLLM 发送至 SigNoz,不经过 Collector,因此不会影响上述 scrape 任务。
设置三个环境变量,并在启动命令中添加一个参数:
Copyexport OTEL_SERVICE_NAME=vllm
export OTEL_EXPORTER_OTLP_TRACES_PROTOCOL=http/protobuf
export OTEL_EXPORTER_OTLP_TRACES_HEADERS="signoz-ingestion-key=<your-ingestion-key>"
vllm serve <your-model> \
--host 0.0.0.0 \
--port 8000 \
--otlp-traces-endpoint https://ingest.<region>.signoz.cloud:443/v1/traces验证这些值:
<your-model>:你要提供的模型,例如Qwen/Qwen2.5-7B-Instruct。<region>:你的 SigNoz Cloud 区域。<your-ingestion-key>:你的 SigNoz 数据摄入密钥。
必须设置协议和请求头环境变量。vLLM 本身不会发送身份验证头,且默认使用 gRPC。
gRPC 导出器无法连接 SigNoz CloudvLLM 创建的 gRPC 导出器设置了 insecure=True,从而禁用了 TLS。由于 SigNoz Cloud 强制要求 TLS,通过 gRPC 发送的 Traces 将会失败。请使用如上所示的 http/protobuf。gRPC 仅适用于在你自己的网络中运行且未启用 TLS 的 Collector。
修改启动命令后,请重启服务器。
验证
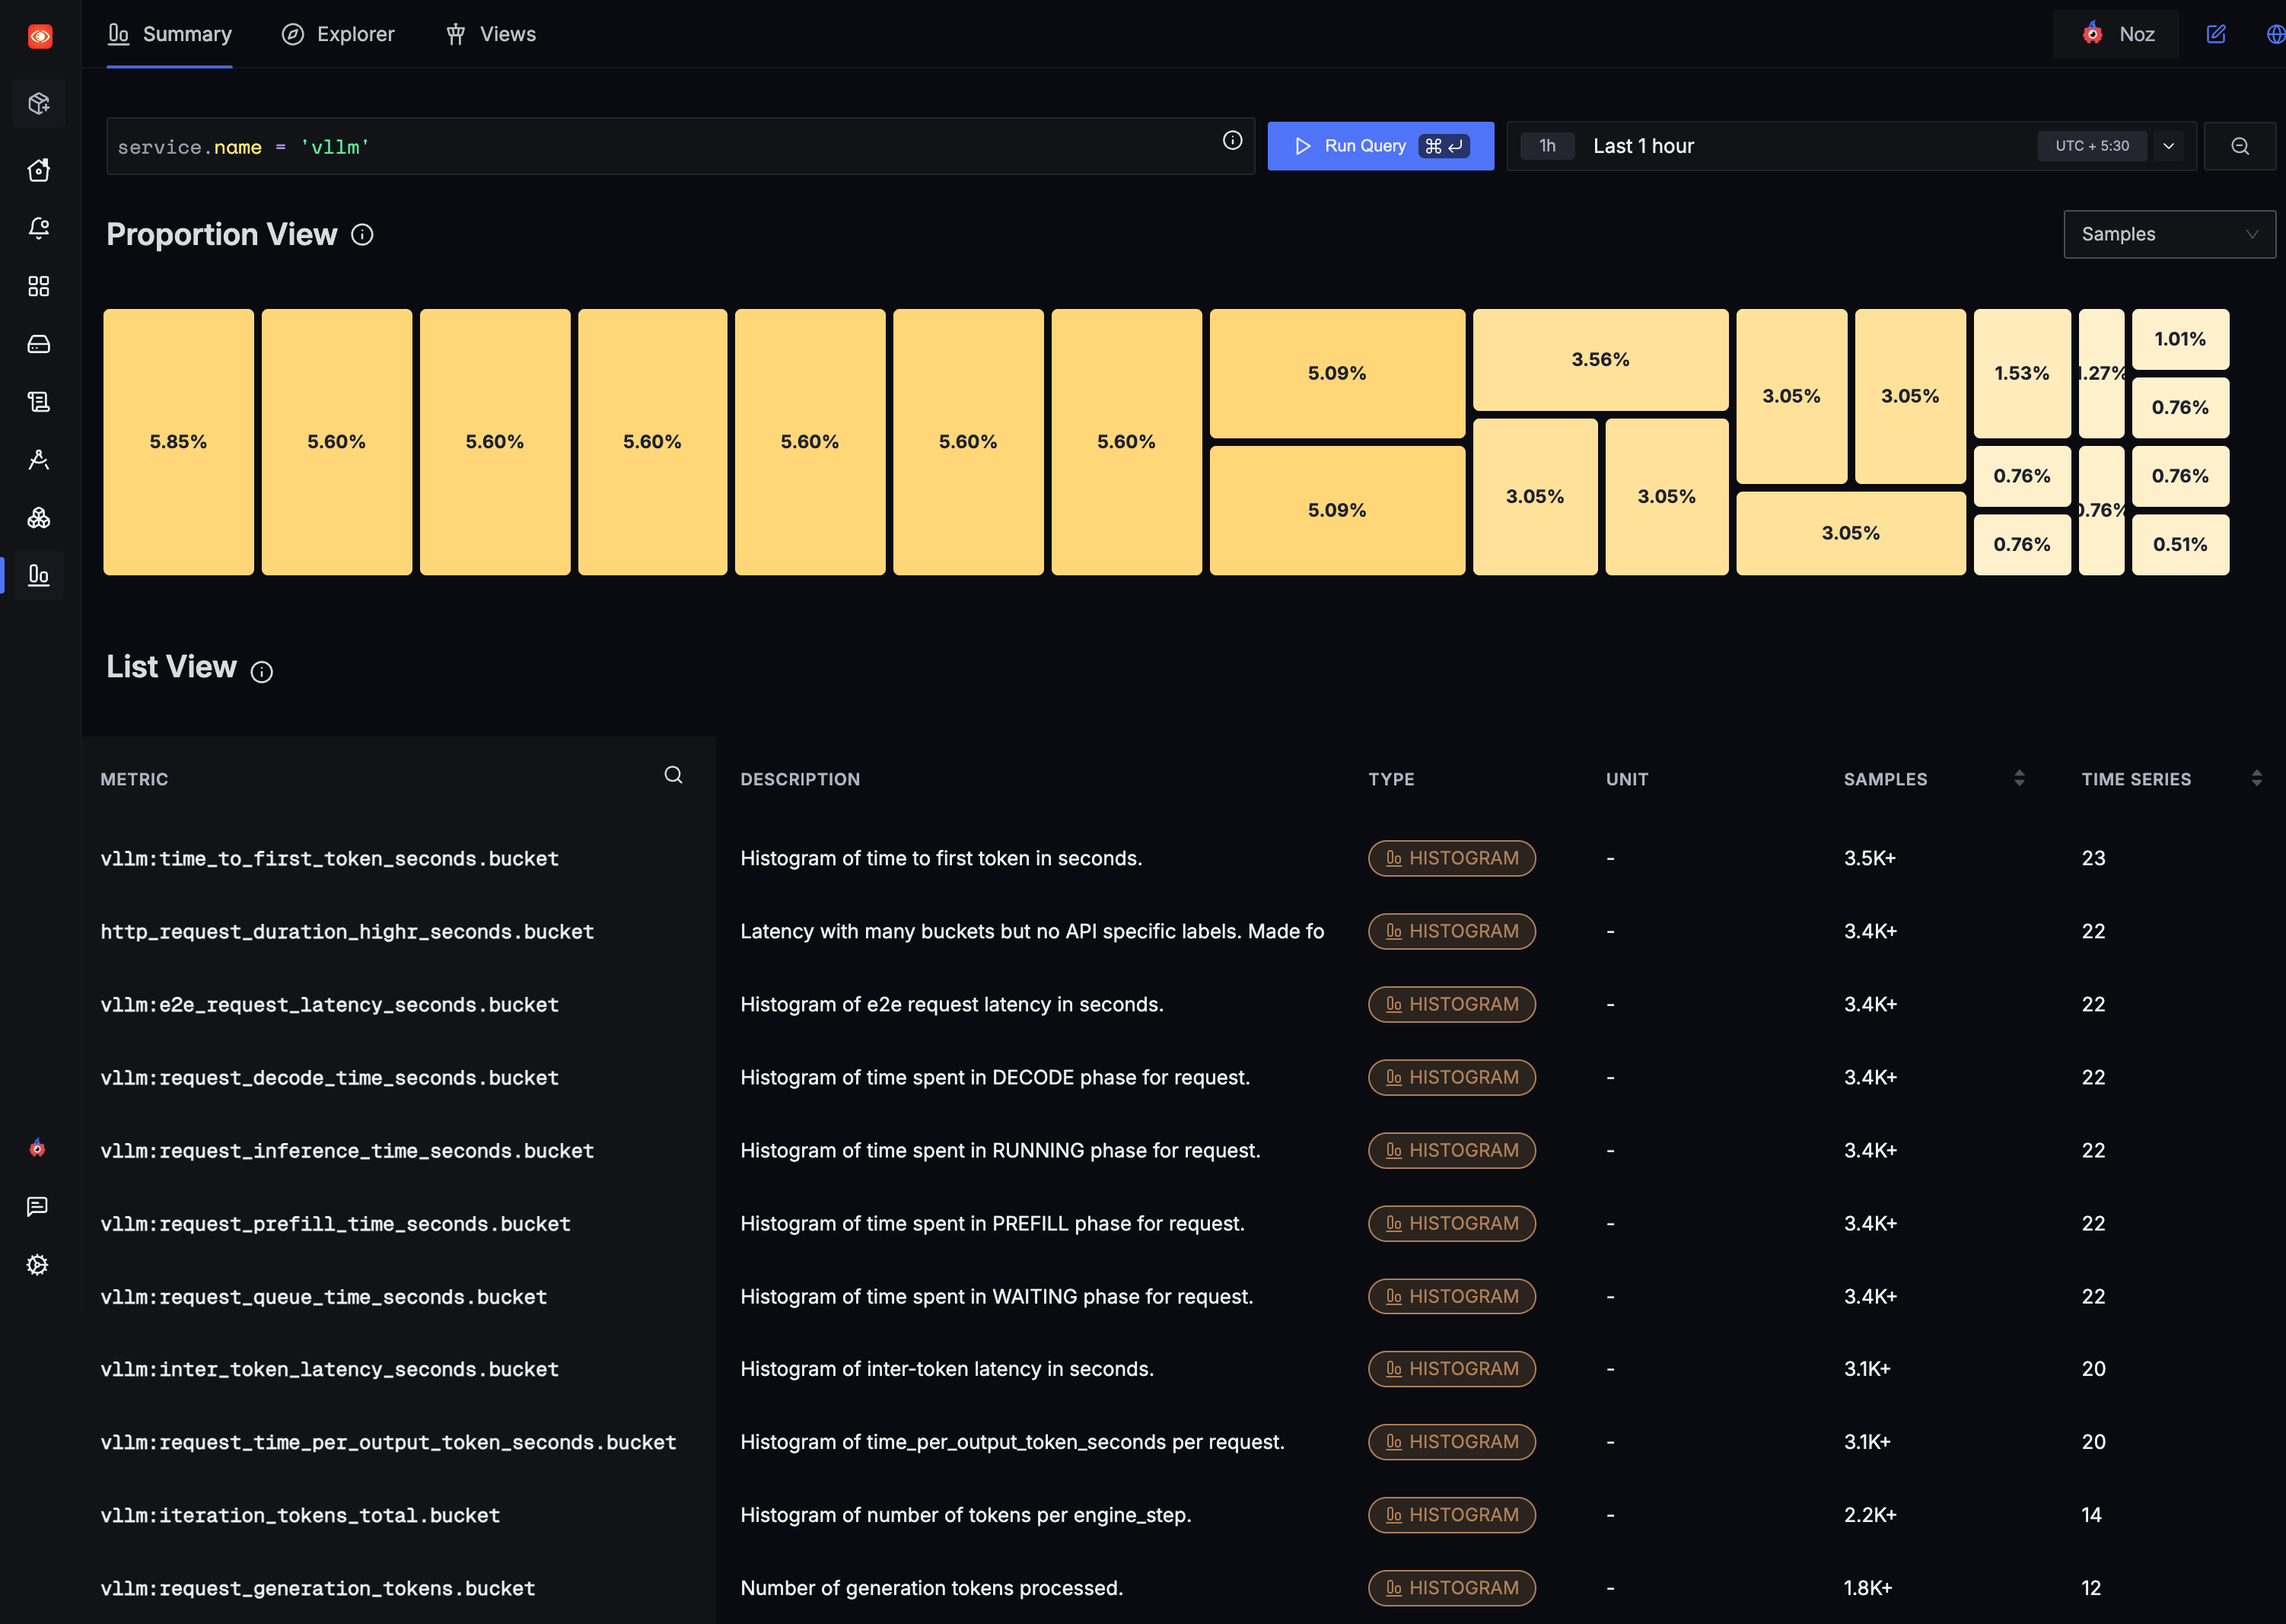
打开 Metrics > Metrics Explorer,用 service.name = 'vllm' 过滤。
这个值来自抓取任务中的 job_name。指标会在一个抓取周期内出现。
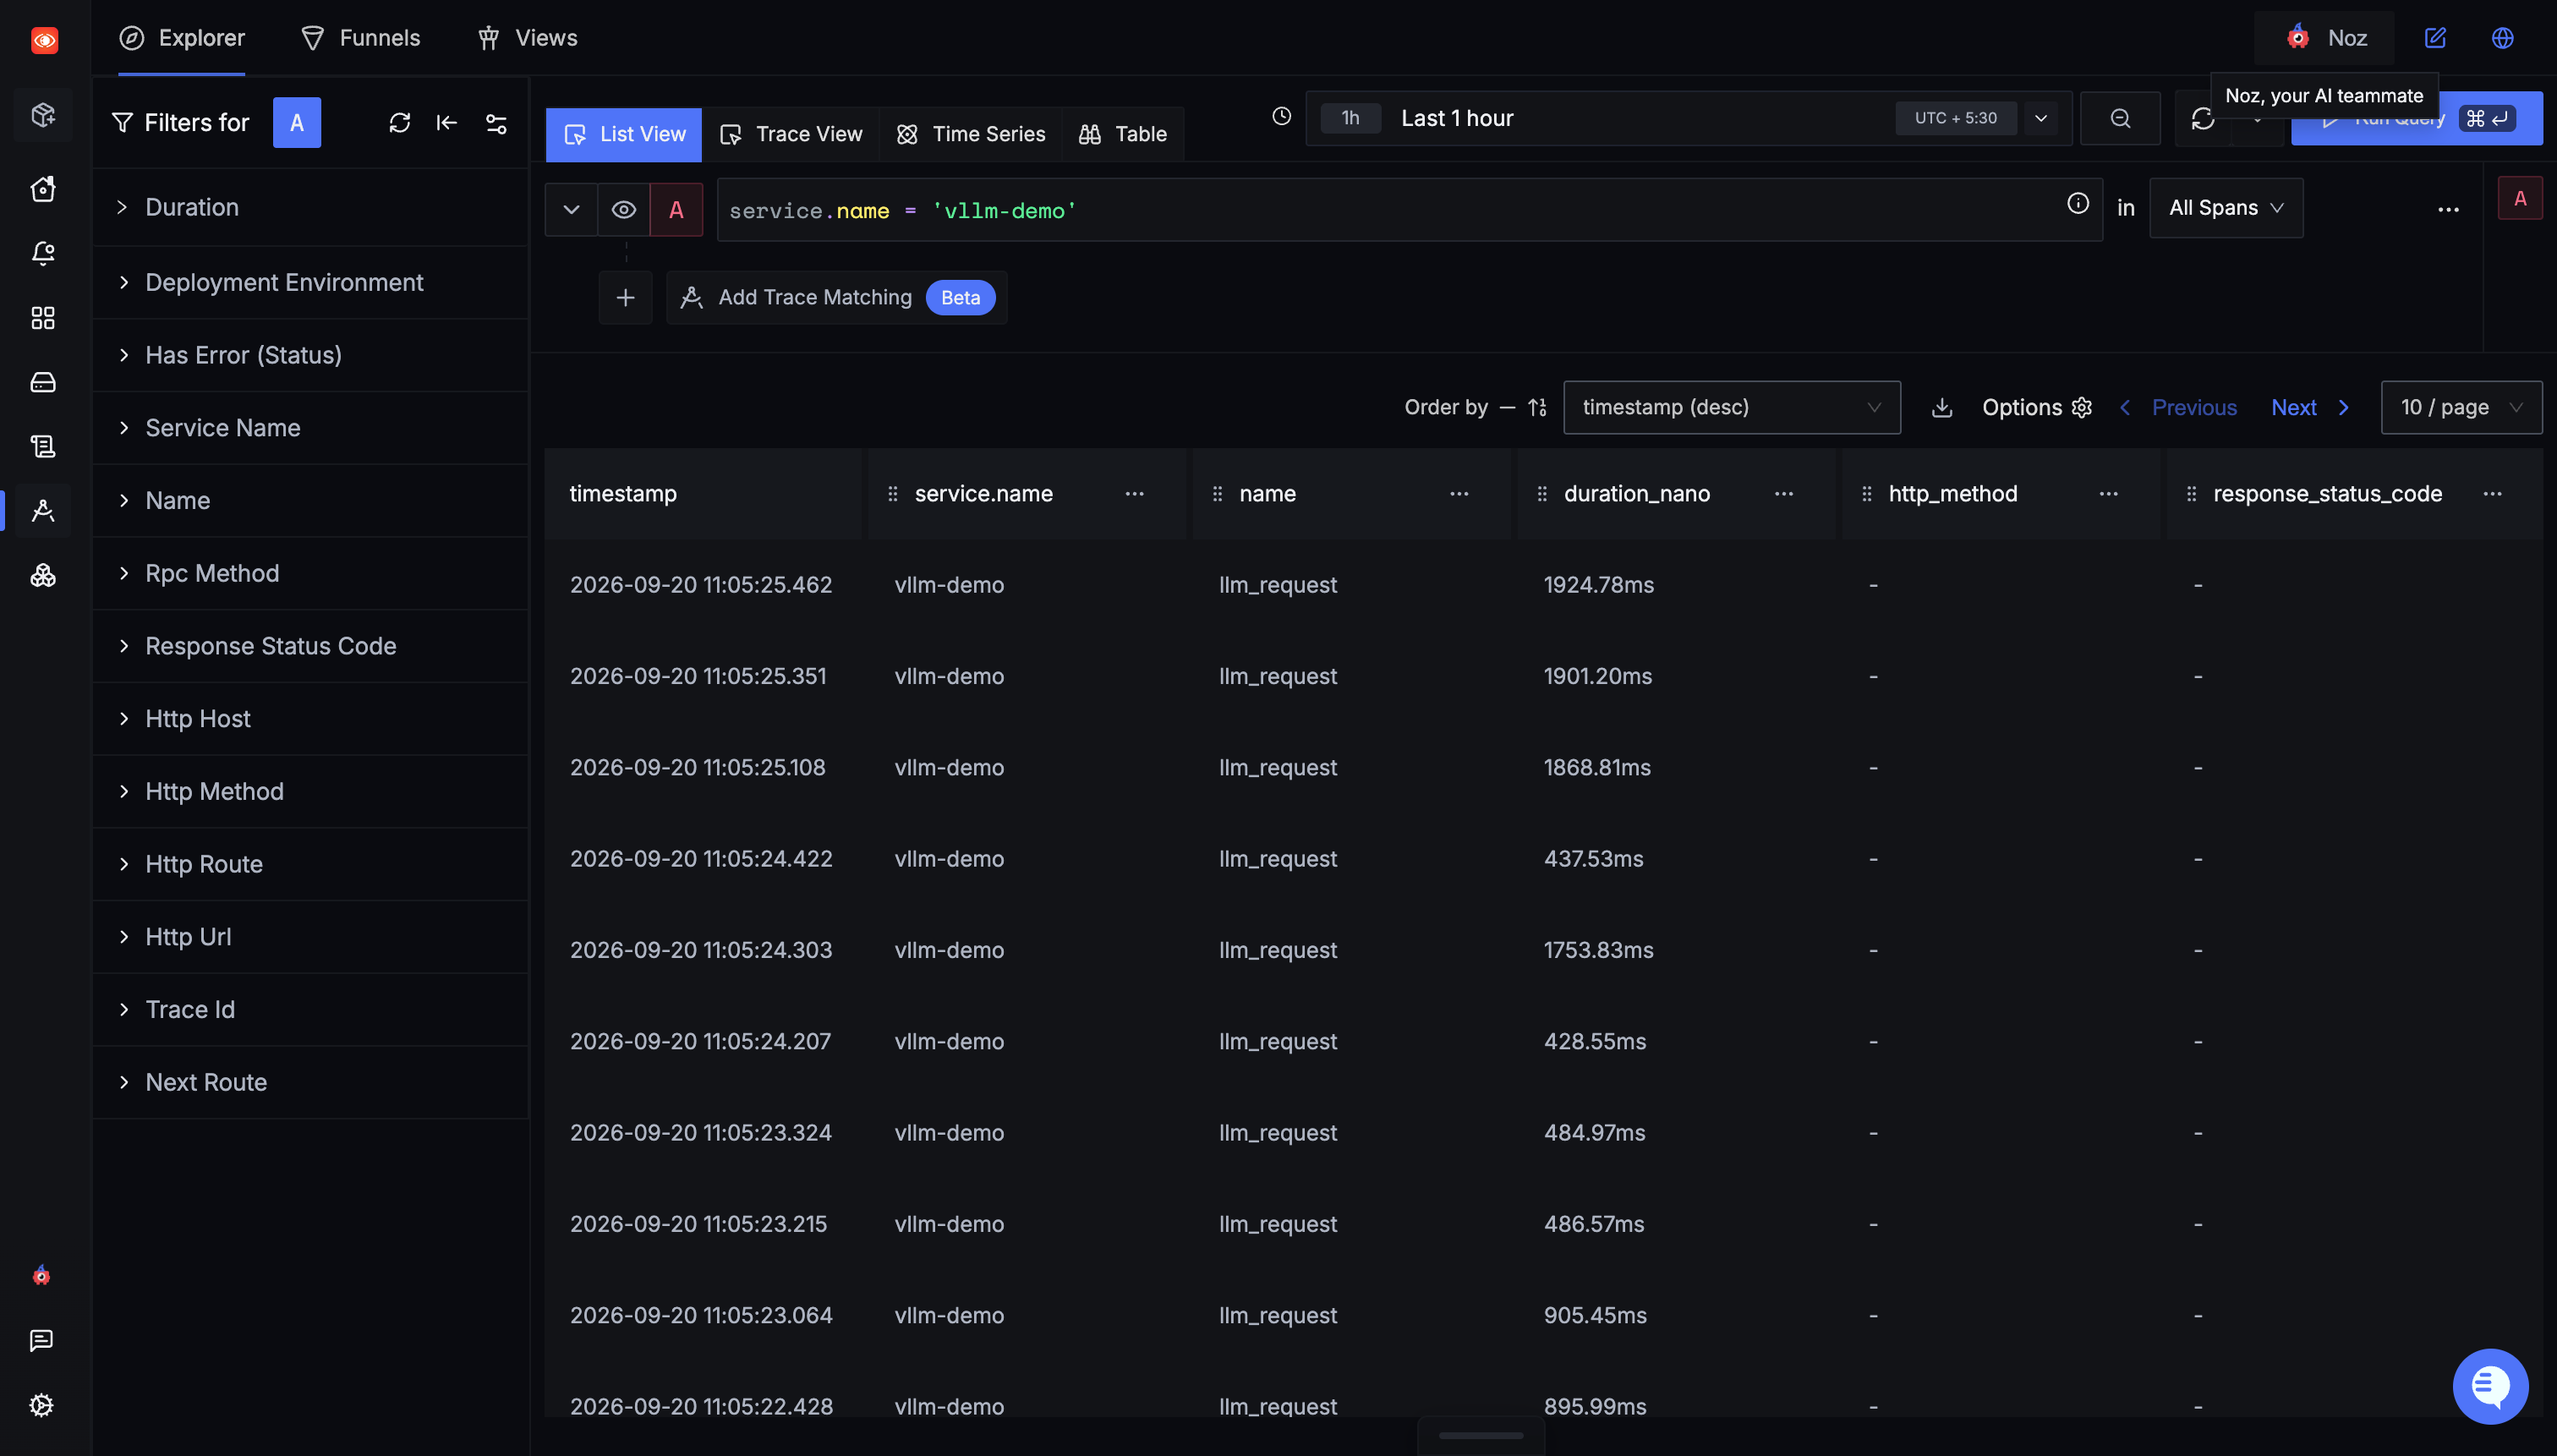
如果你启用了链路追踪,打开 Traces,按 OTEL_SERVICE_NAME 设置的值过滤。每个请求都会生成一个名为 llm_request 的 span。
指标参考
| 指标 | 类型 | 含义 |
|---|---|---|
vllm:generation_tokens_total | Counter | 生成的输出 token 数。求速率可得每秒 token 数。 |
vllm:prompt_tokens_total | Counter | 已处理的 Prefill token 数。 |
vllm:prompt_tokens_cached_total | Counter | 从缓存直接读取而非重新计算的 Prompt token 数。 |
vllm:time_to_first_token_seconds | Histogram | 首 token 输出前的延迟,决定流式响应的感知速度。 |
vllm:inter_token_latency_seconds | Histogram | 首个 token 之后各输出 token 之间的延迟。 |
vllm:e2e_request_latency_seconds | Histogram | 请求的总耗时。 |
vllm:request_queue_time_seconds | Histogram | 请求执行前的排队等待时间。 |
vllm:num_requests_running | Gauge | 当前执行批次中的请求数。 |
vllm:num_requests_waiting | Gauge | 等待启动的请求数。大于零说明服务器已饱和。 |
vllm:kv_cache_usage_perc | Gauge | 键值缓存(key-value cache)使用比例,取值 0 至 1。 |
vllm:prefix_cache_queries_total | Counter | 在前缀缓存中查找的 Prompt tokens 数量。 |
vllm:prefix_cache_hits_total | Counter | 在前缀缓存中命中的 Prompt tokens 数量。 |
vllm:num_preemptions_total | Counter | 调度器抢占后重新执行的请求数。 |
每个指标都携带 model_name 和 engine 标签。当一台服务器托管多个模型时,按 model_name 分组。
vLLM 没有现成的吞吐量仪表,需将每秒 token 数视为对 vllm:generation_tokens_total 的速率读取。同时缺少前缀缓存命中率指标,需用 vllm:prefix_cache_hits_total 除以 vllm:prefix_cache_queries_total 计算。
Collector 将每个 Prometheus 直方图拆分为三个指标。查询 vllm:time_to_first_token_seconds.bucket 获取百分位,用对应的 .count 和 .sum 指标计算速率和均值。仅查基础名无结果。
vllm:iteration_tokens_total 虽是每个引擎 step 的 token 直方图,但带 _total 后缀。查询时写为 vllm:iteration_tokens_total.bucket。
vLLM 不同版本的指标名各异。上表指标名出自 v0.29.0,完整列表见 vLLM 指标参考。
故障排查
指标端点返回 404
常见原因:请求发往错误端口,或服务器经代理运行且代理未转发 /metrics。
解决:使用 vLLM 提供 API 的端口,默认 8000。
验证:运行 curl -s http://localhost:8000/metrics | head,输出应以 # HELP 开头。
Collector 日志报连接拒绝
常见原因:vLLM 绑定 127.0.0.1,外部无法访问。
解决:启动服务器时加