
蓝曜炬辉AI 1小时前 · 2026-09-22 19:31:19 · 0 阅读
移动端AIAgent工程化:手机到眼镜助手的三层取舍
移动端 AI Agent 工程化:手机到眼镜助手的三层取舍2026 年 9 月,一家叫 NavigateAI 的公司进入公众视野:它给建筑工人做 AI 教练,核心产品跑在智能手机上,免提模式戴 Meta 的 AI 眼镜。镜头对准施工面,工人用自然语言问"这个扭矩对不对、是否符合规范",系统实时调出图纸、厂商手册与公司规程。种子轮 2500 万美元,投后估值 2.25 亿美元。这是移动端 AI Agent 工程化少见的真实样本。它同时验证了三件事:这类产品优先服务什么岗位、工程上先取舍什么、商业模式如何闭环。下面用公开数据拆解这三层取舍。我们在手机端把智能体从 Demo 推到生产的过程里踩过不少类似的坑,相关复盘可以参考另一篇移动端 Agent 从 Demo 到生产的落地记录。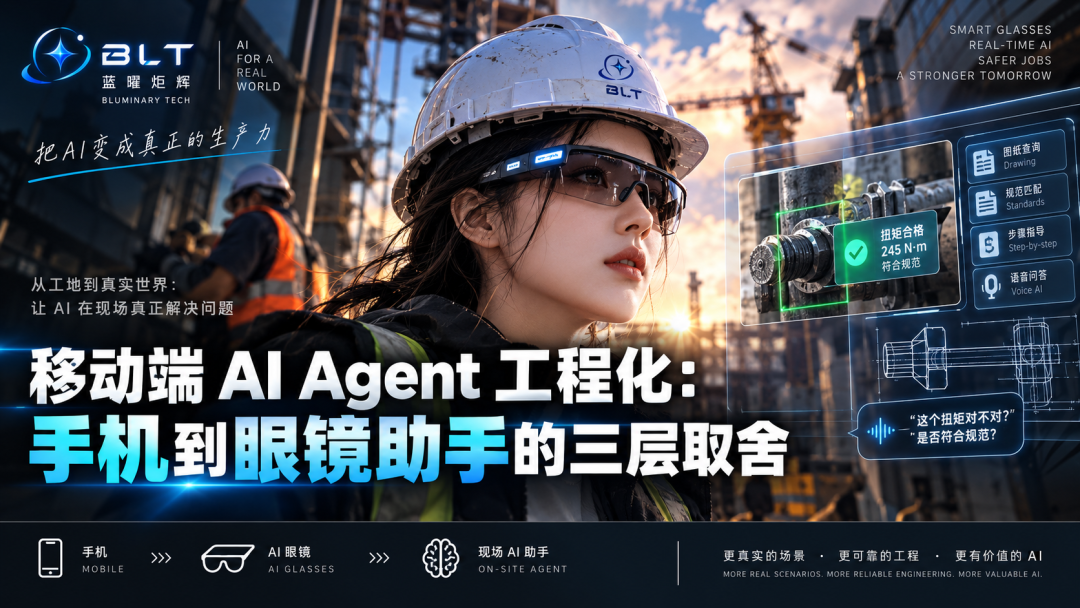
为什么工地成了移动端 Agent 的第一批客户
需求端的数据很直白。美国建筑商与承包商协会估算,2026 年仅补足建设需求就缺约 34.9 万名工人。大型项目把缺口进一步放大:Meta 在路易斯安那州的 Hyperion 园区高峰期需要约 5000 名建筑工人,OpenAI 在得克萨斯州的 Stargate 工地涉及约 6400 人。Kelly 人力公司称,90% 的数据中心运营方把人力短缺列为扩张的关键约束。工人少、任务重,意味着每一次返工和误操作都很贵。AI 教练的价值不在于取代人,而在于让经验不足的人在现场达到老手的判断水平。这也解释了移动端 Agent 为何先在工地这类岗位出现:有实物现场、有可校验的规范、有明确缺口。
第一层取舍:时延预算决定免提体验
NavigateAI 创始人 Eric Wu 的原话很朴素:免提体验的优越性是"可测量的"——工人不应为了看手机而停下手中的活。这句话落到工程上,就是一条时延预算链:从语音唤醒、画面采集到模型返回结论,任何一环超时都会让用户低头看屏幕。
我们做端侧模型选型时的经验是:不要一上来就追大参数。先把场景里 80% 的高频问题压缩成可本地判定的规则或小模型任务,剩下的才交给云端大模型。这套"端侧筛、云端判"的分层,比单纯堆算力更稳。链路一旦拉长,超时与重试会变成新的故障源,如何处理这类边界条件我们单独写过一篇Agent 超时、重试与副作用治理。
第二层取舍:现场知识先做资产治理,再谈检索
演示里"实时调出图纸与手册"听起来简单,工程上最难的不是检索算法,而是文档本身。同一面墙可能有多版图纸,同一台设备有不同年份的厂商手册,公司规程还在随时更新。如果不过滤版本,检索再准也会给出过期结论。我们踩过的坑是:早期把全部资料交给通用模型做开放问答,它在版本冲突时"自信地"选了一版过期的。教训是,做这类系统要先把知识资产拆成三层——最新图纸、历史版本、公司规程,给每层设权限与生效时间,检索只允许命中有效层。授权与上下文管理是这类系统最常见的隐性负债,我们在企业 Agent 的授权、上下文与成本工程债里有展开。2026 年 9 月最高人民法院发布涉人工智能纠纷案件审理意见,共 5 部分 24 条,覆盖换脸拟声、自动驾驶事故等裁判规则;生成式判断一旦进入施工、医疗等现场,责任边界会越来越清晰,工程上必须留审计记录。
第三层取舍:按 token 计费会饿死项目,按价值分成才能闭环
NavigateAI 的定价演变值得抄作业。它最初用"token + 毛利"的用量计费,新合同已转向价值分成:如果系统帮建商把一套住宅的综合成本从 30 万美元降到 28 万,公司抽取节省额的约 20%。这意味着产品从一开始就要埋点:哪条建议省了多少工时、避免了多少返工。没有这层计量,价值分成无从谈起;只按调用量收钱,客户用几次就会砍预算。移动端 AI Agent 的工程化,后端一半在模型,前端一半在计量与归因。
给技术决策者的落地清单
常见问题
移动端 Agent 和 App 里套一个聊天窗口有什么差别差别在闭环。聊天窗口只回答问题;移动端 Agent 要接摄像头、定位、通知与免提播报,能在现场动作链条里完成"观察—判断—指导"。
端侧小模型能扛住这类任务吗不能全扛,也不需要全扛。高频短判断走端侧,低频复杂规范走云端,中间靠路由层衔接。先定路由规则再选模型,比先选模型再定场景更省成本。
AI 眼镜是必需品吗不是。NavigateAI 也是从手机起步,眼镜是免提场景的加分项。落地时建议先验证手机 + 语音能否覆盖核心流程,再把眼镜作为第二阶段设备引入。
不做工地,这套方法论能复用吗能。零售盘点、物流分拣、售后巡检的结构几乎一样:现场实物 + 手册规范 + 人员缺口。换行业时先重做知识资产治理,模型与链路骨架可以直接迁移。
PART 01
为什么工地成了移动端 Agent 的第一批客户
需求端的数据很直白。美国建筑商与承包商协会估算,2026 年仅补足建设需求就缺约 34.9 万名工人。大型项目把缺口进一步放大:Meta 在路易斯安那州的 Hyperion 园区高峰期需要约 5000 名建筑工人,OpenAI 在得克萨斯州的 Stargate 工地涉及约 6400 人。Kelly 人力公司称,90% 的数据中心运营方把人力短缺列为扩张的关键约束。工人少、任务重,意味着每一次返工和误操作都很贵。AI 教练的价值不在于取代人,而在于让经验不足的人在现场达到老手的判断水平。这也解释了移动端 Agent 为何先在工地这类岗位出现:有实物现场、有可校验的规范、有明确缺口。
PART 02
第一层取舍:时延预算决定免提体验
NavigateAI 创始人 Eric Wu 的原话很朴素:免提体验的优越性是"可测量的"——工人不应为了看手机而停下手中的活。这句话落到工程上,就是一条时延预算链:从语音唤醒、画面采集到模型返回结论,任何一环超时都会让用户低头看屏幕。
| 交互环节 | 约束 | 工程对策 |
|---|---|---|
| 语音唤醒与采集 | 工地噪声大,端上处理优先 | 本地降噪 + 唤醒词,避免音频上云 |
| 画面识别与判断 | 单次请求需在秒级内闭环 | 端云分级:短问题走端侧,复杂规范走云端 |
| 知识检索 | 图纸与手册体量大,无法全量塞进上下文 | 先检索再生成,限定返回片段长度 |
| 结果播报 | 免提场景只能听,不能看 | 结论前置:先给"合格/不合格",再解释依据 |
PART 03
第二层取舍:现场知识先做资产治理,再谈检索
演示里"实时调出图纸与手册"听起来简单,工程上最难的不是检索算法,而是文档本身。同一面墙可能有多版图纸,同一台设备有不同年份的厂商手册,公司规程还在随时更新。如果不过滤版本,检索再准也会给出过期结论。我们踩过的坑是:早期把全部资料交给通用模型做开放问答,它在版本冲突时"自信地"选了一版过期的。教训是,做这类系统要先把知识资产拆成三层——最新图纸、历史版本、公司规程,给每层设权限与生效时间,检索只允许命中有效层。授权与上下文管理是这类系统最常见的隐性负债,我们在企业 Agent 的授权、上下文与成本工程债里有展开。2026 年 9 月最高人民法院发布涉人工智能纠纷案件审理意见,共 5 部分 24 条,覆盖换脸拟声、自动驾驶事故等裁判规则;生成式判断一旦进入施工、医疗等现场,责任边界会越来越清晰,工程上必须留审计记录。
PART 04
第三层取舍:按 token 计费会饿死项目,按价值分成才能闭环
NavigateAI 的定价演变值得抄作业。它最初用"token + 毛利"的用量计费,新合同已转向价值分成:如果系统帮建商把一套住宅的综合成本从 30 万美元降到 28 万,公司抽取节省额的约 20%。这意味着产品从一开始就要埋点:哪条建议省了多少工时、避免了多少返工。没有这层计量,价值分成无从谈起;只按调用量收钱,客户用几次就会砍预算。移动端 AI Agent 的工程化,后端一半在模型,前端一半在计量与归因。
PART 05
给技术决策者的落地清单
- 选岗位:找"有实物现场 + 有可校验规范 + 人员短缺"的场景,工地、仓储质检、设备巡检都符合。
- 定时延预算:把整条链路拆到秒级,先保免提场景的结论前置。
- 做知识资产治理:版本、权限、生效时间三件事先于检索算法。
- 设计价值计量:埋点记录每次建议对工时与返工的影响,为结果计价打底。
- 合规先行:涉及现场影像与人身安全的场景,参照最新裁判规则做审计与披露设计。
PART 06
常见问题
移动端 Agent 和 App 里套一个聊天窗口有什么差别差别在闭环。聊天窗口只回答问题;移动端 Agent 要接摄像头、定位、通知与免提播报,能在现场动作链条里完成"观察—判断—指导"。
端侧小模型能扛住这类任务吗不能全扛,也不需要全扛。高频短判断走端侧,低频复杂规范走云端,中间靠路由层衔接。先定路由规则再选模型,比先选模型再定场景更省成本。
AI 眼镜是必需品吗不是。NavigateAI 也是从手机起步,眼镜是免提场景的加分项。落地时建议先验证手机 + 语音能否覆盖核心流程,再把眼镜作为第二阶段设备引入。
不做工地,这套方法论能复用吗能。零售盘点、物流分拣、售后巡检的结构几乎一样:现场实物 + 手册规范 + 人员缺口。换行业时先重做知识资产治理,模型与链路骨架可以直接迁移。
原始来源: 蓝曜炬辉AI