
Transformers 现已支持运行 llama.cpp 量化模型
我们即将支持在 transformers 中高效运行 GGUF 模型,这样你就能通过熟悉的 transformers API,使用匹配笔记本内存大小的检查点。只需从 Hub 挑选一个 GGUF 模型,用 from_pretrained 加载,即可在本地机器上开始生成。
在笔记本上运行 AI 模型已变得简单许多,llama.cpp 功不可没。其推理引擎驱动了 Ollama、LM Studio 和 Jan 等本地 AI 工具。它与 MLX 等项目共同推动了本地推理,使其成为日常使用的可行选择。
这是本地 AI 体验的一个近期示例:
这就是我们现在的状态。说实话,感觉相当神奇 🧙♀️
— Julien Chaumond (@julien_c) 2026年4月24日
Qwen3.6 27B 通过 Llama.cpp 在 MacBook Pro 上的 Pi 编码代理中运行
对于 @huggingface 代码库中非琐碎的任务,体验非常接近 Claude 的最新 Opus… pic.twitter.com/lsIxLoUneU
GGUF 是 llama.cpp 团队开发的本地推理常用格式。该团队还在 Hub 的 ggml-org 下共享量化检查点。Unsloth、LM Studio Community 和 bartowski 等发布者也提供多种量化版本、即开即用的 GGUF 检查点,用户可根据机器配置选择合适的版本。GGUF 模型已下载数百万次。
我们也希望让使用 transformers 本地运行这些模型变得更容易。只有模型运行体验良好,兼容性才有意义。为接近 llama.cpp 的性能,我们复用其底层的 ggml kernel,通过 kernels 库实现,并降低 generate 的开销。我们的初期重点是在 Apple Silicon 上进行本地推理,首先支持 Qwen3.5 架构。
GGUF 文件格式是什么?
GGUF 将模型权重和元数据(如分词器信息和可选的聊天模板)打包进单个文件。它支持多种量化级别,让你通过牺牲部分精度来换取更小的内存占用。像 Q4_K_M 这样的变体会混合使用不同的张量精度:大部分权重采用 4 位量化,而对精度敏感的张量则保留更高精度。
以下是 Unsloth 发布的 Qwen3.5-4B 在不同量化级别下的文件大小变化:
| GGUF 变体 | 文件大小 | 特点 |
|---|---|---|
BF16 |
8.42 GB | 非量化基准 |
Q6_K |
3.53 GB | 比更小变体精度更高 |
Q5_K_M |
3.14 GB | 在体积与精度间取得平衡 |
Q4_K_M |
2.74 GB | 本地推理的实用起点 |
建议先从 Q4_K_M 开始,若内存充裕可尝试 Q5_K_M 或 Q6_K。更激进的量化有助于让大模型装进内存,但质量损失取决于具体模型和任务。请在实际目标任务上评估模型表现。Hub 的 GGUF 文档 详细列出了可用的量化类型。
使用 Transformers 加载 GGUF
开始之前,请确保具备以下条件:
- Apple Silicon 芯片的 Mac 电脑。
- 受官方发布的 ggml-quantization 内核构建 支持的 PyTorch 版本,通常为最近发布的两个 PyTorch 版本。
- 最新版本的 transformers(目前为 main 分支,直至下一个正式版发布)及兼容版本的
kernels。
pip install -U "git+https://github.com/huggingface/transformers.git" kernels
加载 GGUF 模型时,需将 Hub 上的 model_id 和文件名作为 gguf_file 参数传入 from_pretrained。
无需任何额外配置:当权重仍以打包形式留在 Metal 上时,transformers 会自动加载兼容的 ggml/Metal 层内核,并使用 ggml-org/ggml-attn 作为 attention 实现。如果该内核无法获取,模型会回退到 "sdpa" 并给出警告;你也可以显式传入 attn_implementation="sdpa" 来强制使用它。更多加载选项请参阅 GGUF 文档。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    gguf_file=filename
)
GUF 相关的步骤就只有这些,之后的操作用的都是标准 transformers API:
messages = [{"role": "user", "content": "Explain why the sky is blue in a few sentences."}]
inputs = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    outputs = model.generate(**inputs, max_new_tokens=256)

print(tokenizer.decode(outputs[0], skip_special_tokens=True))
如果没有兼容的量化内核,加载器会回退为反量化整个模型,内存占用也会更高。
用你偏好的接口来部署 GGUF
你也可以把同一个 checkpoint 交给 transformers serve,它会提供一个 OpenAI 兼容的 API:
pip install -U "transformers[serving] @ git+https://github.com/huggingface/transformers.git" kernels

transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"
模型参数的格式是 <model_id>:<filename>.gguf:冒号前是 Hub 仓库(unsloth/Qwen3.5-4B-GGUF),冒号后是要加载的文件(Qwen3.5-4B-Q4_K_M.gguf)。这样可以在一个包含多种量化的仓库中选出特定的量化版本。
对于聊天模板支持推理(thinking)的模型,可添加 --reasoning off 跳过推理或 --reasoning on 启用推理。默认参数 --reasoning auto 将遵循聊天模板的设定。详细设置请参考推理选项。
你可以通过添加自定义 OpenAI 兼容提供商来连接 Jan 或 Pi 等客户端,具体配置如下:
| 设置项 | 值 |
|---|---|
| Base URL | http://localhost:8000/v1 |
| Model ID | unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf |
Transformers 在 Mac 上运行模型,而客户端提供对话界面。支持该 API 的其他客户端也可使用相同的端点。
与 llama.cpp 进行基准测试
我们将 llama.cpp 作为本地推理性能的参考基准。下表对比了三个 GGUF 检查点:一个小规模稠密模型、一个大规模稠密模型和一个混合专家模型。
llama.cpp 的数据来自 llama-bench 工具(构建版本 5f55650a7,Release b10200,采用来自 ggml 0.18.0 的 Metal 后端),运行命令为 llama-bench -m <file> -p 0 -n 128 -r 3。该命令报告 tg128 指标:即解码 128 个 Token 的生成速率,取三次重复的平均值,且不包含 Prompt 处理时间。Transformers 的数据来自 generate 函数,基于 12 个 Token 的 Prompt 生成同样 128 个 Token,取三次预热运行后的最佳成绩,且包含 Prefill 阶段。
测试环境为 MacBook Pro M2 Max,配备 32 GB 统一内存,运行 macOS 26.6、PyTorch 2.12.1 和 Kernels 0.17.0,且连接电源。
基准测试脚本import time
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
model_id, filename = "unsloth/Qwen3.5-4B-GGUF", "Qwen3.5-4B-Q4_K_M.gguf"
model = AutoModelForCausalLM.from_pretrained(model_id, gguf_file=filename)
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
inputs = tokenizer("The capital of France is Paris. The capital of Germany is", return_tensors="pt")
inputs = inputs.to(model.device)
with torch.inference_mode():
model.generate(**inputs, max_new_tokens=8, min_new_tokens=8, do_sample=False) # warm up
torch.mps.synchronize()
for _ in range(3):
time.sleep(90) # let the machine cool: back-to-back runs decay by 10% or more
start = time.perf_counter()
model.generate(**inputs, max_new_tokens=128, min_new_tokens=128, do_sample=False)
torch.mps.synchronize()
print(f"{128 / (time.perf_counter() - start):.1f} tok/s")
另一列使用:
llama-bench -hf unsloth/Qwen3.5-4B-GGUF:Q4_K_M -p 0 -n 128 -r 3
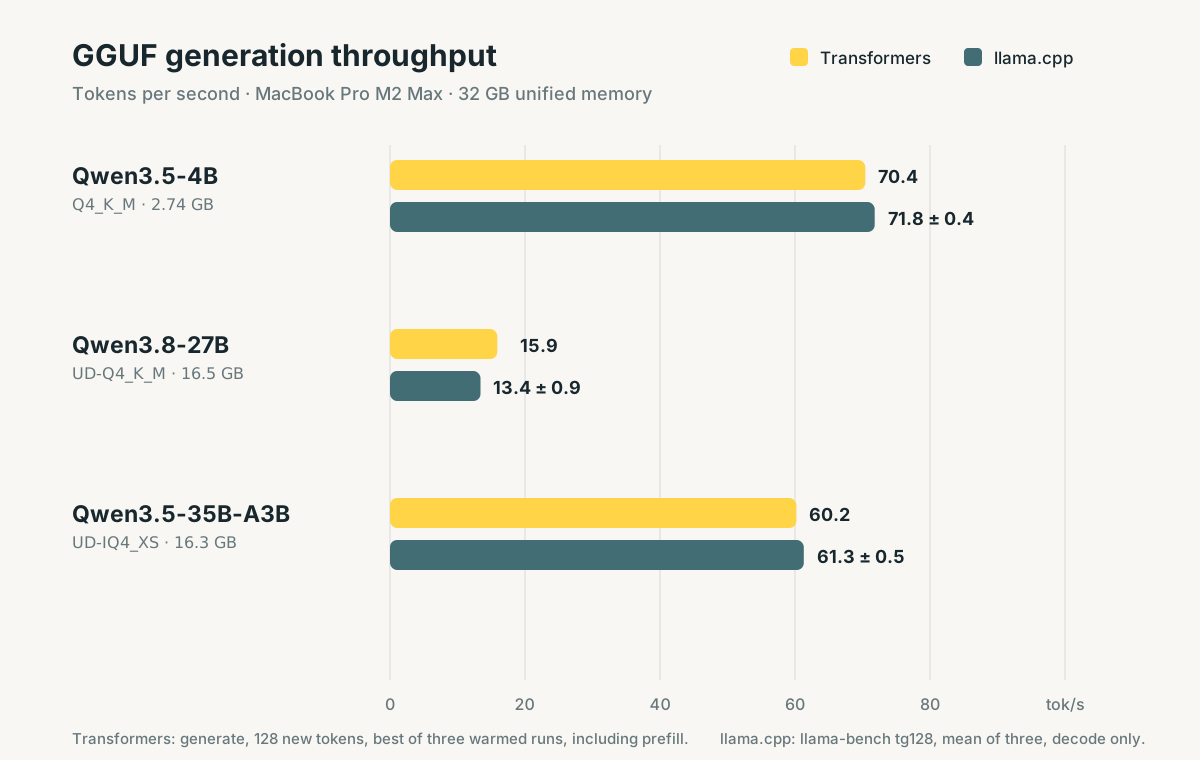
在全部三个 checkpoint 上,Transformers 的表现都与 llama.cpp 非常接近。图表采用上述相同的测量方式;但这并不意味着基准测试条件完全相同,因为 Transformers 的测量包含了 prefill,而 llama-bench 仅报告 decode 吞吐量。
对比 transformers 与 llama.cpp
当 GGML 和 llama.cpp 加入 Hugging Face 时,我们阐述了二者的互补关系:llama.cpp 为本地推理奠定基础,而 transformers 为模型定义奠定基础。GGUF 支持让这两者更加贴近。
如果你的首要目标是高效的本地推理,我们仍推荐 llama.cpp。 其专用运行时、内存管理以及广泛的硬件支持均围绕这一目标构建。此次集成为开发者提供了一条便捷路径,可在 transformers 内使用相同的 GGUF checkpoint:
- 用 Python 和 PyTorch 实验 GGUF。通过 hook 检查中间激活值、修改模型的 forward 过程,或用熟悉的 PyTorch 工具搭建自定义层原型。
- 评估 GGUF 模型。直接复用现有的 transformers 评估流程来衡量量化 checkpoint 的质量。
- 验证 GGUF 转换。对我们开发者来说,在 transformers 中同时加载原始 checkpoint 和它的 GGUF 转换版本,可以更方便地确认权重转换正确、量化误差在预期范围内。
- 尝试新的解码思路。在
generate中使用自定义 logits processor 和 stopping criteria,或直接用 Python 写自己的生成循环。 - 从 GGUF checkpoint 出发微调。反量化权重后,继续走标准的 transformers 训练流程。
最后一种情况可以用 GgufConfig(dequantize=True):
import torch
from transformers import AutoModelForCausalLM, GgufConfig

model = AutoModelForCausalLM.from_pretrained(
    "unsloth/Qwen3.5-4B-GGUF",
    gguf_file="Qwen3.5-4B-Q4_K_M.gguf",
    quantization_config=GgufConfig(dequantize=True),
    dtype=torch.bfloat16,
)
GGUF 之外:面向更多模型的 ggml kernel
更大的机会在于,把 ggml 的性能优势带给 llama.cpp 不支持的模型。
transformers 已经提供了这些架构的 PyTorch 实现。有了 PyTorch 中可用的 ggml kernel 和量化方案,我们就能加速其中已支持的操作,而不必先在 llama.cpp 里把整个模型实现一遍。这对新架构、研究型模型以及可能永远不会被 llama.cpp 专门实现的自定义变体尤其有用。
这个机会不止于 GGUF 格式本身。kernel 操作的对象是张量,并不要求整个模型都来自 GGUF 文件。同样的构建模块也可以集成到其他 transformers 模型和加载流程中。这还打开了通往其他模态的路径:计算机视觉、音频和多模态模型都可以复用兼容的 attention、归一化和矩阵乘法 kernel,而无需先有完整的 llama.cpp 实现。当然,每种架构仍需单独集成和验证;本文的 GGUF 示例只覆盖了文本生成。
用 Python 和 PyTorch 实现极速本地推理
我们也想展示在不离开 Python 的前提下,模型和生成循环能跑出多快的性能。搭配合适的 kernels 和高效的生成循环,Python 加 PyTorch 照样能交出强悍的本地推理成绩。重活交给 kernels,生成循环则通过减少不必要的同步来让 GPU 保持高负载。
我们的目标是在不开启 torch.compile 的情况下,让 eager 执行模式变得飞快。为了交互式使用,我们希望既能快速启动,又能稳定地输出 token,不用忍受编译等待或因输入形状变化而重新编译。这项工作的两大核心就是 kernels 和 generate 函数本身。
复用 ggml 的 Metal kernels
Kernel 是一种在 GPU 上执行特定运算的小程序。PyTorch 提供的是通用实现;而专用 kernel 可以做得更精简、把多个操作合并在一步里,甚至直接读取量化权重的存储格式。
kernels 库允许我们在 Hub 上分发 ggml Metal kernels 的兼容版本,并从 transformers 里直接调用。这样 ggml 的优化就能无缝进入 PyTorch 模型,无需把整个模型迁移到单独的推理运行时。
| Kernel | 功能说明 |
|---|---|
ggml-quantization |
读取打包好的量化权重用于矩阵运算,包括 MoE 模型中被选中的专家层,避免在每次 decode 操作前都要把整张权重矩阵展开。 |
ggml-norm |
将多种归一化操作融合在一起,涵盖 Qwen3.5 和 Qwen3.8 使用的零中心 RMSNorm。 |
ggml-attn |
为 prompt 处理和 token 解码提供 ggml 的 Metal 版 flash attention。 |
ggml-gated-delta-net |
加速 Qwen3.5 和 Qwen3.8 混合架构中线性注意力层使用的 gated delta network。 |
topk |
为 MoE 模型中的每个 token 选择专家,结合 softmax 和 top-k 路由。这是我们的 Metal 实现。 |
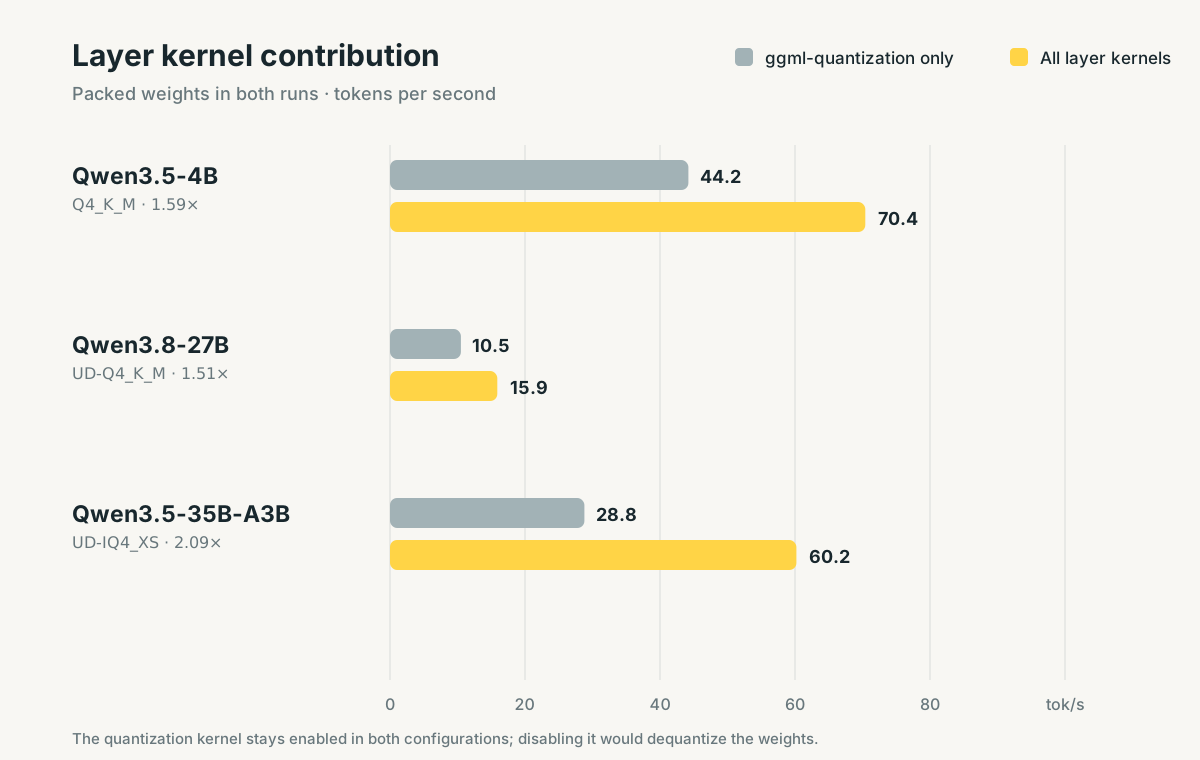
前四个包基于 ggml 的内核构建;top-k 内核则解决了 MoE 路由中的另一个瓶颈。两者共同减少了生成每个 token 所需的 GPU 工作量。
为了展示层内核的贡献,我们对比了相同打包 GGUF checkpoint 在启用和未启用这些内核时的表现。两种配置下,量化内核保持启用:禁用它会改变权重的表示方式,并衡量不同的权衡。
让 CPU 和 GPU 协同工作
只有当 GPU 有任务可执行时,更快的内核才有用。在生成过程中,CPU 负责调度 GPU 操作,并控制生成下一个 token 的循环。从 GPU 读回结果可能迫使 CPU 等待直到队列中的操作完成。即使是很小的等待,只要每个 token 都重复一次,也会显著降低吞吐量。
在 generate 中的两项改进解决了这个问题,从而为所有 transformers 模型(不仅限于运行 GGUF 文件时)带来提升:
- 提前移除不必要的注意力掩码 (#48814)。 当支持的 decoder-only 输入没有 padding 时,其全 1 的 padding 掩码可以在生成开始时移除。下游注意力代码不再需要反复检查该掩码以判断是否可以跳过。因果注意力仍然保持不变。
- 延迟停止检查 (#47975)。 在支持的路径上,
generate异步复制停止决策,并在下一步消费它。CPU 可以在 GPU 运行时继续调度工作。流式 token 使用相同方法,任何超出停止条件的额外步骤都会从结果中移除。
这些改动优化了模型外围的生成循环,因此其收益不限于 GGUF。它们与 kernel 层面的优化相辅相成:kernel 降低单个操作的开销,而更少的同步点则让 CPU 调度与 GPU 执行得以重叠。
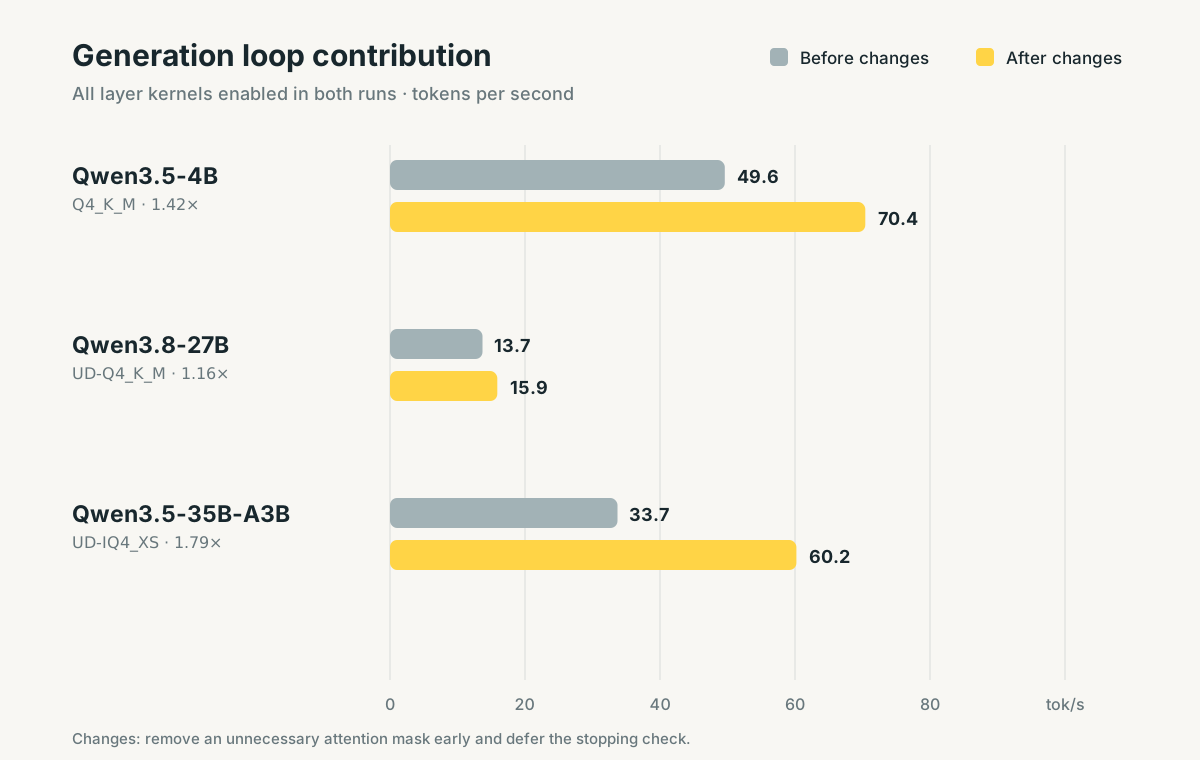
以上测试开启了所有层的 kernel;柱状图仅体现生成循环改动的效果。
当前限制与后续计划
初期目标是 Apple Silicon 上的单轮交互式对话。目前有几点限制需要注意:
- 打包推理路径目前仅支持 MPS。 通过反量化导入 GGUF 仍是独立的选项;支持该文件格式并不意味着打包 kernel 在所有设备上可用。
- Padding 和批处理仍需完善。 无 padding 的输入可以受益于上述 mask 优化,而带 padding 的批次无法走同样的捷径,性能可能更低。我们计划将这项工作扩展到 MPS 上的
generate_batch。 - 支持的架构还有限。 打包加载器目前仅覆盖 Qwen3.5 的 dense 和 MoE 架构,包括兼容的 Qwen3.8 checkpoint。添加其他架构的支持相对简单,我们会逐步扩展覆盖范围。
如果你有想在 transformers 中使用的 GGUF 模型,欢迎携带 checkpoint 和使用场景 提交 issue。这将帮助我们优先支持大家实际在本地运行的模型。
致谢
感谢 Arthur Zucker 发起这项工作并审阅了我所有的 PR,感谢 Cyril Vallez 完成的 generate 相关 PR。我们向 Sayak Paul、llama.cpp 团队以及 Bertrand Chevalier 表达谢意,感谢他们在内核集成过程中提供的帮助。此外,感谢 Aritra Roy Gosthipaty 和 Pedro Cuenca 审阅本文,也感谢 Lysandre Debut 对项目的监督指导。