
对话 COBRA-Skills 一作卢平琛:仅用 50 个样本,重构 Agent 技能降本路线
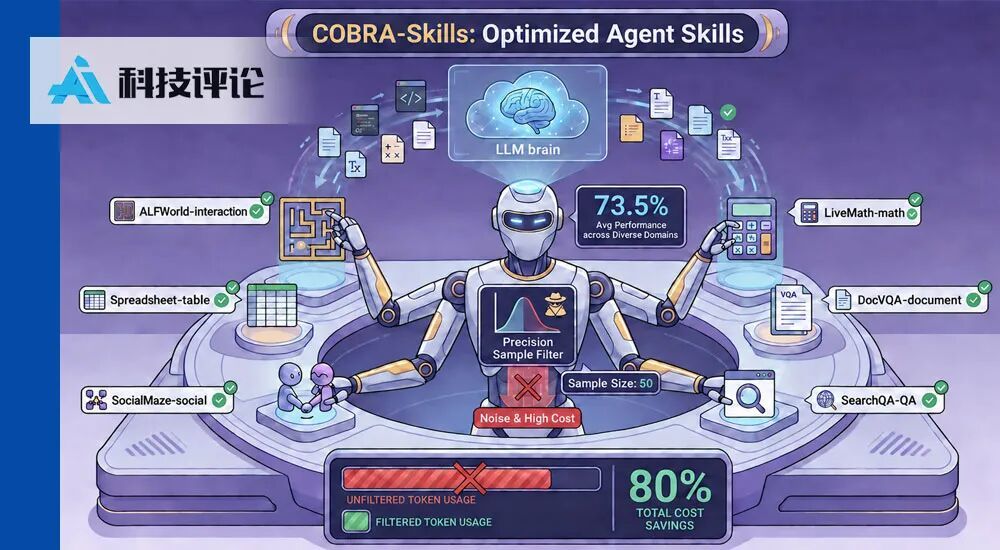 当经典算法遇到 LLM,用概率预判代替盲目试错,或许才是架构演进的真正解法。
作者丨张 璐
编辑丨马晓宁
过去,智能体的技能(Skill)大多依赖人类专家手动撰写,不仅耗时费力,更难以覆盖海量复杂的真实场景。为此,借助大模型“自动化生成与优化技能”,成了让 Agent 迈向自主进化的新范式。然而,摆脱了人工编写的束缚,却撞上了高昂的 Token 账单。要验证一个自动生成的技能到底管不管用,必须让智能体带入真实任务中落地执行。每一次试错,都是实打实的 Token 消耗与多轮交互的时间成本。更棘手的是,许多候选技能在刚生成时就自带缺陷。但在现有框架下,我们缺乏“事前筛选”的能力,只能任由大量预算被这些低质候选无意义地吃掉。同时,后续的精炼流程也在频繁调用高阶 LLM,哪怕缺乏有效的新证据,这种“反思—重写”的流水线依然在机械重复。评估贵,精炼也贵,两笔账算下来,技能优化的效率就成了绕不开的瓶颈。针对这一痛点,来自香港中文大学(深圳)、天津大学、香港科技大学(广州)和新加坡国立大学的研究团队,在论文《COBRA-SKILLS: Contextual Bandit-Guided Evolution for Agent Skill Optimization》中提出了一种全新的破解思路。 论文链接:https://arxiv.org/abs/2609.11682COBRA-Skills 摒弃了盲目堆叠 Token 的演化路线,巧妙地将技能优化转化为一个带预算控制的情境多臂老虎机(Contextual Bandit)问题。它在真实评估前增加了一道“收益预判”机制,确保只有最具潜力或探索价值的候选技能才会进入实际演练,并结合精细化算子迭代种群。凭借这套高效的筛选策略,COBRA-Skills 仅用 50 个优化样本,就将优化成本降低了 55%~58%,并在 6 个跨领域 Benchmark 上实现了对现有主流方法的全面超越。雷峰网(公众号:雷峰网)AI 科技评论近日独家对话了论文第一作者卢平琛。在交谈中,他向我们还原了团队如何将“情境多臂老虎机”引入 Agent 技能演化,以及这套低成本范式背后的真实踩坑经历与工程抉择。
01
双轮闭环:
经典算法“筛选” + 进化算子“重构”
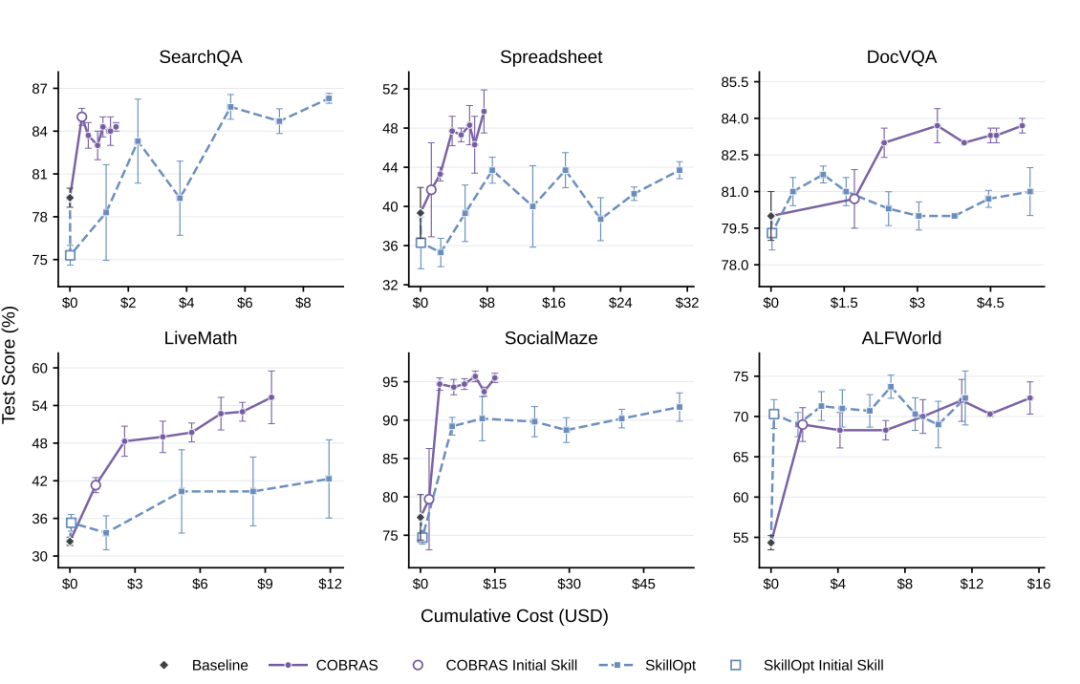
COBRA-Skills 的设计可以概括成:老虎机负责“选”,进化负责“改”,两者形成一个持续运转的闭环。具体而言,系统维护着一个固定规模的技能种群。在日常迭代中,流程分为三步:1.筛选评估。由老虎机算法为种群中的每个技能打分,挑选出得分最高者;2.实战检验。目标智能体搭载该技能在优化集上执行任务,并返回对应的奖励与执行轨迹;3.反馈更新。将评估结果写入历史数据,用于更新打分模型。此外,种群会定期触发进化更新,淘汰低分技能并生成新技能填补空缺。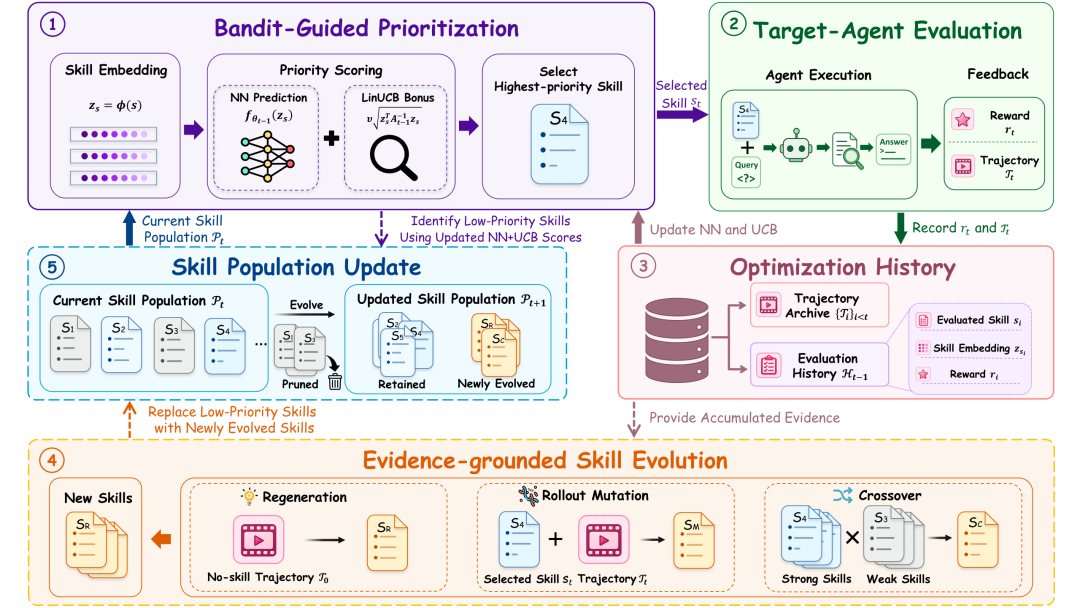 这两大机制紧密结合。老虎机依据历史数据预测技能潜力,而进化生成的新技能则会回流至老虎机的候选池;反过来,进化机制所依赖的改进证据,来自执行老虎机精细挑选后的技能后留下的执行轨迹。
02
引入“老虎机”,
将 Token 消耗拦在评估之前
论文第一作者卢平琛在接受AI科技评论采访时透露:团队深入分析后发现,核心瓶颈在于教学模型(Teaching Model,如 GPT-5.5 类高阶模型)调用次数过多,且单次调用的上下文极长。因此,团队在设计初期就明确将目标定为控制实际经济成本(Cost),而非简单统计 Token 数量。在最开始复现同类工作时,我们发现总 Token 量看似还好,但账单却高得吓人。
▎两层 MLP 收益预测:为未评估技能精准打分
最直接的做法,是基于历史评估数据,预判候选技能在未评估时的预期得分。COBRA-Skills 借助一个轻量级的两层 MLP 来实现这一点:先将每个技能转化为语义嵌入向量,再由 MLP 输出一个标量奖励预测值。随着评估数据的积累,预测精度会稳步提升。每完成一次技能评估,最新的“技能—奖励”数据就会被纳入历史库,用于重新拟合预测模型。然而,单纯依赖预测收益往往会带来局限。若某种技能当前的预测得分最高,算法就容易陷入对它的持续选择,导致其他有潜力的技能永远得不到评估机会。这便是经典的“探索与利用”困境。▎LinearUCB 空间探索:破除“只选高分”的贪婪困境
在探索策略的选择上,团队曾经历过严谨的实证对比。据卢平琛介绍,团队最初曾尝试过 NeuralUCB,但发现其特异性筛选能力较弱。相比之下,LinearUCB 则展现出了极高的性价比与精准度。仿真实验表明,以技能嵌入向量为输入、对应奖励为输出时,LinearUCB 能非常灵敏地识别出哪些语义区域已被充分探索,进而精准压低该区域的探索奖励,实现了轻量与高效的兼得。因此,团队最终采用了 “神经网络预测收益 + LinearUCB 量化探索” 的轻量高效组合。最终优先级分数 = 预测奖励 + 探索奖励在运行逻辑上,系统每轮仅挑选得分最高者送入评估,而综合分值垫底的技能则会在后续进化中被淘汰。这种设计将有限的评估预算精准引导至两类技能:要么预测表现极佳(利用),要么信息增量巨大(探索)。至于那些既无性能优势、又处于已探明区域的低质技能,则会被彻底过滤,不再浪费任何 Token。比如连续两轮选中同一个技能,系统对该技能不确定性的衰减幅度与其他技能几乎没有区别;此外,NeuralUCB 的计算量极其庞大,在做对角化近似时还会牺牲部分精度。
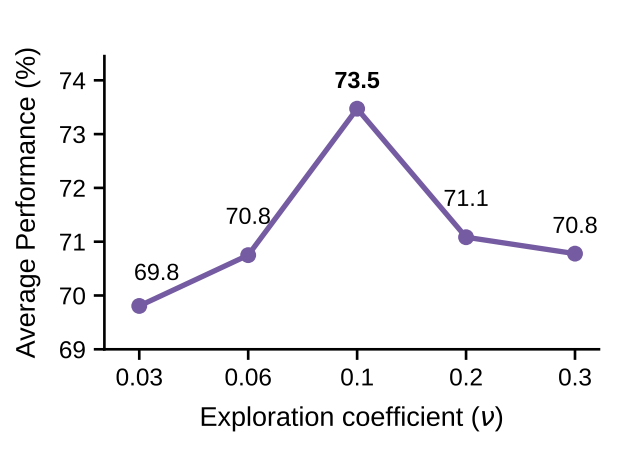 图:LinearUCB 探索系数v对系统平均性能的影响分析(当v=0.1时达到最优性能 73.5%)
03
基于轨迹证据演化,
告别全局重写的盲目消耗
老虎机算法解决了“选谁评估”的效率问题,但候选技能本身并不会凭空变强。真正推动技能质变的是进化机制。它立足于评估所产生的实战证据,负责对候选技能进行持续的生成、重组与精炼。▎攒够证据再动刀,避免频繁消耗 Token
为了避免高频调用高昂的 LLM 去频繁重写技能,进化机制并非逐轮触发,而是采用了对数调度策略,例如在第 3、6、9、13、19……次迭代时按需触发。据卢平琛介绍,随着演练推进,老虎机本身已能建立起相对准确的预测逻辑,老虎机的预测结果也能逐渐收敛到好的候选技能上,因此后期并不需要高频补充新技能。这种“前期密集、后期稀疏”的演化节奏,让团队得以在积攒了足够的实战轨迹证据后才精准“动刀”,从而大幅降低了 Teaching Model 的调用频次与 Token 消耗。▎三种演化算子:保守微调与结构保护
每次进化更新时,算法淘汰评估得分最低的m个技能,并由以下三种算子生成新技能填补空缺:1.再生算子(Regeneration):直接从初始无技能的执行轨迹中归纳全新的独立策略,不依赖现有父代,为种群引入全新的探索方向。卢平琛提到:2.轨迹变异(Rollout Mutation):针对当前轮次评估的技能,采样其最新的成功与失败案例,仅做局部的针对性修正。3.交叉重组(Crossover):对比历史高绩效与低绩效技能,以其中一个高分技能为“骨架”,吸收成功经验并规避已知失败模式。该过程无需目标智能体重新评估,属于“零成本”重组。除了算子设计,团队在技能的修改幅度上也展现出了极强的工程克制。不同于许多同类工作让 LLM 对技能进行全局重写或过度融合,团队在实验中发现,大面积修改极易破坏原技能中已生效的优良结构,从而引发性能震荡。卢平琛强调:若整个框架只能保留一个算子,再生算子无疑是绝对核心,因为初始技能种群正是基于它构建而来的。
对于轨迹变异与交叉重组算子,我们以现有技能或高分技能为骨架,进行少量、保守的局部修改,这样才是稳定可控的。
04
实测验证:
性能全面超越,优化开销直接腰斩
为了全面验证 COBRA-Skills 的泛化能力,论文在 6 个异构的智能体基准上进行了评估。这些任务覆盖的维度相当广泛: - SearchQA:开放域问答;
- SpreadsheetBench:电子表格自动化操作;
- DocVQA:文档图像理解;
- LiveMath:研究级复杂数学推理;
- SocialMaze:社会推理与隐藏角色推断;
- ALFWorld:具身环境中的多步决策。
▎突破性能上限,中小模型“补强效应”尤为突出
在三个不同能力梯队的目标模型上,COBRA-Skills 均取得了最高平均性能。相比无技能基线,它在 Qwen、GPT-Nano 和 Gemma 上分别大幅提升了 13.1、26.9 和 22.5 个百分点。数据表明,优质技能对于能力相对较弱的小模型,具有更显著的“补强效应”。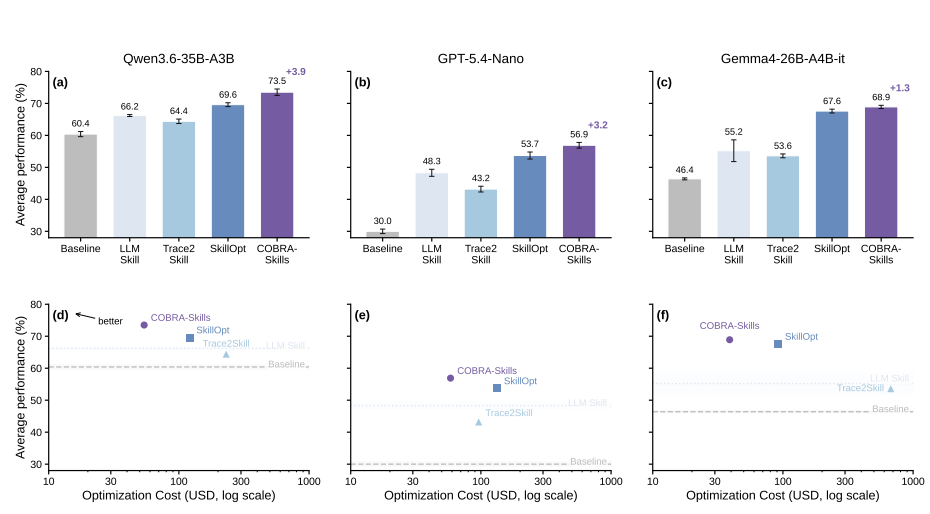 图:COBRA-Skills 与主流方法在不同目标模型上的平均性能(上)及性能与优化成本对比(下)对比实验还显示,即便仅做初始化、不做后续优化的“证据锚定技能基线”,其表现也能稳定超出无技能基线,而 COBRA-Skills 则在此基础上实现了进一步的跨越。值得一提的是,在三个目标模型的实验结果种,COBRA-Skills 并非在所有单项基准上都拔得头筹(例如在Qwen3.6-35B上,SearchQA 上略低于 SkillOpt;在Gemma4-26B上,DocVQA 上优势不明显)。但它的核心优势在于极高的综合鲁棒性。无明显短板,也没有在任何模型上失灵。
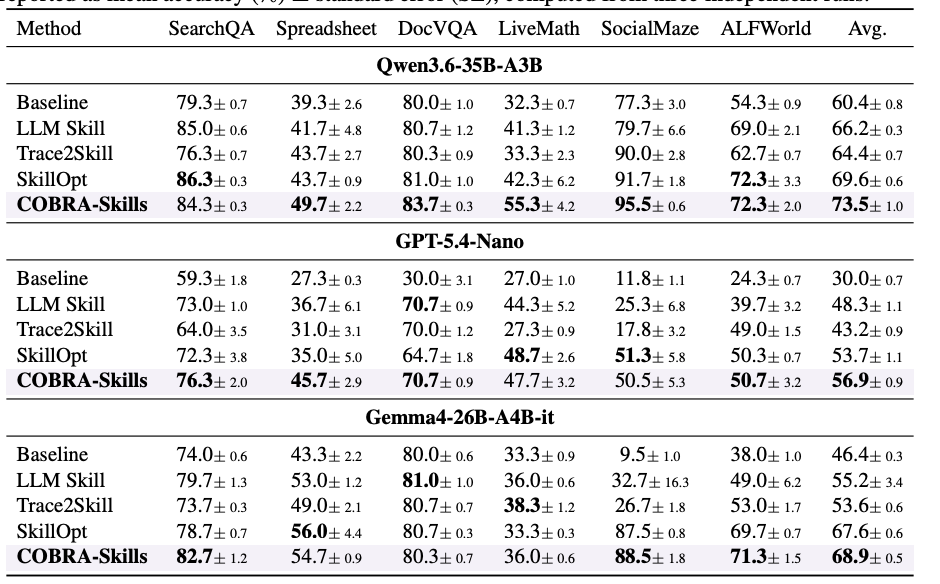 表:COBRA-Skills 与主流方法在 6 个 Benchmark 上的详细性能对比数据在复杂的异构任务场景中,这种“不偏科”的综合稳定性,远比单一任务上的单点突破更具实用价值。
▎教学 Token 节省八成,50 样本撬动高稳定泛化
在成本控制上,与最强基线 SkillOpt 相比,COBRA-Skills 的总优化成本降低了 55%–58%,教学模型的 Token 消耗大幅缩减了 67%–80%,每单位性能提升的成本降低了 60%–69%。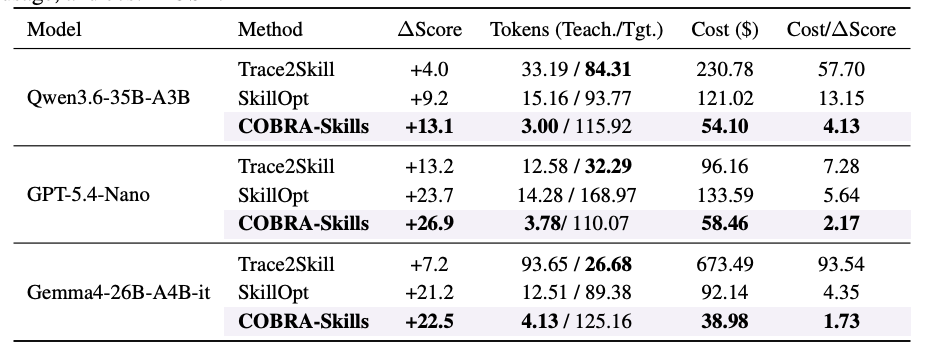 表:COBRA-Skills 与主流方法在 Token 消耗、优化总成本及单位性能成本上的量化对比传统方法往往依赖庞大的样本集进行训练与验证。例如在 SearchQA 上,SkillOpt 官方配置包含 400 个训练样本和 200 个验证样本;SpreadsheetBench 的 Trace2Skill 也使用了 200 个样本。相比之下,COBRA-Skills 在所有基准上统一仅使用 50 个优化样本。 针对这 50 个样本的设计考量,卢平琛解释道:
这 50 例样本在“评估可靠性”与“任务覆盖度”之间取得了极佳平衡:每个候选技能均在这 50 例上完整评估,以获取可靠的排序信号;同时,样本完整保留了基准任务的真实构成,能暴露出多样化的重复模式供技能归纳。样本少不等于信息少,关键在于利用效率。样本太少(如 20 个)会导致分数反馈剧烈震荡,而 50 个样本能提供非常稳定的反馈信号。在具体进化时,我们每次从 50 个样本中随机抽取 8 条执行轨迹作为证据;C₅₀⁸构成了极其庞大的组合空间,既保证了证据的针对性,又为技能生成保留了丰富的多样性与探索空间。
 论文还设计了两组消融实验:1.w/o Bandit(移除老虎机):保留进化机制,但候选筛选改为随机选择,平均性能下降 2.2 分。 2.w/o Evolution(移除进化):保留老虎机机制,但在固定的 30 个技能池中挑选,不生成新技能,平均性能下降 2.4 分。 两者均造成 2 分以上的性能衰退,可见选择性评估分配与候选空间演化互为补充、缺一不可。 此外,论文还设置了 Best-of-30 基线(用同样的证据锚定机制生成 30 个技能,全量评估后取最优解)。结果显示,Best-of-30 比完整方法低了 2.5 分。
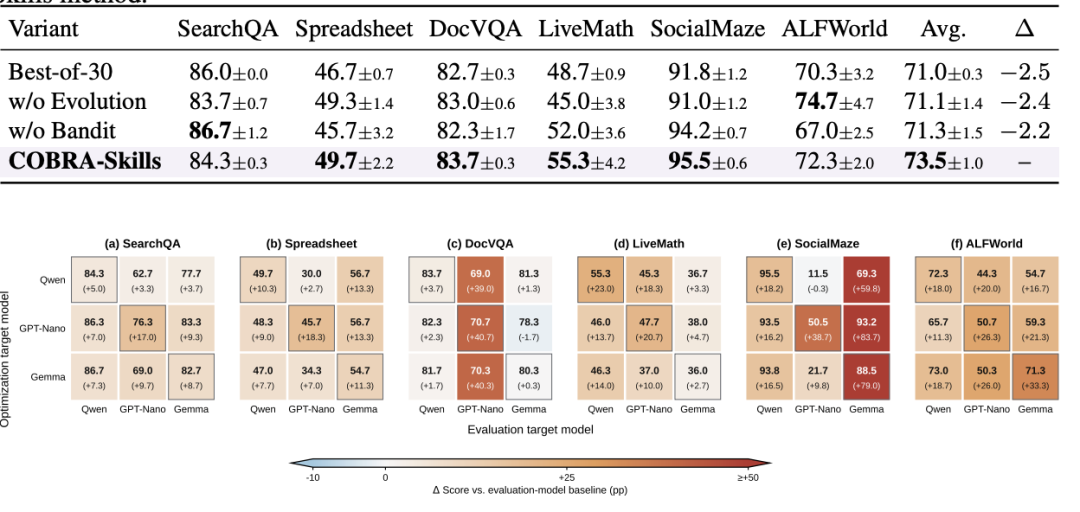 图:消融实验与 Best-of-30 结果对比(上表)及 36 组跨模型技能迁移矩阵热力图(下图)
▎无惧接口切换、离线自教学与跨模型迁移
论文从三个层面进一步验证了方法的泛化韧性。 1.框架适配:将 Qwen 移植至 Claude Code 和 Codex 框架下运行,COBRA-Skills 依然分别取得 68.2 和 72.4 的最高平均分,证明其效果不依赖特定的智能体接口。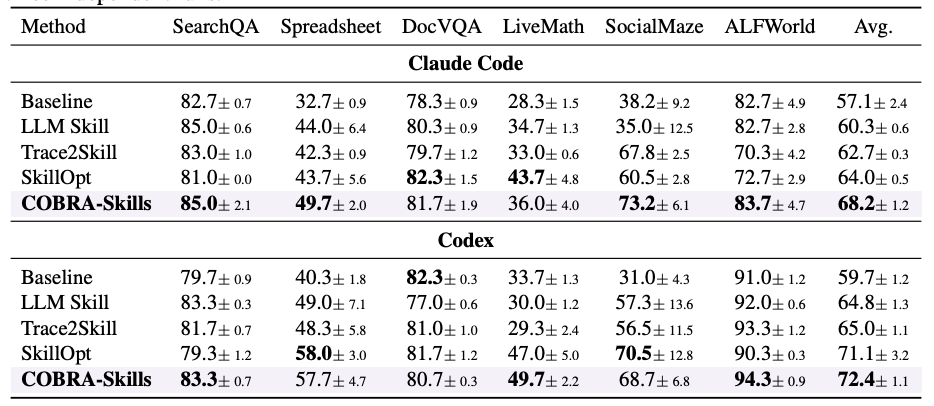 表:COBRA-Skills 在 Claude Code 与 Codex 框架下的跨平台适配性能对比 2.自教学进化:若以目标模型自身取代 GPT-5.5 进行技能生成与精炼,系统平均分仅由 73.5 微降至 72.5,却实现了成本减半,且性能远超同等设置下的 SkillOpt(68.4),展现了离线低成本自教学的巨大潜能。
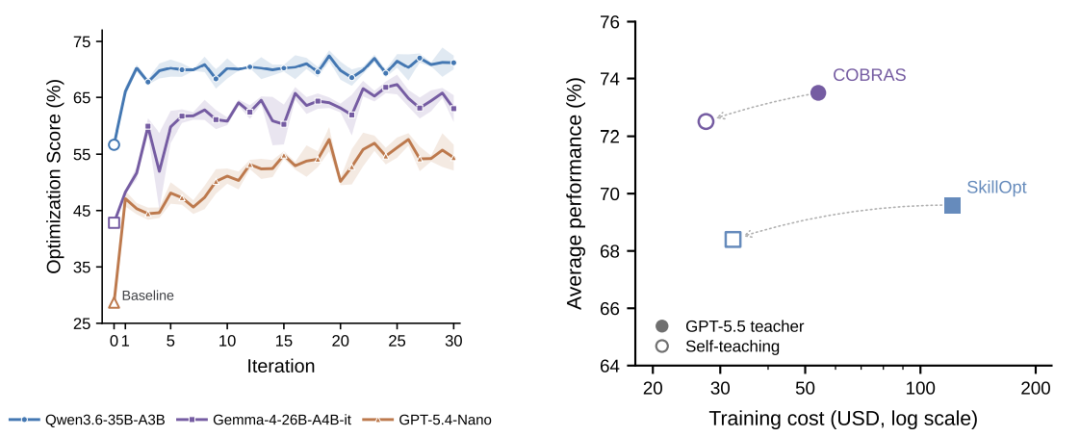 图:迭代收敛过程(左)及自教学模式下的性能与成本对比(右) 3.跨模型复用:将 GPT-5.5 优化的技能库迁移至其他目标模型,36 次迁移中 34 次成功超越基线。这有力地说明,COBRA-Skills 提取的是高泛化性的任务层解题范式,而非与特定模型绑定的 Prompt 技巧。
05
大模型负责创造,
经典算法负责控本
过去一段时间,Agent 领域隐约浮现出一种“大模型全包”的迷信:从任务理解、技能生成,到诊断反思与重写进化,全盘交给 LLM 端到端解决。但这篇论文用一组直观的账单数据,直白地戳破了这种“全能幻觉”。 大模型固然具备惊人的符号生成与语义理解能力,但在处理带预算约束的序列决策、估计统计不确定性,以及计算“算力回报率”这类问题时,它不仅价格昂贵,而且缺乏天然的概率把控力。 COBRA-Skills 最耐人寻味的设计,恰恰在于它的“复古”。团队没有强求大模型凭空判断哪个技能更有价值,而是优雅地引入了决策理论中经过数十年验证的“上下文老虎机”。 这种“传统 ML 负责量化与控本,LLM 负责生成与提纯”的范式融合,为下一代 Agent 的架构设计提供了清晰的示范。06
独家对话:专访第一作者,
拆解工程边界与落地未来
▎AI科技评论:在跨模型迁移实验中,36 次迁移有 34 次成功超越了基线,但有 2 次表现欠佳。这两次“例外”是什么原因造成的?
卢平琛:这两次例外的幅度其实都很小,分别只比对应的无技能基线低约 0.3 和 1.7 个百分点。一个更可能的原因是,不同模型的能力结构、推理习惯和错误模式并不完全一致,因此在一个模型上优化出的 Skill,未必能完全匹配另一个模型最需要的指导方式。当然,这其中也包含少量的随机因素。但总体来看,超过 94% 的成功率证明,优化出的技能抓取的是通用的任务级策略,具备极强的跨模型通用性。▎AI科技评论:从工程落地的角度看,目前 COBRA-Skills 最大的局限性是什么?
卢平琛:目前我们主要聚焦于任务层(Task-level)的技能演进化。从技能自身的结构来看,我们尚未覆盖过于复杂的多技能联动场景。比如像 Claude Code 提出的某些 Skill 结构中,会在执行 SQL 的同时动态调用 Python 脚本,或者通过索引去关联其他 SQL 技能。这种跨工具、多层级的复杂技能联动结构,是我们目前尚未覆盖、也是下一步需要探索的方向。▎AI科技评论:如果将这种“老虎机 + 进化”的思路延伸到其他场景(如 Agent 工具调用、RAG 检索等),你觉得哪种最有可能率先落地?
卢平琛:RAG 领域的相似度检索最有可能率先落地。因为 Skill 的标准结构本身就包含 Title(标题)、简短 Description(描述)以及 Body(正文)三部分。在实际业务中,大量 Agent 正是依赖那句简短 Description 进行索引与匹配的,这与我们当前的优化框架天然契合。▎AI科技评论:如果用一句话来概括这篇论文最核心的贡献,你会怎么总结?
卢平琛:高效、低成本地优化 Agent 的 Skill,让智能体演化不再被昂贵的账单拖垮。
为了方便大家抱团交流、互通会议消息,我们专门建了 ECCV 2026 参会交流群!进群你会解锁这些「福利」?
会议情报站:投稿 DDL、格式规范、评审进度……关键节点第一时间送达,再也不怕错过 deadline,投稿准备稳稳的。
同行茶话会:天南海北的同行都在群里,聊心得、碰思路、攒人脉,科研路上我们同行。
前沿补给站:最新研究成果、热点方向实时同步,结合会议主题帮你捋清投稿脉络,给论文灵感加满油。
现场后援团:(会议期间专属开启):到了会场也不用慌——
路线导航:场馆分布、报告厅怎么走,群里随时问;
议题共读:热门 session、Keynote 现场探讨,错过也能追;
Poster 汇编:现场海报精华整理,一键收藏不遗漏;
约局广场:约饭局、采访局、交流局……想唠嗑、想合作、想面基,群里发起就成。
? 进群传送门: 扫码进群或添加微信Qvv0909777,备注:ECCV + 单位/学校+姓名+方向。
搞科研/搞技术,信息差很重要。
来,一起快人一步!
上车,带你看遍全球 AI 顶会精华
可独家畅览:
专家演讲PPT
大会报告全文
热门论文解读
学术新星访谈

扫描上方二维码
或点击「阅读原文」关注专区。
雷峰网原创文章,未经授权禁止转载。详情见转载须知。