
不写代码、不要聊天、AI跑得比大模型快 200 倍:Jev 把"判断"这件事切了出来
不写代码、不要聊天、AI 跑得比大模型快 200 倍:Jev 把"判断"这件事切了出来
潮流科技爱好者深度解读"所有大模型都在卷"能写多长代码、能聊多少轮",Jev 只做选择。"
一一、名字都不像模型:TypeSafe 拿到 1.2 亿 Token 启动包,Jev 直接开放
9 月下旬,一款叫 Jev 的 AI 在 Hacker News 上连霸三天榜首。注册用户打开 TypeSafe 官网,立刻拿到 5 美元额度——折合约 1.2 亿 Token。输入端每百万 Token 仅 0.042 美元,输出端免费,这个定价直接抹掉了输出成本。
很多人误以为 Jev 又是一个聊天机器人。点开产品页才发现,Jev 不生成完整句子。它只会返回三种形态:Choice(多选一)、Score(0–255 分)、Noul(带置信度的类型化答案)。每条结果后面都跟一个置信度分数,用户可以直接当结构化数据喂给下游系统,连 prompt 工程都不用写。
上线当周,Vercel 把原来的分类器全部换成 Jev,整体提速 5–18 倍。API 在第三天短暂宕机,原因是上线后调用量远超预期,TypeSafe 后端没顶住脉冲。这家公司连产品介绍都写着"端到端延迟 70—500 毫秒"——这是含网络往返、网关处理、模型推理、置信度校验在内的完整链路。同样的任务让 LLM 来做,光推理就要 1.5–15 秒,是 Jev 的 20–200 倍。
二二、不是又一个开源套壳:Jev 是个"只做判断"的全新物种
AI 圈最近密集冒出一批"不写代码的 AI"。它们的技术路线高度收敛,但产品形态各不相同:
- 前 OpenAI 研究员 Diogo Almeida 做了 System 1 模型,号称比 LLM 快 200 倍、便宜 400 倍、零幻觉——因为它根本不生成自由文本。
- LangChain 把"decision models"单独拎出来,建了一个叫 LangSmith Gateway 的产品类目,创始人 Harrison Chase 把它放到了导航栏的第一位。
- Jared Palmer 开源 Kev——基于 Qwen3.5 的微型决策模型家族,提供 0.8B/4B/9B 三个尺寸,单机就能跑,单卡就能微调。GitHub 一天冲上 2400 星,HN 评论区挤满了"我为什么没早想到"的声音。
这些团队的方向高度一致:不卷参数,也不再卷"通用"。他们只解决一件事——"判断"。
LLM 像一个读完所有百科全书的全才博士,你让他做选择题,他也能做——只是要先和你寒暄三段话、再写一段长文解释,最后才慢吞吞给出答案。Jev 这类模型像一个只接受过"分类"训练的质检员:你给它一段文字和几个问题,它只回结构化分数,绝不多说一个字。当任务边界足够窄,模型的"减法"比"加法"更有价值。
三三、三组数字打脸:为什么 LLM 干判断这件事是浪费
第一,速度差 200 倍。▍LLM 一次完整 forward pass 要经过数千亿参数的激活,单条判断请求 200 毫秒打底。Jev 的端到端延迟 70—500 毫秒看似不快,但它指的是**整条链路**——含网络往返、网关处理、模型推理、置信度校验。LLM 同样任务,光推理就要 1.5–15 秒。一个 Agent 系统调用 10 次判断任务,总延迟差距能从几秒拉到几分钟。第二,价格差 400 倍。▍LLM 按 token 计费,输入输出双向收费。Jev 输入端每百万 Token 0.042 美元,**输出端直接不收费**——因为它不生成文本,只返回结构化字段。一条分类请求的成本不到 0.0001 美元。一个月跑 1 亿次判断,LLM 的账单可能 50 万美元起步,Jev 不到 5000 美元。第三,幻觉率为零。▍LLM 必然要"猜"下一个 token,幻觉是数学结构性的副产品——你不让它猜,它就不会说话。Jev 输出的不是 token,是带置信度的离散标签。当置信度低于阈值,它会主动返回"不知道"或"需要人工复核"——**这从机制上消除了幻觉**。对生产系统而言,"知道不知道"比"答对答错"更重要。结果就是:判断这件事,Jev 用 1/200 的时间、1/400 的钱、产出 0% 幻觉的结果。这不是渐进式优化,是数量级的代差。
四四、决策模型的技术核心:小模型 + 类型化输出 + 置信度
Jev 的架构其实不复杂。剥开产品包装,它的技术栈清晰得让人意外:
- 底座是个 7B–13B 的小模型,够用就好,不追求通用能力。决策任务根本不需要读完所有维基百科。
- 输出层被强制改写为"类型化标签":Choice、Score、Noul 三种形态,禁止生成自由文本。模型结构上就直接关闭了"自由生成"这个开关。
- 每条标签都附带置信度分数,下游系统可以基于阈值触发"转人工"、"走兜底逻辑"或"二次重试"。这是和 LLM 最大的区别——LLM 输出的是"看起来合理的话",Jev 输出的是"带置信度的结构化判断"。
- 训练数据是窄分布的标注集——分类、路由、评分、打分,不需要万亿 token。几万到几十万条高质量标注就够训练一个垂直领域的决策模型。
这套架构解决了一个根本矛盾:LLM 是用"通用智能"换"判断准确率"。当任务只是"这一段文本是正面还是负面"、"这个 bug 应该分给前端还是后端",通用智能完全是浪费——你花的钱 95% 用来生成一段漂亮解释,只剩 5% 用来回答真正的问题。
决策模型本质是"窄智能"▍:把任务边界划死,把输出空间压缩到几个离散标签,再用置信度给出"留退路"。它牺牲了通用性,换来了确定性、低成本和零幻觉。五五、已经上岗:浏览器代理、模型路由、安全分类,Jev 正在替代 LLM
判断模型不是 demo 玩具,已经在生产环境大规模跑:
- 浏览器代理:复杂 Agent 调用 LLM 之前,先用 Jev 判断"这一步该不该调用 LLM"。这一步的判断失误率直接决定整个 Agent 的成本结构——LLM 一秒钟成本 0.01 美元,调用错了就白扔。
- 上下文压缩:Jev 给一段长文本打分,告诉你"前 30% 包含 90% 关键信息",让 LLM 只读压缩后的版本。同样准确率,token 消耗下降一个数量级。一份 10 万 token 的合同,压缩后 1 万 token,LLM 成本降 90%。
- 模型路由:用户的请求先过 Jev,判断该路由到 GPT-5.6 还是 Claude Fable 5.1,响应延迟下降 35%,成本下降 60%。强任务走强模型,弱任务走弱模型,整体性价比最优。
- 安全分类:内容审核、Prompt 注入检测、违规识别——这些任务天然就是分类问题,用 LLM 是用大炮打蚊子。Jev 替换后,识别速度提升 8 倍,成本下降 95%。
Vercel 的实践最有说服力:他们把原本基于 LLM 的分类器全换成 Jev,整体提速 5–18 倍。一家头部 PaaS 厂商愿意动生产链路,证明 Jev 已经过了工程验证门槛——不是论文数字,是线上 SLA。
更关键的是部署形态:决策模型几乎都支持本地化部署。7B 参数量化后只要 4GB 显存,普通消费级显卡就能跑。这意味着企业可以把决策模型放在自己机房,数据不出内网,合规成本接近零——对金融、医疗、政务这类强监管行业,这是决定能不能上线的关键门槛。
六六、AI Agent 范式分裂:通用模型做"主脑",决策模型做"小脑"
这场变革的真正信号不是 Jev 一个产品,而是 AI Agent 的内部架构正在分裂:
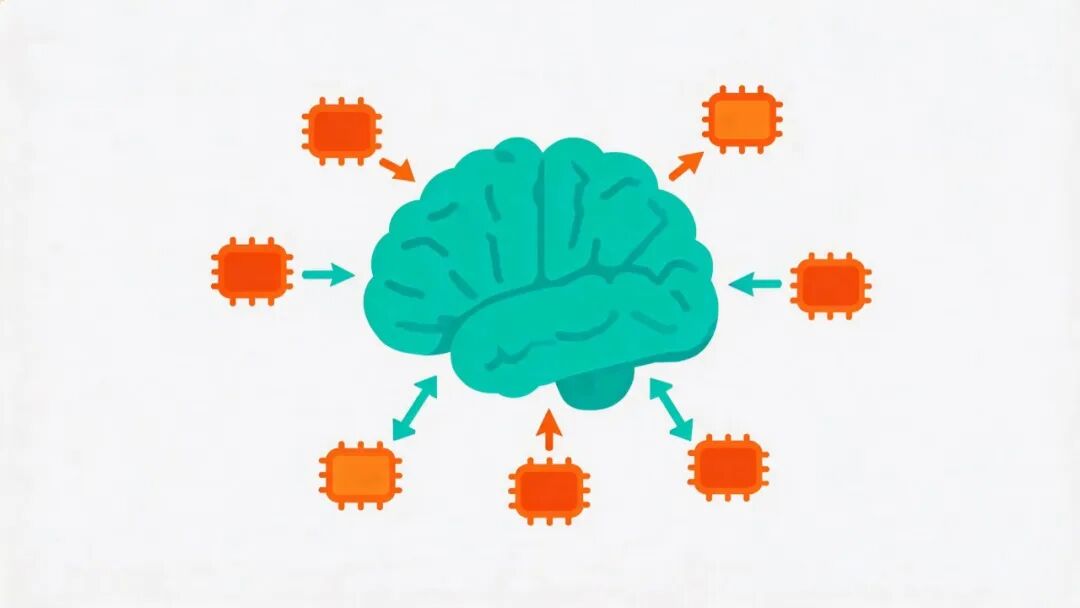
过去▍——一个 LLM 包打天下:理解指令、做计划、调工具、写代码、做反思,全靠一个通用大脑。结果是"判断"和"生成"挤在同一条算力链上,成本居高不下。现在▍——任务被拆成两类:**生成类任务**(写代码、写文档、写邮件)继续用大模型;**判断类任务**(路由、分类、评分、过滤)改用决策模型。这套新架构有清晰的命名:主脑 + 小脑。主脑负责"想事情、造东西",小脑负责"看情况、做选择"。一个 70B 的主脑,配 5 个 7B 的小脑,整体成本能压到原来 1/5,延迟压到 1/3。
更深层的信号是基础设施层面:LangChain 把"decision models"单独建了产品类目,意味着 AI 中间件厂商开始把它当成独立赛道包装。决策模型正在从"LLM 的小工具"变成"AI 系统的标准组件"。当年消息队列从"数据库的一个功能"独立成 Kafka 是同一种逻辑——当一个组件的使用频率高到一定程度,它就值得变成独立品类。
七七、当 AI 不再卷参数,下一场战争在"判断"的精度
Jev 这类产品揭示了一个被忽视的事实:大模型的边际成本 80% 花在了"判断"上,只有 20% 花在了"生成"上。但业务侧真正付钱的,恰好是那 20%——用户要的是结果,不是推理过程。
下一个赛点不是"谁的模型参数更大",而是"谁的判断更准、置信度更可信、集成更顺"。TypeSafe 把置信度做成产品护城河,LangChain 把决策模型做成新类目,Kev 把它开源到单机可跑——整条赛道已经拉开架势。
对创业者来说,这意味着三个机会:第一,做垂直行业的判断模型(医疗诊断分诊、法律文书分类、金融风险标记);第二,做决策模型的训练数据平台(标注质量决定模型上限);第三,做决策模型的运维工具(监控、漂移检测、A/B 测试)。大模型的红利期过了,决策模型的窗口期刚开。
大厂也在补位:OpenAI、Anthropic、Google DeepMind 都在内部尝试把"判断"任务从主模型里剥离出来,独立训练专精模型。Anthropic 的 Claude Fable 5.1 在分类任务上比通用 Opus 版本准确率高 12%,延迟低 60%——这是同一公司内部"通用 vs 专精"的成本账已经算清楚了。
回到开头那个问题:当 AI 不再写代码、不再聊天、不再卷参数,它还能干什么?Jev 给出的答案是——专门做你最不想让 AI 写废话的那件事。