Claude 如何为 AI 生成文本添加水印
前几天我发了一条 Substack 笔记,聊了聊 Claude 新推出的文本水印方案及其实现。这个话题很热门,讨论也很热烈,所以我想进一步展开,详细讲讲它的原理。
这次没有写成常规文章,而是录制了一期小讲座(换个花样)。下面是视频和对应的文字稿。
原本计划做 10 页幻灯片,录一个 10 分钟的短视频。结果整理过程中不断补充关键细节,最后变成了 50 多页幻灯片、48 分钟的录制。
希望这次能把原理讲清楚。祝观看愉快!
如果你更喜欢用 YouTube 播放器,这里有YouTube 版本
幻灯片下载链接在此
视频文字稿
说明:以下文字稿经过少量编辑和润色以方便阅读,但保留了视频讲座的整体顺序和脉络。
Claude 文本水印的工作原理
大家好。几天前,Anthropic 宣布将为 Claude 模型输出的文本添加水印。我当时在社交媒体上发帖简单解释了它的原理,反响挺热烈的——火倒不是水印本身,而是背后的解释和机制。考虑到那条帖子只有一张图,还引出了不少问题和讨论,所以值得展开来讲,把细节说清楚。
于是我想,那索性再多画几张图吧。我原本的计划是只做大约 10 页幻灯片,带大家过一遍流程。结果居然做成了 50 页,但我相信这些内容能清晰解释水印机制的原理、水印如何失效或被移除等问题。我认为这个话题挺有意思,因为如今很多人都在使用 LLM,同时也消费着大量可能由 LLM 生成的互联网文本。
现在会出现这种水印技术,大家可能会担心它降低文本质量,或者疑惑水印的实际好处是什么,它到底意味着什么。我觉得如果能更好地理解水印的本质,就能消除大部分疑虑,也便于我们自行判断这是好是坏,权衡其利弊。
所以,我的目标真的是解释清楚其底层机制,以及如何实现这种文本水印。
这也是一个很好的例子,可以说明从头理解事物为何如此有用。这种水印技术也恰好能解释传统模型或 LLM 在底层是如何工作的。没错,你们可能知道我喜欢“从零开始”做事。比如我的书:《从零构建大语言模型》、《从零构建推理模型》,还有一些标注为“从零开始”的文章。
对我来说,“从零开始”通常包括编码。这次的内容与代码无关,但从零编写代码确实是一项非常有用的技术,因为它能帮你真正理解某件事是如何实现的。由此出发,我们才能推导出理解、图表和概念。因为如果我们不真正动手实现,没有代码,很多时候事情就会模棱两可。当然,我也意识到,现在已经不是每个人都从零开始写代码了。
想当年,代码全靠人手写,从零开始造轮子是唯一的办法。如今 LLM 已经能写代码了,但这并不意味着读代码就没用了——代码里包含大量信息。就拿本文讲的水印技术来说,花时间从零实现过一个 LLM,你才能真正明白内部的采样是怎么做的。我们后面也会给出相关的代码片段。
这反过来能帮助我们理解:哦,原来水印是在这个位置加上的,它会带来这样那样的影响。所以我觉得,尽管现在人们不再总是从零写代码了,但从头构建一些东西仍然有价值——既能在教育层面深入理解原理,也能在研究层面以透明的方式对其进行修改,而不是把一切藏在层层抽象之下。
不过抛开这些不谈,这里算是个巧合的美好呼应:这份幻灯片里其实用了不少我「从零实现」系列教程里的图。
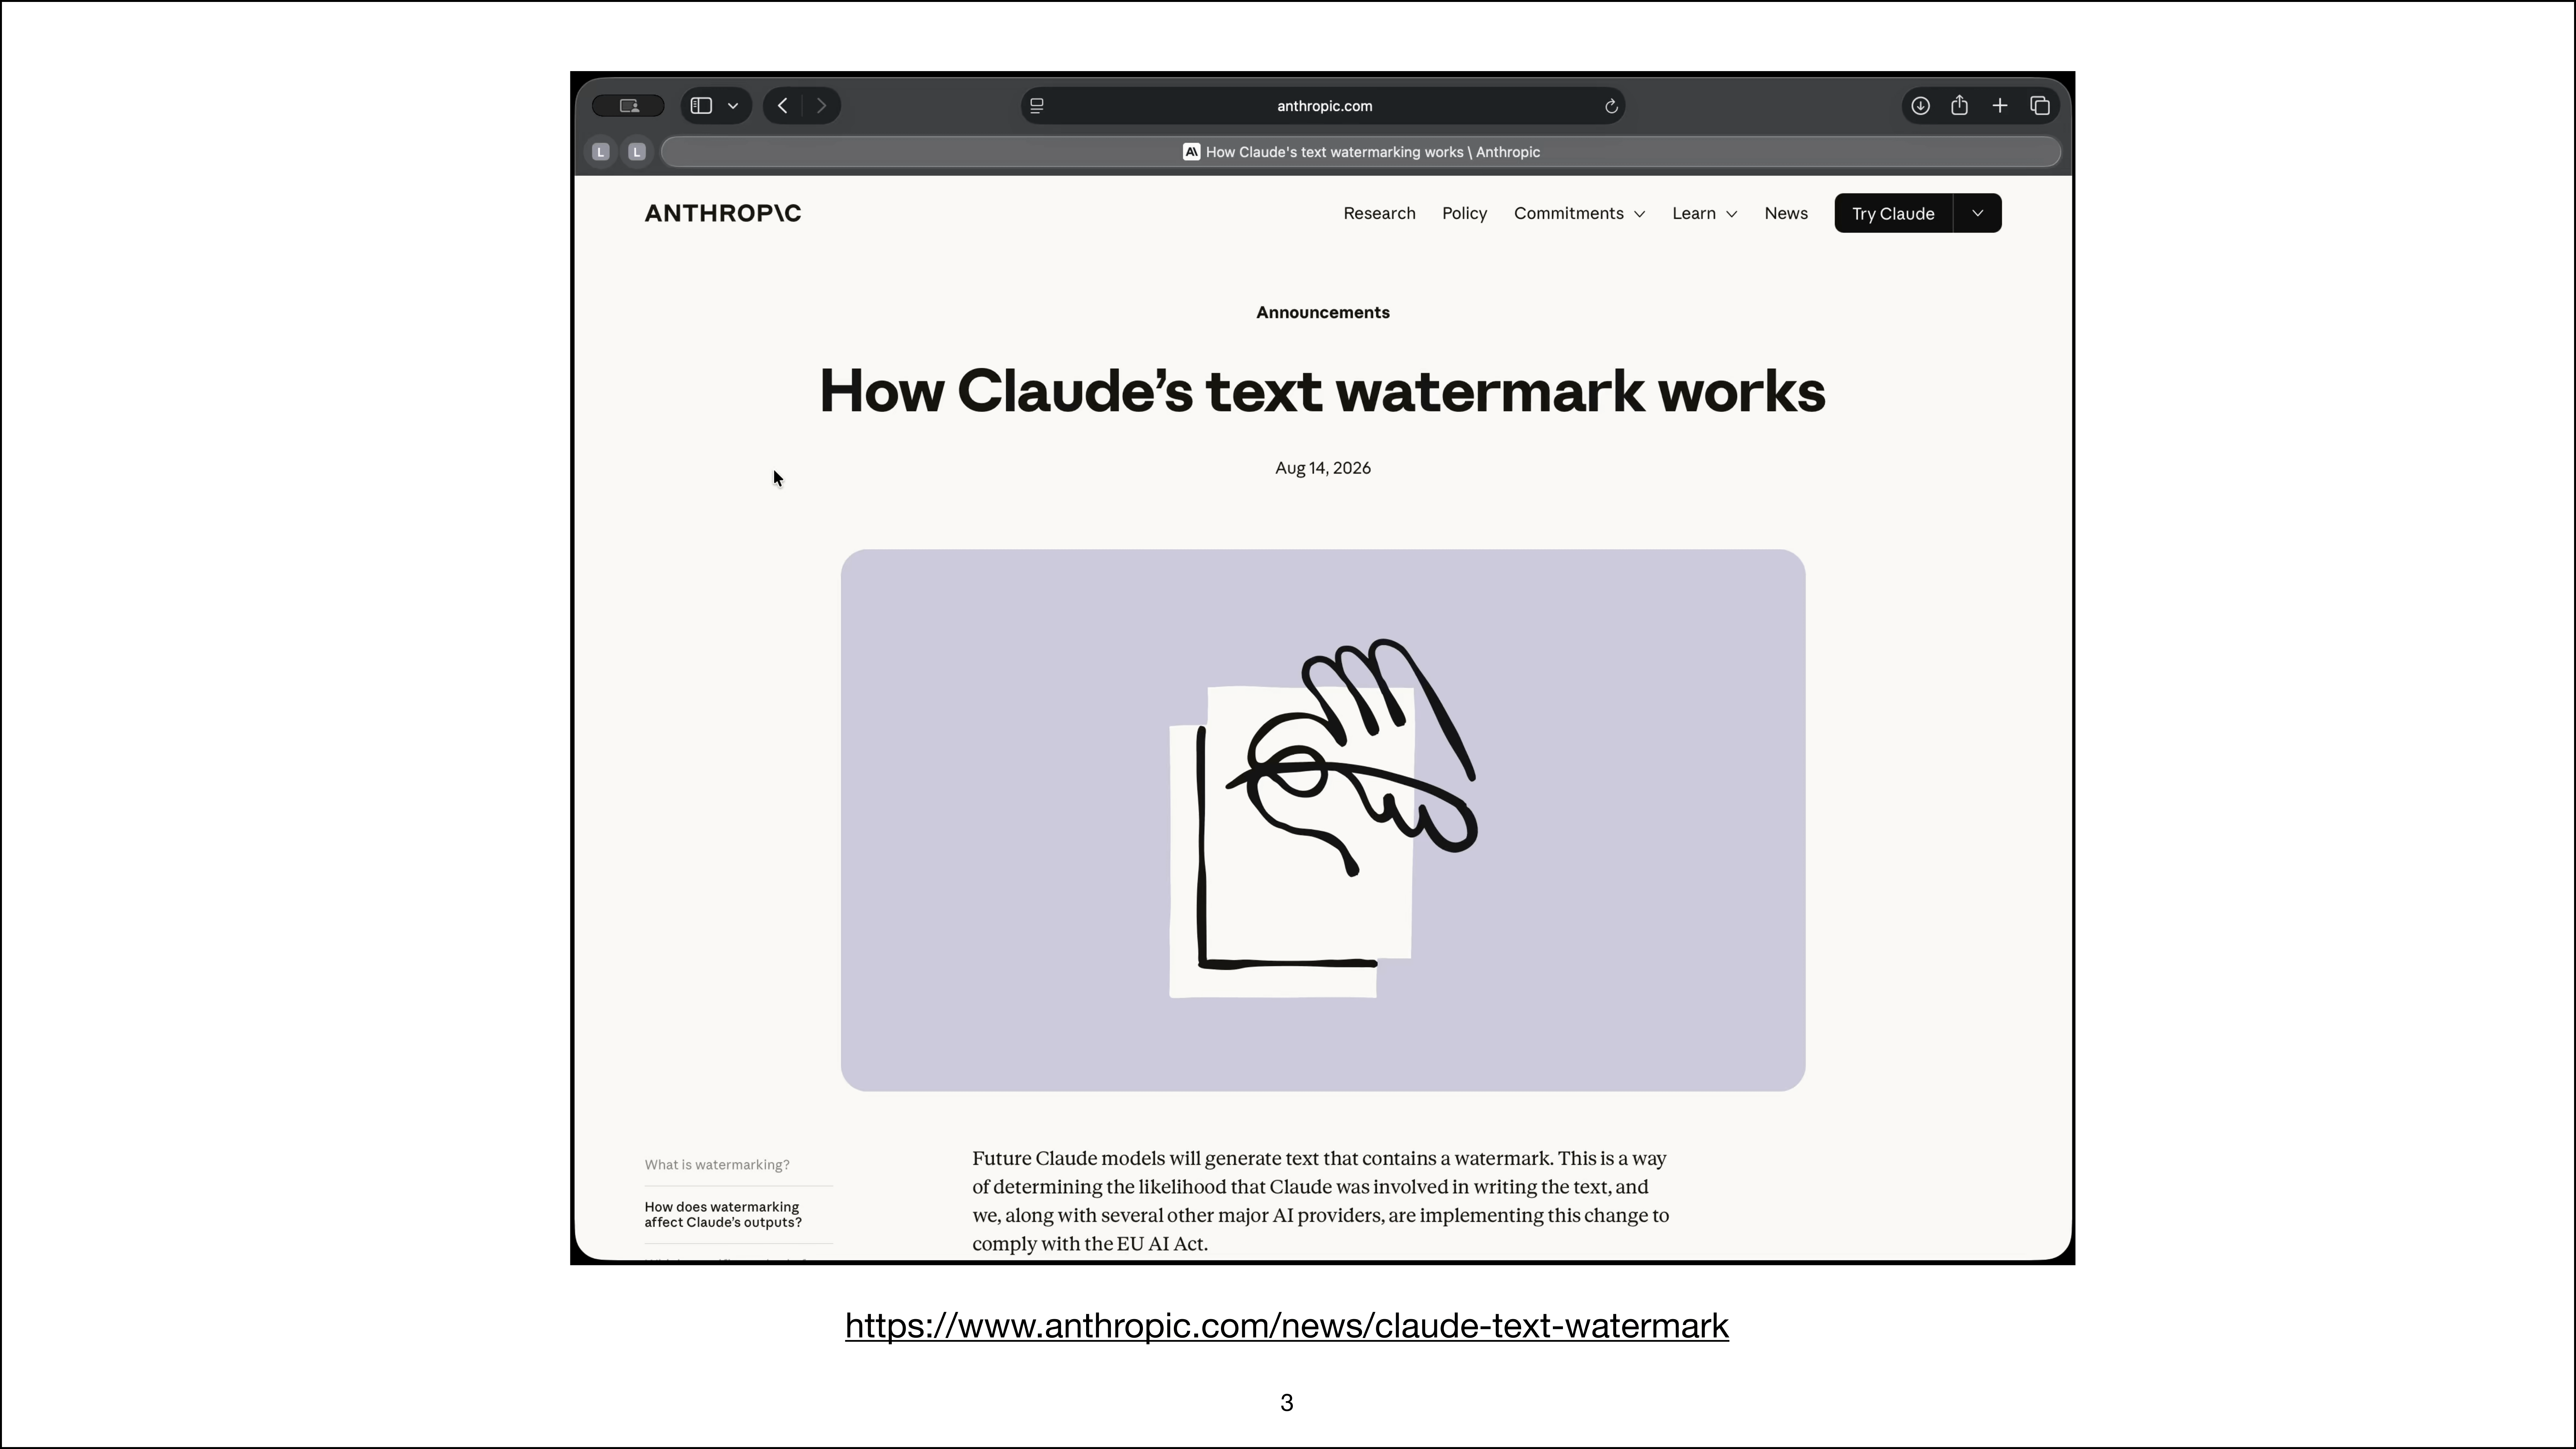
几天前(8 月 14 日),出了一篇文章《How Claude’s Text Watermark Works》,就是这篇。它基本上是个屏幕录制形式的内容,把幻灯片里的东西都放了出来,细节相当丰富。而且后来还更新了好几版——我最初读的时候比现在短得多。不过它还是比较偏概念性,有个总体概述,而且一整篇文章里连一张图都没有。
所以,他们到底想做什么,其实还是不太好琢磨。他们花了很多篇幅解释为什么要这么做,却对“怎么做”避而不谈。文中某处链接了一篇论文,但那篇论文技术含量极高。因此,我觉得很有必要退一步,从头讲起,这样才能更好地理解他们想通过这种水印技术实现什么。
顺带一提,引入水印的核心动机,是让他们能够识别出某段文本是否由他们的模型生成。比如,当有人发布了一段文字,他们可以据此断定:“哦,这段文字是我们 Claude Opus 4.8 模型生成的。” 也就是说,只要文本中嵌入了这种水印,他们就能判断出这是 AI 生成的内容。而且,这种水印对用户是隐形的,只有他们自己能解码,从而验证文本是否带有水印。
为什么只有他们能做到?这一点我们会在后面(希望视频不会太长的情况下)详细解释,我们一步步来。
LLM 文本生成的工作原理
我想先简单做个铺垫,解释一下 LLM 中的文本生成是怎么运作的。有了这个基础,大家就能更轻松地理解水印是如何工作的——实际上,它并非一个额外昂贵的复杂模块,充其量只是在常规文本生成流程中做了一点轻微的调整。
举个例子,当我们在 ChatGPT 里输入“德国首都是什么”,这类 LLM 就会像示例中那样回答“柏林”。实际上它生成了两个 token,分别是“柏林”和句号。为了简化说明,我们假设这里只生成了一个 token,即下一个 token 是“柏林”。那这个 token 内部是如何生成的呢?
当我们输入“德国首都是什么”并收到“柏林”这个 token 时,幕后到底发生了什么?底层的实际运行机制是怎样的?
接下来几页,我会简单讲讲生成下一个 token 时底层发生了什么。
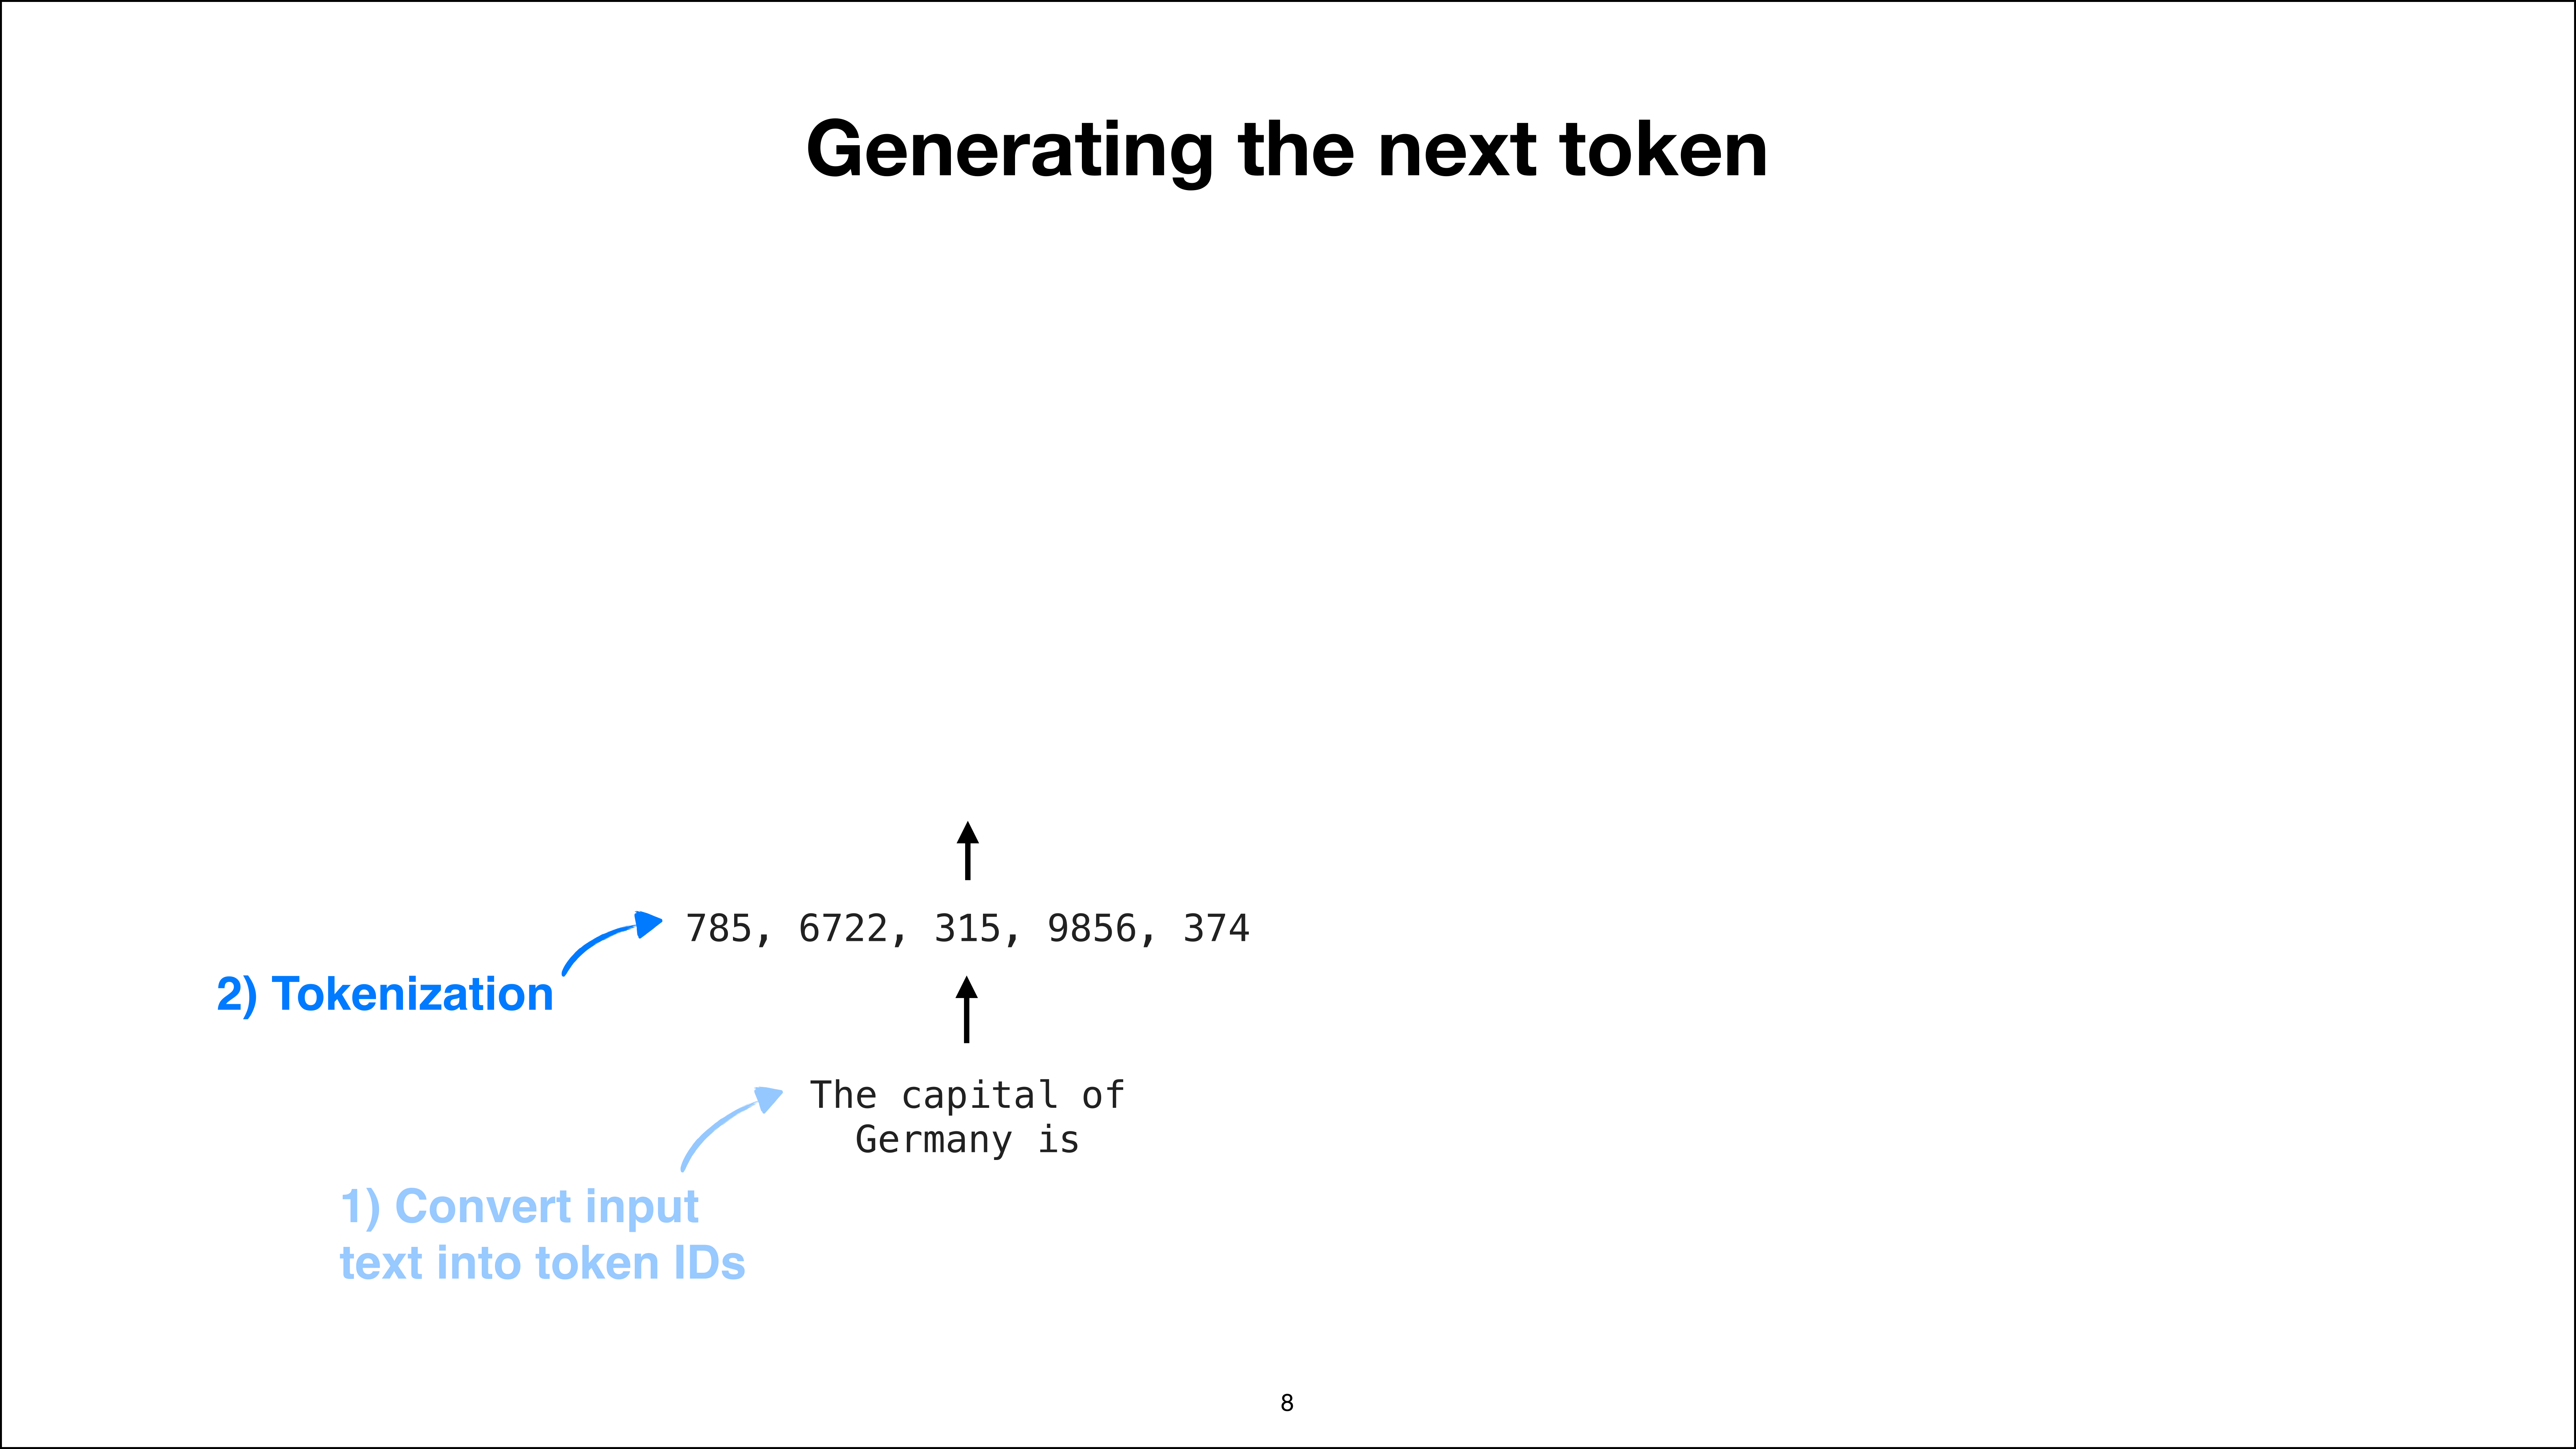
假设我们的提示词依然是“德国首都是”。这里的第一步是将文本转换为 token ID。分词(tokenizing)并将其映射为 token ID 是初始阶段的核心环节之一。这一步发生在 LLM 外部,而非内部。我们只是将文本转换为一种 embedding 层能够处理的格式。
随后,数据进入 LLM。LLM 会输出下一个 token 的分数分布。
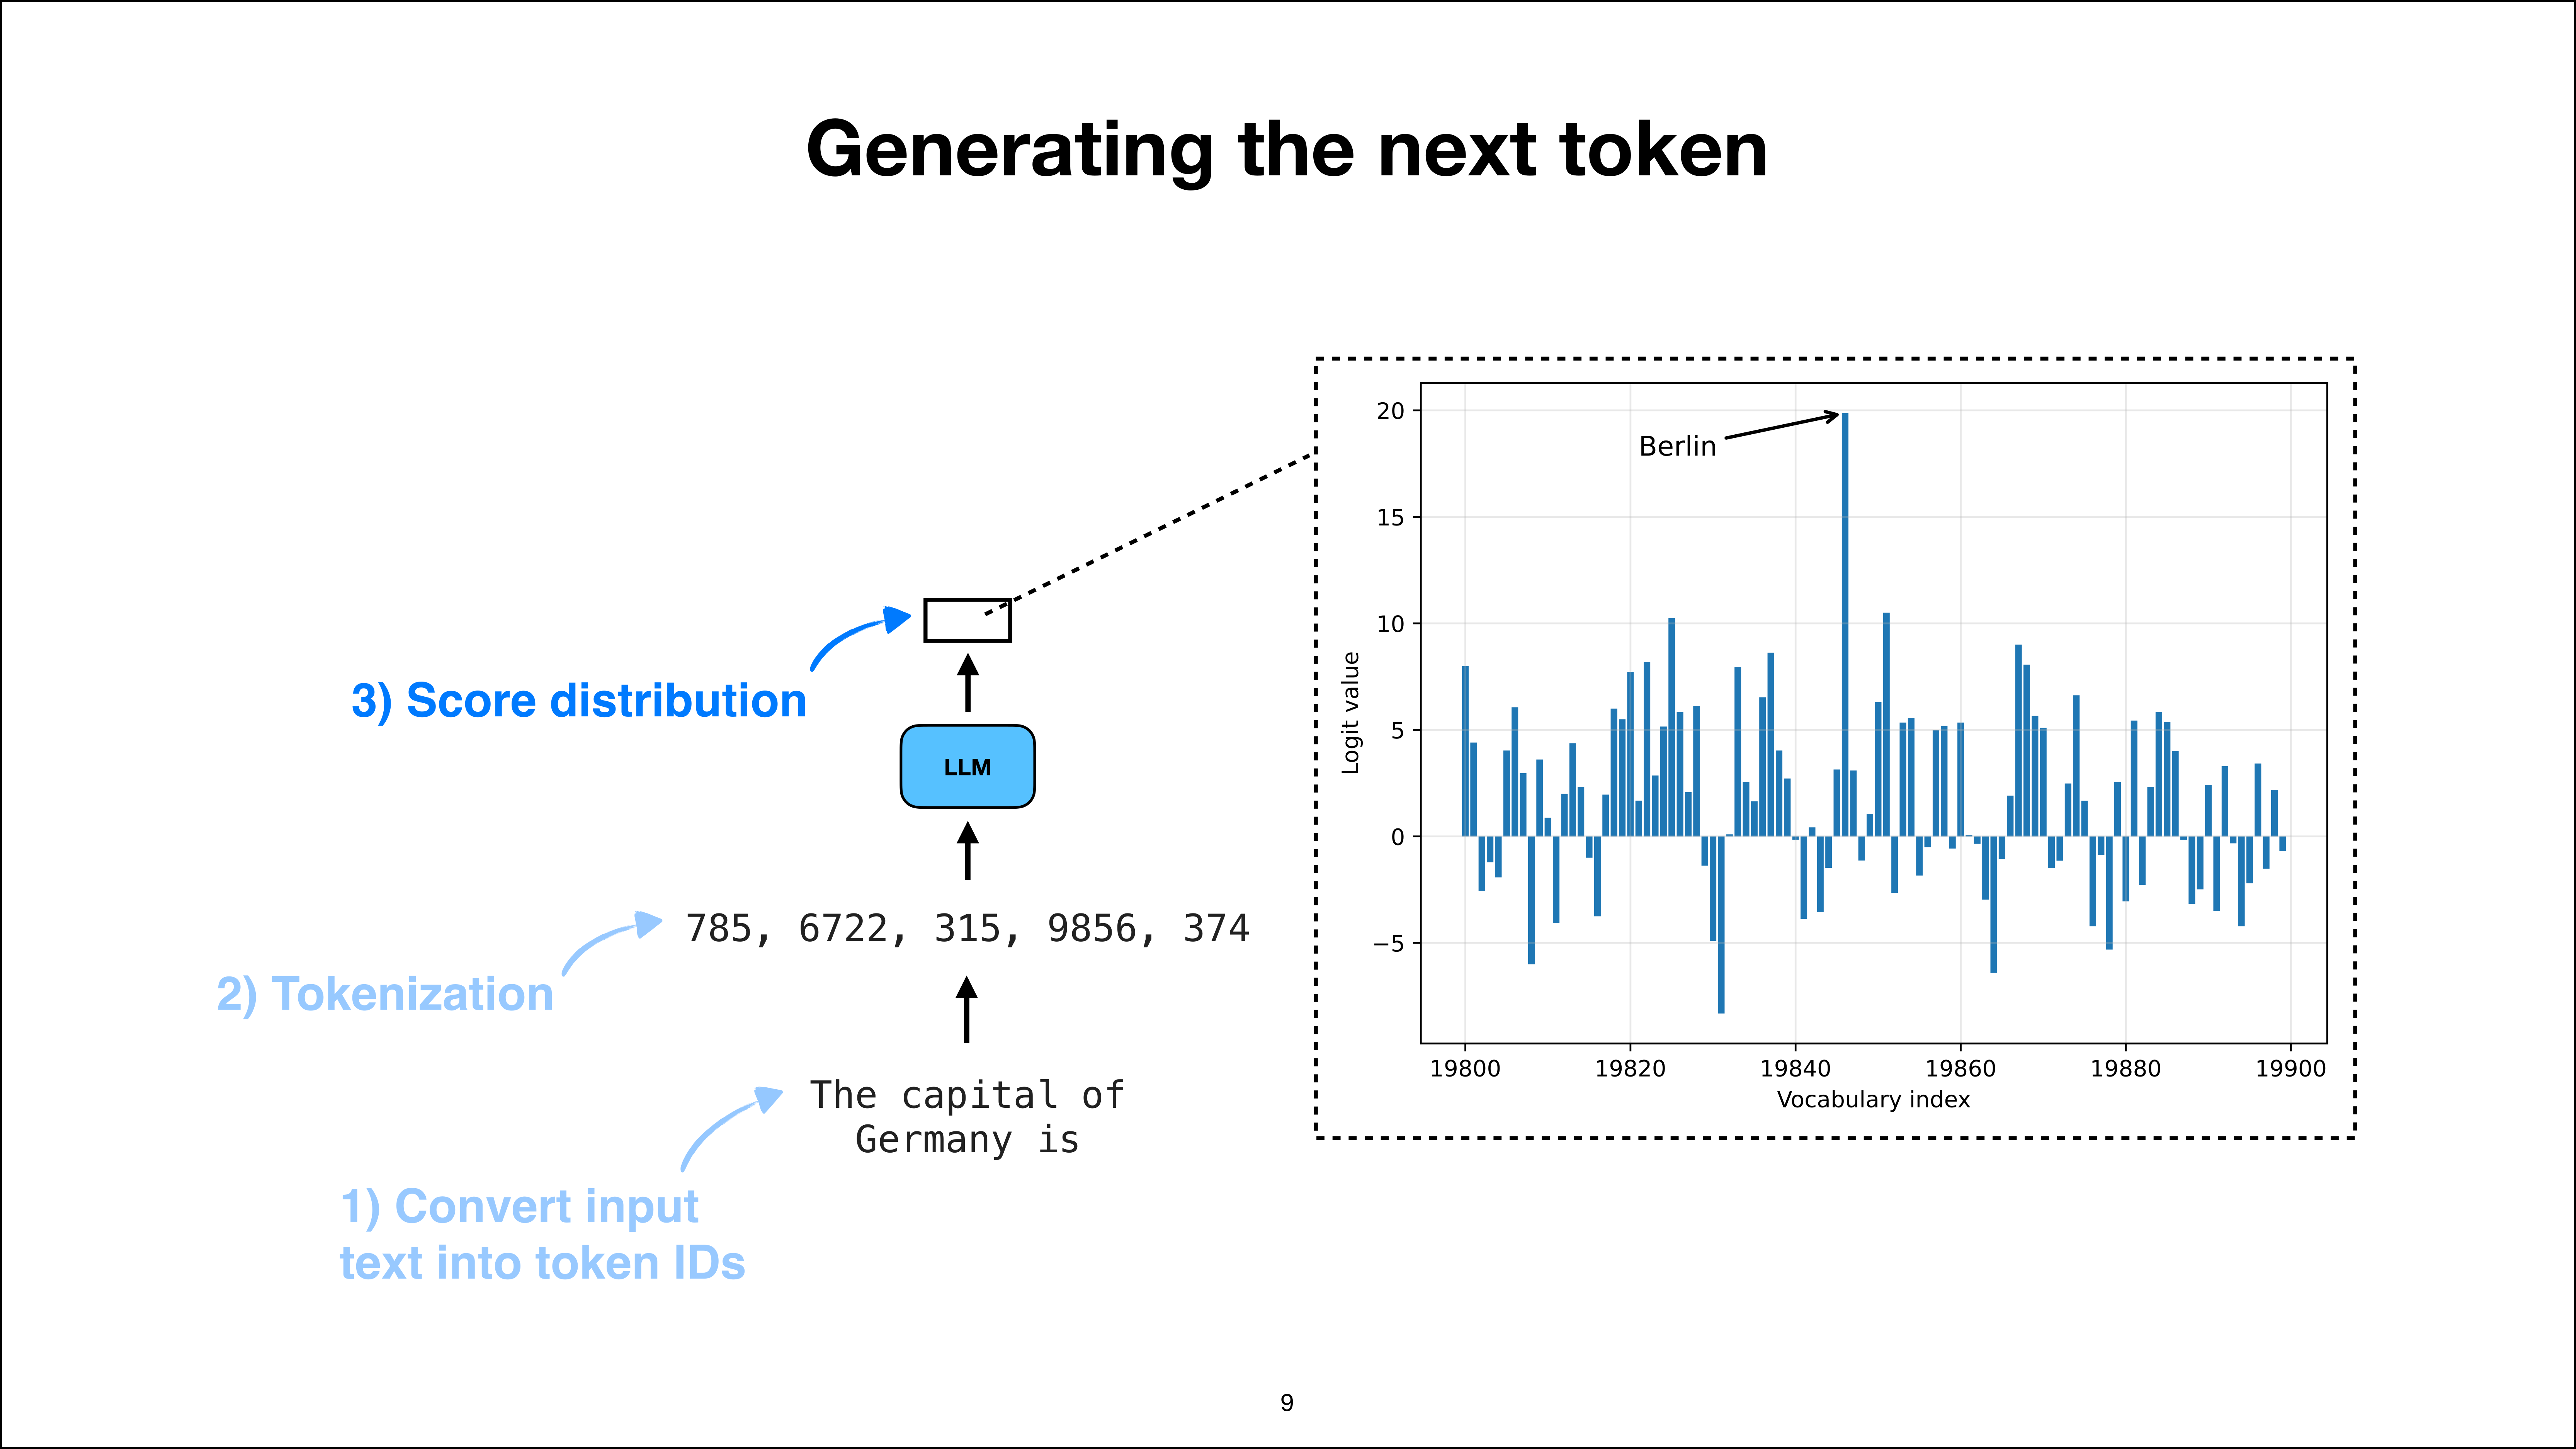
以上简要概述了 LLM 的内部运作机制。我并不打算在此深入讲解 LLM 的具体实现细节,相关内容我在之前关于从零构建 LLM 的视频和书籍中已多次阐述。关键点在于,当我们生成下一个 token(例如“柏林”)时,此时已获得一组分数分布,这就是 LLM 的输出结果。
在这里,我们看的是 logit 值。这本质上就是一组分数,取值范围从负无穷到正无穷。图中给出的例子,范围大约在 -8 到 20 之间。虽然我们能把这些数值转换为概率分布,但根据采样方式的不同,这在技术上并非绝对必要。因此,你可以把 logit 值理解为一组原始分数。
这些原始分数覆盖整个词汇表。
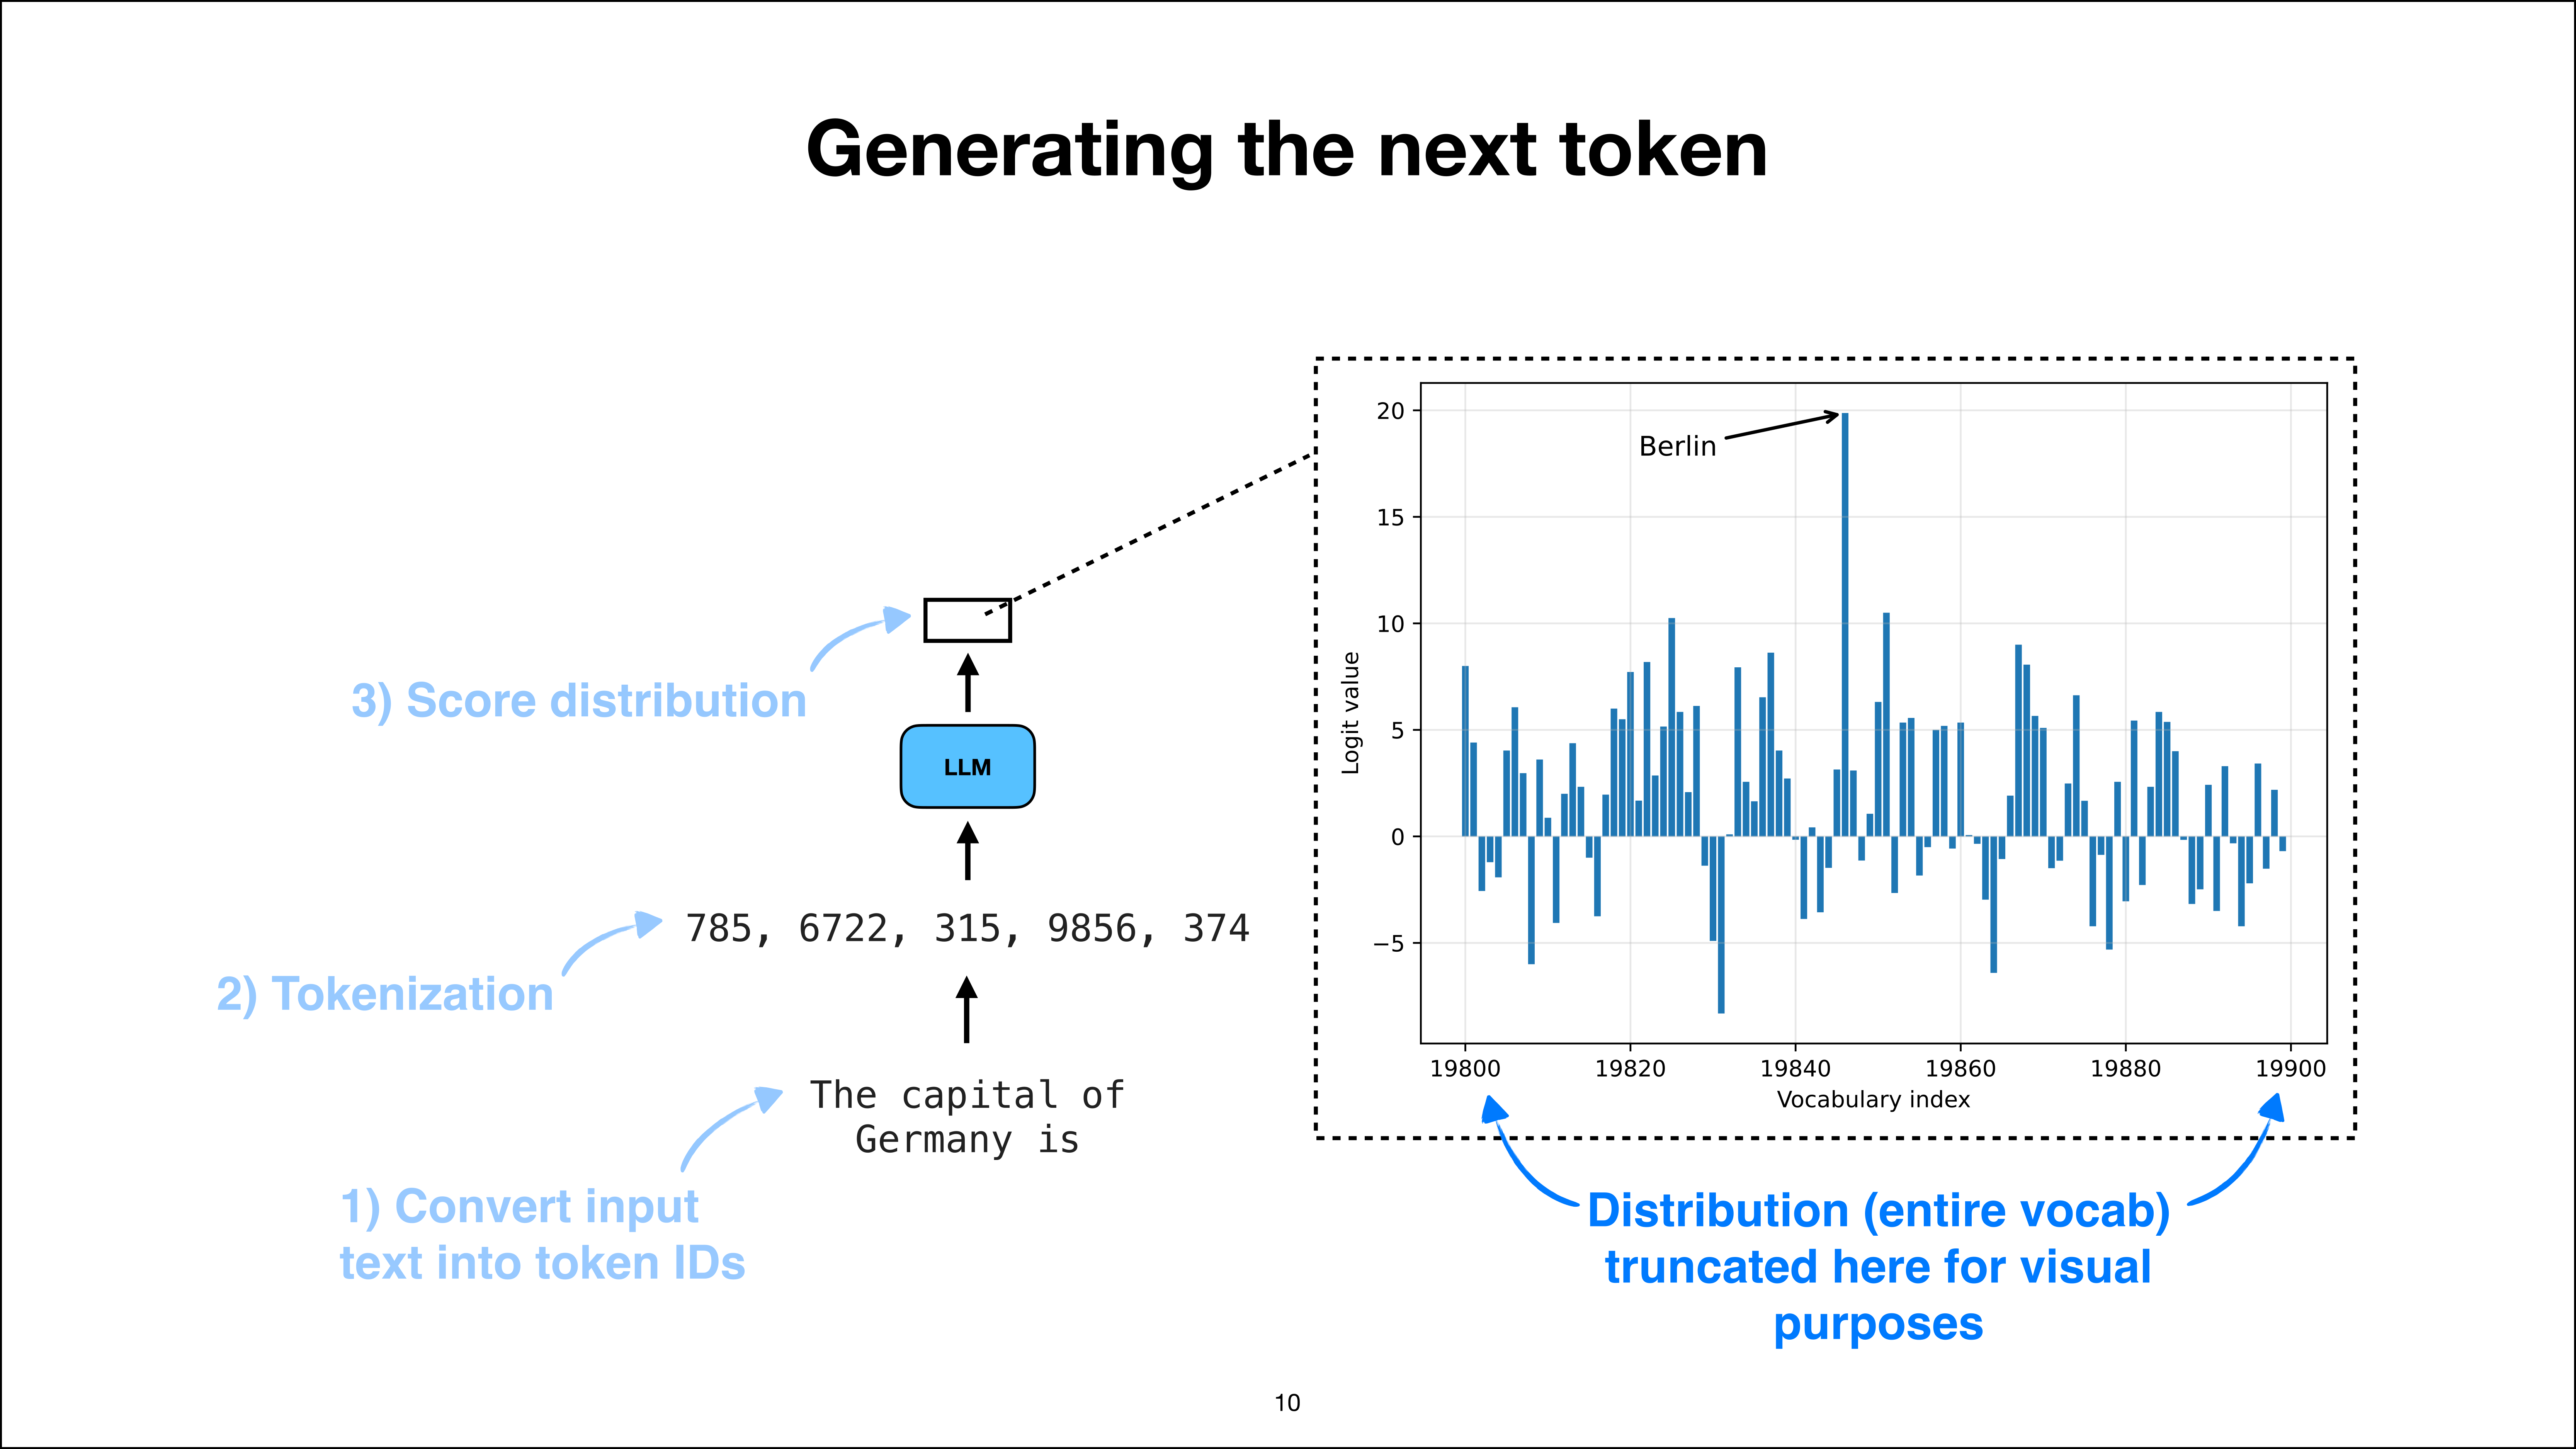
也就是说,LLM 可能生成的每一个单词都包含在内。在当前的词汇索引中,某个特定值(索引位置 19,846)获得了最高分。为了更清晰地展示,我将分布做了平滑处理。如果你把这段 prompt 实际跑一遍,会发现结果更为极端:几乎所有项的分数都极其接近零,而“Berlin”的分数会远高于其他。
为了展示几个峰值,让画面看起来更有趣,我把分布图放大并展开了一些。在这个图中,“Berlin”的得分最高。你可以把它理解为:在我给出一个非常具体的 prompt 时,它是最有可能或最合理的下一个 token。其他选项可能是 LLM 会误判的词汇,比如“Hamburg”或“Munich”。
但现在,LLM 应该能相当确定地判断“Berlin”才是正确答案。你在这里看到的也是词汇索引,它覆盖了整个词汇表。如今 LLM 的输出候选项大约有 25 万个 token。由于幻灯片空间有限,我这里截取的是 19,800 到 19,900 这一小段。如果展示出 25 万个单词的完整分布,曲线会极度狭窄,我们将几乎看不到任何细节。
这里为了教学做了截断。关键在于:常规文本生成会得到这样一个分数分布,接下来我们要做的就是找出其中最高的分数。
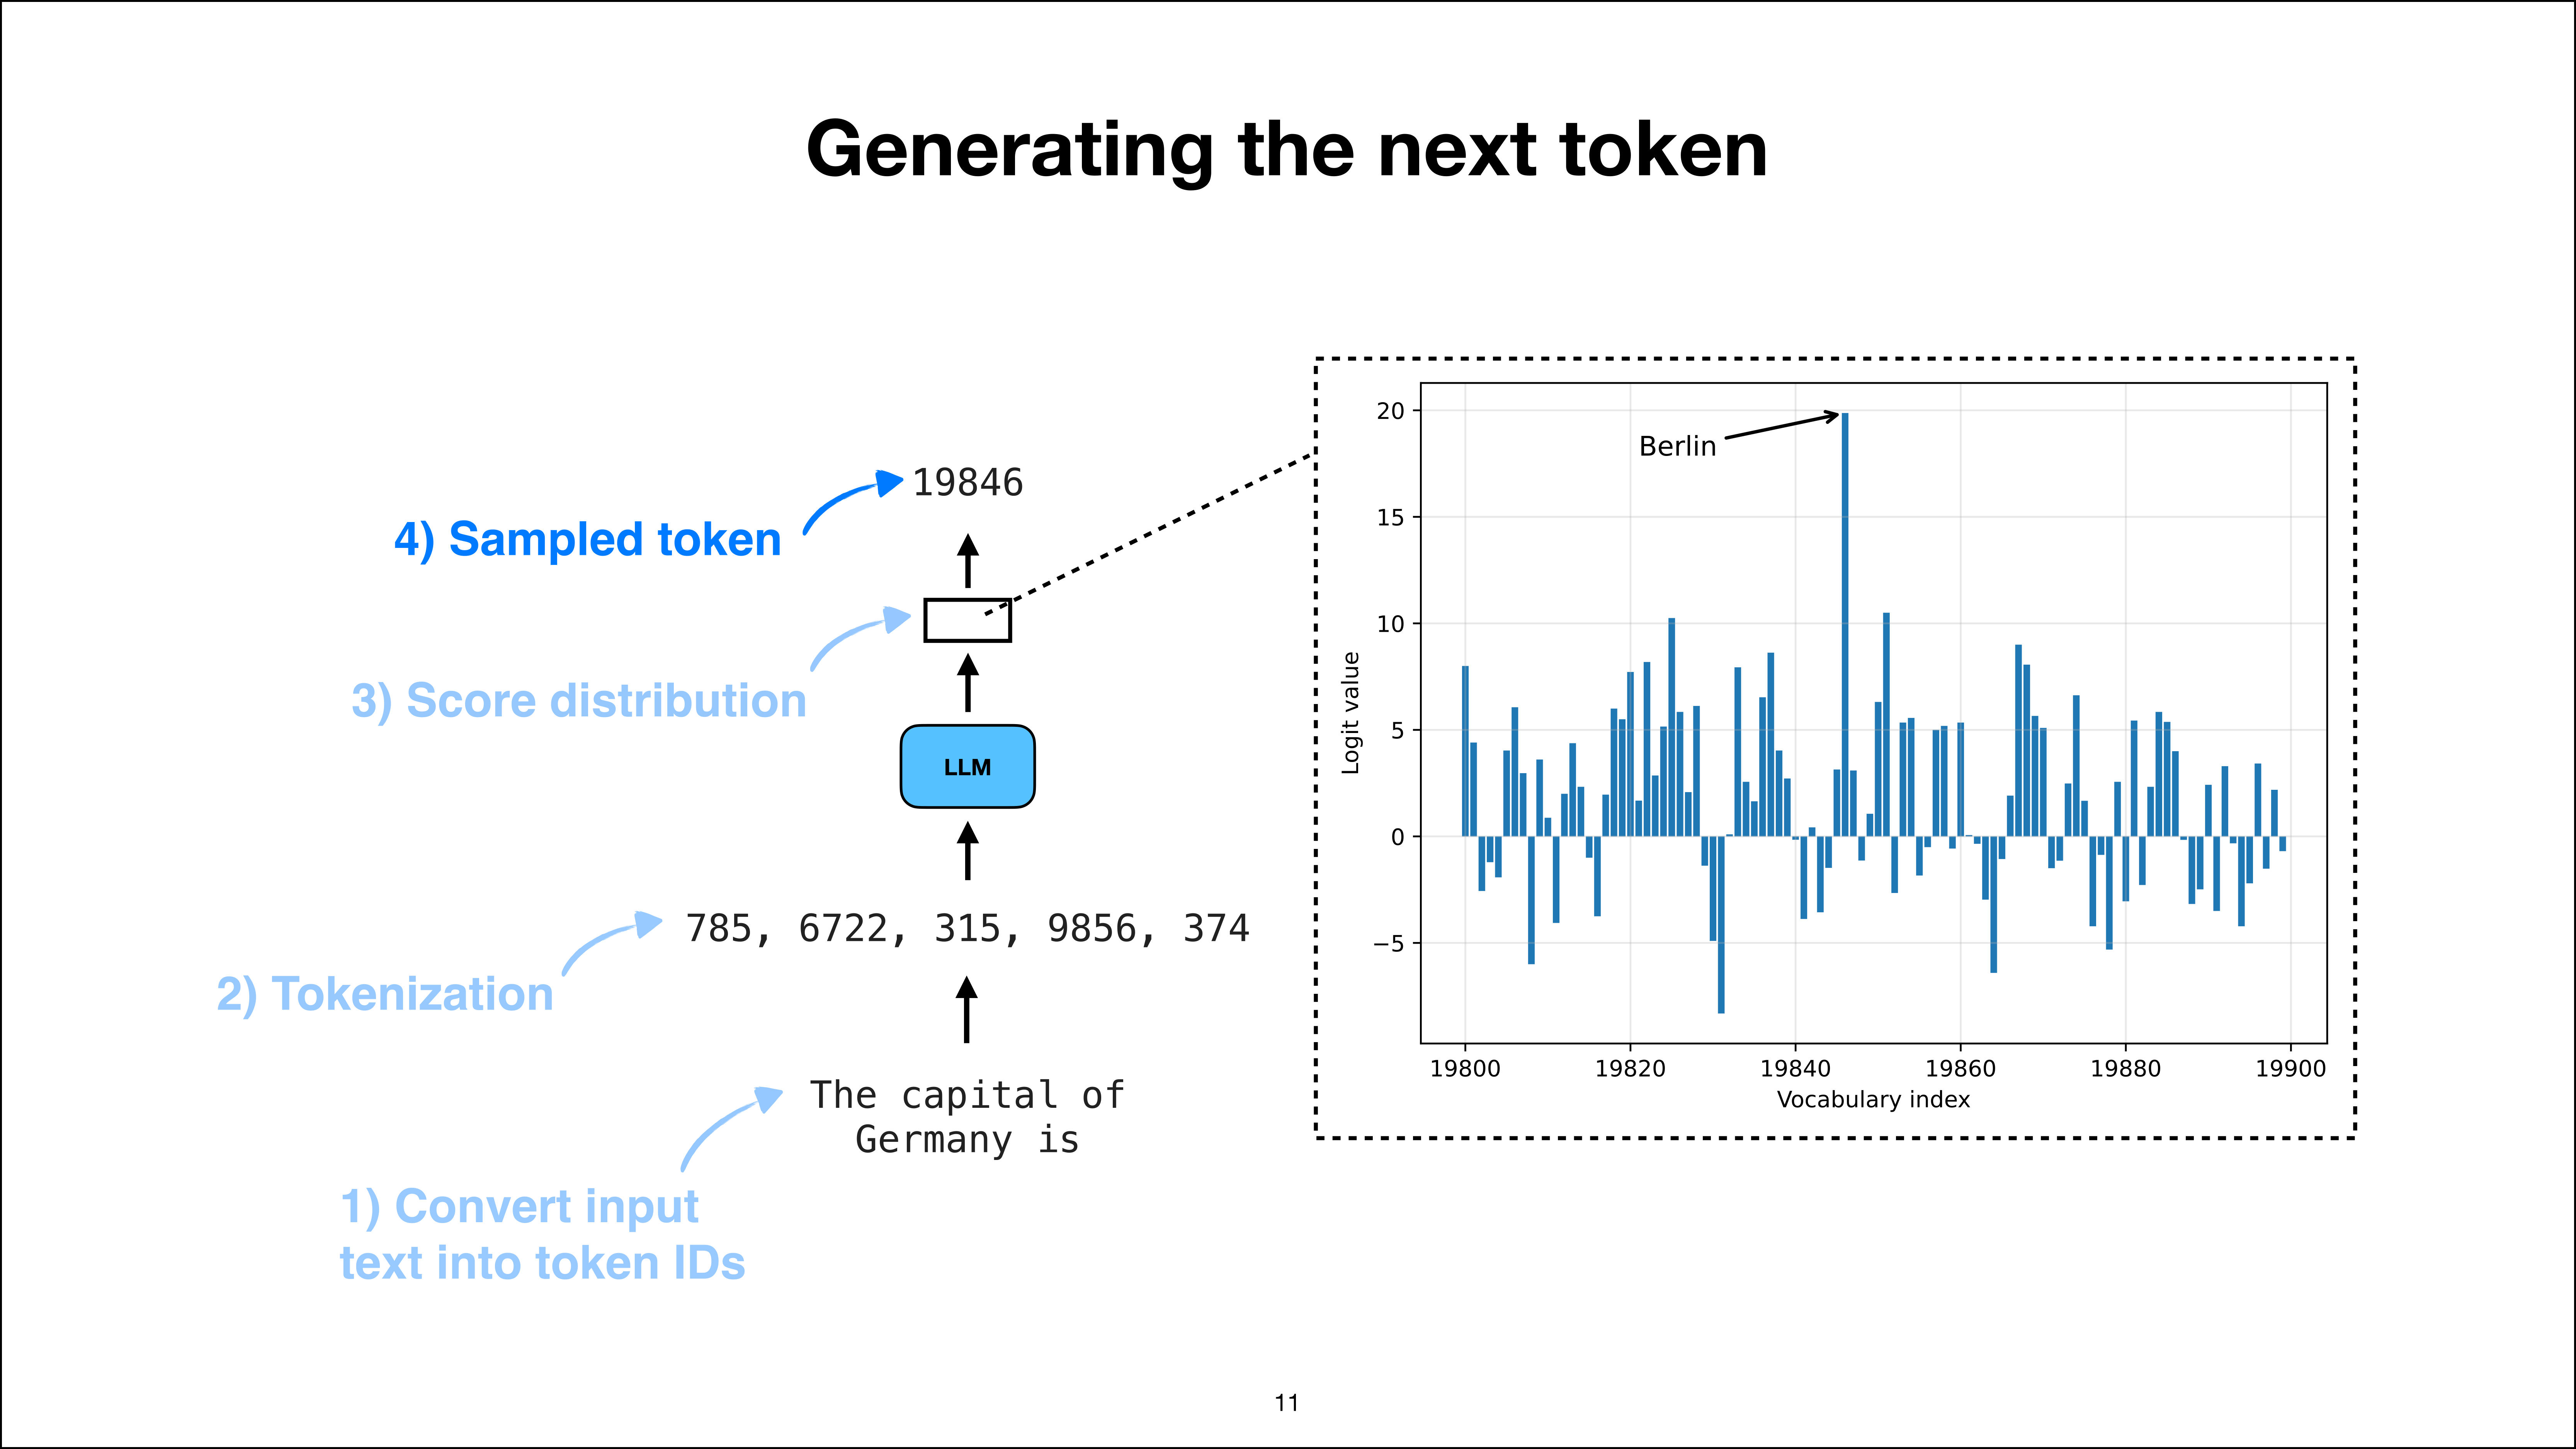
具体怎么选,后面会详细讲。实际上不一定严格取最高的那个,但为简单起见,就当这里是取最高分。在这个例子里,最高分是 19,846。
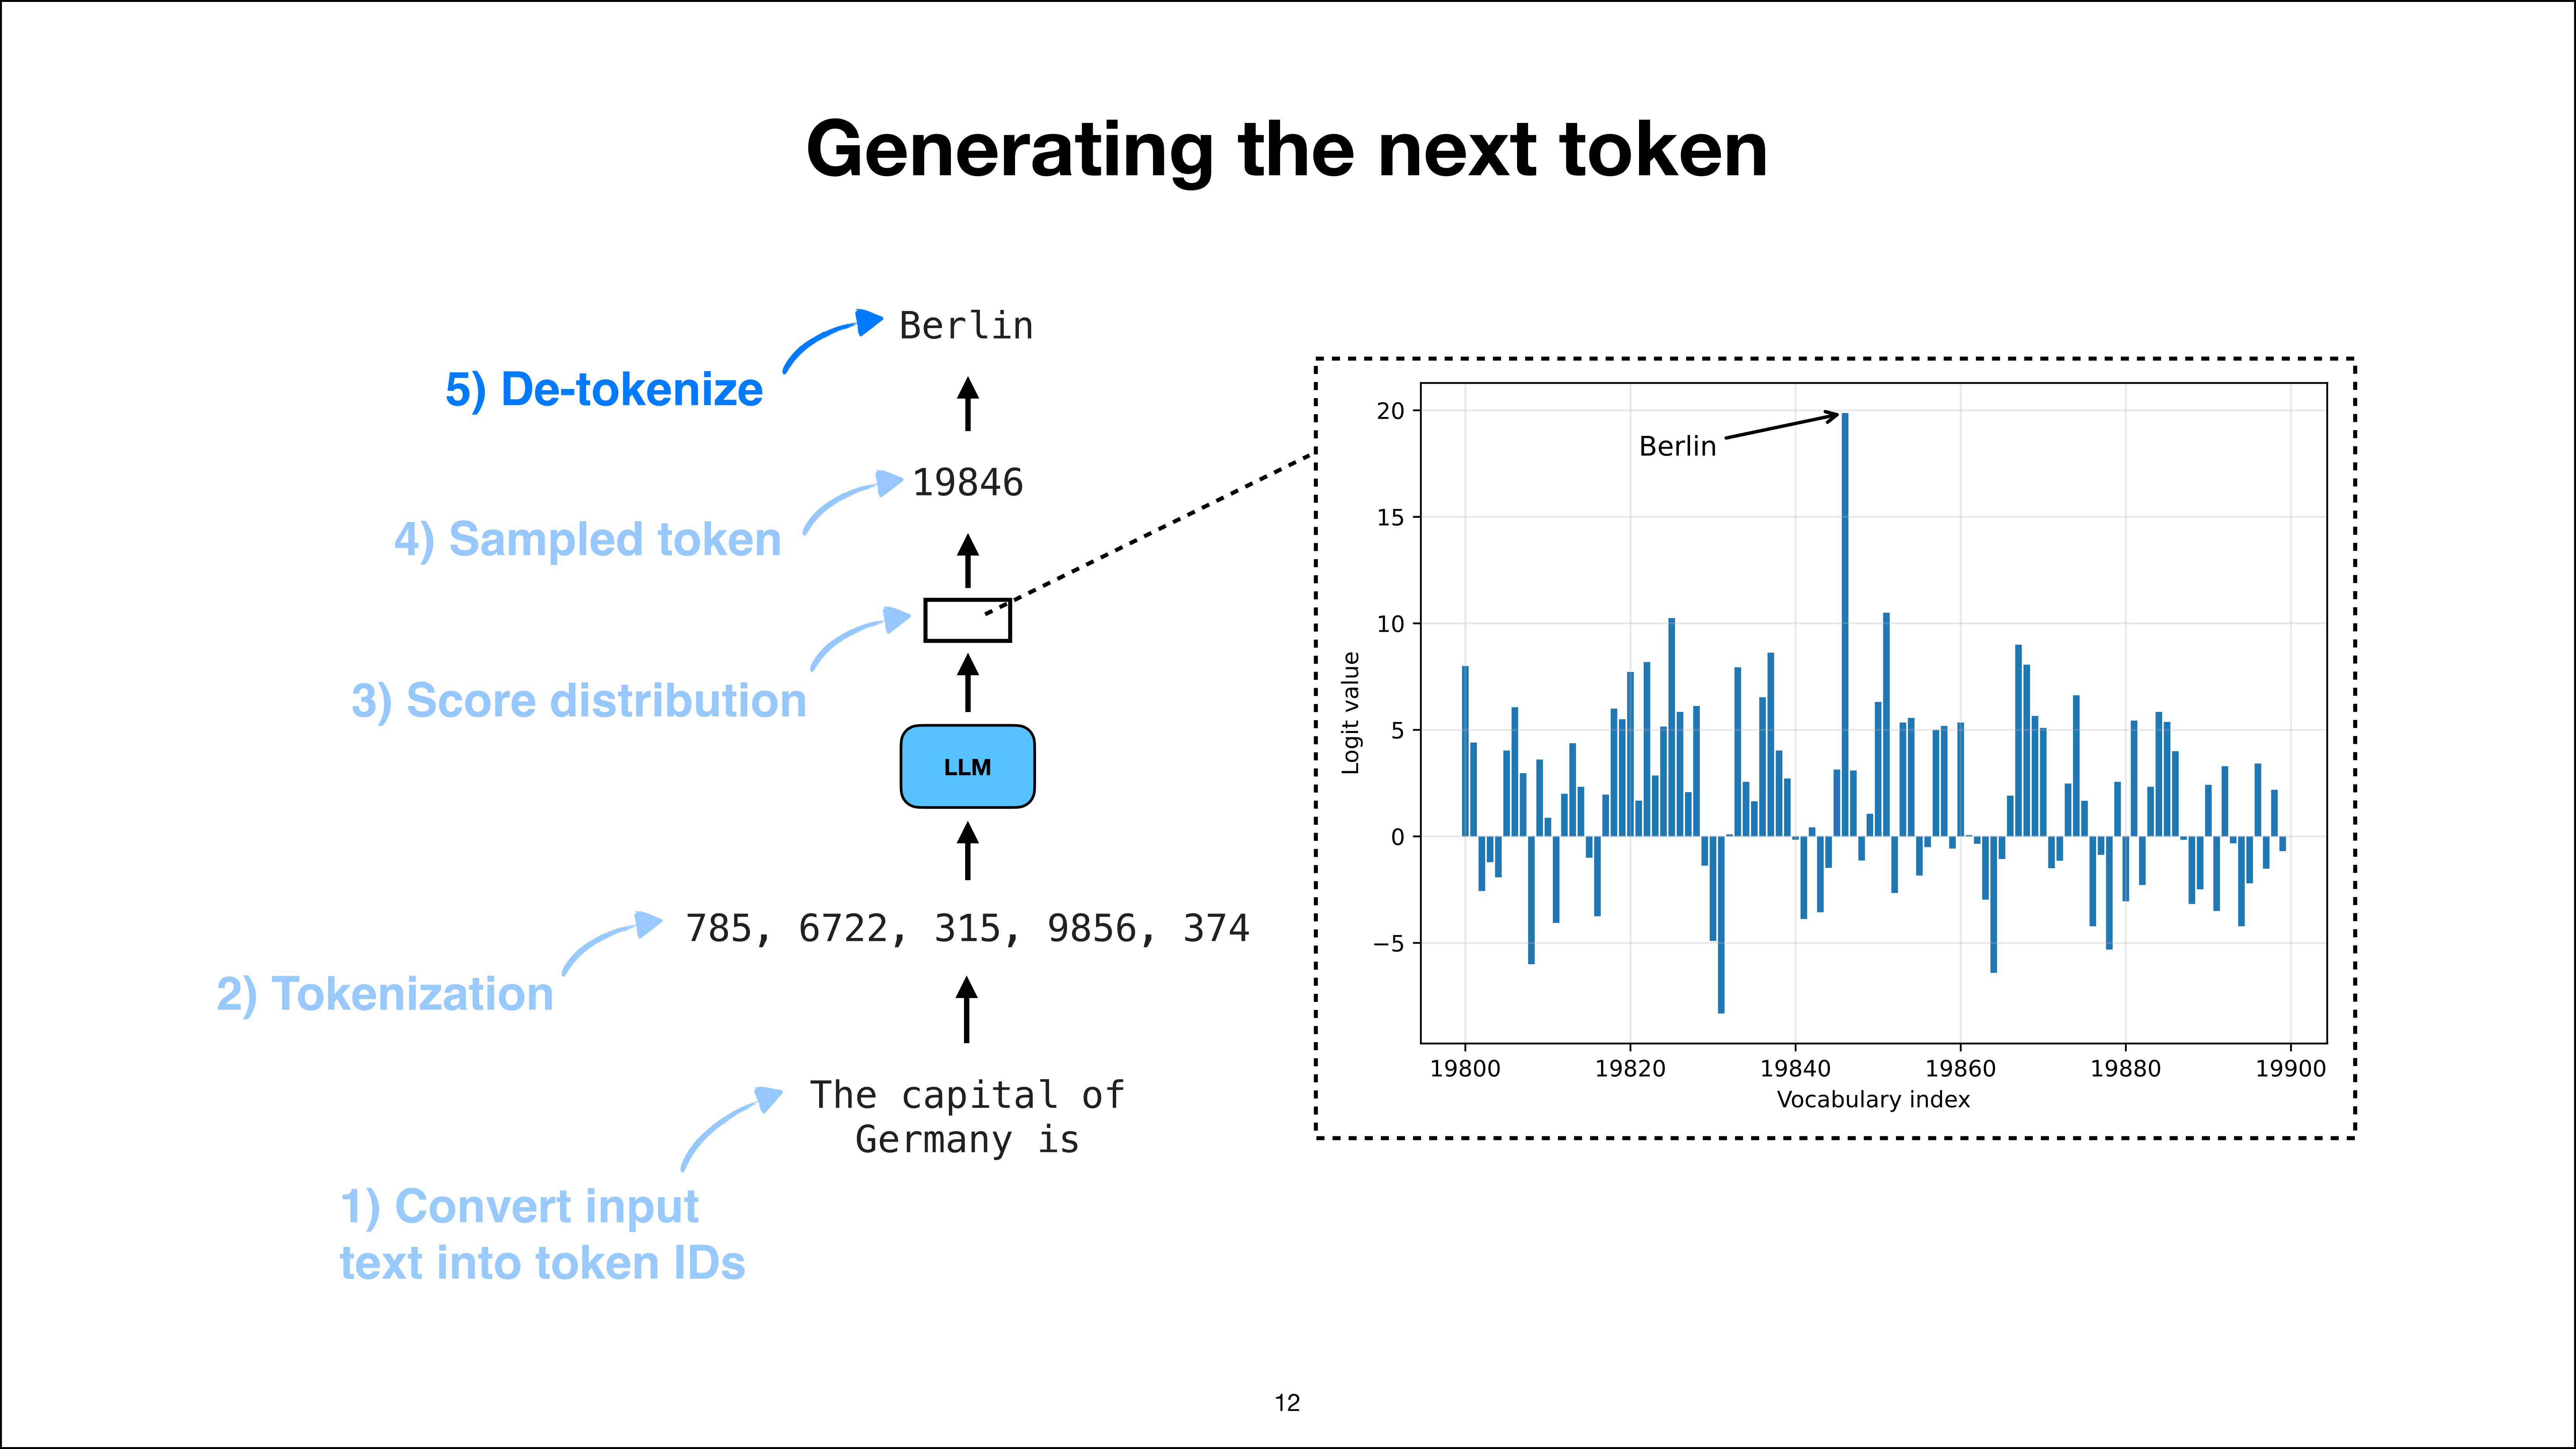
接着对这个分数做 detokenize,就还原出了“Berlin”。这就是本页幻灯片展示的完整流程:从输入 prompt 开始,转成 token ID 并完成 tokenization,交给 LLM,得到分数分布,取出下一个 token,再转换回文本。
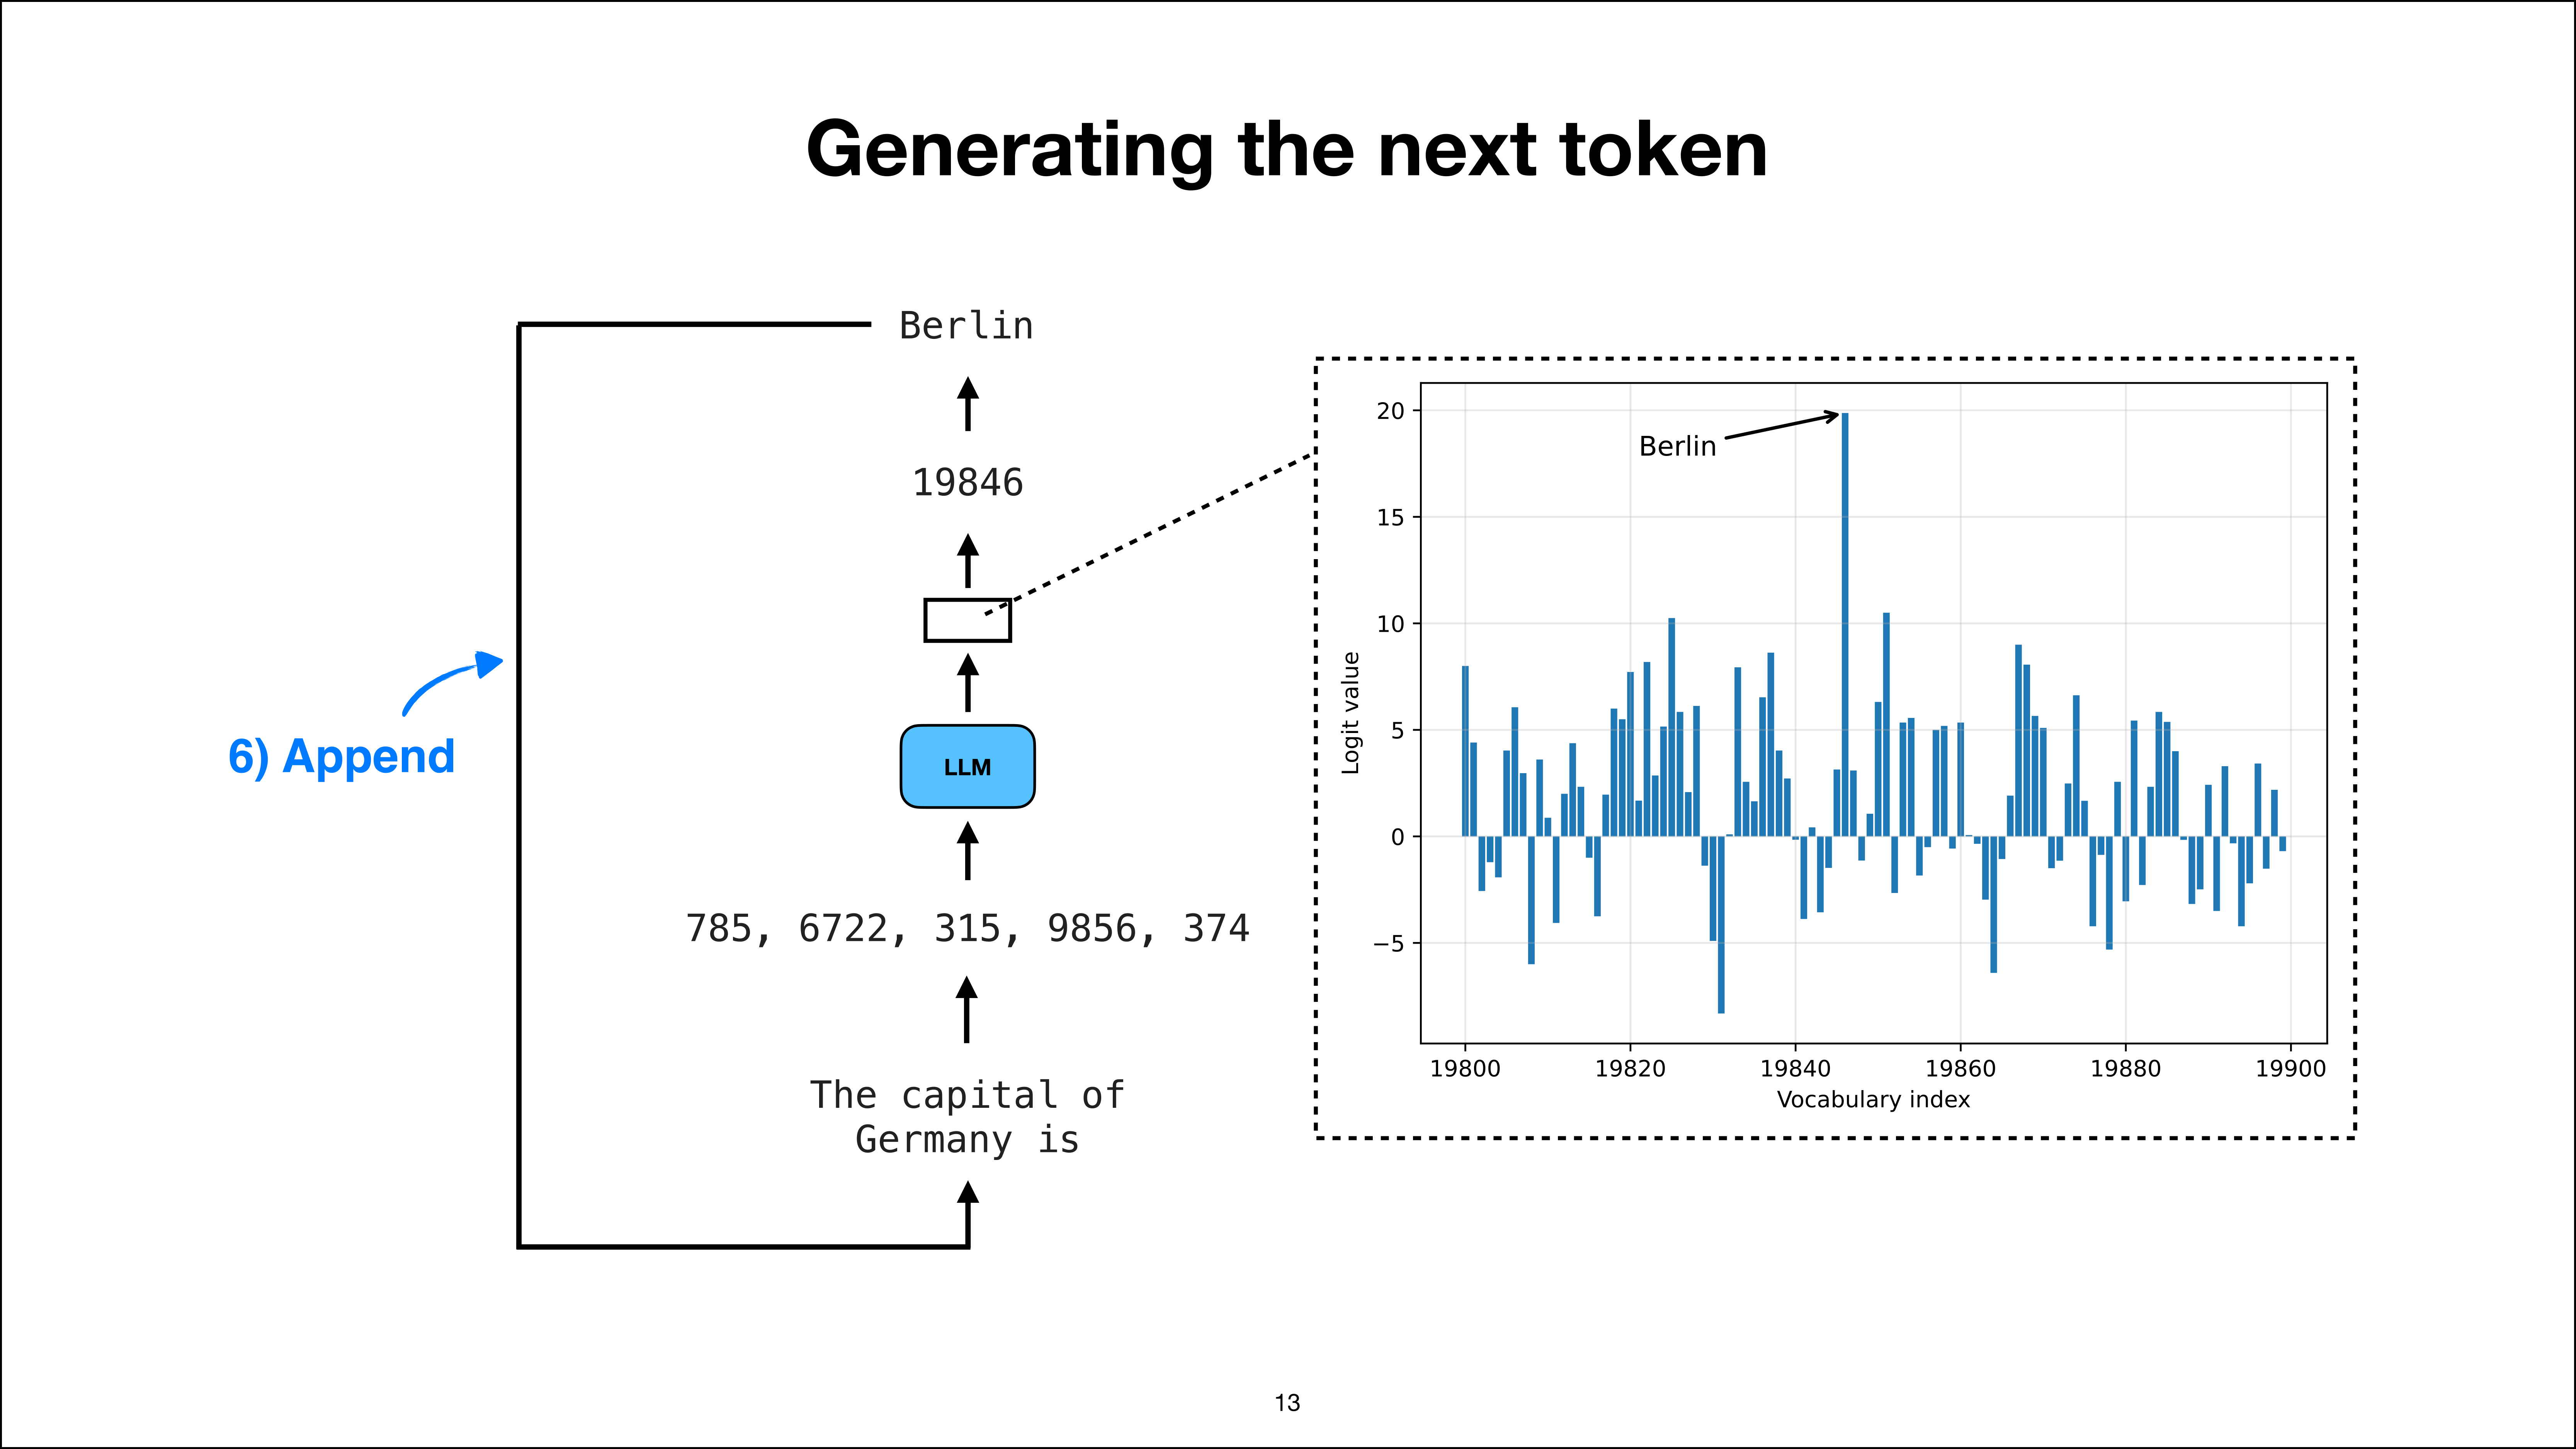
随后,这段文本会被追加到输入中。因此,如果某个问题需要输出多个 token,我们会在这个循环中持续进行,直到答案生成完毕。这通常意味着 LLM 生成了一个文本结束符(end-of-text token),比如图中所示。为了简化演示,我只展示了一次迭代过程,即生成一个 token。正如我之前所说,实际上它会这样持续下去,把修改后的输入反馈给 LLM,以便进行下一轮生成。
那么,我们究竟该如何采样下一个 token 呢?
Next-Token 采样机制解析
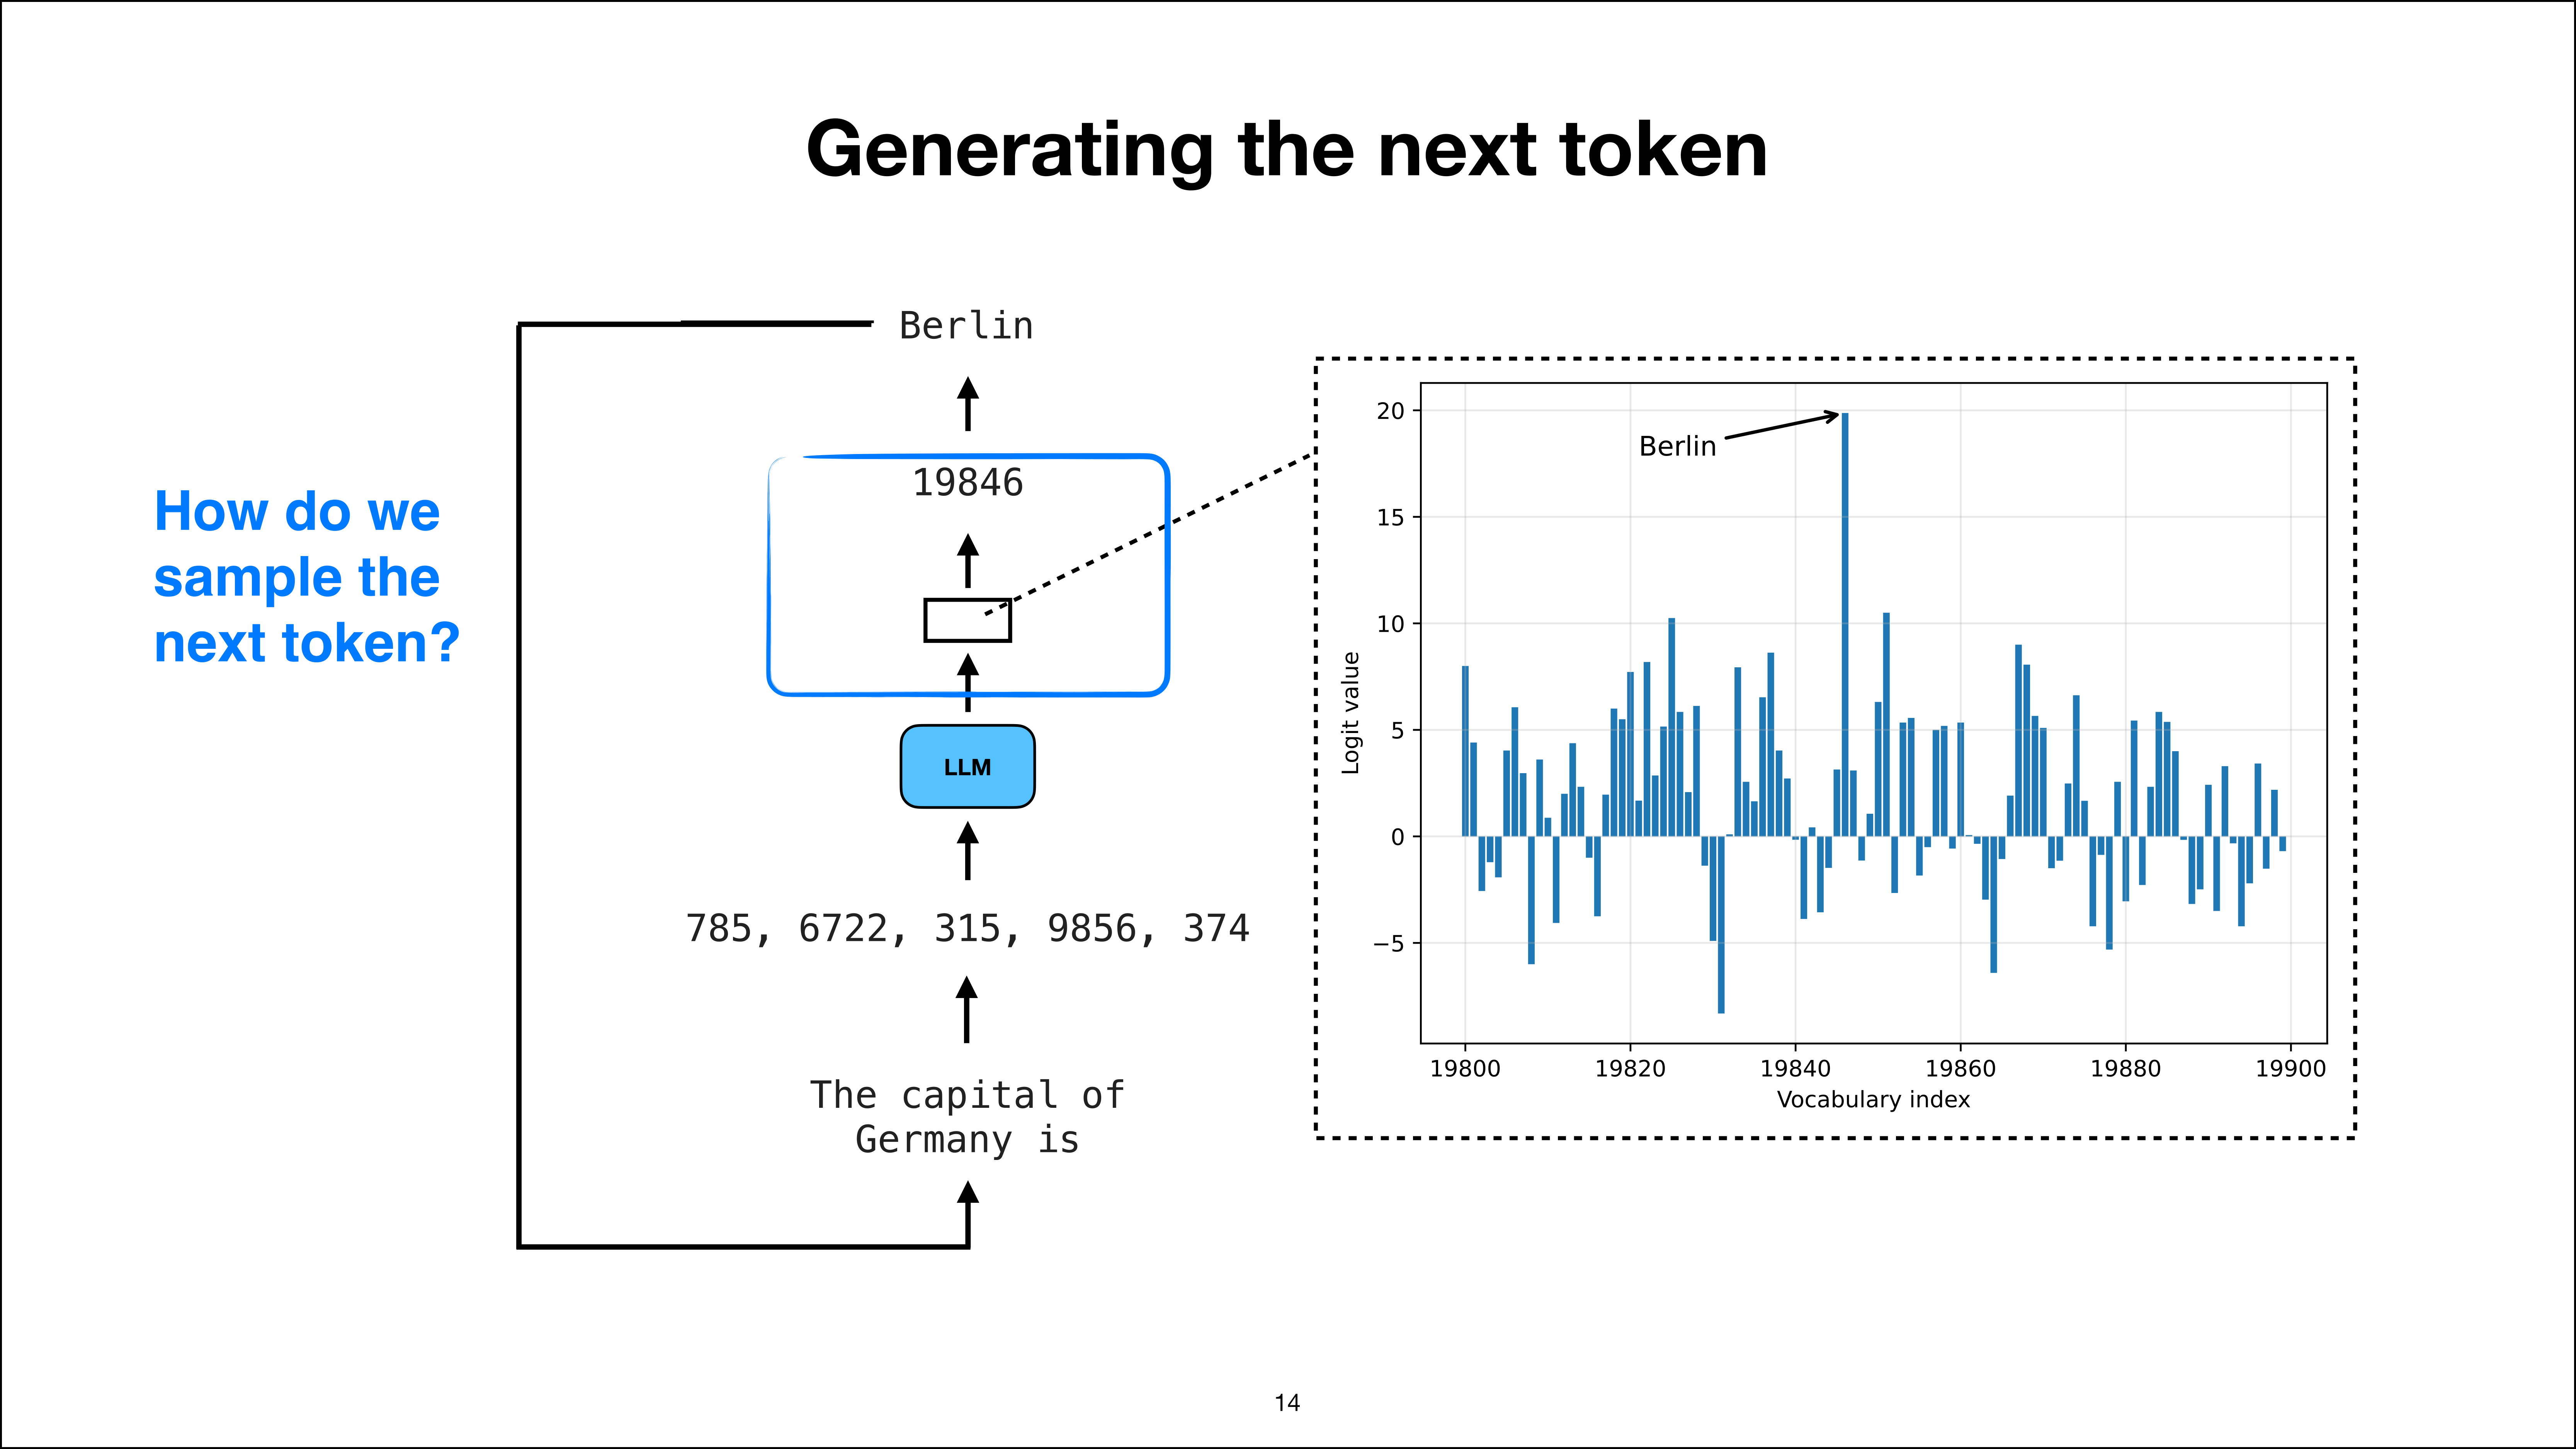
我刚才简要提到,从技术上讲,我们可以直接选择得分最高的那个。这被称为贪婪解码(greedy decoding),是一种可行的方式。但大多数 LLM 在使用时并不采用贪婪解码,即并非总是选取最高分选项。因为在某些提示词下,始终追求最高分可能并非我们想要的结果,那样会导致模型仅仅是在复述训练数据。
这样模型总会给出相似的响应,缺乏多样性。因此,我们通常希望输出具备一定的变化性,但又不能随机到胡言乱语的程度。其工作原理是:当我们从该分布中采样时,首先通常会将其转换为概率分数。
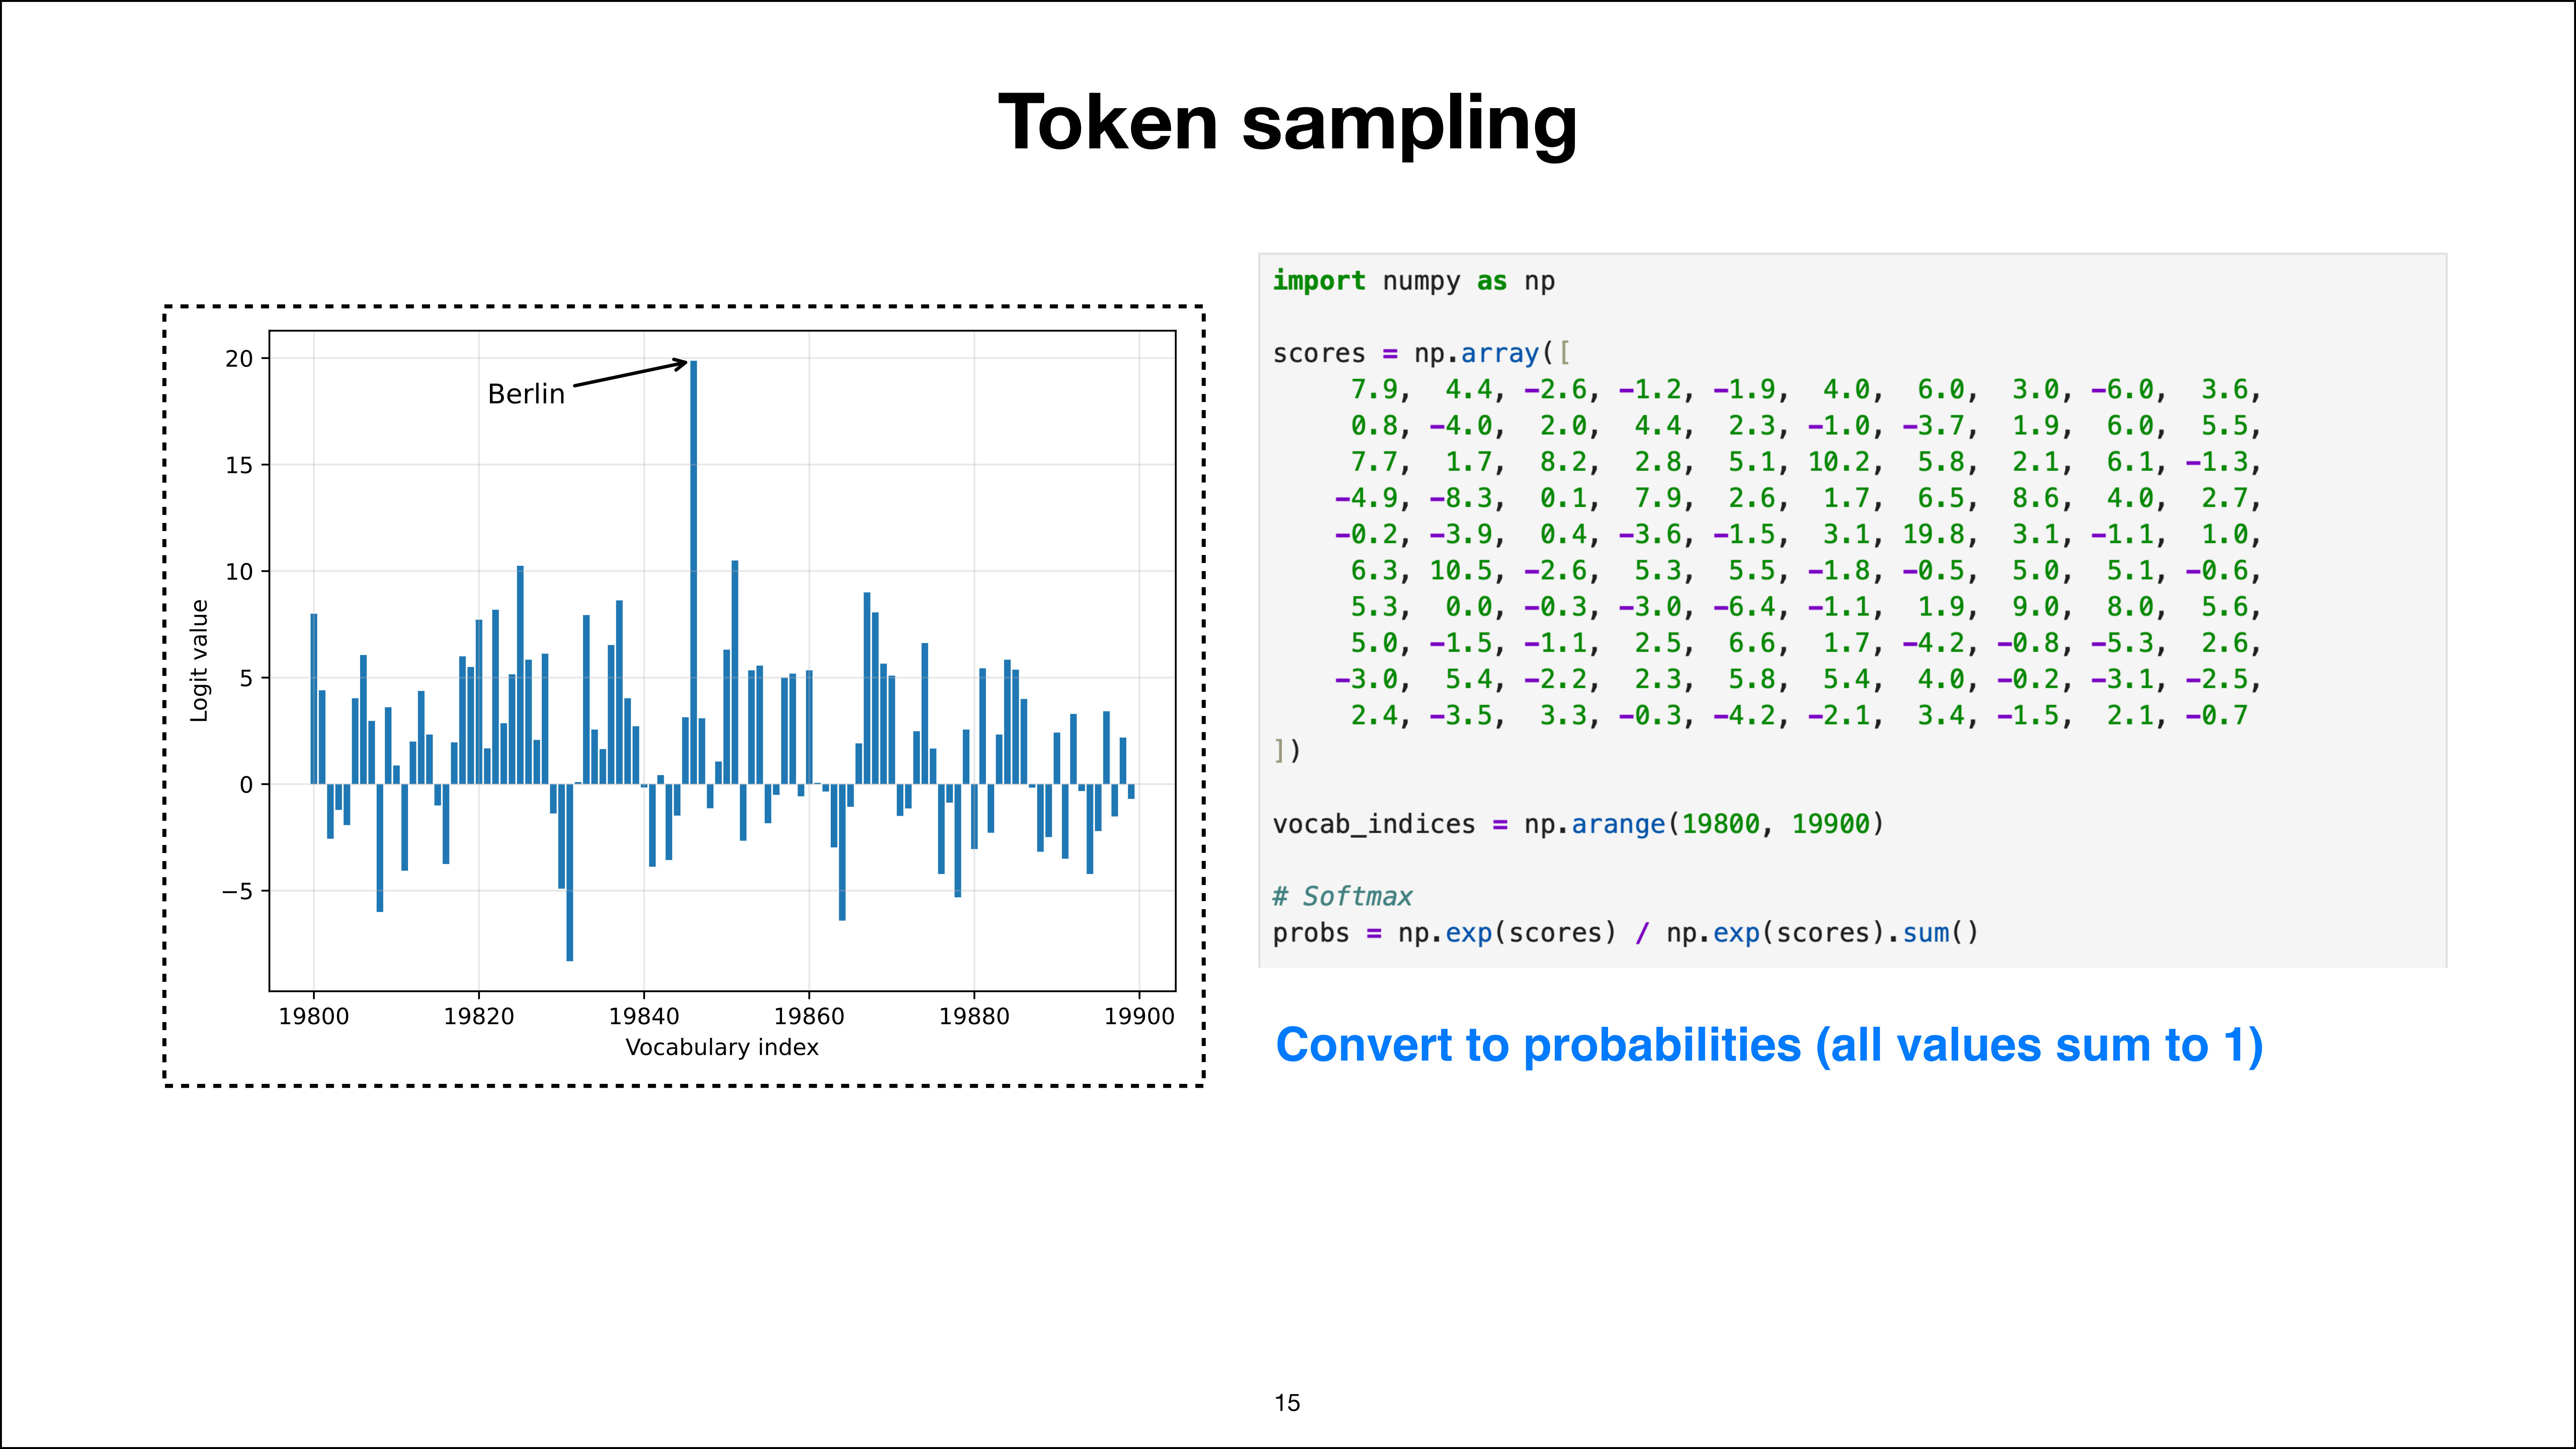
如这张图所示,我只把分数展示了出来。为了简洁,这里用的是 NumPy;无论你用什么工具(比如 PyTorch),原理都一样。假设我们手里是 NumPy 里的分数,我会先算 softmax。严格来说,我会调用 Torch 或 PyTorch 里实现好的 softmax 函数,这种实现在数值上是稳定的,能处理极大、极小,以及正负幅值都很高的数值。
这里我直接写出来,只是标准 softmax 的简化写法,方便阅读。具体细节不重要。
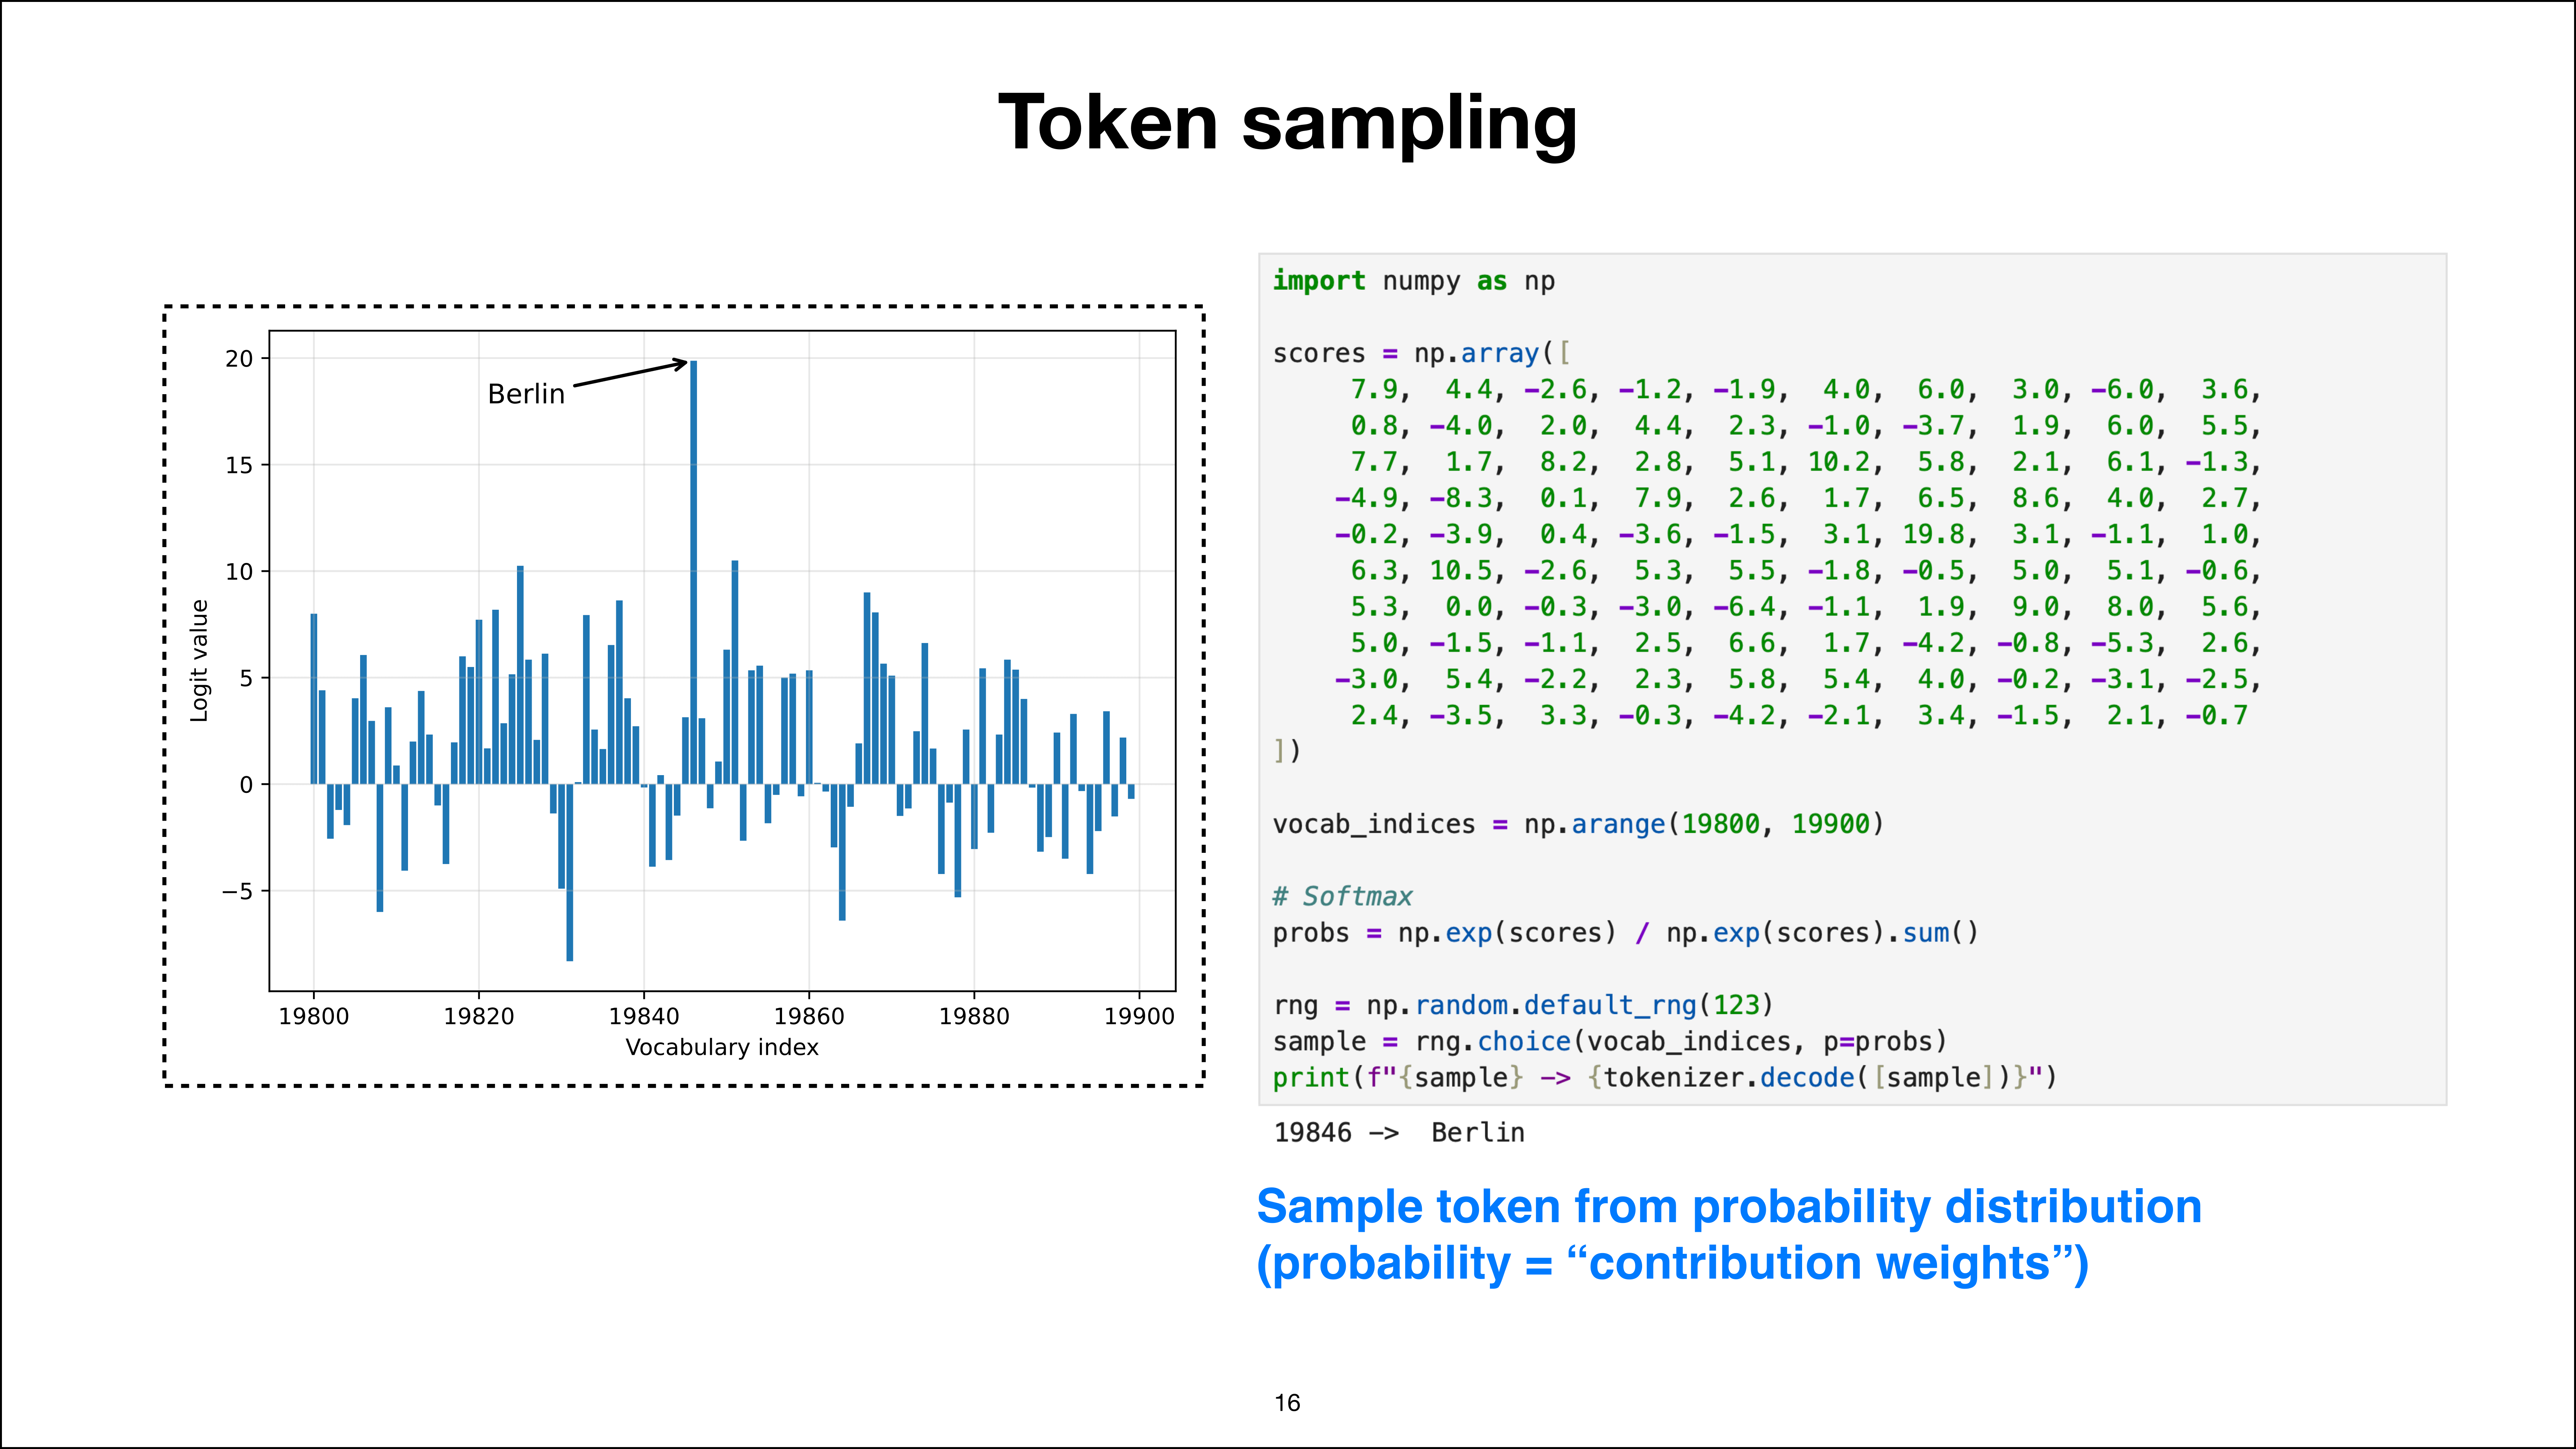
关键在于,经过这个转换后,这些分数的总和为 1,相当于做一次重归一化。概率转换的核心就是这一步:softmax。有了概率之后,就可以用随机数或随机采样算法来生成结果了。
举个例子,在 NumPy 里我们可以用 choice 函数。这里传入了 vocabulary 的索引,指定了一个固定的随机种子。关键在于,我们还把概率作为权重传了进去——本质上就是在回答"某个 token 被选中的可能性有多大"。比如经过 softmax 归一化之后,"Berlin" 的概率是 99%,其他 token 加起来只有 1%,那么采样 100 次,大概会有 99 次选中 "Berlin"。
在训练充分的现实 LLM 中,"Berlin" 的概率可能高达 99.999999% 之类,所以你几乎每次都会采样到 "Berlin",因为模型非常确信这个场景下答案就是 "Berlin"。这就是从这个分布中采样的方式。此外还有一些变体,比如 top-k 采样或 top-p 采样。简单起见,以 top-k 采样为例:我们只取得分最高的 100 个 token,然后只在这 top 100 里做随机选择,这样就能避免采到无意义的 token。
对这个例子来说这其实不重要,我只是顺带一提,简单带过。你可以假设这里已经是用 top-k 之类方法筛过的 top 100 token 了。
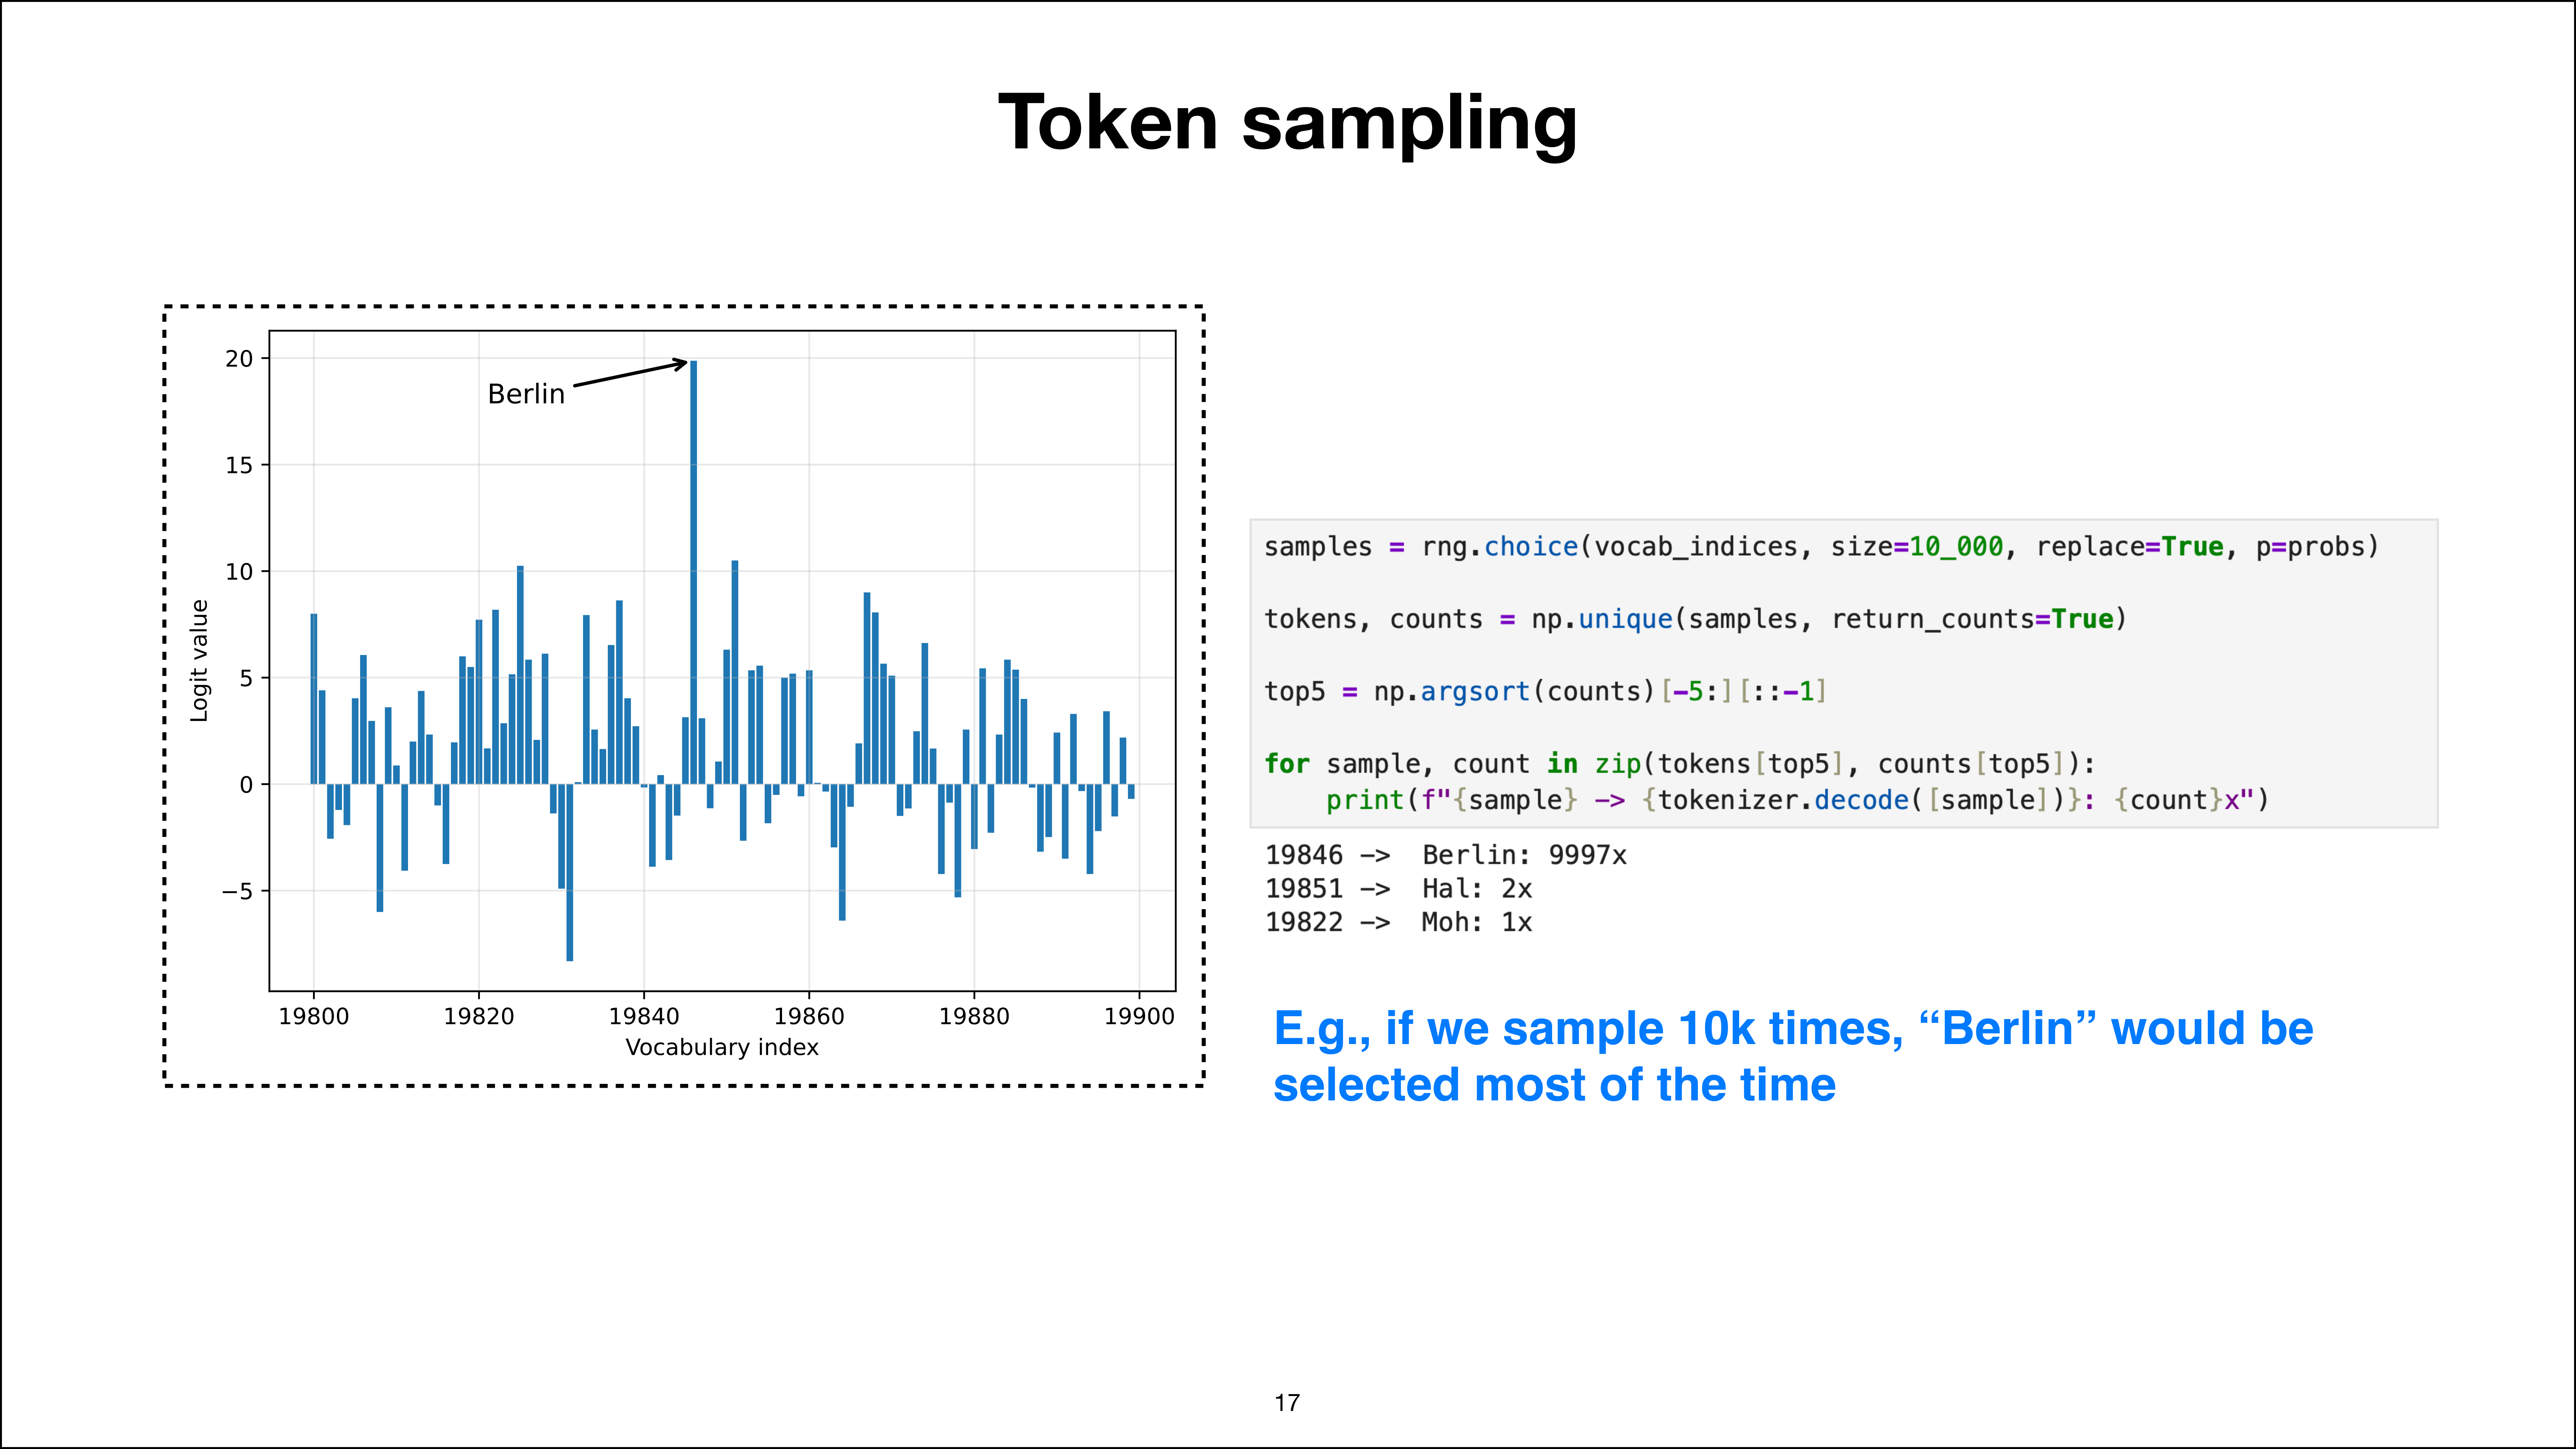
再举个例子:如果采样 10000 次,"Berlin" 的概率很高,达到 99.9%,那么结果大概是采样到 "Berlin" 9997 次,"Hal" 两次,"Moh" 一次。后面这两个基本就是无意义的 token。这种情况其实很少发生——模型会生成无意义内容,是因为我之前为了演示效果刻意把概率分布拉得平了一些。
一个真实的 LLM 在一万次采样中大概会有九千多次都选中"Berlin",因为这个词的概率极高。这里只是为了示意。
从采样到水印
刚才我们简单讲了 LLM 的底层机制,这本身也是个挺有趣的概念。不过我讲过很多次了,不想太啰嗦,只是想为接下来介绍水印原理铺个背景。
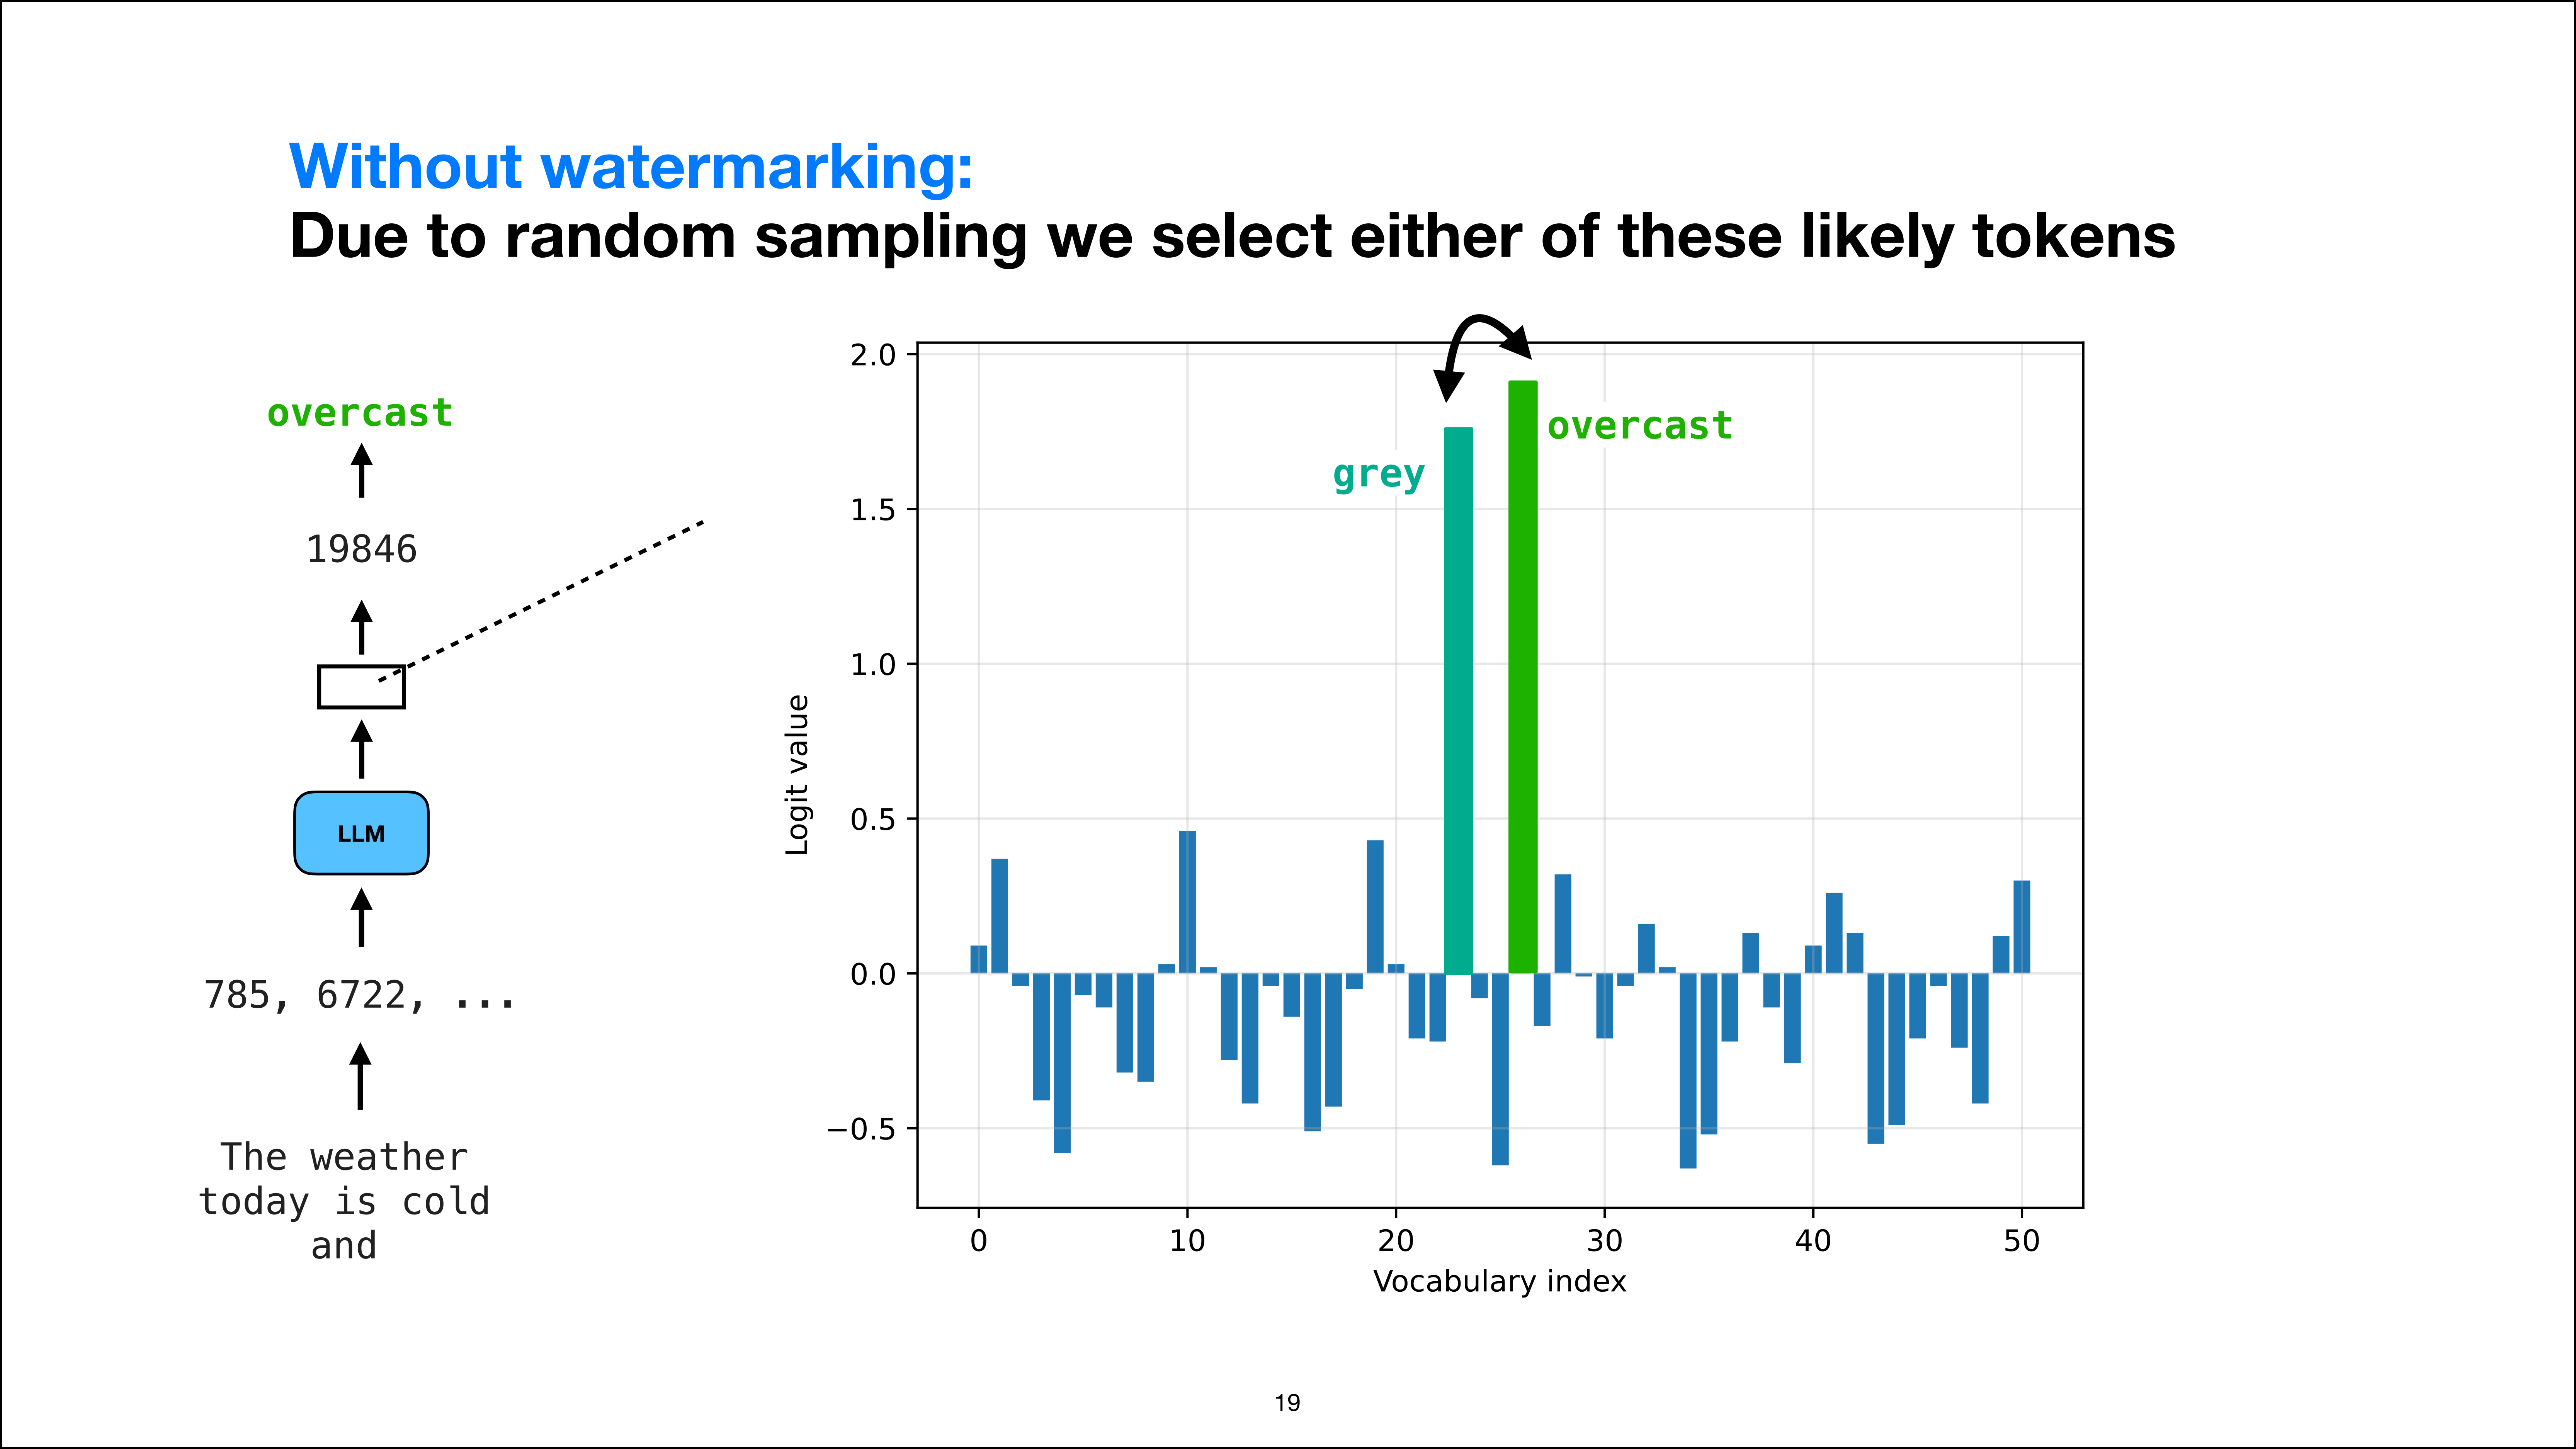
我们说过采样时会取得分最高的 token,或者说用概率采样,大多数时候都会选中得分最高或次高的那个。这里再举个没有水印的例子。我把提示词稍微改了一下,现在提示词是:今天的天气是"cold",可能的答案可以是"gray"或"overcast"。和"Berlin"那个例子相比,我认为"gray"和"overcast"基本可以互换。
考虑到补全文本或生成下一个词的目标,这两个词作为下一个 token 都相当合理。选择哪一个几乎如同抛硬币,二者客观上并无明显优劣。因此,当我们进行随机采样时,由于这两个 token 得分都较高且数值接近,结果可能是其中任意一个。
也就是说,如果多次重复采样,大约一半的结果会是 “overcast”,另一半则是 “gray”。LLM 对同一提示词往往给出不同答案,原因就在这里:当你多次输入相同提示词时,结果通常会略有差异。因为在某些位置,两个候选 token 的概率几乎相同,模型就会随机选取其中一个。
一旦选定了某个 token,它还会影响后续所有 token 的生成,如此层层递进。
随机种子与确定性采样
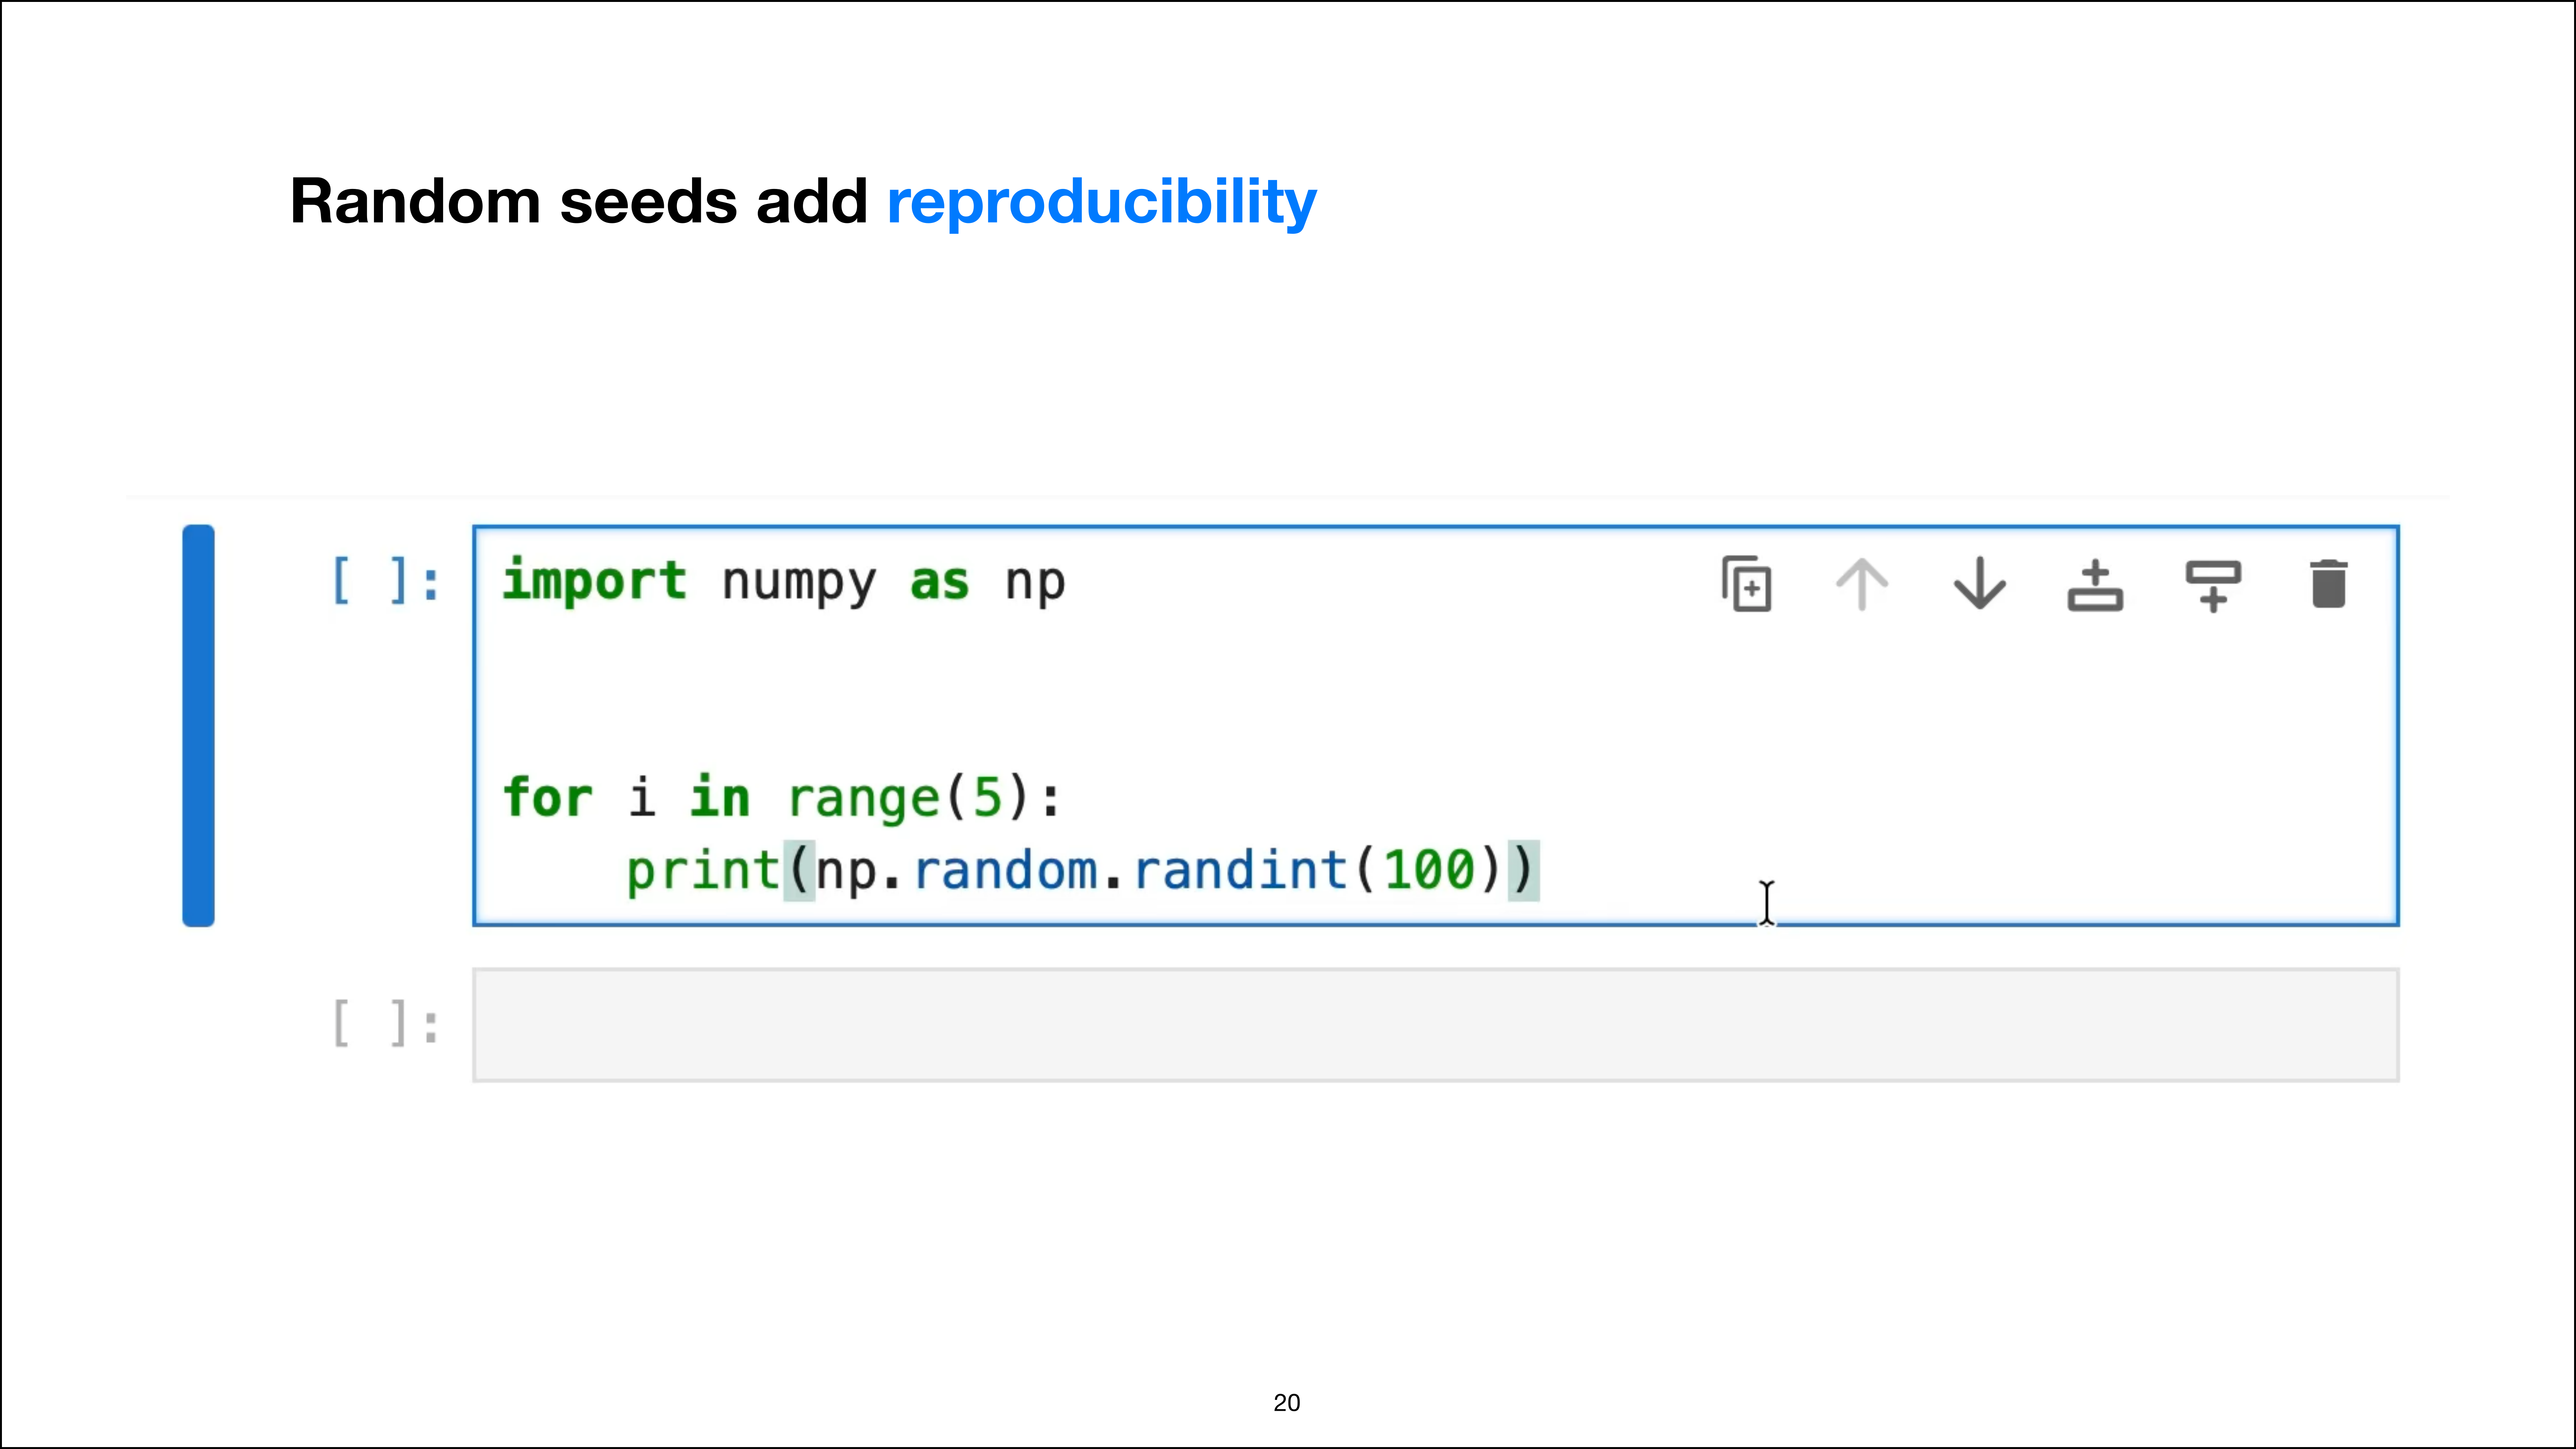
这里快速讲一下随机数生成。例如,使用随机数生成器会产生一串随机数字,再次运行时,这串数字就会不同。你可以看到,每次生成五个数字,结果都不一样。但如果我设置一个随机种子(比如 1、2、3),然后多次运行,虽然生成的仍是随机数,但每次的结果完全一致,对吗?
即便使用了随机种子,生成的仍然是彼此不同的随机数,但这些序列是可复现的。无论是否使用随机种子,我们得到的都是随机数;区别在于,设置了随机种子后,能得到可复现的数字序列。请记下这一点,这只是个铺垫,稍后会用到这个概念。
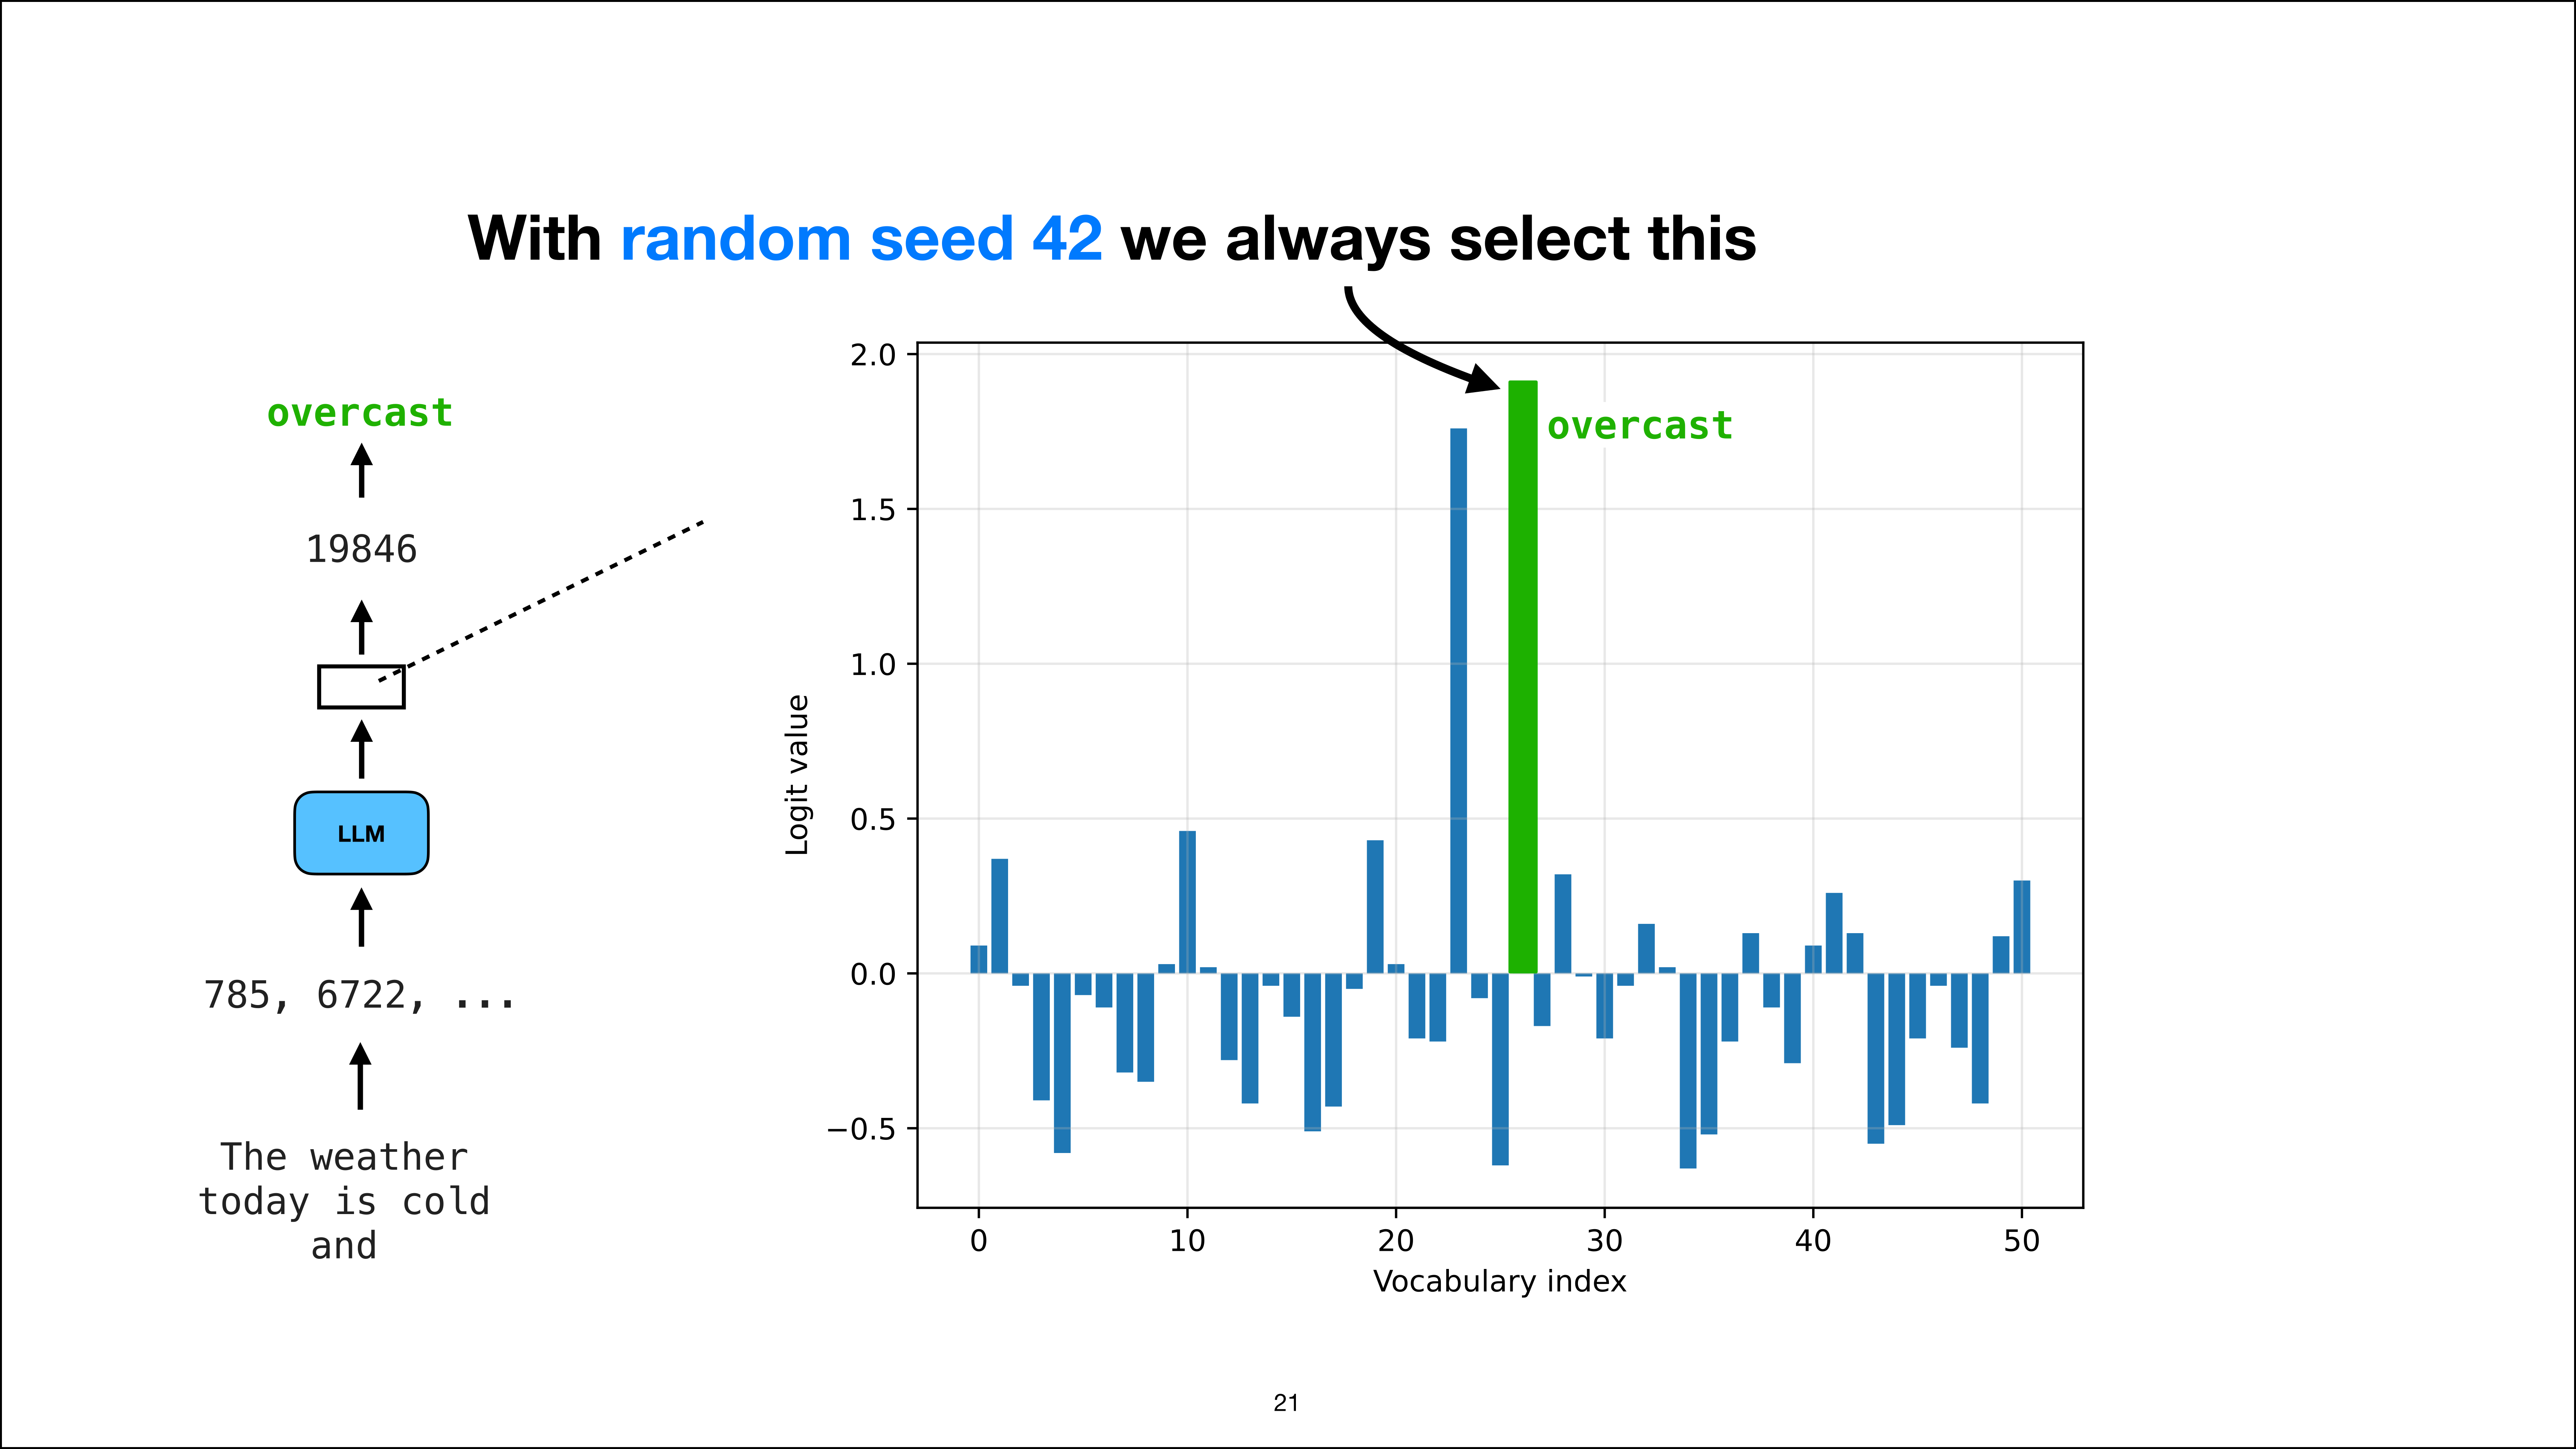
举个例子,我之前提到过随机采样时可能选中 "gray" 或 "overcast"。但如果我们指定一个随机种子,比如 42,那每次都会选中 "overcast"。也就是说,这仍然是随机选择,但通过随机种子让它变成了确定性的。在这个例子里,给定同样的提示词,模型每次都会选中 "overcast"。
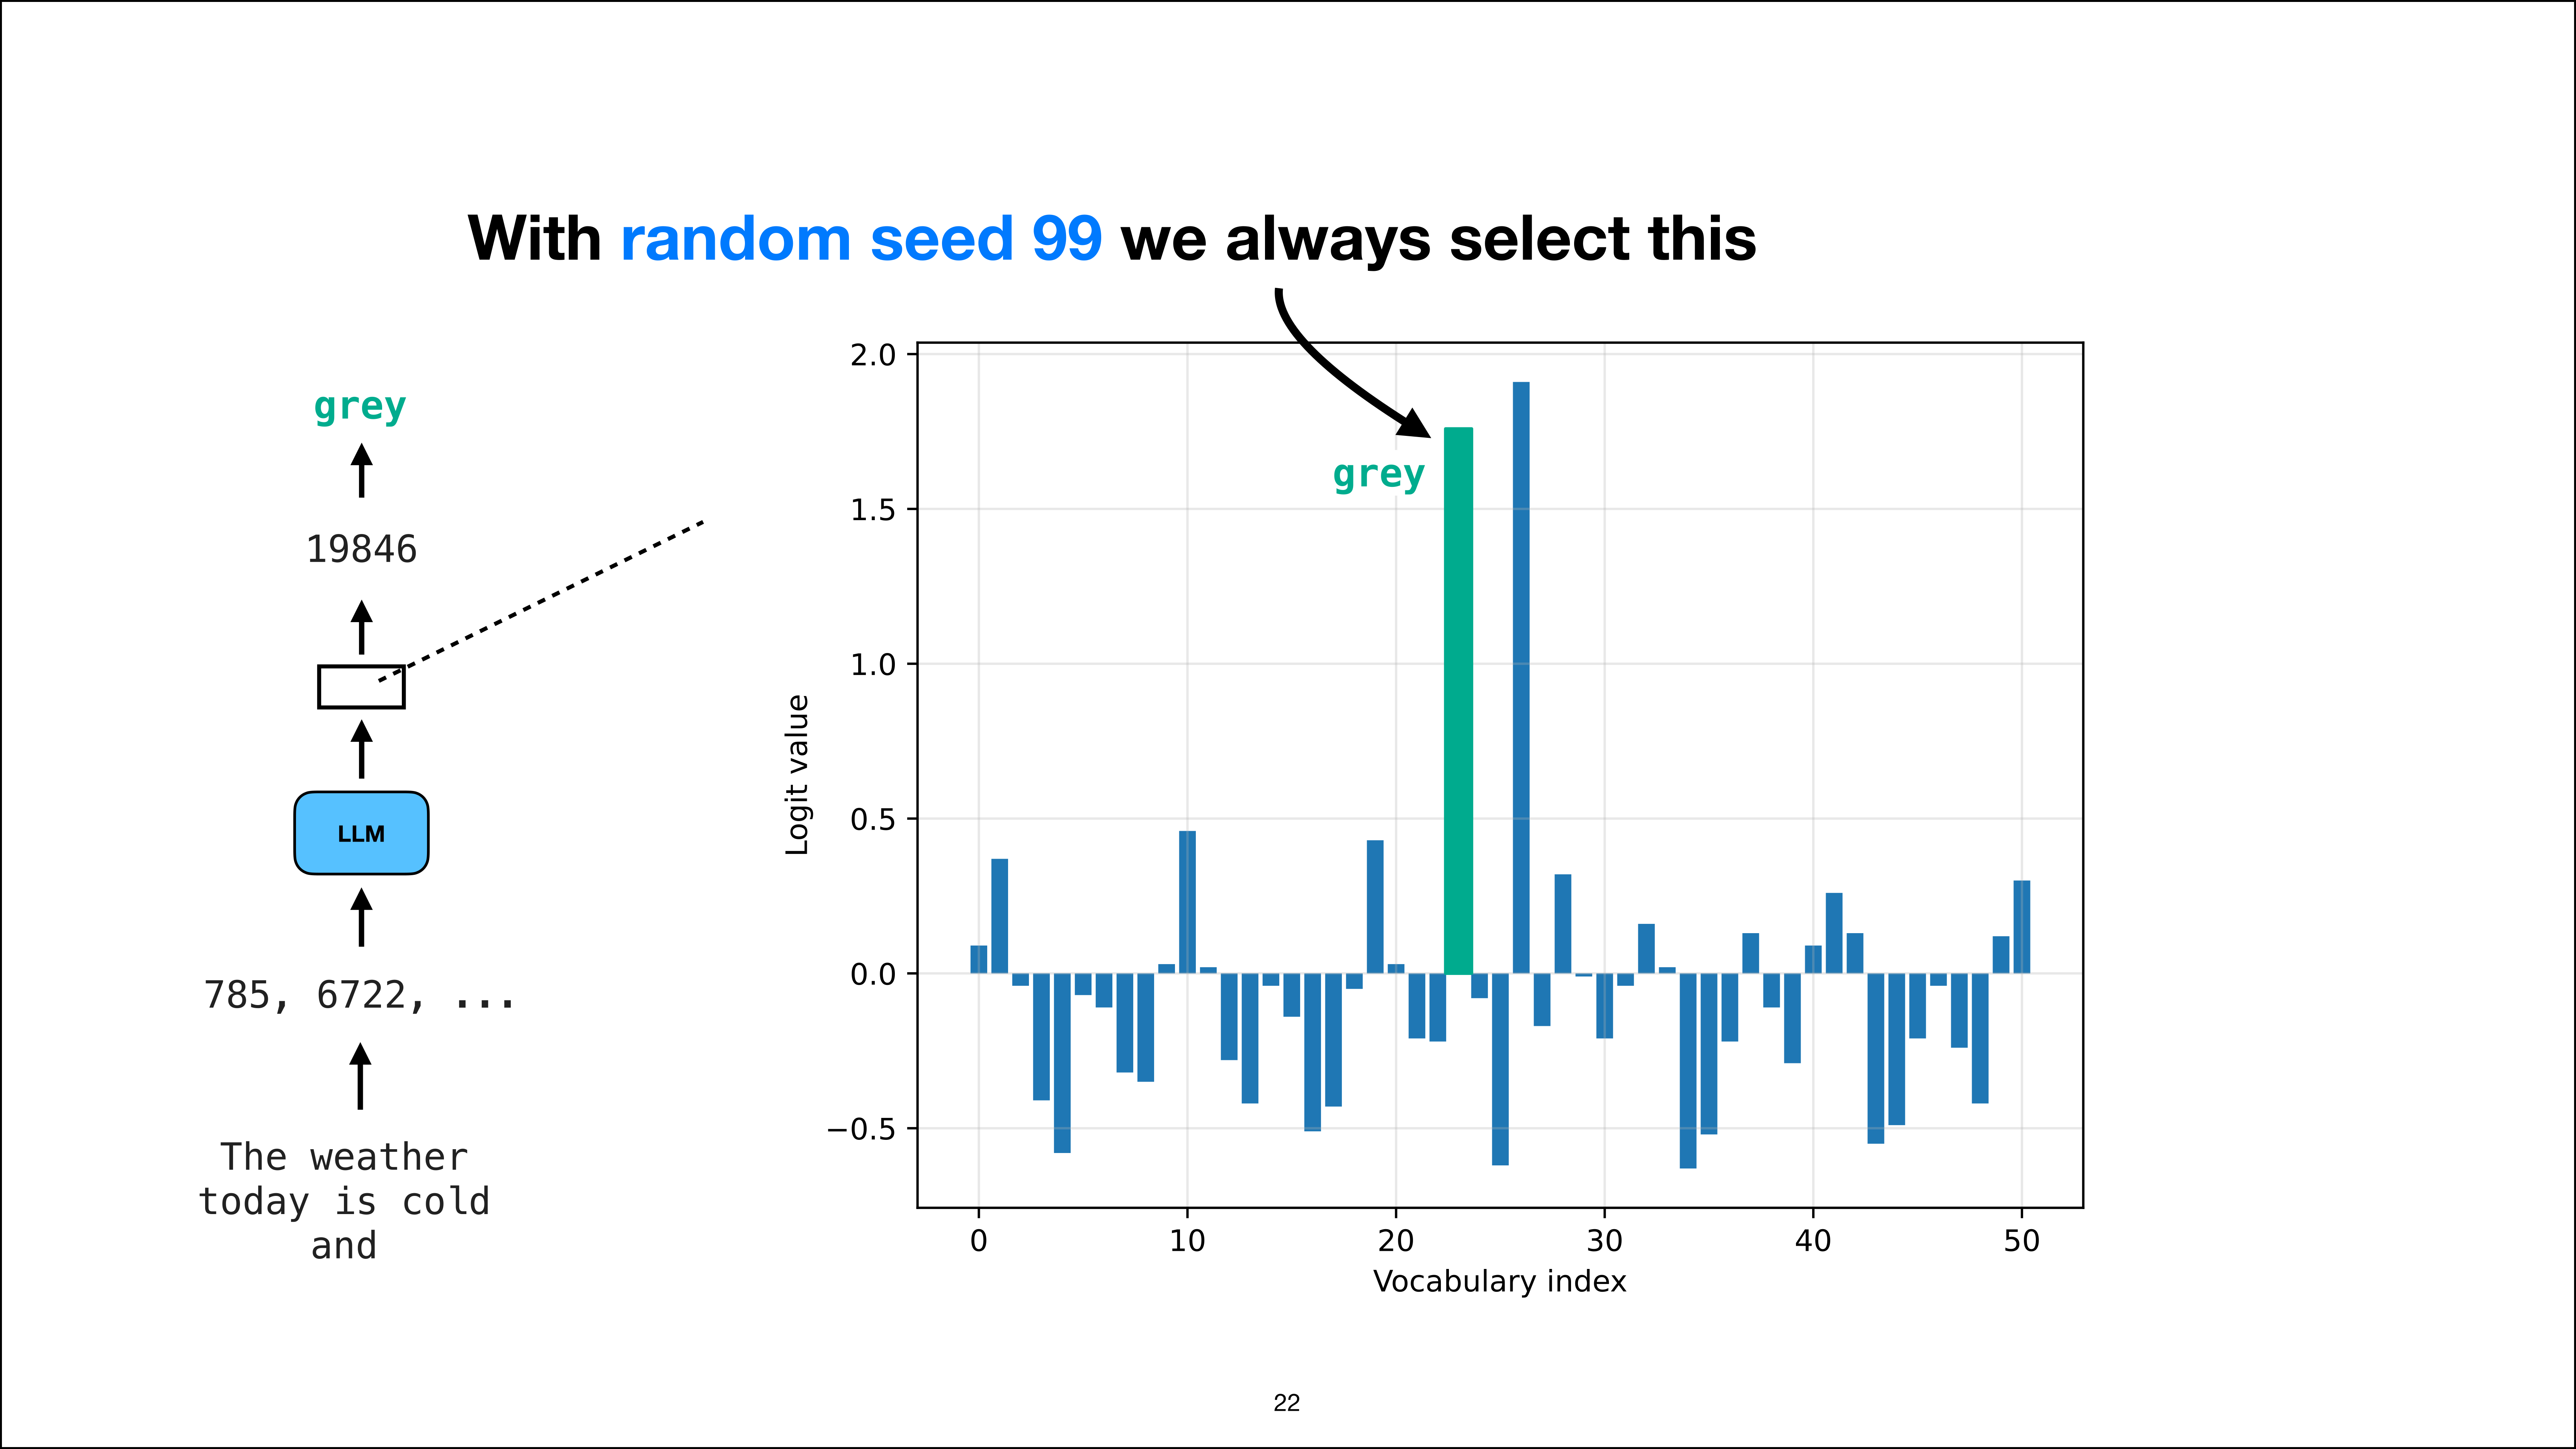
如果换一个随机种子,模型可能就会选中 "gray"。而且每次采样时,下一个 token 都会固定选 "gray"。所以本质上还是随机采样,只是借助随机种子让它变得可复现、可确定。
水印密钥的工作原理
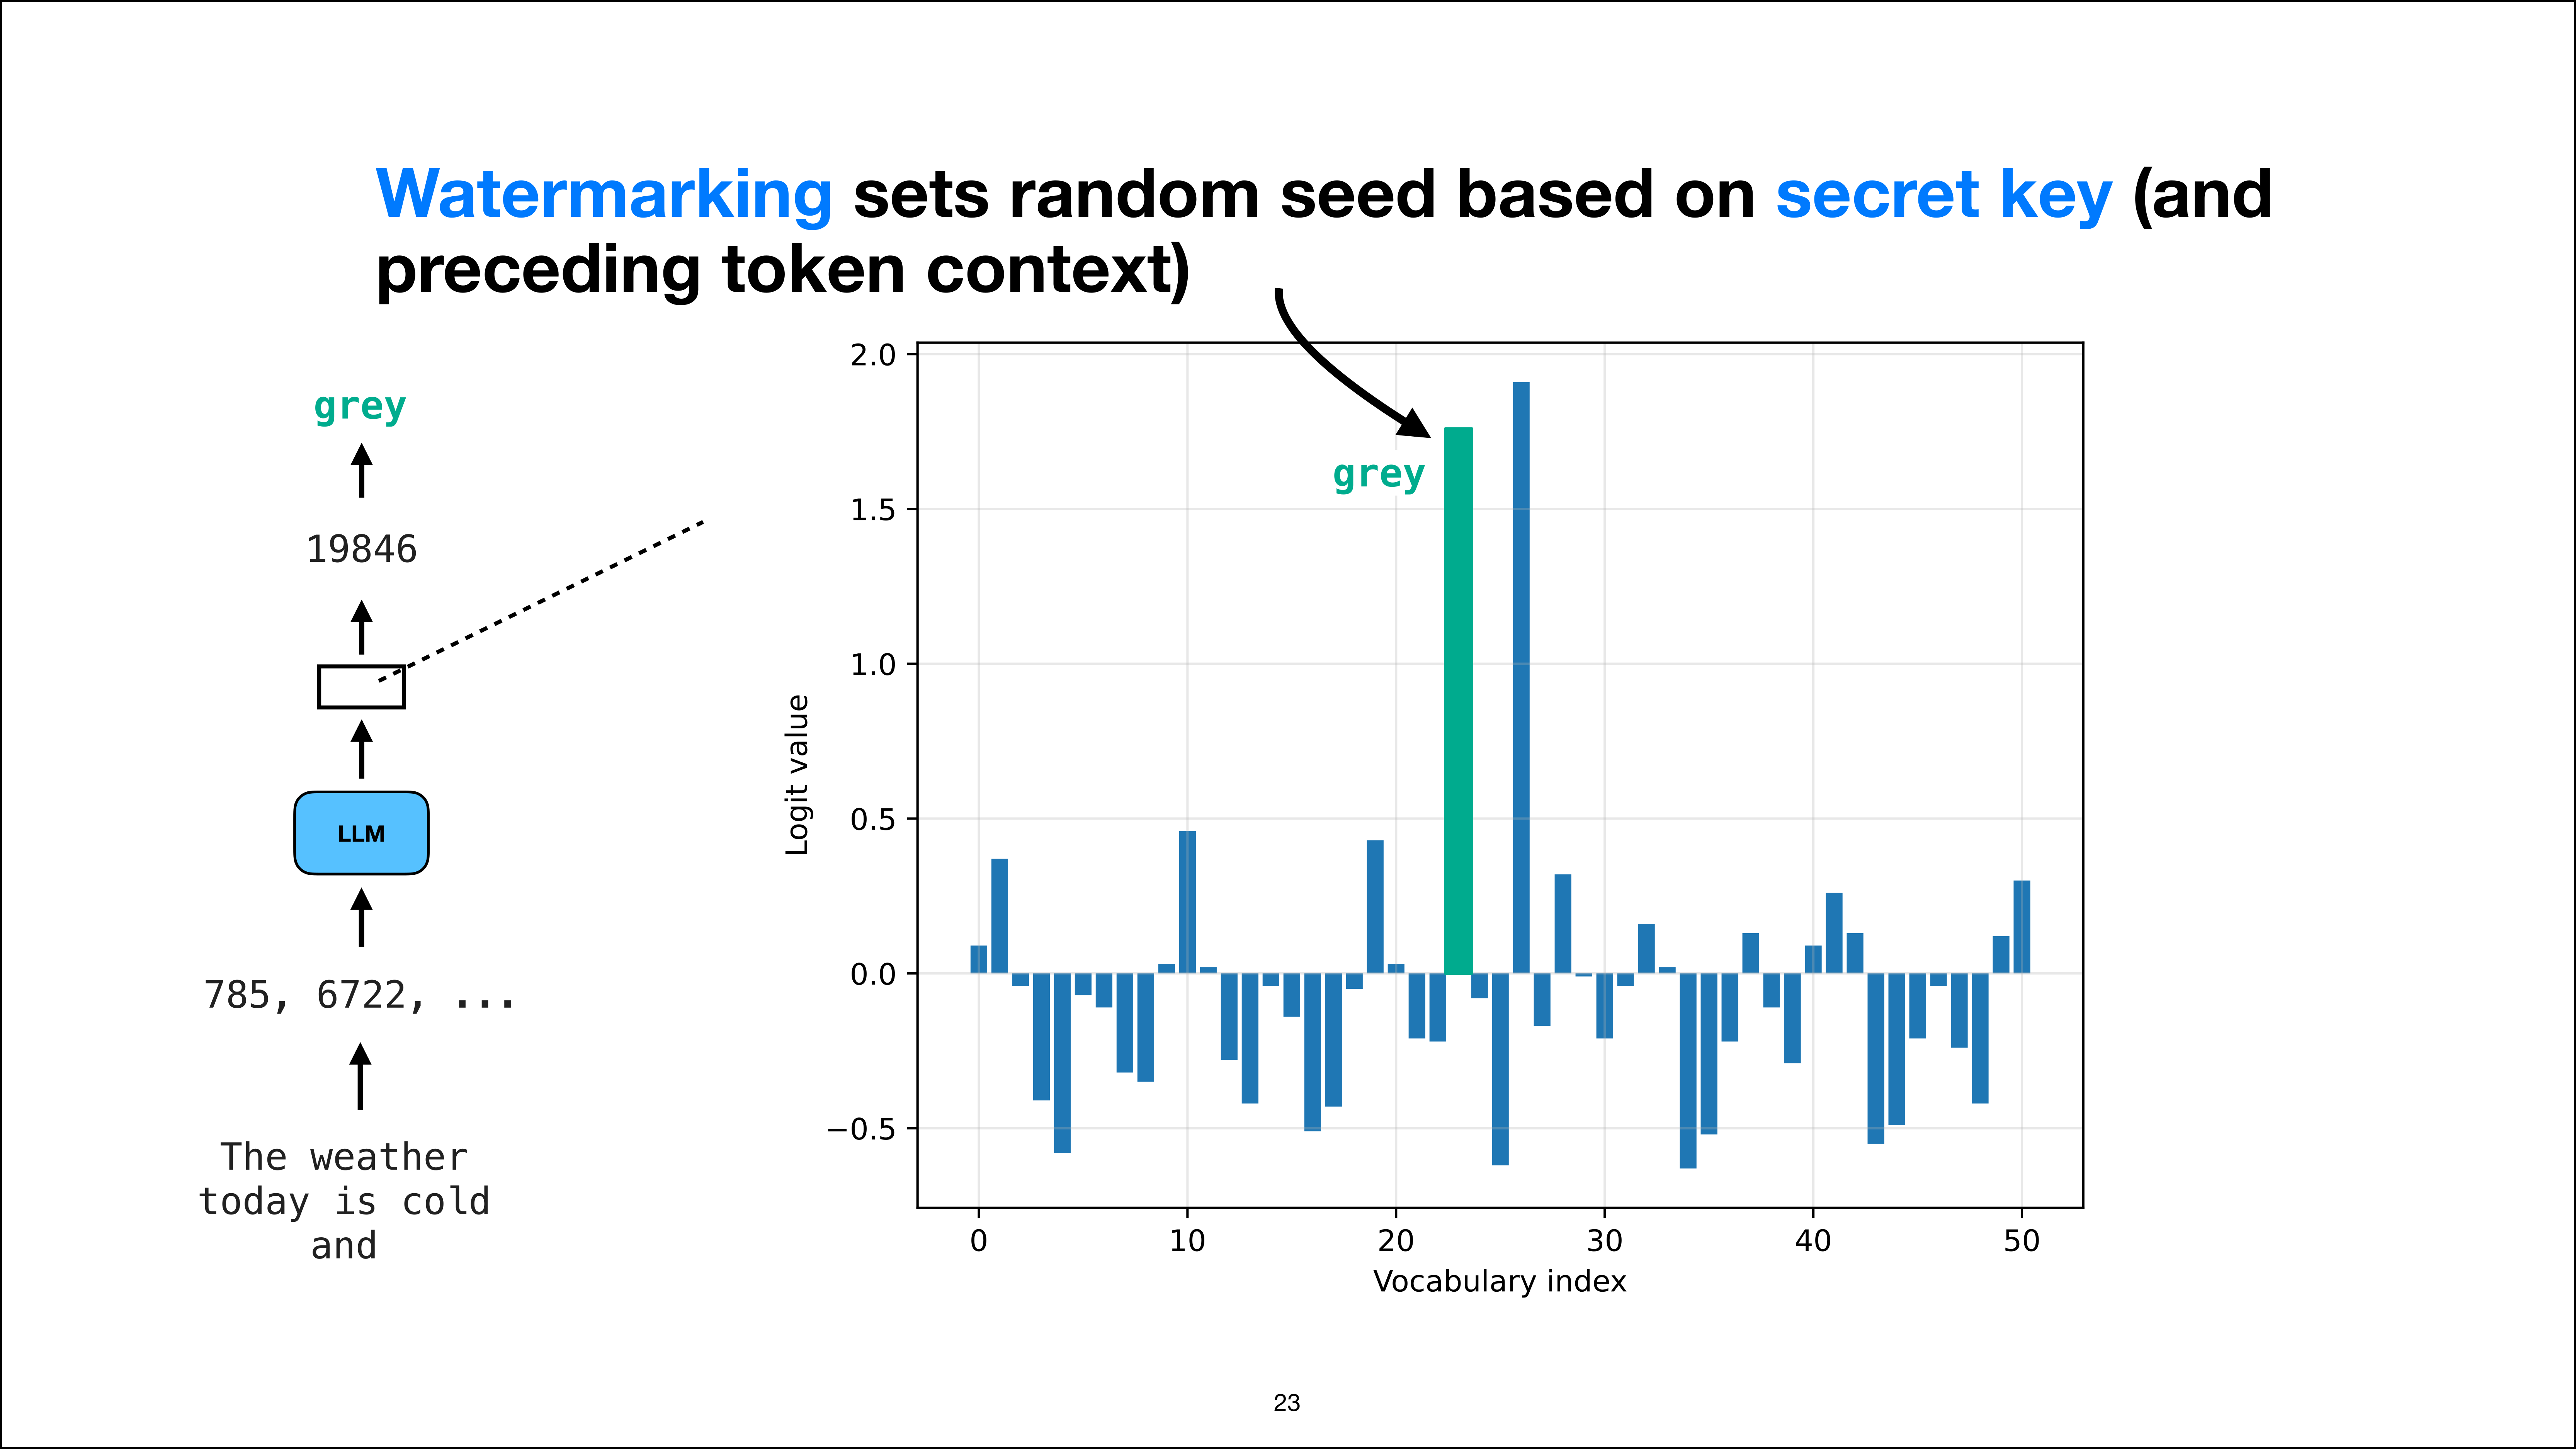
水印技术中,Claude 的方法本质上是设置一个随机种子。但这里的种子并非由某人写死的一个固定数值,而是通过类似 API Key 的密钥,结合前四个词的信息推导出来的。换句话说,他们利用密钥和上下文共同生成这个随机种子。
回顾上一张幻灯片,原理类似:固定的随机种子始终会选择同一个后续 Token。例如,通常可能使用固定种子 99,但在 Claude 的方法中,是通过密钥加上前序 Token 的信息来动态推导种子。具体细节稍后再展开。

水印技术让文本生成在特定位置变得更确定。例如,左侧展示了多种合理的文本可能。假设有一句话:
> 今天天气寒冷,且
后面既可以接“阴沉”也可以接“灰暗”。下一句可能是:
> 随后,“轻风”或“微风”
这两个词也是可以互换的。
> 然后,微风在树间“拂过”或“吹动”,街道显得“宁静”或“静止”。
换句话说,我可以说“安静”,也可以说“宁静”。这意味着文本中有某些位置,不同的 token 选择概率几乎相同,就像我们之前看到的。也就是说,在没有加水印的情况下,当我们让 LLM 处理提示词时,有时会得到这个答案,有时又会是那个答案,如此种种。
根据位置的数量,这里可能有 128 种潜在答案。当然,文本越长,可替换词的位置就越多,可能的组合也就越多,生成的文本输出自然也更多。举个例子,其中一种可能的输出是:
> 今天天气又冷又阴,微风轻拂过树梢,街道显得格外宁静。我想留在家,泡杯茶看本书。
这是其中一种可能的文本。另一种则是:
> 今天天气又冷又灰,柔和的微风穿过树林,街道显得静悄悄的。我想留在室内,捧杯茶读本小说。顺便说一句,外面其实还在下雨。我不知道这个麦克风效果如何,但这情景倒是挺应景的。
总之,你可以看到,这里生成了两段都很合理的文本,而且还有更多可能的组合。它们都很合理,没有哪一段一定比另一段更好,只是细微的变体。如果我们不加水印,可能会得到其中一种,这纯粹是随机的。由于随机采样的存在,我们可能得到这个,也可能得到那个。
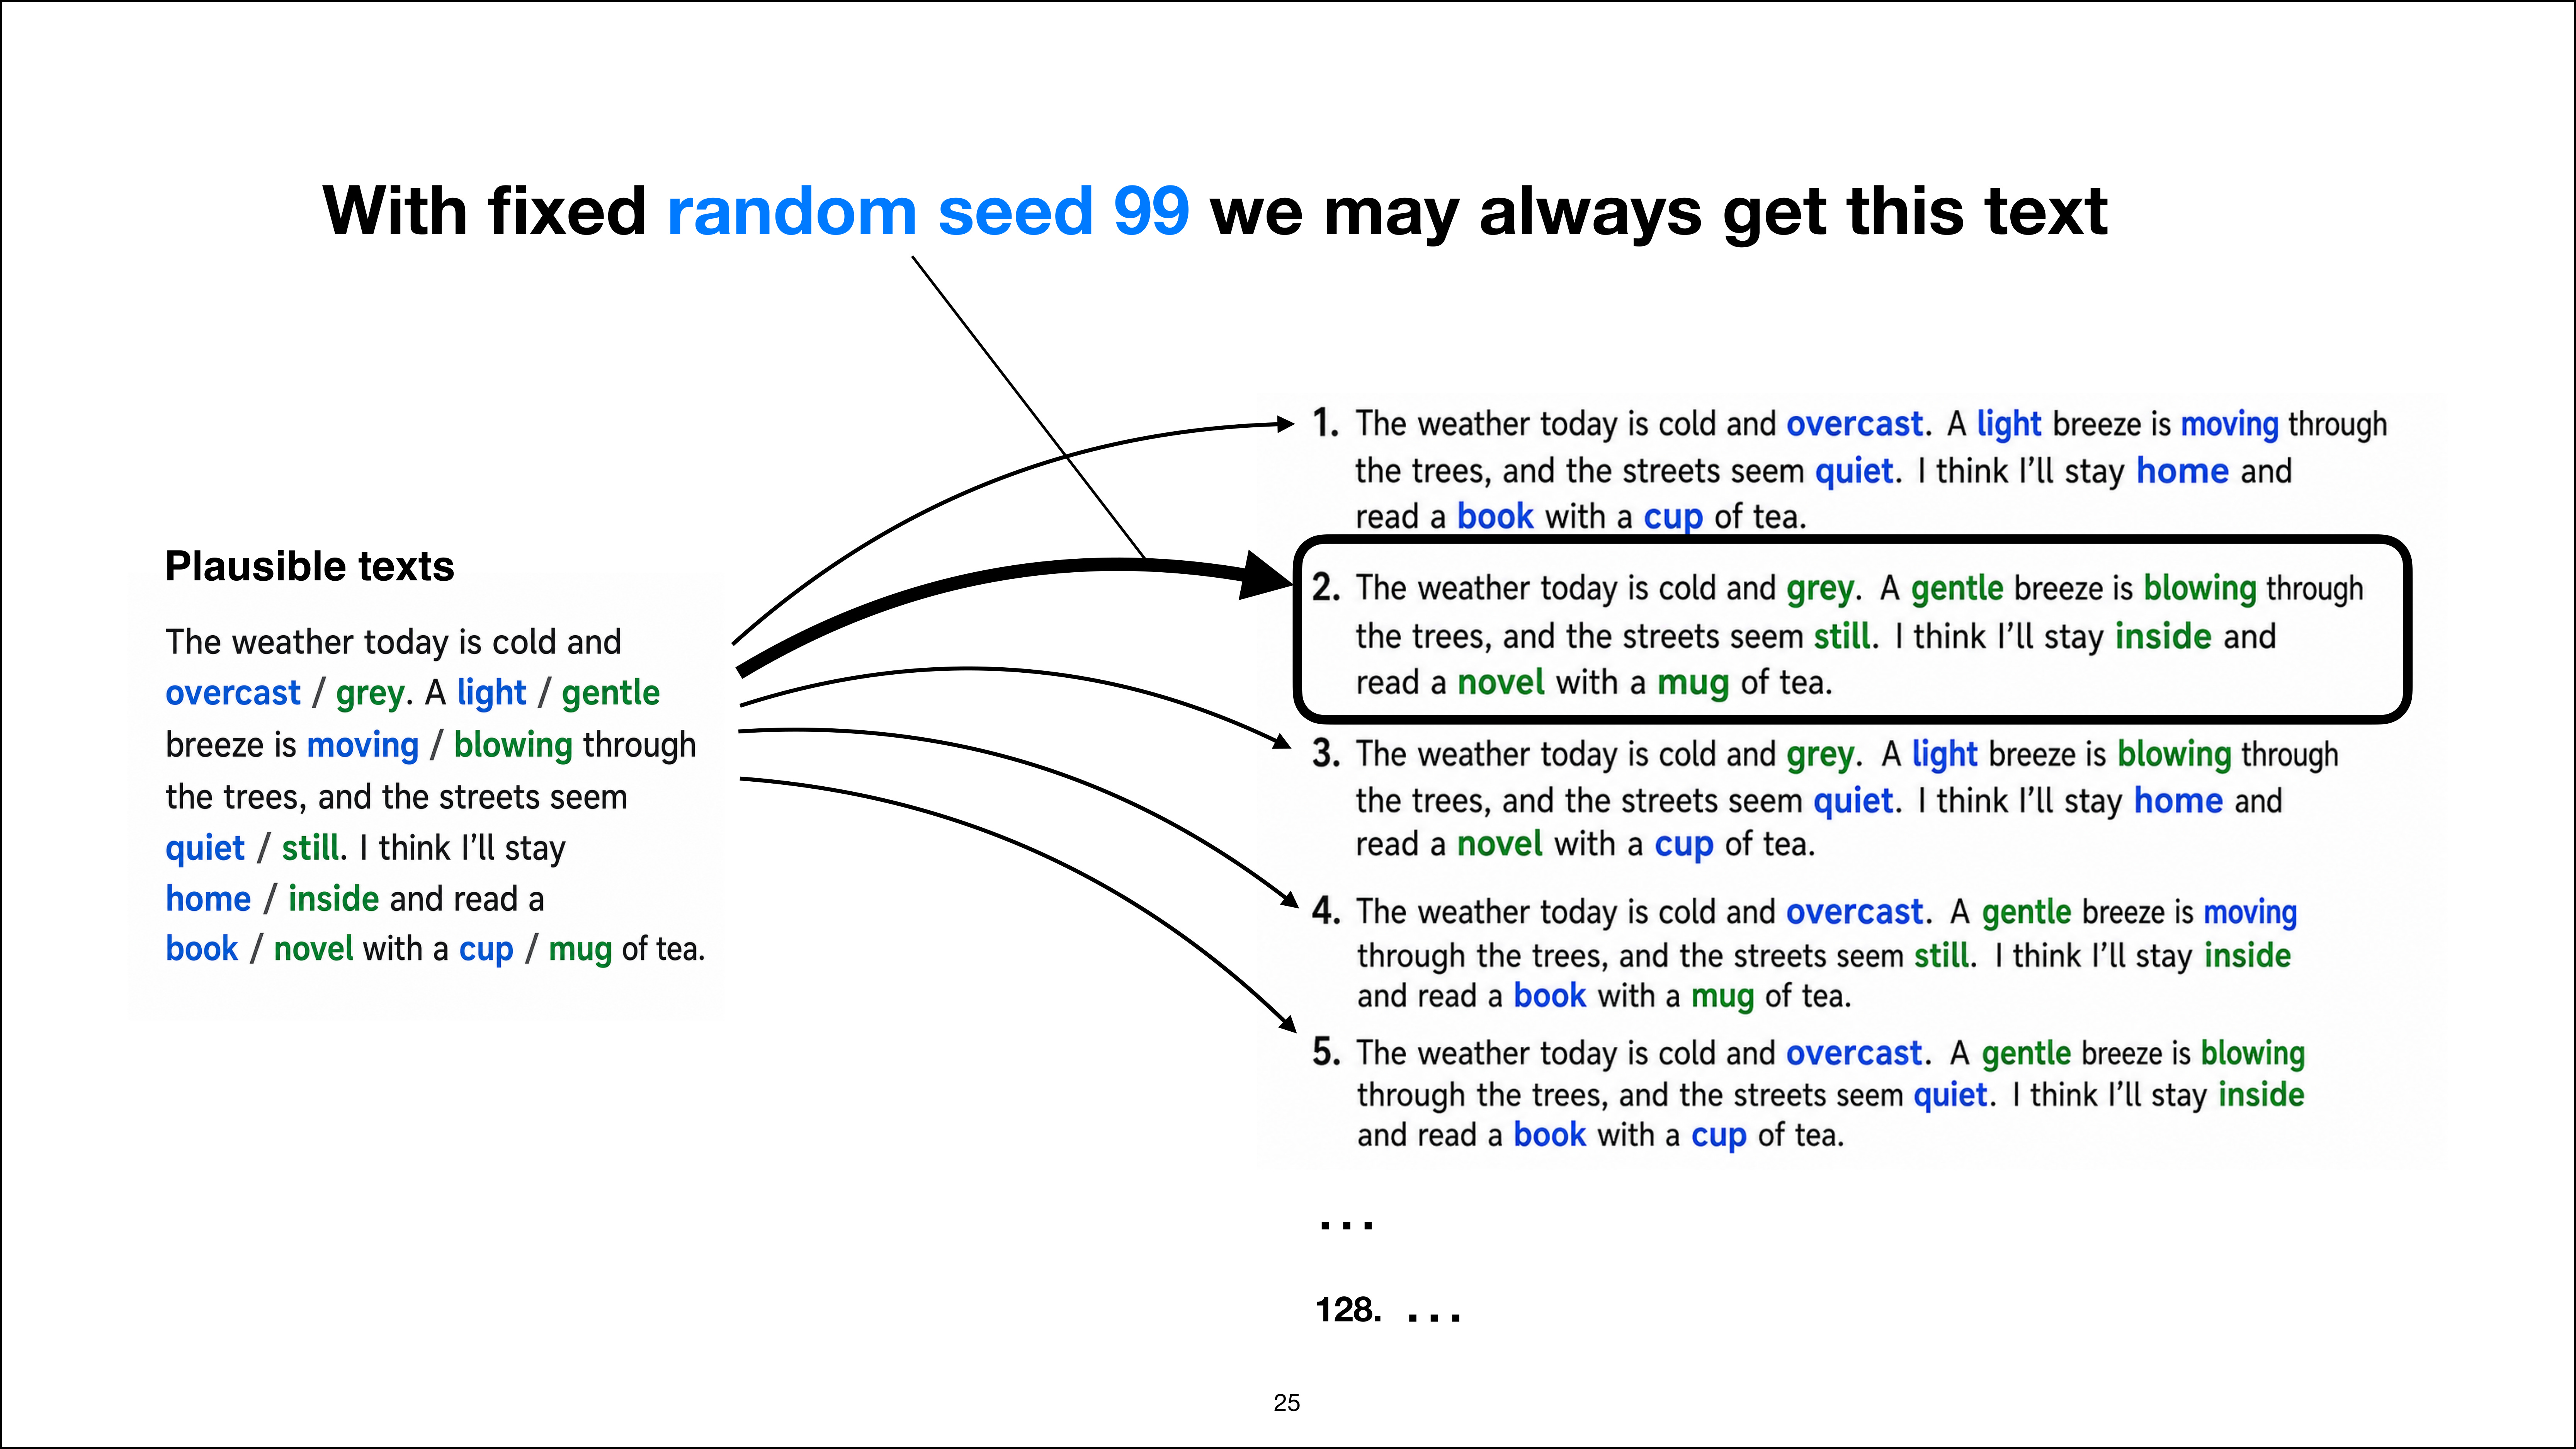
现在,如果我们固定随机种子——之前提过,比如种子设为 99——那么每次可能都会得到同一段文本。也就是说,借助随机种子,我们可以“锁定”输出结果:采样过程仍然是随机的,但同时又是可复现的、确定性的,每次都一样。好,这依然是没加水印、只用随机种子的情况。
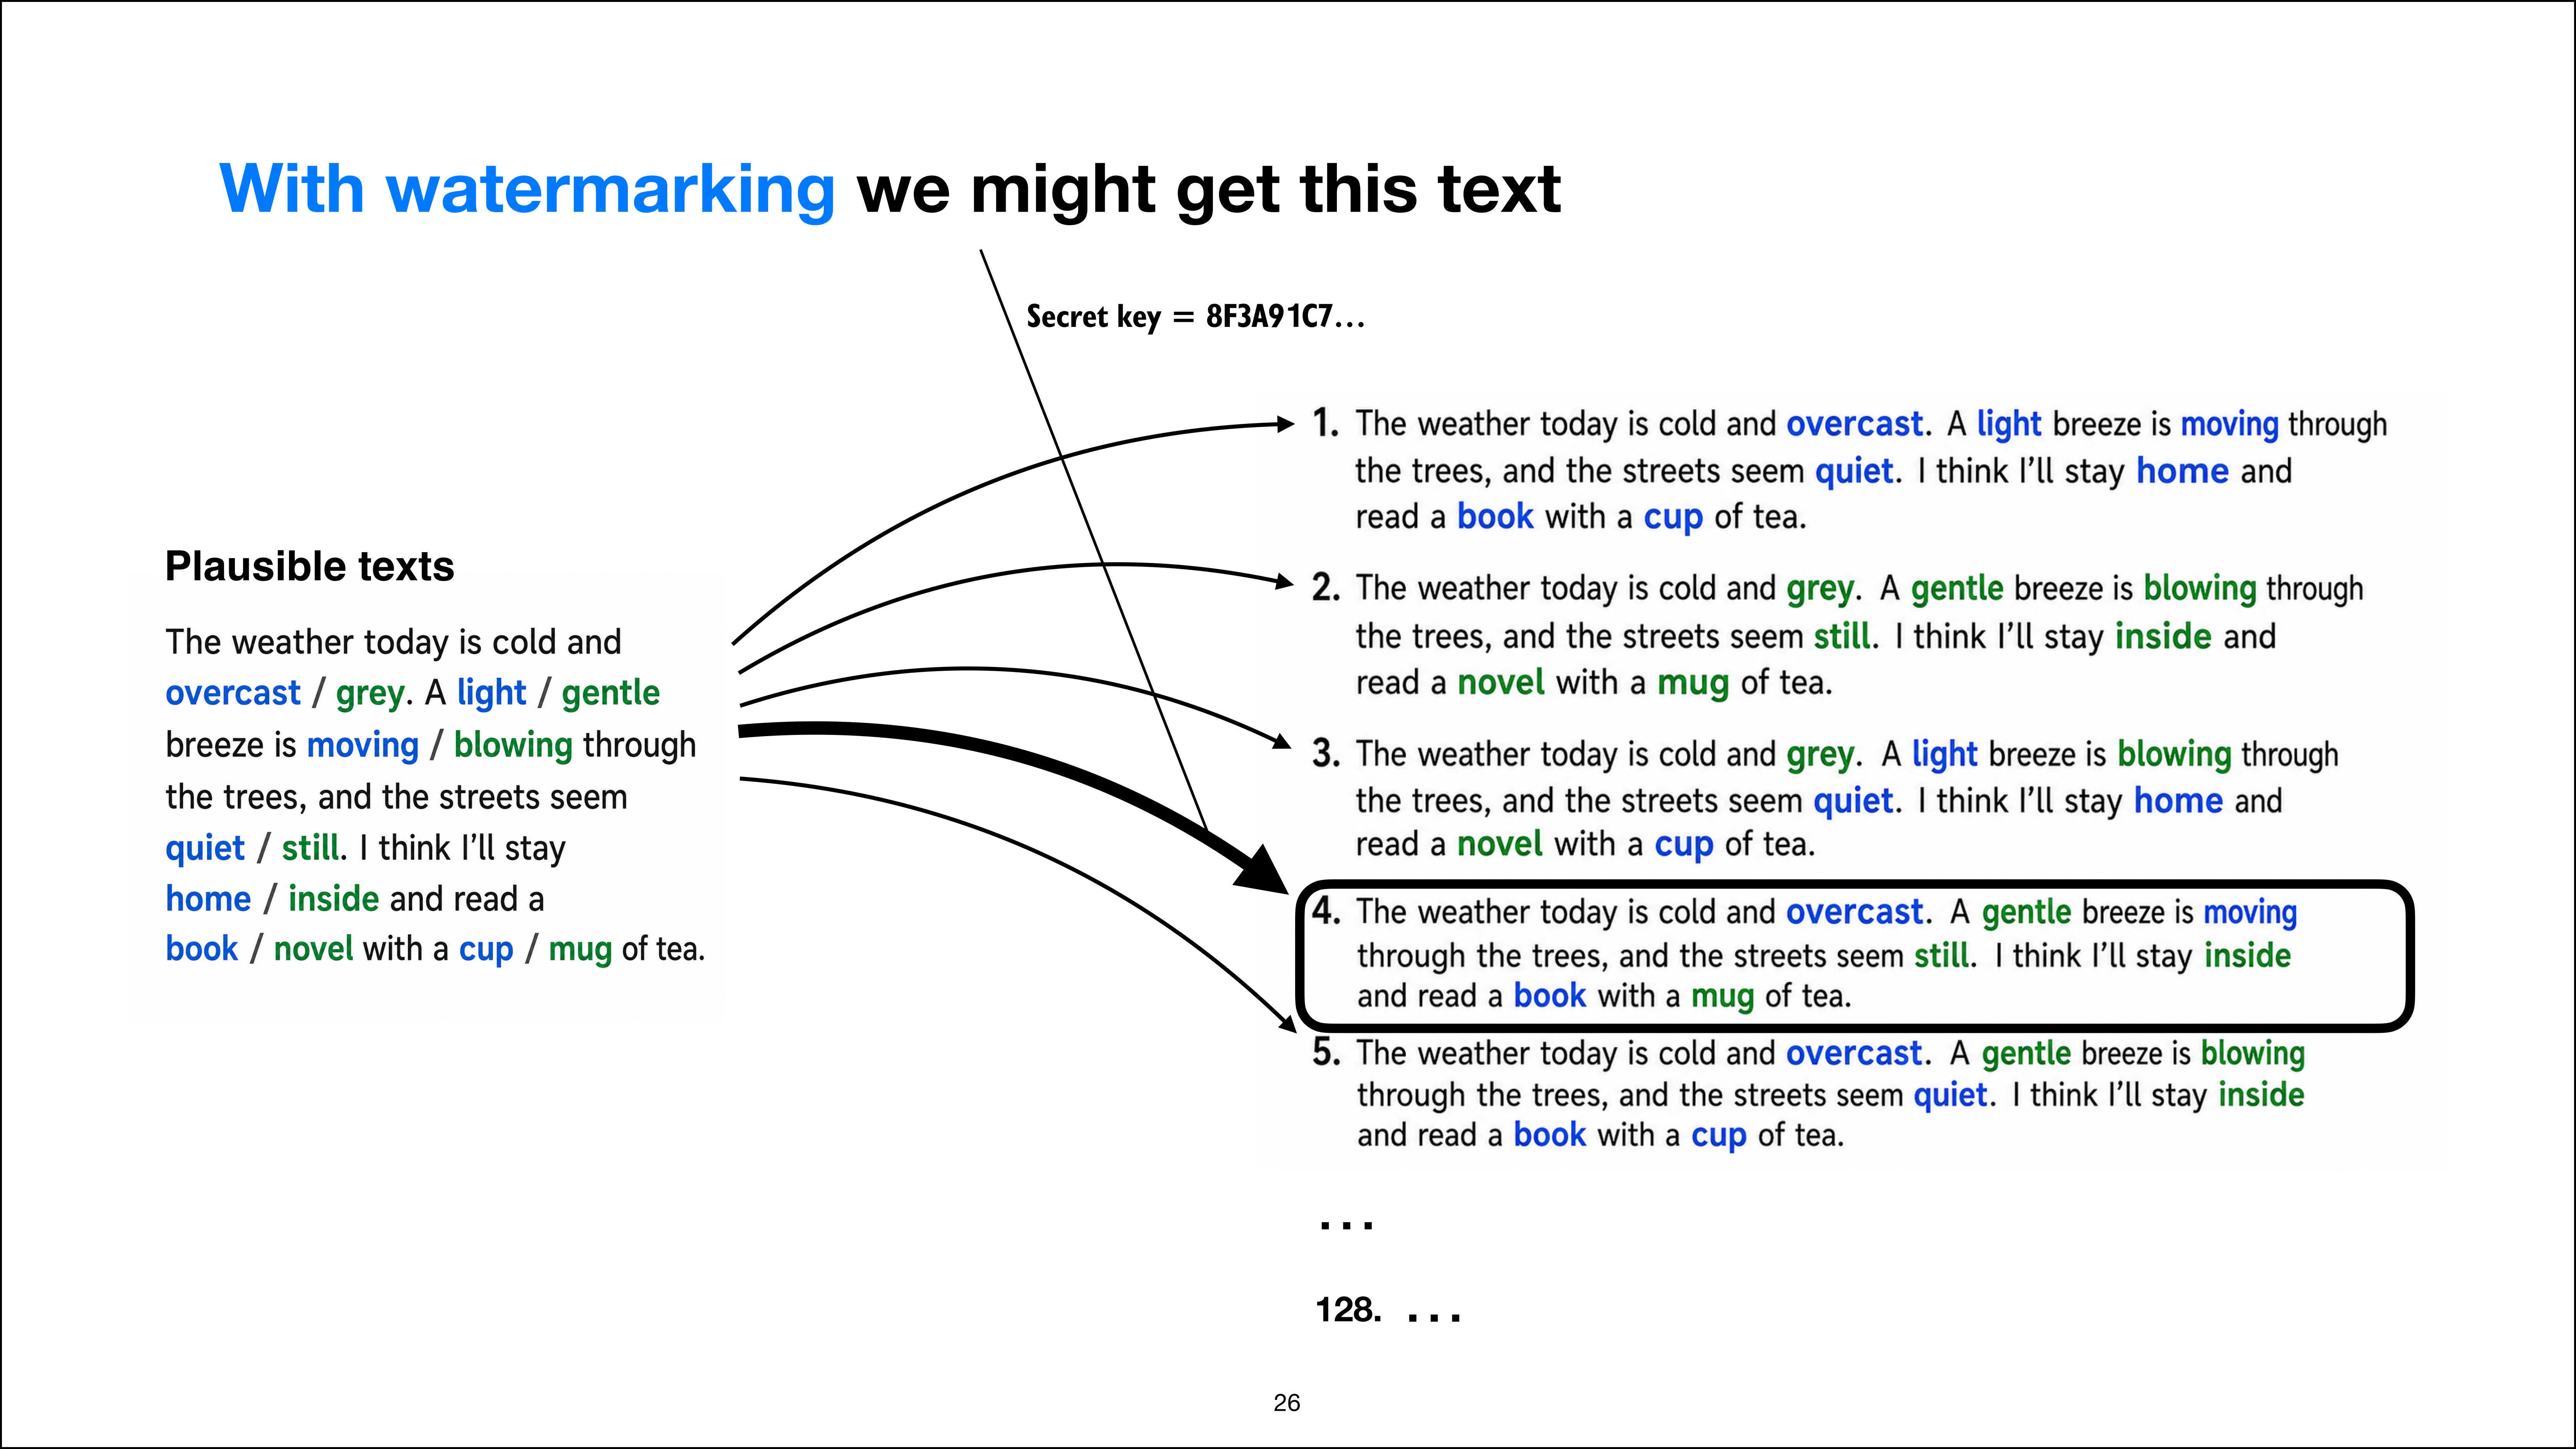
水印本质上做的事情是一样的,只是不再用简单的随机种子,而是用一个所谓的随机密钥(key),由这个密钥参与决定生成哪段文本。由此我们不难看出 Claude 博客里说的那句话为什么成立——水印不会让文本质量变差。
顺带说一句,我不是在为水印辩护,只是在解释原理,别迁怒于我。我想说的是:对最终用户来说,加水印无非就是固定了一个随机种子,让采样变得某种意义上的确定性,就这么回事。
水印施加在哪里
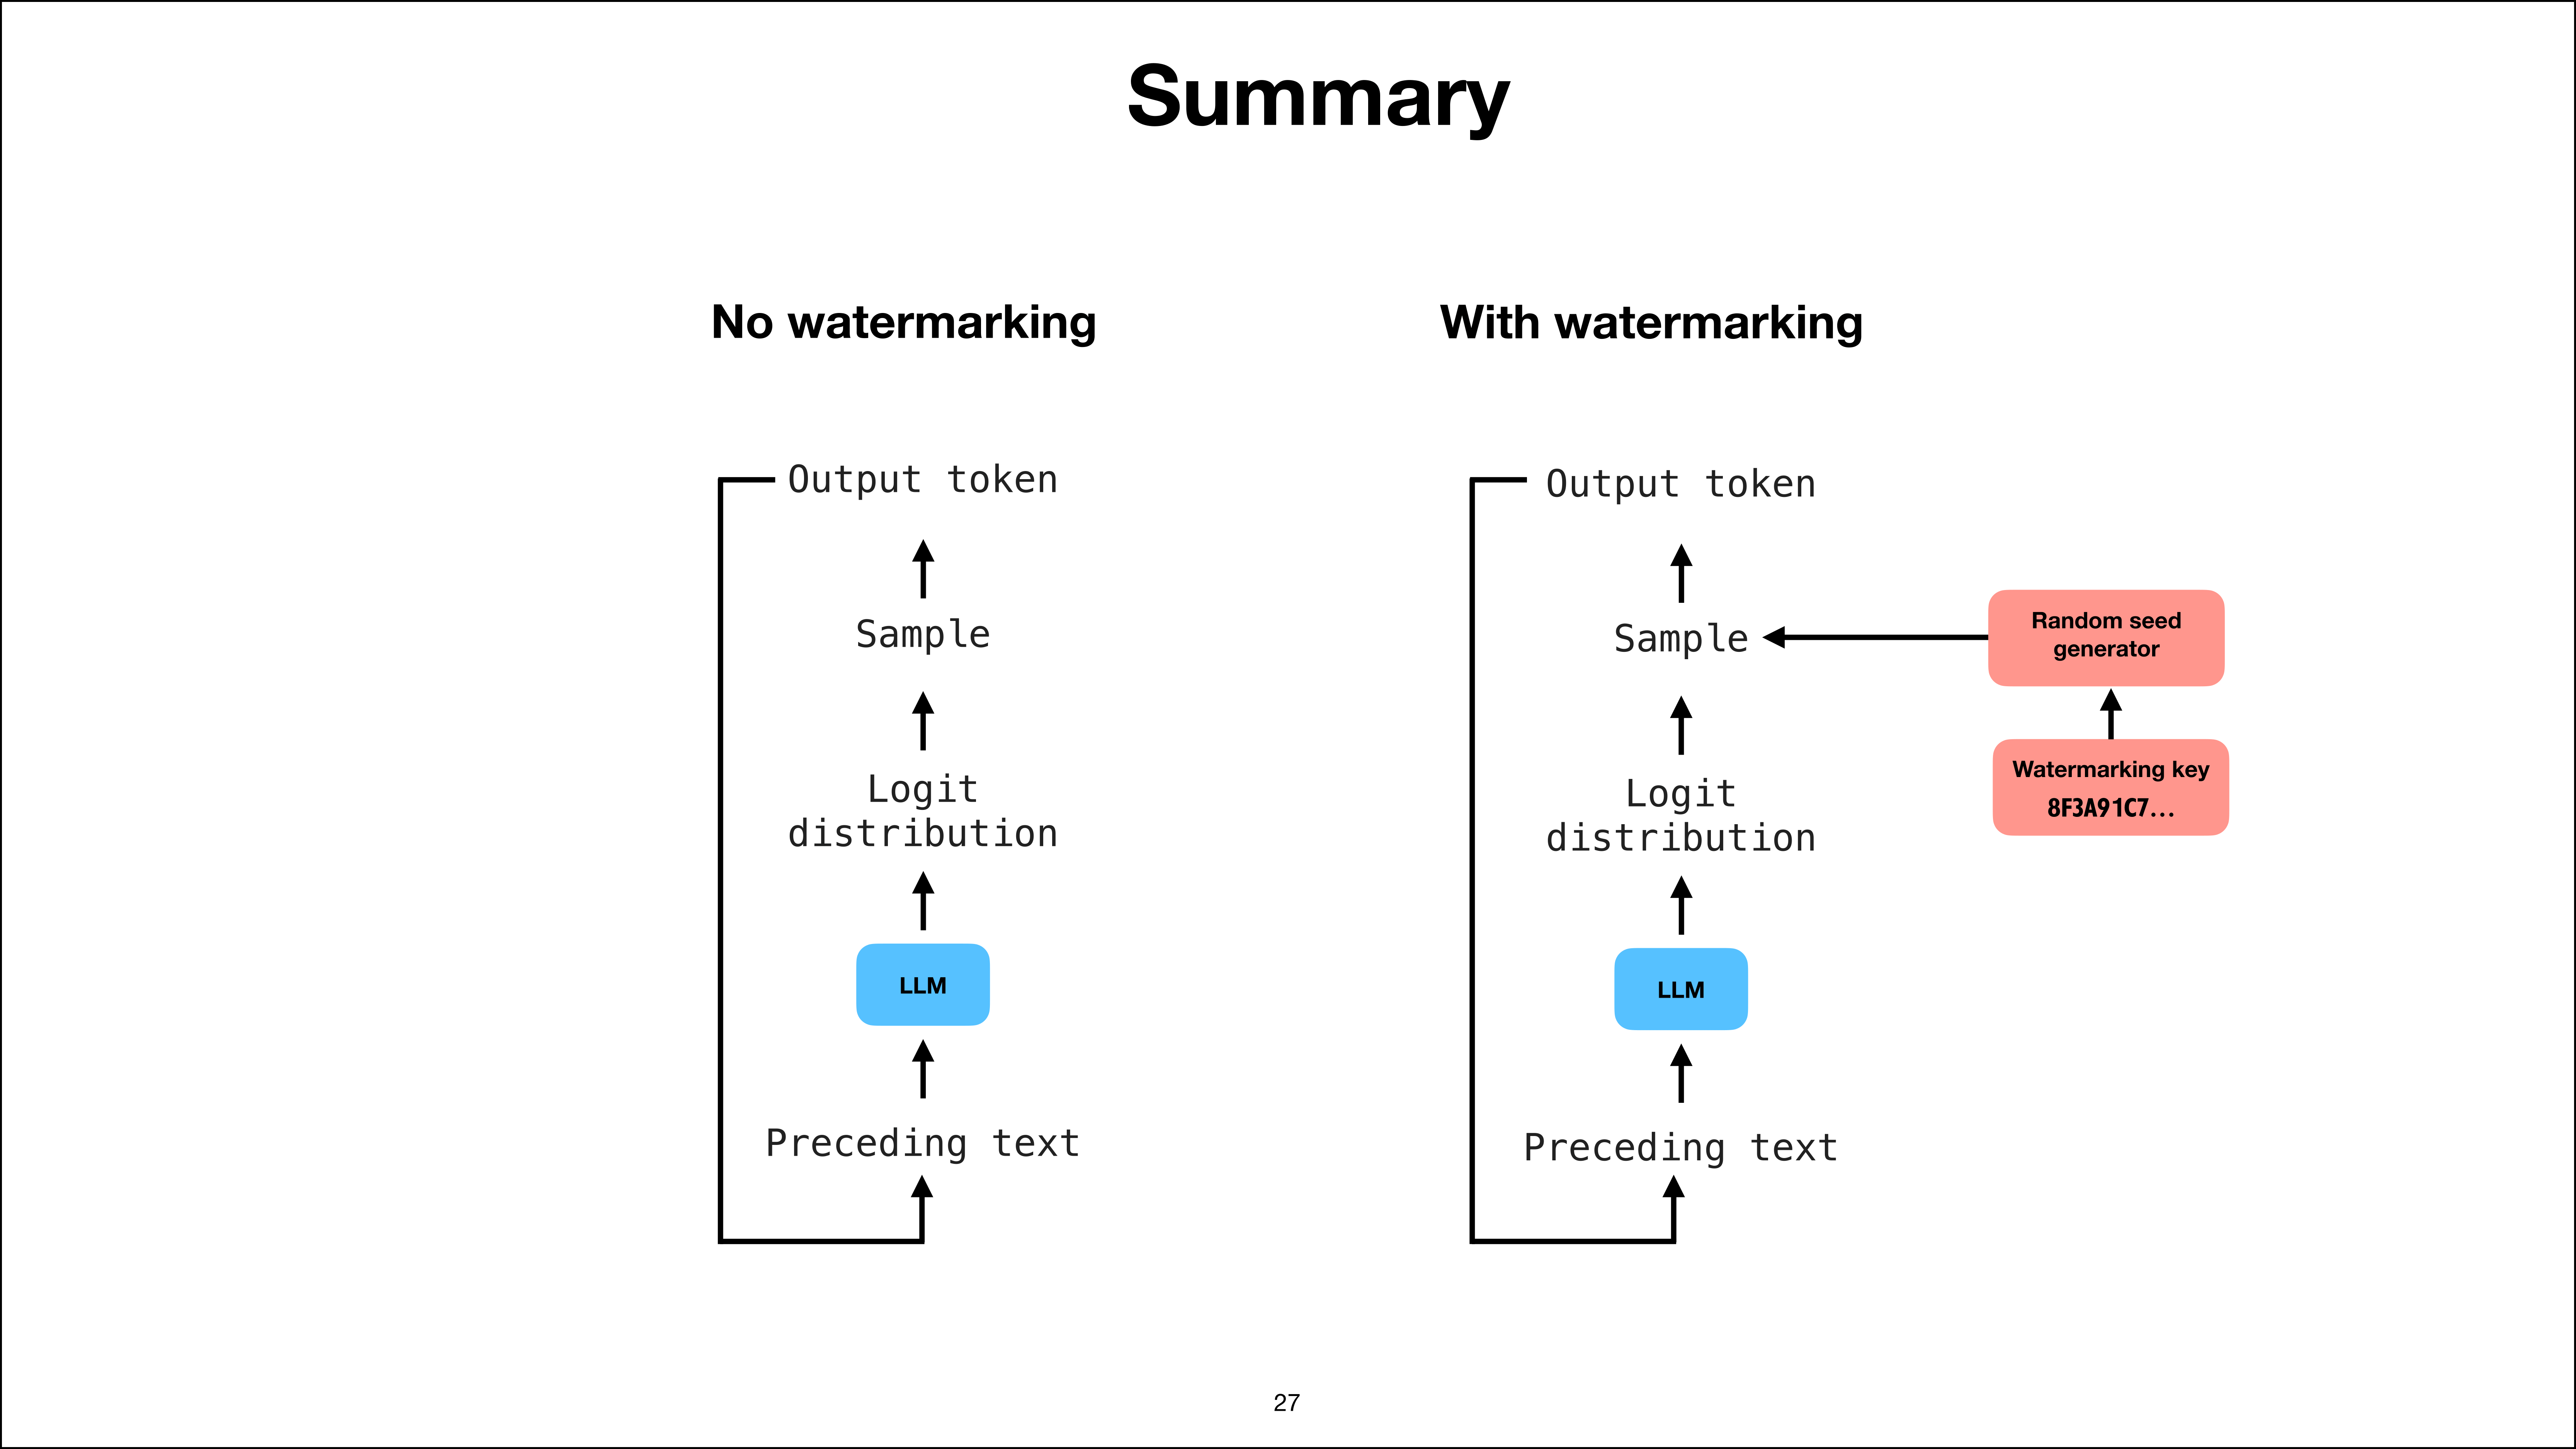
那么,目前的总结是:在没有水印的情况下,我们通常不使用随机种子进行采样,因为我知道大多数人甚至都不用随机种子。老实说,我不确定你通过 Claude 和 OpenAI API 能否做到这一点。我知道你可以在 Ollama 里实现,但我之前也有些问题,因为我在书中用作奖励材料时,用 Ollama 生成过一些文本。
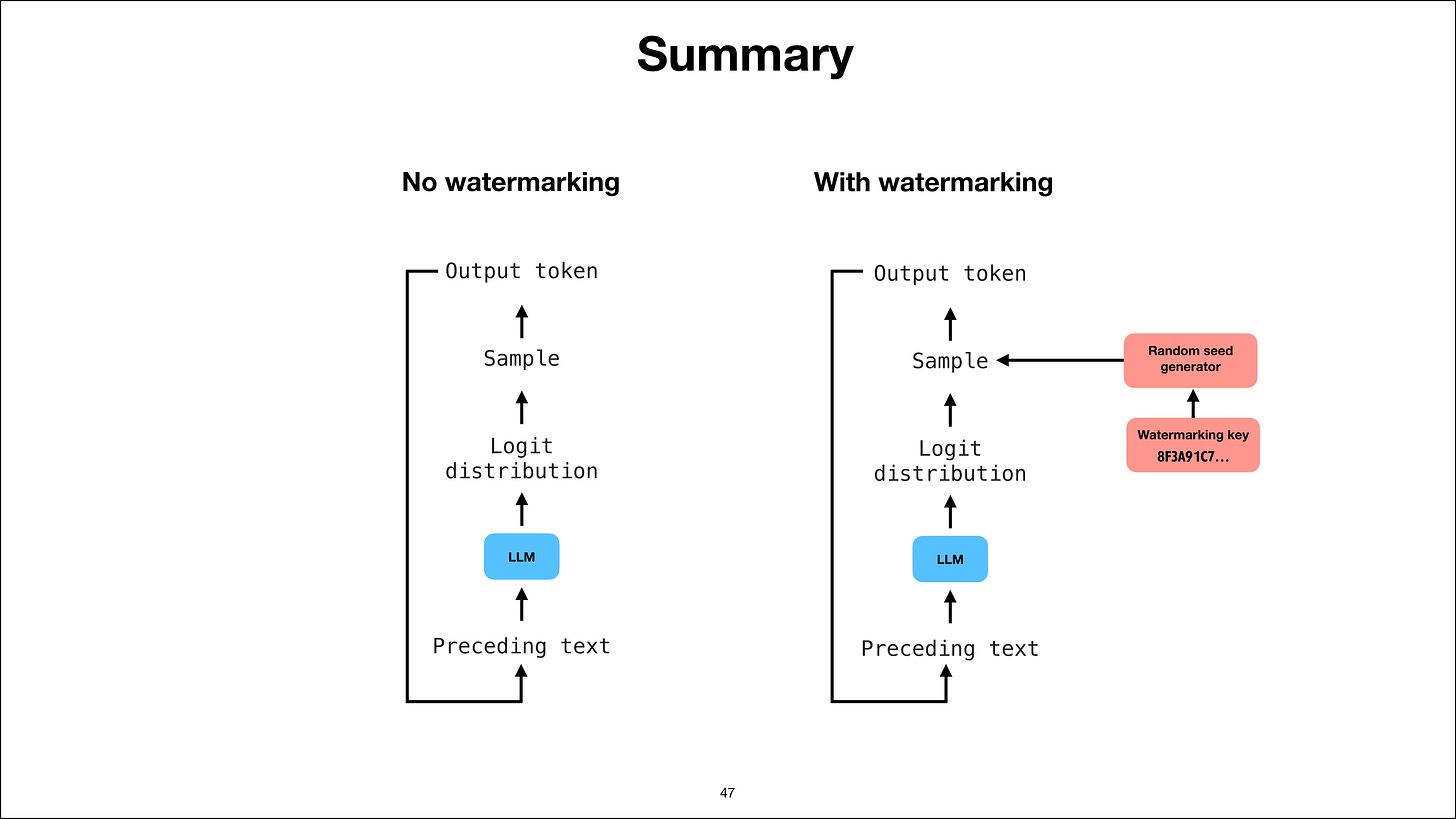
我固定了随机种子,但它仍然并不总是具有确定性,诸如此类。所以这很棘手。根据软件版本等因素,你的体验也可能会有所不同。总之,在没有水印的情况下,我们进行随机采样。右边带有水印的情况,我们仍然进行随机采样。但除了纯随机采样之外,我们还有一个水印密钥。
这个水印密钥被传递给随机种子生成器,以设置特定的随机种子,使其具有确定性。但本质上非常相似,正如我所说,从头理解这些事情有很多好处。现在我们知道这个水印本质上是应用在哪里了。它应用在采样阶段,而不是在 LLM 内部,这其实是个很酷的知识。
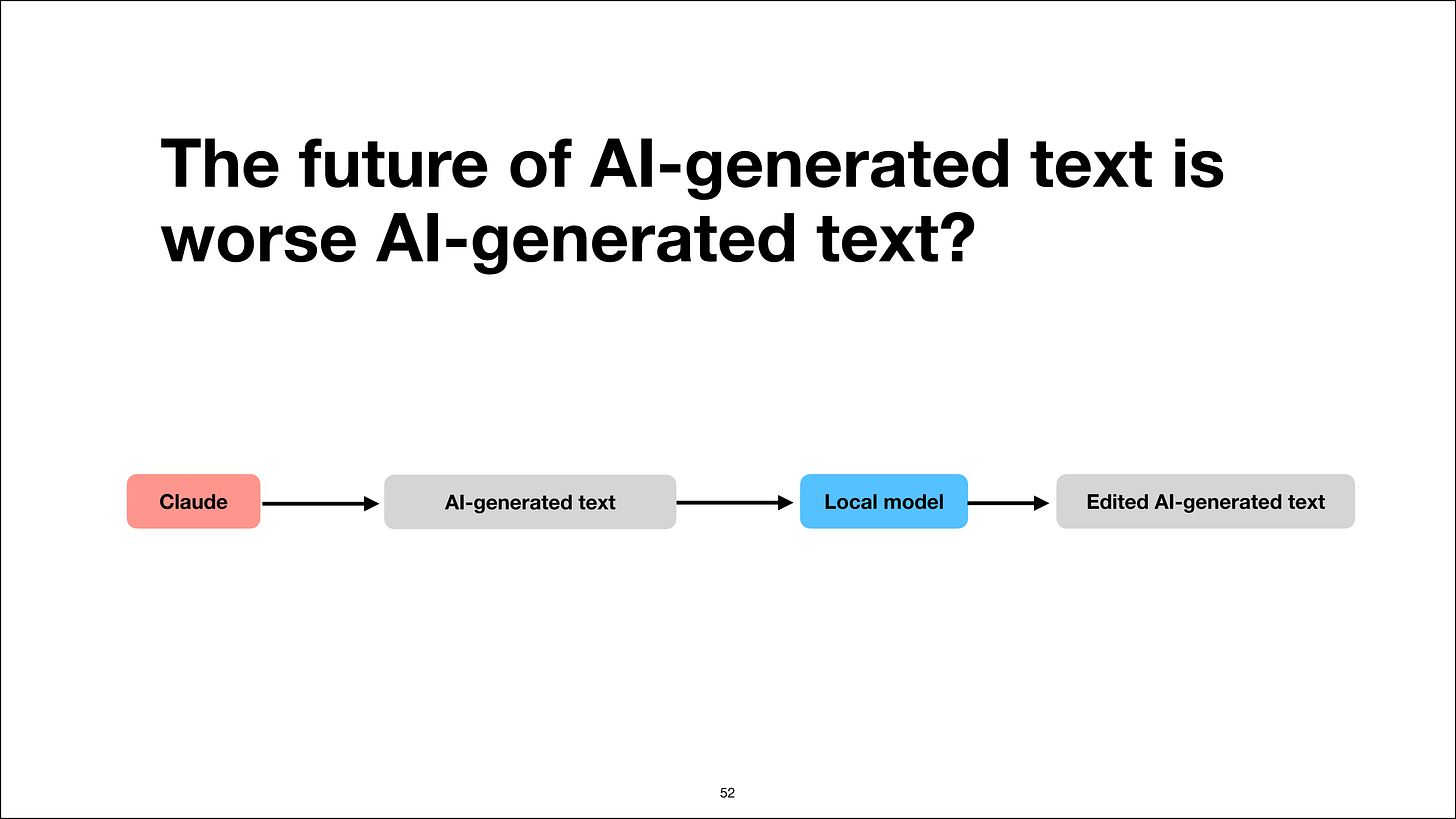
因此,他们不需要为此训练一个新的 LLM。他们可以使用现有的 LLM,只在这个采样阶段应用即可。他们不需要重新训练任何东西。所以,是的,这确实很有趣,对吧?
水印检测是如何工作的
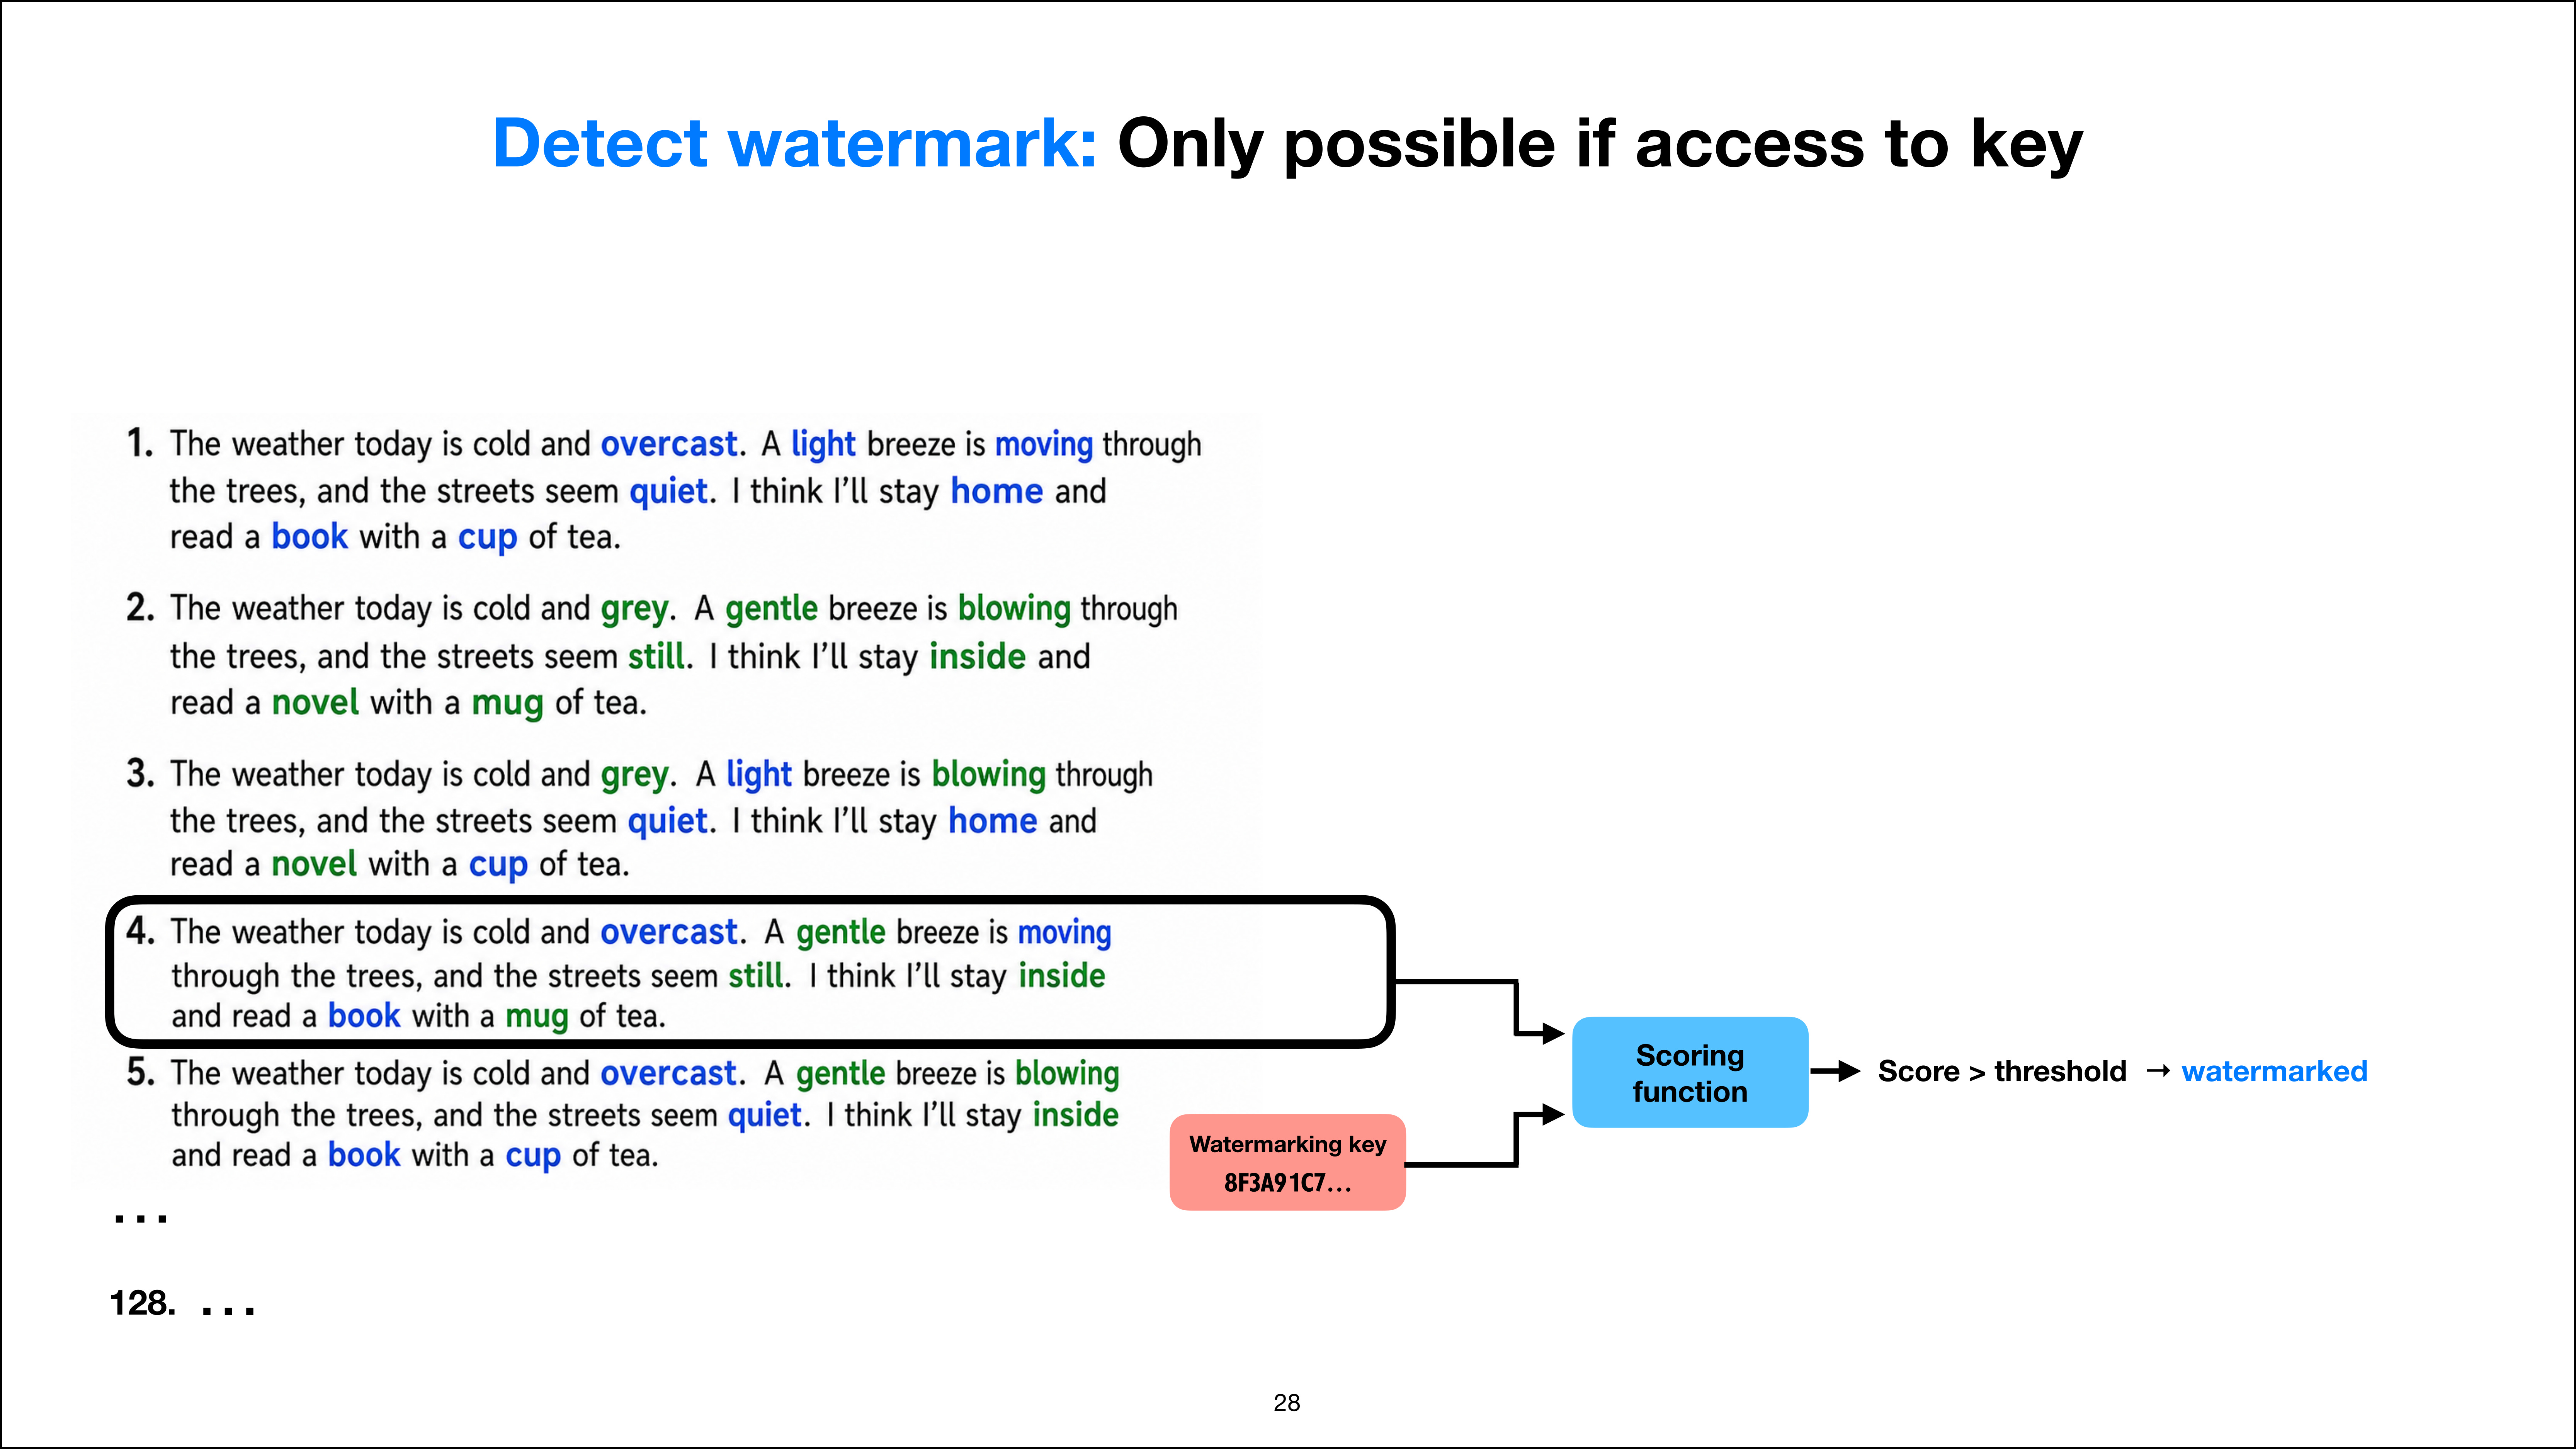
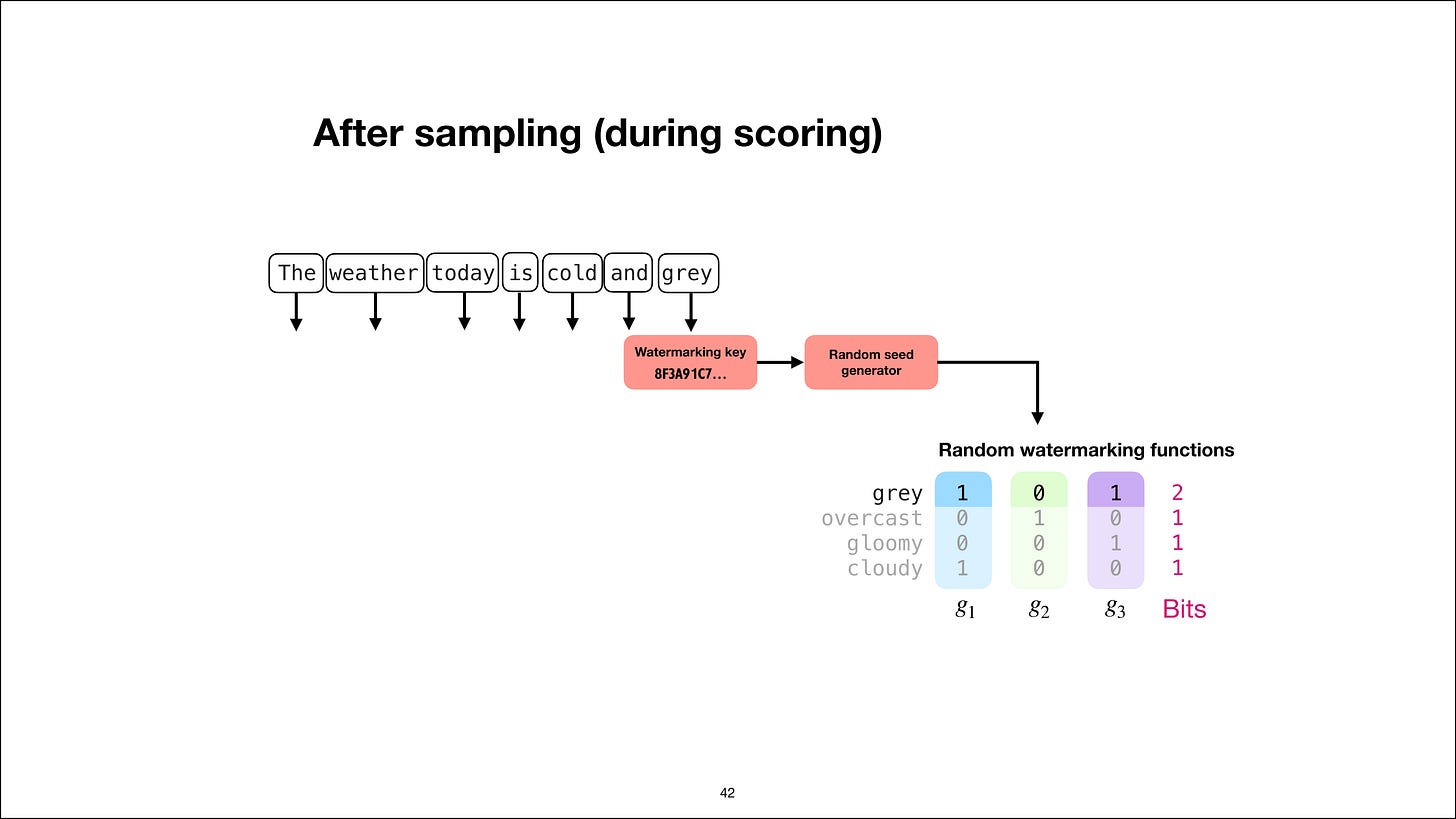
不过我们还没讲完。接下来聊聊如何判断或查看文本是否带有水印。检测水印的前提是拥有密钥。假设我们有若干文本,其中某段(比如第四段)是你从网上随机找到的,你想确认它是否含水印——这就难办了。
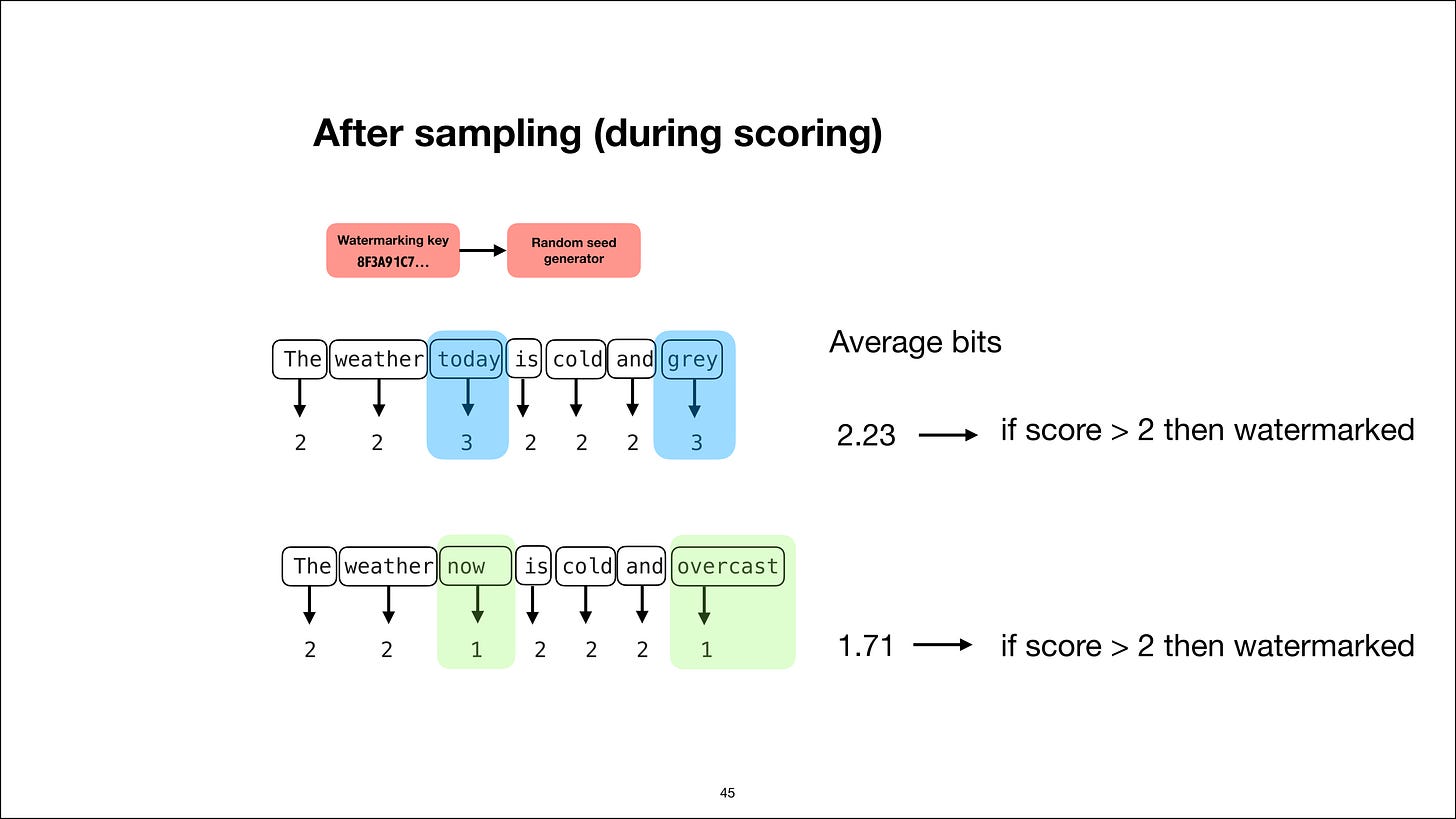
因为你不知道,就得靠水印密钥。你需要一个评分函数,用它对文本打分。如果分数超过某个阈值,就认定含水印;否则就是没有。但作为终端用户,我们做不到这些,因为手里没有密钥。密钥对我们是不可见的。
只有 Anthropic 掌握密钥。不过那篇博文中提到,他们可能会开放相应资源,或者开发一个 API 供外部使用。具体细节我不清楚,毕竟我没有官方内部消息,只是读了那篇博客。所以,这个 API 最终可能仅限某些公司使用,比如 X 或 Substack Notes,用来标记 AI 生成的帖子。
他们也可能向普通用户开放。孰是孰非,只能拭目以待。总结起来就是:除非拥有水印密钥,或者使用他们即将推出的 API,否则无法检测水印。
如何去除水印
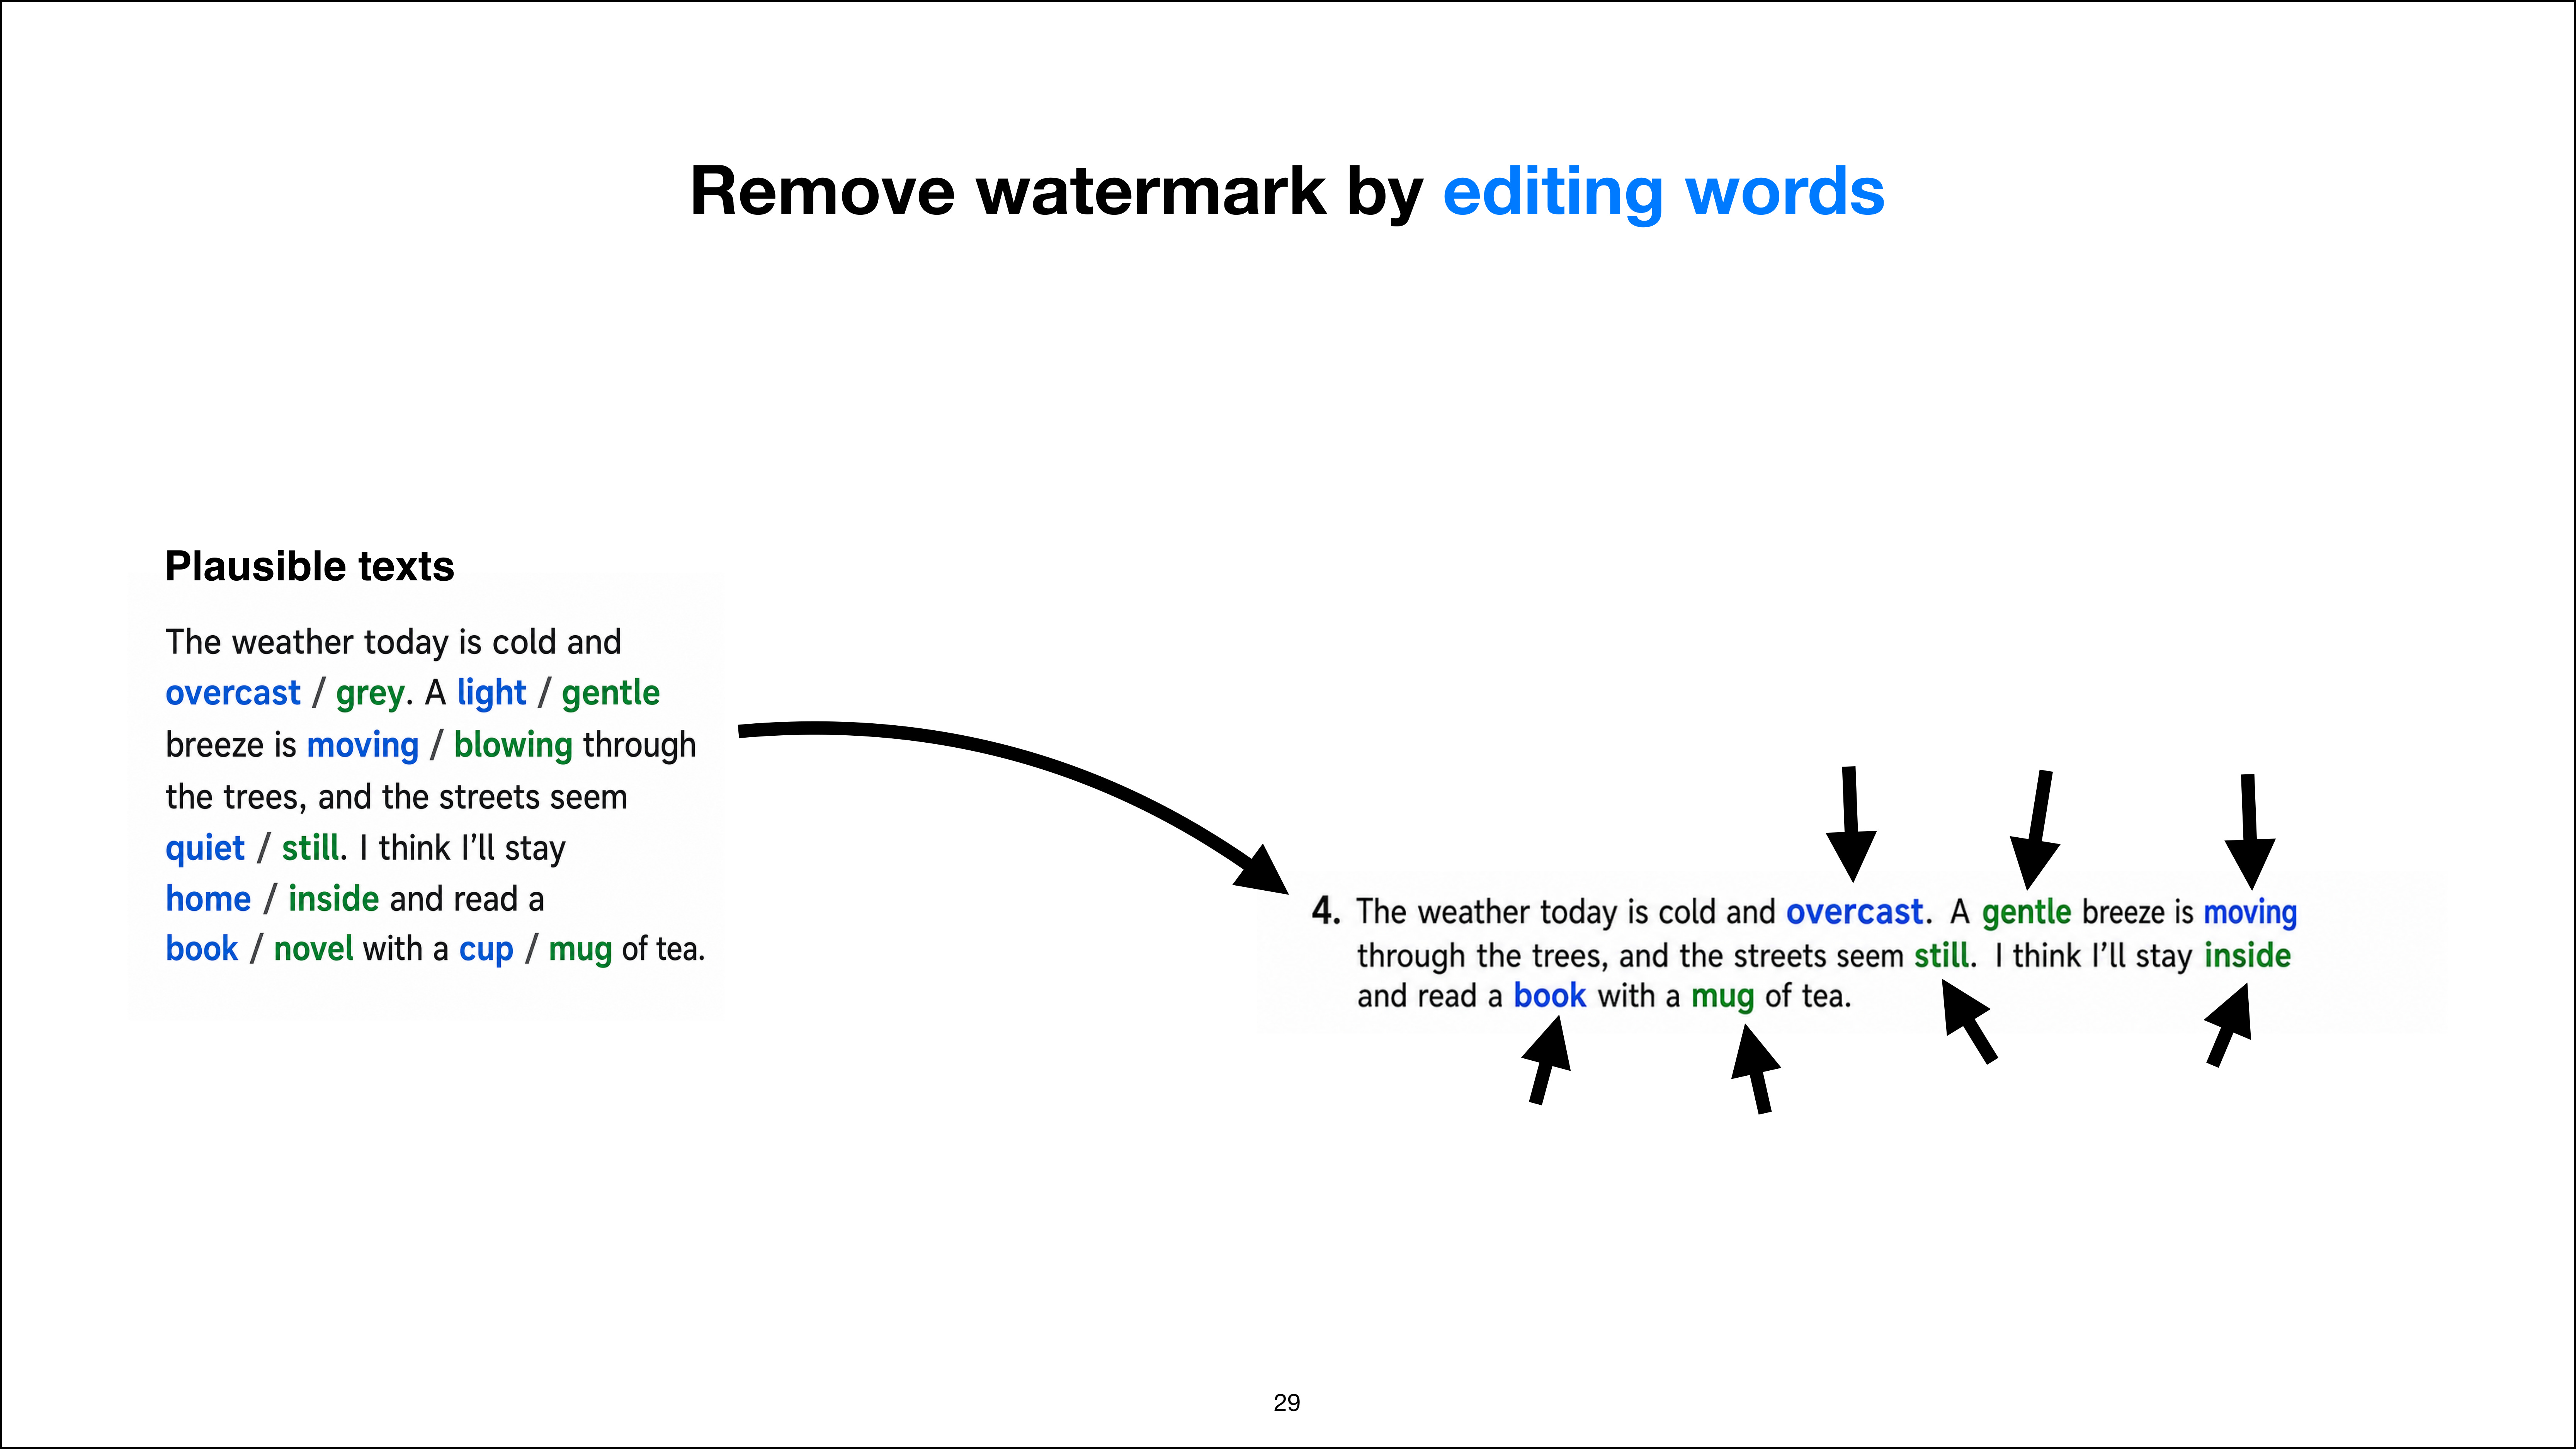
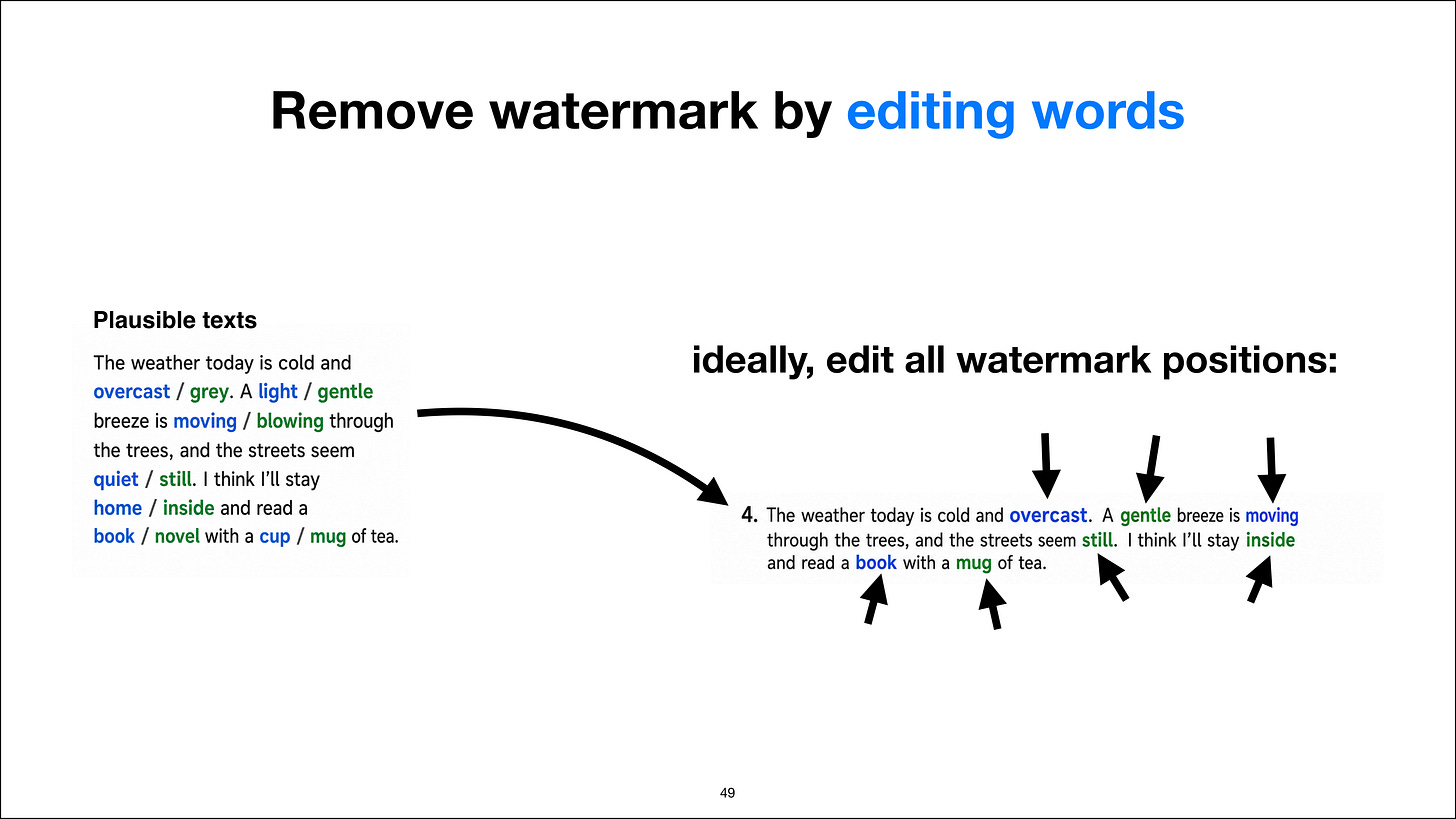
接下来聊聊移除水印,这就有意思了。搞清楚了水印的工作原理,自然也就知道了它的短板。水印高度依赖特定位置上的特定 token。比如在这段文本里,如果这些彩色单词(也就是 token)是水印位置,那么只要编辑这些地方就能去掉水印,对吧?只要把这些位置上的词全部换掉,就一定能破解这个水印。
但问题在于,我们根本不知道这些位置在哪,对吧?
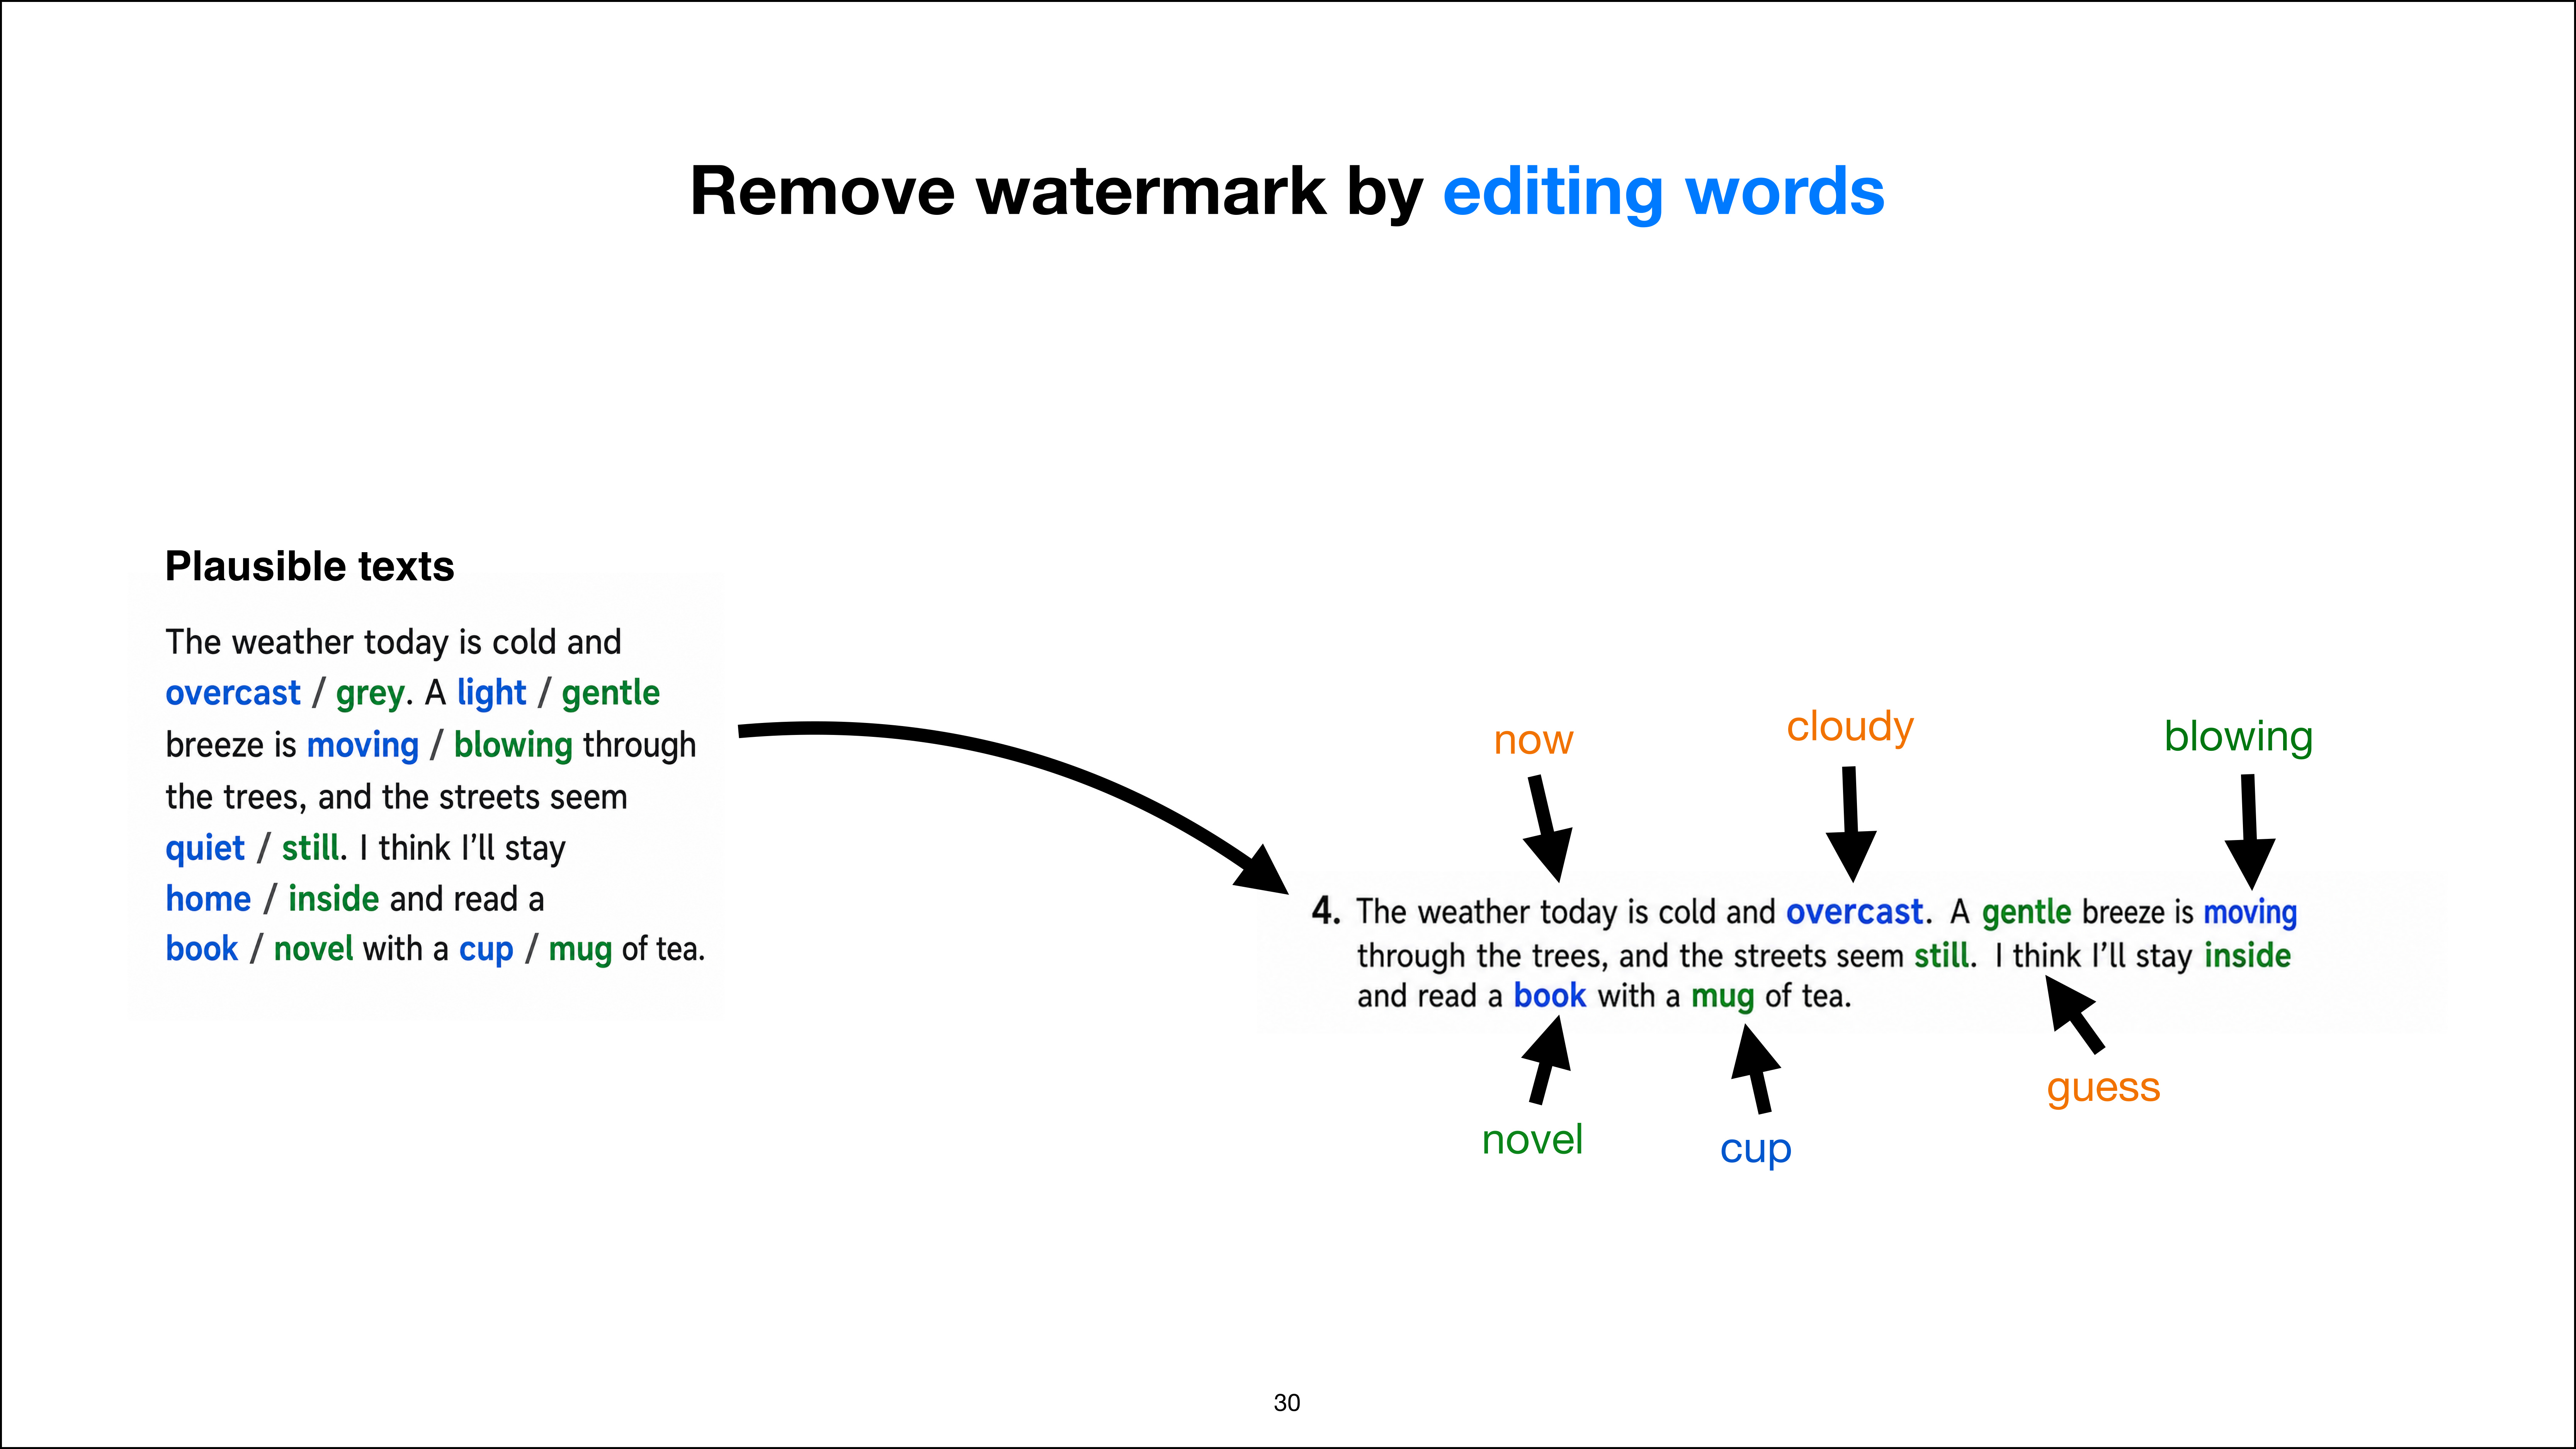
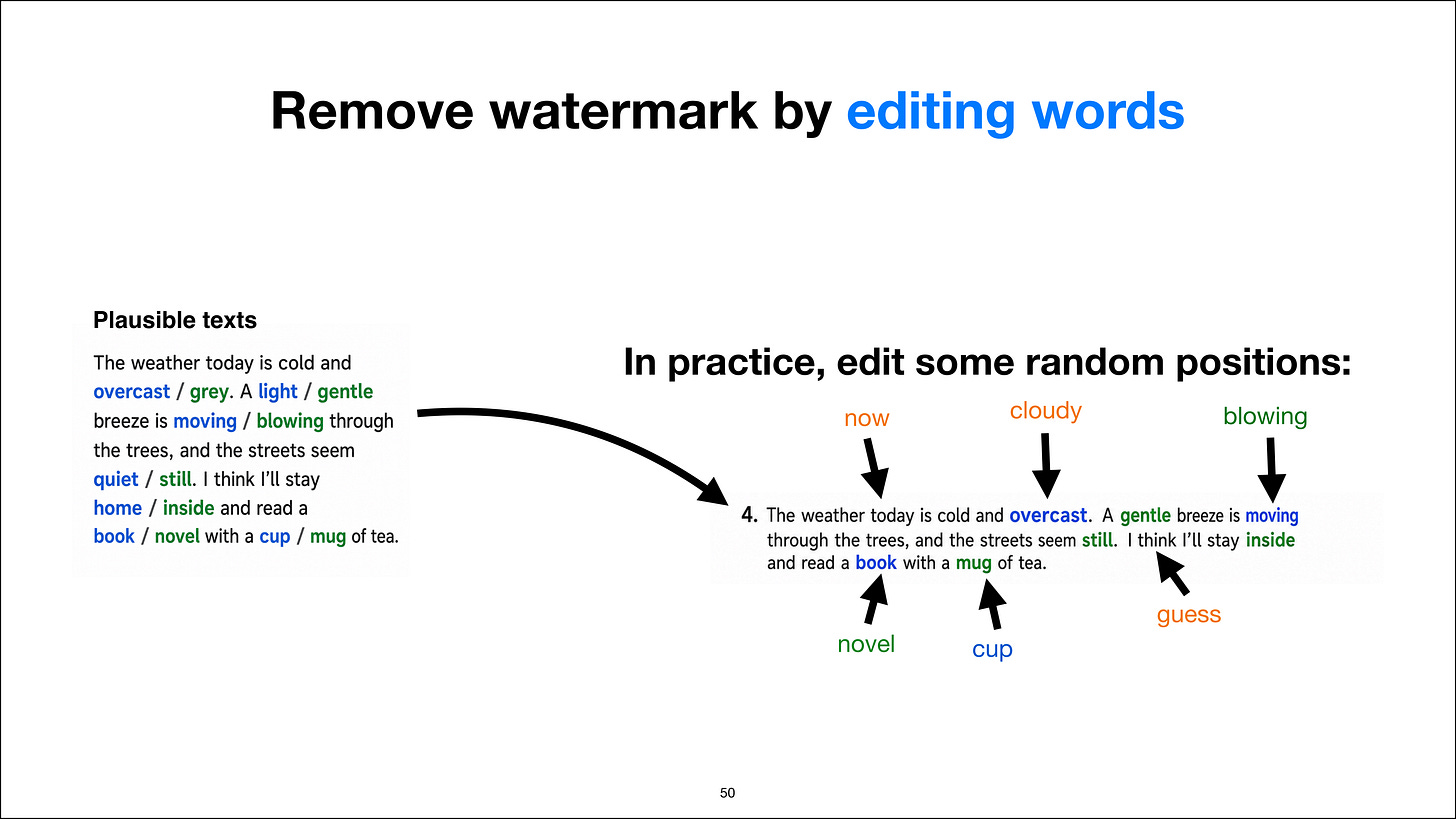
我们不知道这些词在哪,因为水印不是我们生成的,自然不知道该盯哪些位置。所以实际可行的办法就是随机编辑文本:随便改几个词,赌改动足够多的位置能碰到水印点,这算是一种移除水印的方式。另外,我们也无法知道哪些位置得分最高——那需要拿到背后的 LLM,把 prompt 重新跑一遍才能确定——所以只能靠猜了。
举个例子,我们可能会说,把“overcast”换成“cloudy”,因为我们并不知道“gray”的得分更高。在这个例子里,选择“gray”可能很直观,但情况并不总是如此。我想说明的是,这是一种通用的文本编辑方式:我们在调整词的位置,但依然是在猜测哪些位置属于水印。
既然我们事先不知道,就只在各处替换了几个词。如果替换得足够多,同样会破坏水印的有效性。
水印评分函数的工作原理
上面就是水印技术的简述。我提到过一个评分函数,用来判断文本是否带有水印。视频已经挺长了,但作为额外内容,我还是想简单解释一下这个评分函数是如何工作的,因为这很有趣。它稍微有点复杂,理解其细节并非必要条件。
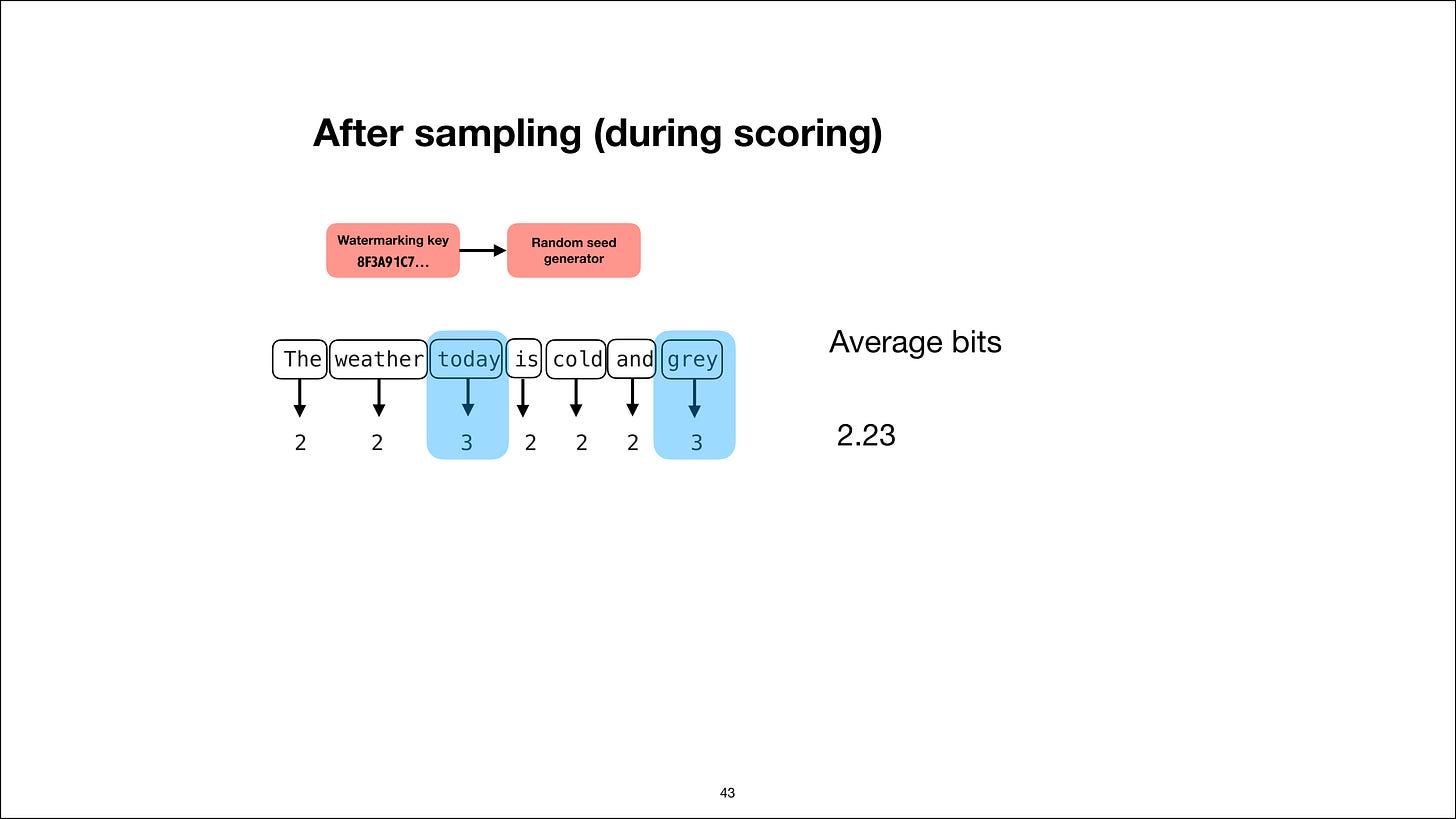
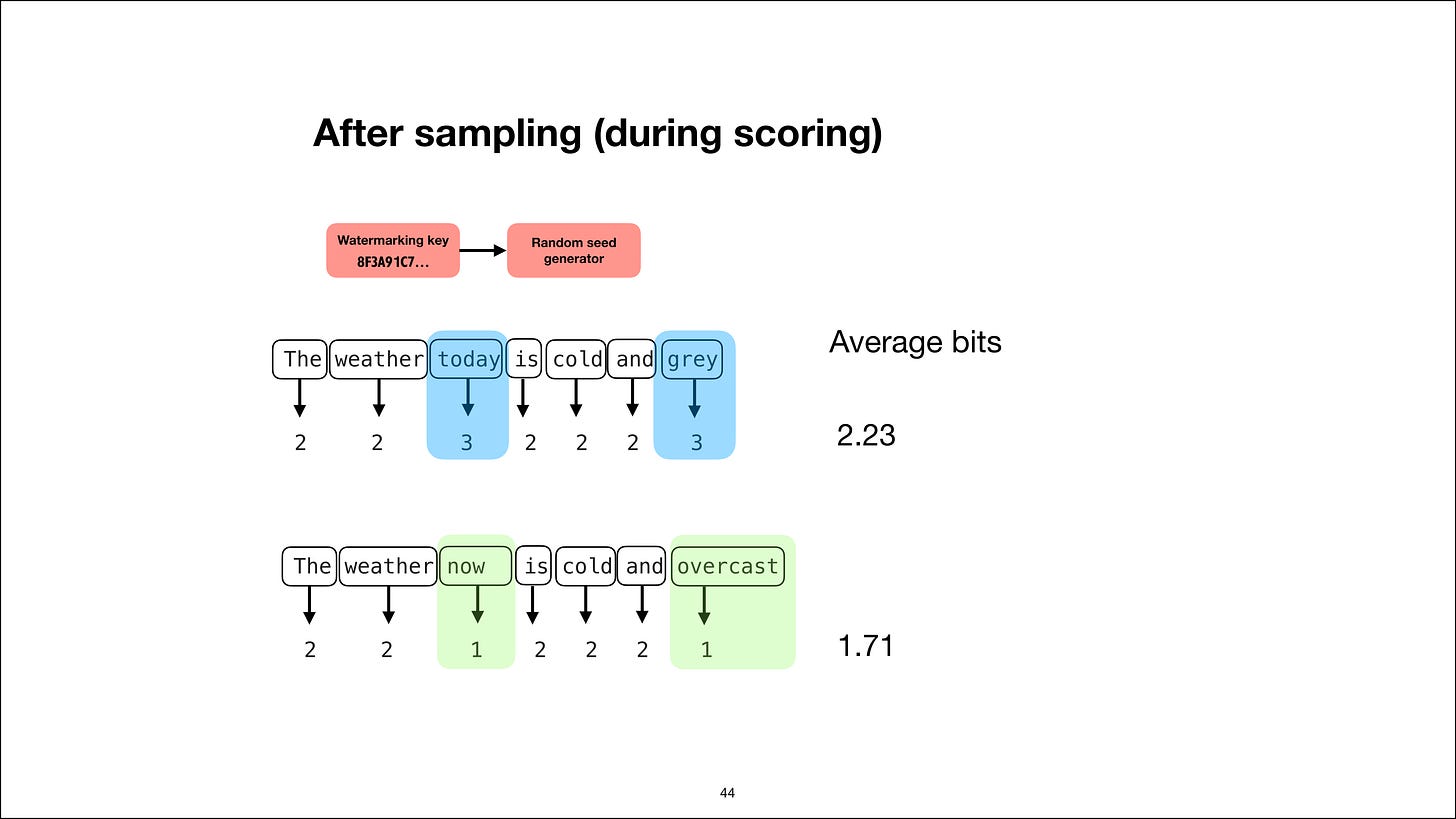
他们采用特定方式的主要原因是为了降低检测成本。否则,如果我们回看前一两张幻灯片,要检查某段文本是否带水印——即便他们自己也想检查——就必须重新运行提示词(prompt)来获取这些得分,然后应用水印随机种子生成文本,再进行比对。这就非常昂贵了,因为这意味着你想对比的每一段文本,都得重新跑一遍 LLM。
你得知道用的是哪个 LLM,这往往行不通,因为你通常连原始提示词都不清楚。因此,他们采用了一个技巧——可以这么说——修改采样过程,使得后续评分阶段不再需要依赖 LLM。在博客文章中,他们提到这种方法源自一篇论文。
那是一篇发表在 Nature 上的论文,该方法被称为 SynthID-Text。这篇论文大约是一两年前发布的,由 Google 主导,他们使用了类似的技术,称为 Claude watermarking。我不确定,抱歉,我不确定他们是否完全采用了那种技术,但文中提到的是这个。
SynthID Text 与锦标赛采样
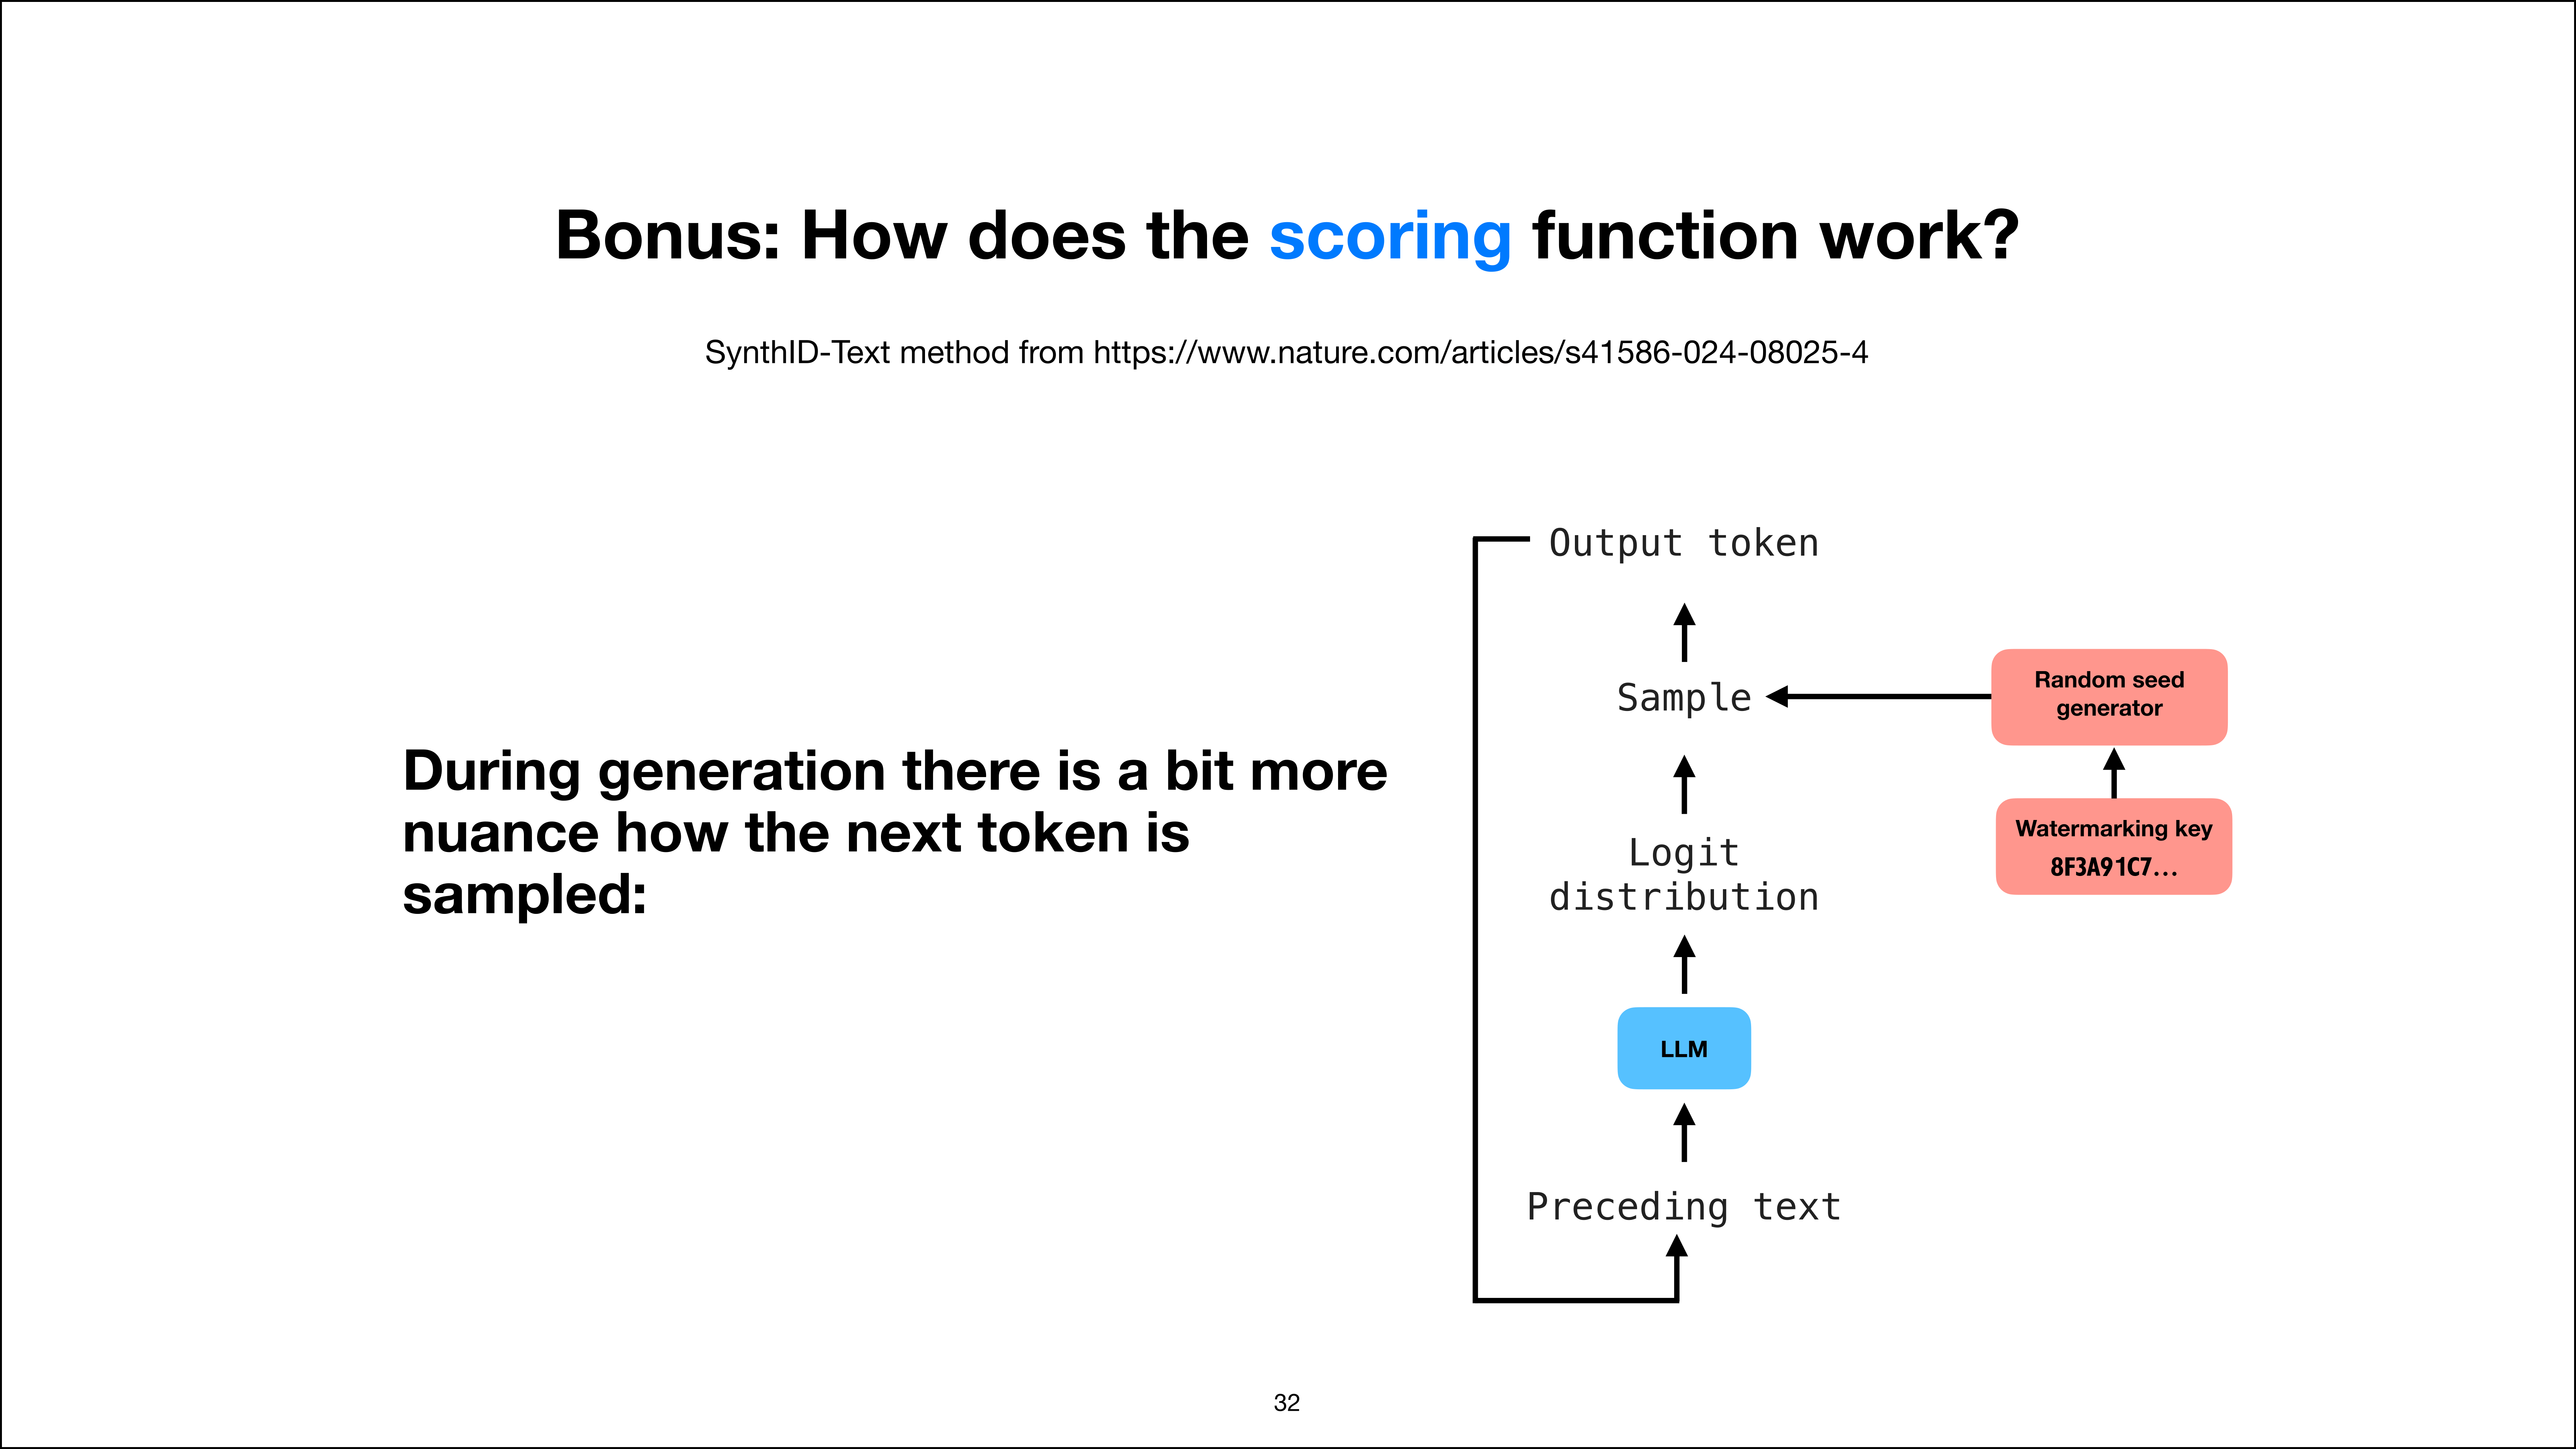
具体是怎么实现的呢?在看幻灯片之前,我们先回顾一下常规的概览:输入文本,通过 LLM,得到 logit 分布,然后从该分布中采样,输出 token。在此过程中,我们使用了水印密钥和随机种子生成器。这个流程描述依然准确,但这只是概况,token 采样的具体细节还包含更多微妙的地方。
他们并非简单使用 NumPy 的 random choice,而是采用了更精细的方法。
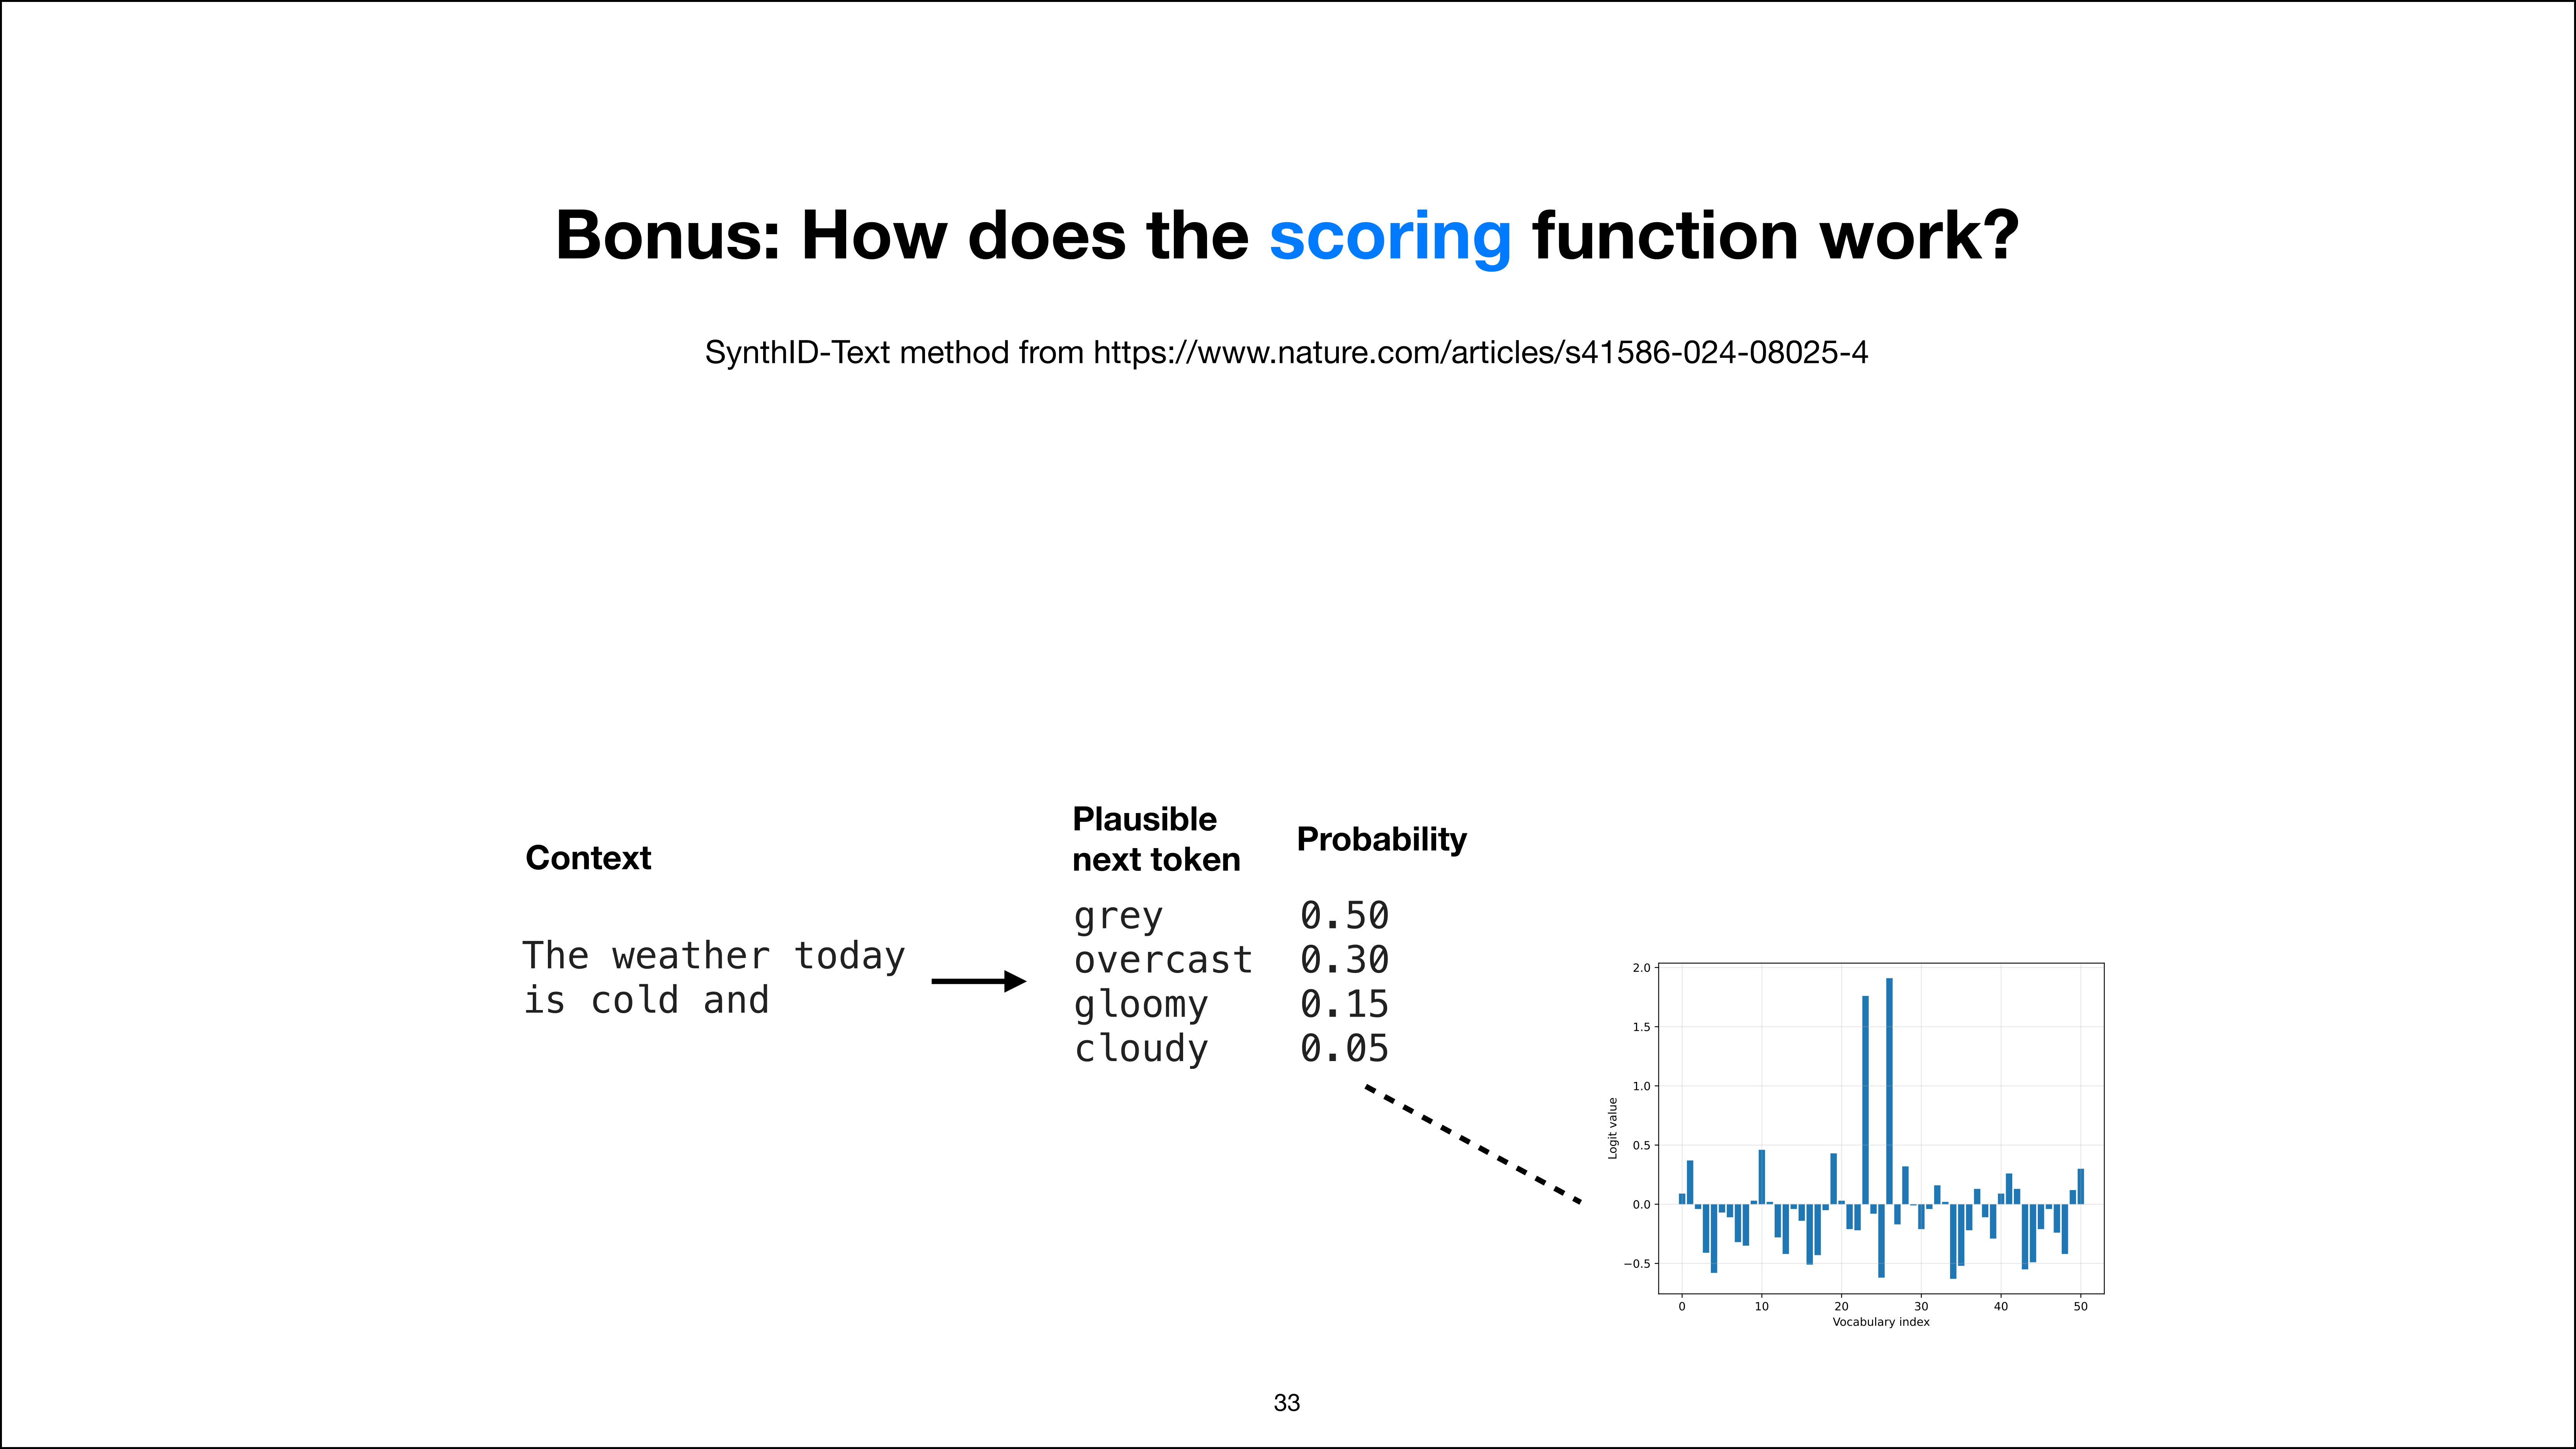
再次假设上下文为“今天的天气很冷”,我们需要生成下一个 token,例如 “gray”、“overcast”、“gloomy” 或 “cloudy”。其中 “gray” 的概率为 50%, “overcast” 为 30%, “gloomy” 为 15%, “cloudy” 设为 0.05,其余设为 0。这里的图示与实际略有不同,比如将概率最高的 “gray” 和 “overcast” 作为示例。我直接复用了这张图。想象一下,除了 “gloomy” 和 “cloudy” 概率稍高外,其他 token 的概率都非常小。
为了简化说明,我们把词表缩小到只有四个词,而不是之前的 50 个。之前提到过,我们可以用 NumPy 的 random choice 按这些概率采样下一个 token。
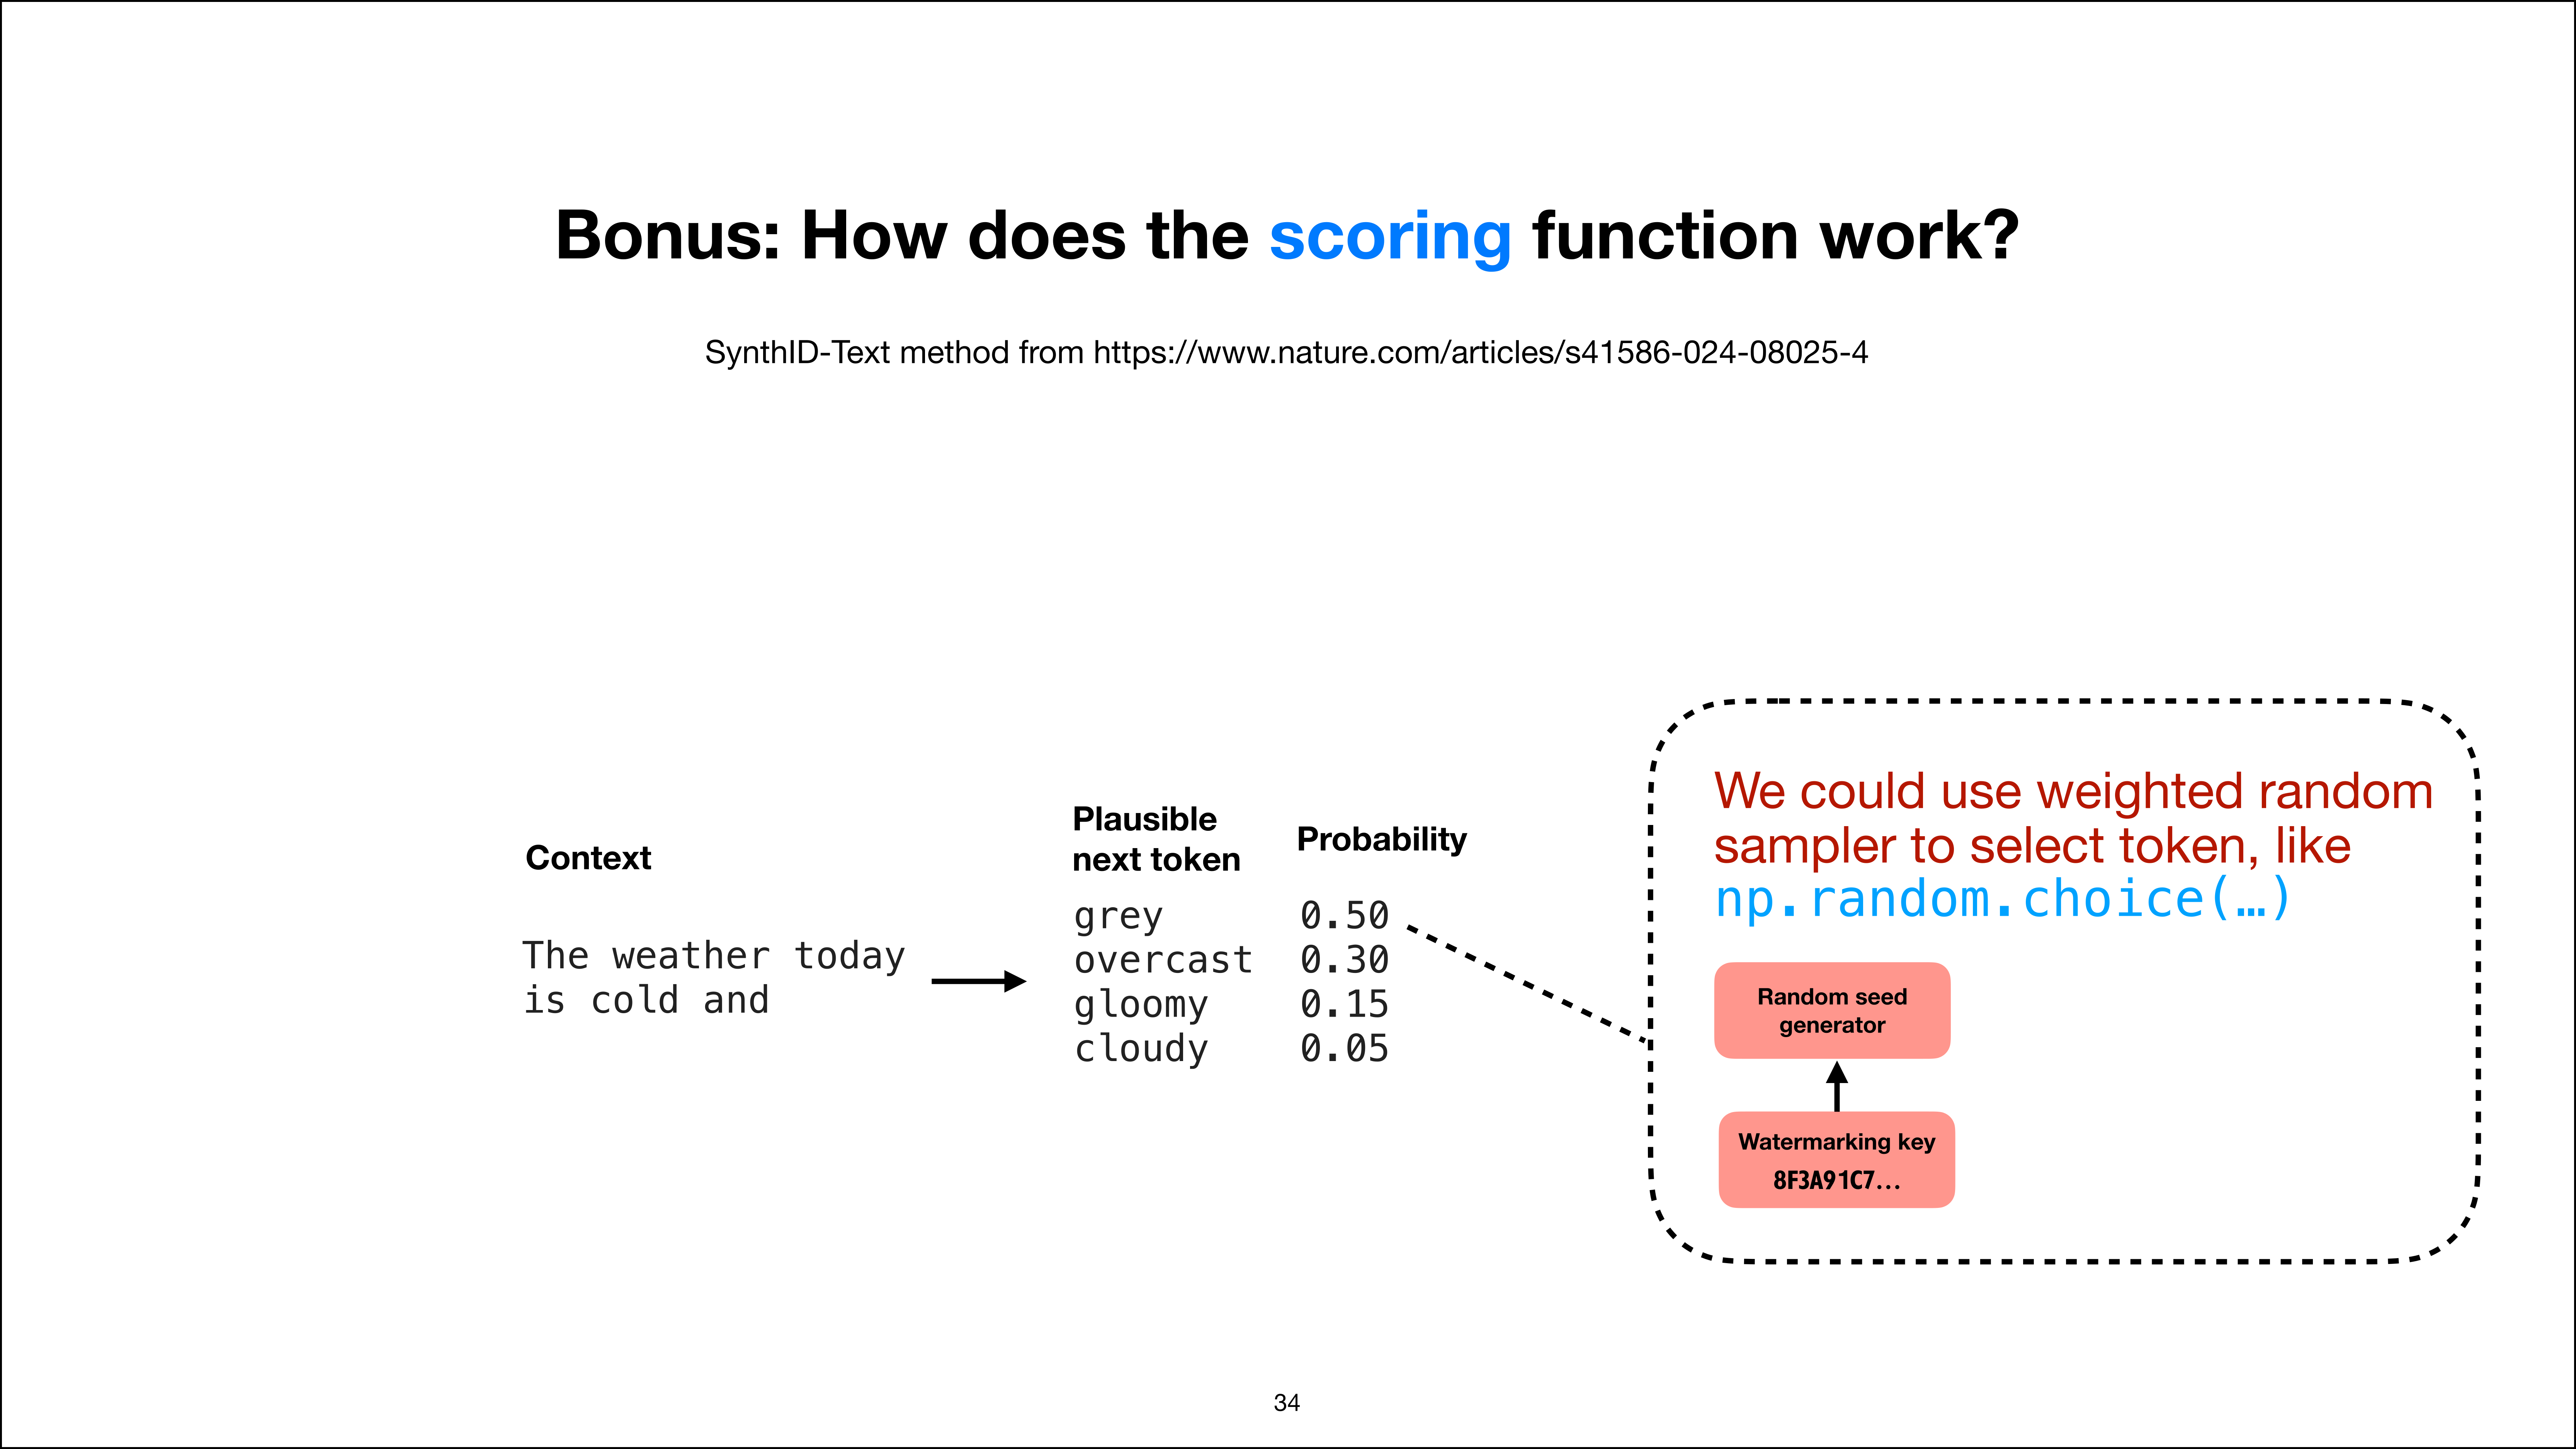
再配合水印密钥作为随机种子,就能让采样过程变成确定性的,得到我们想要的水印。但正如之前所说,这样做代价很高。问题不在采样本身——采样其实很便宜——而在于后续的检测:如果要在互联网上检查海量随机文本,成本会非常高。
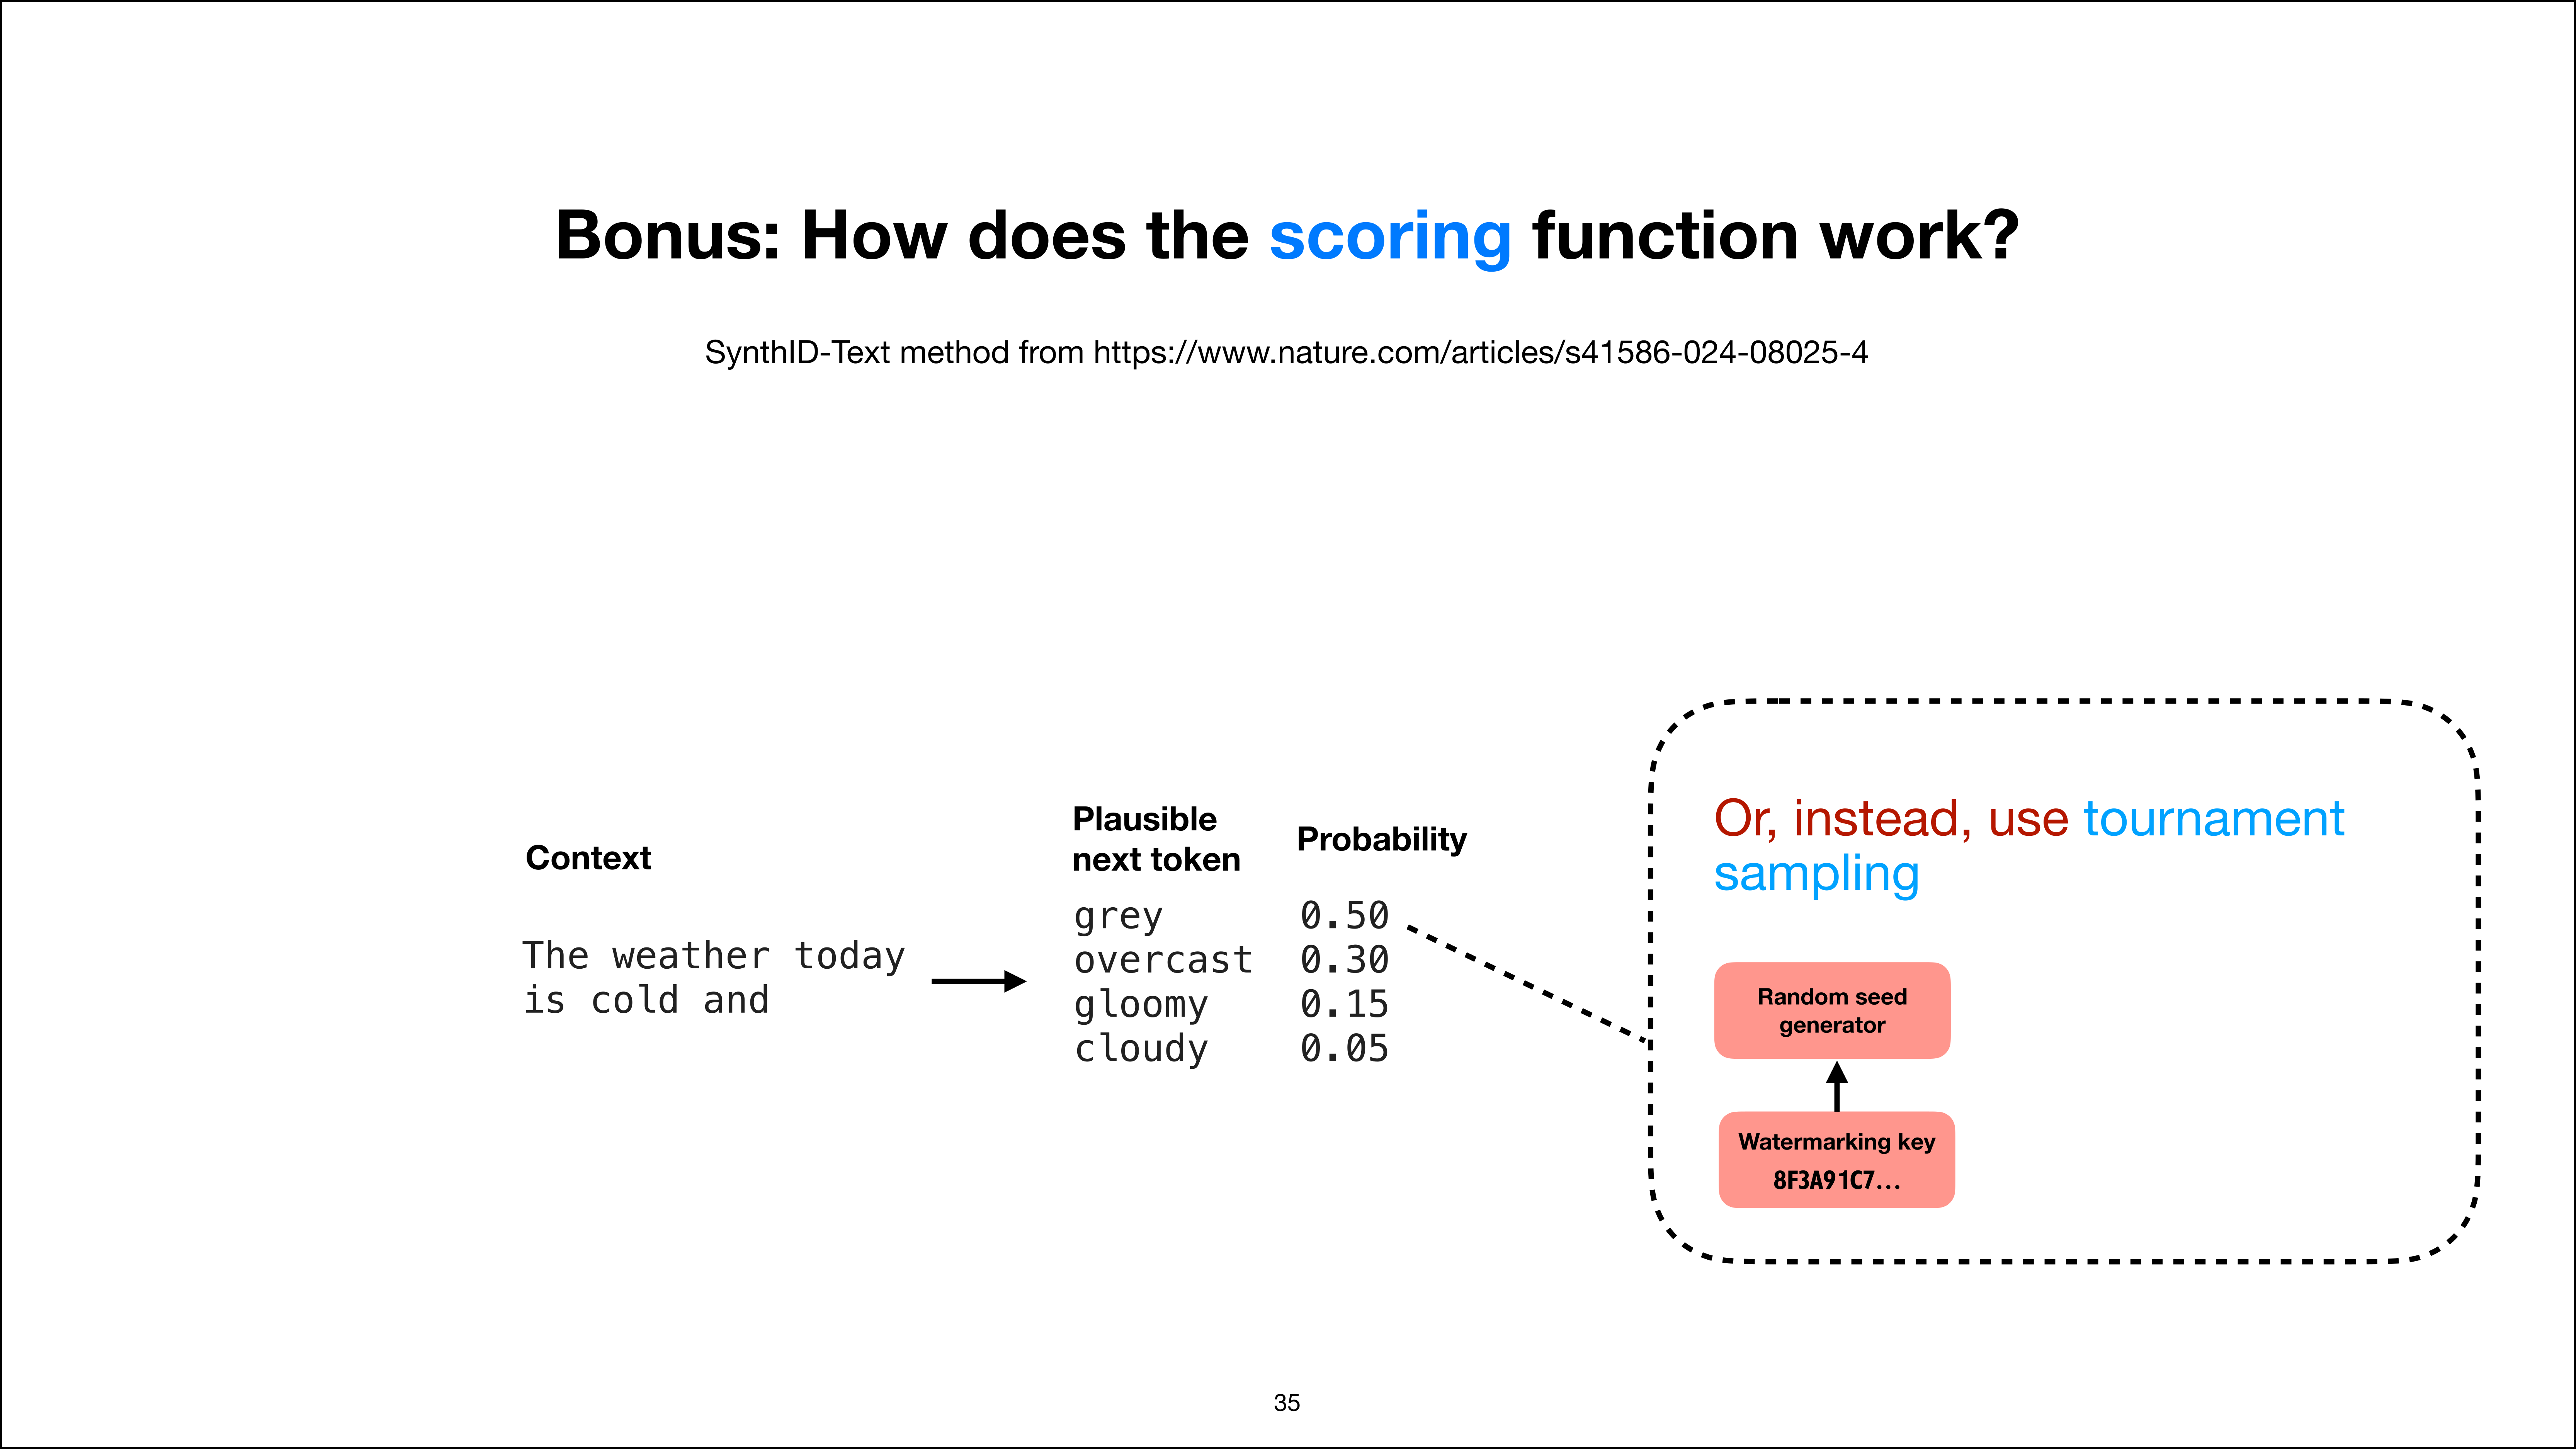
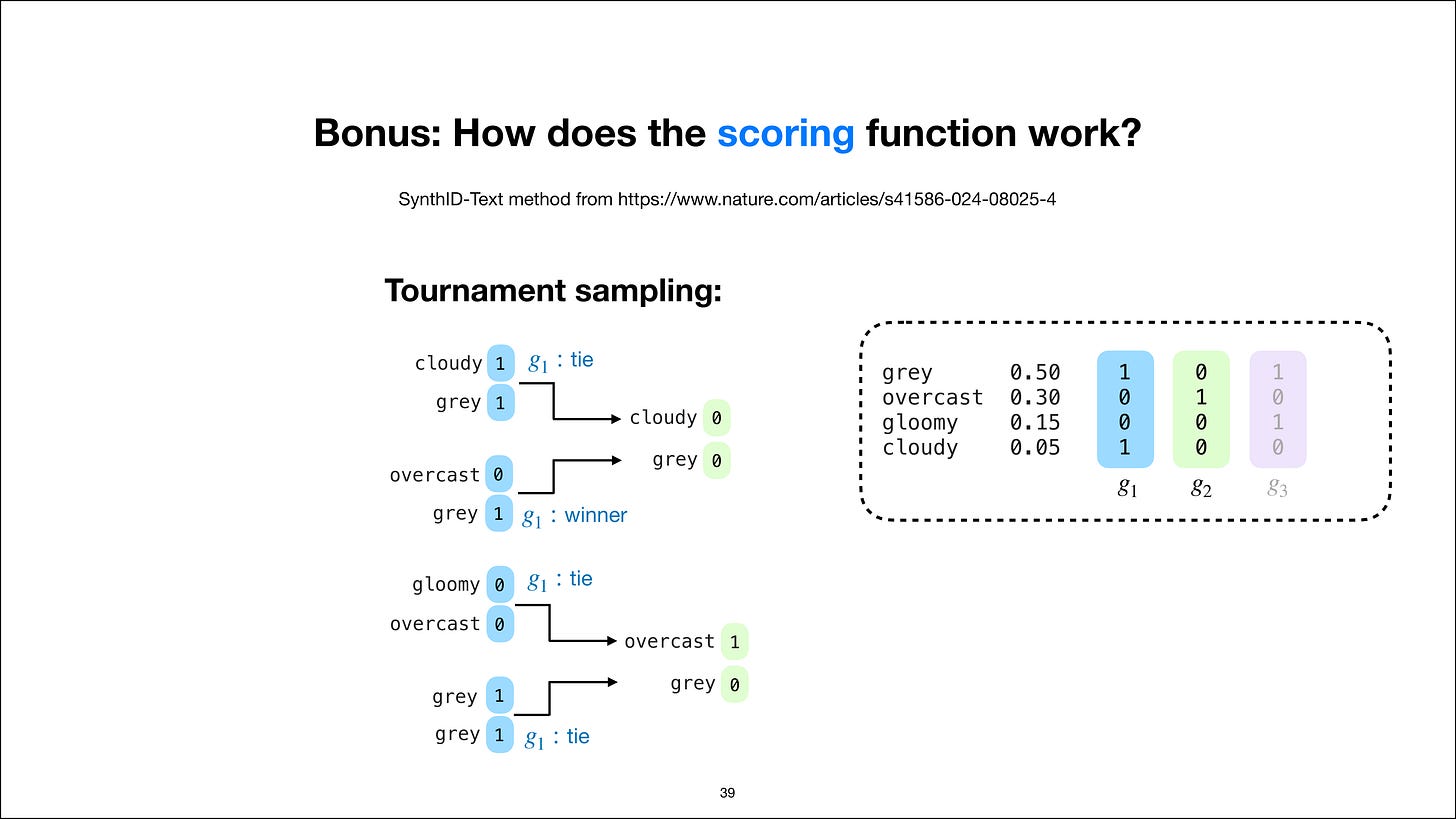
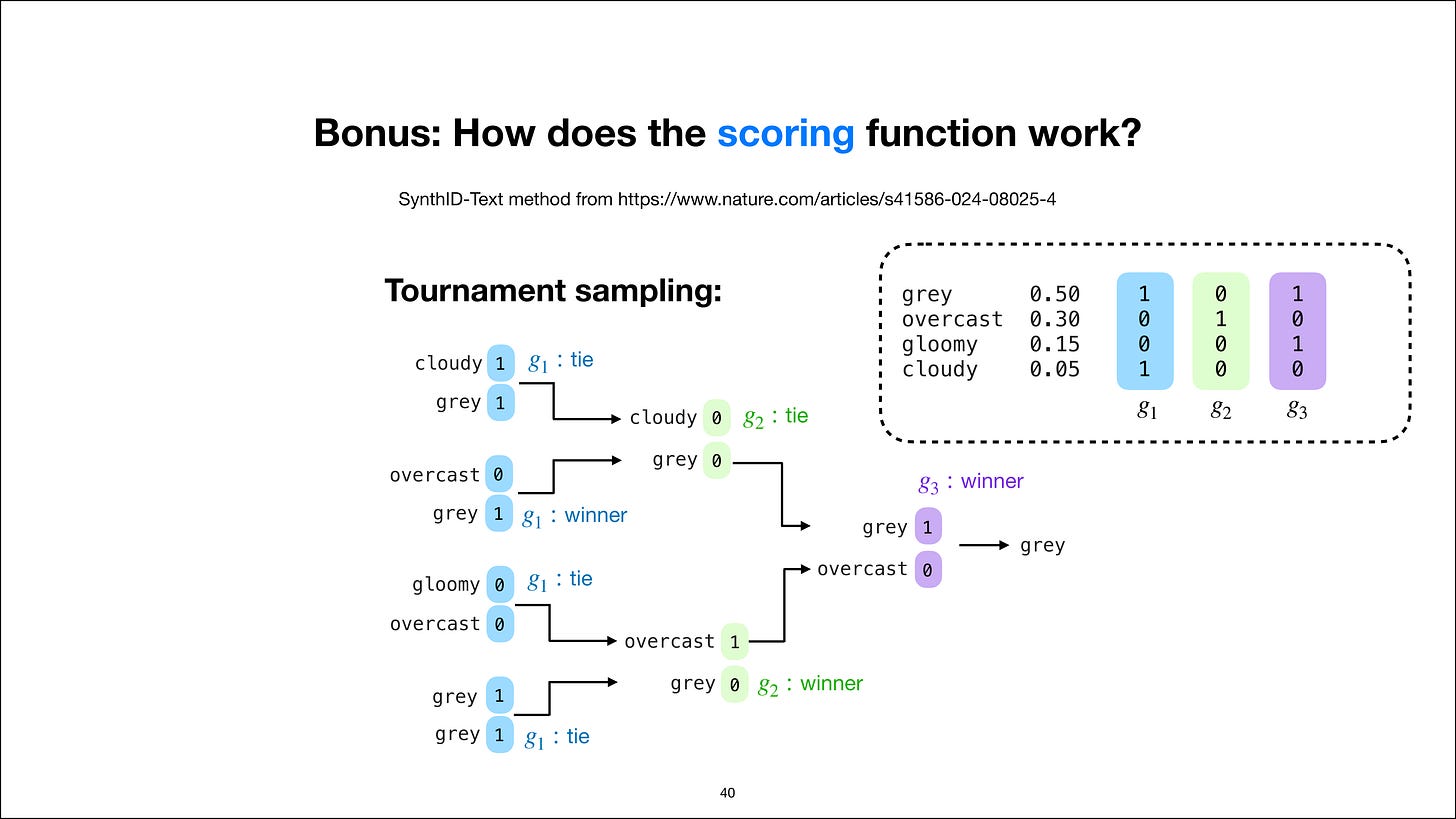
所以他们改用了锦标赛采样(tournament sampling)。这种方法在生成阶段采样时就用上,之后检测阶段可以直接复用。它不再用 random choice 这类方式,而是采用锦标赛采样的思路。原理是怎样的?看起来有点复杂,但说实话,它只是显得复杂,实际没那么难。
所以,你可能得在某个时间点暂停视频,仔细看看那张图。不过我觉得它其实比看上去简单。一旦弄懂了,思路就很清晰。让我来解释一下。我们这里有上下文,然后有一组可能的下一个 token,每个 token 对应不同的概率。
他们称之为随机水印函数。
随机水印函数
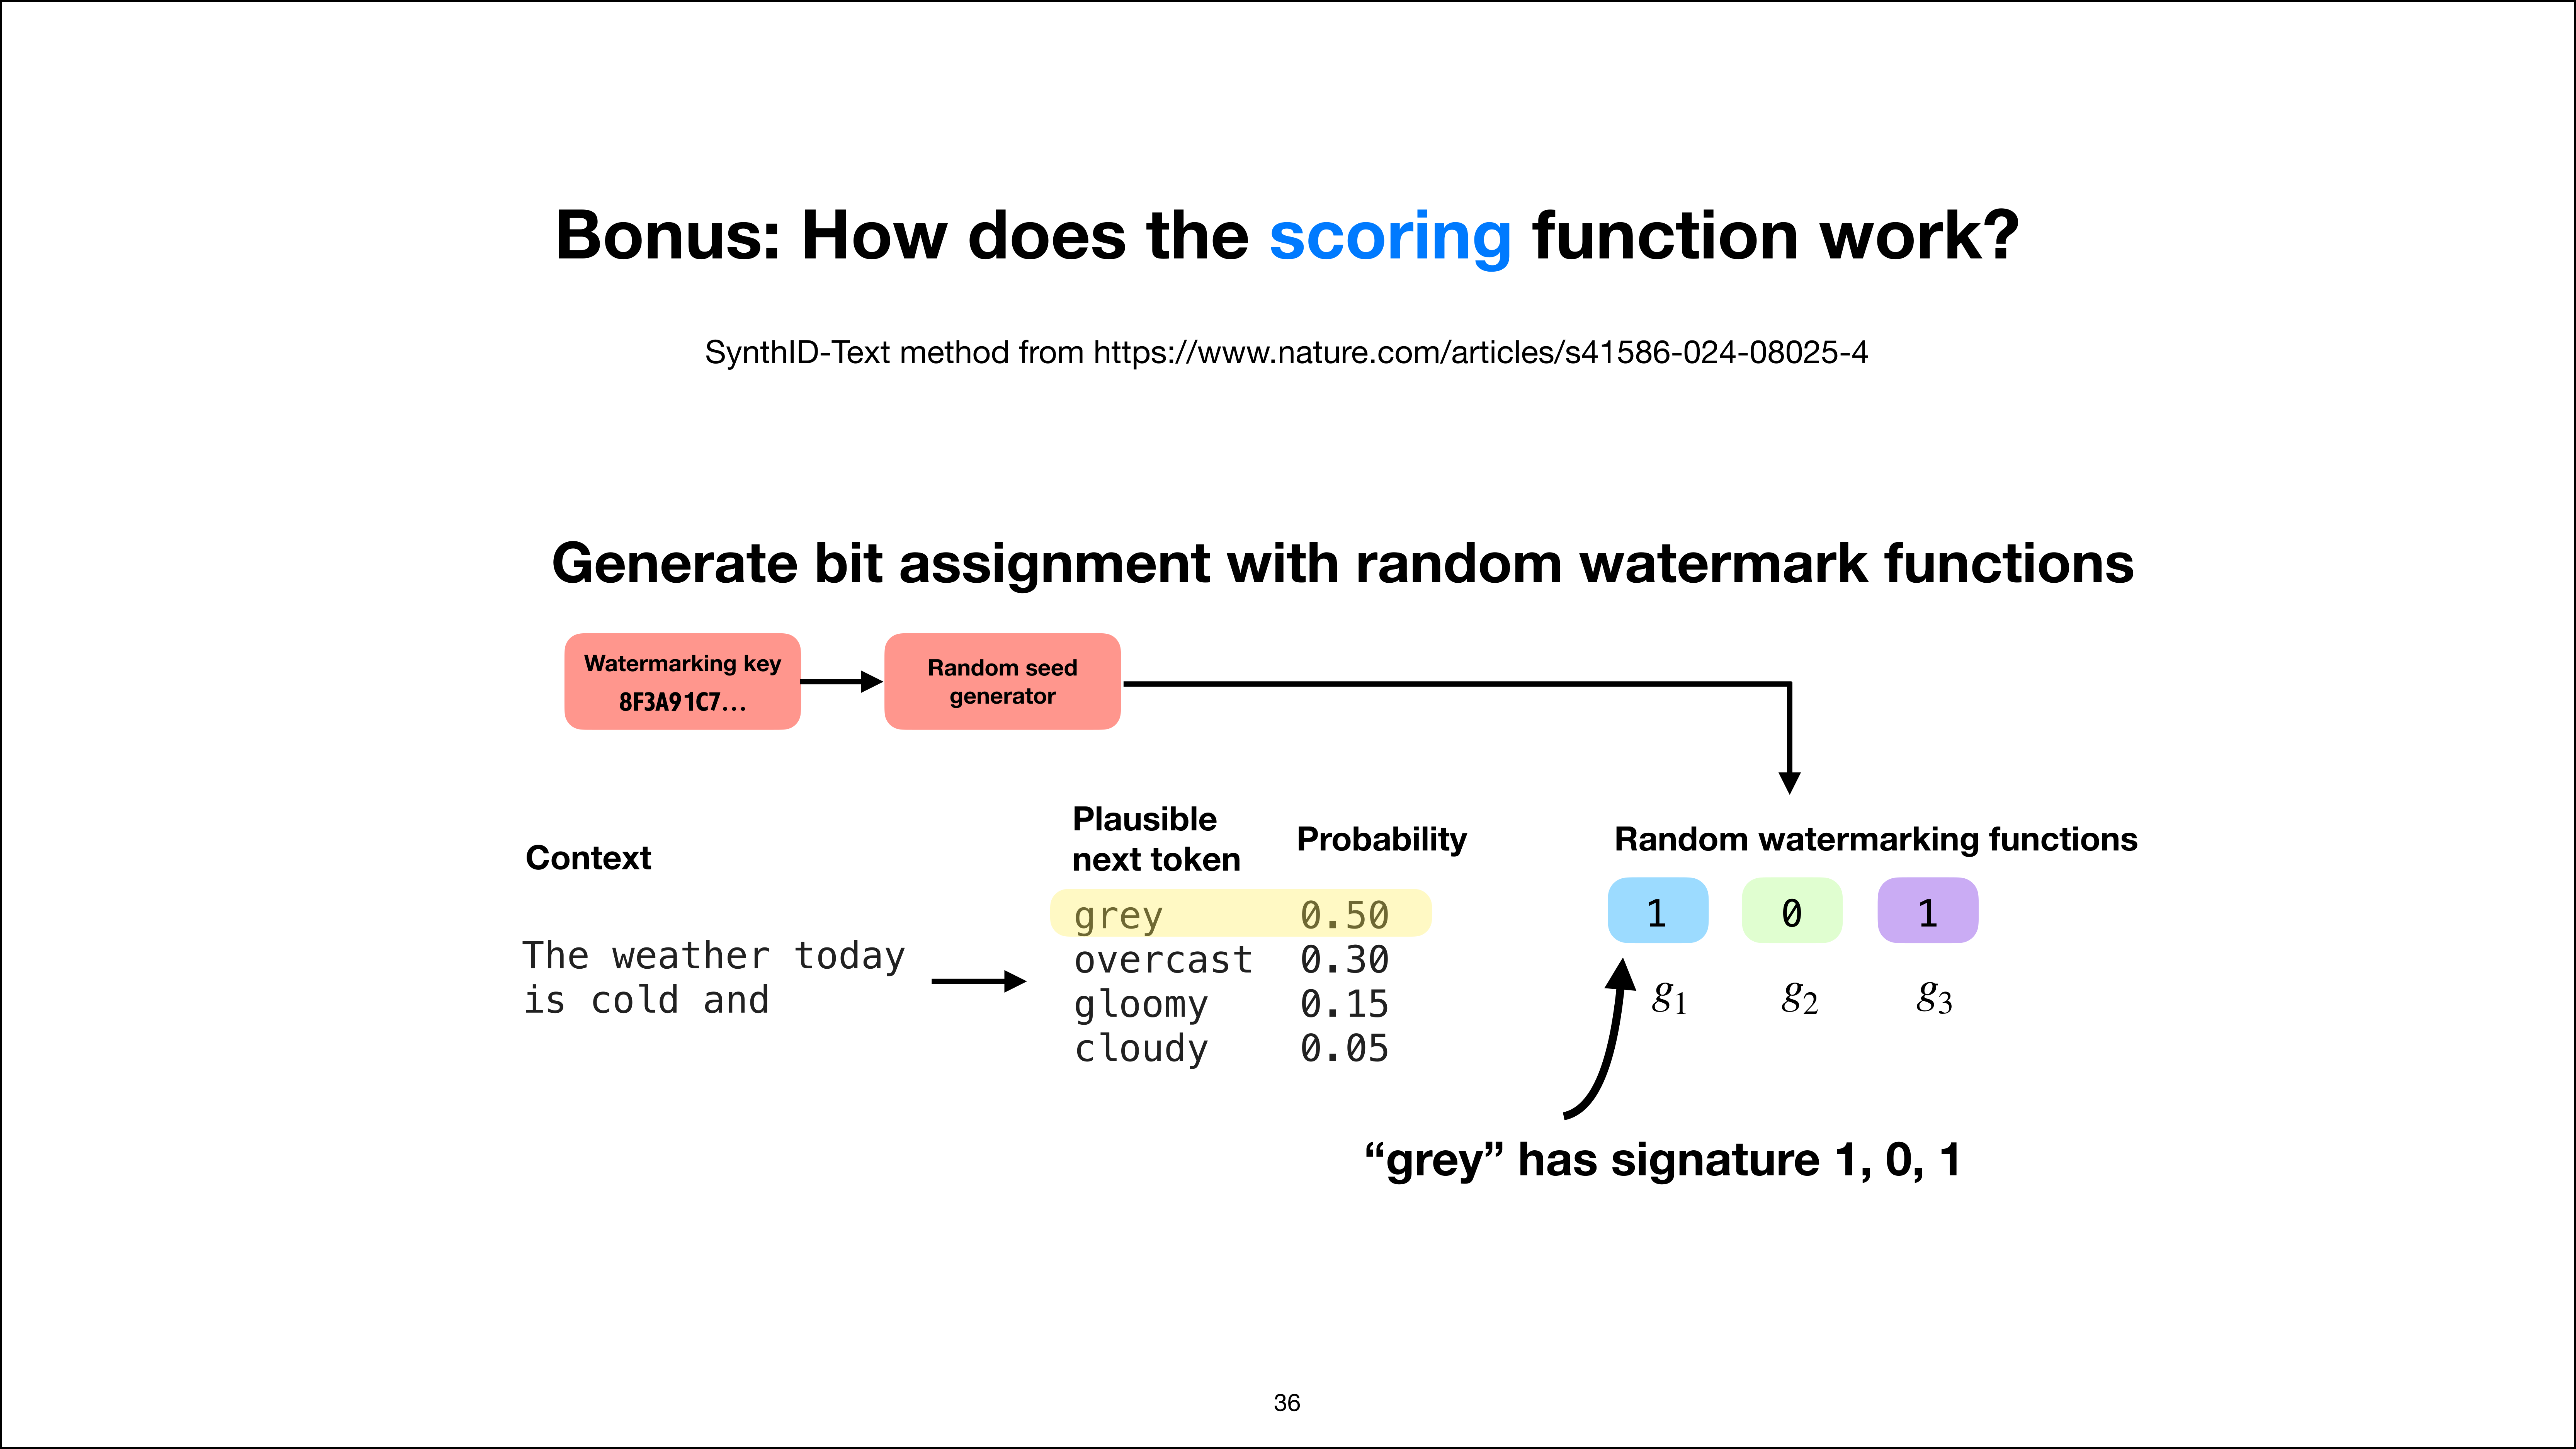
这里有三个水印函数:G1、G2 和 G3。实际中可能有 30 个、50 个甚至更多。这张幻灯片上我只用了三个,因为这样更简洁,版面也更紧凑。现在,如果看“gray”这个词,它会生成一个 101 的签名。也就是说,我们用这个水印密钥生成随机种子,配合 G1、G2、G3 这三个函数。
如果输入“gray”这个词,我省略了一步细节:通常要把“gray”和上下文中的前两到三个词一起输入,比如“cold gray”。把“cold gray”连同水印密钥一起喂给 G1,得到结果 1。为什么?这就是该函数的特性。它是个随机函数,返回值只有 0 或 1。在这种情况下,配合这个随机密钥和这个 token,它返回了 1。
用同样的密钥,换成不同的函数,结果可能是 0;再换一个函数,结果又变成 1。所以如果有更多函数(比如 30 个),这串 1 和 0 会非常长。
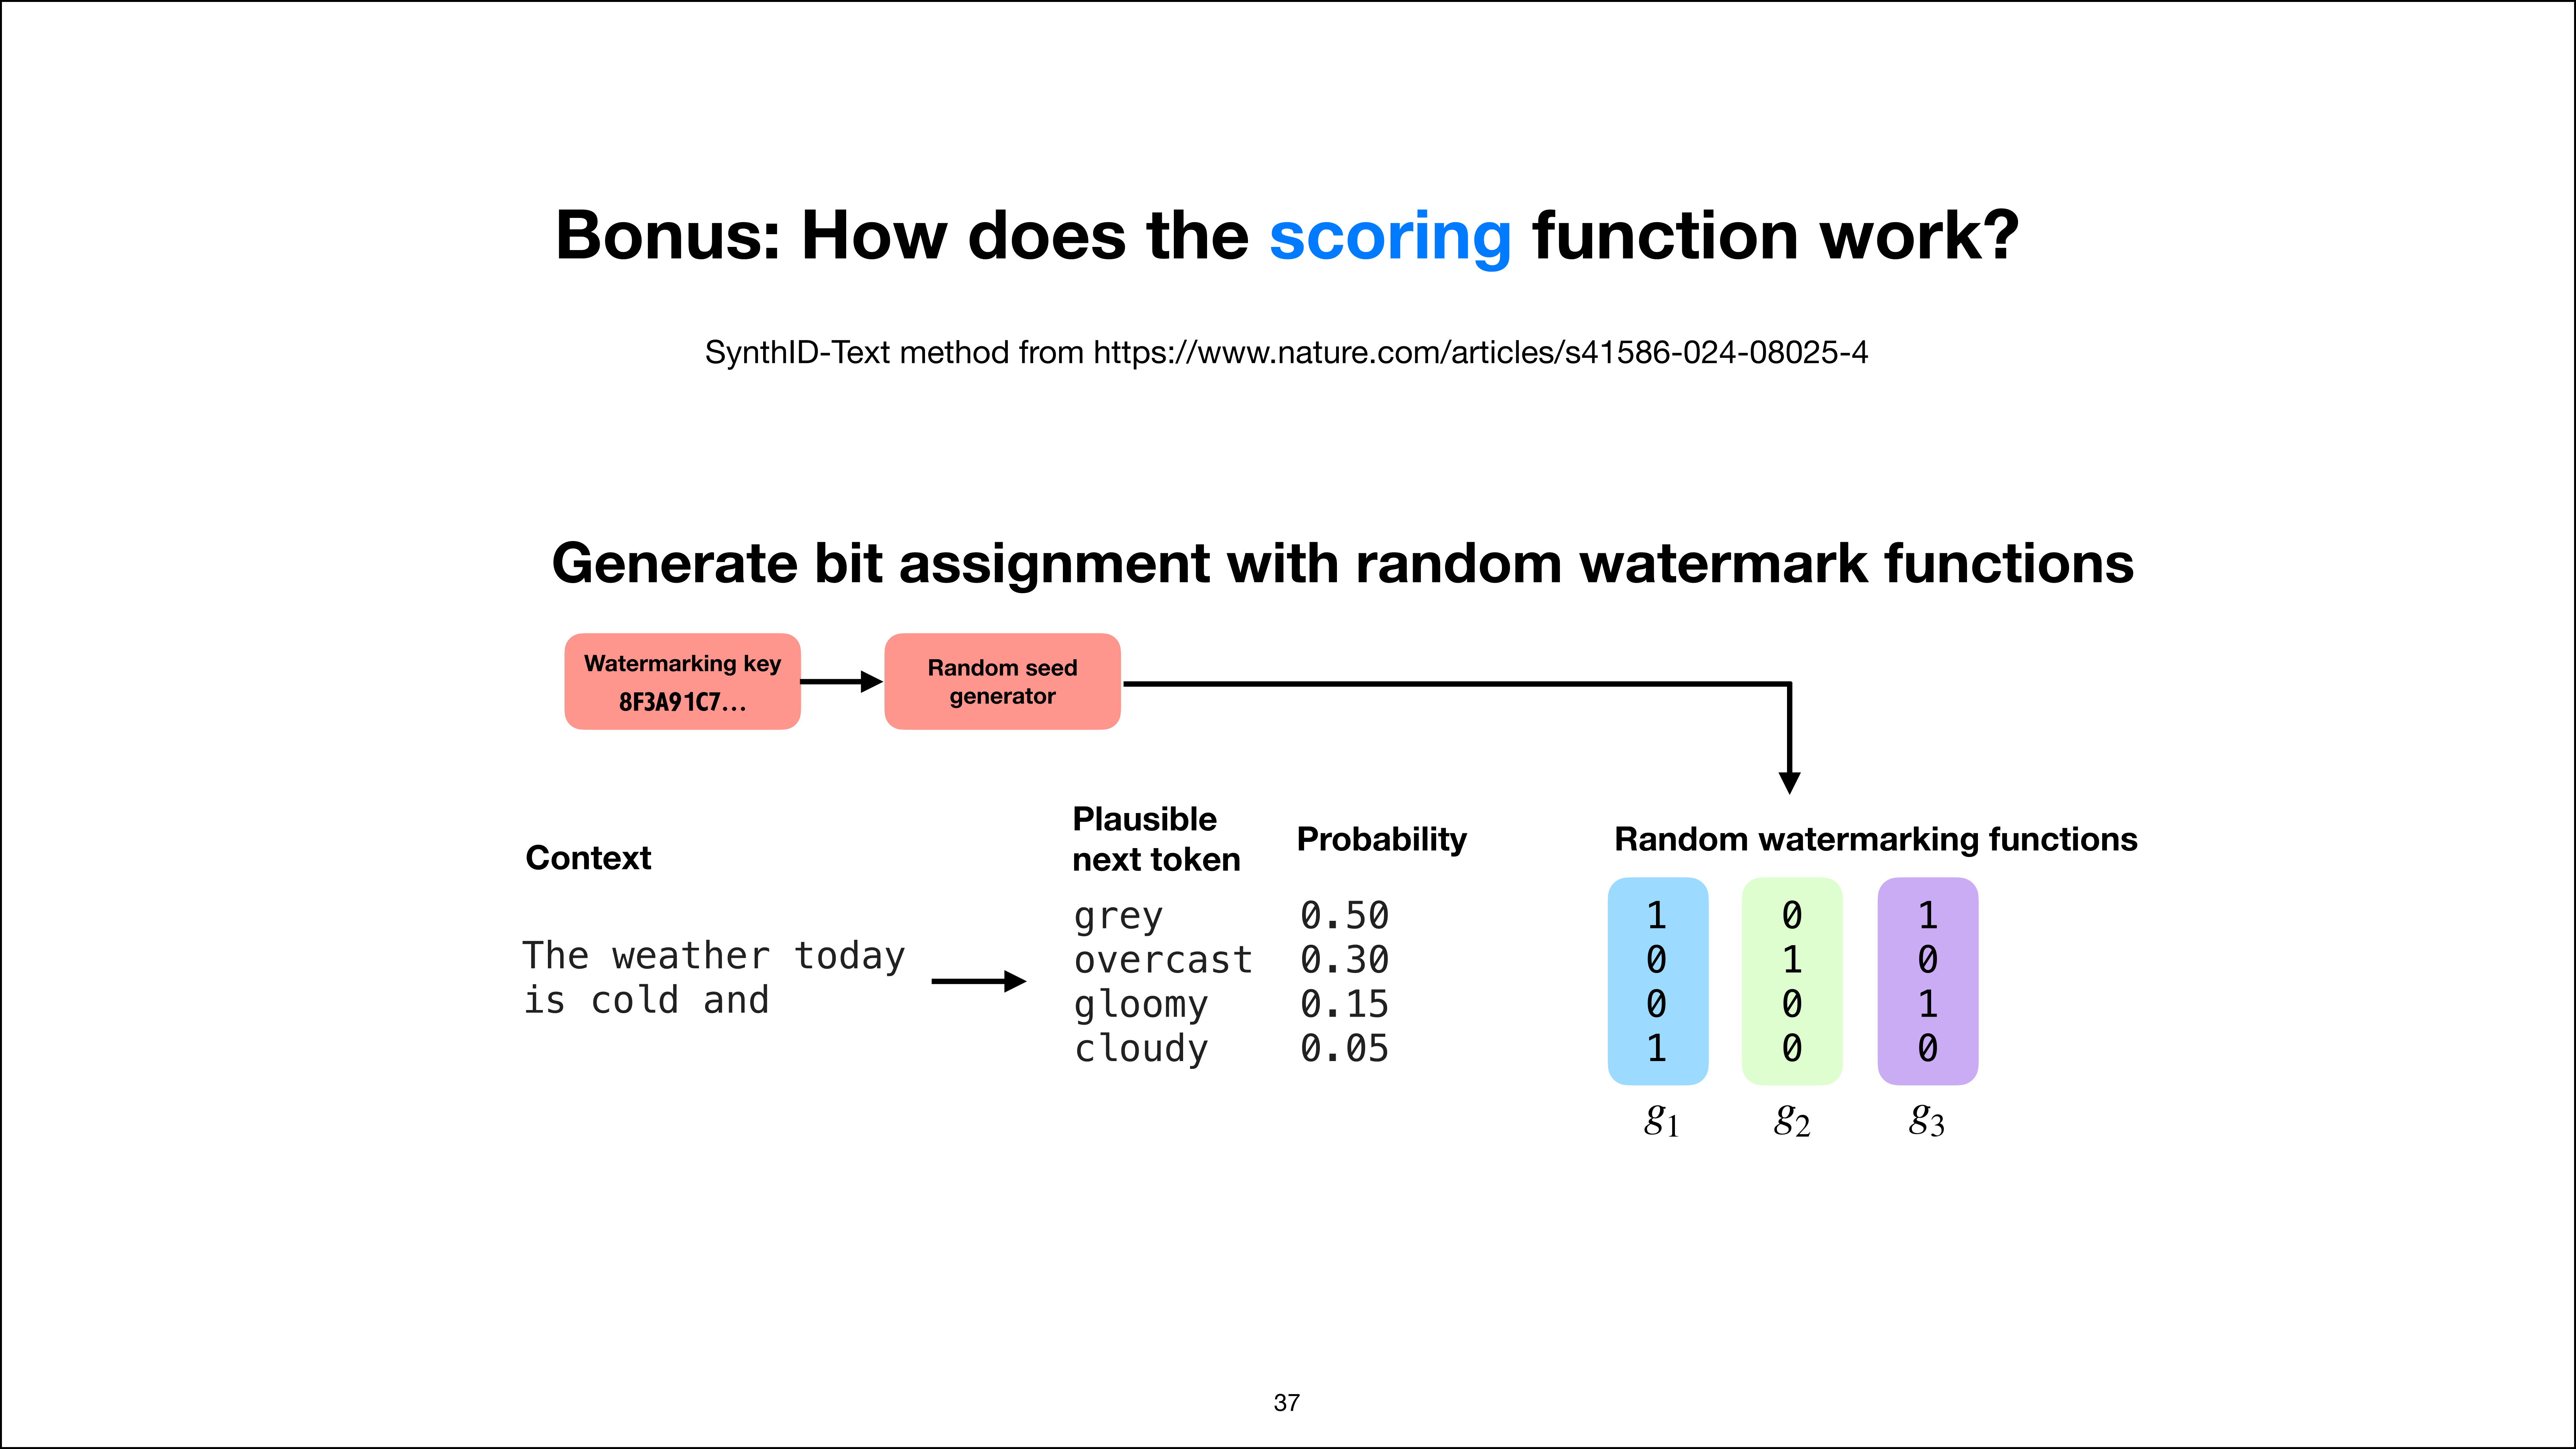
本质上,它就像一串由 0 和 1 组成的比特串。好的,这里以“gray”为例,通过这些水印函数,我们得到签名 101。对其它词也可以做同样的操作,比如对“overcast”、“gloomy”和“cloudy”都分别处理。每个词都有不同的签名,例如“overcast”是 010。
“Gloomy”是 001,“cloudy”是 100。好了,现在我们有了这些比特值。下一步是所谓的锦标赛抽样,也就是把这些值两两配对。
锦标赛抽样分步解析
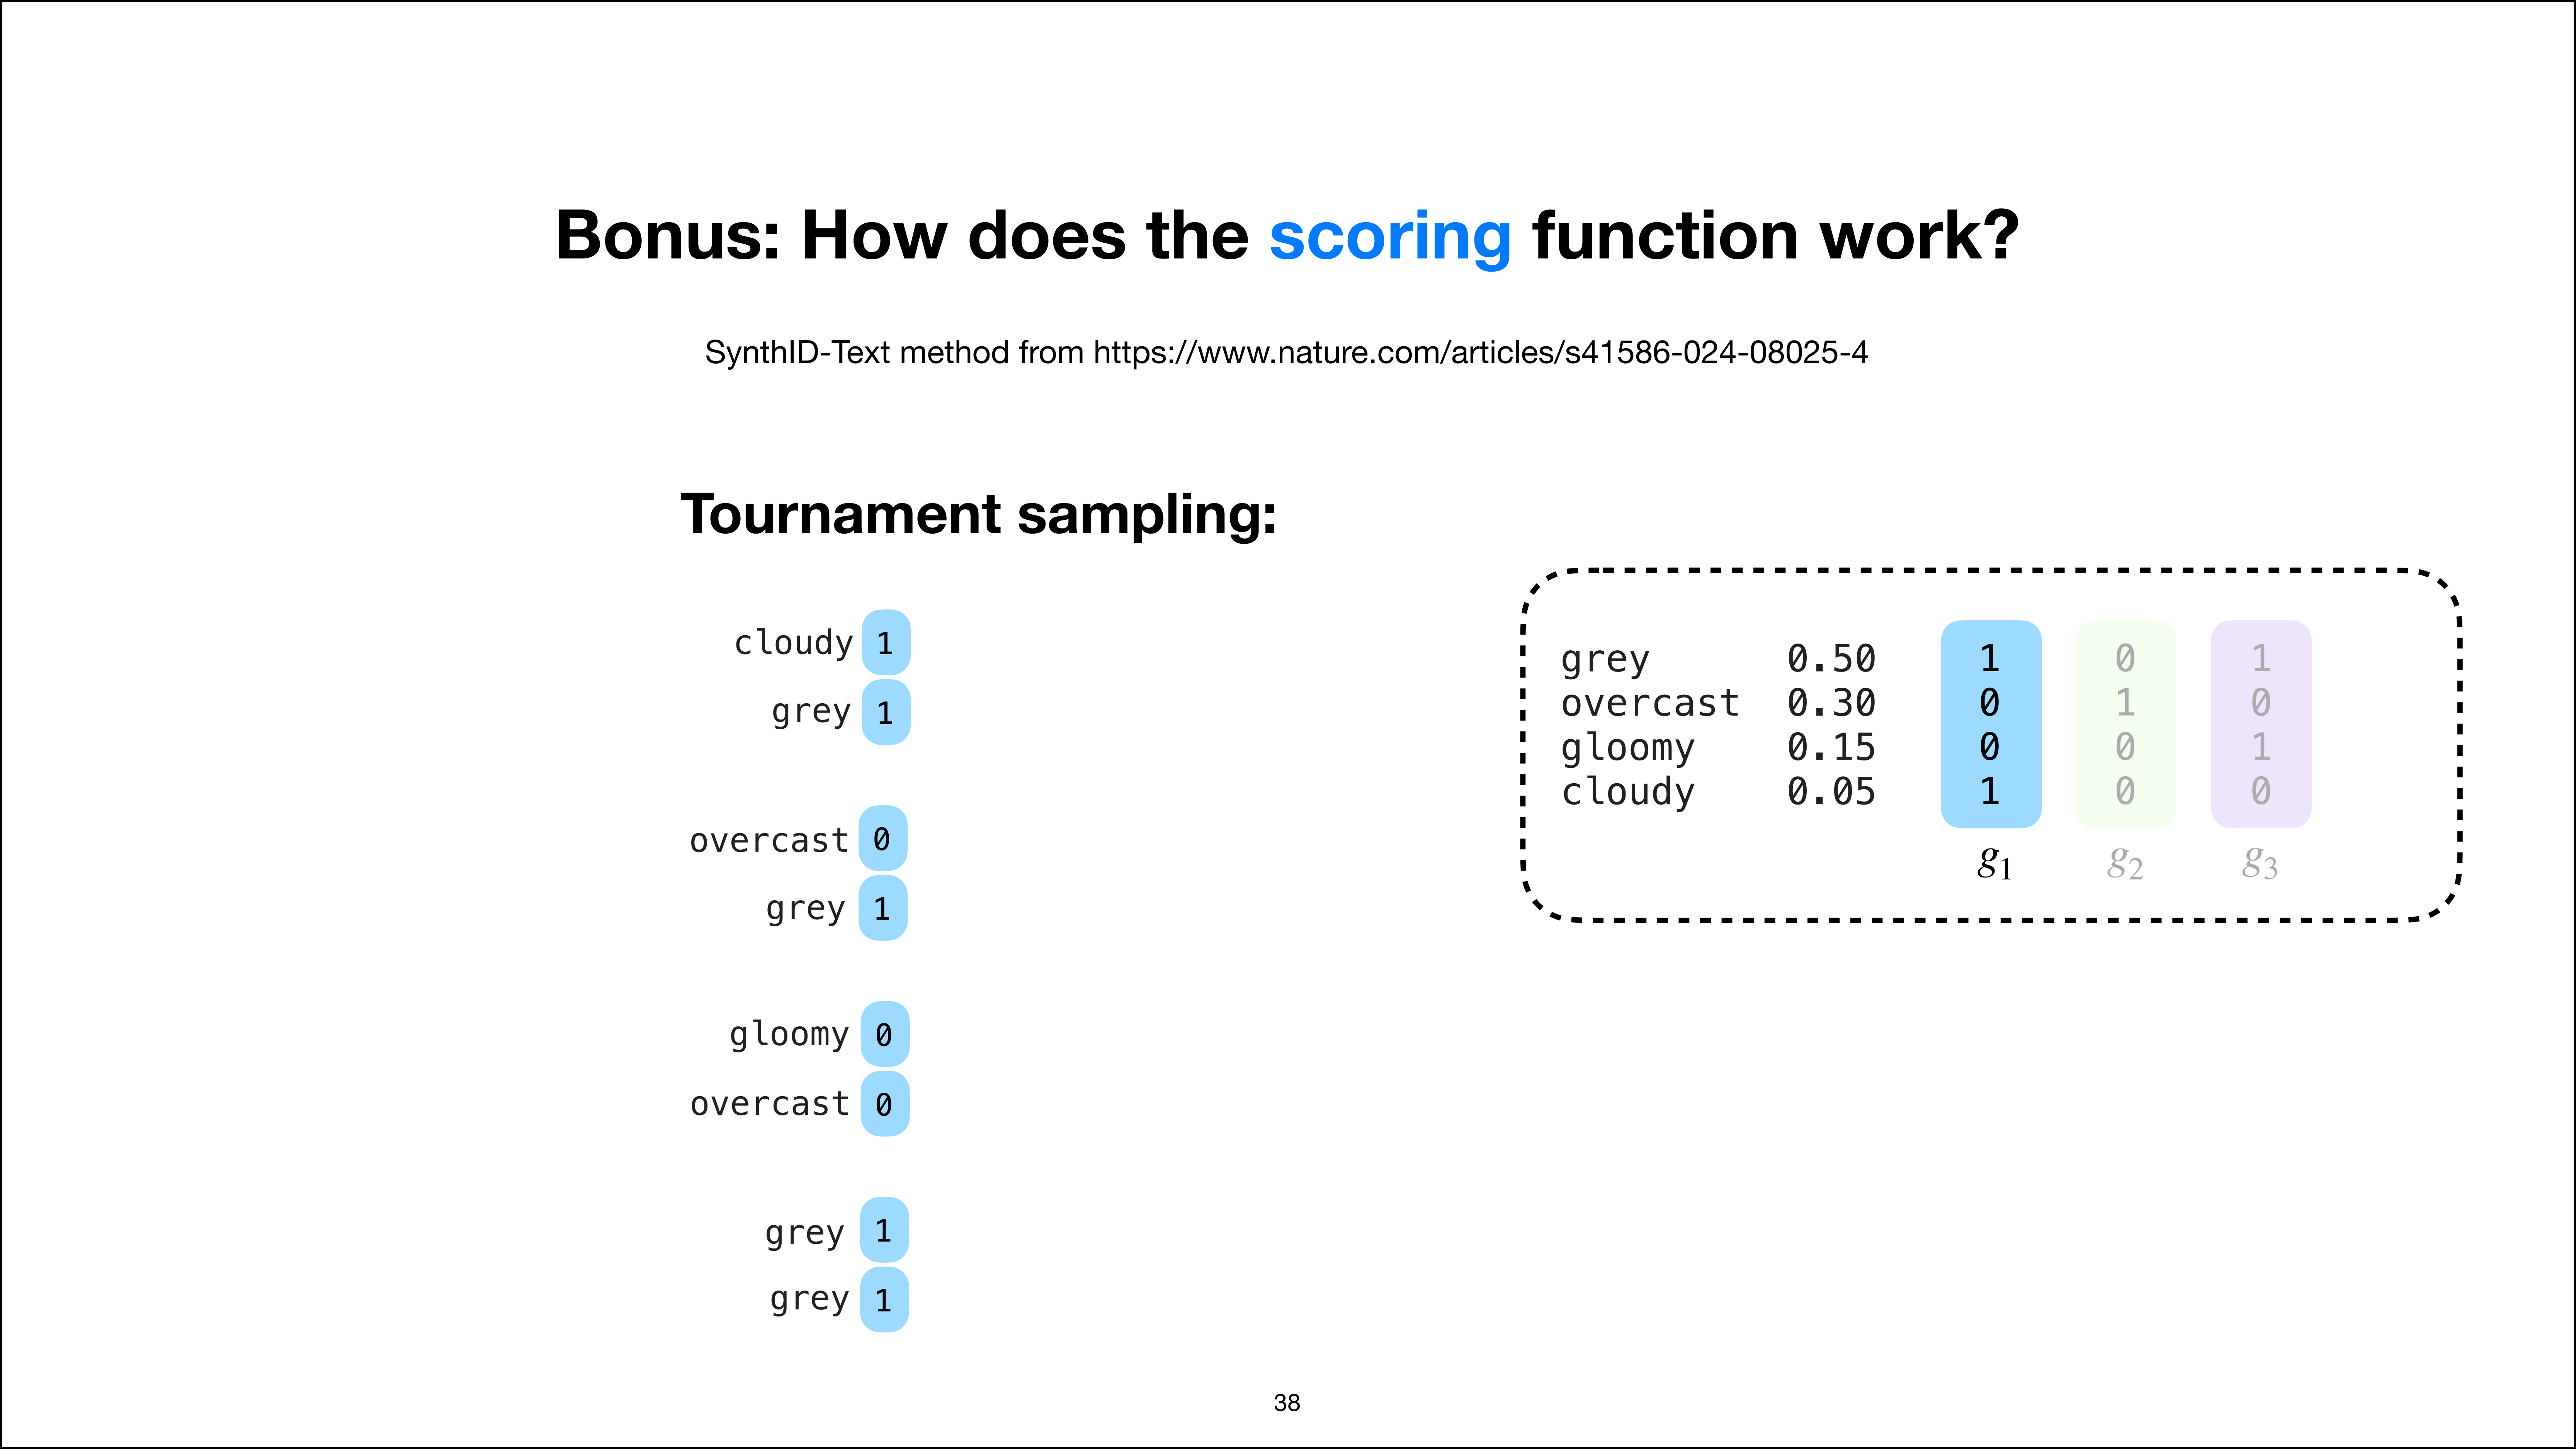
这就好比足球比赛的淘汰赛阶段,或者美式橄榄球的季后赛,总是两支队伍进行对决。这里的原理类似,我们将两个 token 配对,让它们本质上相互竞争。这里的得分来自上述函数。因此,我们从第一轮的第一个函数开始。第一组对手是“cloudy”和“gray”。