
【深入理解AIAgent】第09篇:窗口快爆了,为什么不能直接删前半段?—— 上下文压缩与子Agent隔离
我们沿着第二章的压缩代码追了一遍,发现“让上下文变短”只是表面目标;真正困难的是,删完以后 Agent 还能不能继续做对决定。
一、⚠️ 窗口快满了,最早的历史是不是最该先扔?
假设我们让 Agent 做一场长时间竞品调研。它已经搜索十几轮,网页正文、工具回执、失败记录和阶段结论不断涌入。上下文容量条终于变红,于是框架采用一个看起来很公平的办法:从最早的消息开始删除。
窗口立刻空出一大块,可第一轮恰好记录了竞品名单,第三轮保存了价格口径,第五轮解释了为什么排除某个来源。几轮之后,Agent 找不到这些依据,只好重新搜索;更糟时,它会用残缺信息拼出一个自信结论。
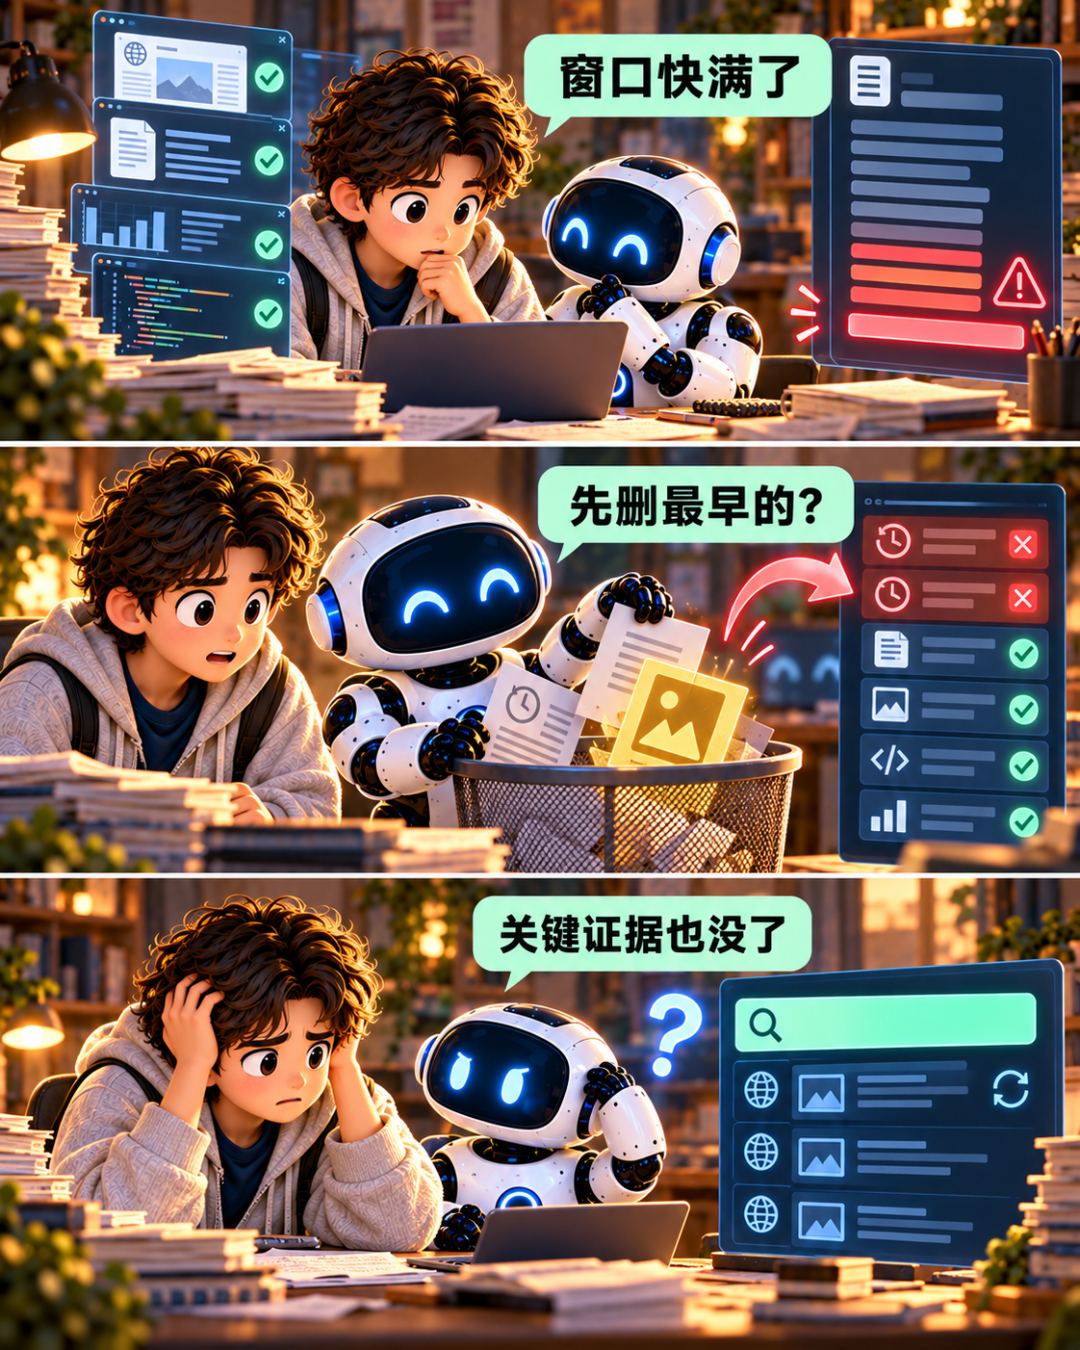
这就是滑动窗口最容易制造的假象:Token 少了,系统看起来更轻,任务却可能反复劳动。信息的价值并不按时间平均分布,最早出现的内容也可能决定后面所有步骤。
这篇我们只回答一个问题:当上下文越来越长,怎样在“保留原文、提炼摘要、彻底隔离”之间做选择,而不是把压缩变成一场盲目的删减比赛?
二、🧠 截断、压缩和隔离,其实是三种完全不同的动作
把上下文想成我们的项目工作台。网页、日志、代码和讨论都摊在桌上。桌面满了之后,可以有三种处理方式:把左边一摞直接扔掉、整理成高密度会议纪要,或者从一开始就让另一张桌子承担资料搜集。
截断是直接扔。它按长度、时间或消息数量裁掉内容,不理解里面是什么。速度快、成本低,但没有语义保证;如果工具申请与回执被拆开,还可能连 API 消息结构都破坏。
压缩是提炼后保留。它把多页搜索结果变成结构化摘要,保住姓名、日期、决策、失败与来源,把导航栏、重复段落和无关背景移走。它通常有损,而且需要额外模型调用。
隔离则是噪声不进主桌。主 Agent 把“大范围搜索代码库”交给子 Agent,子 Agent 在独立上下文里读取几十个文件,最后只返回函数位置、调用点和证据。中间材料随子上下文结束,不需要事后清扫。
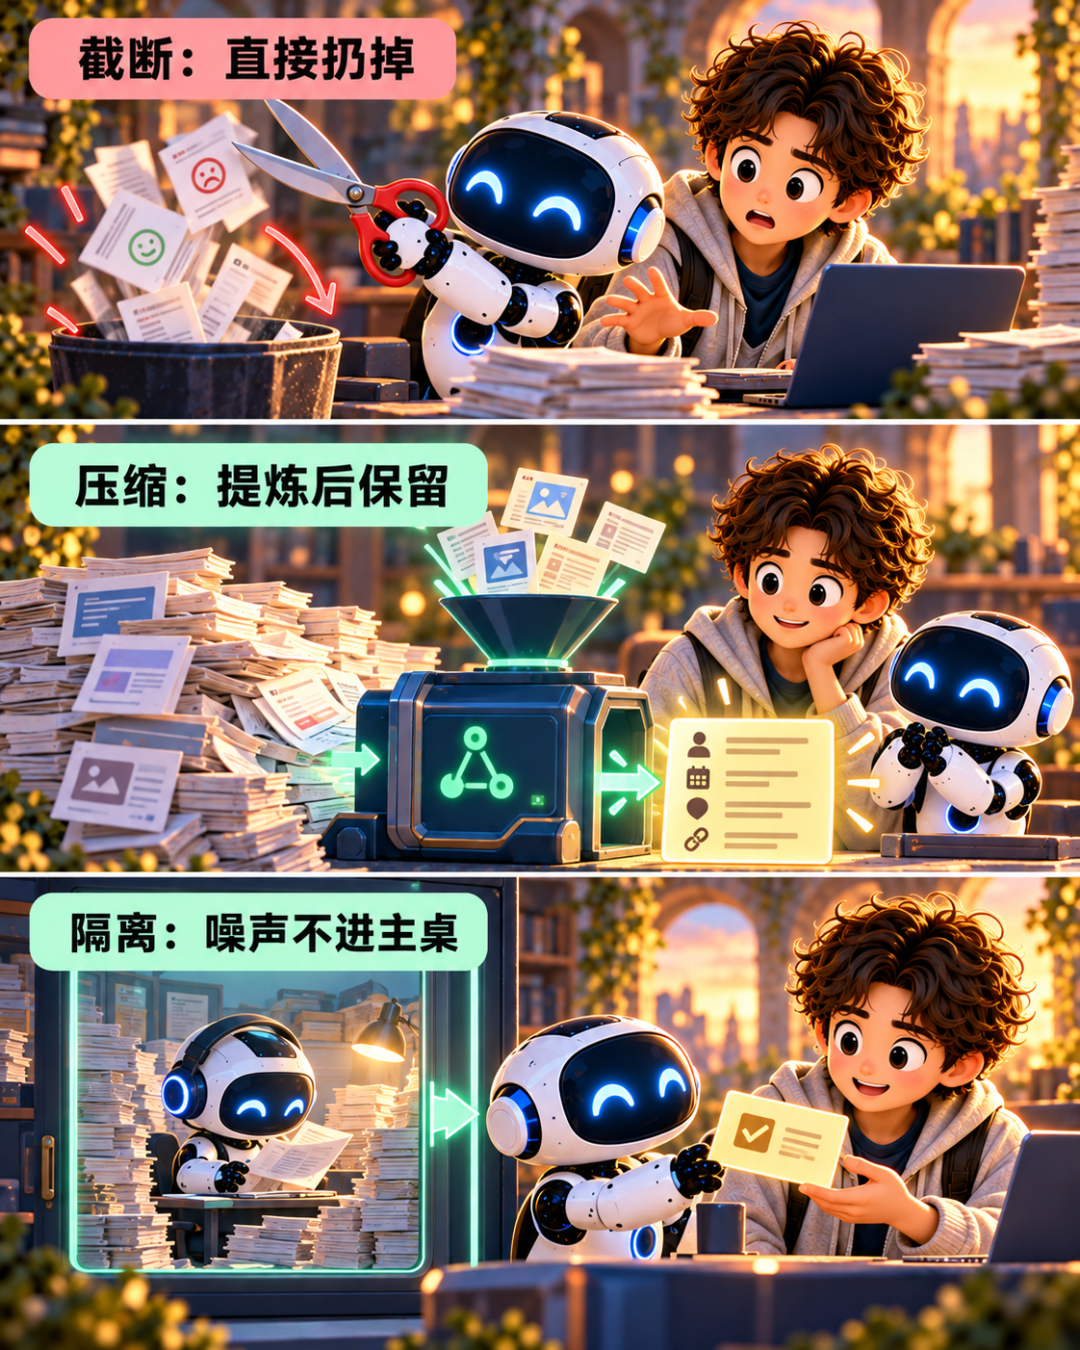
三个动作不能互相冒充。截断适合确定无价值、可以重新获取的尾料;压缩适合信息仍重要但原始形态过于臃肿的内容;隔离适合会产生大量中间噪声、而主 Agent 只需要结论的独立子任务。
这里还有一个比“窗口溢出”更隐蔽的问题:上下文腐化。窗口明明还没满,模型却在海量无关 Token 中找不到已经出现的关键信息。压缩不只是为了装得下,也为了提高信息密度,让后续决策更容易检索到真正的依据。
这个工作台比喻也有边界。压缩后的摘要不是事实本身,子 Agent 的结论也不是天然正确。无论怎样减负,关键结论都应保留来源指针,让主 Agent 或验收器能够回到原文重新核对。
三、⚙️ 压缩应该发生在什么位置,又会牺牲什么?
压缩通常发生在两次模型调用之间。Harness 先读取上一轮 Token 使用,再决定是否处理消息列表。稳定的系统提示词与工具定义尽量不动,主要压缩体积巨大的旧 tool 结果,从而保住前面的缓存前缀。
项目的窗口化策略使用 last_prompt_tokens,而不是把所有轮次的累计消费误当作当前窗口大小。只有本轮 Prompt 超过 128K 演示预算的 80%,才批量处理尚未带 [COMPRESSED] 标记的工具消息。
# 摘自 chapter2/context-compression/agent.py,省略日志
threshold = Config.CONTEXT_WINDOW_SIZE * 0.8
if self.trajectory.last_prompt_tokens <= threshold:
    return messages

marker = "[COMPRESSED]"
for message in messages:
    if message.get("role") != "tool":
        continue
    if message.get("content", "").startswith(marker):
        continue
    # 结合原工具查询压缩,并在结果前写入 marker
为什么不是每轮都压?因为替换中间消息会让变动点之后的 KV Cache 失效,压缩本身也要花一次模型调用。接近阈值时批量处理,是用一次可控的缓存重建,换取后续更多轮次可继续运行。
上下文感知压缩还会把“当前查询”和“已有信息”放进摘要提示。相同网页在“找出全部创始人”和“核对某人现在任职”两个阶段,应该保留不同内容。好的摘要不是原文缩小版,而是服务下一步决策的任务视图。
带引用的策略再多保留一层无损索引:摘要可以有损,但 URL、文件名、哈希或记录 ID 必须精确保留。它会占更多 Token,却让模型遇到争议时有路返回原始材料,这是一笔为了可验证性支付的成本。
原书图 2-16 汇总了六种策略。项目文档记录的单次运行中,无压缩在第 5 轮触发 128K 保护而失败;上下文感知摘要以 7 轮、40,157 Token 完成,文档中是成功策略里 Token 最少的一项。
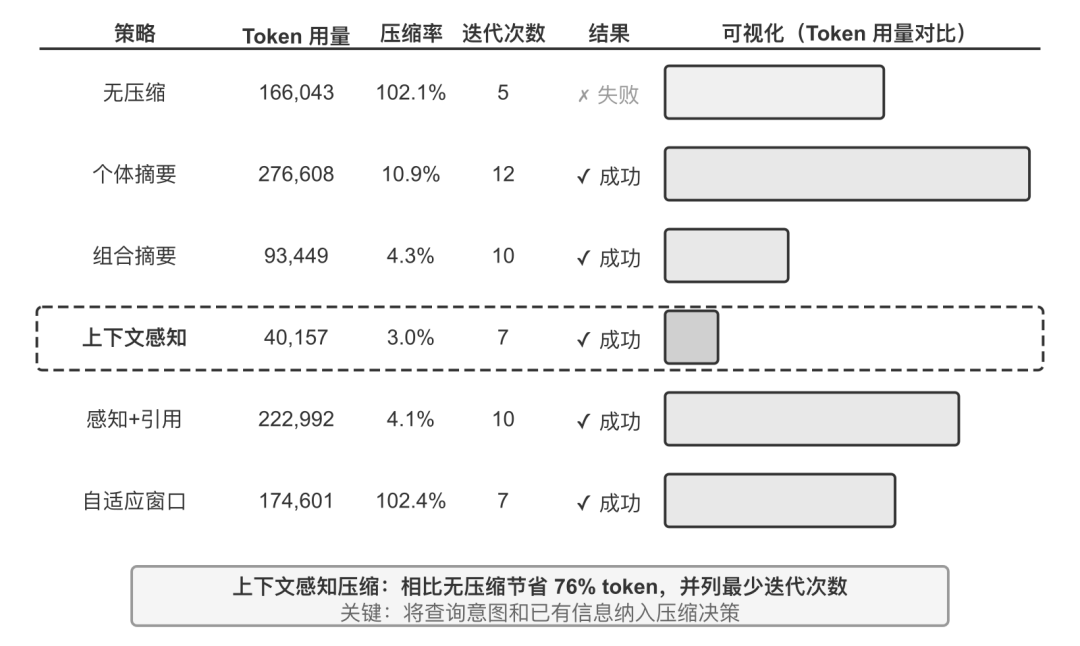
但这里必须划清证据边界:README 指向的 results/kimi_k3_real_20260718.json 当前并未随仓库保留。我们能核对书稿、图、实现和一致的文档数字,却看不到原始逐轮收据,因此不能把 40,157、93,449 等数字写成我们的独立复核结果。
即便只按项目文档读,结果也不能简化为“压得越狠越好”。逐页摘要用了 276,608 Token 和 12 轮;带引用的上下文感知用了 222,992 Token;自适应窗口虽然记录为 174,601 Token,却用 7 轮完成且延迟到接近阈值才压缩。
这说明压缩比、总 Token、轮次、是否成功和可追溯性是五个不同指标。组合摘要很短,但超长输入可能先被截断;引用版更贵,却能回源;窗口化保留近期原文,字符压缩率看起来甚至接近 100%,也不等于它没有管理上下文。
最后是隔离。对于代码库大范围搜索、网页批量抓取这类“中间过程大、最终结论小”的任务,先交给子 Agent 往往比先污染主上下文、再花钱压缩更干净。代价是委派描述必须自包含,否则子 Agent 会因看不到主上下文而走错方向。
四、🔍 我们的实践心得与深水区避坑指南
本篇验证等级是 L1/L2 文档与源码复核 + 局部 L3 离线测试。本轮没有真实搜索或模型压缩;完整测试最初因缺少 bs4 无法收集,uv --locked 又遇到镜像 403 和锁文件不一致。我们把 beautifulsoup4、html2text 安装到临时目录后,最终得到 6 passed。
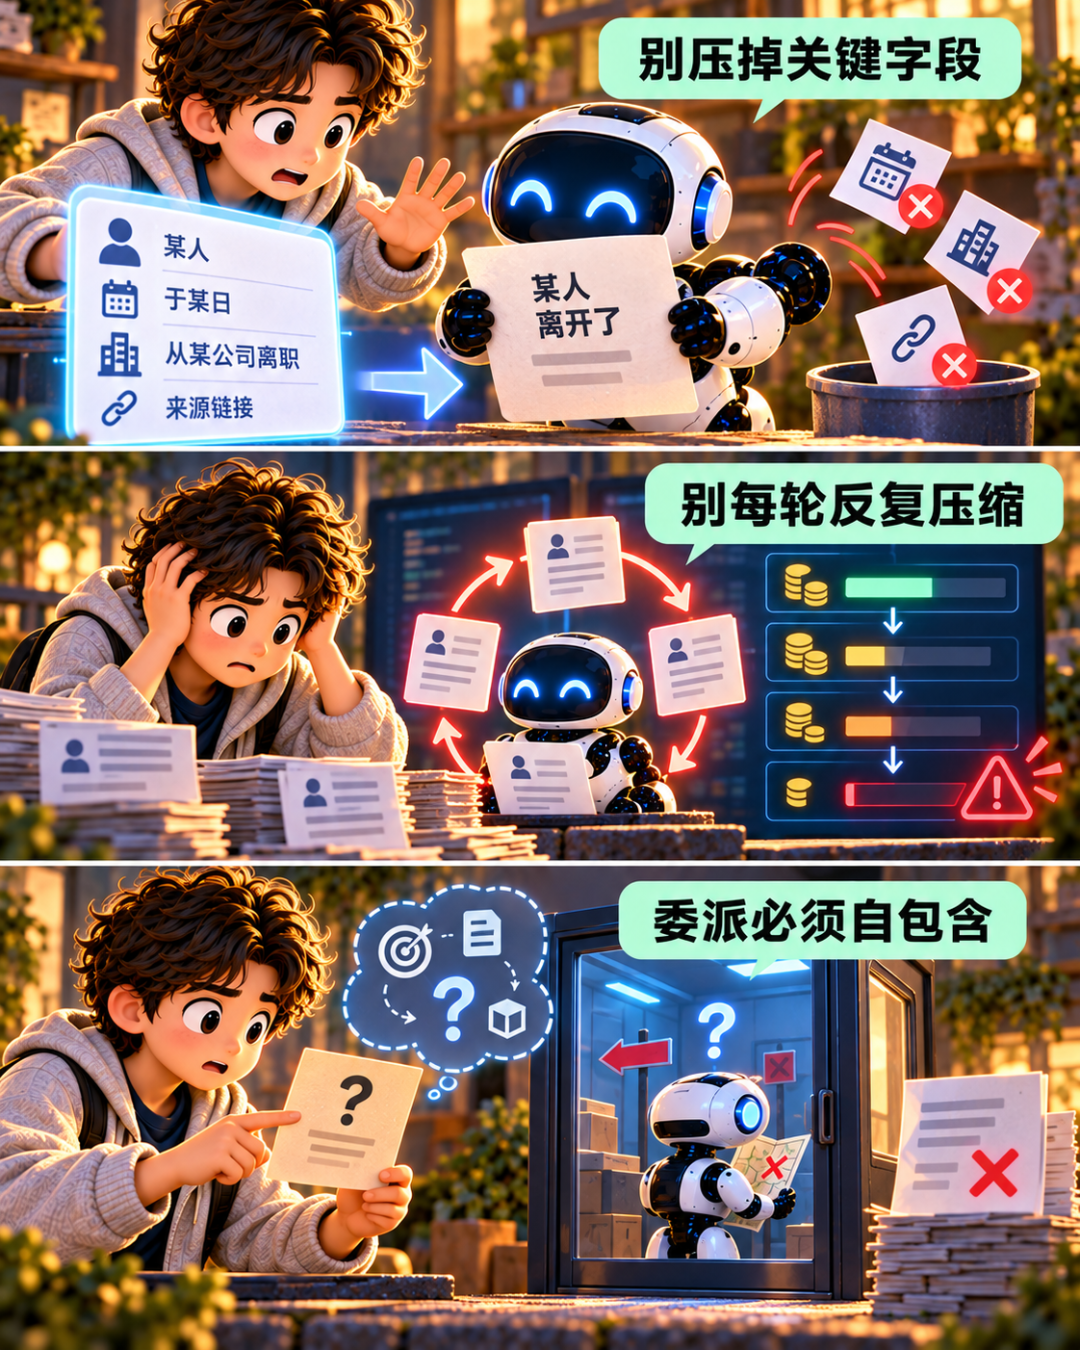
陷阱 1:只追求压缩率,把关键字段压成一句废话
“某人在某日从某公司离职”若被压成“某人离开了”,字数确实下降,却丢了时间、对象和事件语义。可观察后果是后续比较时间线失败,或无法证明结论来自哪里。
避坑方法是为任务定义保留清单:实体、时间、金额、状态、约束、决策理由、失败路径、文件名、URL、哈希和未完成 TODO。自然语言可以概括,标识符必须逐字保留。
陷阱 2:压缩失败后静默截断,或者每轮重复压缩
源码 compress_for_history() 捕获压缩异常后,会退化为前 2,000 字符加截断提示。这保证循环不崩,但末尾信息可能永久丢失;如果系统不记录降级状态,用户甚至不知道证据已经被裁掉。
可执行做法是给压缩产物加版本、原始长度、来源和降级标记;设置阈值批量压缩,并用 [COMPRESSED] 防重复。连续失败应熔断并请求调整策略,不能形成“压缩失败—再压缩”的烧钱循环。
陷阱 3:以为用了子 Agent,就自动实现了高质量隔离
子 Agent 看不到主任务里没写出的约束。只说“帮我查一下支付代码”,它可能返回一堆文件;明确目标、范围、输出 Schema、证据要求和停止条件,才可能只回传主 Agent 真正需要的结论。
我们建议上线前做一张“信息保质期表”:什么必须原文保留,什么可以结构化摘要,什么可直接删除,什么应从一开始隔离。 再为每类信息设置回源方式和验收规则,比只配置一个最大 Token 阈值更可靠。
本地 6 passed 只覆盖策略分派、Token 跟踪、流式日志、空内容和网页结果等代码边界,不证明书稿里的真实联网数字。把测试通过写成实验复现,恰恰会制造我们这篇反对的“信息压缩失真”。
五、💡 总结与课后思考
上下文压缩不是把字变少,而是让下一步决策需要的信息更密集、更准确,并且仍然找得到原始证据。
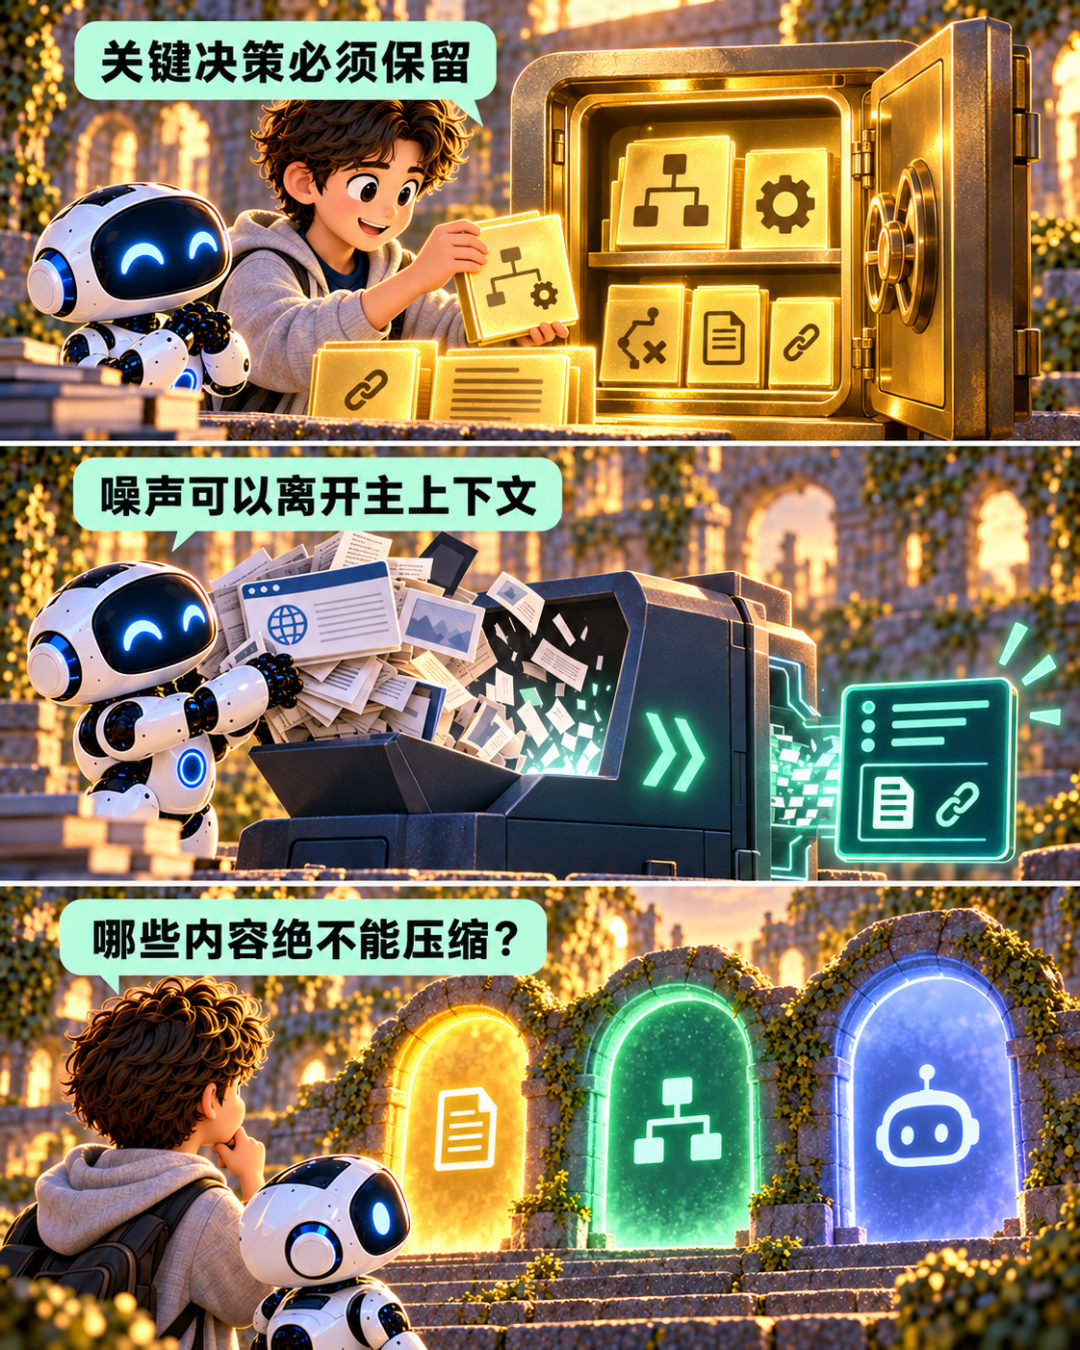
在你的真实 Agent 项目里: 哪些内容绝不能压缩——架构决策、用户授权、失败原因、文件路径、引用来源,还是别的?欢迎在评论区挑一类,并说说它应该保留原文、留下摘要,还是交给独立子 Agent。
下一篇,我们进入第三章:当会话结束后,哪些信息应该真正跨会话留下?我们会拆用户记忆的四种存储形态,以及“记住一切”为什么可能比“什么都不记”更危险。
📌 专栏导航与版权说明
本系列记录我们精读和实践《深入理解 AI Agent:设计原理与工程实践》的过程。我们尽量用自己的语言解释原理,并明确区分源码阅读、证据复核与独立复现。
- 原书与实验仓库:https://github.com/bojieli/ai-agent-book[1]
- 在线阅读:https://bojieli.github.io/ai-agent-book/[2]
- 开源许可:Apache License 2.0
本文不是原项目的官方解读。涉及作者信息、实验数量和项目状态时,以发布前核实的当前仓库与官方信息为准。
感谢阅读。下一篇,我们继续沿着原书、源码和实验往下拆。
参考链接
- https://github.com/bojieli/ai-agent-book: https://github.com/bojieli/ai-agent-book
- https://bojieli.github.io/ai-agent-book/: https://bojieli.github.io/ai-agent-book/