
LLM 研究论文精选清单:2026 年 1–5 月
如部分读者所知,我有个长期保留的习惯:持续维护一份我想阅读、回顾,或在未来的文章和项目中引用的研究论文清单。
去年,我分享过两份整理好的论文列表,一份涵盖 1 月至 6 月,另一份涵盖 7 月至 12 月。
不少读者反馈这些列表非常实用。受此鼓舞,我按同样的思路为 2026 年上半年准备了一份新清单,涵盖 2026 年 1 月至 5 月期间我收藏的论文。
请勿将此视为今年所有发表论文的完整列表。鉴于每天发表的论文数量庞大,做到全覆盖是不现实的。相反,这是一份精选参考列表,基于我发现有趣或与我当前工作相关的论文。在整理清单时,我仔细审阅了标题、摘要和主题框架,但必须承认,我也只是详细阅读了其中一部分论文。
为什么要制作这些列表?在撰写文章、书稿章节、代码示例或讲义时,我常想起曾在某处见过一篇相关论文,但再次找到它往往令人头疼。一份分类清晰的 Markdown 列表解决了这个问题,希望对你也有帮助。(即使在基于 LLM 的网络搜索时代,拥有特定的上下文列表依然非常有用。)
今年的列表再次侧重于推理模型、强化学习和高效推理,因为我倾向于收藏与当前工作相关的论文。与 2025 年的列表相比,我还收藏了更多关于 agent harnesses、工具使用、长上下文、扩散语言模型(diffusion language models)以及实际服务基础设施的论文,因为这些是我目前深入参与的方向,也是该领域的未来趋势。
这份研究论文列表的分类如下。(小贴士:在网页版文章中,你可以使用左侧的目录跳转到与你最相关的部分。)
架构与模型设计
高效训练与扩展
推理效率与 KV Cache
稀疏注意力与长上下文
推理与测试时计算
强化学习与 RLVR
智能体系统与工具使用
编码智能体与软件工程
扩散语言模型
模型评估与基准测试
1. 架构与模型设计
本部分收录了关于模型架构、模型发布技术报告,以及解释当前 LLM 为何呈现现有形态的论文。
我对 2026 年迄今的一个有趣发现是,架构工作不再局限于放大 Transformer。目前有大量工作围绕以下方向展开:
混合架构(例如 Nemotron 3 和 Arcee Trinity),
状态空间层(Nemotron 3 和 Mamba-3),
MoE 容量分配(Scaling Embeddings Outperforms Scaling Experts 和 Step 3.5 Flash),
表示几何(Symmetry in Language Statistics Shapes the Geometry of Model Representations)。
这些论文都相当有趣,这也是我最初标记它们的原因。但如果只能推荐一篇必读,我会选择 Nemotron 3 Super。这篇文章细节极其丰富(非故意玩双关),且描述了已在生产环境中使用的模型技术。毕竟,它是同尺寸级别中表现最佳的模型之一。
Nemotron 3 的一个有趣方面在于其混合架构设计,即在常规注意力层和 Mamba-2(状态空间模型)层之间交替,以提高长上下文处理效率。在 2026 年,随着越来越多的 LLM 被接入智能体框架(如 OpenClaw 等),长上下文效率至关重要,这要求模型能够处理越来越长的上下文。
话虽如此,120B-A12B 对于普通消费者硬件的本地推理可能稍显庞大,不过也有一个 Nemotron 3 Nano(4B)版本可用。
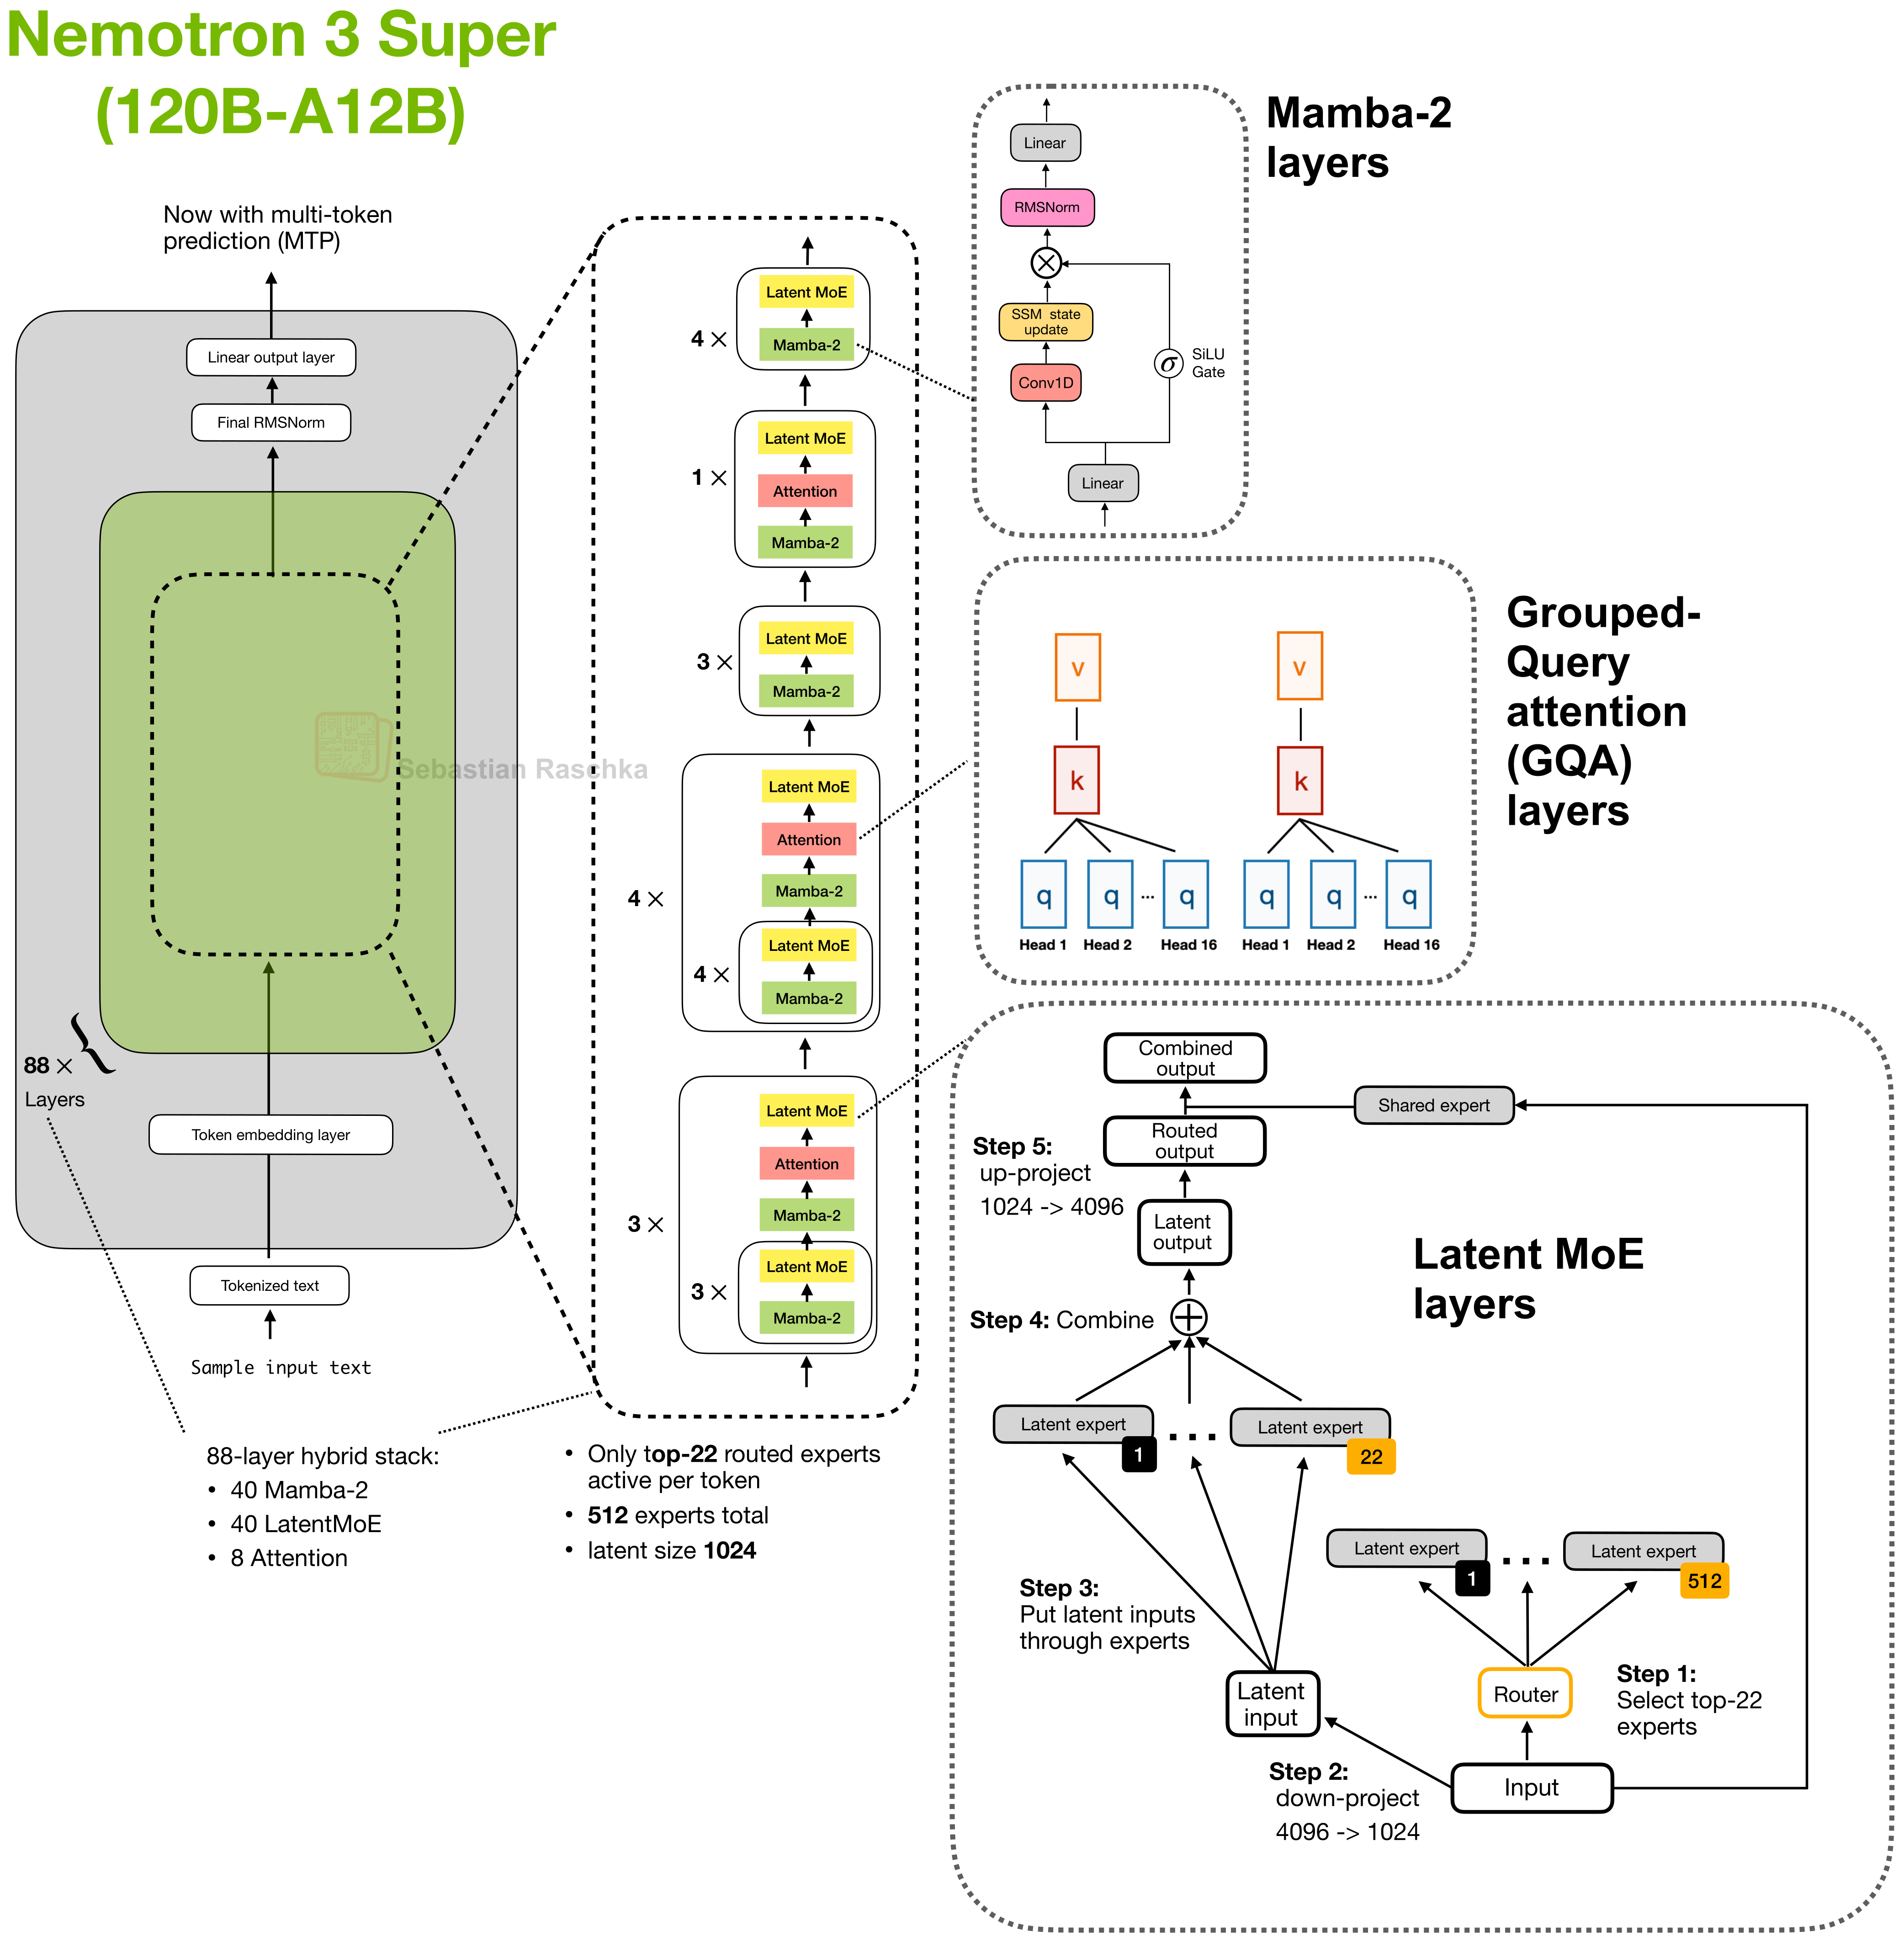
值得一提的是,Nvidia 两天前还发布了它的放大版本 Nemotron 3 Ultra(550B-A55B),只是扩大了 embedding 和 projection 的维度,其他构建模块基本相同。如果想看图解说明,我在 Substack Notes 上发过一篇帖子,见这里。
这种在 attention 层之间交替插入其他类型层的混合架构,是今年相当热门的发展方向。采用类似混合设计的最知名的开源权重 LLM 系列应该是 Qwen3.6,它的非 attention 部分用的是 Gated DeltaNet 层而不是 Mamba-2 层。更详细的介绍可以看我写的 Hybrid Attention(https://sebastianraschka.com/llm-architecture-gallery/hybrid-attention/)一文,内容整合自我之前在 Substack 上写过的几篇相关文章。
另外,你可能已经注意到,下面的论文列表里出现了 Mamba-3 和 Gated DeltaNet-2(也就是 Mamba-2 和 GatedDeltaNet 的更新版本),很期待在接下来的开源权重模型(比如 Nemotron-4 和 Qwen4?)中看到它们的应用。
除了介绍混合架构设计,Nemotron-3 论文里还有大量其他有意思的消融实验,比如面向 speculative decoding 的多 token 预测、NVFP4 预训练与 BF16 的对比、合成 MMLU 风格数据,以及后训练量化方案等,不过这些细节超出了本文概览的范围。
1 月 1 日,Deep Delta Learning,https://arxiv.org/abs/2601.00417
1 月 6 日,MiMo-V2-Flash Technical Report,https://arxiv.org/abs/2601.02780
1月13日,Ministral 3,https://arxiv.org/abs/2601.08584
1月29日,《规模化嵌入优于规模化专家:语言模型中的新发现》,https://arxiv.org/abs/2601.21204
1月30日,《LatentLens:揭示LLM中高可解释的视觉Token》,https://arxiv.org/abs/2602.00462
2月4日,《ERNIE 5.0 技术报告》,https://arxiv.org/abs/2602.04705
2月8日,《ViT-5:面向2020年代中期的视觉Transformer》,https://arxiv.org/abs/2602.08071(本文大部分内容聚焦于LLM,但我实在没忍住,加入了一个最新的重大视觉Transformer设计。)
2月11日,《Step 3.5 Flash:以11B激活参数实现开放前沿级智能》,https://arxiv.org/abs/2602.10604
2月12日,《Nanbeige4.1-3B:一个能够推理、对齐并执行行动的小型通用模型》,https://arxiv.org/abs/2602.13367
2月16日,《语言统计中的对称性塑造模型表示的几何结构》,https://arxiv.org/abs/2602.15029
2月17日,《GLM-5:从氛围编程到智能体工程》,https://arxiv.org/abs/2602.15763
2月18日,《Arcee Trinity Large 技术报告》,https://www.arxiv.org/abs/2602.17004
3月4日,《尖峰、稀疏与汇聚:巨型激活值与注意力汇聚的解剖》,https://arxiv.org/abs/2603.05498
3月12日,《Tiny Aya:连接规模与多语言深度》,https://arxiv.org/abs/2603.11510
3月15日,《注意力残差》,https://arxiv.org/abs/2603.15031
3月16日,《Mamba-3:基于状态空间原理改进序列建模》,https://arxiv.org/abs/2603.15569
3月31日,《从注意力到Mamba:跨架构蒸馏的配方》,https://arxiv.org/abs/2604.14191
4月13日,Nemotron 3 Super:面向智能体推理的开源高效混合 Mamba-Transformer 专家混合模型,https://arxiv.org/abs/2604.12374
5月6日,ZAYA1-8B 技术报告,https://arxiv.org/abs/2605.05365
5月13日,Delta Attention 残差,https://arxiv.org/abs/2605.18855
5月21日,Gated DeltaNet-2:线性注意力中擦除与写入的解耦,https://arxiv.org/abs/2605.22791
5月25日,MiniMax-M2 系列:微小激活量释放极致现实智能,https://arxiv.org/abs/2605.26494
2. 高效训练与规模化
本节聚焦训练系统、适配方法及规模化策略。这些论文并非(全部)关于从零开始预训练。部分研究关注微调、蒸馏、测试时训练,或在受限硬件上提升训练效率。