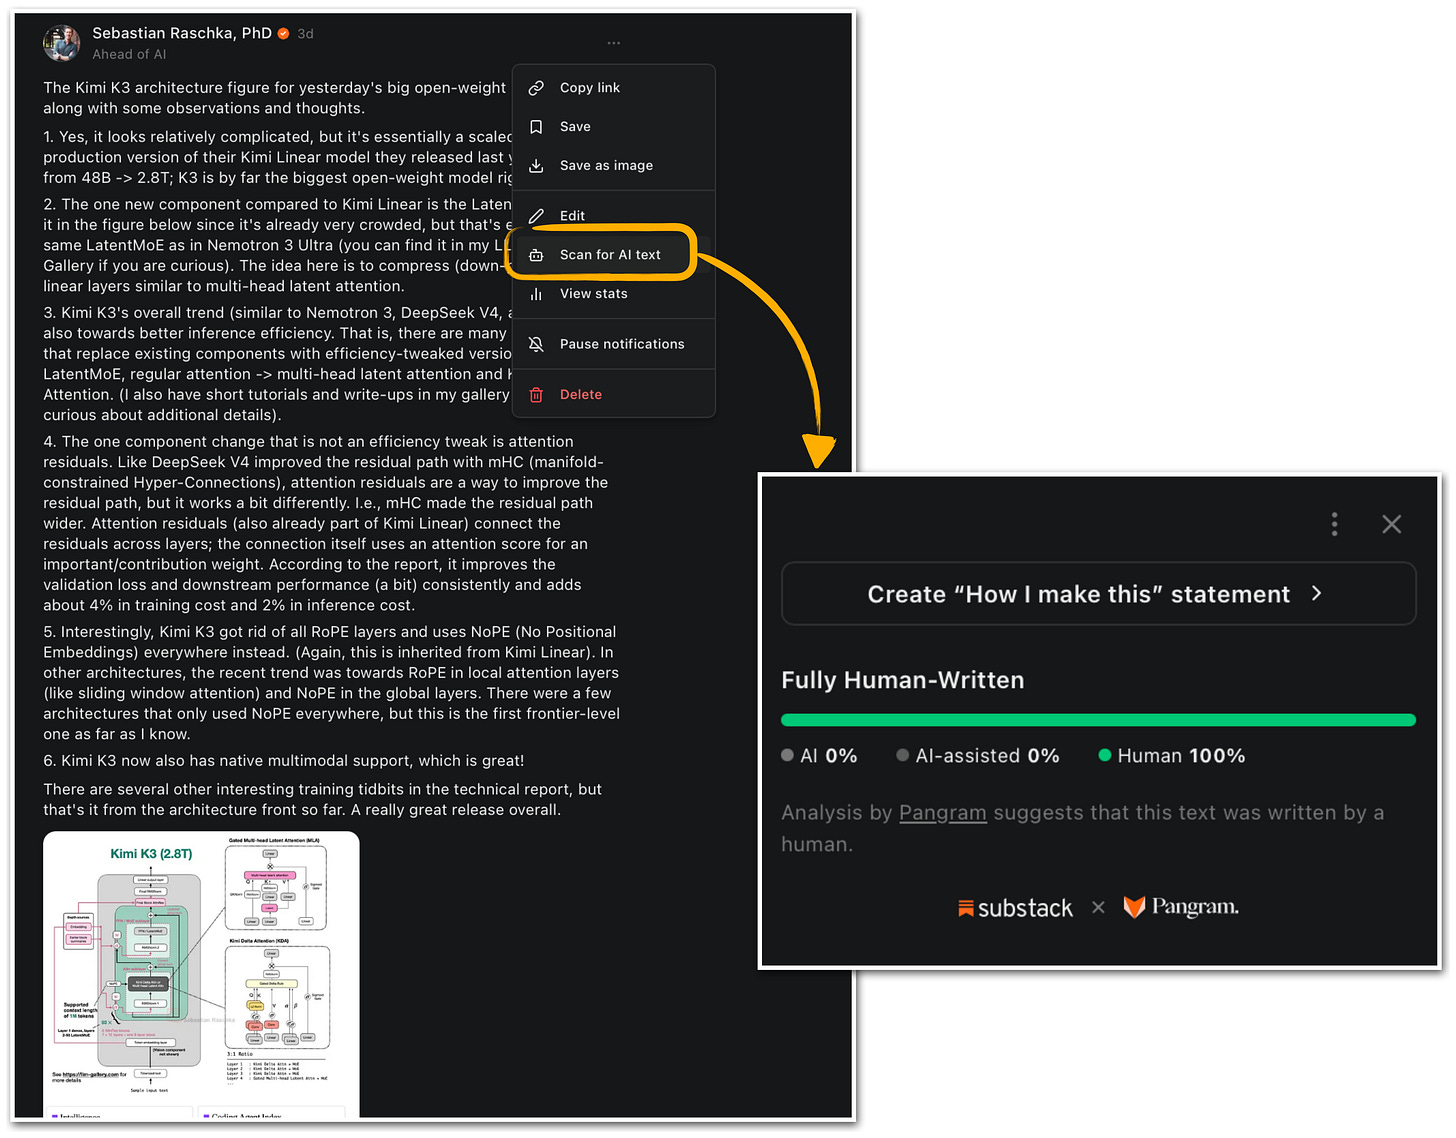
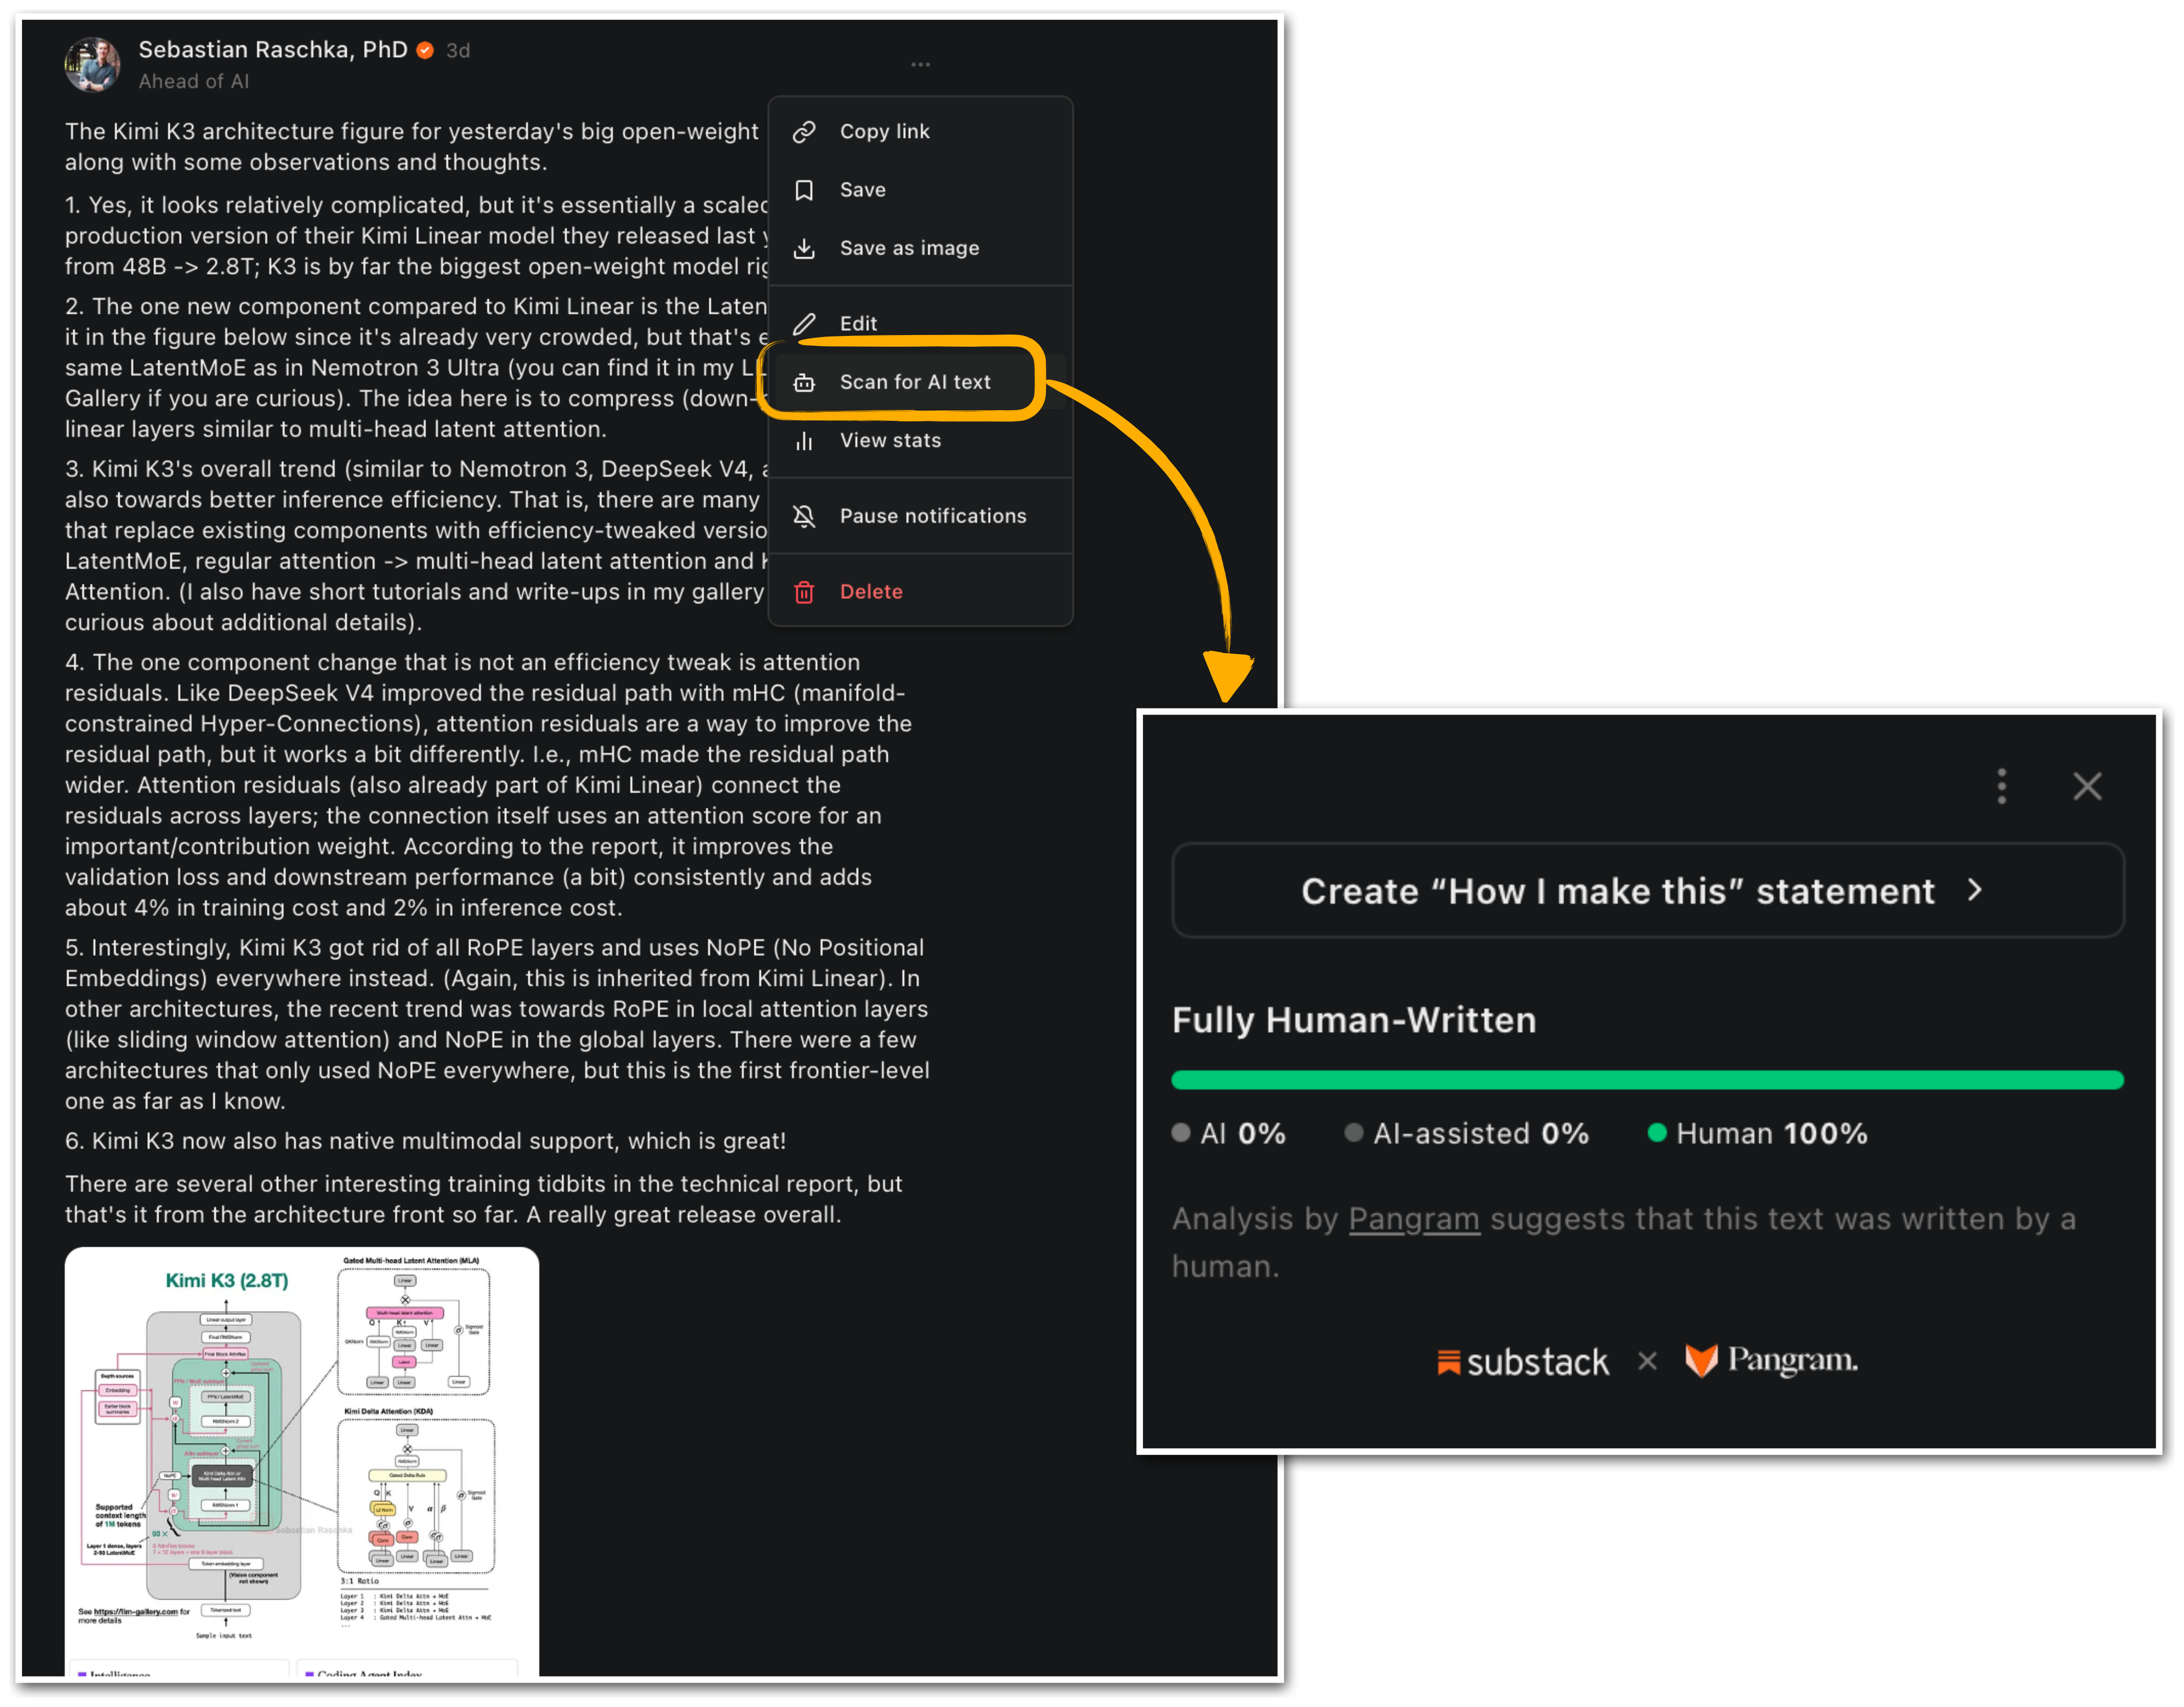
Substack 最近在界面上线了 AI 检测功能,非常有趣。
另一方面,很多人问过我有没有适合本地折腾的 LLM 项目,可以当 demo 展示小语言模型(SLM)能做什么。
两者结合,我觉得展示一下 AI 检测器怎么实现会很有意思。我还会把它用作一个验证器,训练一个小语言模型生成能绕过检测的文本。这是一个小型教学项目,用来研究 AI 检测器的局限性,同时探索一种基于验证器的 LLM 应用——不同于常规的数学和代码推理模型。
图 1:Substack 现在内置了 AI 检测功能。
所以,如上所述,本教程的目标是通过亲手构建一个(简单的)AI 检测器,来讲解它的工作原理。
实际应用中,这类检测器可以用来过滤垃圾内容,也能帮你改进个人写作——同时避免让文字变得像 AI 生成的。比如你写了一篇长文,想修正拼写和语法问题,用语法检查工具润色一下、提升可读性,既诱人也确实有用。市面上有不少这类服务,包括 ChatGPT 这样的通用 LLM。但风险在于,这些工具可能把你的文字——虽然仍是你的原创——润色得过度,结果读起来像 AI 写的,被当成垃圾内容标记出来。
有了 AI 检测器,你就可以说:“帮我修正语法,但要保证我的文字 AI 生成率为 0%。”
总之,虽然我们要构建的是一个功能完整的检测器,但真正的目的是:1)讲清楚 AI 检测器(可以)如何工作,2)以此为例,探讨一个更通用的话题——如何构建可配合 LLM 使用的打分器或验证器。
说明:AI 检测本质上是一场猫鼠游戏。检测器或许能识别出某种特定模式,将其视为 AI 生成内容的特征;然而下一代 LLM 很可能恰好或不刻意避免这种模式,从而绕过检测。检测器随即需要升级以应对新的 LLM,如此循环往复。此外,检测器还容易出现误报——将人类写作的文本标记为 AI 生成——这一点稍后会详细讨论。
项目目标
这个项目有几大目标。核心目的自然是在于展示 AI 检测器的工作原理,并演示一个完整的 LLM 应用项目,涵盖评估、训练及本地部署等实际落地环节。
最终成果是一个 AI 检测器 API,人类和智能体(Agent)均可调用,并配有一个易用型 UI。
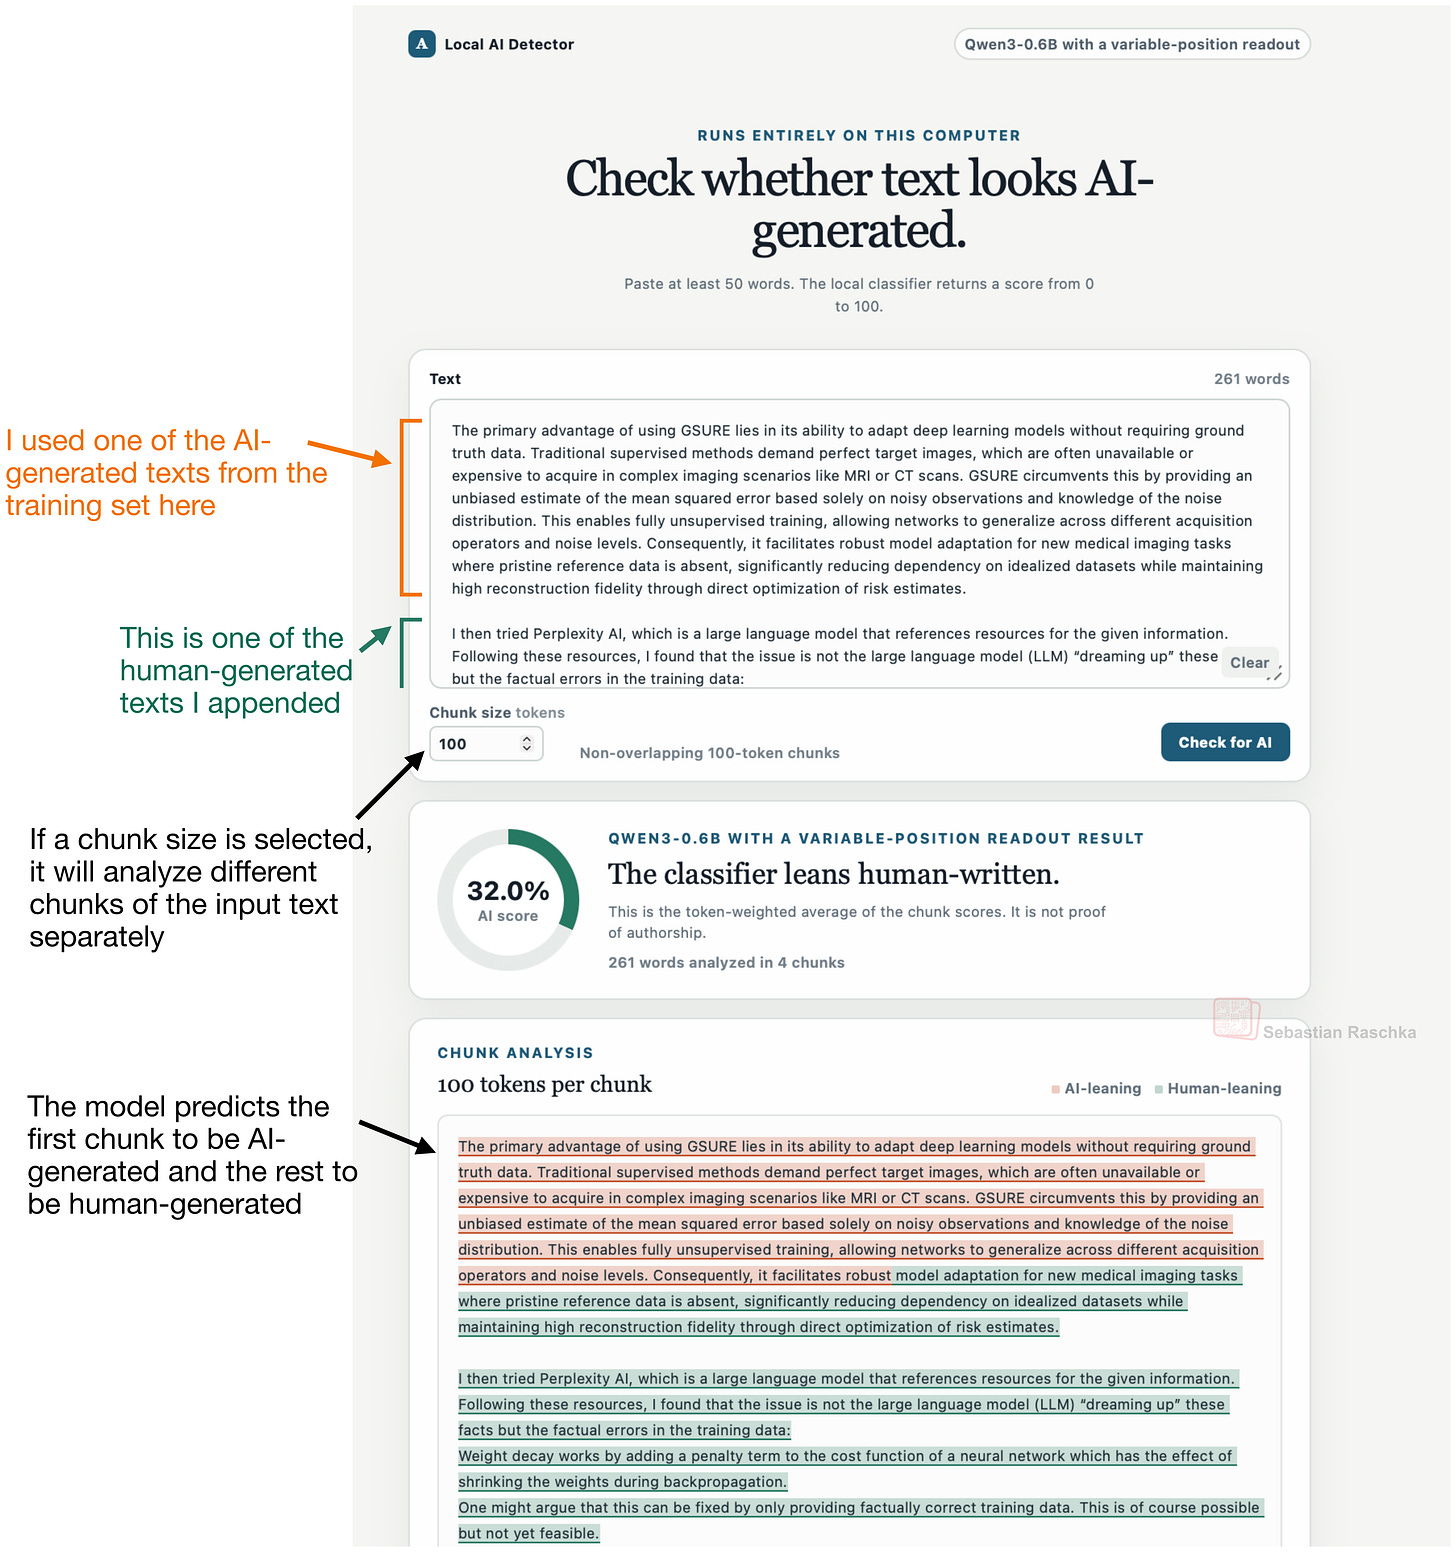
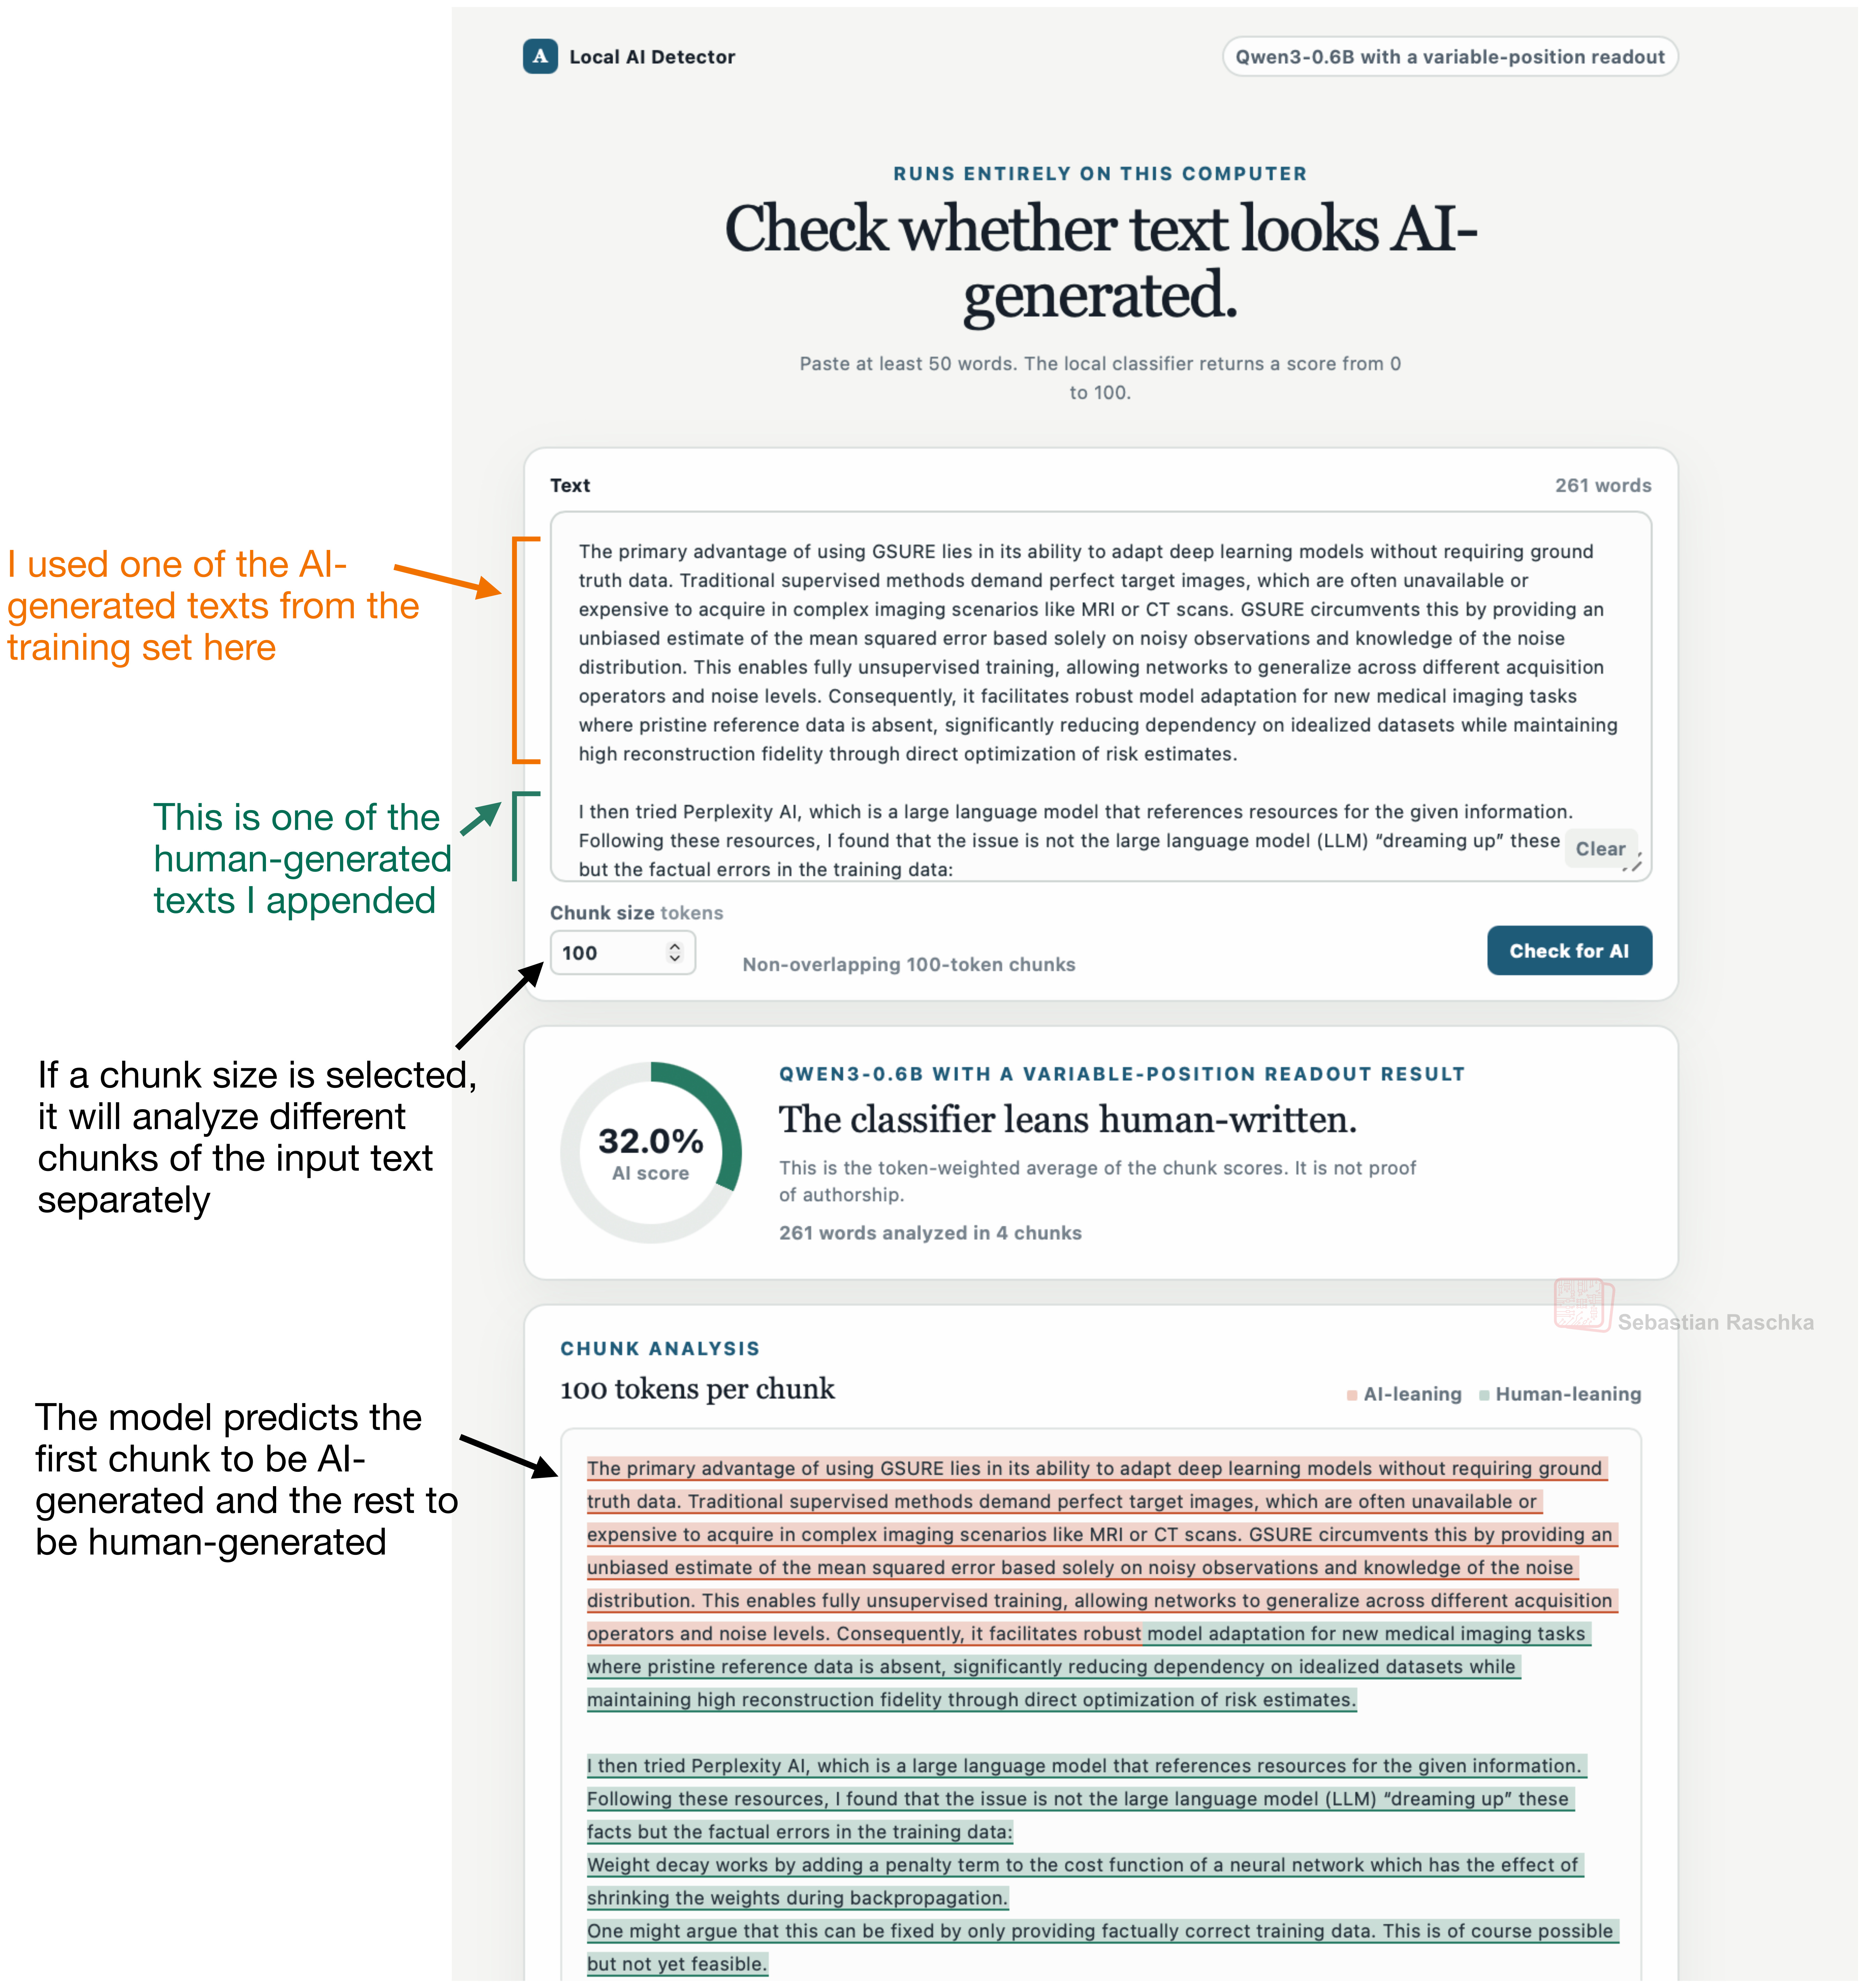
图 2:本项目后期开发的本地浏览器界面预览。它可输出全文的 AI 得分,还能高亮显示各个文本片段的得分。
方法概述
我们将构建一个与 Pangram 模型类似的检测方法。就笔者所知,Pangram 模型正是 Substack 平台上 AI 检测功能背后的技术。