
AI大模型实战-经典算法之RNN:开发人员绕不开的循环神经网络
 (我:更新这些内容,随着对AI相关工作的深入,越来越觉得技术更迭的速度已经超乎人的想象,我相信很多人即使自己已经深入了很多AI技能相关知识,但总会遇到让自己眼前一亮的关于这个技术/行业更富有诗意或更富想象力的产品/应用/作品,可以说在AI时代这个开始的前几年,大把大把的创造力想象力思维聚集在了AI周围,随着AI发展地深入,也总归会有大浪淘沙的时候吧,比如有些应用,虽然在此时是不错的,比如最早的小龙虾,虽然当时火了一阵子,但是之后包括QClaw或现在的Deepseek-harness等等也都逐渐在能力上体现出优势,而除非有特别大的让技术人佩服的改变,否则也会泯然众人)在前面的引文部分,我们跟着花名叫“独行”的这位来自阿里的分享者,认识了几种模型的使用方式和微调思路,(我:即使没有相关地继续深入,也没有关系,因为人的学习是有惰性的,直到某个时刻,在前面的坚持下,总会看到你希望看到的技术学习的实现)而上一讲里,作者重点讲的是神经网络。神经网络的种类不少,常见的有前馈神经网络(FNN)、卷积神经网络(CNN)、循环神经网络(RNN)、图神经网络(GNN),以及带自注意力机制的 Transformer 等。
FNN(前馈神经网络)- 针对彼此独立的向量、层间全连接。它是最简单的一种结构,数据只朝一个方向流动:从输入层经隐藏层到达输出层,相邻层之间彼此全连接,既没有回路也没有反馈。这类网络默认各输入样本互不相关,因此更适合表格型数据以及较简单的分类、回归任务;不足之处是参数规模偏大,也难以刻画空间或时间上的结构。
CNN(卷积神经网络)- 面向网格型数据,采用局部卷积并共享权重。专为网格状数据而生,典型的如图像(二维网格)或音频频谱(一维/二维)。其关键在于让卷积核在输入上滑动,借助局部感受野与权重共享,高效捕捉边缘、纹理这类局部特征,再通过多层堆叠得到全局语义。常见网络有 ResNet、VGG,后来也被搬到文本分类里(TextCNN)。
RNN(循环神经网络)- 面向序列数据,靠循环连接实现时间上的记忆。专为序列数据而设计,比如文本、语音、时间序列等。它在各个时间步之间传递隐藏状态,从而让网络拥有“记忆”。不过最初的 RNN 会遇到梯度消失或爆炸,难以抓住长距离依赖;后来的 LSTM、GRU 借助门控机制缓解了这个毛病。常用于机器翻译、语音识别。
GNN(图神经网络)- 面向图数据,通过聚合邻居、传递消息来工作。专为图结构数据而设计,例如社交网络、分子结构或知识图谱。它依靠消息传递,让每个节点吸收相邻节点的信息来刷新自身表示,进而捕捉图上的拓扑关系。代表模型有 GCN、GAT、GraphSAGE。
在真实项目里,这些网络常常混搭使用,例如用 CNN + RNN 生成视频描述、用 GNN + RNN 做分子生成。本节课的重点是 RNN,它擅长处理序列数据。那为什么还要专门学它?其实,如今主流的大语言模型基本都建立在 Transformer 之上,但透过 RNN,我们能弄清神经网络是怎样处理序列中的依赖、记住历史信息并据此做出预测的,尤其是梯度消失、梯度爆炸这几个核心难点,这些都会为之后理解 Transformer 打好基础。
循环神经网络循环神经网络(RNN)是专门用来应对序列数据的一类网络。和传统前馈网络不同,它可以处理长度不固定的序列,比如文本或语音。RNN 的关键之处在于网络里加入了循环,使其能够维持某种“状态”,因此在序列任务上往往表现得更好。
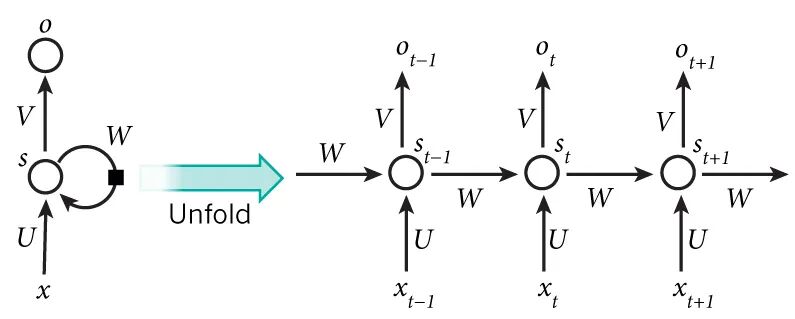
如上图所示,左侧勾勒了 RNN 的基本原理,(我:看起来像之前大概学过的编译原理课程中的有限状态自动机类似这种,一般W应该是指这是在这个节点进行自身调用),其中 x 表示输入层、o 表示输出层,中间的 s 是隐藏层,循环就发生在 s 上;右边则是把这个循环按时间展开后的样子,本质上是一个随时间 t 变化的状态过程。换句话说,网络在处理数据时能同时“看到”前一时刻和后一时刻的状态,也就是我们平时说的上下文。(我:右侧的x,o,s编号可以看到,中间的是正常表示t,前后都是-1以及+1,如果在代码或者数据结构中实现,也应该都是通过索引的方式,根据顺序索引或者类似链表的前节点后节点记录,但实际实现未知)举个例子,和朋友或爱人一起看完一场汽车发布会,对方说“想买个十来万或几十万的那个”,你一定明白 TA 指的是车,而不是别的,因为你掌握了上下文——你们本就在发布会现场。换成模型,它又该如何准确领会我们的话呢?道理是一样的,同样得依赖上下文。而 RNN 的隐藏层带有时序状态,推理时正好能借助上下文,把语义理解得更到位。
基本结构与原理
RNN 的核心是隐藏层,而隐藏层要解决的关键问题,就是隐藏状态如何随时间不断更新,其计算公式如下:
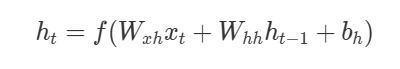
(我:我感觉现在学点东西,一时间学不懂某部分真的没关系,比如上面公式)式子中,ht 为当前时间步的隐藏状态,xt 是这一步的输入,ht-1 则是上一时间步的隐藏状态;Wxh、Whh 为权重矩阵,bh 是偏置项,f 表示激活函数——这里我们选用的是 tanh。
要读懂 RNN,“时间步”是个绕不开的概念。说白了,时间步就是序列中元素的位置索引,RNN 会按时间步一个接一个地处理序列,每走一步就更新一次内部状态。
直观理解
比如给出句子“我 爱 学习”,RNN 的处理过程大致如下:
时间步 t=1: 输入"我"   → 更新隐藏状态 h1

时间步 t=2: 输入"爱"   → 更新隐藏状态 h2

时间步 t=3: 输入"学习" → 更新隐藏状态 h3
每个时间步处理一个(或一批)元素,同时把上一步的隐藏状态传进来。所以“时间步”不一定指真实时间,而是序列中的顺序位置。
核心公式
标准 RNN 在每个时间步 t 做两件事:
h_t = tanh(W_xh · x_t + W_hh · h_{t-1} + b_h)

# 更新隐藏状态

y_t = W_hy · h_t + b_y

# 计算该步输出x_t:当前时间步的输入h_{t-1}:上一时间步的隐藏状态(记忆)h_t:当前隐藏状态,会传给下一步y_t:当前步的输出(可选,取决于任务)
关键点:同一组权重W_xh、W_hh、W_hy在所有时间步共享,这正是 RNN 能处理变长序列的原因。
时间步与任务类型
不同任务对时间步输出的使用方式不同:
| 任务类型 | 输入 | 输出 | 例子 |
|---|---|---|---|
| 多对一 | 整个序列 | 只用最后一步 | 情感分类 |
| 一对多 | 单个输入 | 多个时间步 | 图像描述生成 |
| 多对多(同步) | 每步输入 | 每步输出 | 词性标注 |
| 多对多(异步) | 整个序列 | 另一序列 | 机器翻译(编码器-解码器) |
时间步带来的问题
1. 长序列训练慢时间步必须串行计算,h_t 依赖 h_{t-1},无法像 CNN 那样并行。序列越长,训练越慢。
2. 梯度消失/爆炸反向传播要沿时间步展开(BPTT),梯度连乘很多次。距离远的时间步之间,梯度要么趋近 0(学不到长依赖),要么爆炸。LSTM/GRU 的门控机制就是为此设计的。
3. 时间步长度不一致实际中序列长度不同,需要 padding 到统一长度,并用 mask 忽略填充部分,否则会影响损失和梯度。
和 Transformer 的对比
Transformer 用自注意力替代了循环结构,所有时间步可以并行计算,且任意两个位置之间的路径长度都是 1,更容易捕捉长依赖。这是它取代 RNN 成为序列建模主流的重要原因。不过 RNN 在流式、低资源场景下仍有价值。
再看一个例子:设想有这样一个文本序列任务,要根据已经出现的字符去预测下一个字符.为简化起见,假设字符集里只有三个字符——“A”、“B”、“C”,任务是在给定序列“AB”之后猜出下一个字符.第一步是在输入层把字符变成数值,比如用 One-hot 编码,“A”=[1,0,0],“B”=[0,1,0],“C”=[0,0,1],于是序列“AB”就对应两个向量:[1,0,0] 和 [0,1,0].第二步进入隐藏层,这里假设只放一个隐藏单元(真实场景中可能有很多个),激活函数取 tanh.时间步 1——处理 A:1. 输入:[1,0,0](我:我觉得这块内容,可能对数据结构有了解的就比较方便理解,就是一个一维数组的占位,结合最近的回顾编码的感悟,我觉得让AI生成一些学习方向的demo,去跑,去运行,调试,然后查看每一步代码做了什么,省去了以往查各种博客或者书籍专门找这一个小问题的地方,也是挺方便的)2. 令 Wxh 与 Whh 都等于 1,初始隐藏状态 h0=0.3. 于是新的隐藏状态 h1=tanh(1*[1,0,0]+1*0)=tanh(1)≈0.76.时间步 2——处理 B:1. 输入:[0,1,0]2. 沿用上一时间步的隐藏状态 h1≈0.76.3. 算得新的隐藏状态 h2=tanh(1*[0,1,0]+1*0.76)=tanh(0.76)≈0.64.可以看到,在这个简化例子里,每一步的隐藏状态 ht 都由当前输入 xt 和上一步的隐藏状态 ht-1 共同决定.正是靠这种方式,RNN 把之前读到的输入(这里是字符 A 和 B)记在心里,再用这些信息去影响后面的处理,例如预测序列的下一个字符——模型也就因此有了记忆能力.
知识卡片
√ One-hot 编码(独热编码)它是将类别、ID 型特征转换成数值向量的一种最典型的编码方式。它通过把所有其他维度置为 0,单独将当前类别或者 ID 对应的维度置为 1 的方式生成特征向量。
这怎么理解呢?我们举例来说,假设某样本有三个特征,分别是星期、性别和城市,我们用 [Weekday=Tuesday, Gender=Male, City=London] 来表示,用 One-hot 编码对其进行数值化的结果。
- Weekday=Tuesday:
[0,1,0,0,0,0,0] - Gender=Male:
[0,1] - City=London:
[0,0,1,0,...,0,0]
从图中我们可以看到,Weekday 这个特征域有 7 个维度,Tuesday 对应第 2 个维度,所以我把对应维度置为 1。而 Gender 分为 Male 和 Female,所以对应的 One-hot 编码就有两个维度,City 特征域同理。
√ tanh 函数一个在数学和计算机科学中经常使用的函数,全名是“双曲正切函数”。tanh 函数接受一个实数作为输入,然后输出一个介于 -1 和 1 之间的数。
这个函数有一个特点,就是当输入的数字接近 0 时,输出的数字也接近 0;当输入的数字变得很大(无论是正数还是负数)时,输出的数字会接近 1 或 -1。具体来说,当输入是正无穷大时,输出是 1;当输入是负无穷大时,输出是 -1。
tanh 函数在神经网络和机器学习中很有用,可以帮助我们处理一些复杂的模式和数据。通过调整神经网络的权重和偏置,tanh 函数可以帮助我们更好地理解和预测数据。总的来说,tanh 函数就像一个“压缩器”,把输入的实数压缩到 -1 和 1 之间。这种压缩可以帮助我们更好地处理和分析数据。
这里作者引用了其他文章
https://time.geekbang.org/column/article/295300
关键挑战
RNN通过当前的隐藏状态来记住序列中之前的信息.这种记忆一般是短期的,因为随着时间步的增加,早期输入对当前状态的影响会逐渐减弱,在标准RNN中,尤其当遇到梯度消失情况时,就会遇到短期记忆的问题,几乎无法更新权重.
梯度消失
我们先看下什么是梯度?梯度就是指函数在某一点的斜率,在深度学习中,该函数一般指具有多个变量的损失函数,变量就是模型的权重.损失函数衡量的是模型预测与实际数据之间的差异,一般情况下,我们要尽可能地让损失函数的值最小.如何找到这个最小值呢?需要进行梯度下降,也就是说,我们要不断调整参数(权重),使损失函数的值降到最小,这个过程就是梯度下降.
为什么会产生梯度消失呢?一般有两个原因.
1. 深层网络中的连乘效应:在深层网络中,梯度是通过链式法则进行反向传播的.如果每一层的梯度都小于1,那么随着层数的增加,这些小于1的值会连乘在一起,导致最终的梯度非常小.
2. 激活函数的选择: 使用某些激活函数,如tanh,函数的取值范围是-1~1,小于1的数进行连乘,也会快速降低梯度值.
这里作者详细解释反向传播:
在深度学习中,训练神经网络涉及两个主要的传播阶段:前向传播和反向传播.在前向传播阶段,输入数据从网络的输入层开始,逐层向前传递至输出层.每一层都会对其输入进行计算,如加权求和,然后应用激活函数等,并将计算结果传递给下一层,直到最终产出输出.(我:刚从一些游戏视频动画短视频流转过来,话说上个词打到输出,这里刚好想起一件事,之前有看过一位硕士朋友圈,也从其他书籍中验证过,就是要多输出,而不是一味地纳入,比如我刚才刷短视频,就不如去做短视频,学习新技术上有时是往往输出大于输入的效果,因为要想输出合理的内容,如博客,技术文章,不知不觉中就会输入很多内容,而且不觉枯燥,因为已经想好了该怎样输出,而不是漫无目的地输入)这个过程的目标是根据当前的网络参数,权重和偏置等得到预测输出.
一旦在输出层得到预测输出,就会计算损失函数,即预测输出与实际目标输出之间的差异.接下来,这个损失会被用来计算损失函数相对于网络中每个参数的梯度,这是通过链式法则实现的.这个计算过程从输出层开始,沿着网络向后,即向输入层的方向,逐层进行,这就是"反向传播"的由来.
这些梯度表示了为了减少损失,各个参数需要如何调整.最后,这些梯度会用来更新网络的参数,通常是通过梯度下降或其变体算法实现.而在反向传播过程中,每到达一层,都会触发激活函数,这就是上面说的2点原因.
由此可见,如果要解决梯度消失的问题,我们就从这两个原因入手.
1.长短期记忆(LSTM)
https://time.geekbang.org/course/detail/100077201-420627
和门控循环单元(GRU)
https://time.geekbang.org/course/detail/100077201-418603
是专门为了避免梯度消失问题而设计的.它们通过引入门控机制来调节信息的流动,保留长期依赖信息,从而避免梯度在反向传播过程中消失.
2.使用ReLU及其变体激活函数,在正区间内的梯度保持恒定,不会随着输入的增加而减少到0,这有助于减轻梯度消失问题.
梯度爆炸
与梯度消失相对的问题是梯度爆炸,当模型的梯度在反向传播过程中变得非常大,以至于更新后的权重偏离了最优值,导致模型无法收敛,甚至发散.
通常梯度爆炸发生原因有三个.
1.深层网络的连乘效应:在深层网络中,梯度是通过链式法则进行反向传播的.如果每一层的梯度都大于1,那么随着层数的增加,这些大于1的值会连乘在一起,导致最终的梯度非常大.
2.权重初始化不当:如果网络的权重初始化得太大,那么在前向传播过程中信号的大小会迅速增加,同样,反向传播时梯度也会迅速增加.
3.使用不恰当的激活函数: 某些激活函数(如ReLU)在正区间的梯度为常数.如果网络架构设计不当,使用这些激活函数也可能导致梯度爆炸.
梯度爆炸和梯度消失基本相反,解决方法一样,要么使用长短期记忆和门控循环单元调整网络结构,要么替换激活函数,还有一种办法就是进行梯度裁剪,梯度裁剪意思是在训练过程中,通过限制梯度的最小/大值来防止梯度消失/爆炸,间接地保持梯度地稳定性.
长短期记忆(LSTM)
无论是梯度消失还是梯度爆炸,都提到长短期记忆结构,简单看一下,LSTM就像是具有类似大脑记忆功能的模型,它在处理数据,如文本,时间序列数据时,能够记住当前任务重要信息,并忘记不重要的信息.这是通过以下几个关键机制实现的.
1.遗忘门(Forget Gate): 决定了哪些信息是过时的,不重要的,因此应该从模型的记忆中抛弃.就像你在阅读时可能忘记某个次要角色的不重要的细节.
2.输入门(Input Gate): 它决定哪些新的信息是重要的,应该被添加到模型的记忆中.这就像你在阅读新章节时,发现关于男主人公重要的新信息并记住它们.
3.输出门(Output Gate): 它决定了在当前时刻,哪些记忆是相关的,应该被用来生成输出.这就像你在思考男主人公的动机和行为时,会回想起之前关于他的重要记忆.
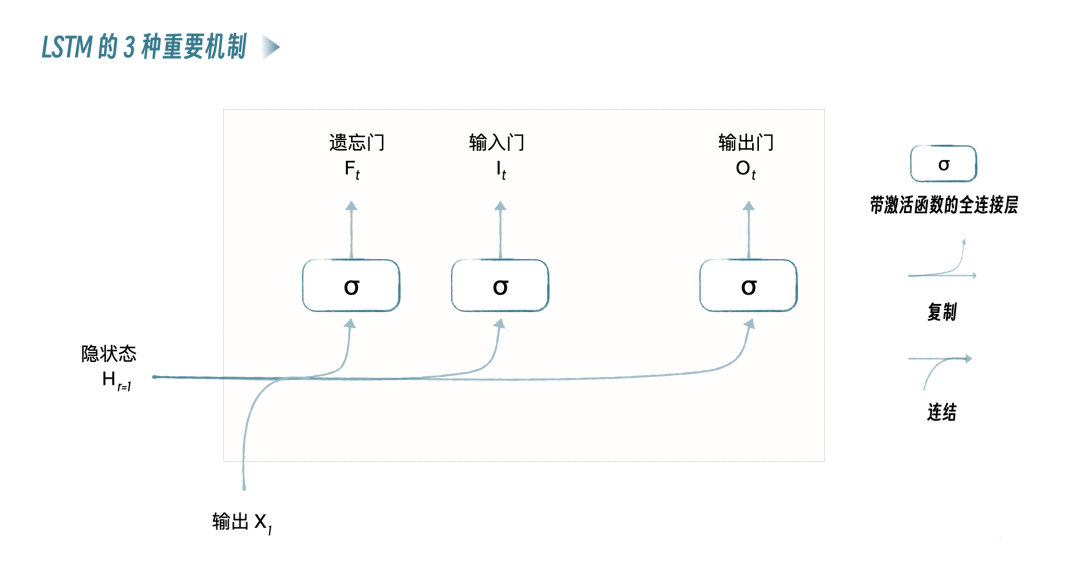
通过这些机制,LSTM能够在处理序列数据时,有效地保留长期的依赖信息,就像是记住故事中的关键情节和角色,同时避免了标准RNN中常见的梯度消失问题.这使得LSTM特别适用于需要理解整个序列背景的任务,比如语言翻译,需要理解整个句子含义,或者股票价格预测,需要考虑长期的价格变化趋势.
RNN实际应用场景
文本生成
文本生成是RNN的一个典型应用,通过学习大量的文本数据,RNN能够生成具有相似风格的文本,我们看一段简单的文本生成模型的代码示例.
import torch
import torch.nn as nn
import torch.optim as optim
from torch.nn.utils.rnn import pad_sequence
from torch.utils.data import DataLoader, Dataset

# 数据预处理
text = "Here is some sample text to demonstrate text generation with RNN. This is a simple example."
tokens = text.lower().split()
tokenizer = {word: i + 1 for i, word in enumerate(set(tokens))}
total_words = len(tokenizer) + 1

# 创建输入序列
sequences = []
for line in text.split('.'):
    token_list = [tokenizer[word] for word in line.lower().split() if word in tokenizer]
    for i in range(1, len(token_list)):
        n_gram_sequence = token_list[:i + 1]
        sequences.append(n_gram_sequence)
max_sequence_len = max([len(x) for x in sequences])
sequences = [torch.tensor(seq) for seq in sequences]
sequences = pad_sequence(sequences, batch_first=True, padding_value=0)

class TextDataset(Dataset):
    def __init__(self, sequences):
        self.x = sequences[:, :-1]
        self.y = sequences[:, -1]
    def __len__(self):
        return len(self.x)
    def __getitem__(self, idx):
        return self.x[idx], self.y[idx]

dataset = TextDataset(sequences)
dataloader = DataLoader(dataset, batch_size=2, shuffle=True)

# 构建模型
class RNNModel(nn.Module):
    def __init__(self, vocab_size, embed_size, hidden_size):
        super(RNNModel, self).__init__()
        self.embedding = nn.Embedding(vocab_size, embed_size)
        self.lstm = nn.LSTM(embed_size, hidden_size, batch_first=True)
        self.fc = nn.Linear(hidden_size, vocab_size)
    def forward(self, x):
        x = self.embedding(x)
        x, _ = self.lstm(x)
        x = self.fc(x[:, -1, :])
        return x

model = RNNModel(total_words, 64, 20)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 模型训练
for epoch in range(100):
    for x_batch, y_batch in dataloader:
        optimizer.zero_grad()
        output = model(x_batch)
        loss = criterion(output, y_batch)
        loss.backward()
        optimizer.step()
    if epoch % 10 == 0:
        print(f'Epoch {epoch + 1}, Loss: {loss.item()}')

# 文本生成
def generate_text(seed_text, next_words, model, max_sequence_len):
    model.eval()
    for _ in range(next_words):
        token_list = [tokenizer[word] for word in seed_text.lower().split() if word in tokenizer]
        token_list = torch.tensor(token_list).unsqueeze(0)
        token_list = nn.functional.pad(token_list, (max_sequence_len - 1 - token_list.size(1), 0), 'constant', 0)
        with torch.no_grad():
            predicted = model(token_list)
            predicted = torch.argmax(predicted, dim=-1).item()
        output_word = ""
        for word, index in tokenizer.items():
            if index == predicted:
                output_word = word
                break
        seed_text += " " + output_word
    return seed_text

print(generate_text("Here is", 4, model, max_sequence_len))
关键步骤作者已经写在代码注释里了。这只是个入门级示例,真正用起来时,你多半得换上更大的文本语料来训练,并对模型结构做些调整,比如加深层数、改动 LSTM 单元个数或超参数,同时配合更精细的数据预处理和文本生成策略,才能得到更理想的效果。
小结
这一讲其实有些难度,我们先借简单的例子弄懂了 RNN 的基本概念,再动手敲代码练了练。RNN 的长处在于记忆能力,它靠隐藏层的循环结构抓住序列里的长期依赖,因而很适合文本生成、语音识别这类场景。当然它也有短板,例如梯度消失和梯度爆炸,而这些问题借助 LSTM 能在一定程度上得到化解。
思考题
既然 LSTM 能解决这么多问题,那为什么当下主流的大语言模型偏偏不采用 RNN 架构呢?欢迎把你的想法写在评论区,我们一起交流;要是觉得这节课对你有帮助,也别忘了分享给身边的朋友,我们下节课见!