如何在廉价硬件上运行大模型?
认证通常是应用中测试最少部分。生产环境需要网络访问和真实凭据,而模拟测试(Mock)往往无法覆盖那些导致线上故障的边缘情况。
@workos/emulate 可在本地运行 WorkOS API,适用于开发和 CI(持续集成)流程。你可以预先注入用户、组织、RBAC 角色和 SSO 连接等数据,然后测试完整的 AuthKit 登录流程、签名 Webhook、Token 刷新以及错误处理机制。响应数据和事件结构均基于 WorkOS OpenAPI 规范,确保测试覆盖与生产环境一致的接口。
设想这样一个场景:一位开发者构建了一个基于 AI 的编码助手,运行在台式机上。模型支持下载,应用逻辑简单,机器存储空间也充足。然而,当程序尝试加载模型时,却报出内存不足的错误。
此时,本地 AI 开发就变成了一道硬件难题。
仅仅把大模型下载到电脑里,并不意味着能真正运行它。即便成功加载,也无法保证拥有可用的响应速度。
大模型要在较低配置硬件上运行,必须降低其占用的内存、减少计算量,或将部分任务转移到速度较慢的硬件上。为此,有几种技术可以应对上述挑战。本文将详细介绍这些技术,内容涵盖:
运行模型究竟意味着什么
为何小硬件难以容纳大模型
为什么值得费力实现本地运行
量化:为每个权重提供更小的表示形式
逐层卸载(Offloading):按需加载权重
混合专家(MoE):为每个 Token 选用特定部分
蒸馏:让大模型教小模型
剪枝:移除贡献较小的部分
投机解码:先预测多个 Token 再验证
运行模型究竟意味着什么
AI 模型中包含一些数值,称为参数(parameters),也叫权重(weights)。它们决定了输入如何变成输出。训练过程中,这些数值会被不断调整,让模型在任务上表现得越来越好。一个 8B 模型大约包含八十亿个参数(权重)。
这些权重按层组织。每一层对接收到的信息进行计算,并把结果传给下一层。
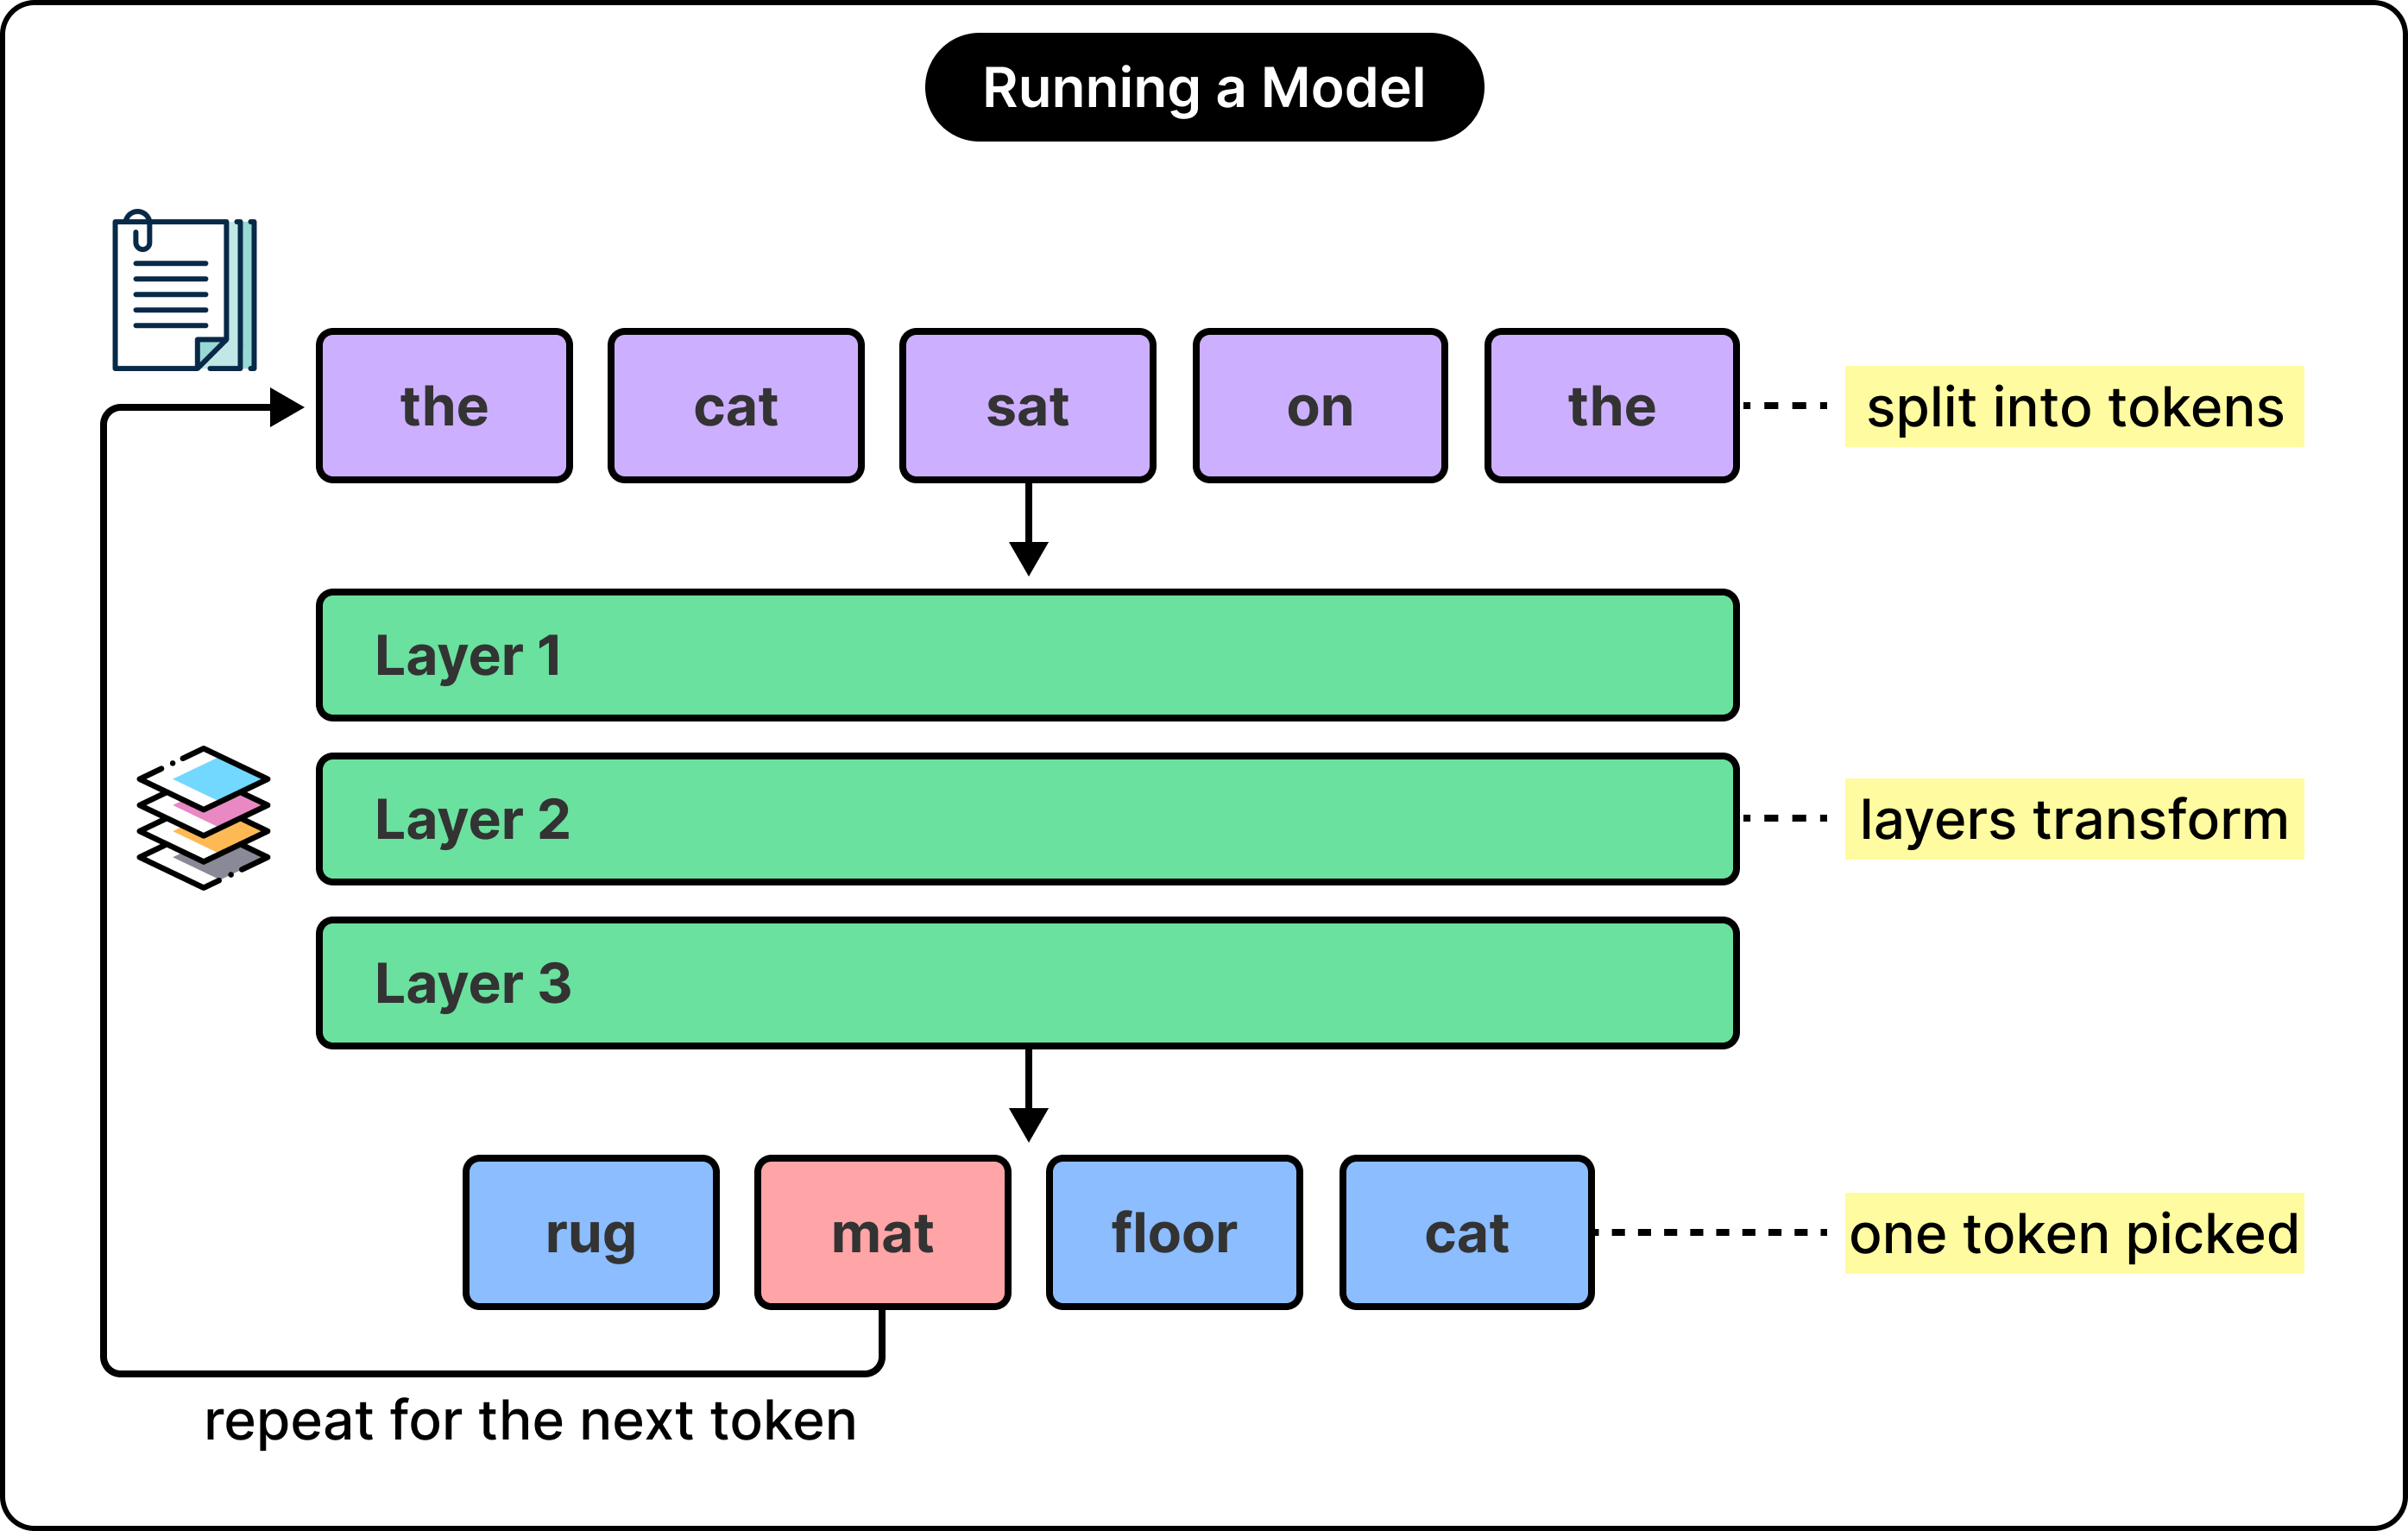
在语言模型中,输入文本首先被切分成 token,token 可以是一个词、词的一部分,甚至是一个标点符号。模型对这些 token 进行处理,输出下一个 token 的概率分布。每选定一个 token 并加入序列后,文本生成就继续进行下去。
生成一个完整的回答,本质上就是不断重复这个过程。
有几点需要记住:
使用已经训练好的模型叫推理(inference)。模型在回答问题时,权重通常保持不变。
训练则需要额外的计算来更新权重,因此开销很大,需要昂贵的基础设施。
这个区别解释了为什么在昂贵基础设施上训练出来的模型,有时可以在普通电脑上运行。本文讨论的重点不是训练,而是模型的推理部分。
[Webinar] 如何不再当 AI Agent 的保姆(赞助内容)
figure中的内容保持不变,图片链接和标签保留,只翻译段落文字:Agent 能够生成代码。但要让代码符合你的系统架构、团队规范和过往技术决策,才是难点所在。这往往导致你在纠错循环中浪费大量时间和 Token。
增加更多的 MCP、规则和更大的上下文窗口,确实能让 Agent 获取到信息,却未必让它真正“理解”这些内容。那些跑在前列的团队,拥有一层上下文抽象层,能够精准地向 Agent 提供当前任务所需的关键信息。
参加 9 月 23 日的免费网络研讨会,你将看到:
团队在 AI 成熟度曲线中容易卡住的环节,以及为什么常规修复手段往往收效有限
上下文抽象层如何同时解决质量、效率和成本问题
现场演示:同一编码任务在有/无上下文抽象层下的对比表现
如果你想最大化 AI Agent 的价值,这场活动值得花时间参加。
为什么在更小硬件上运行模型这么难
模型的每一个参数(权重)都要占用内存。以 16 位存储的数值需要占用 2 个字节。以此类推,仅 80 亿参数的原始权重就需要约 16 GB 内存。此外,临时计算、软件开销以及生成过程中保留的信息还需要额外空间。
内存的存放位置至关重要。计算机的 RAM 是主要的工作内存,而独立显卡拥有独立的 VRAM。一台配备 32 GB RAM 和 8 GB VRAM 的台式机,并不会自动变成一个拥有 40 GB 空间且速度均等的内存池。尽管采用统一内存架构的计算机在处理器之间共享内存,但仍受容量限制。
大容量 SSD 可以容纳模型文件,但执行模型时,数据必须到达处理器。如果频繁地从存储介质中提取权重,速度将远慢于将权重保存在工作内存中。
但无论如何,内存容量只是其中一个限制。神经网络还要执行大量的乘法和加法运算。CPU 虽然也能完成这些计算,但 GPU 在并行处理大量同类数值运算时效率要高得多。不过,GPU 仍需要有足够的内存,并支持模型所用的数值运算。
最后,即使模型装得进内存,处理器也得足够快地读取模型权重和其他信息。
内存带宽衡量的是单位时间内内存与处理器之间能传输多少数据。对于单用户生成文本这类常见负载来说,模型数据的搬运往往成为主要瓶颈。
文本生成与推理分为两个阶段:
预填充(prefill)阶段:模型处理输入的提示词,这一步可以做大量并行计算。
解码(decoding)阶段:模型逐个生成输出 token。
两个阶段的瓶颈可能各不相同。一个模型即使能装进内存,响应速度也可能慢到没法用。
为什么要费劲在本地跑模型?
本地运行可以让现有硬件派上用场,方便做实验,也减少对租用算力的依赖。对于私密文档和专有源代码来说,这一点尤其重要。
离线可用性对桌面助手、远程部署环境,以及无法保证网络稳定的产品来说也很关键。本地运行还能让开发者更好地掌控模型版本和应用行为。
不过,本地运行并不一定在所有场景下都更省钱。
硬件、电费、维护成本和响应速度都要纳入考量。偶尔用一下托管服务可能更划算,而高频使用则更适合本地硬件。具体怎么选,取决于实际应用场景。
接下来介绍几种能帮你在廉价硬件上跑大模型的技术。
量化:用更小的表示来存储每个权重
量化会降低数值表示的精度。举个简化的例子:以 0.1 为步长,数值 0.73 可以近似为 0.7。这种近似会引入误差,但只要误差足够小,应用就能接受。
下图展示了量化的过程:
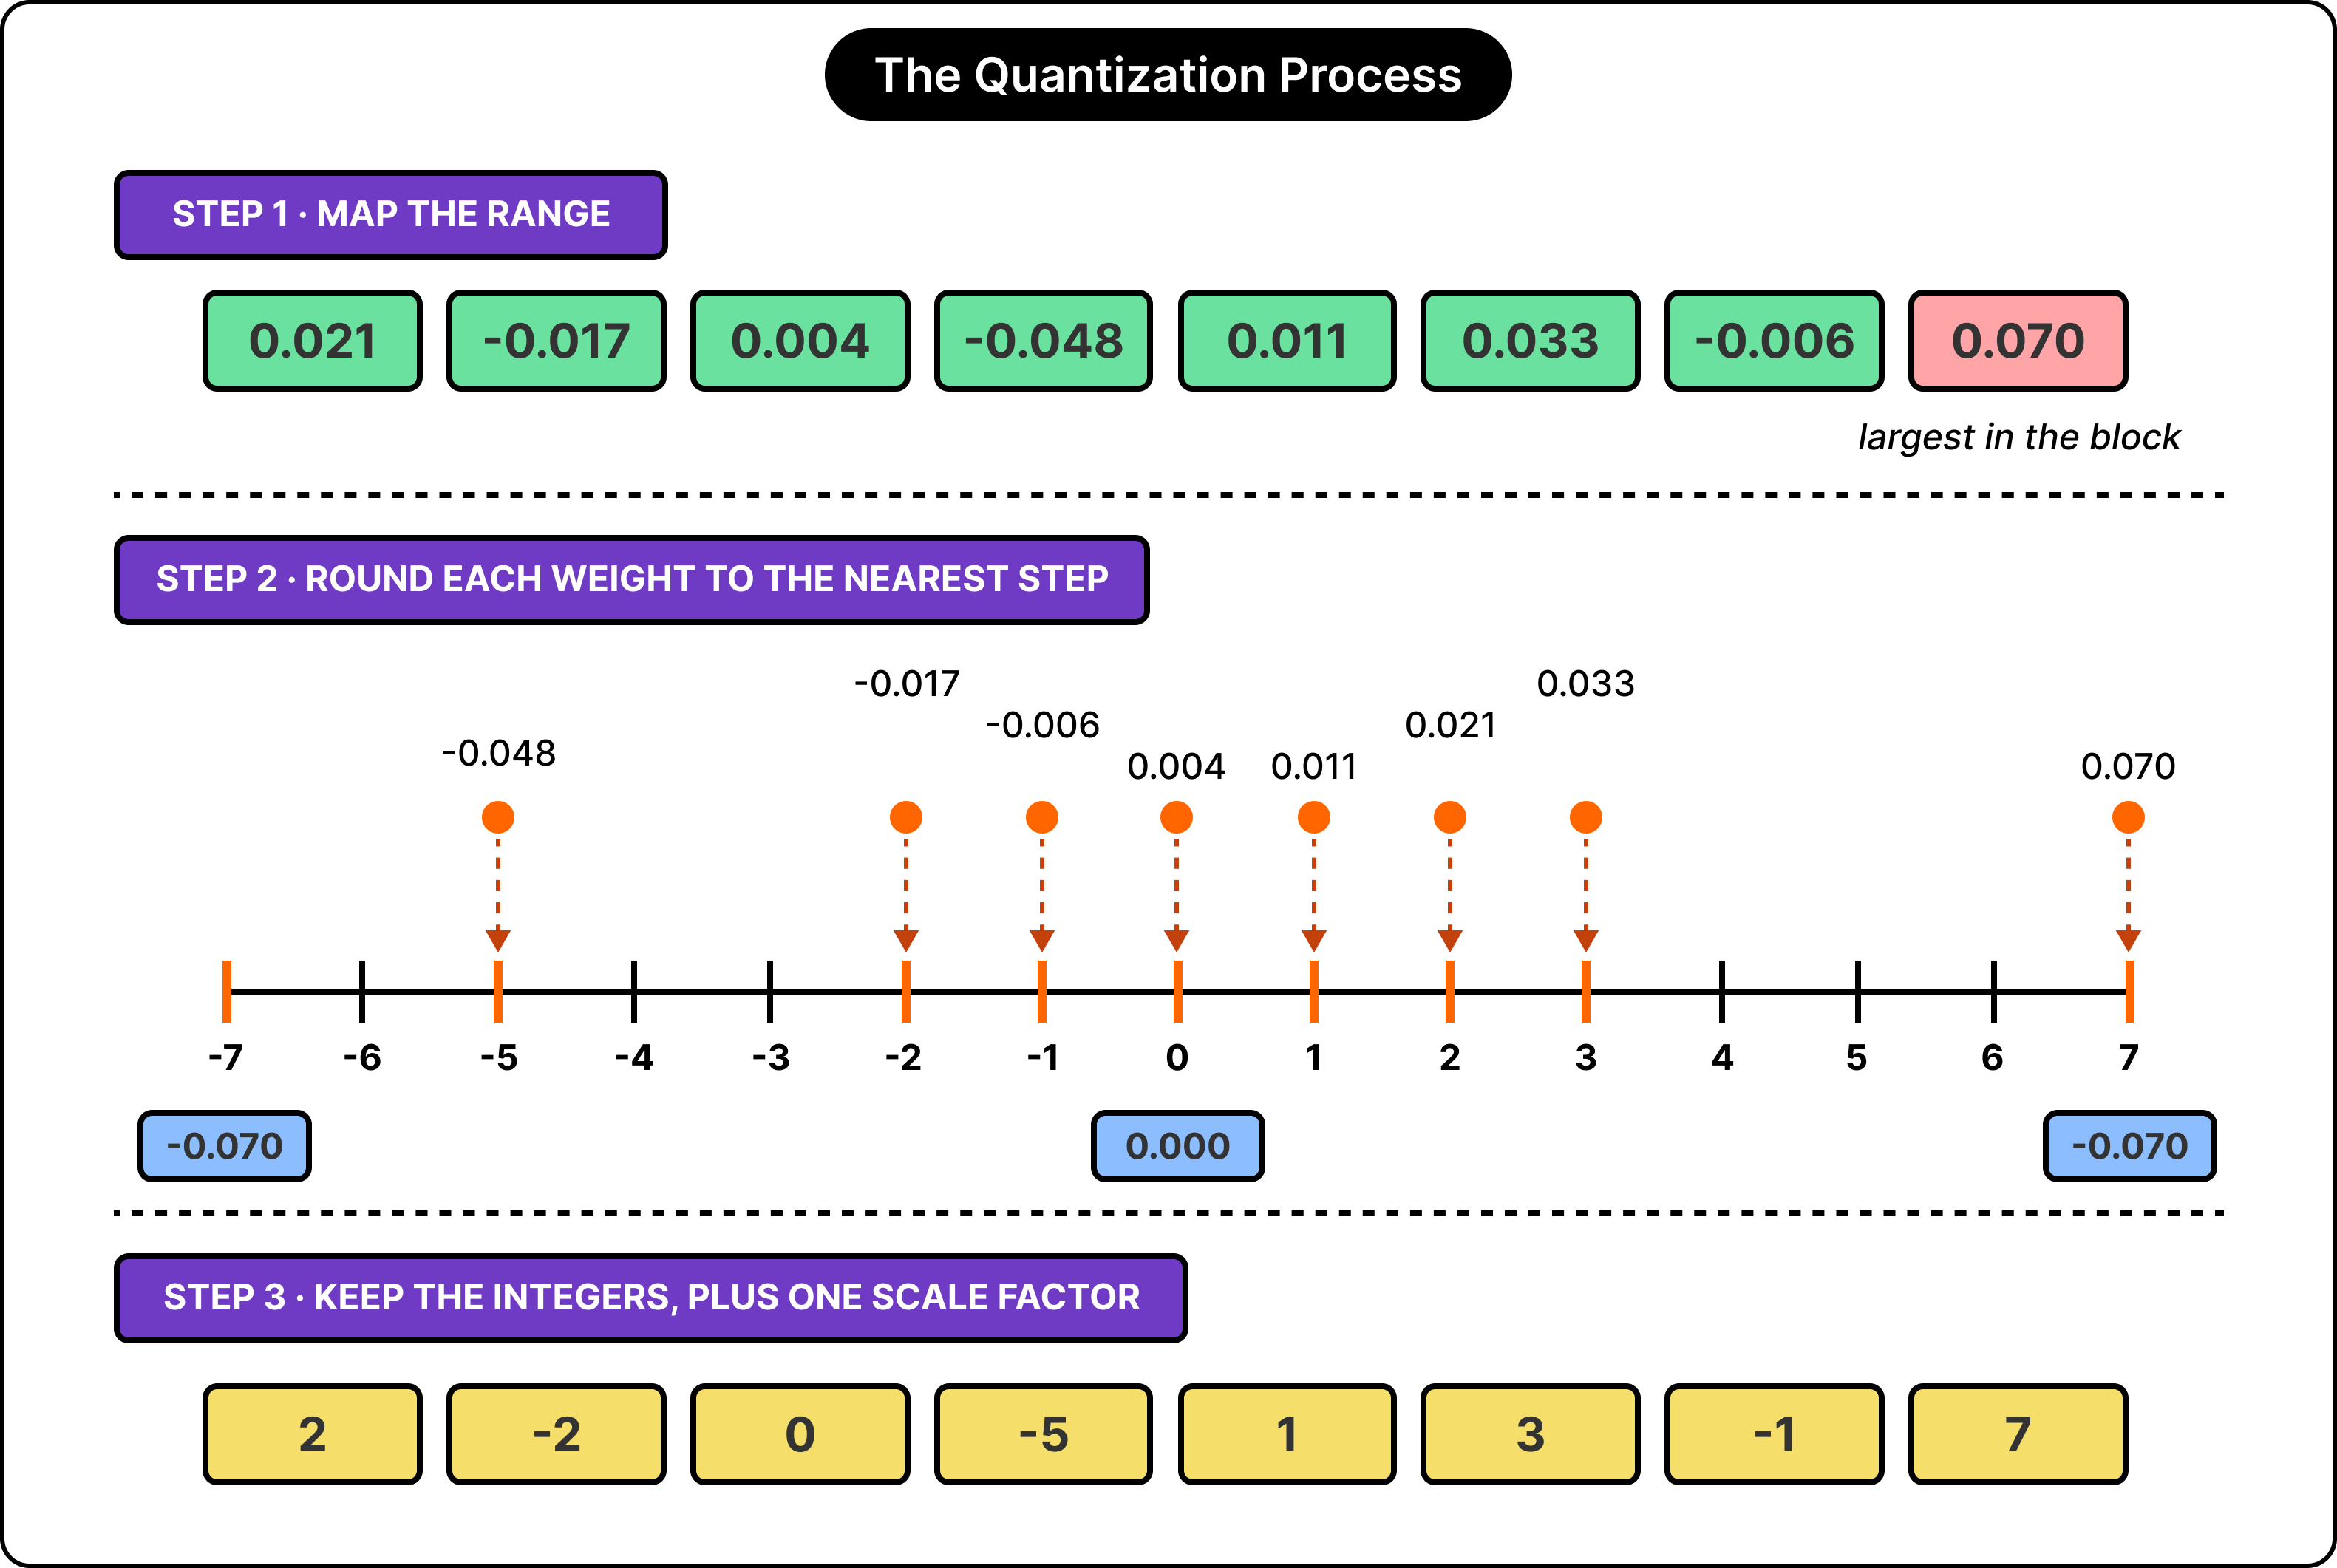
实际方法将权重映射到较小的数值集合中。例如,4 位编码仅有 16 种可能的取值。权重分组可以借助独立的缩放信息,将这些编码映射到合适的数值范围。
潜在的空间节省十分可观。一个 8B 模型,若权重采用 16 位精度需占用 16 GB,而使用 4 位精度时其原始权重体积约为 4 GB。将理论上的权重体积从 16 GB 压缩到 4 GB,可以为其他资源分配腾出空间。模型的参数数量保持不变,但每个参数的存储更加紧凑。
代价可能是回答质量有所下降。具体下降程度取决于模型、压缩方法以及当前任务。在某些配置下,模型虽然能很好地处理日常对话,但在解决特定编程问题时表现可能不够稳定。
降低精度也不意味着性能一定会同比提升。部分实现在存储 4 位权重的同时,仍按更高精度执行计算。运行效率取决于硬件支持情况,以及处理这些转换的软件实现方式。
量化可在训练完成后进行,这被称为训练后量化。但在训练过程中也可考虑量化引入的误差。应用开发者通常从现成的量化版本入手,评估其输出是否满足需求。
逐层卸载:按需调用权重
量化改变的是权重的占用空间。而卸载改变的是权重的驻留位置或计算执行位置。
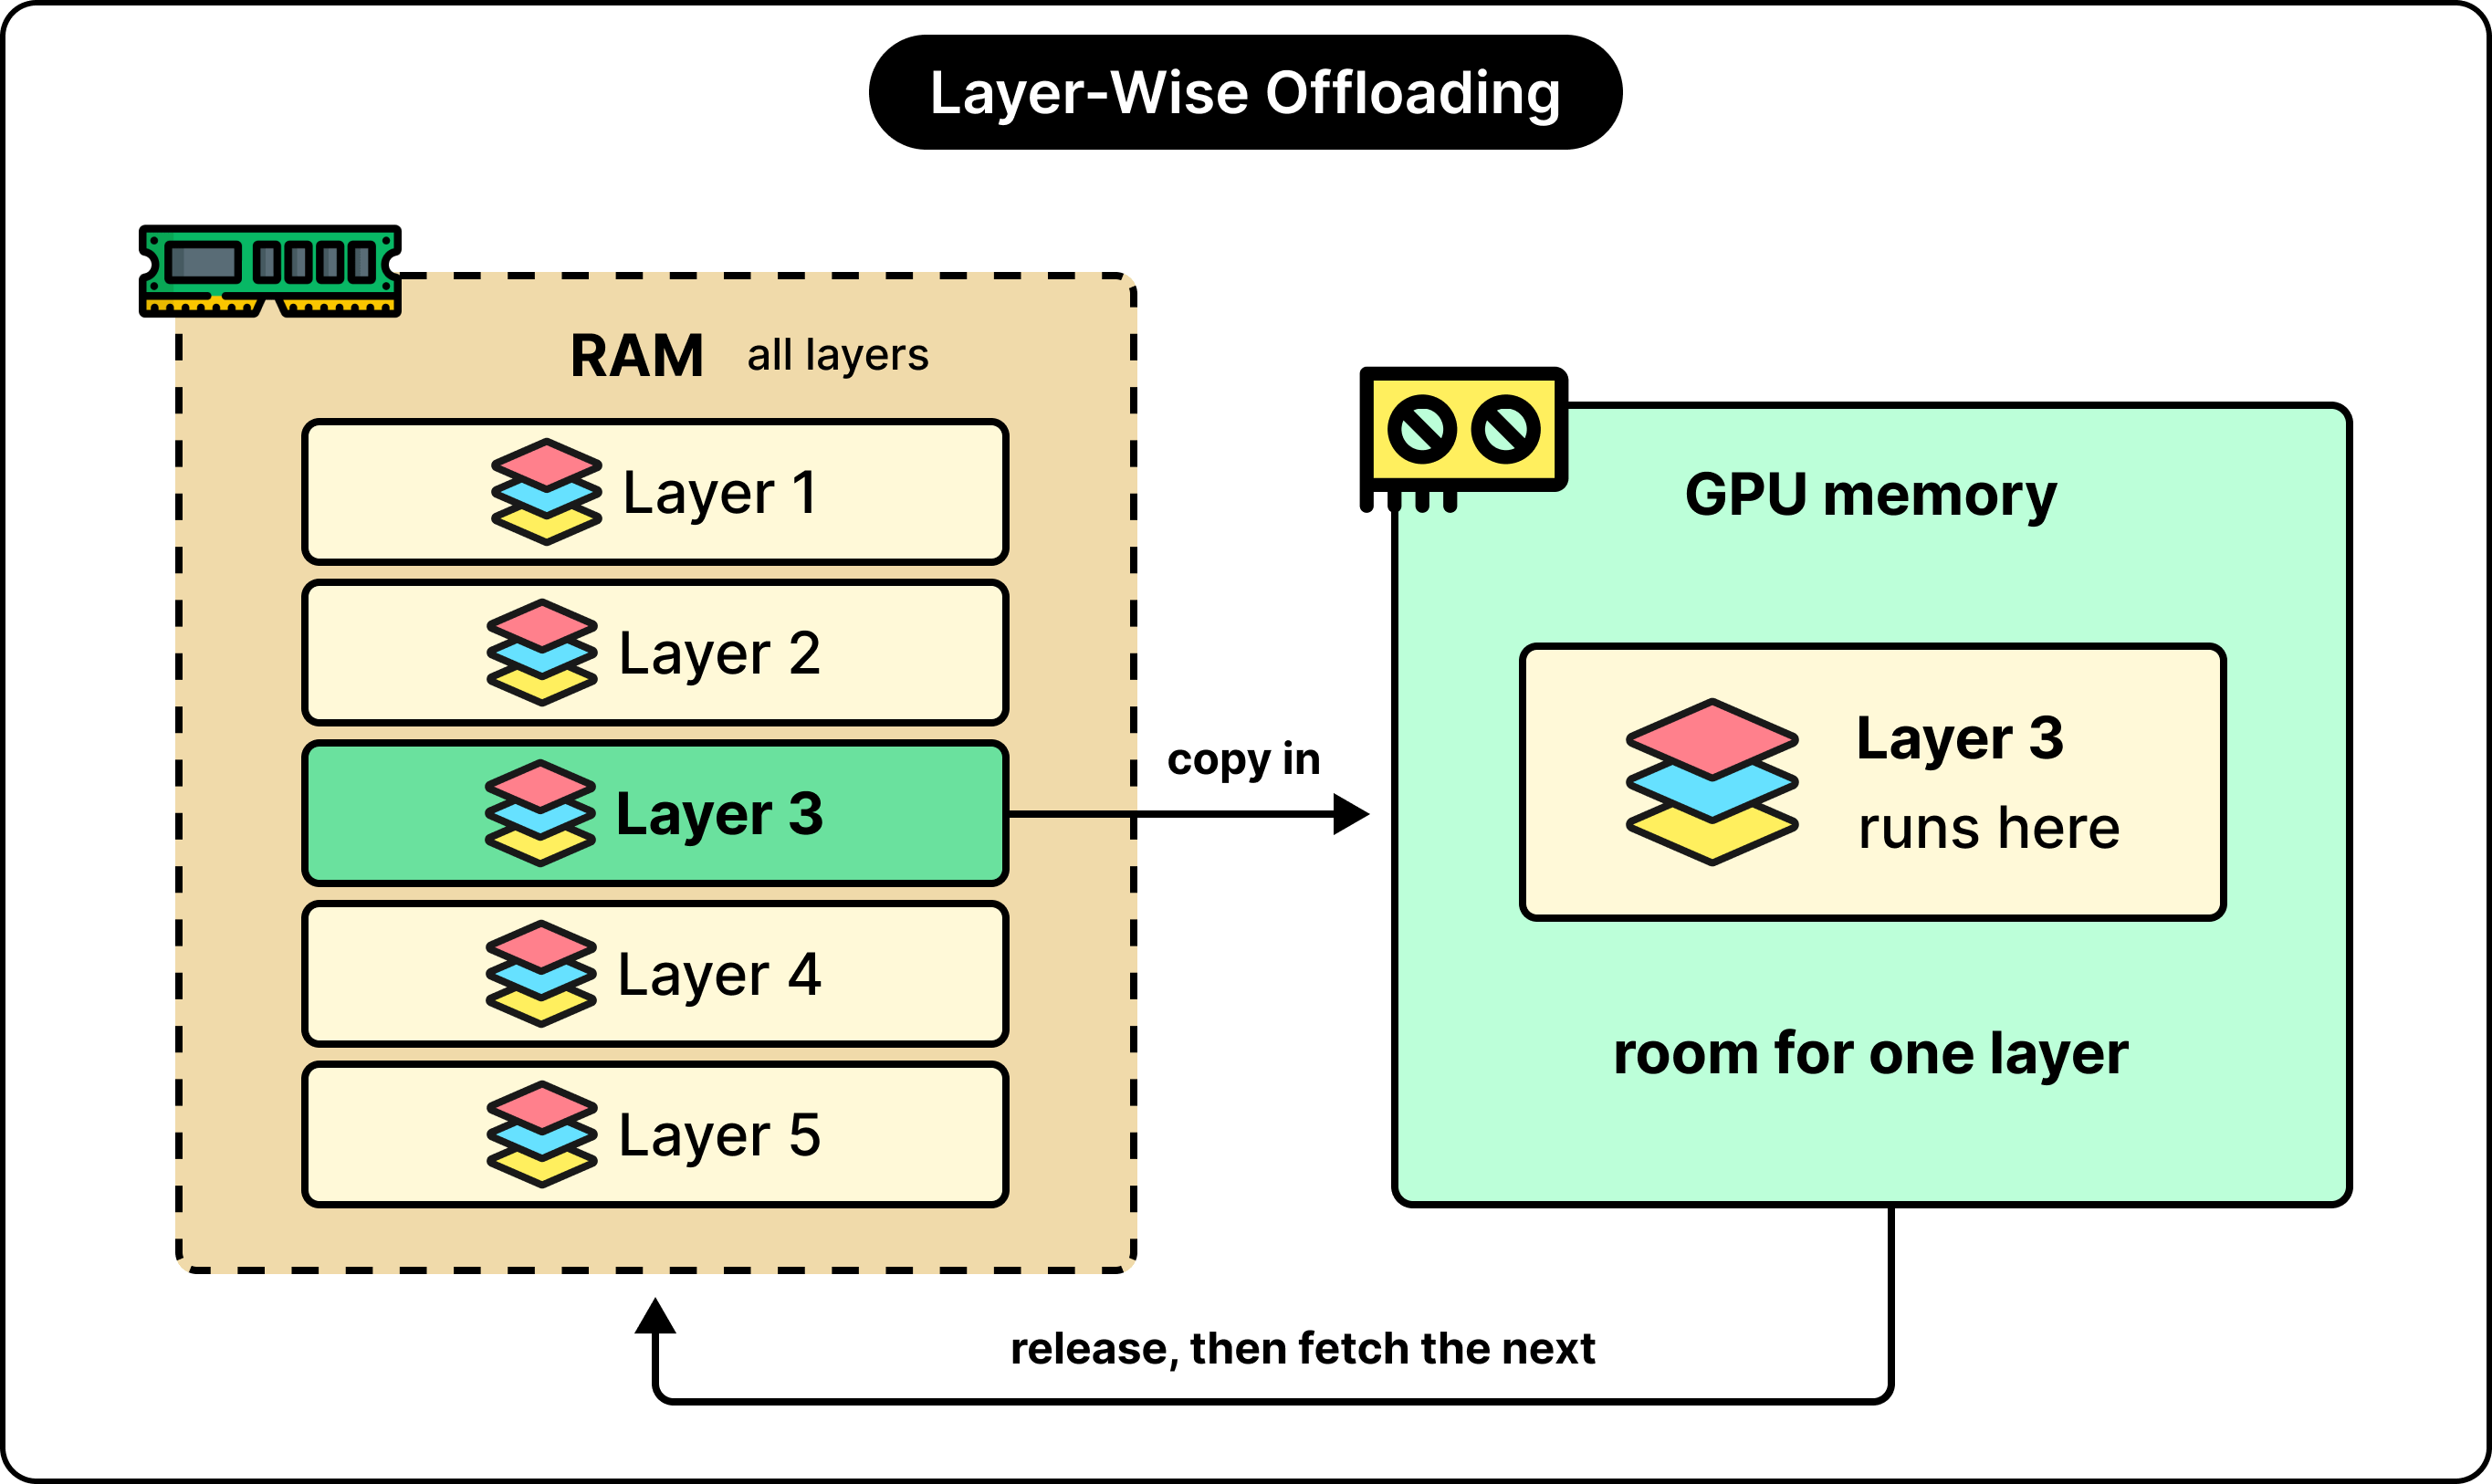
在前向传播过程中,信息在模型各层之间流动。GPU 不需要在同一时刻持有所有层的权重。系统可将大部分权重保留在 RAM 中,将单层权重传输到 GPU 上执行计算,再释放该 GPU 副本以便加载下一层。其他层也可能常驻 GPU。