
RetroChimera:大规模提升小分子合成预测的逆合成模型
概览
- 我们的逆合成模型 RetroChimera 近期发表在《Nature》上。
- 论文详细介绍了模型架构和大量验证实验,包括对罕见反应类型的召回能力,以及在专有数据集上成功的 zero-shot 迁移和微调。
- 我们开源了 RetroChimera 的实现代码和模型权重,希望帮助研究者加速开发新的药用分子和先进材料。
开发新药和新材料都离不开制造新分子,但如何规划合成路线,至今仍主要依靠人工,既耗时又费钱。RetroChimera 可以自动提出高质量的合成路线。它结合了两个优势互补的强模型,并学习如何对二者的方案进行排序,从而得到优于任何单一模型的预测结果。在盲测中,博士级化学家更青睐 RetroChimera 给出的单步反应预测,而非此前模型或文献中记载的反应。
定制分子正在推动现代医学、智能材料和可持续农业的进步。然而,化学合成——在实验室里用简单原料制造新分子的耗时过程——拖慢了这一进程,也是药物研发成本的重要来源。因此,尽管计算方法已经能够大规模探索全新的分子,如何找到切实可行的合成路径,依然是一个关键挑战。
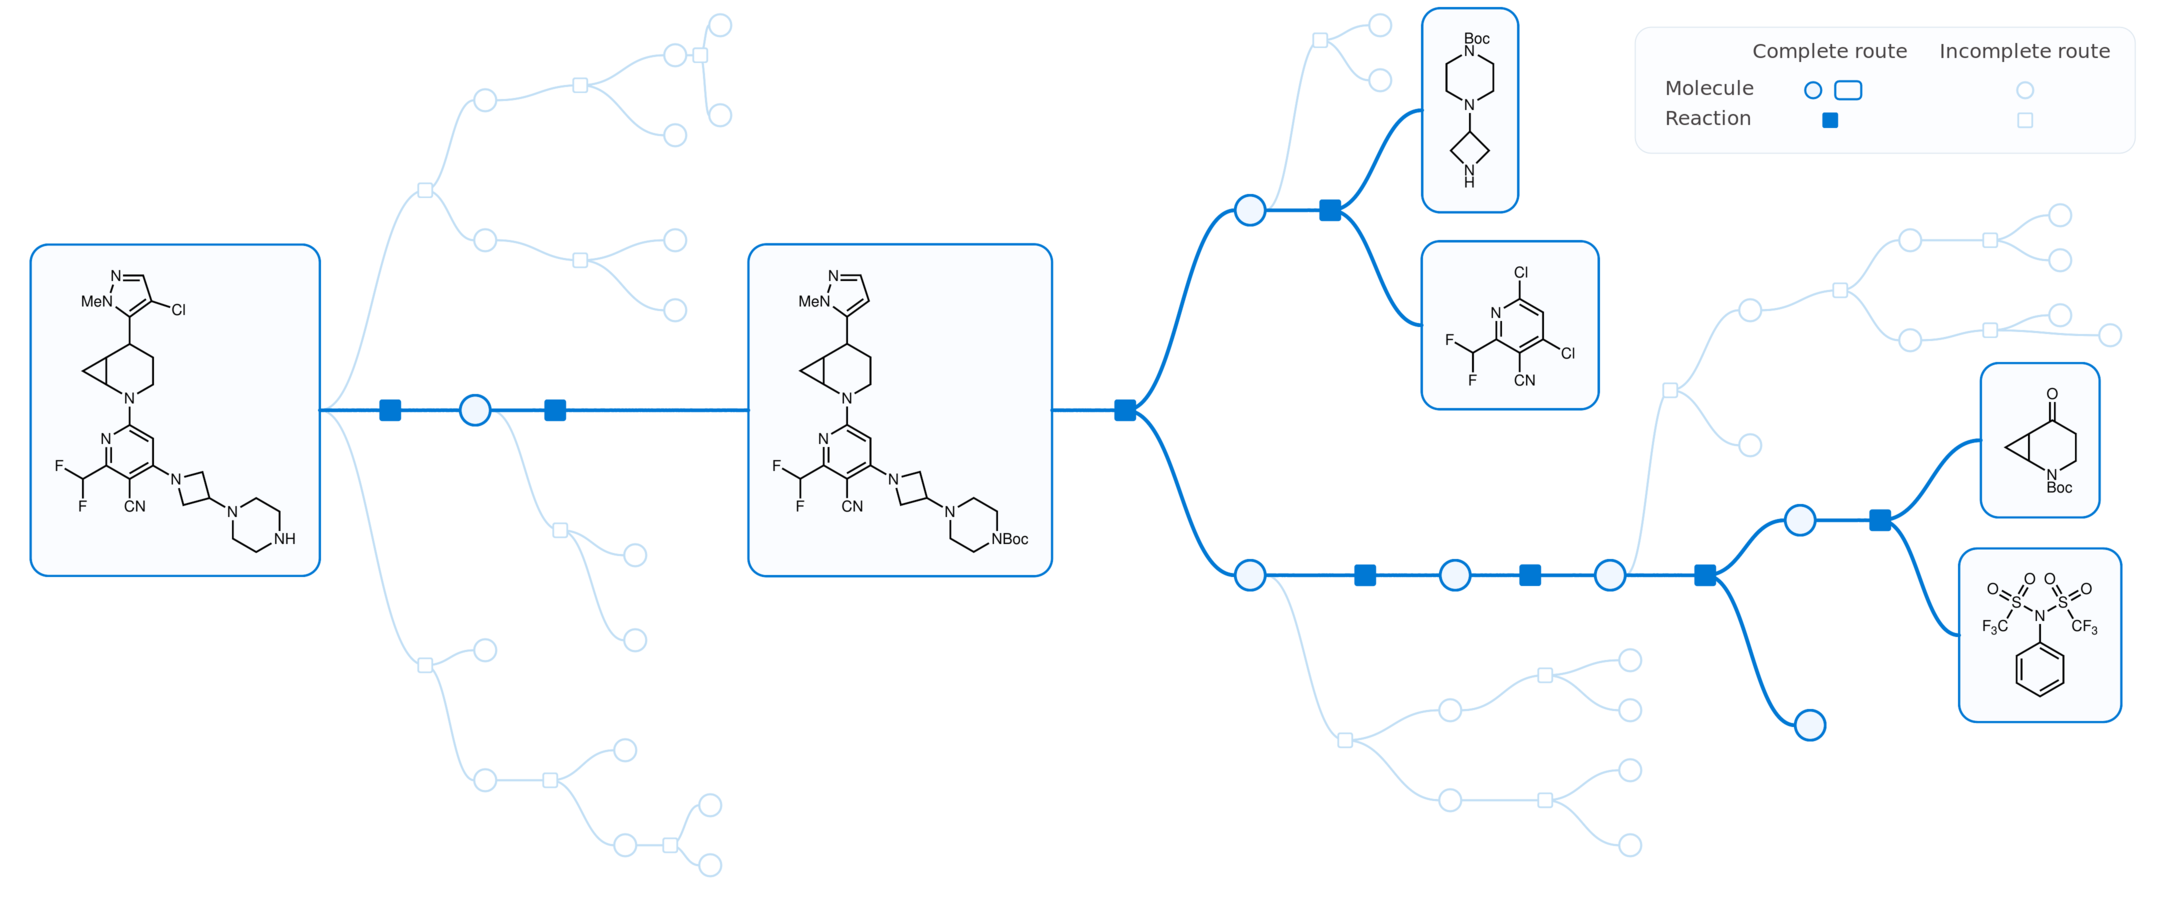
逆合成采用逆向思维,从目标分子出发,将其逐步拆解为更简单的前体(见图 1)。这一过程类似于国际象棋、围棋等策略性棋类游戏。它不仅要求玩家审视大量即时走法(即单个断键),还需具备高阶战略思维以达成端到端的合成规划。然而,逆合成中可能的走法数量远超棋类,且给定分子有哪些可行走法并不直观。现有系统面临重大挑战,包括回忆罕见但对战略至关重要的反应、超出训练分布的鲁棒性,以及与化学家预期的一致性。因此,逆合成通常需要高度专业化的知识,这阻碍了科学发现的规模化与自动化。
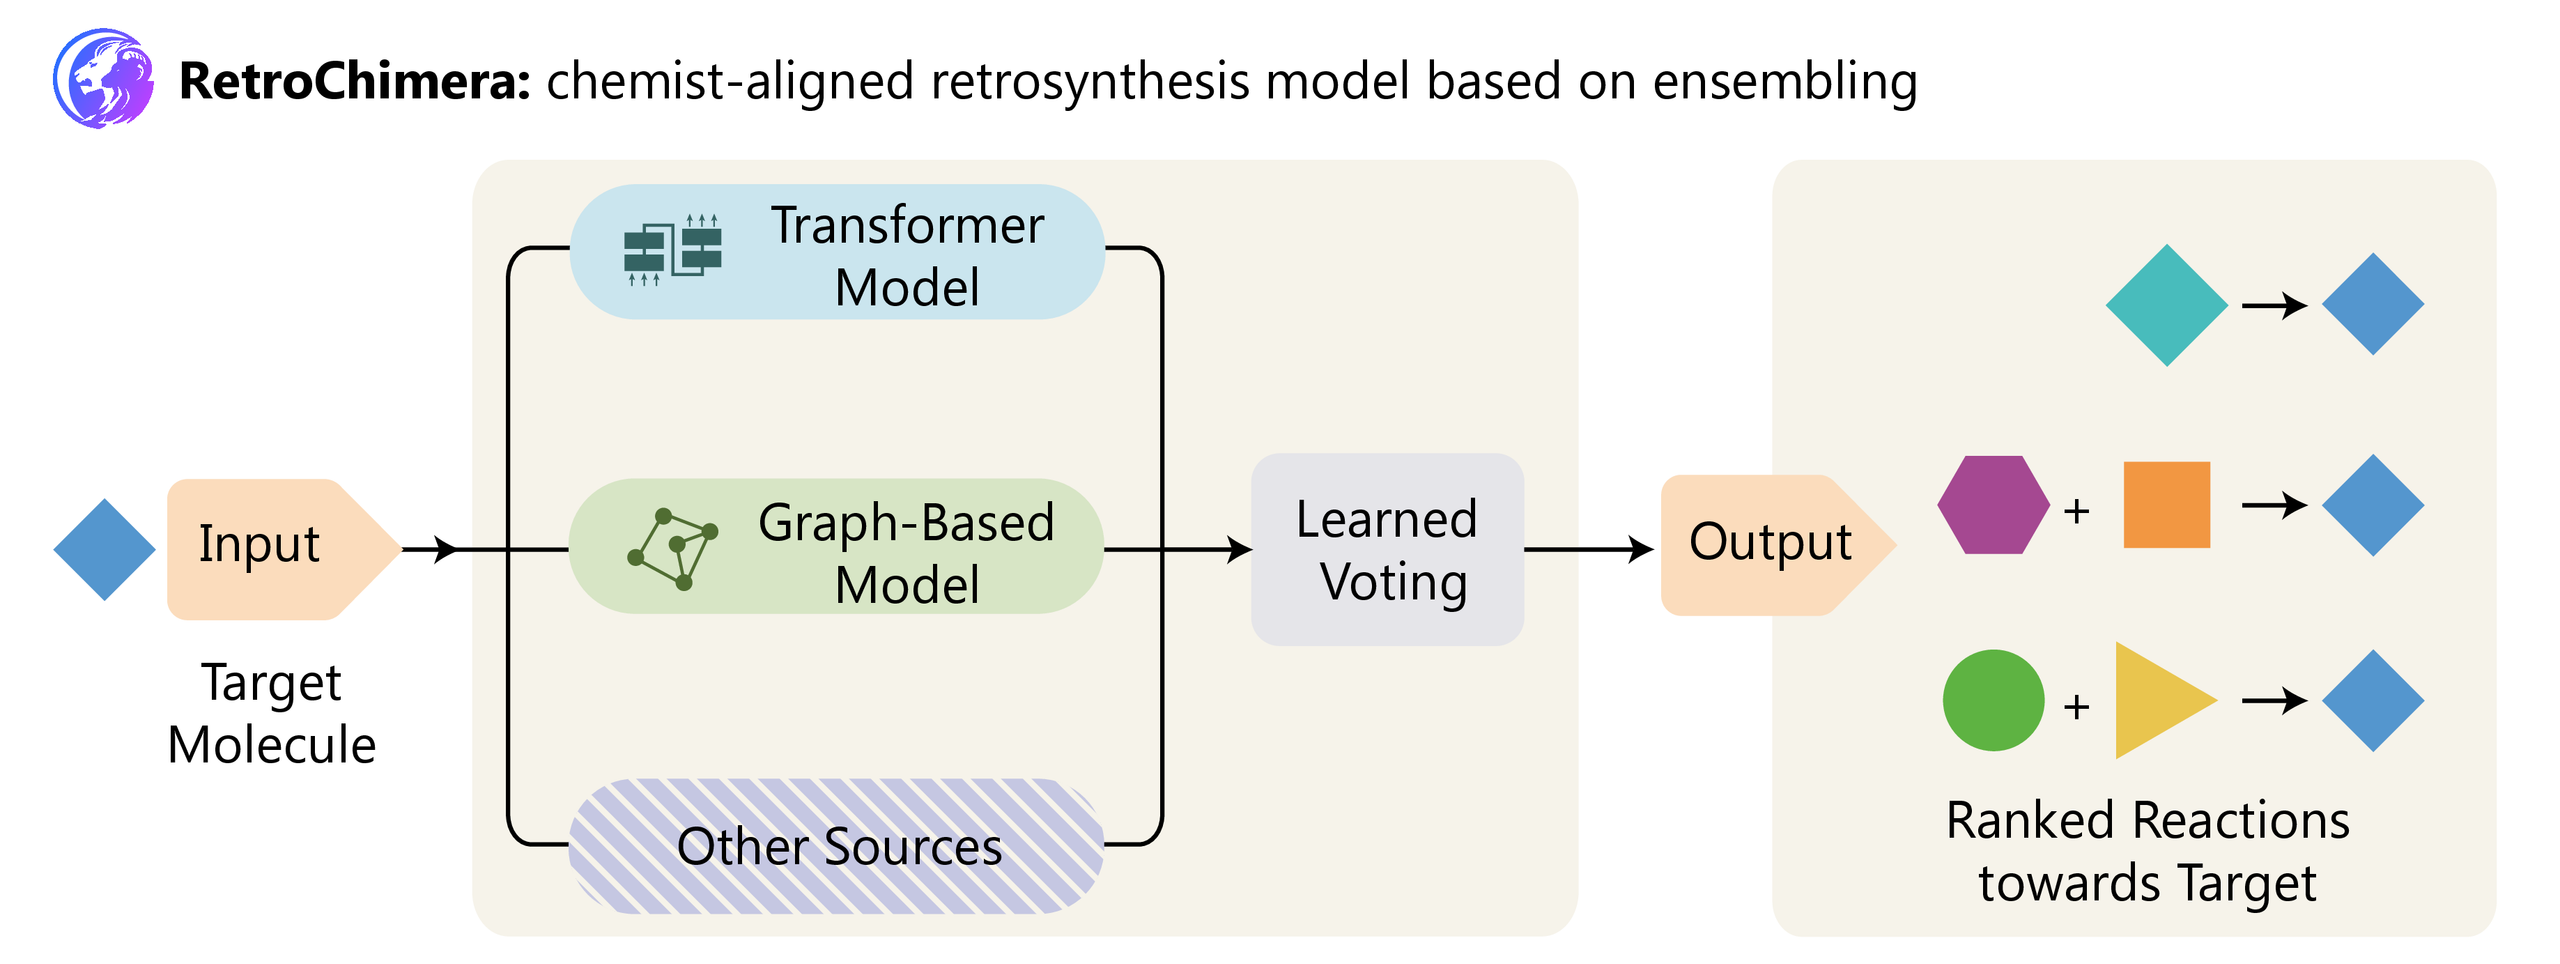
在我们最近发表于《自然》(Nature)杂志的论文中,我们提出了 RetroChimera,这是一个全新的逆合成预测框架。它围绕两个模型构建(见图 2)。R-SMILES 2 是一款基于 Transformer 的从头生成(de-novo)模型,它能直接从输入分子预测前体分子。这种设计使其具备灵活性,可直接从数据中学习反应模式。然而,其无约束的生成机制也容易导致幻觉(hallucination)。
相比之下,NeuralLoc 是一款基于图神经网络(GNN)的模型,它同时以图结构编码目标分子和反应模板。该模型负责选择反应模板,并预测在目标分子上的应用位置。由于其预测基于从训练数据中提取的反应模式,因此往往能产生更准确、更可靠的结果。但面对反应模板库未覆盖的反应时,其灵活性会受到更多限制。
这种差异恰恰构成了一种优势。这两个模型并非做出同类的预测,而是捕捉了化学中互补的模式,并专精于不同的反应类型。R-SMILES 2 在涉及大幅结构变化的反应上表现优异,而 NeuralLoc 则擅长处理先例较少以及涉及更局部变化的反应。
RetroChimera 采用一种学习得到的集成策略来合并两个子模型的排序预测结果。每个模型会为每个预测出的反应物集合赋予一个学习到的、与排名相关的票数,当两个模型提出相同反应时票数相加。通过学习在不同排名下该信任每个模型多少,RetroChimera 能充分利用二者互补的优势,在各类反应上表现接近表现更好的那个子模型。
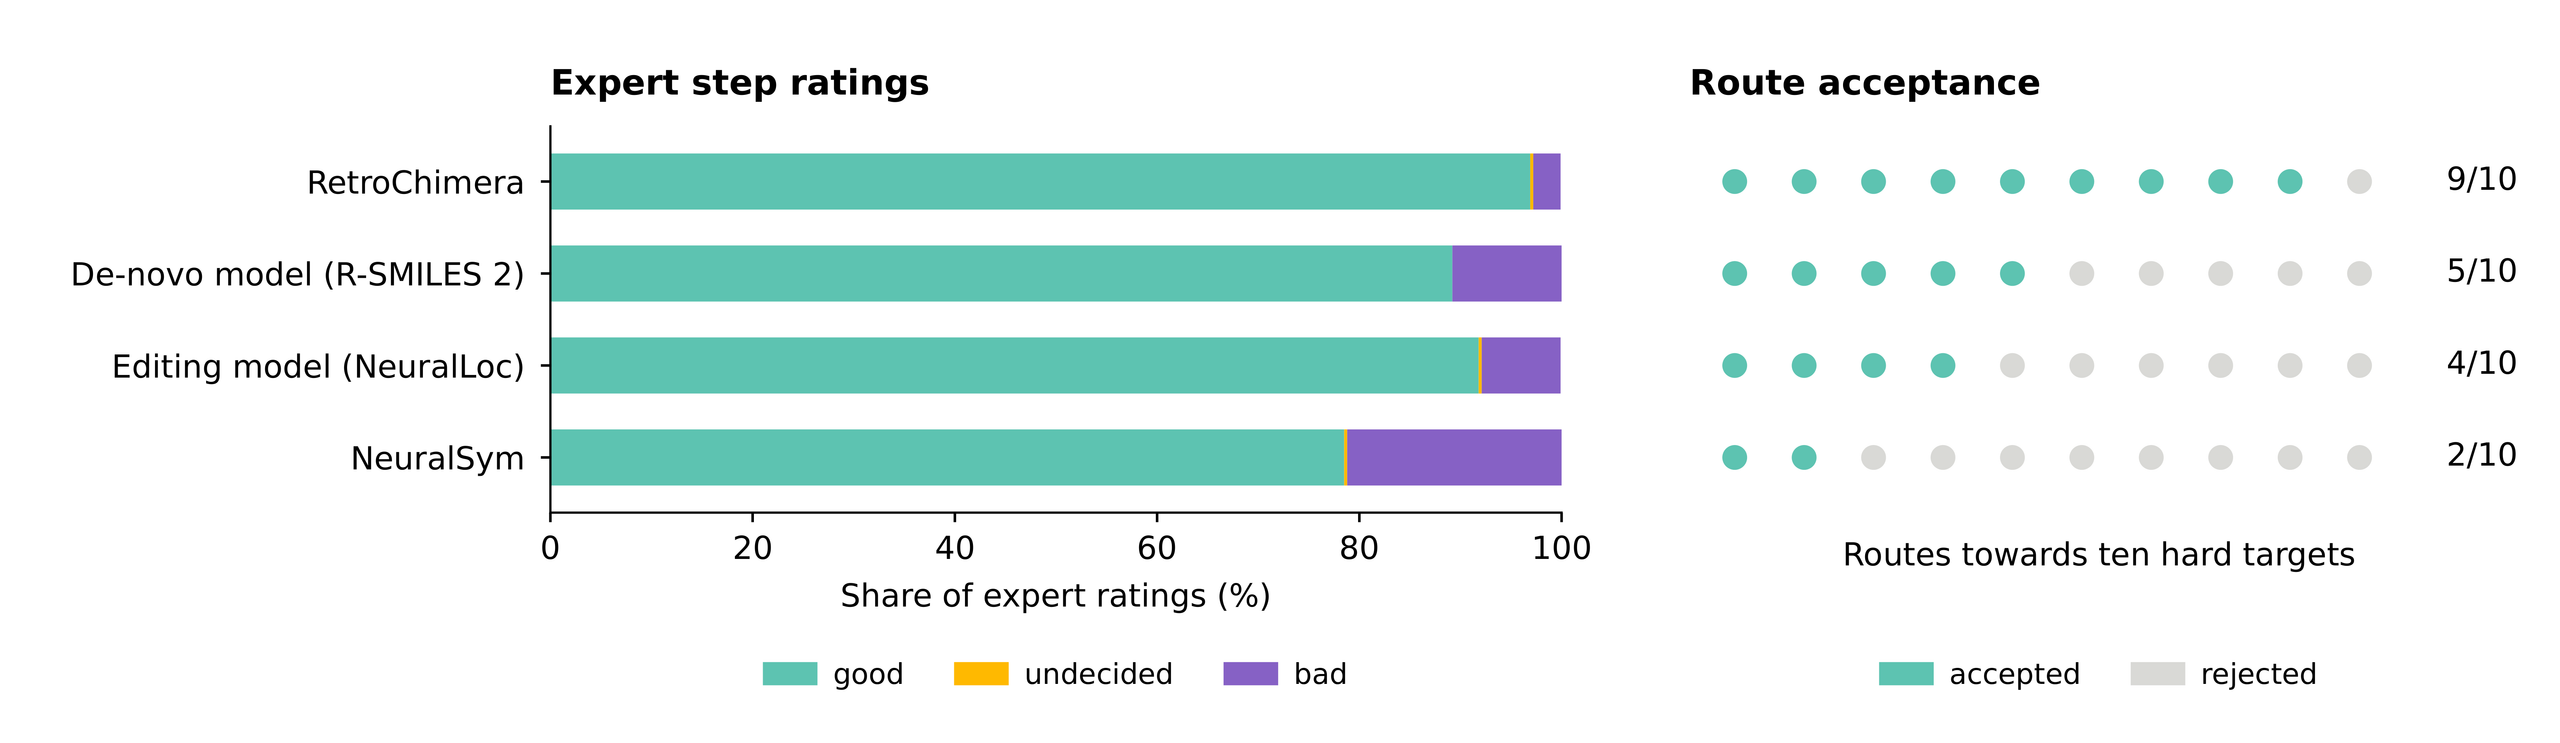
因此,RetroChimera 无论在常见还是罕见反应类别上都有出色表现,其逆合成预测也更符合化学家的判断(图 3)。在盲测中,专家化学家更青睐 RetroChimera 为复杂分子提出的断键方案,认为它优于其组成子模型、更传统的方法,甚至优于测试集中的真实答案。
我们相信 RetroChimera 能帮助研究人员更高效地找到有前景的合成路线,加速分子科学各领域的“设计—合成—测试”循环,包括药物研发和智能材料设计。RetroChimera 有望让化学家大规模评估更多、更复杂的候选分子。结合日益提升的实验室自动化水平,我们预计合成规划与执行的闭环自改进系统将进一步加速到来。
RetroChimera 已在 GitHub 上发布(采用 MIT 许可证),也可通过 Microsoft Foundry 访问。关于获取检查点的具体步骤,请参阅 GitHub 仓库。 我们诚邀更广泛的化学界同仁试验 RetroChimera,帮助识别其优势与不足,以便未来进行改进。期待看到它在大家关注的各类目标上的表现! 如需深入了解研究结果(包括与我们外部研究合作者开展的评估实验),请参阅完整的 Nature 论文 及配套 Microsoft Source 文章。 论文 开源代码库 Microsoft Foundry