
AI大模型运行,全靠HBM喂饱
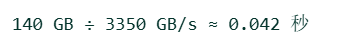 这就是它生成一个字的理论极限:每秒最多 24 个字。还没算 KV Cache、算子开销和卡间通信。请注意这个算式里没有出现一次算力。乘法单元有多快、张量核心有多少个,跟这个结果一点关系都没有。模型吐字慢,不是因为嚼不烂,是因为粮草运不上来。
大模型到底有多能吃
要理解 HBM,先得知道对面坐着的是个多大的胃口。它有三张嘴同时开合,任何一张堵上,整条流水线就得停下来等。
第一:每吐一个字,先把模型整个读一遍
自回归解码的规矩很死板:输出下一个 token 之前,权重必须从头到尾读一遍。参数越多,这趟搬运越重,而这一步的计算量其实很小。
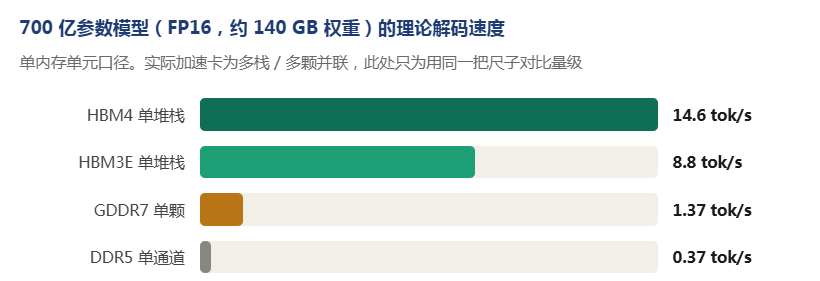
还是那笔账:140 GB 权重,HBM3E 级别 3.35 TB/s 的带宽,理论上限约 24 token/s。换成 DDR5 单通道(51.2 GB/s),同样一趟要 2.7 秒,理论上限掉到约 0.37 token/s。
差 60 多倍。同样的模型、同样的算力,只换一种内存,输出速度就从"能正常聊天"掉到"一分钟憋不出两句话"。
第二:KV Cache 会比模型本身还能吃
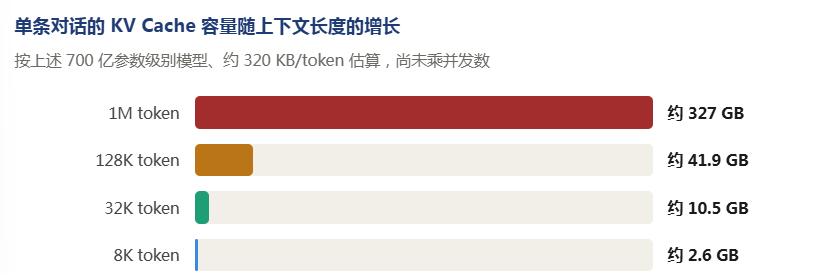
注意力机制为了避免重复计算,把历史 token 的 Key 和 Value 缓存下来。这份缓存随上下文长度线性增长,并发用户数是它的乘数。
按 700 亿参数级别、80 层、GQA 8 个 KV 头、每头 128 维、FP16 估算,单个 token 的 KV 大约 320 KB。一条 128K 上下文的对话,光缓存就要约 40 GB。再乘上并发数,很快超过权重本身。
长上下文和大并发的瓶颈,常常不是算力,而是"装不下"。这直接催生了 PagedAttention、KV Cache 量化、KV 卸载这一整批技术。
第三:优化器状态吃掉了大半个显存
推理只是"读权重",训练要存的东西多得多。混合精度训练加 Adam 优化器,每个参数大约要占 16 个字节,拆开看是这样:
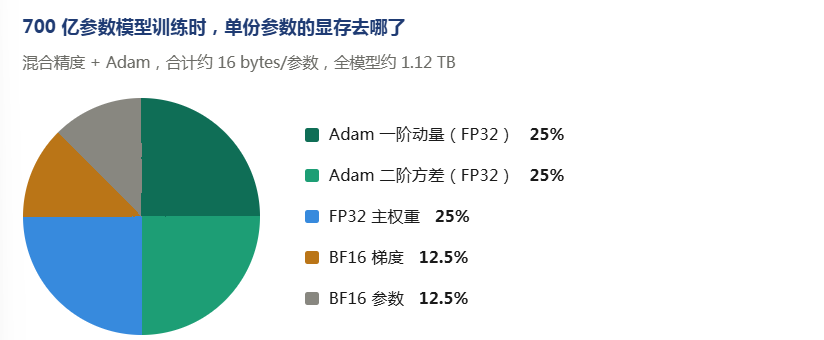
三张嘴一起张着:权重每步都要读一遍,上下文线性膨胀,训练还要额外背上优化器。它们争的是同一块 HBM 的带宽和容量。
为什么喂不饱:内存与算术强度
算力涨了 6 万倍,带宽只涨了 100 倍
算力与带宽的增速严重脱节。行业普遍引用的测算是:过去 20 年 GPU 峰值算力增长约6 万倍,DRAM 带宽只增长了约100 倍。不同机构口径差异较大,此处仅取量级。
结果就是一台发动机排量翻了几百倍,油管还是原来的粗细。油跟不上,转速再高也只是空转。
算术强度:嚼得少,吞得多
判断一个计算任务是"算力受限"还是"带宽受限",看的是算术强度,也就是每搬 1 字节数据能做多少次浮点运算(FLOP/Byte)。
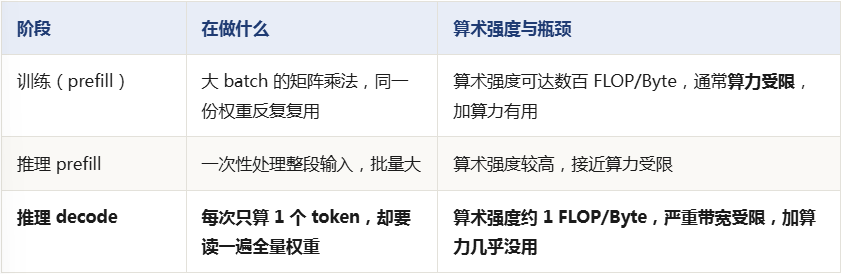
decode 这个阶段天生吃亏:计算量随 batch 线性增长,而权重的读取量是固定的。batch 越小,单位数据的计算量越低,越喂不饱。
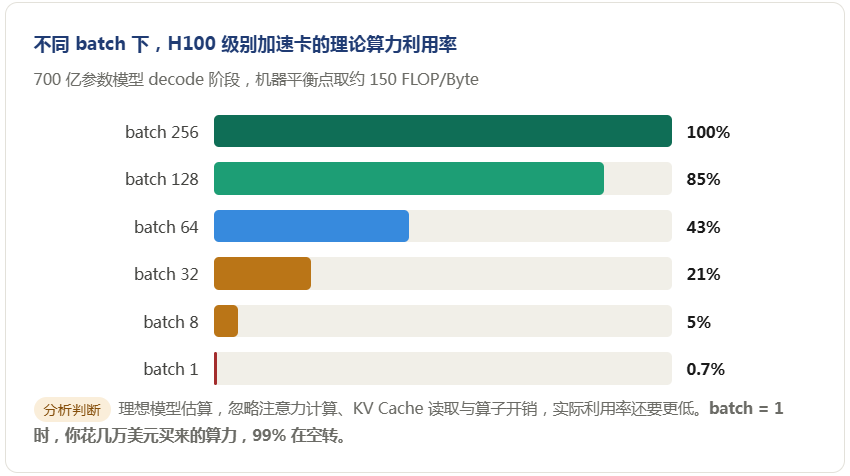
机器平衡点:batch 要做到多大,才算把算力喂饱
把上面这件事量化一下。以一块 H100 级别的卡估算,BF16 密集算力约 500 TFLOPS,HBM 带宽约 3.35 TB/s:
机器平衡点 = 500 TFLOPS ÷ 3.35 TB/s ≈ 150 FLOP/Byte
意思是:只有当你的算子算术强度超过约 150 FLOP/Byte,算力单元才可能跑满。低于这个数,卡就是在等数据。
70B 模型在 FP16 下,decode 的算术强度约等于 batch 大小(每个参数 2 字节,每个 token 做 2 次运算,两者刚好抵消)。于是:
"喂不饱"的四个现场症状
如果系统出现下面这些现象,大概率不是算子写得不够好,而是带宽没喂上。
症状一:GPU 利用率看着很高,吞吐就是上不去SM occupancy 很高但 IPC 很低,profiler 里 memory throughput 一栏接近 100%,compute 一栏只有个位数。症状二:加卡不加速本来就是带宽墙,再加几张卡只是把同样的搬运重复几遍,收益远低于线性。先确认瓶颈在带宽还是算力,再决定要不要加卡。症状三:batch 调大,总吞吐涨了,单请求延迟跟着涨这是正常的取舍。batch 换的是算术强度,代价是排队时间和 KV Cache 占用同步上升。症状四:量化之后速度翻倍,效果几乎没掉INT8 把权重字节数砍半,等于搬运量砍半,带宽墙直接减半。这正是"喂不饱"最三、HBM 是怎么把管子加粗的
既然瓶颈在"油管粗细",解法就很直接:把管子加粗,把距离缩短。HBM(High Bandwidth Memory,高带宽内存)干的就是这件事,它是 JEDEC 标准化的 3D 堆叠 DRAM。
它的做法是把 4 到 16 层 DRAM 裸片垂直堆叠在一颗逻辑基础裸片(Base Die)之上,用硅通孔(TSV)垂直互连,再与 GPU/ASIC 一起贴装在硅中介层(Interposer)上,形成 2.5D 封装。
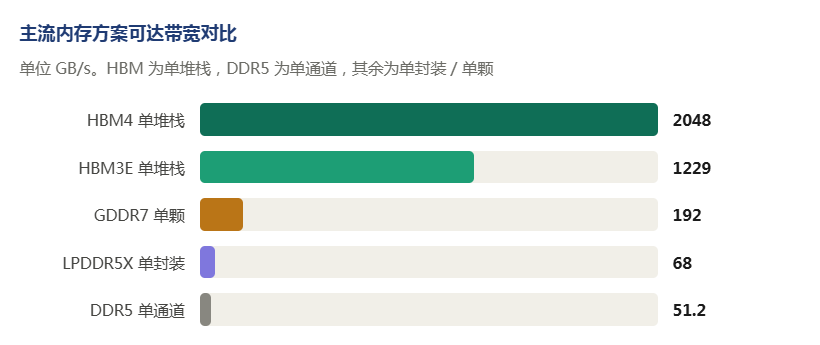
理解 HBM 的关键是几何结构而非频率:它把内存从"离处理器几厘米、走 PCB 的窄通道",变成"离处理器几毫米、走中介层的超宽总线"。DDR5 单通道 64 位,HBM4 单堆栈 2048 位,宽度差 32 倍。这才是带宽量级差异的来源。
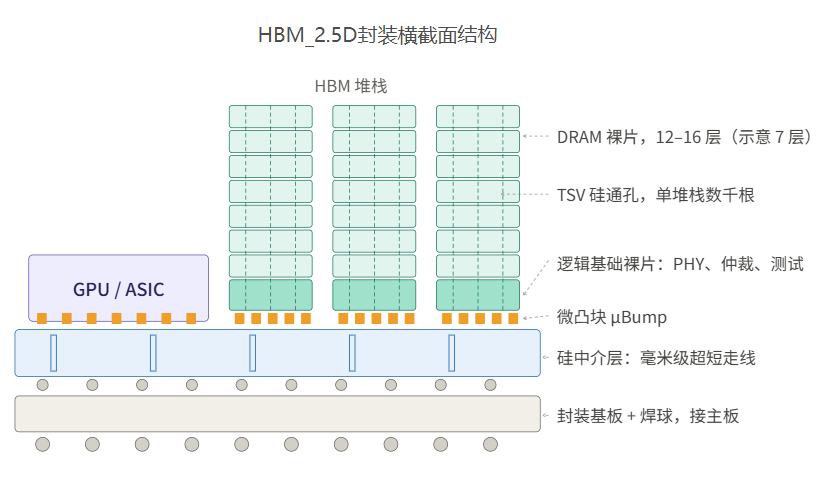
处理器与 HBM 堆栈并排坐在同一块硅中介层上。数据从 DRAM 裸片经 TSV 垂直到基础裸片,再走中介层的毫米级走线进处理器,全程不过几毫米。
四个支柱
1. 3D 堆叠 + TSV
TSV 是穿透硅片的垂直铜互连,直径数微米、单堆栈数千根,把每层 DRAM 的 I/O 直接引到基础裸片,替代传统引线键合,是"垂直方向走线"的物理基础。
2. 逻辑基础裸片(Base Die)
位于堆栈最底层,承担 PHY、TSV 驱动、通道仲裁、ECC、测试与修复逻辑。HBM4 起它的重要性显著提升:三星 HBM4E 已采用4nm 逻辑制程制造基础裸片,HBM 正从"纯存储堆叠"演化为"存储 + 逻辑 + 先进封装"的系统级产品。
3. 超宽接口 + 多通道
HBM4 共 2048 位接口,划分为 32 个独立通道(每通道 64 位),每通道再拆为 2 个 32 位伪通道。伪通道共享 DQ 数据总线,但命令与地址各自独立,在不增加引脚的前提下把并发事务数翻倍,对 AI 推理的不规则随机访问尤其有效。
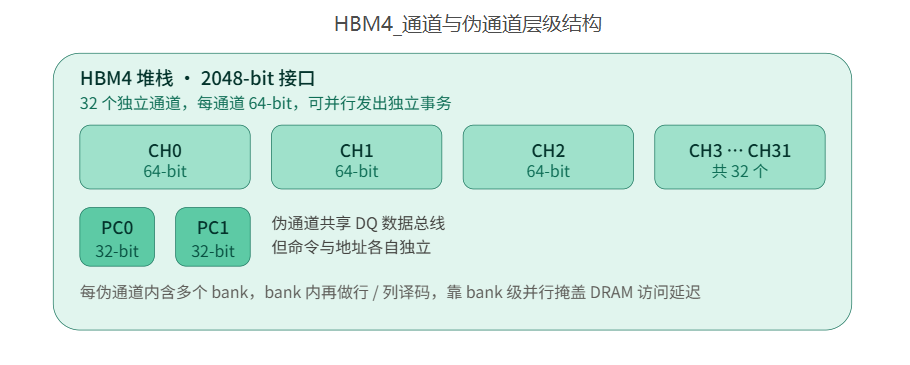
4. 2.5D 中介层集成
硅中介层(如 CoWoS-S)或嵌入式桥接(如 EMIB)提供微米级布线的超短互连,把 2048 根信号线从 HBM 引到处理器 die,走线长度是毫米级而非 PCB 的厘米级。
HBM:物理封装与堆叠
这是 HBM 与传统 DRAM 制造差异最大的地方,也是成本与产能的真正瓶颈。
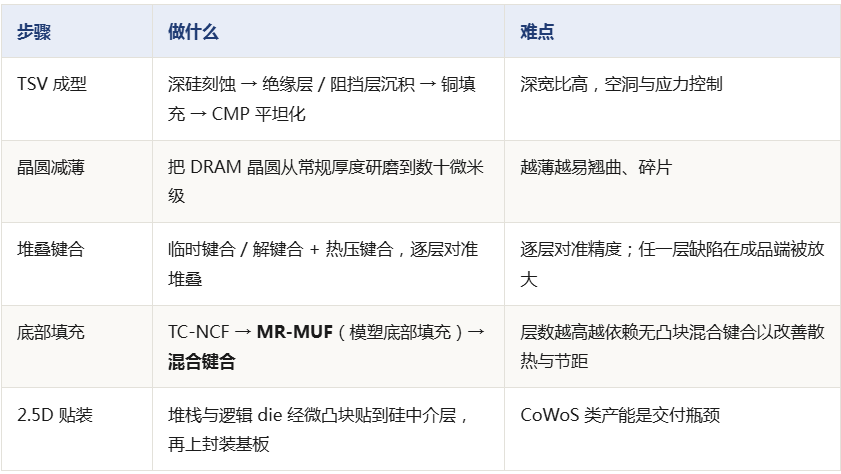
自上而下:DRAM 裸片 ×4–16 层 → 逻辑基础裸片(含 PHY / 仲裁 / 测试)→ 微凸块 µBump → 硅中介层 → C4 凸块 → 封装基板(ABF)→ 焊球 → 主板。
TSV 自基础裸片贯穿至顶层 DRAM,是命令上行与数据下行的垂直通道;中介层承担 HBM 与处理器之间的毫米级水平布线。
两条硬约束
堆叠高度
:JEDEC 对堆栈总高设限(约 0.7 到 0.8 mm 量级)。"增加层数"不是简单往上摞,而要靠更薄的减薄与更细的键合节距腾空间。这解释了 12 层到 16 层的推进为什么这么慢,也解释了混合键合(无凸块、节距可压到 10 μm 以下)为何被视作下一代关键工艺。
散热路径
:中间层 DRAM 只能靠侧向与向上导热,层数越多热阻越大,必须与散热盖、液冷方案联合设计。
一次投喂数据全过程
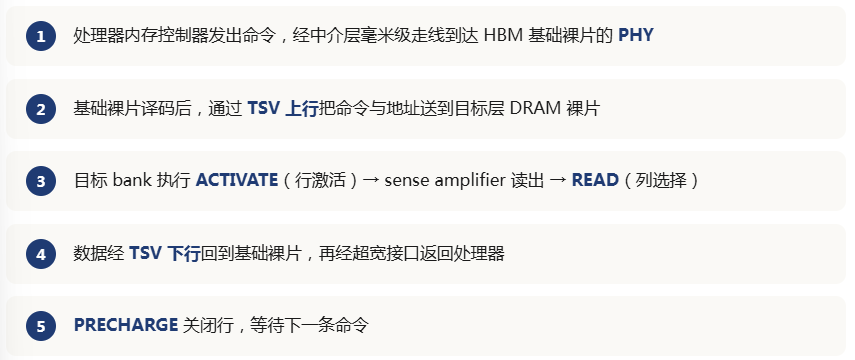
两个工程要点
刷新与可靠性:DRAM 必须周期性刷新。高频访问相邻行会引发 Row Hammer 位翻转。HBM4 引入DRFM(Directed Refresh Management),由控制器指定刷新目标行,替代盲目全量刷新,兼顾安全与性能。
ECC:HBM 支持链路 ECC 与 on-die ECC,但具体是 SEC-DED 还是链路重传,各厂商实现不同,选型时需向供应商确认。
HBM 代际演进
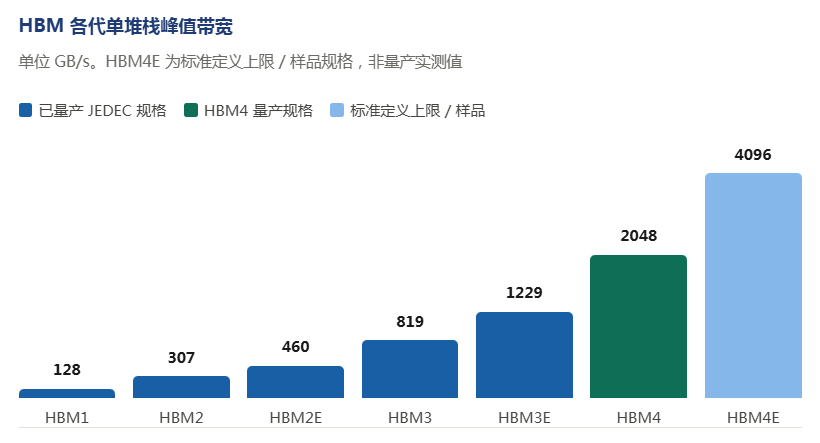
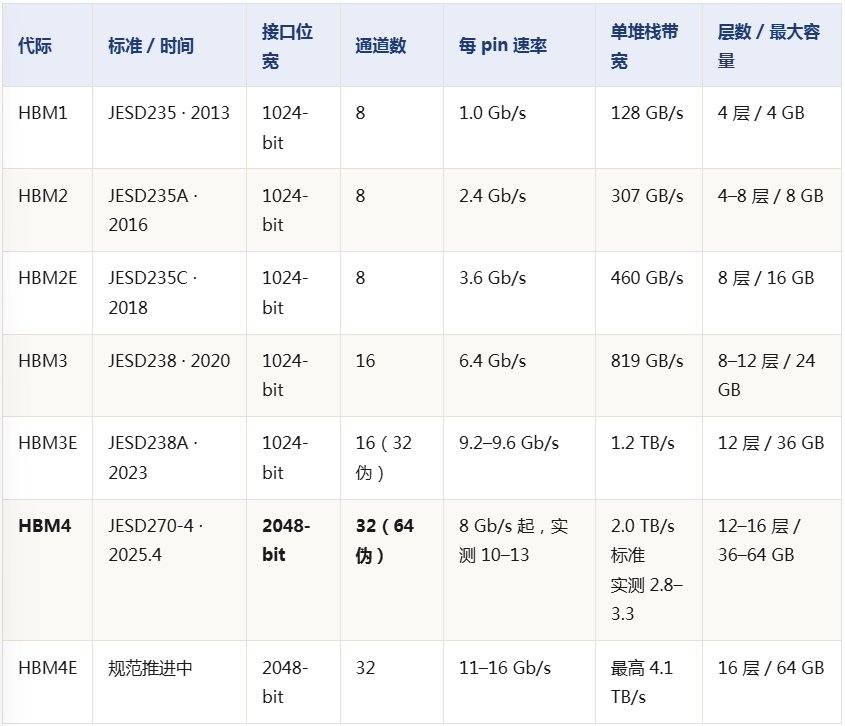
两个关键跳变
HBM2E 到 HBM3:通道数翻倍。
8 变 16,单通道带宽没怎么变但并行度翻倍。这代开始 HBM 真正成为大模型训练标配:A100 用 HBM2E 还能凑合,H100 必须上 HBM3。
HBM3E 到 HBM4:位宽翻倍。
1024 变 2048,单堆栈理论带宽从 1.33 TB/s 跳到 2.0–3.3 TB/s。代价是不兼容:HBM4 需要全新 PHY 与内存控制器,已围绕 1024-bit 设计好的系统必须重新设计内存子系统。
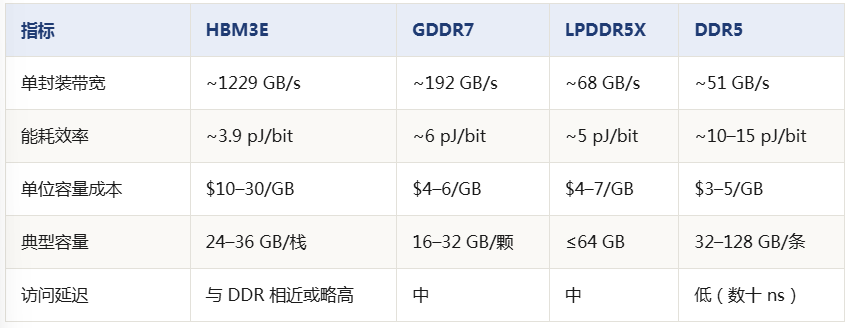
横向对比:HBM 到底比别人强在哪
收益与账单
四项收益
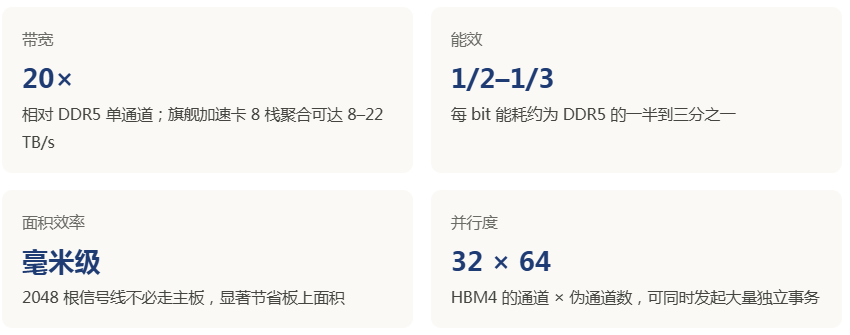
功耗这笔账值得单独说。一个机柜的供电和散热是定死的,带宽要靠堆芯片来换,那就得问一句:搬一个 bit 要花多少电。HBM 约 3.9 pJ/bit,DDR5 大约 10 到 15 pJ/bit,搬同样多的数据,电费只有三分之一上下。放到数千张卡、全年不停转的训练集群上,这是几千万美元级别的差别。
面积上也有收益。如果用 GDDR 去堆出 TB/s 级带宽,需要在 GPU 四周摆十几颗显存芯片,PCB 走线长、信号完整性差,板上面积和功耗一起爆掉。HBM 用 2048 位总线在封装内部解决,板上面积被释放出来,整机反而能塞进更多加速卡。
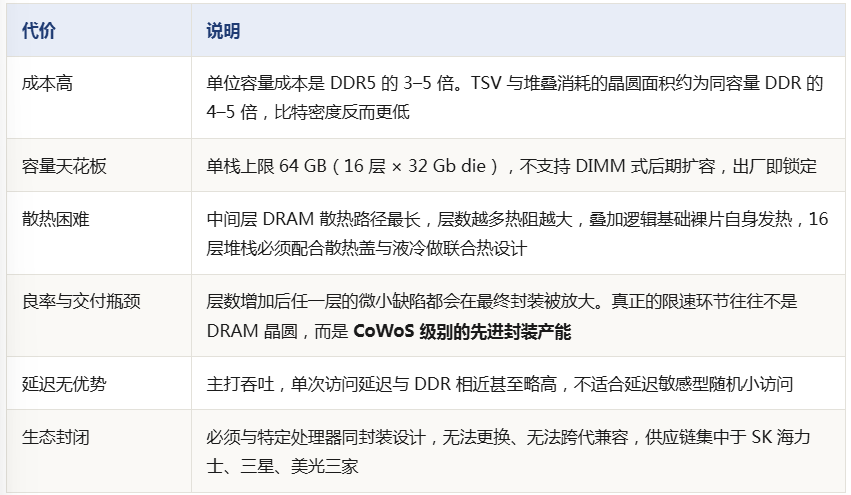
六项代价
未来待解决
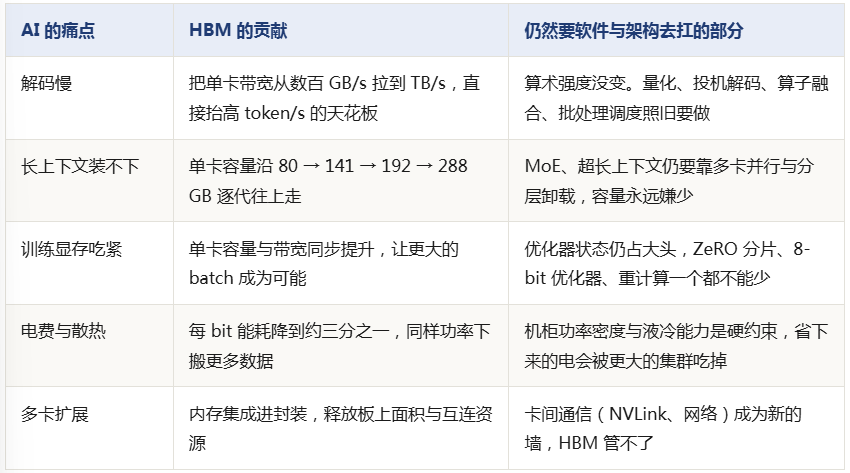
HBM 把管子加粗了几十倍,但并没有把问题解决完。这张表列出的是它扛下来的部分,和留给软件与架构的部分。
需求都流向哪里
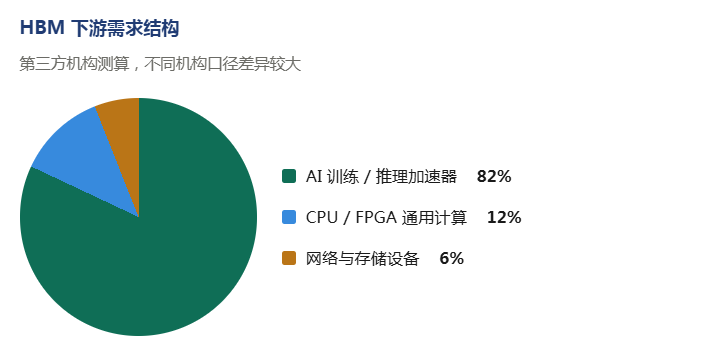 具体落点:AI 训练集群(NVIDIA Blackwell / Rubin、AMD MI300 / MI325 系列、Google TPU、云厂商自研 ASIC)、推理卡、HPC(气象、分子动力学、流体仿真)、高端网络(交换机包缓冲、DPU / SmartNIC)、专业图形与影视渲染。
谁在给 AI 供粮:供应链
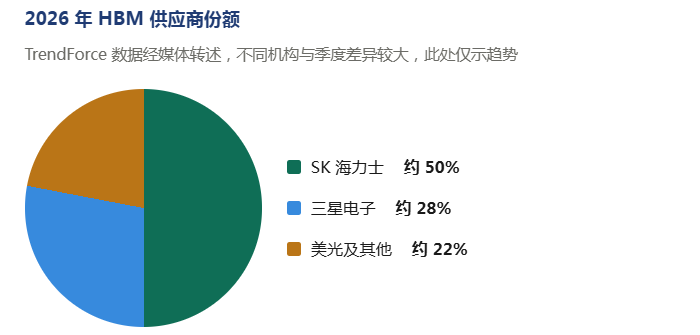
未来发展
基础裸片逻辑化
:HBM4E 已用 4nm 逻辑制程做 Base Die,下一步是近存计算:把注意力打分、激活函数、归约等操作放进基础裸片,直接在 TSV 的 2 TB/s 带宽上算,而不是把数据搬到 GPU。
混合键合取代微凸块
:为突破 16 层以上的高度与散热限制,无凸块混合键合是确定性方向。
定制 HBM
:客户开始要求按自家模型定制堆栈层数与基础裸片逻辑,供应链从标准品走向联合定义。
HBM 不会取代 DDR
:成本高、容量受限、散热紧张,服务器主存仍由 DDR5 与低功耗模块(如 SOCAMM)承担,两者长期共存。
本文基于公开信息整理,希望能为您提供产业层面的参考,但绝不代表投资建议。投资是一场长跑,请务必保持理性,风险自担