
像物理学家一样剪枝 LLM:将层块移除视为 Ising 优化问题
让大型语言模型提速最廉价的手段之一,也是其中最直接粗暴的:直接删除整个 Transformer 层块。由于模型在物理长度上真正变短了,层块移除(亦称深度剪枝)不仅能节省内存,还能带来可预测的推理速度提升,且与量化、低秩压缩等技术兼容,可层层叠加。难点在于判断该删哪些层块。删错层块,模型就会崩塌;而且删掉任何一个层块的效果,都取决于同时删掉了其他哪些层块,因此选择之间存在交互性。这使其成为一个组合优化问题,而非排序问题。而带有交互二元变量的组合问题,正是自旋系统物理所要描述的对象。
我们最新论文基于约束二元优化的层块移除实现 LLM 压缩,将这种对应关系付诸实践。我们将层块选择重构为约束二元优化(CBO)问题,并直接映射到Ising 玻璃模型——一种具有全连接相互作用且“向上”自旋数量固定的无序自旋系统。结果表明,该自旋系统的能量是衡量剪枝后模型在基准测试中实际表现的一个强力且廉价代理指标。这意味着我们无需对大量候选配置逐一进行基准测试,即可对其排序,并将其中难以处理的实例交由我们在 Multiverse 使用的其他经典及类量子求解器解决。在深度压缩区间,收益巨大:在 Llama-3.3-70B-Instruct 模型上实现 50% 压缩时,我们在 MMLU 基准测试上比最佳的竞争层块移除方法高出近23 个百分点。
为何挑选层块是一个多体问题
现有的大多数层块移除方法会对每个层块单独评分,然后删除那些看似最不重要者,通常依据幅度、敏感度或“层块影响力”等启发式规则。从物理学角度看,这些是平均场方法:它们假设每个层块的贡献与其他层块无关,就像平均场理论用单一的场均值场替代自旋的邻居那样。另一种相关的捷径是只删除一段连续的层块,这虽然缩小了问题规模,但丢弃了大部分搜索空间。
难点在于,块与块之间并非彼此独立,正如真实磁体中的自旋一样。移除第20块是否会影响模型,取决于你是否同时移除了第19块或第24块。这就是两个决策之间的相互作用,或者说耦合。模型越深、结构越异构,忽略这些耦合所导致的性能损失就越大,尤其是当你要一次性移除大量块的时候。真正需要的是在考虑相互作用的前提下,搜索块的组合,但组合数量呈指数增长,暴力搜索显然不可行。而这恰恰是统计物理工具大显身手的领域——在具有两两耦合的指数级大配置空间中。
核心思路:将块的选取转化为能量最小化问题
我们为每个 Transformer 块分配一个二元变量:0 表示保留,1 表示移除,类比于可以朝上或朝下的自旋。随后,我们对模型损失关于这些变量进行二阶泰勒展开,得到一个(近似的)Hessian 矩阵。该矩阵的对角线反映了每个块单独的重要性;非对角线元素则正好对应块之间的两两耦合,也就是平均场方法所丢弃的多体物理效应。
这一重构把“该移除哪些块?”变成了一个清晰的优化问题:找出移除哪些 M 个块能使能量 xᵀH⁰x 最小,约束条件是在 N 个块中恰好移除 M 个。从数学上看,这是一个带约束的二元优化问题;从物理上看,它是一个伊辛玻璃(Ising glass),即全耦合自旋系统且磁化强度守恒(固定数量的移除块起到了固定总自旋的作用)。我们确立的一个关键性质是:该能量是下游质量的强代理指标:自旋系统的低能态对应高性能的剪枝模型。 最小化能量与最大化基准分数因此成为同一次搜索。
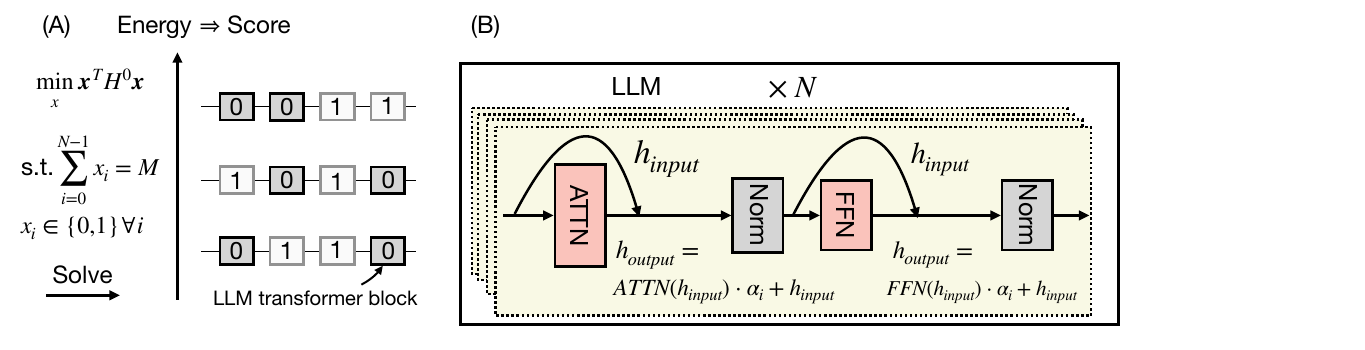
块选择被转化为一个带约束的二元优化问题,等价于寻找 Ising glass 的低能量状态;每个解都指明了从 N 个块中删除哪 M 个。右图:我们在每个块的残差路径中插入的耦合变量 α,用于构建 Hessian。图片来源:论文图 1。
这个方法可行的关键在于成本。Hessian(也就是全部耦合系数)只需计算一次:在一个小的校准数据集上跑一次前向和反向传播即可。之后,评估任何一个候选配置都只是一次开销极小的能量计算,根本不需要真正跑模型,更不用做基准测试。而且由于耦合系数与压缩目标无关,同一个 Hessian 可以复用,用来求解不同的 M 值。
求解:能精确算就精确算,算不动就交给量子或量子启发求解器
对大多数模型来说,配置空间虽然庞大,但仍在可枚举范围内。由于单次能量计算非常便宜,我们直接在单块 GPU 上暴力枚举,最多检验过数百亿个自旋配置。几百万个配置几秒就能算完;这里最难的可处理案例是从 Llama-3.3-70B 的 80 个块中删除 8 个(约 290 亿种配置),花了大约两天。
超出这个规模,精确方法就撑不住了,而这正是把问题建模为 Ising glass 的第二重价值。把它写成等价的 QUBO 形式(约束被吸收进一个惩罚项)后,同一个问题可以直接交给针对这类 Hamiltonian 高度优化的经典、量子及量子启发求解器,也就是量子退火、QAOA、禁忌搜索和专用分支定界这套工具箱。我们发现一个开源的禁忌搜索求解器能在几秒内可靠地找到最低能量状态,即便在我们能用暴力枚举验证的最难案例上也是如此。这样一来,方法就能扩展到配置根本无法枚举的模型,而且用的求解器完全在 Multiverse 的能力范围内。
这里有一个微妙但重要的点,它和优化的常规思路正好相反。通常评价一个 CBO 或退火求解器的标准,是看它能否找到真正的基态。但我们其实不需要基态。我们需要的是一种快速生成若干个良好低能量状态的方法,这个门槛低得多,这正是轻量级求解器对我们如此有效、也让我们能同时跑多个求解器的原因。
为什么整个低能量谱都很重要
能量是衡量模型质量的强代理指标,但并非完美对应,因此能量最低的基态并不总是最优模型。这恰恰是优势而非缺陷:一旦哈密顿量设定完毕,读取基态和低能激发态的代价几乎为零,从而提供了一组高质量的候选剪枝方案,而非单一脆弱的结果。探索激发态(而不仅是基态)本身是物理学研究的活跃领域,这与实践者在此处的实际需求高度契合。
举一个具体例子:在移除 16/32 个块的情况下,Llama-3.1-8B-Instruct 的前 16 个低能态大多倾向于删除模型后部的块,这与先前研究的预期一致。但第 17 个激发态是首个提议删除靠近模型开头块的方案。经过轻微再训练后,该配置在多项基准测试中超越了基态表现。这直接推翻了“最佳剪枝应删除中段或后段连续块”的常见假设,也证明了尊重问题的全多体结构确实能带来收益。
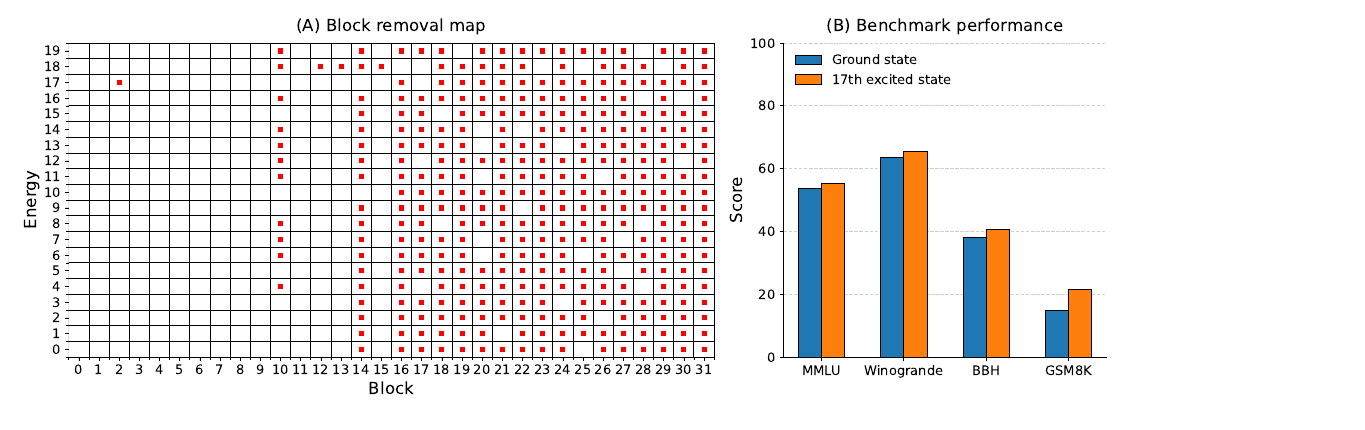
左图:能量最低的 20 个态各自移除哪些块(红色表示已移除)。右图:移除早期块的第 17 激发态,在再训练后于多项基准测试中胜过基态。最佳模型是激发态,而非基态。来源:论文图 2。
结果
在 Llama-3.1-8B-Instruct、Qwen3-14B 和 Llama-3.3-70B-Instruct 上,我们的方法(CBO)与或优于当前的块移除基线方法,且随着压缩率提高,优势进一步扩大。
最显著的收益来自对 Llama-3.3-70B-Instruct 的深度压缩,且评估过程未进行任何重训练。在未移除超过 24/80 的 Block 时,CBO 的表现与 block influence 方法大致相当。但在移除 32/80 和 40/80 的 Block 时,CBO 开始大幅领先,在最深的 40/80 设置下,其 MMLU 得分优势接近 23 分,并在所有测试基准上均超越基线方法。对于移除 12/40 的 Qwen3-14B,CBO 在 MMLU 上领先约 10 分。在轻度压缩场景下,各方法表现相近,这是预料之中的:只有在进行深度裁剪时,相互作用耦合(couplings)才最具决定性。
| Llama-3.3-70B-Instruct,无重训练 | 移除 Blocks 数量 | MMLU |
|---|---|---|
| 原始模型 | 0 | 82.2 |
| CBO(本文方法) | 32 / 80 | 76.6 |
| Block influence | 32 / 80 | 59.3 |
| CBO(本文方法) | 40 / 80 | 76.9 |
| Block influence | 40 / 80 | 54.0 |
在移除 40/80(50% 深度)时,CBO 的 MMLU 得分保持在 77 左右,而最强的基线方法则跌至 55 分段。来源:论文表 2。
该方法能推广到稠密 Transformer 之外的架构
在现代表征性不同的异构架构中,Block 移除的难度显著增加,因为不同类型的 Block 是交错排列的,而 Ising 模型对这一点并不关心:无论每个格点上是哪种类型的 Block,耦合就是耦合。为了压力测试这一特性,我们将该方法应用于 NVIDIA-Nemotron-3-Nano-30B-A3B-FP8,这是一个混合模型,以非均匀模式交错 Mamba2、Attention 和 Mixture-of-Experts (MoE) 层,且全程无重训练。
我们的形式化定义并未假设同构堆叠,因此可直接迁移。移除 2–3 个 MoE 层或 2 个 Attention 层后,CBO 找到的配置在 AIME25 和 GPQA 上均优于 block influence。结果还证实,这些混合模型中的冗余是真实存在的,但分布不均匀:某些 Expert 层比其他层更易于舍弃。该方法的强大之处在于能够搜索耦合配置空间,从而定位到最佳的裁剪位置。即便在此处,稠密模型中观察到的规律依然成立:最优配置往往处于激发态,而非基态。
为什么这与 Multiverse Computing 的理念契合
把一个棘手的机器学习问题重新表述为 Ising Hamiltonian,再借助物理学领域积累的经典与量子启发式优化工具来求解,正是 Multiverse 擅长的方向——我们的压缩技术栈贯穿的也是同一种思路。而且移除模块(block removal)可以与技术栈中的其他方法叠加使用:量化、低秩/SVD 压缩、宽度剪枝、基于知识蒸馏的修复等,因此它适合嵌入更大的流水线,而非与之竞争。
想了解完整的技术细节,包括 Taylor 展开推导、QUBO 映射、求解器基准测试、校准数据集消融实验以及完整结果表格?欢迎在 Hugging Face 阅读完整论文,或联系我们的团队,聊聊如何将这一方法应用到你的模型上。代码已在 github.com/CompactifAI/Block_removal_through_constrained_binary_optimization 开源。