
开放模型领域的力量平衡
最近,我应邀向一批美国国会议员及其幕僚简要介绍了中美竞争视角下开放权重模型的现状。我把准备好的发言稿分享出来,作为一份面向更广泛读者的开放模型“国情咨文”。
Interconnects AI 是一份由读者支持的刊物,欢迎考虑订阅。
Subscribe背景:什么是开源、开放权重与闭源模型?
开放语言模型是指权重公开可供查看或下游使用的 AI 模型。它们通常与所谓的“闭源”AI 模型形成对比。闭源模型只能通过 API(应用程序接口)供开发者直接调用,如 GPT-4 或 Claude Opus 4.5,或以产品形式提供,如 ChatGPT 和 Claude Code。
开放语言模型大致分为两类:开放权重模型和开源模型。开放权重模型是最常见的形式,比如 Meta 的 Llama、阿里巴巴的 Qwen、Google 的 Gemma,以及 DeepSeek 的各款模型。这类模型受许可证(规定下游使用边界的法律文件)约束,通常还附带 Transformers、VLLM、SGLANG 等推理库中的推理代码。自 2025 年 4 月前后开始,中国 AI 公司在开放权重模型领域已明显处于领先地位。
真正的“开源”模型与此类似,同样包含权重、许可证和推理代码,但还包括复现该模型所需的完整信息——即训练代码和训练数据。最知名的开源模型来自美国,近期代表是 Allen Institute for AI(AI2)的 Olmo 系列,我在那里工作的两年半里曾参与其构建。其他著名的开源模型也均由美国的非营利组织开发,包括 OpenAthena 的 Marin 模型和 EleutherAI 的 Pythia 模型。
开放权重、开源以及各种其他标签的模型——包括主要通过 API 提供的闭源模型——其实都处在一个连续的光谱上。例如,Nvidia 的 Nemotron 模型比大多数开放权重模型开放得多,以宽松许可证发布了大量训练数据,但因为没有公开全部数据,还算不上完全开源。闭源模型同样存在程度差异,取决于 API 透露的信息多少和使用条款。
中美开源模型竞争态势(单位经济、技术能力等)
我们所处的世界里,最新的领先中国模型,如GLM-5.2 和 Kimi K3,正在实现开源模型商业可行性的阶梯式跨越——跨越了 Anthropic 的 Claude Code 在 2025 年 12 月跨越的智能体能力阈值。
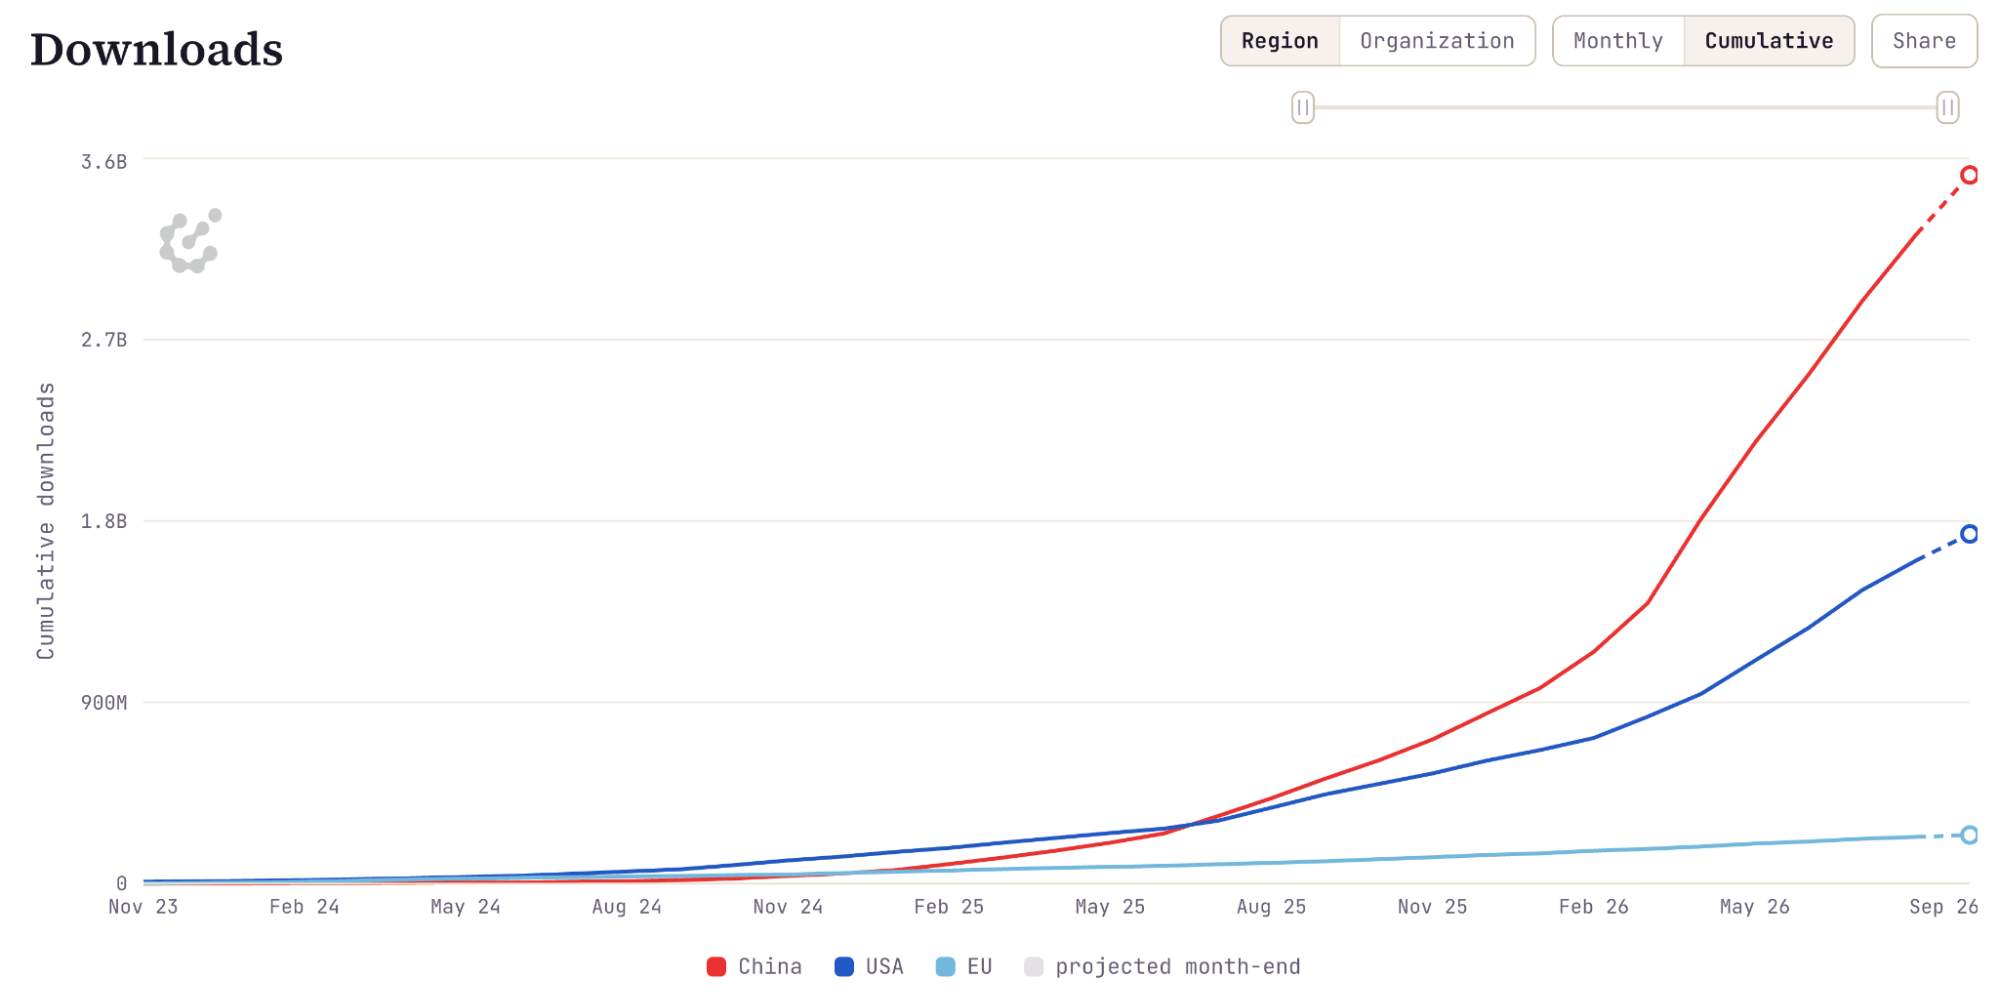
美国在开源语言模型领域早期占领先地位,主要归功于 Meta 的 Llama 模型,它在研究和商业任务中被大量使用。大约 18 个月前,中国开源模型在这两个关键领域超越了美国。展现这一点的简单指标是 Hugging Face 下载量,2025 年 7 月,主要得益于阿里 Qwen 模型的成功,中国开始领先。我专门维护工具来追踪这些数据,自 2025 年 8 月首次发布美国真开源模型(ATOM)项目以来,中国的下载量领先已扩大至约 16 亿次——总下载量达 32 亿,是美国的两倍。
在主流能力基准测试(如 Artificial Analysis Intelligence Index,简称 AAII)中,中国开源权重模型明显领先于美国同类模型。截至 2026 年 9 月 14 日,排名前三的中国模型分别是 Z.ai 的 GLM-5.3 和 GLM-5.3-Flash,以及 Moonshot AI 的 Kimi K3,得分分别为 45、42 和 44。相比之下,表现最好的美国模型是 Thinking Machines 的 Inkling 和 Inkling Small(得分均为 26),以及 Nvidia 的 Nemotron 3 Ultra(得分 23)。这些顶尖美国模型发布于 2026 年 6 月和 7 月,更新频率低于中国模型。例如,中国实验室发布的模型得分高于这些美国模型,且发布时间早 2 到 6 个月(如 GLM-5 或 DeepSeek V4 Pro)。虽然 Arcee AI、Poolside 和 IBM 等美国公司正在增多发布模型,但它们并未迅速缩小这一性能差距。其他基准测试的结果也类似。
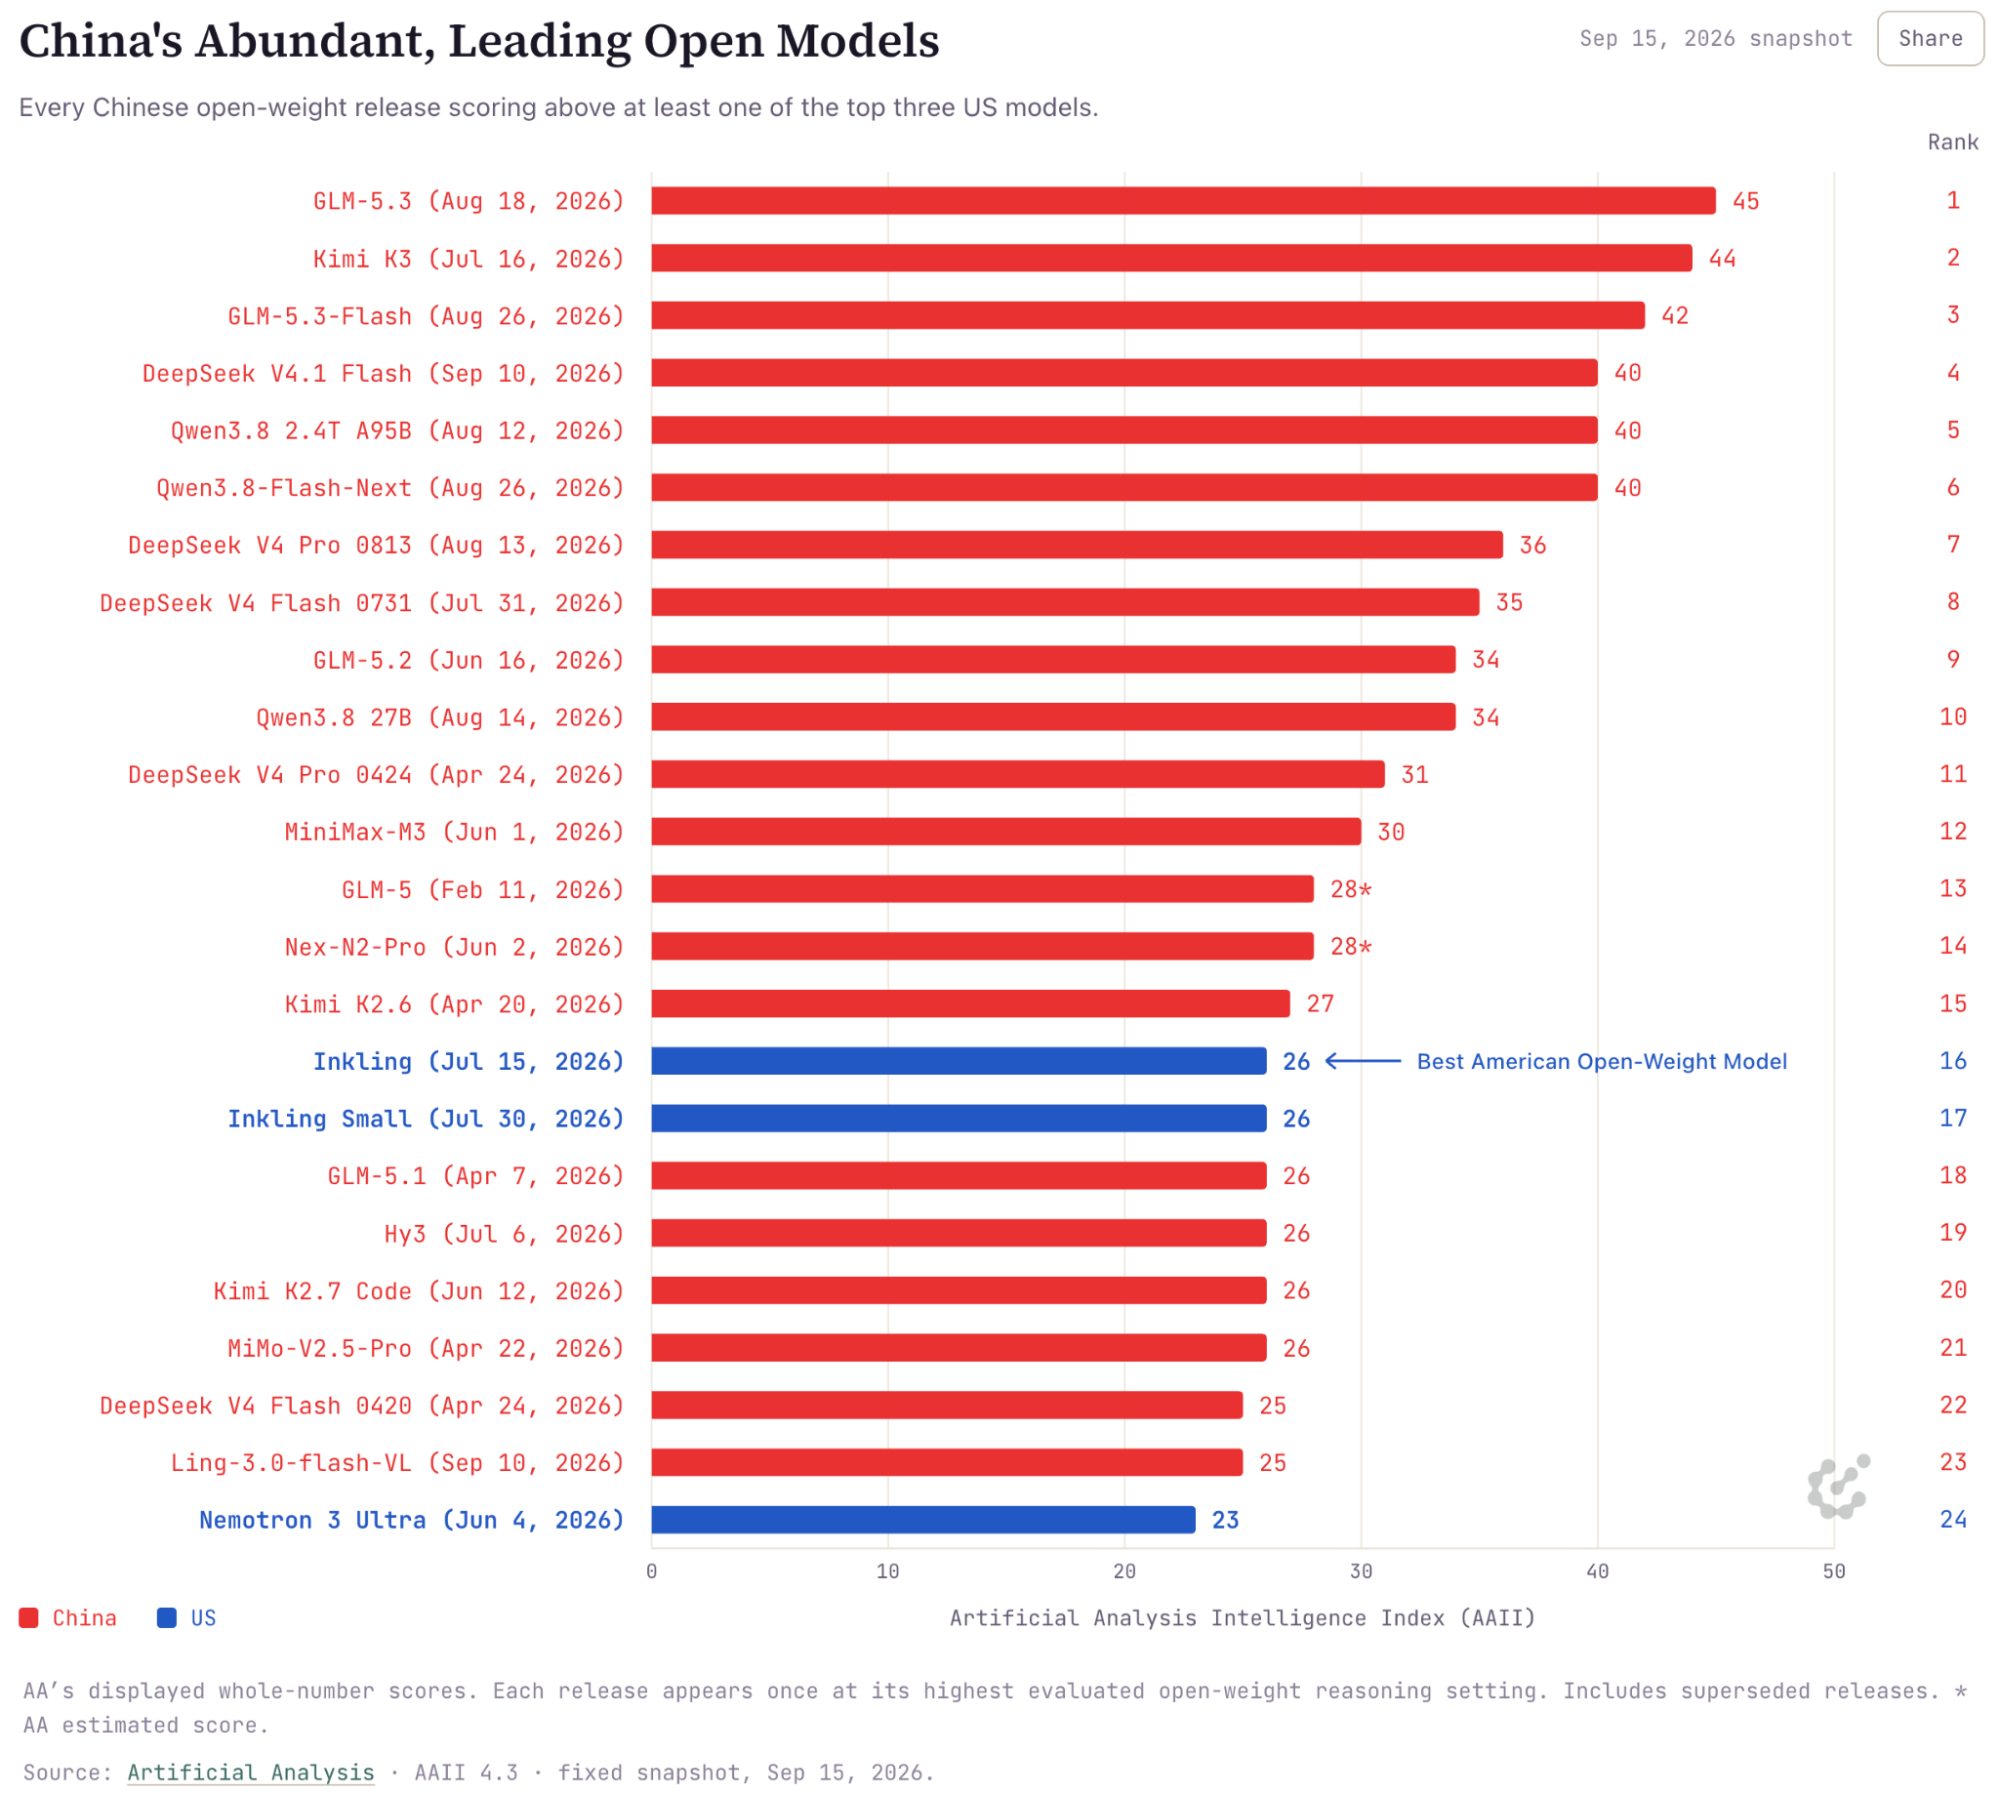
总体而言,中国开源权重模型大约落后于美国闭源前沿模型 2 到 5 个月,而美国开源权重模型则大约落后于 OpenAI 和 Anthropic 等公司 6 到 9 个月。在具有明确用户需求的任务(如 agentic coding)上,中国实验室表现最接近前沿水平;而在更开放的科研任务(如物理或生物学)上,则落后更多。
中国实验室资源不如美国同行,却能训练出这些强大的模型,原因何在至今仍有争论,很大程度上与不同的工作文化有关,但也受几个关键技术因素影响。中国实验室发布模型的节奏更快,且专注于范围稍窄的任务分布,这让它们在公开基准测试上的成绩略占便宜。发布得快之所以有助于拿高分,是因为所有实验室都在持续进步——模型一旦“完成”并发布,就只是那个时间点性能的快照,发布时间越晚的实验室往往得分越高。即便如此,中国实验室做出的模型确实很强,对美国产业构成了实质竞争。即使封闭实验室修补了 API 上可被用来做蒸馏的漏洞,这种竞争也不会明显减弱。
蒸馏在新领域里影响最大,但有了蒸馏并不意味着就能轻松造出一个全面强大的最终模型。我估计,即使完全杜绝蒸馏——比如 Anthropic 和 OpenAI 采用 KYC(了解你的客户)工具——最强美国模型与中国开源权重模型之间的差距也只会拉长 1-2 个月。
举个例子,2026 年中国实验室在为训练数据付费这件事上的态度正在快速转变。年初时,包括 Moonshot AI 和 Z.ai 在内的头部中国实验室还强烈倾向于自建数据流程,但到了夏天,它们已经开始从成熟的美国公司和中国新兴创业公司购买前沿数据——即用于 agentic 任务的 challenging RL environments。
随着中国的开源权重模型不断逼近能力前沿,以及最近围绕前沿模型在网络安全等领域风险日益增加的记录(如 OpenAI-HuggingFace 事件),一个监管层面的不确定性正在加剧:持续发布模型,究竟如何才能促成更安全的生态?
开放权重模型面临一个结构性挑战:目前缺乏有效手段阻止开放软件的组件落入不法分子手中。若试图限制中国获取最强开放权重模型的权限,理由是其放大了安全风险,那么受损的将是美国企业。我们已有实例——HuggingFace 利用中国开放权重模型来分析网络攻击,因为封闭模型无法响应其请求。因此,管理开放权重模型的风险通常取决于生态系统的应对准备。开放权重模型正成为普及人工智能的关键工具。应对此类风险以及改善美国企业依赖中国构建模型这种失衡关系的最佳途径,是继续推动美国对开放模型的投入。掌控开放模型有助于更好地协调和应对具有全球性质的风险,同时加速国内经济中 AI 服务的普及。
开放模型采纳现状:学术界、企业及他国如何使用开源?
2026年,开源权重语言模型在关注度和商业可行性上均取得长足进步,让我们得以初步洞察美国、中国及其他地区模型在 Hugging Face 指标之外的直接采用差异。OpenRouter 平台就是一个典型案例。作为主流的 LLM 推理平台,OpenRouter 提供统一接口,方便用户在来自美国和中国的开源及闭源模型间切换。该平台主要以试用各类开源模型著称。自 2025年1月1日起,平台公开了头部模型的使用数据,显示其处理量从 2025年9月某周的约 1万亿 tokens 增长至今日每周约 80万亿 tokens。在此期间,中国模型的份额从约 70% 攀升至使用量的 80% 以上。其他旨在将开源模型商业化的平台也呈现出类似数据,例如开源编程智能体 OpenCode,其推理量中有 95% 以上来自中国模型。
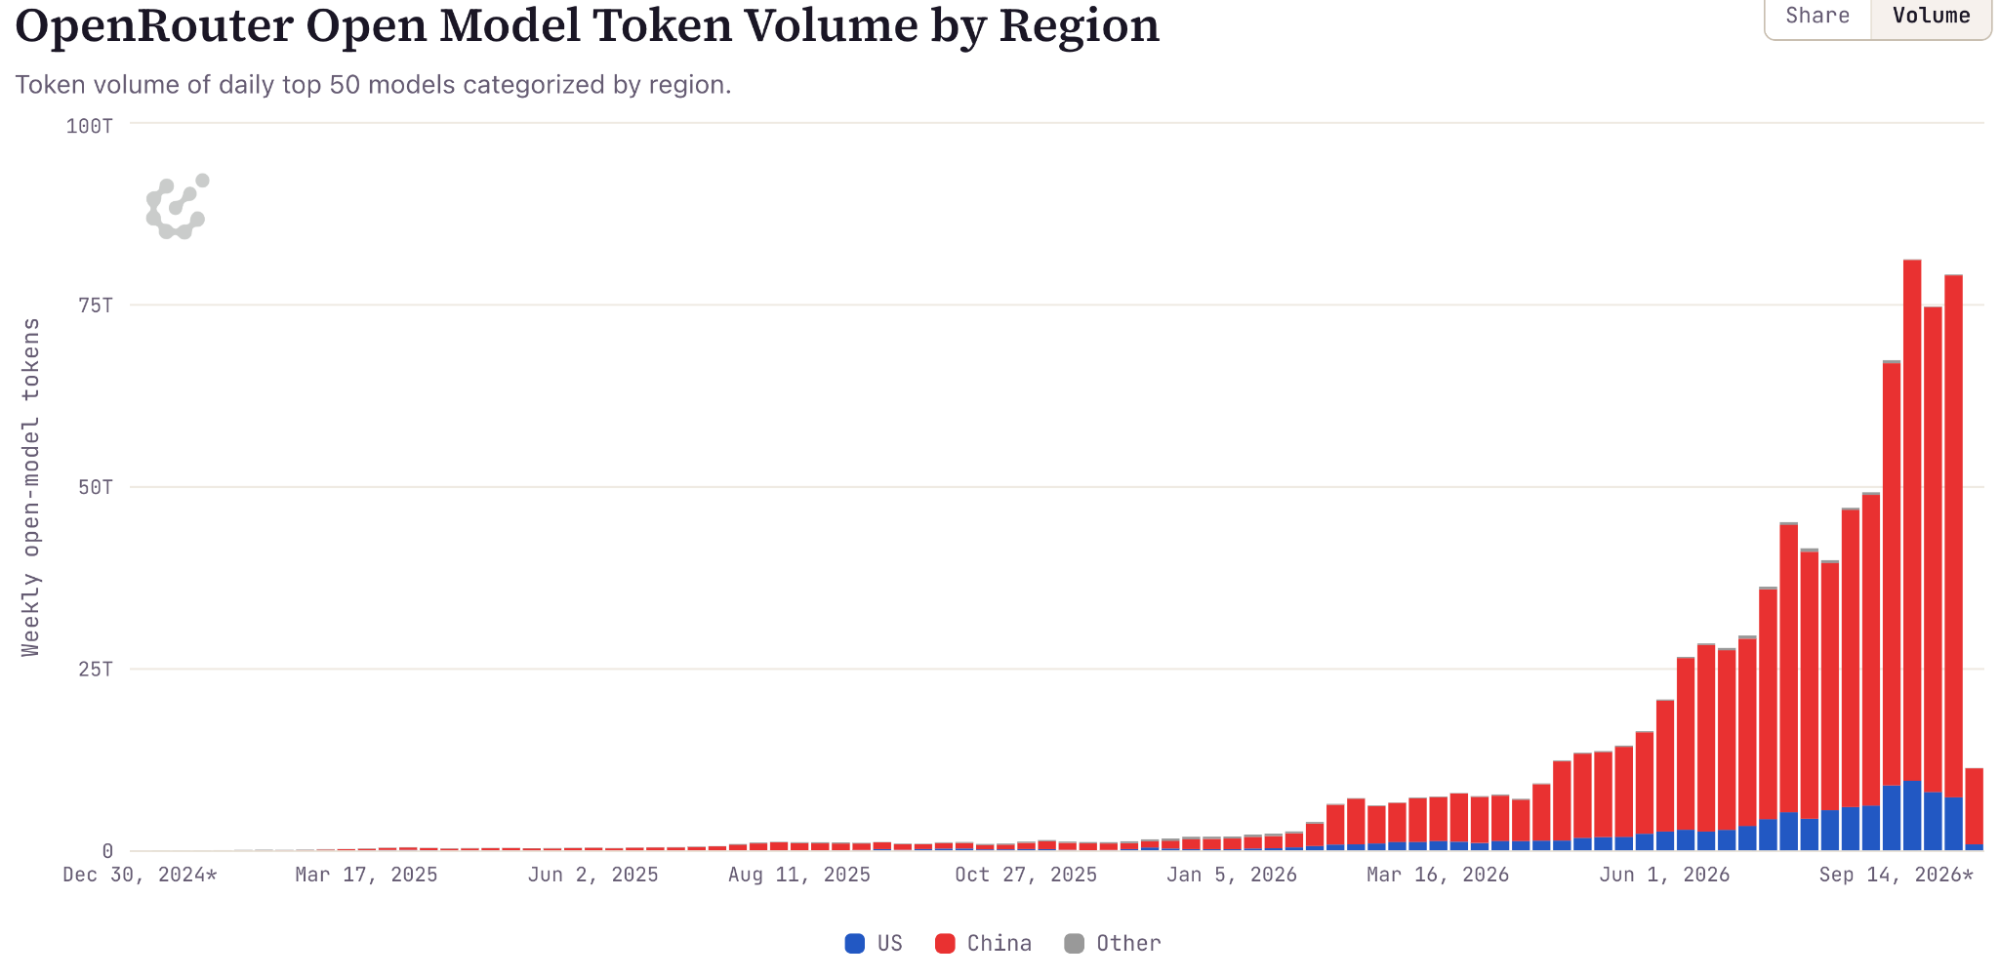
这些开放平台是衡量开源模型使用情况的最佳近似指标——事实上,大量开源模型的使用发生在不公开单模型细分数据的平台上(如 Together AI 或 Fireworks AI),以及企业私有部署场景中。
许多知名科技公司和新创企业都在基于中国的开源权重模型打造 AI 功能,例如法律智能体 Harvey、编程智能体 Cursor,以及 DoorDash 使用 Kimi 模型、Airbnb 使用 Qwen、Perplexity 使用 DeepSeek。这些知名公司只是冰山一角——大量硅谷新创公司为了获得低成本、灵活的方案,也在采用中国模型。美国初创公司和企业与中国模型实验室签订企业合作协议以获准在产品中使用其模型的趋势正在兴起,这种跨境技术合作的新形式,在我职业生涯中从未见过。
围绕中国模型的创新已进一步渗透到整个 AI 生态。粗略来看,大多数学术研究都是在阿里巴巴的 Qwen 系列模型上进行的。我在访华期间见过 Qwen 领导团队的多位成员,他们对这种被采用非常重视且有意为之,而要把这一生态拉回美国模型,绝非易事。
为了量化开源模型在学术界的采用情况,我扫描了 AI 研究常用预印本平台 arXiv 上五个最热门机器学习类别(cs.AI、cs.CL、cs.CV、cs.LG、stat.ML)的所有论文。结果清楚地印证了我对 AI 研究格局演变的判断:LLM 正成为机器学习研究的基础层——提及开源模型的论文占比从 2023 年 1 月的 2% 升至 2026 年 9 月的 50%——而同期主导地位也从美国转移到了中国。
以 2023 年 4 月至 5 月为例,那是 Meta 首个 Llama(Llama 是一个首字母缩略词,代表 Large Language Model Meta AI,最早于 2023 年 2 月发布)推出后的几个月。当时,arXiv 上发布的约 12,000 篇新 AI/ML 论文中,有约 2,600 篇提及了至少一个重要的开源模型家族。在所有被扫描的论文中,约 5.5% 提及了 Llama,而提及中国模型的比例仅为约 1%。到了 2024 年秋季,在 Llama 的巅峰期,约 23% 的论文提及了 Llama,而约 7.5% 提及了 Qwen,后者是中国最直接的竞争者。如今,Llama 已在学术界失去领先地位,尽管它仍在约 21% 的论文中被提及,展现了非凡的生命力,但 Qwen 的份额已上升至 30%。总体来看,任何中国开源权重模型在被提及的比例上超过 40%,高于美国的 30%,且中国的份额仍在持续增长。
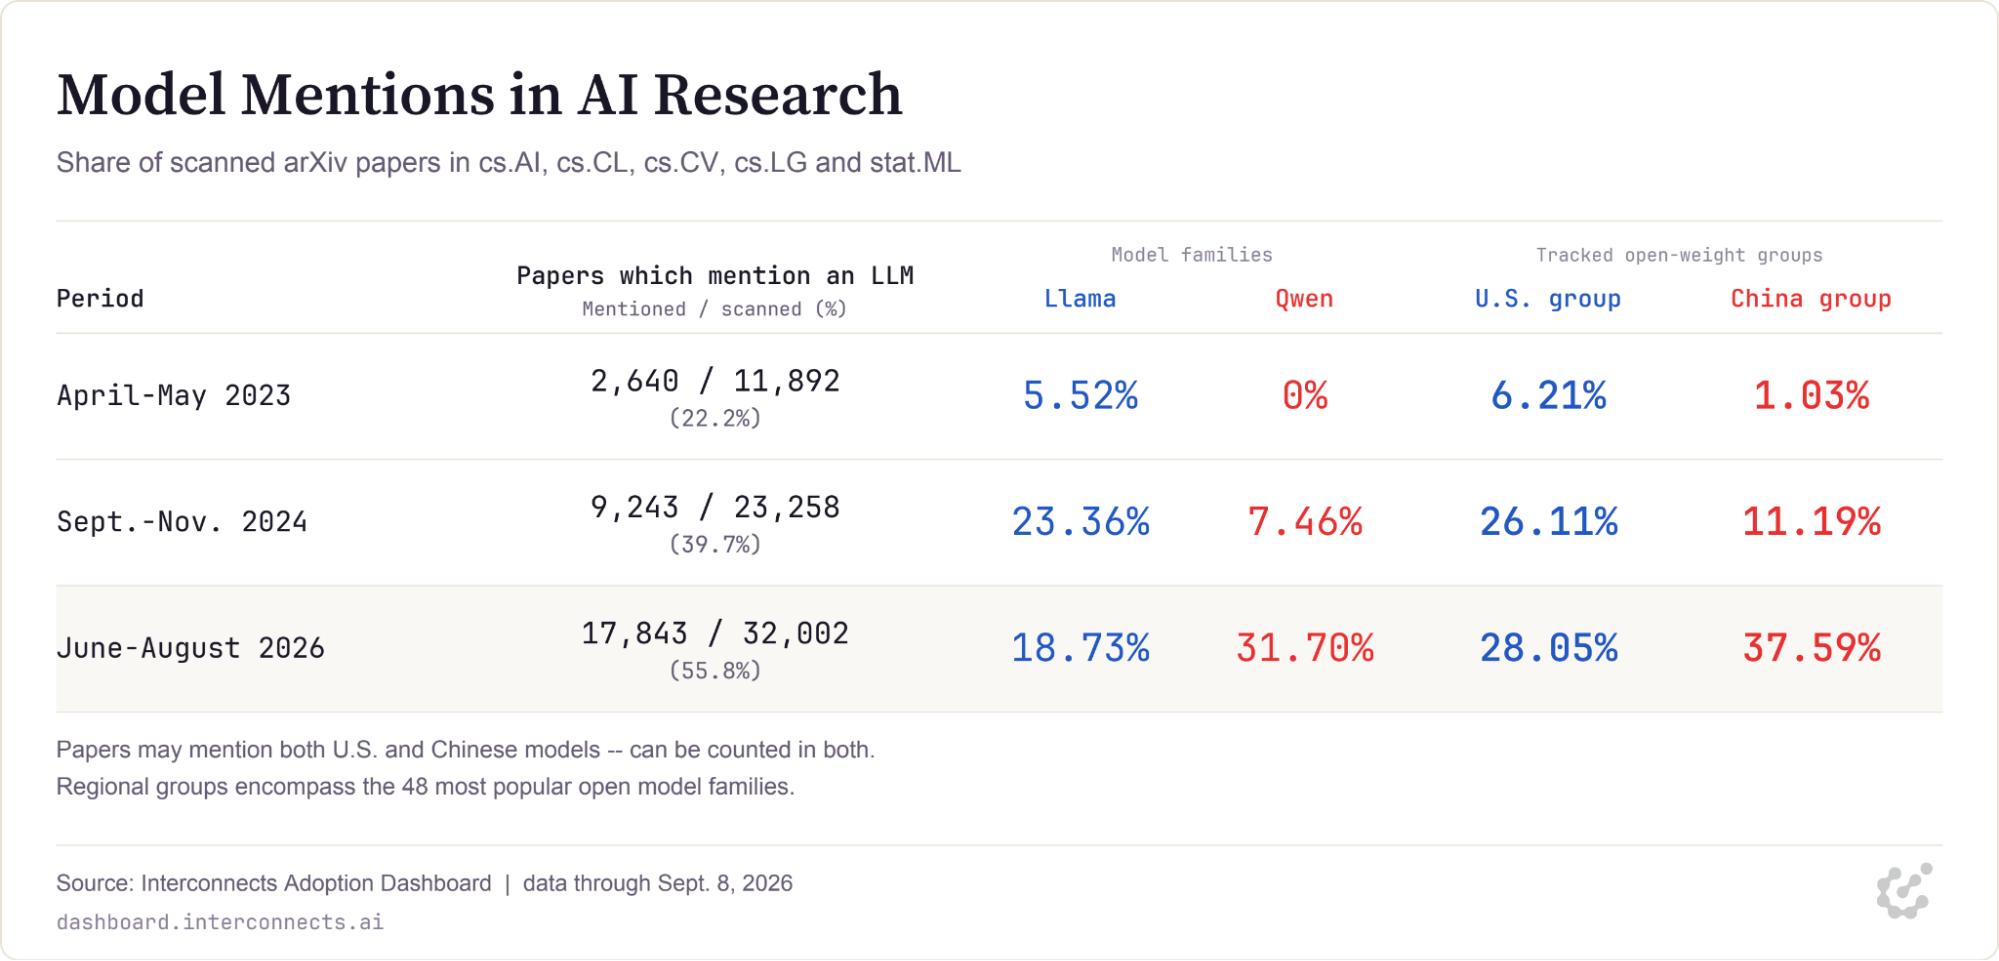
这表明,在开源权重语言模型时代,若要让美国重新确立其 AI 研究中心的地位,我们显然还有很多工作要做。不过,也出现了一些希望迹象。
在我们的研究中,我们发现,美国模型在其与中国同行相当的能力和规模区间内,采用了不成比例的高比率。在过去一年里,我们看到自 ChatGPT 以来 OpenAI 首个开源权重模型 gpt-oss 成为有史以来采用率最高的开源权重模型之一。自那以后,Google 的 Gemma 4 模型成为极少数在采用数量上能与 Qwen 最热门小型模型相提并论的模型,而 Nvidia 的 Nemotron 模型尽管在同一规模点上拥有更多具备更强能力的模型,其采用率却相对温和。
摘要
2026年,开源模型的叙事核心在于确立其经济价值。这是整个AI生态中多条发展线索的交汇,概括如下:
-
过去三年,用户可用的开源模型与闭源模型之间的差距正在
缩小
。这种差距因任务而异,大致可估算为2至5个月的能力代差。鉴于整体能力进展迅猛,这一趋势使开源权重模型在2026年解锁了庞大的市场,并预示着近期将迎来更多增长拐点。
-
开源模型在软件、
法律服务和
金融服务等高价值行业的使用量呈爆发式增长,预示着一种有别于顶尖闭源模型的替代生态正在兴起。Together、OpenRouter、Fireworks、Baseten等以开源模型推理为主的平台正迎来惊人增长,它们是开源模型后训练经济的早期受益者(其他层级还包括如Thinking Machines的Tinker等微调API)。这一趋势也得到了AI行业技术人员的大量实例佐证,他们因速度快、价格低、可定制以及隐私优势,选择使用GLM-5.3等开源权重模型作为Claude或GPT的替代品。
-
中国AI公司在开源权重模型领域处于绝对领先地位。相对于2025年DeepSeek R1等中国模型震惊AI界,美国实验室在开源权重模型上的地位已有所回升。但尽管美国方面投入巨大,中国实验室仍持续产出显著更强、备受各类用户青睐的模型。
过去三年,用户可用的开源模型与闭源模型之间的差距正在 缩小 。这种差距因任务而异,大致可估算为2至5个月的能力代差。鉴于整体能力进展迅猛,这一趋势使开源权重模型在2026年解锁了庞大的市场,并预示着近期将迎来更多增长拐点。
开源模型在软件、 法律服务和 金融服务等高价值行业的使用量呈爆发式增长,预示着一种有别于顶尖闭源模型的替代生态正在兴起。Together、OpenRouter、Fireworks、Baseten等以开源模型推理为主的平台正迎来惊人增长,它们是开源模型后训练经济的早期受益者(其他层级还包括如Thinking Machines的Tinker等微调API)。这一趋势也得到了AI行业技术人员的大量实例佐证,他们因速度快、价格低、可定制以及隐私优势,选择使用GLM-5.3等开源权重模型作为Claude或GPT的替代品。
中国AI公司在开源权重模型领域处于绝对领先地位。相对于2025年DeepSeek R1等中国模型震惊AI界,美国实验室在开源权重模型上的地位已有所回升。但尽管美国方面投入巨大,中国实验室仍持续产出显著更强、备受各类用户青睐的模型。
中国实验室对美国 AI 模型的蒸馏,并不能完全解释它们成功的原因。蒸馏是一种行业通用技术,即用某个通常更强的模型的输出来训练另一个 AI 模型。这一技术在中国 AI 行业最为普遍,它们利用一些基本漏洞,从美国公司防护不严的产品中提取推理轨迹和额外数据。据最乐观的估计,蒸馏能将中国公司与美国前沿水平的差距缩短 1-2 个月。
中国模型,尤其是阿里巴巴的 Qwen 系列,已成为学术界和本地模型用户研究与开发的基础层。近几个月,38% 的 AI 论文引用了中国开源权重模型,高于美国的 28%,且中国份额的增长速度远超美国。这一点,加上其他政治因素以及美国头部 AI 公司的封闭性,正在加速削弱美国作为全球最顶尖 AI 研究中心的领先地位。
开源权重模型的能力正在进入新阶段:大量模型可被获取,会带来网络安全等新风险,生态系统层面必须提前做好应对准备。这一新的风险时代也伴随着政治上的不确定:监管关注点集中在最强模型上,但政策如何合法落地仍存在巨大变数。与此同时,许多研究人员和工程师因为开源模型限制更宽松而依赖它们——Claude、GPT 这类闭源模型经常会拒绝关键的网络安全防御工作或生物学研究。
更多数据请查看 Interconnects Dashboard。
结论
2026 年,中国实验室显然仍在保持其开源权重 AI 生态引领者的地位。与此同时,开源权重模型已跨过商业可行性的拐点,而美国实验室的竞争活动也在加剧。中国头部实验室在全球范围内不断扩大企业和研究领域的采用,目前看不出受到了什么实质性的挑战。
开源模型生态系统的这一现状,恰逢整个 AI 生态发展的关键节点。我们看到 OpenAI 和 Anthropic 凭借其最新发布的公开模型迈出了巨大步伐,同时也呼吁各方就如何管理 AI 进步的下一阶段进行协调与审慎管理。当前,少数 AI 实验室内部(尤其是在人才密度和算力密度极高的环境下)正在发生的事情,预示着开源模型生态系统即将出现的趋势。开源模型将成为世界上除极少数真正的 AI 前沿实验室之外的所有人的基石,帮助他们驾驭软件工程及其他计算实践中的加速。对于那些能够促进对变革性智能进行广泛访问的组织而言,这将带来巨大的软实力、影响力以及潜在机遇。
随着这一未来临近,我们需要集体保持谦逊,不要对开源模型的确切发展路径做出武断判断。开源模型存在诸多未知因素——例如,我们缺乏关于美国和中国以外的国家如何应用这些模型的有效数据。鉴于机器学习训练专业知识的分布非常广泛,即数十个组织和成千上万名人员距离能力前沿仅在一年之内,开源模型跨越性能阈值、启用新工作流只是时间问题,而非是否可能发生的问题。集体应对策略应是理解如何利用这种广泛可及的开放智能行善,同时主动缓解潜在危害。
感谢 Florian Brand 和 Kevin Xu 对此工作的反馈和建议。欲了解支撑本文的更多研究,请参阅开源 AI 阅读列表。