
Cloudflare 再省 100 TB 内存:将服务器哈希数量削减 90%
Cloudflare 又节省了 100 TB 的 RAM again,这次是通过优化哈希映射算法实现的。Cloudflare 最大的业务场景之一是数据缓存,具体来说,就是从内存或磁盘直接提供 URL 内容,而不是从实时站点获取(这往往耗时较长)。该公司使用自研的开源 Pingora 框架 来完成将任意 URL 映射到其众多缓存服务器之一的工作,采用的是 Ketama 算法。这在概念上很简单,但在后端服务器随时动态增减的环境中会变得相当棘手;而在 Cloudflare 的规模下,难度更是倍增。
“后端路由”,即将 URL 映射到众多缓存服务器之一,需要内存中维护大量的表。传入的 URL 会被哈希处理(就像用 CRC-32 处理文件那样),得到的数值随即被转发到某台服务器。直觉上的做法是顺序处理,每台服务器对应一个 URL,但很快会遇到第一个问题:相同的 URL 无法始终指向同一台服务器。因此,你需要为服务器(例如使用其 IP 地址和名称)生成一个哈希值,并将两个哈希值按数值接近度进行匹配。
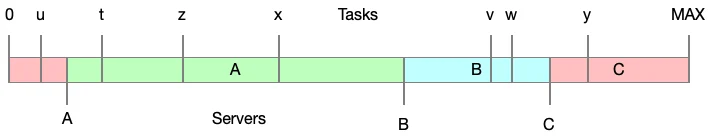
听起来很简单,而且确实有效,因为 URL 哈希值的分布实际上接近随机,请求会以公平的方式重定向到同一台服务器。但紧接着你会正面撞上第二个问题:假设有四台服务器,每台处理 25% 的请求,突然二号服务器因为有人绊到电源线而下线了。你就得把它原本处理的请求重定向到哈希表中最近的服务器,结果导致三号服务器(下一个)过载,而一号和四号服务器则依然负载很低。
解决这个问题的办法,是增加每台服务器的哈希数量并随机混合。这样一来,四台服务器上的大量哈希就呈随机分布,即使其中一台宕机,进来的请求也能均匀地分配给剩下的服务器。但这会消耗大量内存。一旦你配置了带权重规则的层级(让大服务器处理更多请求),再加上内容限制和架构区域决定了并非所有服务器都能响应所有请求,内存消耗会进一步攀升。综合来看,Cloudflare 每台机器最多需要维护 10 万条服务器哈希,导致 RAM 需求急剧膨胀。
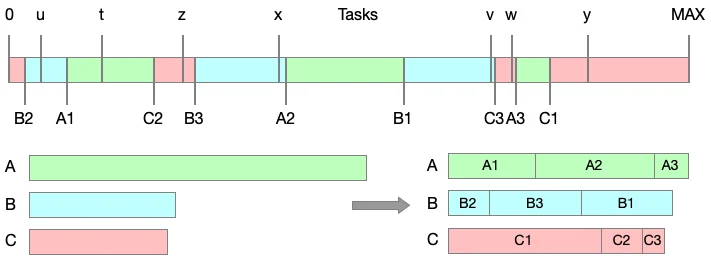
经过一番精心的代数与基础统计学推算,Cloudflare 的工程师得出结论:使用 10 万条哈希早已远远超过了边际收益递减的临界点。团队算出来,只需其中 10% 的量就足以获得几乎相同的结果——因为超过 1 万条后,每再增加一个数量级,错误率的下降微乎其微。随后,他们对 Rust 的数据结构进行了一番精细的整理,让哈希-服务器映射表中的每条记录省下 2 字节。2 字节听起来微不足道,但乘上数十亿条记录,效果就很可观了。
总而言之,这项优化让 Cloudflare 总共省下了约 100 TB 的 RAM。为了稳妥起见,团队把这个“v2”算法做成一条独立的代码路径,而不是直接替换旧代码——这样万一出问题,随时可以切回原方案。要是现代软件都能如此审慎地对待资源使用就好了。