
什么时候值得采用规范驱动开发
验证成了新的瓶颈
AI 编程助手已经不是什么新鲜事,而是逐渐变成了软件开发的基础设施。在 2026 年的今天,大多数工程团队每周都在用编程助手。AI 生成的代码开始组成了越来越多的生产环境代码,并且覆盖了全部的软件开发生命周期。但问题也随之而来:AI 让代码产出越来越多,但没能让人们更有把握地确认这些代码是否正确、安全,以及是否真正符合最初的意图。 一些受控研究显示,AI 确实带来了实际的生产力提升,但在真实生产环境中也出现了开发速度减缓和质量问题。与此同时,越来越多的实证研究发现,进入生产环境的 AI 生成代码中,依然存在安全漏洞、常见的 Bug 类型,以及一些不易察觉的行为偏离。
于是,瓶颈变了。过去瓶颈是在“写代码”,现在瓶颈成了“验证代码”。不过这也让真正棘手的问题从“模型能力够不够”变成了治理问题:谁应该对 AI 生成代码的行为负责?如何发现代码已经偏离了原本的意图?人和模型又该如何分担监督这项工作?
这个问题在 2026 年第二季度已经不再只是纸上谈兵,因为相关要求正在陆续落地。EU AI Act 针对高风险 AI 提出了风险管理、记录保存以及有效人工监督等要求。ISO/IEC 42001 要求建立有文档记录的 AI 管理体系,并配套控制措施和审计轨迹。NIST AI 风险管理框架则将类似要求归纳为 Govern、Map、Measure 和 Manage 四个部分。如果越来越多的生产代码由 AI 生成,那么仅仅说“我们会认真审核 AI 的输出”,其实很难说明风险管理、记录保存和人工监督这些控制措施究竟是怎么落实的。
目前比较常见的一种做法,是不仅审查代码,也审查规范。也就是说,把规范当成 AI 必须遵守的契约,在生成代码之前先进行审查,再要求生成的代码符合这份规范。我认同这种思路,但我也想知道,它到底能不能经得起实际测量。于是,我围绕其中最核心的一个环节做了一项研究:由人来对照一份经过批准的基线,审查 AI 生成的代码。
研究结果让我重新思考了自己该如何论证这整套方法,这也是我写下这篇文章的原因。规范基线并没有让评审人员发现更多 Bug。它真正改变的是:评审人员发现的问题,有了明确的依据,也因此能够追溯和问责。搞清楚这两者之间的区别很重要,因为只有这样,你才能判断:使用 AI 所付出的这些额外成本,到底什么时候值得。下面的结论来自我参与的一项研究,该研究已经被 GAISS 2026 收录 。需要说明的是,这些结果仍属于初步、方向性的发现,样本量较小,涉及的任务也不多。后文我会逐一说明这些结论的局限性。
将规范视作治理的基线
规范(Specification)是在开始构建软件之前,对软件应该做什么形成的书面、共同认可的描述,其中包括需求、接口以及可测试的行为。在这项研究中,一份规范分为三层:规范本身,也就是业务需求和规则;高层设计(HLD),用于定义组件及其接口;以及低层设计(LLD),用于明确每个方法必须满足的具体不变量。举个例子,一个资金转账服务的规范会制定这样一条业务规则:“转账绝不能让账户余额变成负数。”
其中,规范的 HLD 会定义一个 TransferService 接口,其中包含 transfer 操作,也就是指定转出账户、转入账户和金额。LLD 则进一步把这条要求变成可以测试的不变量:如果转账金额超过可用余额,就必须拒绝转账,同时不能产生任何账本记录。之后审查 AI 生成的代码时,依据的就是这些具体规则。
为了让这个过程更直观,我们来看研究中实际使用的一条基线,它贯穿上述三个层次。
在规范层,一条业务需求规定:转账必须以原子方式在账户之间移动资金;同一个幂等 Key 最多只能执行一次;并且绝不能凭空产生或销毁资金。
到了 HLD 层,这些要求被转化为一个契约:Bank 组件提供一个转账操作,包含 from_id、to_id、amount 和 idempotency_key;转账、验证和有序审计历史则被定义为相互独立的子系统。
在 LLD 层,同样的要求进一步落实成可测试的方法契约:查询两个账户,账户不存在则抛出异常;如果幂等 Key 已经执行过,则直接返回此前的结果,不得再次转移资金;接下来检查余额是否充足,如果不足,则终止操作,并且不能改变任何一个账户的状态;然后将源账户扣款和目标账户入账作为一个整体执行,同时分别追加历史记录。
这些要求都对应着一个有名字的不变量,代码审查时可以直接引用,例如 transfer_idempotent、transfer_atomic_on_fail、transfer_moves_funds 和 assets_conserved。完整的基线在核心资金操作、转账、利息、每日限额、账单和账户生命周期等方面,共定义了 20 个这样的不变量。这份编号后的不变量列表,就是代码审查用来检查生成代码是否发生偏离的契约。
在展示研究结果之前,我们先看看这套测试中的治理模型。核心思路是:不要把规范当作是提示词的装饰品,而要把它当成治理工件——一份经过审查、批准并版本化的契约,所有控制点和责任归属都应以它为依据。
它建立在三个原则之上:在输出之前先治理输入,因为审查规范的成本低于修改已经生成的代码;让基线明确且可审计,把经过批准基线、高层设计和低层设计作为一个统一的参考基线;以及让人在关键判断环节参与,而不是让人承担大量机械检查工作。自动化负责发现偏离,再由专人来判断什么才是正确的。
这种方法会形成五个生命周期控制点,每个控制点都会产生一个工件,供下一环节继续使用,如表 1 所示。
表 1:规范治理的五个生命周期控制点,每个控制点都会产生供下一环节使用的工件。
关键不只是存在这五个控制点,而是每个控制点都会留下具体记录。已批准的基线记录了人类认可的系统应该如何运行;代码生成记录将代码与特定版本的基线关联起来;偏离日志记录实现在哪些地方偏离了基线;核查记录则记录人类如何处理这些偏离。这些工件组合在一起,就把“我们审查过 AI 的输出”变成了一个真正可以追溯、解释和审计的流程。
如图 1 所示,最终形成的架构不是单向的 Prompt,而是一个迭代循环:先编写并批准基线,模型根据特定版本生成代码,再针对同一版本检测偏离,由人来处理每一项有意义的偏离。如果设计发生变化,就回到评审关卡;如果发现代码缺陷,则回到生成或实现环节。整个过程产生的记录共同构成审计轨迹。
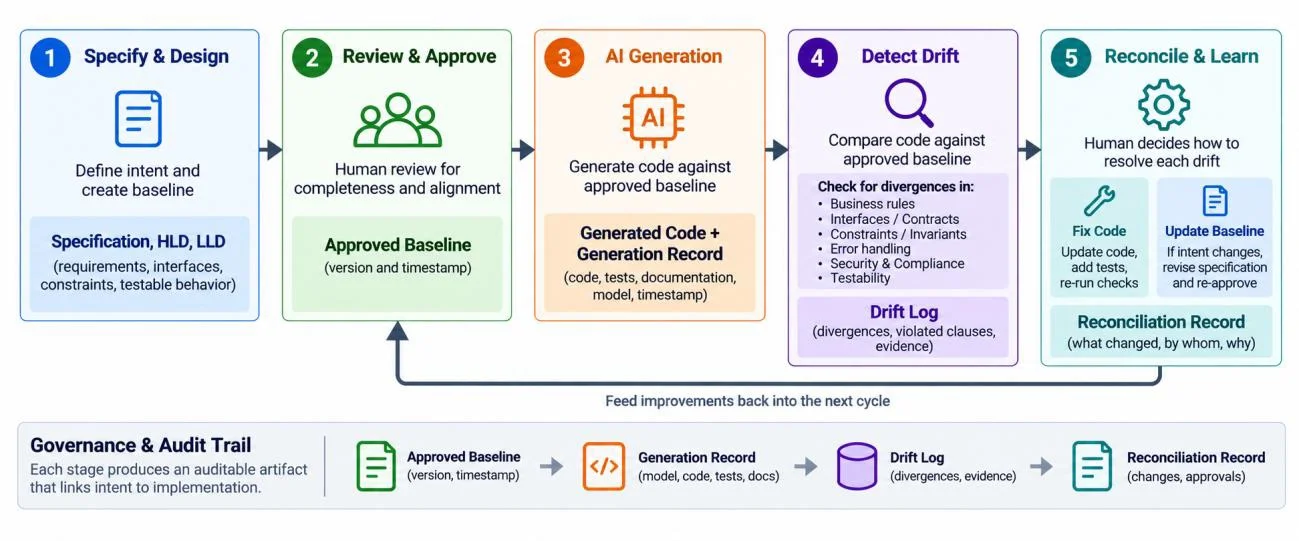
图 1:面向 AI 生成代码的规范驱动治理循环(