
《AI大模型第3期》| 大模型 + 遥感(RS)——让卫星影像“自己解释自己”
你好,欢迎来到「大模型公开服务赋能GeoAI」专栏的第三期。
前两期我们聊了大模型怎么和GIS结合——让空间数据“开口说话”。这一期,我们抬头看天——让卫星影像“自己解释自己” 。
如果你做过遥感影像解译,你一定体验过那种“盯着屏幕看一天,眼睛快瞎了”的感觉。传统遥感解译流程大致是:获取影像→预处理→人工判读→矢量化→生成报告。效率低、成本高、依赖专家经验。
而现在,多模态大模型正在彻底改变这件事。
你不再需要逐像素地看,不再需要逐地块地画——你只需要上传一张影像,问一句“这张图里有什么”,大模型就能给你一个条理清晰的回答。
这不是科幻。这是已经发生的事。
一、首先理解一个核心转变:从“像素级处理”到“语义级对话”
传统遥感解译,本质上是像素级的工作——你盯着每一个像元,判断它是水体、植被、建筑还是裸土。
大模型时代的遥感解译,本质上是语义级的对话——你把一张影像“说”给模型听,模型用自然语言告诉你它“看到”了什么。
这个转变的关键,是多模态大模型(MLLM, Multimodal Large Language Model) 的出现。
多模态大模型不仅能“读文字”,还能“看图”。你给它一张遥感影像,它能:
- • 图像描述(Image Captioning) :用一段话描述影像整体内容
- • 视觉问答(VQA, Visual Question Answering) :回答你关于影像的具体问题
- • 视觉定位(Visual Grounding) :在影像中定位到你问的那个物体
- • 目标检测与关系分析:识别影像中的物体并分析它们之间的空间关系
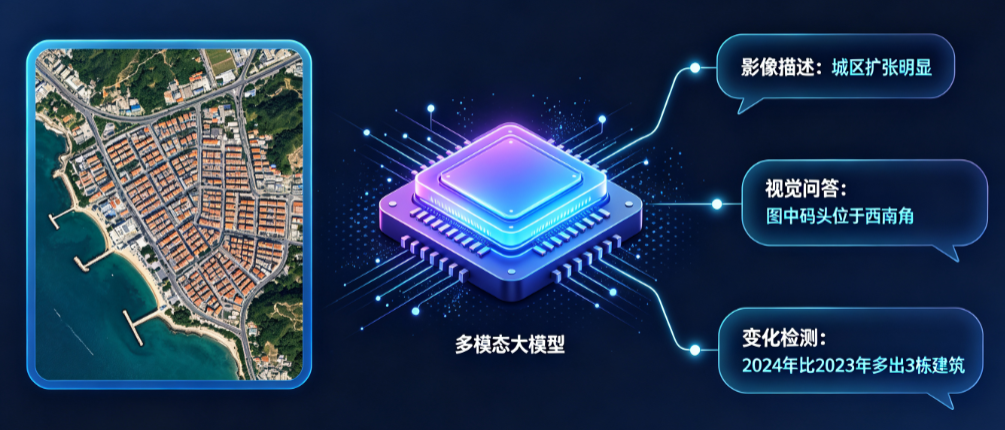
💡 一句话理解:传统方法是“人看图、人说话”;多模态大模型是“机器看图、机器说话”——你把遥感影像喂给它,它用自然语言告诉你它看到了什么。
二、市面上有哪些可用的遥感多模态大模型?
过去两年,学术界和工业界涌现了一大批专门针对遥感影像的多模态大模型。以下是几个代表性模型:
1. EarthGPT-X——多源遥感影像的“全能选手”
北京理工大学毛雪瑞教授团队推出的EarthGPT系列,是遥感领域最早的一批通用大模型之一。最新版本EarthGPT-X是首个能够统一处理多源遥感影像(光学、SAR、红外)的灵活空间多模态大模型。
核心亮点:
- • 支持点、框、自由形状等多种视觉提示——你可以在图上圈个框,然后问“这个区域里有什么”
- • 支持场景级理解到细粒度目标属性分析的层次化空间推理
- • 在多项遥感视觉任务上大幅超越此前的自然场景和遥感领域多模态大模型
- • 代码和数据集已在GitHub开源:https://github.com/wivizhang/EarthGPT-X
2. GeoLLaVA-8K——能吃下8K超高分影像的“火眼金睛”
超高分辨率遥感影像对多模态大模型一直是个挑战——影像太大,token爆炸。GeoLLaVA-8K是首个能处理8K×8K分辨率输入的遥感多模态大模型,基于LLaVA框架构建。
核心亮点:
- • 提出了背景token剪枝和锚点token选择策略,在保留关键语义的同时大幅降低显存占用
- • 构建了SuperRS-VQA(平均8376×8376)和HighRS-VQA(平均2000×1912)——遥感领域分辨率最高的视觉-语言数据集
- • 在XLRS-Bench上达到了新的SOTA(State-of-the-Art)
- • 代码已开源:https://github.com/MiliLab/GeoLLaVA-8K
3. LHRS-Bot / LHRS-Bot-Nova——用众包地理信息“喂”出来的遥感专家
南京大学团队开发的LHRS-Bot是一个利用全球志愿者地理信息(VGI)增强的多模态大模型。升级版LHRS-Bot-Nova在ISPRS Journal of Photogrammetry and Remote Sensing上发表,进一步提升了遥感视觉-语言解译能力。
核心亮点:
- • 利用OpenStreetMap等众包地理信息增强遥感影像理解
- • 在ECCV 2024上被接收
- • 模型权重和训练代码已开源:https://github.com/NJU-LHRS/LHRS-Bot
4. EarthDial——IBM的多传感器对话助手
IBM研究院开发的EarthDial是一个专门为地球观测数据设计的对话式助手,能将复杂、多传感器的地球观测数据转化为交互式自然语言对话。
核心亮点:
- • 支持多光谱、多时相、多分辨率影像
- • 构建了超过1111万条指令微调数据集,覆盖RGB、SAR、近红外、红外等多种模态
- • 支持双时相和多时相序列分析(如变化检测)
- • 在44个下游数据集上 outperforms 现有通用和领域专用模型
- • 代码已开源:https://github.com/hiyamdebary/EarthDial
5. OpenEarthAgent——会“动手”的地理空间智能体
以上模型主要解决“感知”问题——看懂影像。但遥感分析往往需要“动手”——计算指数、做空间分析、生成报告。OpenEarthAgent(MBZUAI开发,40亿参数)正是为了解决这个问题而生的。
核心亮点:
- • 首个专门针对地球观测设计的工具增强型智能体框架
- • 整合了多光谱分析、地理空间操作和自然语言理解
- • 支持结构化、多步骤推理,能自主调用工具完成复杂分析任务
- • 在Featherless.ai上提供API调用
- • 开源地址:https://github.com/mbzuai-oryx/OpenEarthAgent
三、普通人能用的公开服务平台
上面的模型大多需要一定的技术门槛。但好消息是,已经有一些零门槛的公开服务平台可以让你直接上手体验:
1. Axion Planetary MCP——像聊天一样分析卫星影像
Axion Planetary MCP是一个基于AWS的地理空间AI分析平台,让你通过自然语言就能完成卫星影像分析。
怎么用:
- • 在Claude Desktop中配置Axion MCP服务
- • 然后你就可以像这样提问:“Show me the NDVI vegetation map of Central Park, New York”
- • 支持农业监测、环境监测、城市规划等多种场景
核心功能:Axion还包含一个专有的SAR-to-Optical基础模型,能将合成孔径雷达影像转换为类光学影像,实现全天候、全天时的对地观测。
获取方式:通过邮件或在GitHub上申请API Key。
2. Earth Index——用AI搜遍整个星球
Earth Index是由非营利组织Earth Genome开发的AI卫星影像搜索工具。2026年4月,它正式向公众开放,推出了免费的“Open”层级。
怎么用:
- • 访问 app.earthindex.ai 即可使用
- • 无需编码技能,通过标注几个示例就能让AI找到你想要的任何景观特征
- • 基于Sentinel-2卫星数据运行
- • 特别适合解决“大海捞针”类的问题——比如找矿区、找毁林区域、找土地利用变化
进阶功能:付费用户可获取“Deep Search”(深度搜索)和API访问权限。
3. IBM-NASA Prithvi-EO 2.0——开源的地球观测基础模型
Prithvi-EO 2.0是NASA和IBM联合开发的时空地理空间基础模型,由来自美国、欧洲、巴西12个机构的42名成员协作完成。
核心数据:
- • 在420万多时相影像序列上训练
- • 能够捕捉地球表面的季节性和长期动态变化
- • 在Hugging Face和IBM TerraTorch上开源提供
- • 可通过Replicate平台用API调用
特别适合:土地利用分类、灾害监测、生态系统变化分析等任务。
四、实战案例:DeepSeek在国内遥感领域的落地
除了学术模型和海外平台,DeepSeek在国内遥感领域的应用也已经有了一批非常扎实的落地案例:
案例一:乌鲁木齐市测绘院——DeepSeek深度赋能遥感影像解译
2025年1月20日,DeepSeek-R1模型正式发布后,乌鲁木齐市城市勘察测绘院第一时间将DeepSeek部署在内网云算力平台中,将其与测绘生产管理系统融合,构建了覆盖遥感影像解译、数据查询分析、智能办公、WebGIS开发等核心业务的应用矩阵。
实际成效:突破了传统关键词匹配的局限,升级为认知智能协作,极大提升了日常办公和研发工作的准确度和效率。同时,基于DeepSeek的深度推理能力,研发了地面+低空智能测绘网络平台,为自然资源、城市规划提供现势性更高、类目更丰富的测绘产品。
案例二:长春市——“长春慧眼”遥感智能解译模型
长春市围绕规划和自然资源管理构建样本库,训练升级了遥感智能解译模型——“长春慧眼”。
实际成效:6人10天内完成全市域25000平方公里范围内新增建设用地和耕地变化图斑的提取。实现了违法建设和违法用地行为的 “早发现、早预警、早制止、早整改” 。
案例三:星载智能计算平台——DeepSeek上卫星
星测未来团队在星载智能计算平台(海月02Pro)上部署了DeepSeek-Janus-Pro(7B版本)。
实测数据:输入一张1080p的遥感影像,模型分析并输出文本描述,推理时间约6秒,系统整体峰值功耗不高于70W(含FPGA和电源)。
这意味着——大模型遥感解译已经可以上卫星了。
五、动手实战:用多模态大模型分析一张遥感影像
如果你暂时没有申请到上述平台的API,别急——你手头的通用多模态大模型也能做遥感影像分析。
以下平台都支持图像上传+问答,你可以直接用它们来分析遥感影像:
| 平台 | 多模态能力 | 免费额度 | 操作方式 |
| 通义千问(Qwen3-Omni-Flash) | 支持图像理解 | 新用户7000万token | 网页/API上传图片提问 |
| 豆包(Seed 2.0系列) | 支持多模态 | 50万token/月 | 网页/API上传图片提问 |
| 智谱AI(GLM-4V系列) | 支持视觉理解 | 新用户2000万token | 网页/API上传图片提问 |
| Kimi | 支持图像识别 | 网页版免费 | 网页上传图片提问 |
实战步骤:
Step 1:找一张遥感影像截图(可以从Google Earth、Sentinel Hub或国内的地图服务中截取)
Step 2:打开任意一个支持多模态的平台(推荐通义千问或豆包,免费额度充裕)
Step 3:上传影像,输入以下问题试试:
- • “请描述这张遥感影像中的主要地物类型”
- • “这张图中哪里有水体?哪里有建筑区?”
- • “请分析这张影像中的植被覆盖情况”
- • “图中是否有明显的道路网络?请描述其走向”
Step 4:对比不同平台给出的回答,看看谁“看”得更准
如果你希望将大模型能力集成到自己的工具链中,下面提供两段开箱即用的Python代码,分别对接通义千问和智谱AI的多模态API,帮你快速上手。
方案一:使用通义千问(Qwen-VL)分析遥感影像
优势:新用户免费额度超7000万token,识别准确率高,支持中文。
# 安装依赖库
# pip install dashscope pillow

import dashscope
from dashscope import MultiModalConversation
import base64

# 配置你的API Key(在阿里云百炼平台获取)
dashscope.api_key = "sk-xxxxxxxxxxxxxxxxxxxxxxxx"  # 替换为你的真实Key

def analyze_rs_image_with_qwen(image_path, user_question):
    """
    使用通义千问多模态模型分析遥感影像
    :param image_path: 本地遥感影像路径(支持jpg/png)
    :param user_question: 你想问的问题(如"图中哪里有水体?")
    """
    # 读取图片并转为Base64
    with open(image_path, 'rb') as f:
        img_data = f.read()
    base64_image = base64.b64encode(img_data).decode('utf-8')

    # 构造多模态消息
    messages = [{
        "role": "user",
        "content": [
            {"image": base64_image},
            {"text": f"你是一名资深遥感解译专家。请根据这张遥感影像,回答以下问题:{user_question}。请用中文详细描述,并尽量指出地物的大致分布特征。"}
        ]
    }]

    try:
        response = MultiModalConversation.call(
            model="qwen-vl-plus",  # 也可以换成 qwen3-vl-flash(性价比更高)
            messages=messages
        )
        print("🤖 大模型分析结果:")
        print(response.output.choices[0].message.content[0]["text"])
    except Exception as e:
        print(f"❌ 调用失败,请检查网络或Key:{e}")

# 实战运行示例
if __name__ == "__main__":
    # 假设你截取了一张包含城市、河流、公园的卫星图,命名为 "city_satellite.jpg"
    analyze_rs_image_with_qwen(
        image_path="./city_satellite.jpg",
        user_question="请识别图中的主要地物类型,并分析植被覆盖区域与建筑区的空间关系。"
    )
方案二:使用智谱AI(GLM-4V-Flash)分析遥感影像
优势:GLM-4V-Flash 目前有永久免费额度,适合零成本长期使用。
# 安装依赖库
# pip install zhipuai

from zhipuai import ZhipuAI
import base64

# 配置你的API Key(在智谱开放平台获取)
client = ZhipuAI(api_key="xxxxxxxxxxxxxxxxxxxxxx")  # 替换为你的Key

def analyze_rs_image_with_glm(image_path, user_question):
    """
    使用智谱GLM-4V多模态模型分析遥感影像
    """
    # 读取图片并转为Base64
    with open(image_path, "rb") as f:
        img_base = base64.b64encode(f.read()).decode('utf-8')

    # 构造请求
    response = client.chat.completions.create(
        model="glm-4v-flash",  # 永久免费版本
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "type": "image_url",
                        "image_url": {
                            "url": f"data:image/jpeg;base64,{img_base}"
                        }
                    },
                    {
                        "type": "text",
                        "text": f"你是一名遥感影像分析专家。根据这张影像回答:{user_question}。请详细描述你看到的地物特征及空间分布。"
                    }
                ]
            }
        ]
    )

    print("🤖 GLM-4V 分析结果:")
    print(response.choices[0].message.content)

# 实战运行示例
if __name__ == "__main__":
    analyze_rs_image_with_glm(
        image_path="./farmland_ndvi.jpg",
        user_question="这张影像中的农作物长势如何?是否存在明显的水体或裸土区域?"
    )
💡 代码小贴士:建议先从Google Earth或Sentinel Hub截取一张公开样例影像保存在本地,再运行上述代码。运行前请确保已安装依赖库(
pip install dashscope zhipuai)。
六、未来已来:从“看图说话”到“智能分析”
这一期我们聊了很多,但我最想让你记住的是这句话:
遥感影像解译正在从“专家盯着看”变成“AI对话着看” 。
过去,解译一张遥感影像需要专业的遥感知识和大量的时间。现在,你只需要上传一张图、问一个问题——大模型就能给你一个初步的分析结果。
当然,大模型目前还不能完全替代专业的遥感处理软件(如ENVI、ERDAS)——精确的辐射校正、几何校正、分类精度评估等工作仍然需要专业工具。但大模型正在成为遥感从业者的“智能副驾驶” ——帮你快速理解影像内容、生成初步解译报告、发现值得深入关注的区域。
未来,随着更懂空间的多模态模型(如EarthGPT-X、GeoLLaVA-8K)、更自主的智能体(如OpenEarthAgent)和更轻量的边缘部署(如星载DeepSeek)的持续进化,遥感影像分析的效率和智能化水平还将迎来质的飞跃。
七、本期作业
- 1. 找一张遥感影像截图(Google Earth、Sentinel Hub或任何地图服务都可以),上传到你手头的多模态大模型平台(通义/豆包/智谱/Kimi),至少问它3个关于影像内容的问题
- 2. 如果你有技术基础:尝试申请Axion Planetary MCP的API Key,在Claude Desktop中配置并试一次自然语言遥感分析
- 3. 如果你会Python:运行本期提供的代码,把大模型的分析结果与自己的判读做一次对比
- 4. 把你得到的结果截图发在评论区——哪个模型“看”得最准?哪个回答最实用?下期我会选取典型案例进行点评
下一期,我们将进入大模型+测绘的实战——从数据生产到智能管理,看看大模型如何改变测绘行业的工作方式。不见不散!
📌 参考资料:本期内容参考了NeurIPS 2025、CVPR 2025、ECCV 2024、ISPRS Journal of Photogrammetry and Remote Sensing等顶级会议和期刊的最新研究成果,以及DeepSeek在国内测绘遥感领域的多个实际落地案例。
💬 你用大模型分析过遥感影像吗?遇到了什么问题?发现了什么惊喜?欢迎在评论区分享!