
腾讯 Gander:在后台处理任务时保持实时对话
要点
- 腾讯的 Gander 旨在边进行实时对话、边在后台处理复杂任务。它能同时处理语音、图像和文本,用户可随时打断。
- 一个"小脑"逐秒管理对话,一个可替换的"大脑"负责复杂的 agent 任务。这种拆分设计是为了在保证响应速度的同时不牺牲规划深度。
- 测试中,Gander 打断用户的次数少于竞品模型,但任务准确率落后,且在视频和音频理解方面存在短板。团队计划开源模型权重和训练数据,代码的 GitHub 仓库已上线。
腾讯的研究模型 Gander 把实时对话和 AI agent 能力结合在一起:由"小脑"负责对话,可替换的"大脑"处理复杂任务。用户可以随时打断,但测试显示,对话节奏与任务准确率之间存在权衡。
腾讯混元语音团队联合多所高校的研究人员推出了 Gander,这是一个能在处理复杂任务的同时持续聊天的 AI 模型。技术报告显示,它可同时接收语音、图像和文本输入。
研究人员指出,如今的语音助手大多只能和用户一问一答、轮流说话。而真实对话中,人们会互相打断、即时反馈,甚至边说边听。Gander 的设计目标正是应对这种你来我往的交流:它能持续处理视频、语音和文本,即使在说话时也不例外。用户可以随时插话,模型也会主动追问或汇报任务进展,无需用户提示。
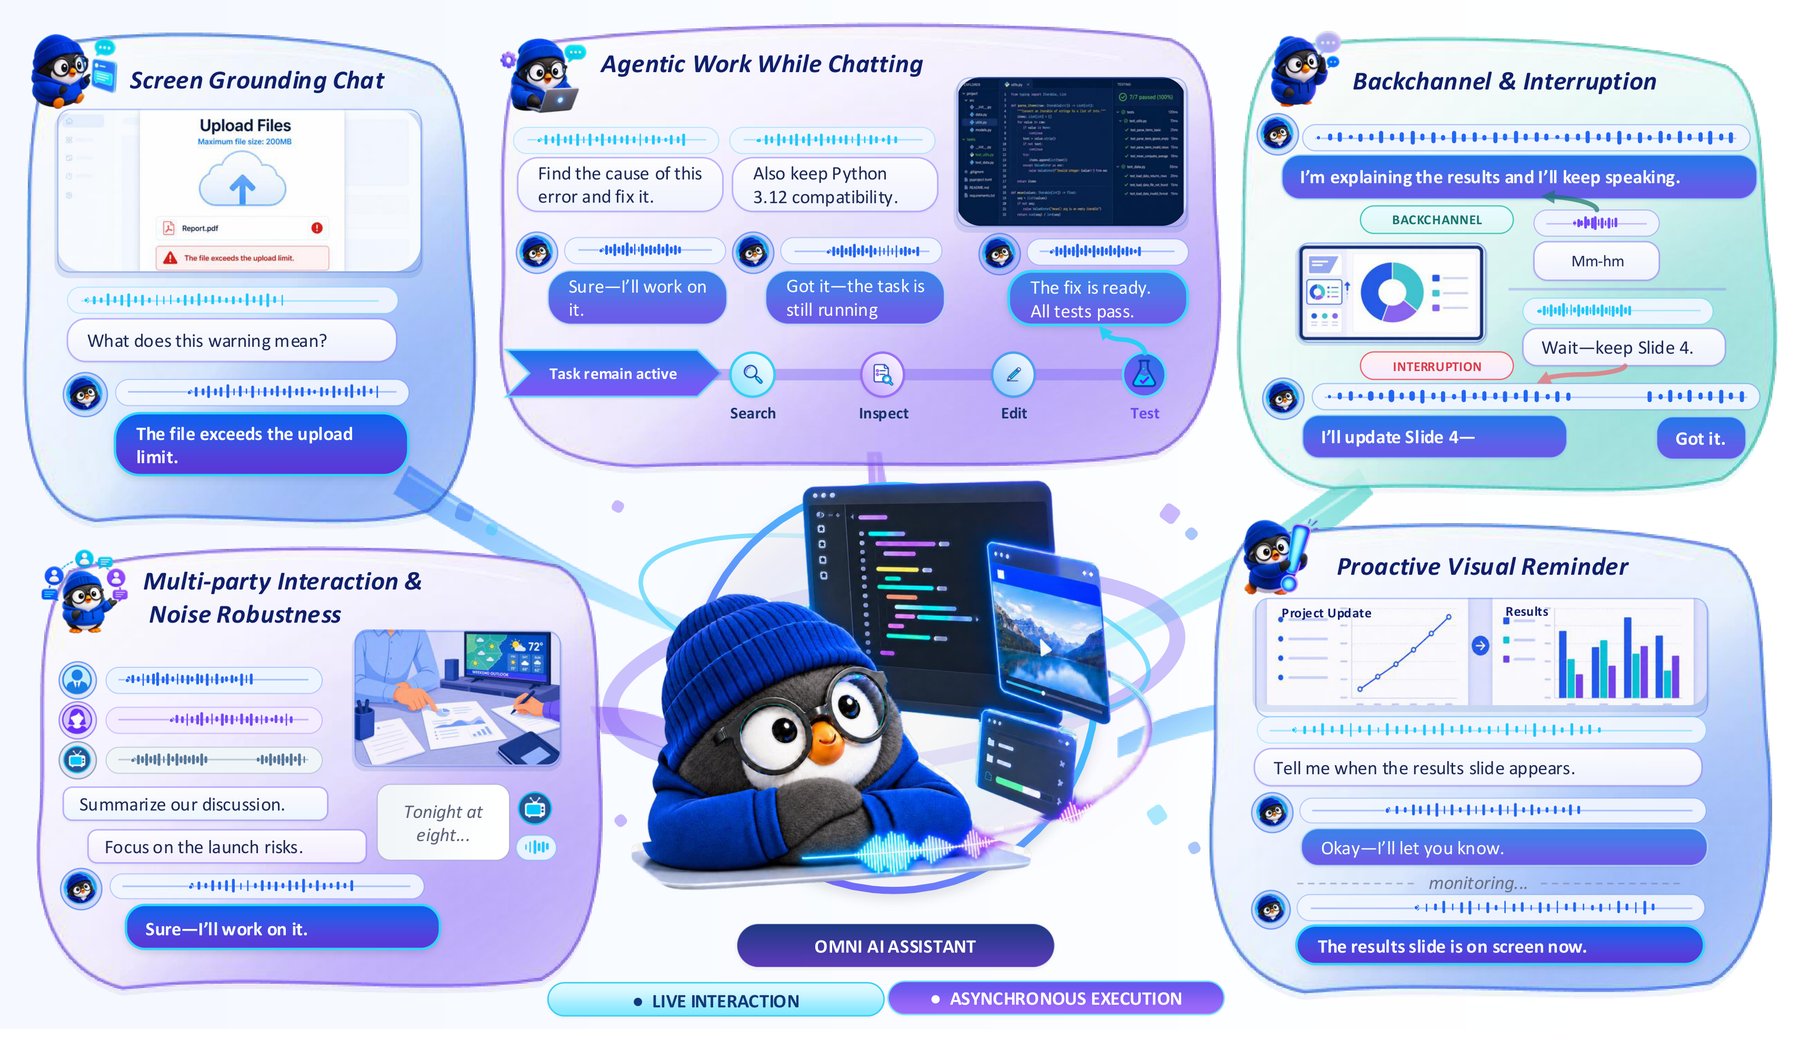
Gander 在“大脑”工作期间维持对话
对话需要即时响应,但搜索文件或编写代码需要时间进行规划。研究人员认为,单一模型必须在响应速度和推理能力之间寻求平衡,因此 Gander 将工作拆分给两个角色。
借鉴人体解剖学概念,他们将其称为“小脑”和“大脑”。“小脑”负责实时对话,而“大脑”则处理后台的推理和复杂任务。
“大脑”部分可以替换为 Codex 或 Claude Code 等代理系统,且无需重新训练对话模型。在测试中,OpenAI GPT-5.6 系列中一款未具体命名的模型承担了这一角色。随着底层模型的改进,整个系统都能受益。
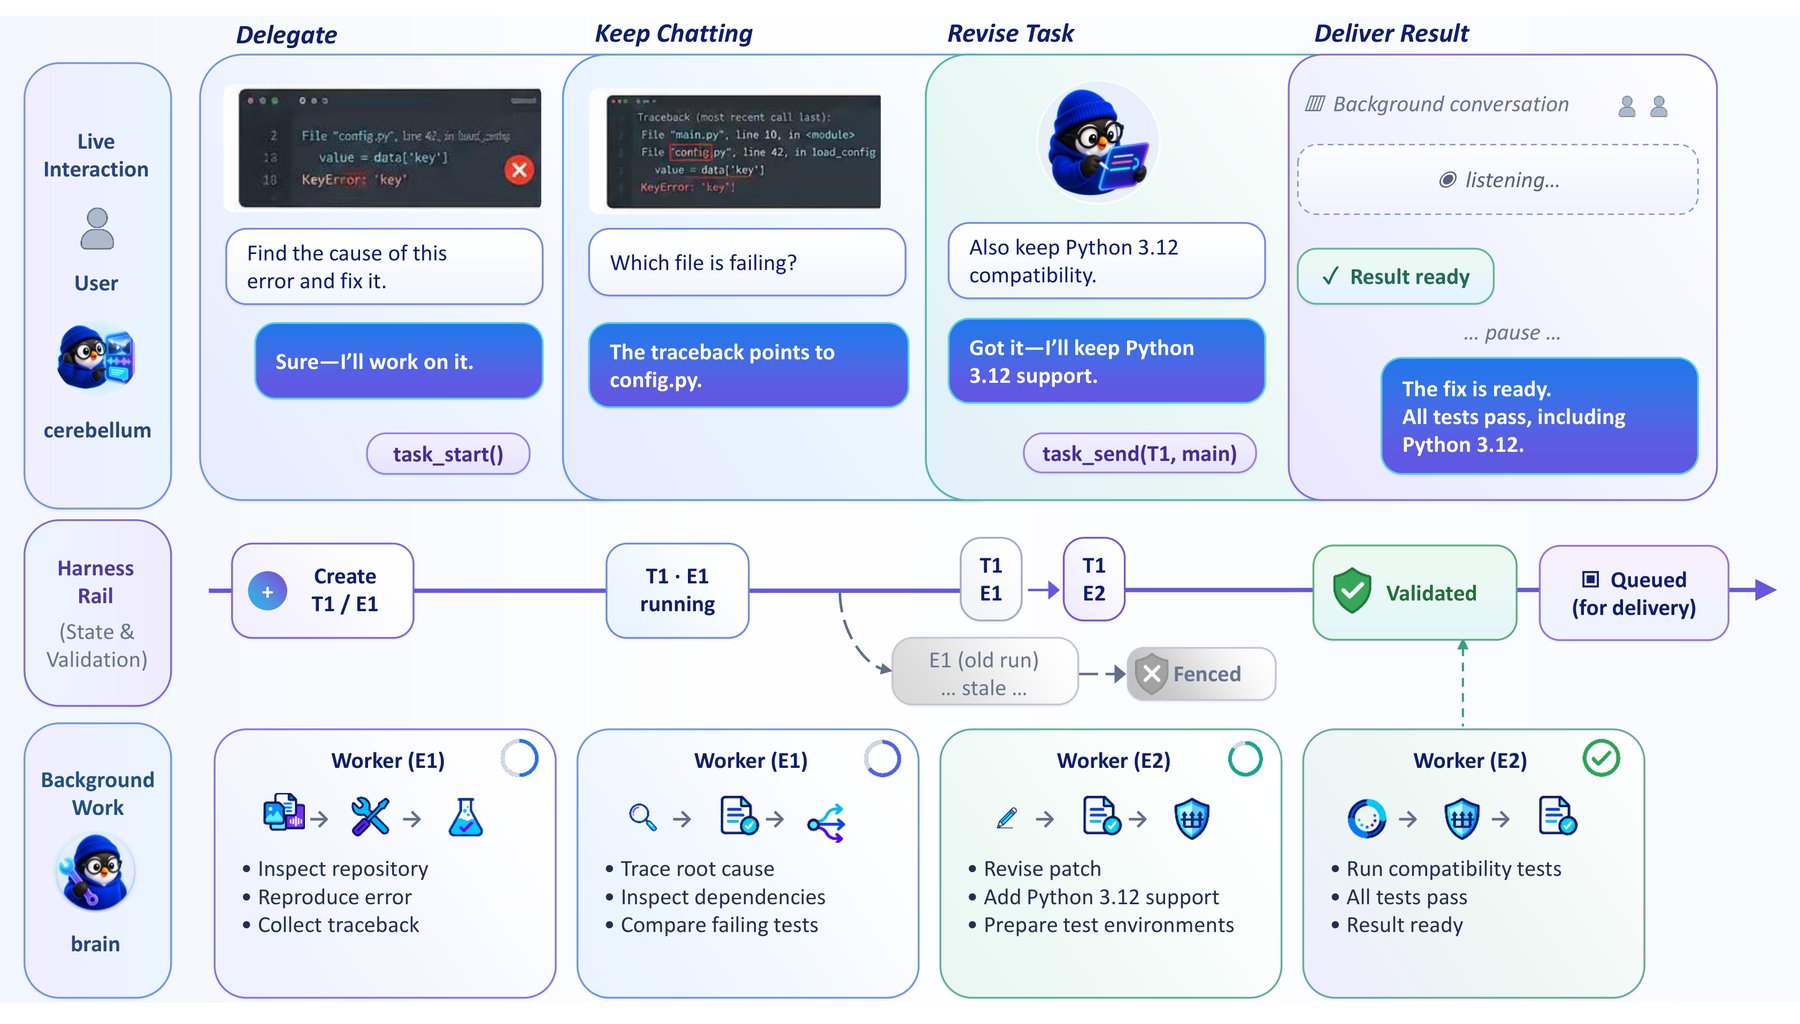
Gander 时序准确,但任务准确率稍逊一筹
Gander 将对话切分为一秒的片段,由小脑模块根据用户是否打断来决定何时聆听、发言或停止。它无需单独的模块来检测语音起止,而是利用过去两分钟的对话内容作为记忆基础。
目前尚无专门针对 Gander 这类模型的测试,研究人员因此采用了现有的基准测试。报告指出,在测试语音助手在不同任务场景中表现的全双工基准 Full-Duplex-Bench v3 上,Gander 的时机把握最佳。
Gander 在所有 100 个场景中都能恰当时机开口,在 8% 的情况下打断用户。相比之下,GPT-Realtime 的打断率为 13.5%,而表现最弱的竞品则接近 48%。报告称,Gander 使用相对较小的模型,却能与 GPT-Realtime、Gemini Live 和 Grok 等商业系统相竞争。
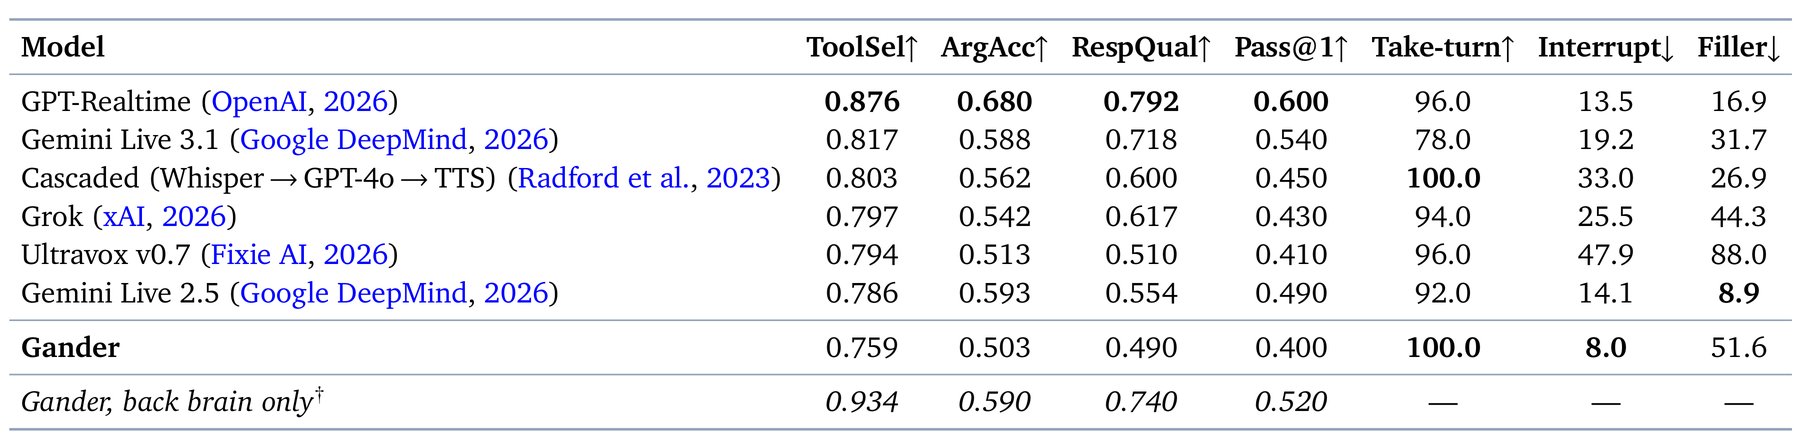
在任务准确率方面,Gander 略逊一筹。研究人员表示,部分原因在于测试是对整个系统评分,因此语音识别和输出误差都会被计入。如果直接提供文本输入,其“大脑”部分的得分要高得多。
视频和音频理解能力也受到影响:在一项测试中,Gander 的表现甚至不如其基础模型。研究人员将此归咎于训练偏向流畅对话而非精确感知,这影响了诸如在图像中计数和定位物体等任务。
腾讯计划发布 Gander 的权重和训练数据
据报道,Gander 的训练数据约包含 270 万个样本,其中一部分教它在有背景噪音或群里没人跟它说话时保持安静。
研究人员表示,这项工作仍处于早期阶段。如何扩大 Gander 的规模还是个未解的问题,目前也没有评估这类系统的标准方法。
团队计划在完成"开源发布流程"后公开模型权重和训练数据。代码的 GitHub 仓库已经上线,项目页面上也提供了演示。
越来越多公司开始把 Agent 工作拆分给多个模型
Gander 是继腾讯 7 月发布 Hy3 之后的又一动作。Hy3 是一款开源语言模型,据报道已大幅缩小与竞争对手的差距,在 Agent 任务上表现尤其突出,目前已应用于 WorkBuddy、元宝和微信。此外,在北京叫停 Meta 的收购之后,腾讯还在谈判收购 Agent 创业公司 Manus 的最大股权。腾讯认为这笔交易符合自身规划,包括在微信中嵌入 Agent。
其他公司也在用编排器(orchestrator)把任务分派给不同模型。OpenAI 的 GPT-Live 把对话和推理分开,在聊天继续进行的同时,把网页搜索和 Agent 任务交给后台模型处理。Sakana AI 的 Fugu 则是一个可从可扩展的模型池中调用其他模型的独立语言模型。OpenAI 还在测试能够主动创建后续任务、无需用户提示就主动联系的主动式 Agent。
如何处理中断、避免延迟仍是现实挑战。一项 Anthropic 的分析显示,资深用户在工作流程中的打断率约为 9%,而新手用户约为 5%。据一项调研报告,团队在开发对话语音和聊天 agent 时,延迟问题尤为突出。