
一千元就能实现顶尖AI大模型Token 自由?
先给答案:能。
一千块钱,买一张二手显卡,插在家里电脑上,就能跑一个 270 亿参数的顶尖开源大模型,而且 token 不限量、不排队、不经过任何第三方服务器。
当然有代价:速度慢。最慢的那张卡,每秒只能输出 13 个词左右,写一段长文得等几分钟。但如果你愿意等,它确实能跑、能写、能给出正确答案。
这篇文章不讲复杂技术,只回答一个问题:普通人花一千块,本地部署大模型到底可不可行?我自费买了三张卡做了实测,结论放在最后。
01 为什么现在要考虑本地部署
最近两年,用 AI 的人越来越多,但“用得起 AI”反而越来越难了:
•高端显卡越来越贵。新一代旗舰消费级显卡价格一路走高,想在家跑大模型的门槛看似在升高。•API 的 token 越来越不经用。各大模型平台的定价和限流政策反复调整,高峰期排队、限额是常态,重度用户一个月的 API 账单可能比电费还贵。•有些模型还会“降智”。高峰期为了省算力,部分平台会悄悄降低模型推理精度,同一个问题,闲时和忙时得到的答案质量可能不一样。本地部署大模型不是必须的——对大多数人来说,直接用 API 更省心。但它的价值正在变大:当 API 越来越贵、越来越挤、越来越不可控的时候,手里有一张能跑大模型的本地卡,就像家里备了一个发电机——平时用不上,停电的时候你会感谢自己。
02 本地部署的独特优势
本地部署有几个 API 永远给不了的优势:
1断网离线也能用。出差路上网络不稳定、家里宽带断了,或者在没有网络的环境里,本地模型照常工作。2机密文件纯本地处理,安全性极高。合同、财报、代码、个人隐私,全部在自己电脑里处理,数据不出本机。3写代码、处理数据不受限流。API 有请求次数限制和 token 配额,本地模型没有这些限制。4作为 API 的备用方案。API 挂了、限流了、降智了,切换到本地模型继续干活,工作不中断。电费确实是一笔开销,但对于重度用户来说,本地部署可能更便宜。
03 三张卡怎么选
我买了三张二手显卡做测试,价格从 1100 到 7000,覆盖了三种典型预算:
| 显卡 | 价格 | 显存 | 实测速度 | 适合谁 |
|---|---|---|---|---|
| Tesla P40 | 约 1100 元 | 24GB | 约 8~13 token/s | 想最低成本体验,愿意等 |
| RTX 2080Ti(魔改 22G) | 约 2700 元 | 22GB | 约 26~28 token/s | 追求性价比的大多数人 |
| RTX 3090 | 约 7000 元 | 24GB | 约 35~40 token/s | 预算充足、追求速度 |
三张卡的区别其实很简单:
•P40(1100 元):最便宜的入场券。24G 显存能跑 27B 级别的大模型,速度慢一点,但愿意等,总是能跑的。•2080Ti 魔改(2700 元):性价比之王。速度是 P40 的两到三倍,日常使用体验流畅很多。如果只推荐一张卡,我选它。•3090(7000 元):性能最强,短跑速度最快。适合预算充足,或者对速度有极致要求的重度用户。⚡ 核心逻辑
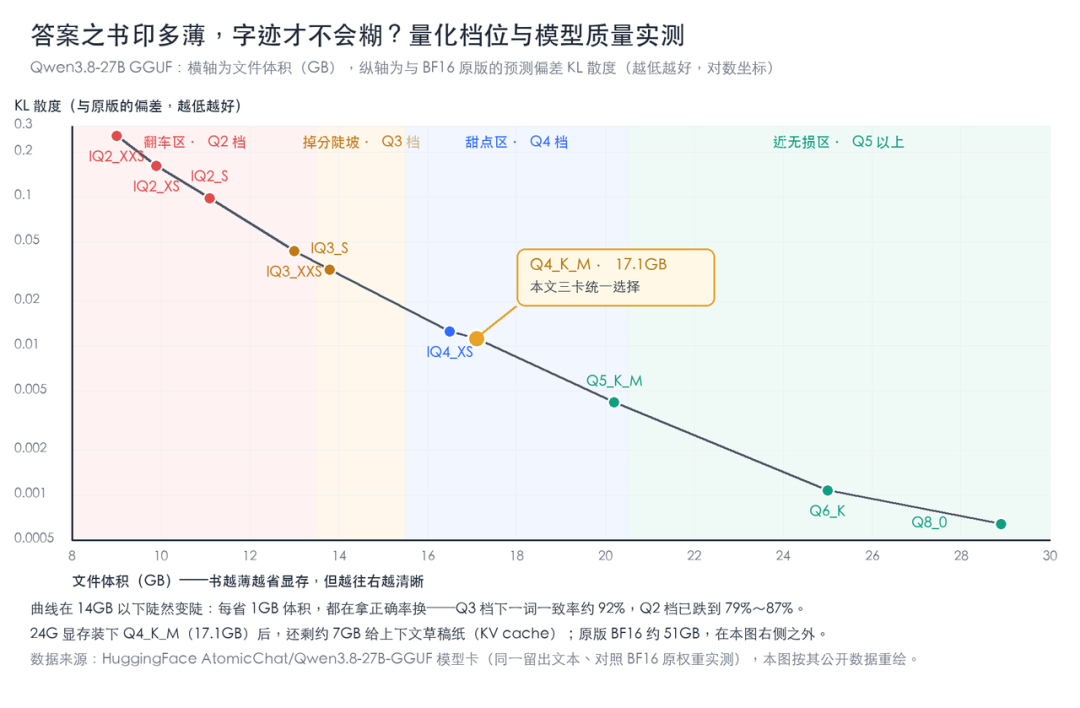
显存决定了你能用哪个量化档位。20GB 以上可以用 Q4_K_M,这是质量几乎无损的甜点区。所以关键不是“能不能跑”,而是“跑出来的质量够不够好”。
下面这张图是 Qwen3.8-27B 不同量化档位的模型质量实测。随着量化等级降低,模型准确度在 14GB 以下陡然下降;Q4_K_M(约 16GB)正好处在曲线的拐点,再往下压,质量就明显打折了。
04 实测:一千元的卡真的能跑
光说不练假把式。我让三张卡用同一个模型(Qwen3.8-27B)、同一道高等数学题,同时开考,看看到底能不能跑、跑得怎么样。
开考第一分钟的速度差异很直观:3090 文字飞速滚动,2080Ti 不紧不慢,P40 一个字一个字慢慢爬。但关键问题是:P40 能不能坚持到最后、给出正确答案?
答案是:能。P40 花了 1 小时 56 分钟,写了 62,045 个 token,最终给出了正确答案。虽然慢,但它完整跑完了一道高等数学证明题,推理过程没有出错,结论正确。
另外两张卡的成绩:
•2080Ti:36 分 42 秒,57,059 token,平均 25.91 token/s,答案正确,最早交卷。•3090:42 分 11 秒,67,362 token,平均 26.61 token/s,答案正确。这次写得更多,而且长时间满载后散热跟不上导致降速,所以反而比 2080Ti 晚交卷——但速度本身是最快的。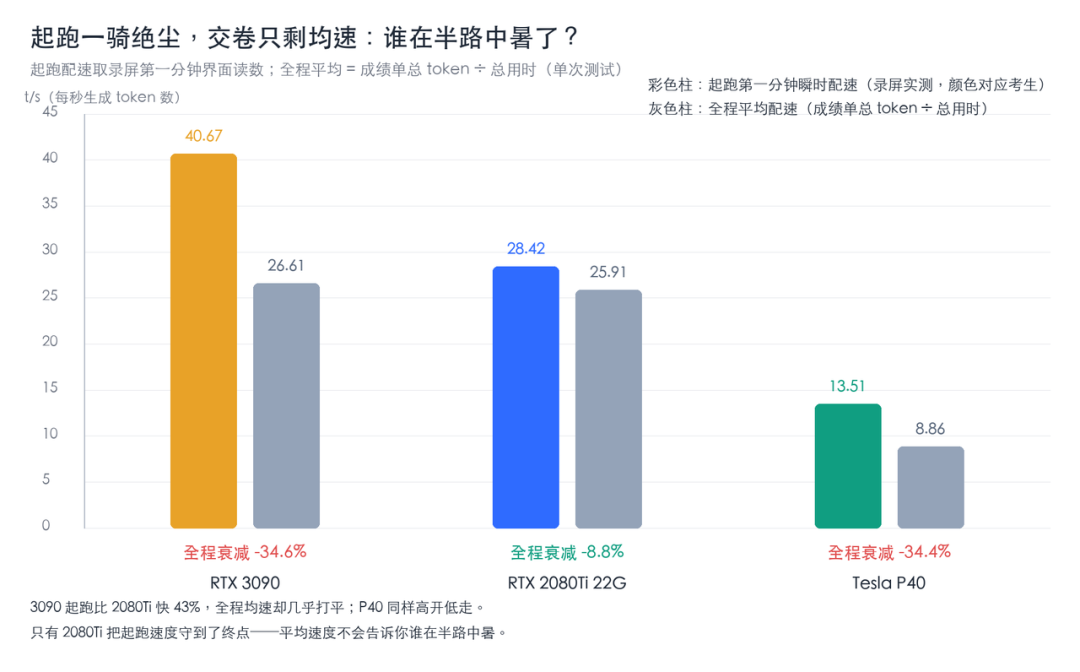
三张卡,三种价格,都完整跑完了同一道高等数学题,都给出了正确答案。一千元的 P40 没有掉队,它只是花了更多时间。
05 结论:可行性确认
回到标题的问题:一千元就能实现顶尖 AI 大模型 Token 自由?
能。一千块钱的二手 P40,24G 显存,能跑 270 亿参数的 Qwen3.8-27B,能做数学题、能写代码、能处理文档,答案质量和付费 API 一样,token 不限量、不排队、数据不出本机。
它的缺点只有一个:慢。每秒 8~13 个词,写一段长文要等几分钟。但如果你愿意等,它确实能用。
所以这篇文章的结论很简单:
•想最低成本体验:1100 元 P40,可行,愿意等就行。•追求性价比:2700 元 2080Ti 魔改,速度流畅,最推荐。•预算充足:7000 元 3090,速度最快,富帅首选。本地部署大模型不是什么高不可攀的技术,也不需要花几万块买旗舰卡。一千块钱的门槛,比大多数人想象的低得多。它不是必需品,但作为备用方案、离线工具、隐私保险箱,它的价值被低估了。
如果你也在考虑要不要折腾一下,我的建议是:先买一张最便宜的 P40 试试水——一千块钱,就算最后吃灰了,也不算亏。
你现在用 AI 是 API 还是本地?有没有遇到过限流或“降智”?欢迎在评论区聊聊。