
EMNLP 2026 | 通过分解生成与动态自反馈,构建工具调用合成数据
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。
现有工具调用数据合成方法通常采用「先生成、再筛选」的流程:模型一次性生成用户问题与工具调用,再通过规则或模型检查决定是否保留。这种方式能够过滤部分错误,但缺少对中间过程的检查,也未充分利用验证结果修正失败样本。
ToolLoop 针对这一问题,将数据合成拆分为目标函数采样、用户问题反向生成和工具调用正向生成三个阶段,并在各阶段引入动态自反馈。其核心思路是以明确的中间结果约束后续生成,通过「生成—验证—修正」逐步对齐目标函数、用户意图与调用参数。
论文标题:ToolLoop: Closed-Loop Tool-Use Data Synthesis via Decomposed Generation and Dynamic Self-Feedback
录用信息:EMNLP 2026 Main Conference
论文地址:https://arxiv.org/pdf/2609.09072
作者简介:曾敏,主要研究方向为大模型后训练、Agent、RSI, 该研究在其任职 vivo AI Lab 期间完成 。
从整体筛选到分阶段校验
工具调用样本的错误并不总能通过格式检查发现。例如,在一个用于说明机制的天气查询场景中,用户只要求查询北京天气,生成的答案却同时查询了北京和上海。两次调用可能都满足 API 格式要求,但额外的调用并不符合用户意图。
如果直接生成完整样本,这类错误需要在最后统一判断,问题来源也不容易定位。ToolLoop 先确定样本需要哪些函数,再生成与之对应的问题和调用,使每个阶段都有可供核对的参照。验证失败时,系统能够围绕当前阶段修正,而不是立即丢弃整条样本。
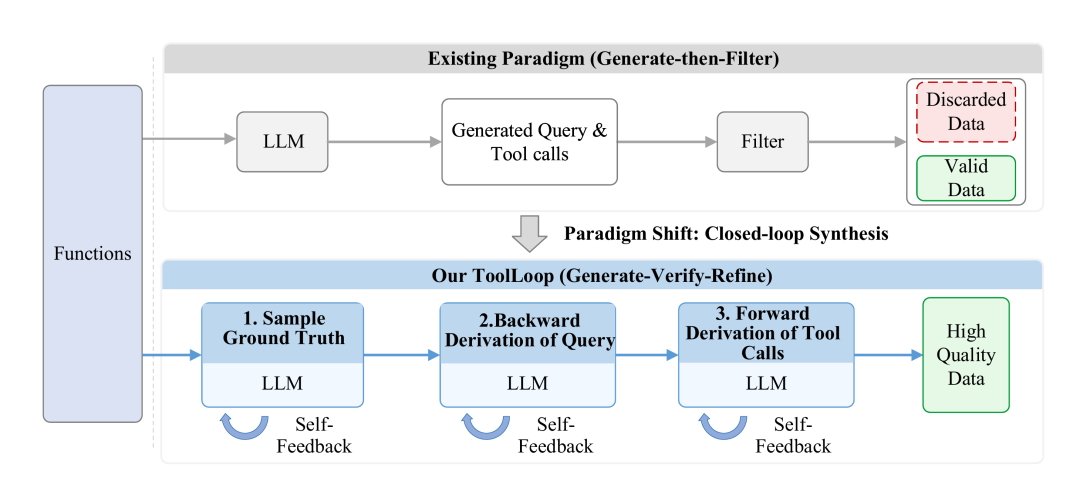
图 1:传统生成后筛选流程与 ToolLoop 闭环合成流程。
三阶段分解生成
在生成样本前,ToolLoop 首先组织候选函数。研究使用函数描述的语义向量进行 K-means 聚类,再结合模型引导的采样,将使用场景相关的函数组成候选集合。这为多工具选择和并行调用提供了具有语义联系的工具组合。
第一阶段:采样目标函数组合。
系统先确定一条样本预期调用的函数名称序列,将其作为后续生成的中间监督。对于单次调用场景,随机采样目标函数;对于并行场景,由模型选择能够服务于同一使用场景的函数组合。并行调用之间应当独立,不能依赖其他调用的执行结果。
这一步只确定调用哪些函数及其次数,具体参数留到后续阶段生成。方法覆盖单函数调用、多候选函数选择、同一函数多次并行调用,以及多函数并行调用四类单轮场景。
第二阶段:反向推导用户问题。
给定目标函数组合及相关函数定义,模型反向生成自然语言请求。问题需要与预期调用严格对应,提供必填参数所需的信息,同时保持日常表达的自然性。
例如,目标是对同一天气函数进行两次独立调用,问题就需要包含两次查询所对应的需求。验证时,既要检查是否遗漏必要信息,也要检查是否引入了目标函数组合之外的额外任务。通过这一步,函数层面的计划被转换为与之匹配的用户意图。
第三阶段:正向生成工具调用。
模型根据用户问题与候选函数定义,生成带有完整参数的结构化调用。函数选择应与目标组合一致,参数值应有用户问题作为依据,参数名称、类型和输出格式也需要满足函数定义。
由此,三个阶段分别处理目标构造、意图表达和调用实例化,便于对不同层面的错误进行检查。
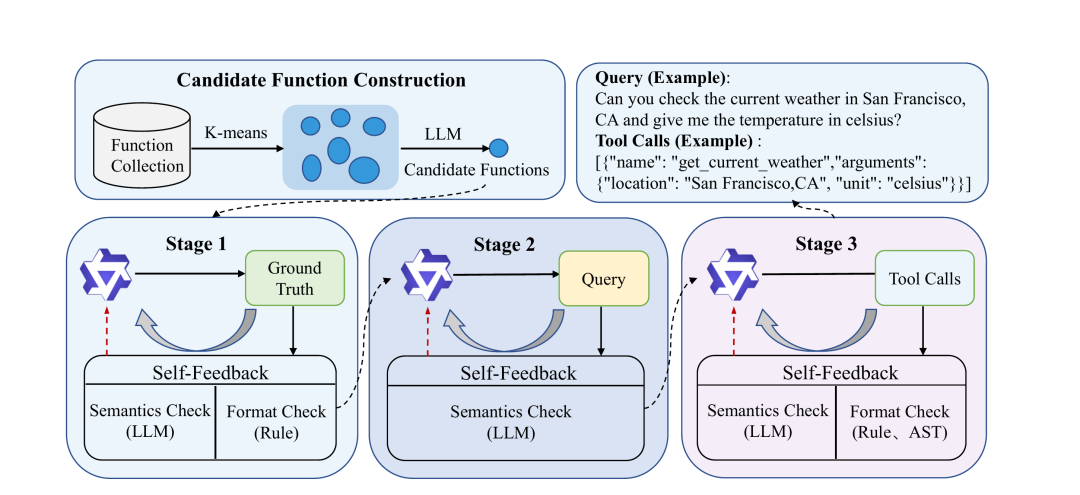
图 2:候选函数构建、三阶段生成及各阶段的自反馈机制。
动态自反馈:利用验证结果修正生成内容
分阶段生成之外,ToolLoop 在每个阶段设置反馈回路。验证由三类信号共同完成:语言模型判断语义合理性与逻辑一致性,确定性规则检查格式、结构和数据类型,AST 解析检查工具调用的语法。
不同阶段的检查重点有所区别。目标函数阶段关注组合是否对应连贯的使用场景、并行调用是否独立;用户问题阶段关注意图是否对齐、参数信息是否充分;最终调用阶段则进一步检查函数及参数是否符合问题和 schema 的约束。
验证失败后,系统将原始生成提示、失败输出以及具体问题组成新的提示,引导模型重新生成当前阶段的内容。例如,问题遗漏了必填参数所需的信息,反馈就指出这一缺失;调用格式出现错误,反馈则说明相应的结构或语法问题。验证通过后,流程再进入下一阶段。
对于已经选定的有效函数组合,后续修正尽量围绕这一目标展开。这使部分较难生成的样本有机会通过修改被保留下来,减少直接筛除带来的场景损失。每个阶段在首次生成后最多进行三次反馈式重试,仍未通过验证的样本才会被丢弃。
语义验证仍可能受到模型判断偏差的影响,因此规则与 AST 检查承担了客观约束的校验。反馈式重试也会增加生成开销,需要与数据质量收益共同考虑。
实验验证
研究使用 ToolLoop 构建了 11,024 条样本,并微调 Qwen3-4B-Instruct-2507。模型在非推理模式下直接输出工具调用。在论文评估的 BFCL 单轮任务上,总体准确率为 86.40%;使用 60K 和 55K 数据训练的 APIGen-4B、ToolMind-4B 分别为 83.11% 和 83.53%。移除与 BFCL 评估候选函数重叠的部分后,Isolate 版本得分为 86.07%。在 ACEBench 上,ToolLoop 的总体准确率为 72.1%。
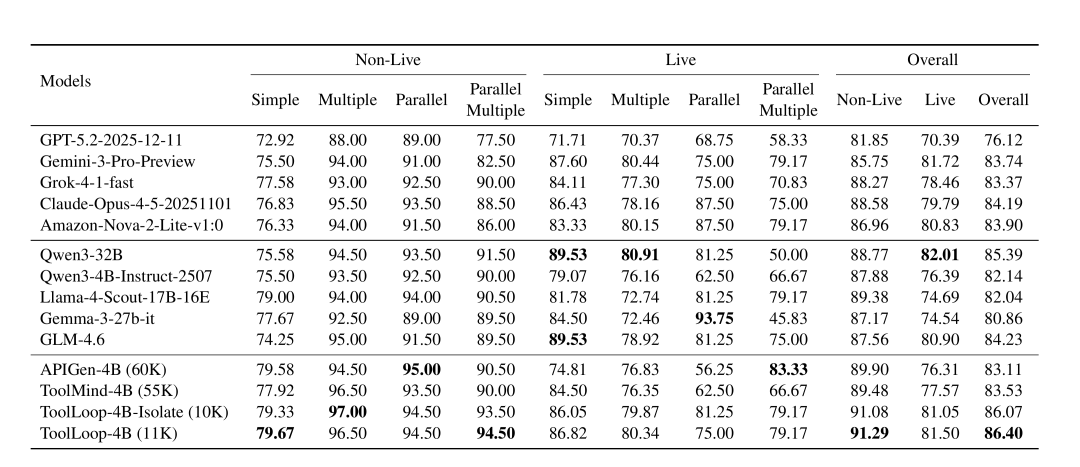
表 1:ToolLoop 与各对比模型在论文 BFCL 单轮评估任务上的结果。表中比较数据截至 2025 年 12 月 16 日。
消融实验进一步比较了反馈机制:不使用反馈、仅做最终筛选和完整 ToolLoop 的得分分别为 79.97%、82.56% 和 86.40%。其中,最终筛选与完整方法使用相同的合成框架、验证器和初始生成预算,但后者增加了反馈式修正。这一结果支持了在合成过程中利用验证反馈的作用。
后续方向
ToolLoop 将工具调用数据的生成拆成三个阶段,并在每个阶段检查和修正,使生成的用户问题与工具调用相互对应。目前,这些检查主要依据函数定义和模型判断,尚未通过真实 API 的执行结果验证。因此,后续可以进一步结合实际执行反馈,探索多轮交互。