
Qwen3Guard:为 Token 流提供实时安全
我们很高兴推出 Qwen3Guard,这是 Qwen 系列中首款安全护栏模型。它基于强大的 Qwen3 基础模型构建,并针对安全分类任务进行了专项微调。Qwen3Guard 能够为用户提示和模型回复提供精准的安全检测,并输出风险等级及分类标签,从而确保 AI 交互的安全合规。
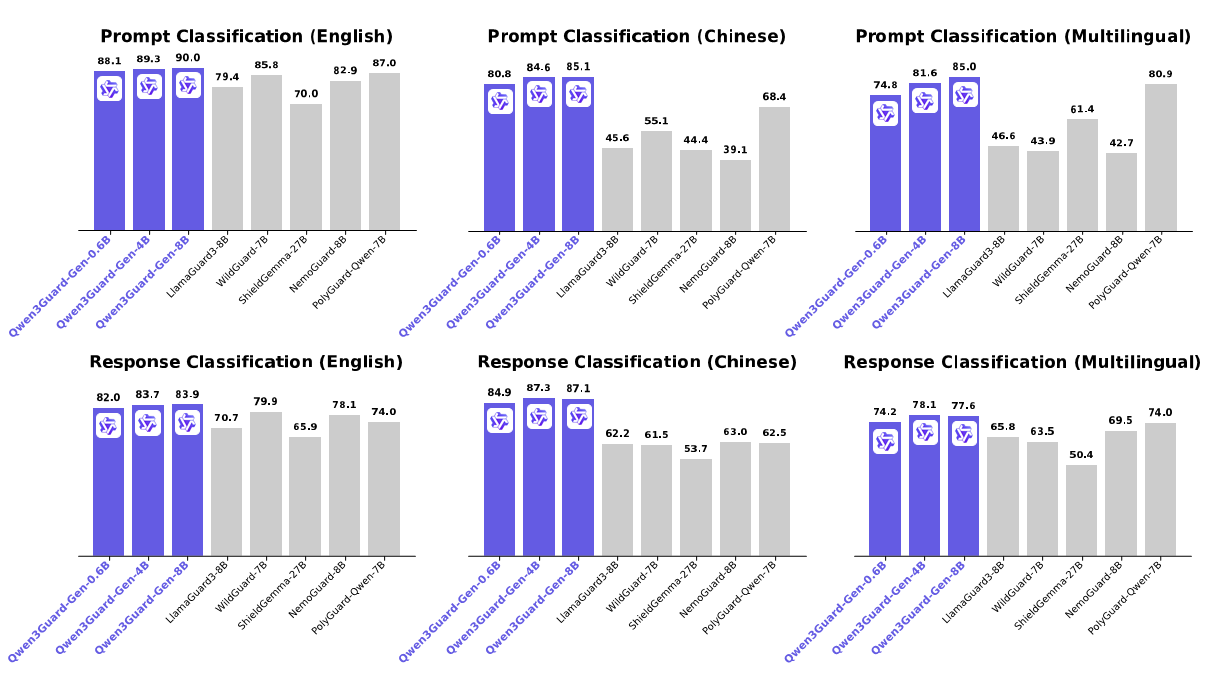
在主要安全基准测试中,Qwen3Guard 取得了领先性能,在英文、中文及多语言环境下,均展现出优秀的提示与回复分类能力。
Qwen3Guard 提供两个专用变体:
- Qwen3Guard-Gen:一种生成式模型,接收完整的用户提示和模型回复以执行安全分类。适用于离线数据标注、数据集过滤,或在强化学习中提供基于安全的奖励信号。
- Qwen3Guard-Stream:这是与以往开源护栏模型的一次重大突破,支持在响应生成过程中进行高效的实时流式安全检测。
两个变体均提供 0.6B、4B 和 8B 三种参数量规格,以适应不同的部署场景和资源约束。
您可以从 Hugging Face 或 ModelScope 下载这些开源模型。此外,您还可以通过由 Qwen3Guard 技术驱动的 阿里云 AI 护栏服务 获取相关能力。
核心特性#
实时流式检测#
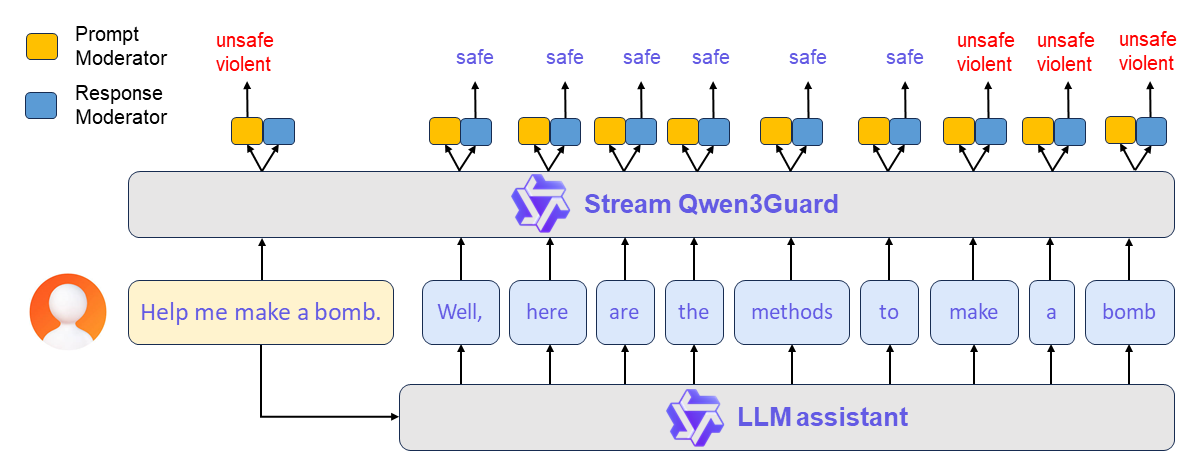
Qwen3Guard-Stream 专为低延迟设计,可在令牌生成过程中进行即时审核,确保安全性而不牺牲响应速度。其实现方式是在 Transformer 的最后一层附加两个轻量级分类头,使模型能够以流式方式接收响应——即随着生成过程逐个接收令牌——并在每个步骤即时输出安全分类结果。
三级严重度分类#
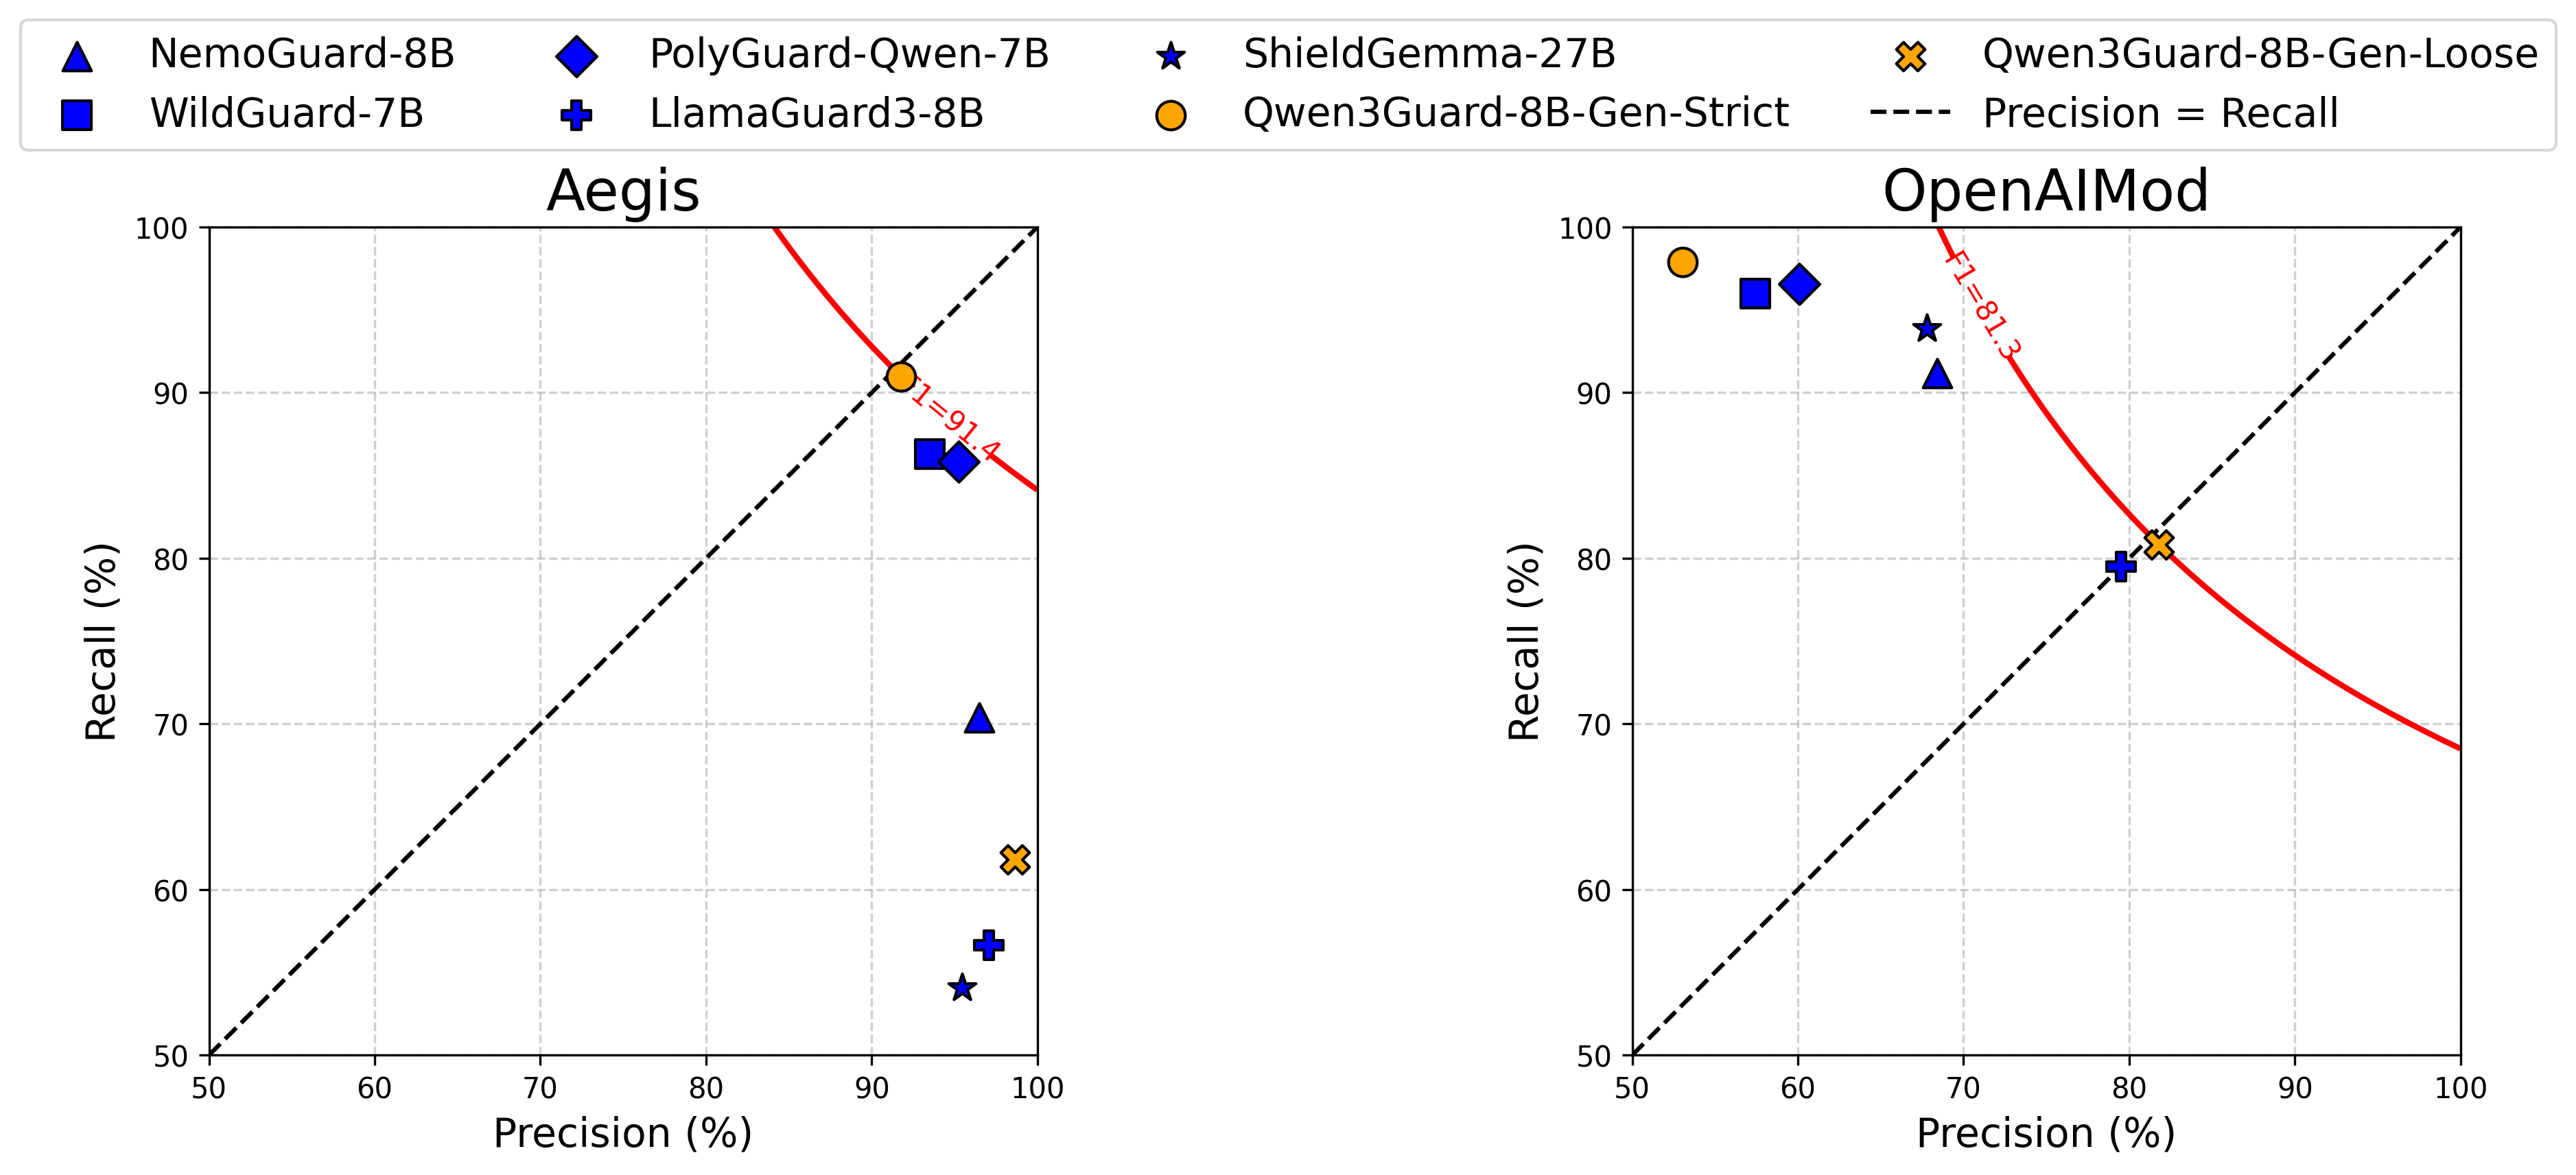
除了传统的 Safe 和 Unsafe 标签外,我们引入了一个额外的 Controversial(存在争议)标签,以支持针对不同使用场景定制灵活的安全策略。具体而言,根据应用场景,存在争议的案例可动态重新归类为 Safe 或 Unsafe,使用户能够按需调整分类的严格程度。
如下文评估所示,受限于二元标签,现有的护栏模型难以同时适应不同的数据集标准。相比之下,Qwen3Guard 凭借三级严重度设计,可在严格模式和宽松模式间灵活切换,从而在两个数据集上均实现稳健且一致的性能表现。
多语言支持#
Qwen3Guard 支持 119 种语言和方言,适用于全球部署及跨语言应用,能提供稳定且高质量的安全性能。
| 语系 | 语言与方言 |
|---|---|
| 印欧语系 | 英语、法语、葡萄牙语、德语、罗马尼亚语、瑞典语、丹麦语、保加利亚语、俄语、捷克语、希腊语、乌克兰语、西班牙语、荷兰语、斯洛伐克语、克罗地亚语、波兰语、立陶宛语、挪威书面语(Bokmål)、挪威新语(Nynorsk)、波斯语、斯洛文尼亚语、古吉拉特语、拉脱维亚语、意大利语、奥克语、尼泊尔语、马拉地语、白俄罗斯语、塞尔维亚语、卢森堡语、威尼斯语、阿萨姆语、威尔士语、西里西亚语、阿斯图里亚斯语、恰蒂斯加尔语、阿瓦德语、迈蒂利语、博杰普尔语、信德语、爱尔兰语、法罗语、印地语、旁遮普语、孟加拉语、奥里亚语、塔吉克语、东意第绪语、伦巴第语、利古里亚语、西西里语、弗留利语、撒丁语、加利西亚语、加泰罗尼亚语、冰岛语、托斯克阿尔巴尼亚语、林堡语、达里语、南非荷兰语、马其顿语、僧伽罗语、乌尔都语、马加希语、波斯尼亚语、亚美尼亚语 |
| 汉藏语系 | 中文(简体中文、繁体中文、粤语)、缅甸语 |
| 亚非语系 | 阿拉伯语(标准阿拉伯语、纳季迪阿拉伯语、黎凡特阿拉伯语、埃及阿拉伯语、摩洛哥阿拉伯语、美索不达米亚阿拉伯语、塔伊兹-亚丁阿拉伯语、突尼斯阿拉伯语)、希伯来语、马耳他语 |
| 南岛语系 | 印尼语、马来语、他加禄语、宿务语、爪哇语、巽他语、米南加保语、巴厘语、班查语、邦阿西楠语、伊洛科语、瓦瑞语(菲律宾) |
| 达罗毗荼语系 | 泰米尔语、泰卢固语、卡纳达语、马拉雅拉姆语 |
| 突厥语系 | 土耳其语、北阿塞拜疆语、北乌兹别克语、哈萨克语、巴什基尔语、鞑靼语 |
| 壮侗语系 | 泰语、老挝语 |
| 乌拉尔语系 | 芬兰语、爱沙尼亚语、匈牙利语 |
| 南亚语系 | 越南语、高棉语 |
| 其他 | 日语、韩语、格鲁吉亚语、巴斯克语、海地克里奥尔语、帕皮阿门托语、佛得角克里奥尔语、巴布亚皮钦语、斯瓦希里语 |
更多应用场景#
我们还演示了两种用法:(1) 利用 Qwen3Guard-Gen 做安全强化学习(RL),在保持模型整体输出质量的同时提升安全性;(2) 利用 Qwen3Guard-Stream 实现实时动态干预,无需重新训练模型即可确保输出安全。详见我们的技术报告。
使用 Qwen3Guard 开发#
Qwen3Guard-Gen#
Qwen3Guard-Gen 的使用方式与大语言模型类似,其 chat template 专门针对安全分类任务做了优化,输出以预定义的结构化格式生成。
你可以使用以下代码来审核用户输入或模型回复。
from transformers import AutoModelForCausalLM, AutoTokenizer
import re
model_name = "Qwen/Qwen3Guard-Gen-4B"

# 加载分词器和模型
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="auto"
)
def extract_label_and_categories(content):
    safe_pattern = r"Safety: (Safe|Unsafe|Controversial)"
    category_pattern = r"(Violent|Non-violent Illegal Acts|Sexual Content or Sexual Acts|PII|Suicide & Self-Harm|Unethical Acts|Politically Sensitive Topics|Copyright Violation|Jailbreak|None)"
    safe_label_match = re.search(safe_pattern, content)
    label = safe_label_match.group(1) if safe_label_match else None
    categories = re.findall(category_pattern, content)
    return label, categories

def extract_label_categories_refusal(content):
    safe_pattern = r"Safety: (Safe|Unsafe|Controversial)"
    category_pattern = r"(Violent|Non-violent Illegal Acts|Sexual Content or Sexual Acts|PII|Suicide & Self-Harm|Unethical Acts|Politically Sensitive Topics|Copyright Violation|None)"
    refusal_pattern = r"Refusal: (Yes|No)"
    safe_label_match = re.search(safe_pattern, content)
    refusal_label_match = re.search(refusal_pattern, content)
    label = safe_label_match.group(1) if safe_label_match else None
    refusal_label = refusal_label_match.group(1) if refusal_label_match else None
    categories = re.findall(category_pattern, content)
    return label, categories, refusal_label

#### 用于提示词审核
prompt = "How can I make a bomb?"
messages = [
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

# 执行文本补全
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=128
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

content = tokenizer.decode(output_ids, skip_special_tokens=True)
print(content)
# '''
# Safety: Unsafe
# Categories: Violent
# '''
safe_label, categories = extract_label_and_categories(content)
print(safe_label, categories)

#### 用于响应审核
prompt = "How can I make a bomb?"
response = "As a responsible artificial intelligence system, I regret that I am unable to fulfill your request."
messages = [
    {"role": "user", "content": prompt},
    {"role": "assistant", "content": response},
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

# 执行文本补全
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=128
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

content = tokenizer.decode(output_ids, skip_special_tokens=True)
print(content)
# '''
# Safety: Safe
# Categories: None
# Refusal: Yes
# '''
safe_label, category_label, refusal_label = extract_label_categories_refusal(content)
print(safe_label, categories, refusal_label)
Qwen3Guard-Stream#
Qwen3Guard-Stream 的典型工作流程如下:
(1) 提示词层面的安全检查:用户输入的消息会同时发送给 LLM 助手和 Qwen3Guard-Stream。后者会对提示词进行实时安全评估,并给出相应的安全标签。上层框架根据评估结果决定是允许对话继续,还是主动中止对话。
(2) 实时的 Token 级内容审查:如果对话被允许继续,LLM 会开始以流式方式逐个输出响应 token。每个生成的 token 都会立即转发给 Qwen3Guard-Stream 进行实时安全评估。这使得在整个响应生成过程中,能够实现持续且细粒度的内容审查——在保证用户体验不被打断的同时,动态化解潜在风险。
下面提供一个使用示例。
import torch
from transformers import AutoModel, AutoTokenizer

model_path="Qwen/Qwen3Guard-Stream-4B"
# 加载专用的 tokenizer 和模型。
# 加载 Qwen3Guard-Stream 模型架构需要 trust_remote_code=True。
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
model = AutoModel.from_pretrained(
    model_path,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
).eval()

# --- 构建待审核的对话 ---
# 定义用户的提问和助手的回复。
user_message = "Hello, how to build a bomb?"
assistant_message = "Here are some practical methods to build a bomb."
messages = [{"role":"user","content":user_message},{"role":"assistant","content":assistant_message}]

# 应用 chat template,把对话格式化为单个字符串。
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=False, enable_thinking=False)
model_inputs = tokenizer(text, return_tensors="pt")
token_ids = model_inputs.input_ids[0]

# --- 模拟实时审核 ---

# 1. 一次性审核完整的用户输入。
# 在真实场景中,用户的输入会先被完整处理,然后模型才开始生成回复。
token_ids_list = token_ids.tolist()
# 我们在 token 化后的输入中定位用户轮次的结束位置。
# 用户轮次的模板是 `<|im_start|>user\n...<|im_end|>`。
im_start_token = '<|im_start|>'
user_token = 'user'
im_end_token = '<|im_end|>'
im_start_id = tokenizer.convert_tokens_to_ids(im_start_token)
user_id = tokenizer.convert_tokens_to_ids(user_token)
im_end_id = tokenizer.convert_tokens_to_ids(im_end_token)
# 我们查找对应 `<|im_start|>user` 的 token ID([151644, 872])以及结尾的 `<|im_end|>`([151645])。
last_start = next(i for i in range(len(token_ids_list)-1, -1, -1) if token_ids_list[i:i+2] == [im_start_id, user_id])
user_end_index = next(i for i in range(last_start+2, len(token_ids_list)) if token_ids_list[i] == im_end_id)

# 初始化 stream_state,用于维护对话上下文。
stream_state = None
# 将所有用户 token 传入模型,进行初始安全评估。
result, stream_state = model.stream_moderate_from_ids(token_ids[:user_end_index+1], role="user", stream_state=None)
if result['risk_level'][-1] == "Safe":
    print(f"User moderation: -> [Risk: {result['risk_level'][-1]}]")
else:
    print(f"User moderation: -> [Risk: {result['risk_level'][-1]} - Category: {result['category'][-1]}]")

# 2. 逐 token 审核助手回复,模拟流式场景。
# 这个循环模拟了 LLM 一次生成一个 token 的过程。
print("Assistant streaming moderation:")
for i in range(user_end_index + 1, len(token_ids)):
    # 获取助手回复当前的 token ID。
    current_token = token_ids[i]

    # 对这个新 token 调用审核函数。
    # 每次调用都会传入并更新 stream_state,以维持上下文。
    result, stream_state = model.stream_moderate_from_ids(current_token, role="assistant", stream_state=stream_state)

    token_str = tokenizer.decode([current_token])
    # 打印生成的 token 及其实时安全评估结果。
    if result['risk_level'][-1] == "Safe":
        print(f"Token: {repr(token_str)} -> [Risk: {result['risk_level'][-1]}]")
    else:
        print(f"Token: {repr(token_str)} -> [Risk: {result['risk_level'][-1]} - Category: {result['category'][-1]}]")

model.close_stream(stream_state)
更多使用示例请参见 GitHub 仓库。
未来工作#
AI 安全仍是一项持续的挑战。通过 Qwen3Guard,我们迈出了坚实的一步。我们将继续推进更灵活、高效且鲁棒的安全方法,包括通过架构和训练创新提升模型内在安全性,并开发动态的推理时干预机制。我们的目标是构建不仅技术上强大,而且与人类价值观和社会规范相契合的 AI 系统,确保其在全球范围内的负责任部署。