
Runway 拟将 AI 视频生成转变为可实时控制的流媒体体验
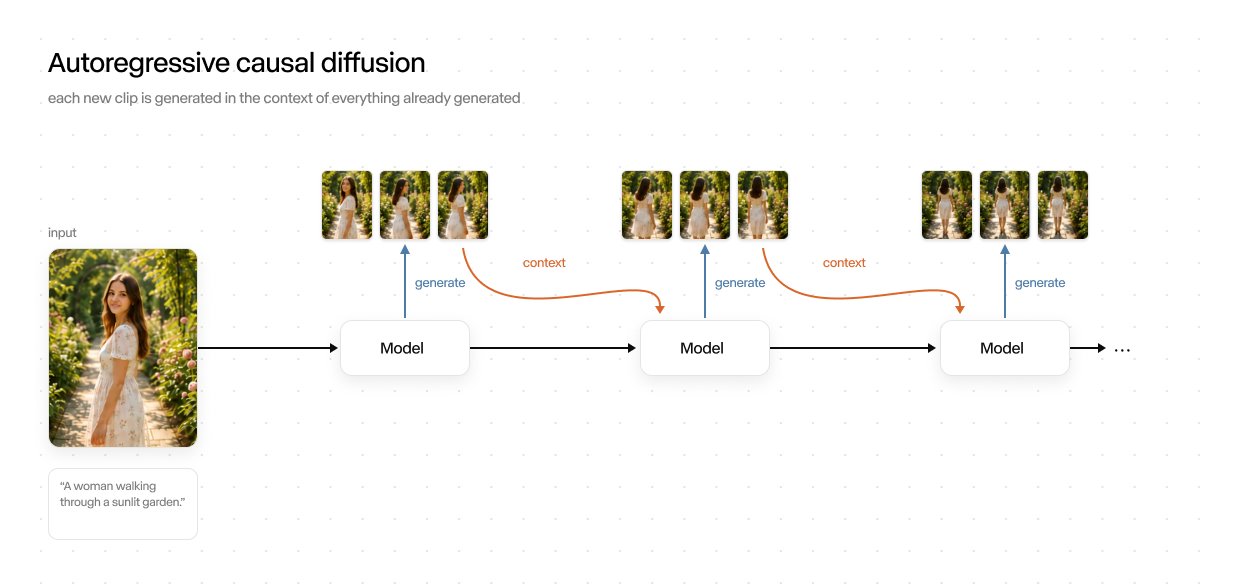
Runway 展示了其实时视频生成研究的最新进展。用户无需输入提示词后等待结果,而是可以一边描述一边流式生成视频。
目前的视频模型通常分步骤工作:输入提示词,等待几秒或几分钟,然后获得成品视频。如果结果不理想,就得重新开始。Runway 表示,用户反馈在视频生成和修改上浪费了最多时间。该公司希望将生成首帧的时间压缩到极致,并在用户输入提示的同时流式输出视频。
Runway 在三月通过 Runway Characters 首次讨论了这一方案。该方案基于 GWM-1,这是 Runway 于 2025 年 12 月推出的首个“通用世界模型”(General World Model)。GWM-1 建立在 Gen-4.5 之上,逐帧生成视频,并支持通过镜头运动、机器人指令或音频进行控制。就在几周前,Runway 还展示了 Solaris,这是一个利用 Gen-4.5 逐帧生成用户界面的系统,并能响应点击或语音输入。
实时生成可缩短等待时间并降低 GPU 成本
Runway 认为,实时生成拉近了创意与其落地之间的距离。借助即时反馈,用户可以将大部分时间用于主动引导视频走向,而不是等待。
Runway 还指出了成本方面的优势。速度更快的模型消耗的 GPU 时间更少,从而更具成本效益。Runway 指出,在特定质量水平下,单位输出的成本决定了哪些应用场景在经济上可行。即时生成将降低这一门槛,使此前无利可图的应用变得可行。
微小的视觉误差可能演变成严重的画面失真
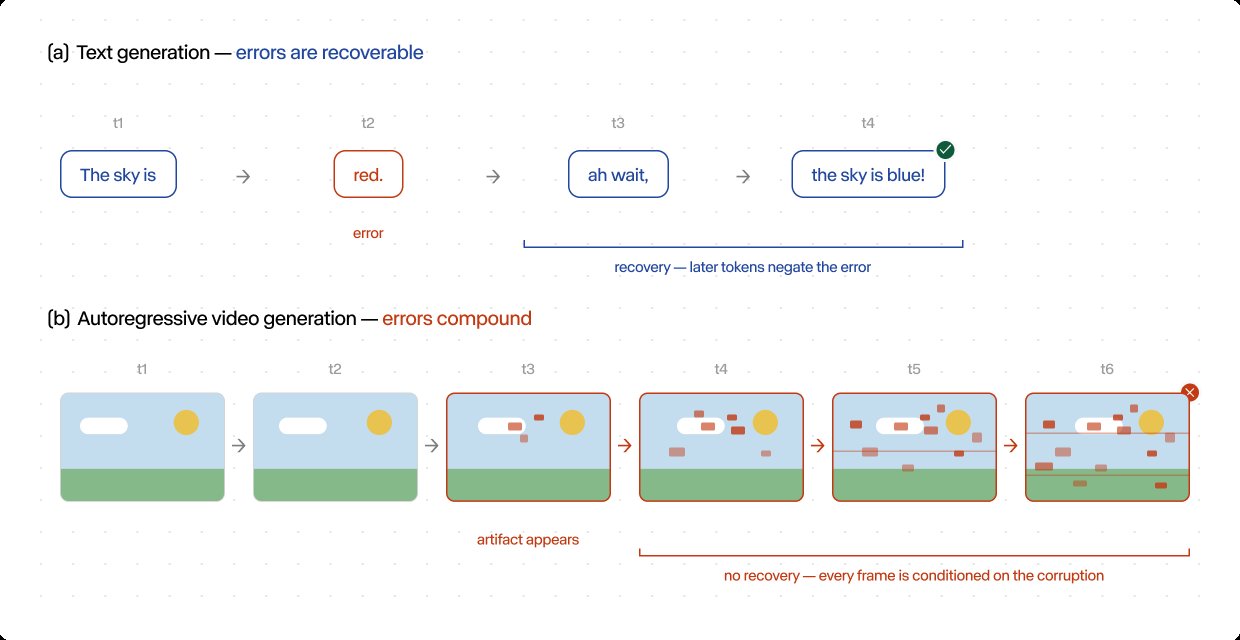
文本模型可以在句子中途自我纠正,但视频模型的每一帧都建立在上一帧之上,微小误差会随时间不断累积,最终演变成严重的画面失真。Runway 将这视为基于 LLM 方案的核心问题,并通过让模型在自身输出(而不仅是无瑕疵的输入)上训练来解决,教它纠正自己的偏差,而不是不断放大。
初创公司 Decart 在其实时模型 MirageLSD 中采用了类似方法,在训练时刻意让它接触有缺陷或失真的图像。Google DeepMind 则表示其世界模型 Genie 3 能以 720p、每秒 24 帧的规格,让交互式世界在数分钟内保持一致。
据 Runway 介绍,实时生成把算力压力从训练阶段转移到了使用阶段。模型必须以足够快的速度生成每一帧以跟上播放进度,同时还要在多个会话共享的硬件上运行。
世界模型可用于训练机器人和无人驾驶出租车
Runway 认为交互式应用是 AI 生成媒体最核心的长期应用场景。该公司指出,教育、游戏和机器人领域都需要能够随观看者操作即时响应的视频。评估机器人或自动驾驶汽车在现实世界中的表现,同样依赖于能够实时生成内容并瞬间应对边缘案例的环境。Runway 此前推出了 GWM Robotics,这是 GWM-1 的变体,专为机器人生成合成训练数据。
Waymo 采用类似策略,推出了基于 Genie 3 并针对道路交通场景优化的 Waymo 世界模型。它允许 Waymo 模拟其车队从未遭遇过的情况,例如与大象、龙卷风或洪水淹没的住宅区互动。据 Waymo 称,Waymo Driver 在虚拟世界中已行驶了数十亿英里,以应对公共道路上的各种场景。
今年 3 月,Runway 还在 Nvidia 的 GTC 大会上展示了与该公司共同开发的实时模型研究预览版。该模型运行在 Vera Rubin 平台上,旨在 100 毫秒内生成第一帧画面。Runway 尚未公布具体的上线时间表。