
从“看见文字”到“读懂画面”:AI MediaKit 如何实现视频字幕无痕擦除
当短剧、漫剧、电商视频、广告素材走向全球市场,字幕擦除早已不只是把画面底部的一行对白抹掉。
真实视频里的文字,往往比想象中复杂:人物姓名可能竖排在角色身侧,章节标题可能带着书法笔触、描边、阴影和动态特效,账号水印可能半透明地浮在复杂背景上。与此同时,招牌、海报、产品包装、衣服印字、现场大屏又属于画面原始信息,不能被误删。
这让字幕擦除从一道“找到文字并抹掉”的题,变成了两道更难的题:
哪些文字是后期叠加,应该擦掉?
哪些文字属于真实场景,必须留下?擦除之后,背景又如何保持真实、稳定、不闪烁?
面向字幕擦除等真实业务场景中的复杂难题,火山引擎推出 AI MediaKit 理解式视频编辑引擎,并以自研 ReFM(Residual Flow Matching,残差式流匹配)作为视频生成修复主干。该方案以 “多模态语义理解 + 视频生成式修复” 为核心,系统升级了文字定位、编辑路径、时序一致性和长视频工程链路,让字幕擦除从传统像素级处理进一步迈向理解式视频编辑。
以多模态时序理解与 ReFM 残差流匹配,让复杂花字、水印精准擦除、场景文字完整保留
先判断:哪些文字该擦,哪些内容要留
传统方案通常根据 OCR 检测结果生成擦除区域。它能回答“哪里有字”,却很难回答“这处文字是不是需要移除的后期叠加层”。
在真实画面里,对白字幕、人物介绍、节目 Logo、手持海报和产品包装可能同时出现。如果把所有文字一并擦掉,品牌信息和场景细节会被误伤;如果只处理画面底部,又会漏掉竖排花字、转场标题和角落水印。新版字幕擦除引擎引入多模态理解能力,先判断文字在画面中的角色,再决定是否擦除。
同一条字幕在连续帧中会受到人物运动、镜头变化和压缩噪声影响,检测框可能抖动、断裂,甚至短暂消失。AI MediaKit 不会孤立判断每一帧,而是根据空间重叠关系和时间连续性,将检测结果组织成稳定的文字轨迹,并选取多个代表帧联合分析。这样既能借助前后文判断文字属性,也能补齐短时漏检,减少“前一帧擦掉、后一帧又出现”的闪烁问题。
对每条文字轨迹,系统会同时观察文字局部、所在画面和前后时序,判断它属于哪一类内容:
对白字幕、人物姓名与身份介绍、章节标题、提示花字、推广水印:应当擦除;
招牌、海报、书本、服装印字、产品包装、现场屏幕、品牌卡与固定 Logo:应当保留。
判断依据不再只是文字内容或所在位置,而是文字与人物、物体、场景载体之间的关系。同样是一行大字,悬浮在人物旁边的身份介绍和印在海报上的标题,会得到完全不同的处理。
对于语义不明确的区域,系统采用更稳妥的保守策略,优先保留原始画面,降低品牌露出、商品信息、舞台大屏和剧情道具等高价值内容被误擦的风险。
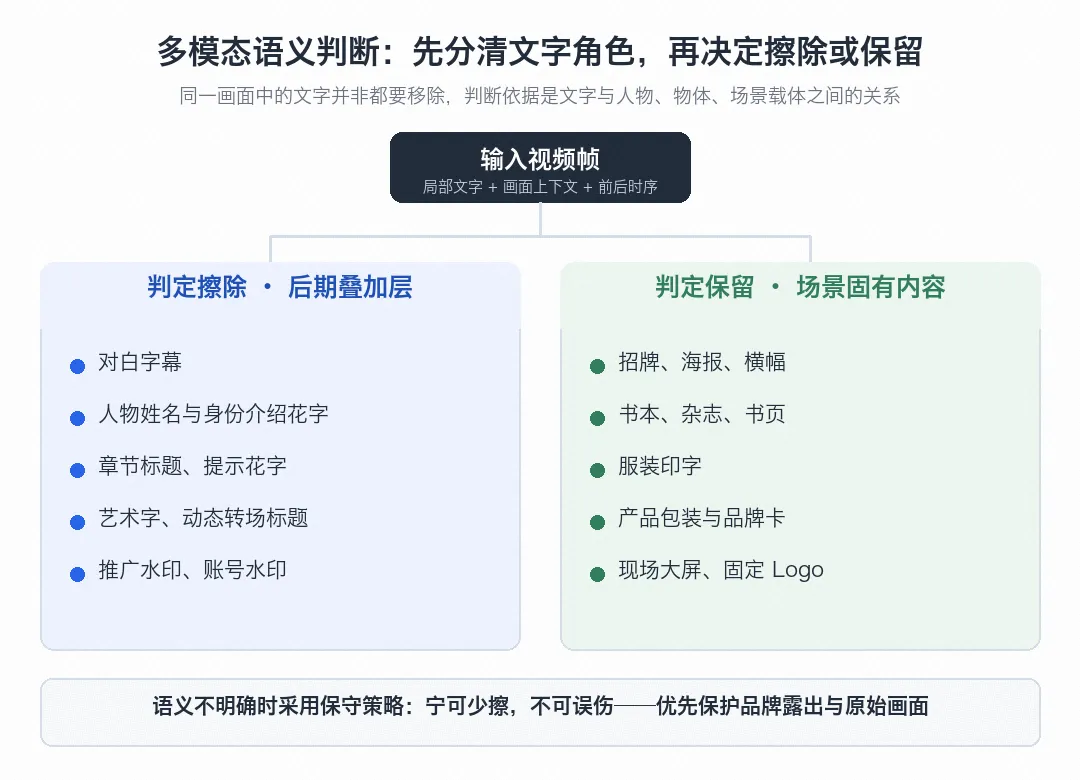
多模态语义判断区分“该擦的后期叠加层”与“该留的场景固有文字”(示意图)
ReFM 让画面自然过渡到无字状态
判断准确,解决的是“擦哪里”;修复自然,决定的是成片是否真的无痕。
传统生成式修复通常从随机噪声开始重建目标区域。用于字幕擦除时,这条路径过长:模型不仅要移除文字,还要重新生成大量原本已经正确的内容,容易带来纹理漂移、人物变形和额外幻觉。
AI MediaKit 将视频生成大模型改造为面向擦除任务的残差编辑模型,这一修复主干就是 ReFM。它不再从高斯噪声开始生成,而是从带字幕的原视频潜变量出发,学习它与无字画面之间真正需要改变的残差。模型的目标也从 “重新画一遍视频”,变成 “只完成必要的那次修改”。
这条更短、更确定的编辑路径,能够更充分地继承原视频中的人物、光照、纹理和运动信息,并在 4 步采样下完成高质量修复。
为了补回被字幕遮挡的细节,模型在视频生成主干中加入两类互补引导:一类是遮挡区域跨帧上下文聚合,从相邻帧中寻找可参考的结构与纹理,为被文字遮挡的局部区域提供信息;另一类是全局视频表征引导,持续向编辑过程注入原视频的整体内容和风格,减少修复区域与周围画面之间的割裂。局部信息负责 “补对细节”,全局信息负责 “让整段视频仍像同一个画面世界”。
在此基础上,系统通过 Latent 精准回贴 进一步守住生成边界:在潜空间中对编辑区域进行精确约束,保留区域尽可能回贴原视频潜变量,仅让模型生成需要擦除和补全的范围。配合稳定的时序掩码,可以减少非目标区域的颜色变化、清晰度损失和纹理漂移。这相当于为生成式修复划出边界:该生成的地方充分生成,不该变化的地方最大限度保持原样。
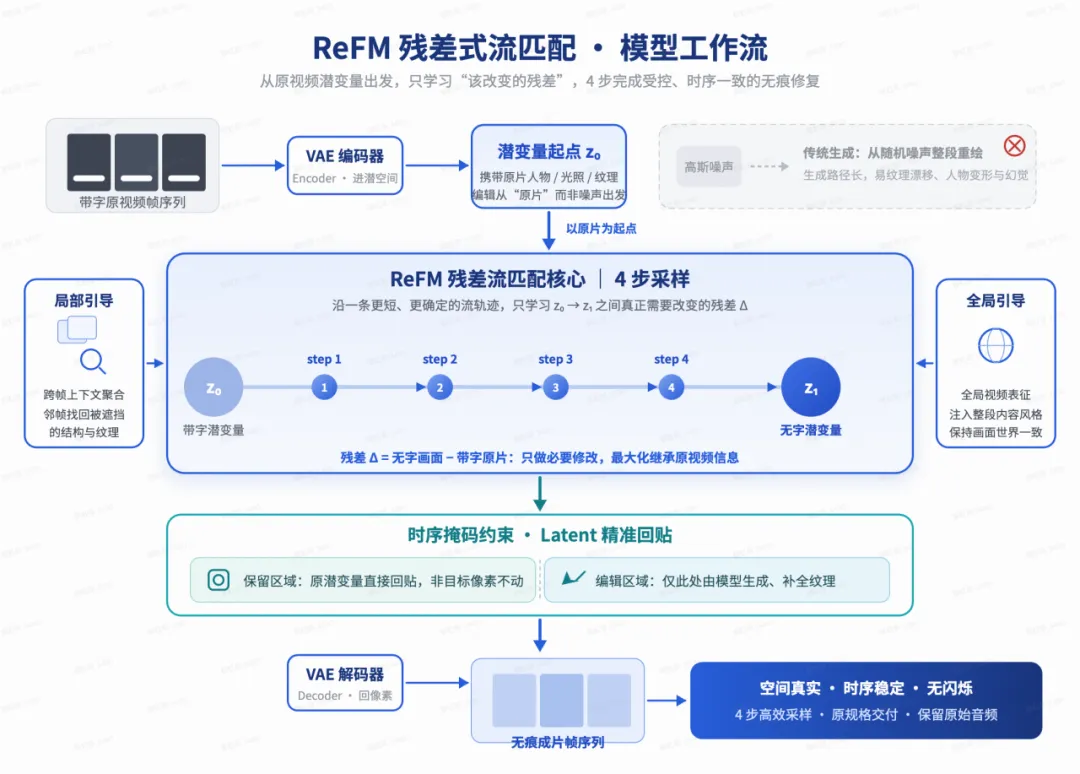
ReFM 残差流匹配模型工作流——从原视频潜变量出发,经局部 / 全局双引导的 4 步残差流编辑与 Latent 精准回贴
解码出时序稳定的无痕成片
面向真实素材,花字、水印、场景文字都要分别处理
真实内容生产中,难处理的往往不是规整字幕,而是位置自由、样式复杂、和画面高度融合的文字。围绕这些高频场景,AI MediaKit 对训练数据与推理策略进行了专项增强。
人物介绍类花字 通常字号大、位置自由,还伴随描边、阴影和竖排版式。系统能够同时移除人物介绍与对白字幕,并利用邻帧信息恢复被覆盖的头发、服装和背景结构。
竖排身份花字与底部对白被一并擦除,人物与背景完整保留(内部评测对比帧)
艺术字和动态标题 往往超出常规字幕区域,甚至覆盖大面积画面。针对书法字、综艺花字、章节标题等样式,系统加入艺术字体与动态文字专项数据,使模型能够处理不规则笔画、彩色描边、移动文字和大范围遮挡。
半透明字幕 会与背景纹理混合,既难检测,也容易留下笔画残影。通过水印专项训练和区域强化监督,系统提升了对低对比度文字、镜面水印和重复推广文字的处理能力。
场景固有文字 则不是要擦除的对象。面对海报、书页、品牌卡、舞台屏幕和商品包装,模型会结合载体关系判断其为场景固有文字,并保留原始信息。字幕擦除的质量不只取决于擦掉了多少字,也取决于保住了多少原本不该动的内容。
面向批量生产,稳定和效率同样关键
模型效果要真正服务内容全球化,还需要进入稳定、可扩展的生产链路。目前,AI MediaKit 已构建覆盖文字检测、多模态判断、视频修复与结果校验的完整流水线:
少步数生成:ReFM 主干采用 4 步采样,在修复质量与处理效率之间取得平衡;
长视频连续处理:通过重叠窗口和时序上下文衔接长视频片段,降低分段边界闪烁;
原规格交付:推理后恢复源视频分辨率,并保留原始音频;
分布式批处理:支持多卡并行、断点续跑、分阶段缓存与逐视频校验;
全链路可追踪:保留检测、语义判断、修复和状态日志,便于质量回溯与快速定位问题。
AI MediaKit 还在部署层面适配 GPU 与 NPU 等多种算力环境,持续提升在不同基础设施上的兼容性与可迁移性,让字幕擦除在算力选型和规模化落地上保留更多空间。
这些能力让字幕擦除不只停留在单段 Demo,而是能够进入批量化的生产流程。
多语种文字擦除,让视频出海更从容
对于短剧出海,字幕擦除是翻译、本地化配音和新字幕制作之前的关键一步;对于电商、广告和版权内容,它也能用于移除旧文案、人物标签与推广水印,为素材二次创作提供干净底片。
新版字幕擦除还支持 50 多种语种的文字擦除,为海外内容创作和本地化制作提供更顺畅的使用体验。
这次升级,不只是把某一行字幕擦得更干净,而是让系统开始理解文字在视频中的角色,并以受控的生成能力完成局部编辑:该擦的,擦得完整;该留的,保得准确;擦除后的画面,补得真实而稳定。
从“看见文字”到“读懂画面”,AI MediaKit 字幕擦除正在把无痕擦除带到更复杂的真实生产场景中,让视频本地化、素材复用和二次创作拥有更可靠的起点。
👉立即访问
https://docs.volcengine.com/docs/6448/2371372?lang=zh,体验无痕视频字幕擦除。