
模拟犯错的数字学生助力 AI 导师高效学习
微软和伊利诺伊大学联合推出了一套新系统,能基于有限数据构建逼真的单个学生数字副本。当从真实学生那里获取反馈成本过高且耗时过长时,这些副本可提供快速反馈,助力研究者改进 AI 导师。
AI 导师的最佳表现取决于能否因材施教,适应每位学生的优缺点。但确定哪种指导方式适合哪位学生,需要投入时间和金钱,因为这一切都依赖真实的学习者。
论文作者写道,用大规模且多样化的学生群体训练 AI 导师“成本极其高昂且耗时过长”。因此,这类导师的进步已落后于 AI 模型本身的发展速度。
研究人员提出,用学生的数字副本来替代真人提供快速反馈。他们的系统名为 StudentSim,能为每位学生构建独立的副本,即便该学生可用的学习记录非常有限。
学生副本需要具备犯错和从指导中学习的功能
据研究人员称,现有方法只能应对两种必要技能中的一种。一些模型能从真实学生数据中学习并可靠地复现学生行为,但它们无法利用导师的解释;另一些则是被提示扮演学生的语言模型,它们能轻松遵循导师的提示,却难以匹配所模拟学生的实际能力。
StudentSim 将这两种技能转化为可衡量的目标。它评估副本答案与真实学生答案(包括典型错误)的匹配度,以及副本在导师协助下修正答案的响应速度。训练导师既需要逼真的初始基准,也需要能对指导做出反应的模拟学生。
两阶段训练让有限学生数据变得可用
研究人员面临的最大障碍是数据匮乏。在英语写作数据集中,学生作文数量的中位数仅为三篇,且超过三分之二的学生作文数在五篇及以下。研究人员表示,直接用如此少的样本训练副本会失效,因为模型会产生过拟合。
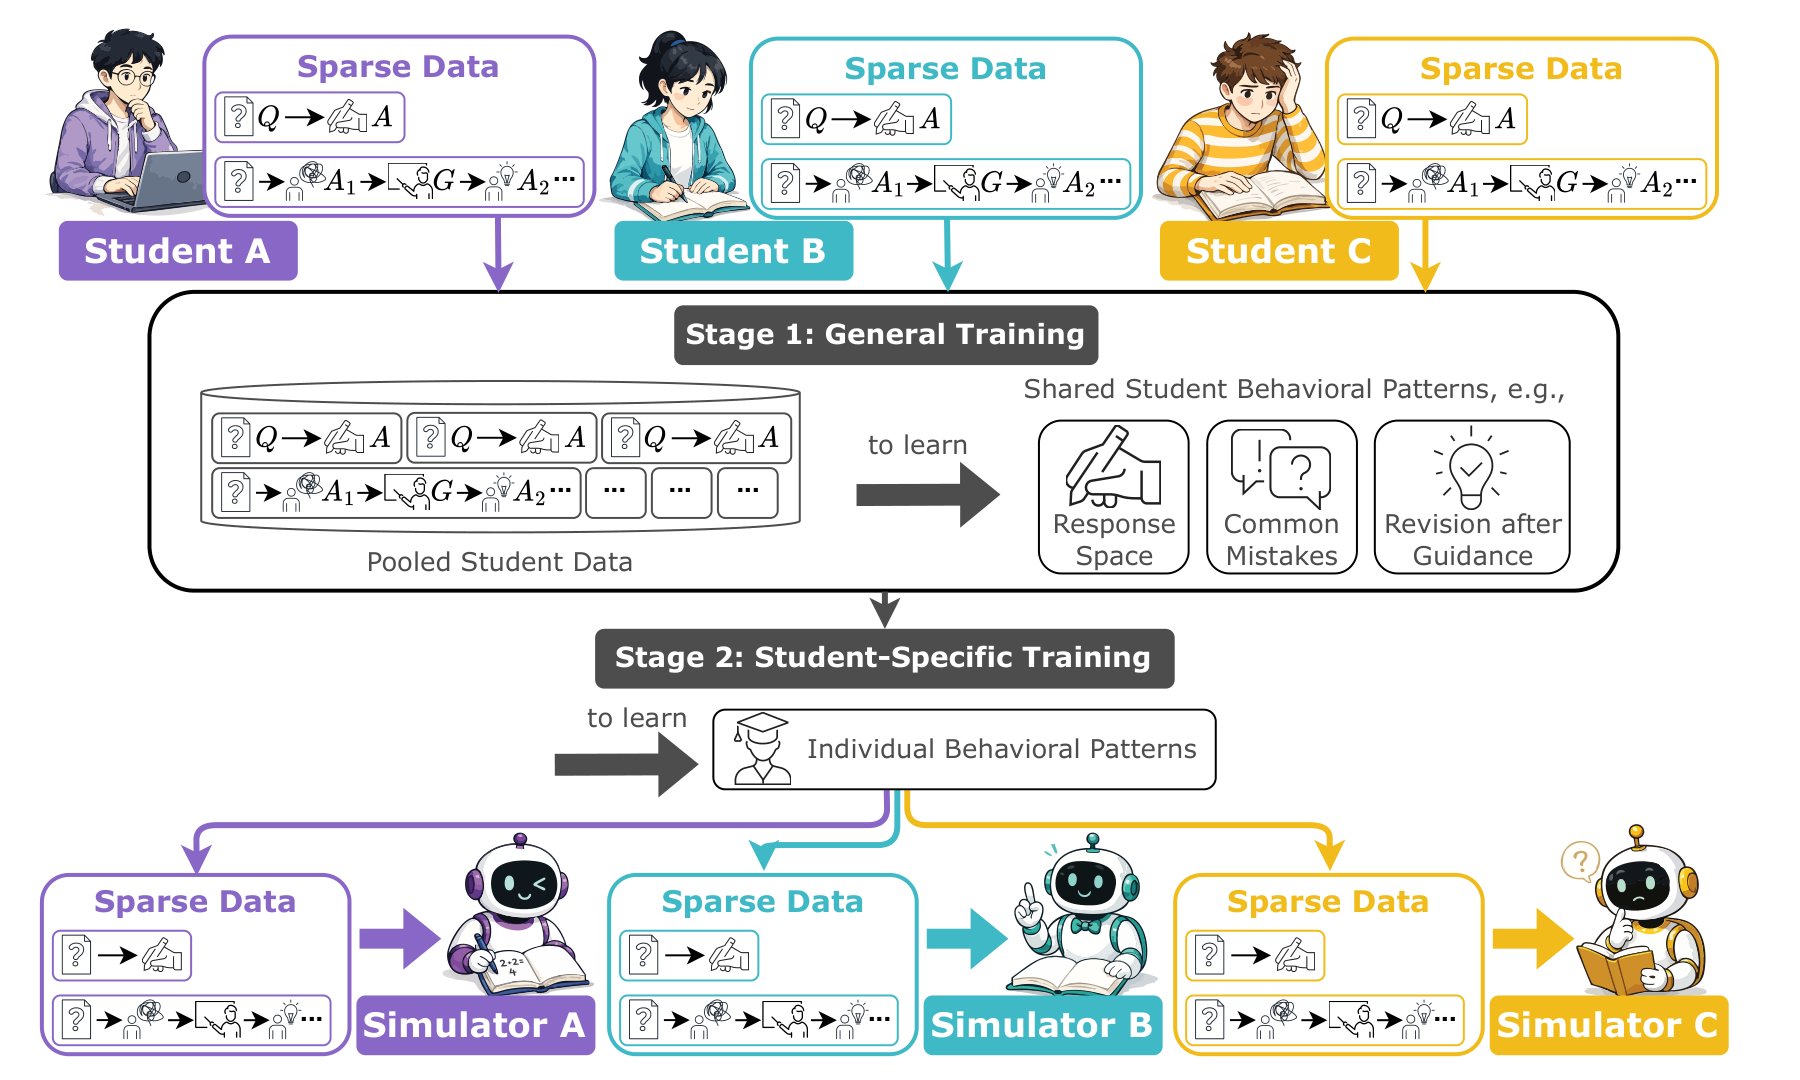
StudentSim 采用两阶段训练方式。首先,基础模型从某学科所有学生的汇总数据中学习,掌握常见错误以及学生在教师提示后修正答案的方式。
研究人员随后利用针对特定学生已有的少量记录,将该模型定制到个体层面。在所有学科中,系统均使用阿里的 Qwen3-4B-Instruct 语言模型作为基础。
StudentSim 在国际象棋、英语和数学中优于 GPT-5.4
研究人员在 60 名学生身上测试了该方法,涵盖国际象棋、外语英语和数学。他们使用了包含真实学习者记录的公开数据集。当 GPT-5.4 被提示扮演学生时,StudentSim 在这三个学科上的表现均优于这个更大规模的 GPT-5.4 语言模型。在国际象棋中,StudentSim 正确预测玩家下一步棋的频率几乎是 GPT-5.4 的两倍,并且几乎总能遵循纠正性指导。GPT-5.4 及专用国际象棋模型均落后于该模型。
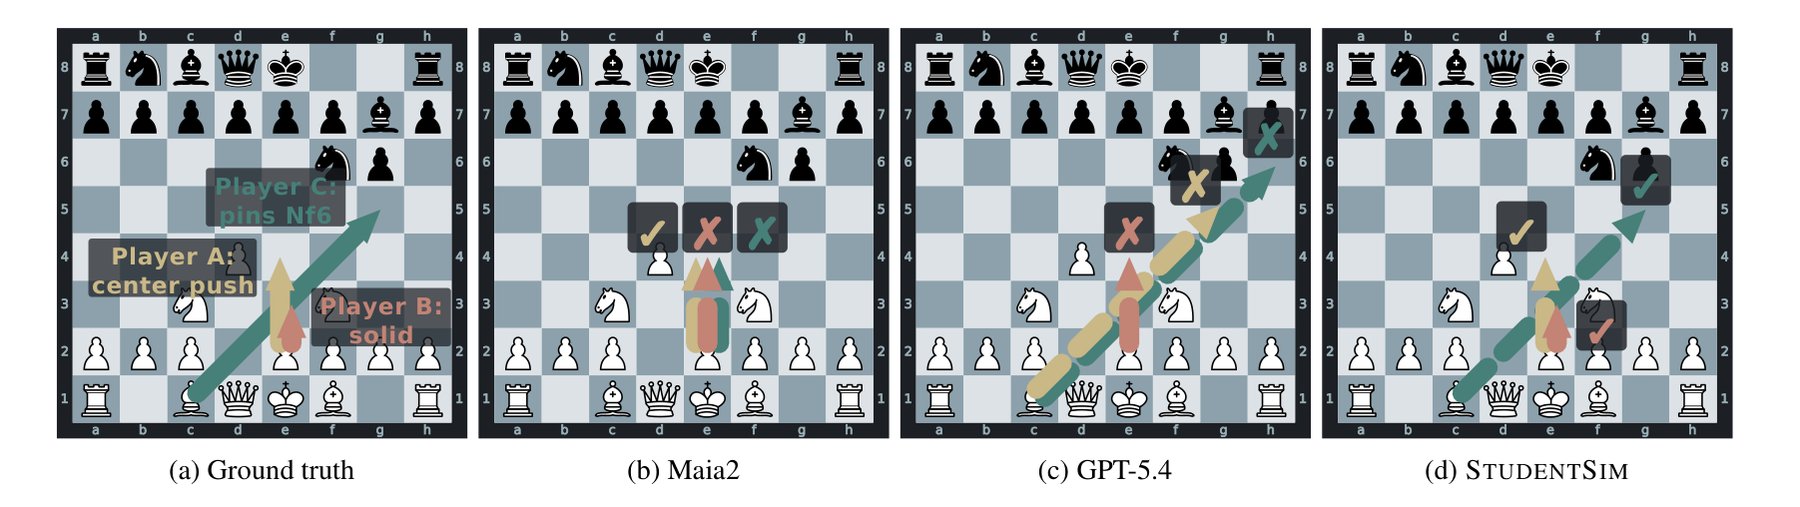
研究人员指出,现有方法各有短板。GPT-5.4 能跟随提示,却无法复现特定学生的错误;国际象棋模型能匹配棋手的行为,但看不懂也理解不了口头提示。在某个局面下,三位真实棋手走出了三步不同的棋:StudentSim 准确复现了每个人的选择,而象棋模型给三个人预测的都是同一步最可能的走法,GPT-5.4 则全部预测错误。
用模拟学生训练能提升国际象棋辅导 AI
作为另一个概念验证,研究人员利用学生复刻模型来改进一个国际象棋辅导 AI。职业棋手对三个版本进行了评估:未经此训练的原始版本、用 GPT-5.4 当学生训练的版本,以及用 StudentSim 训练的版本。
StudentSim 训练出的辅导 AI 在三项指标上得分最高:事实性错误最少,讲解质量和对个体学生的适配度评分也最高。在这个案例中,学生更倾向于被引导着找到解法,而不是直接被告知答案。
而用 GPT-5.4 训练的辅导 AI,在事实准确性上反而低于未做任何额外训练的版本。
研究人员强调,这只是概念验证,并不是宣称造出了最好的辅导 AI。国际象棋适合作为测试场景,因为引擎可以客观判断任意局面下每步棋的好坏。而作文写作和开放式数学题就难得多,因为自由作答缺乏可靠的评分函数。
接下来,团队希望模拟学生在多次练习中如何习得、保持和遗忘知识。代码已开源在 GitHub 上。
研究人员在 2024 年尝试用 AI 智能体复刻约 1,000 名真实用户,每位参与者需接受两小时的访谈。另一项研究则揭示了这些数字副本的局限性:九个开源大语言模型被要求模拟用户在 X、Bluesky 和 Reddit 上的行为,结果发现越像真人,内容准确率反而越低。
微软也在用真实学生测试 AI 辅导系统。在尼日利亚的一个试点项目中,学生在六周内每周两次使用 Copilot 学习,最终取得的测试分数提升相当于两学年的学习效果。
OpenAI 和 Google 分别通过Study Mode和Guided Learning提供各自的学习模式。这两者依赖系统指令和专为教学微调的模型,但都没有为个别学习者建立画像。缺乏这种个性化适配,AI 辅助反而可能削弱表现。研究表明,短暂依赖 AI 直接给答案的用户,其表现反而不如那些一开始就独立解题的人。