
华为昇腾跨过生态拐点,AIAgent却在偷传你的代码 ——中国AI的AB面
华为昇腾跨过生态拐点,AI Agent却在偷传你的代码 | |||
2026年6月,中国AI产业同一天经历了两件事: | |||
 | |||
2026年6月,注定要被写进中国AI产业史。 这一天,华为全联接大会2026刚刚落幕,华为副董事长汪涛站在台上,掷地有声地宣布:昇腾经过八年努力,生态跨过拐点。台下掌声雷动。同一天,一位安全研究者在社交媒体上发出一篇长文,揭示国内头部AI公司智谱的编程助手ZCode,正在悄悄把用户的全部代码打包上传云端。 这两件事发生在同一天,像一枚硬币的正反面——A面写着"算力自强",B面写着"数据失控"。把它们放在一起看,才是2026年中国AI的真实全貌。
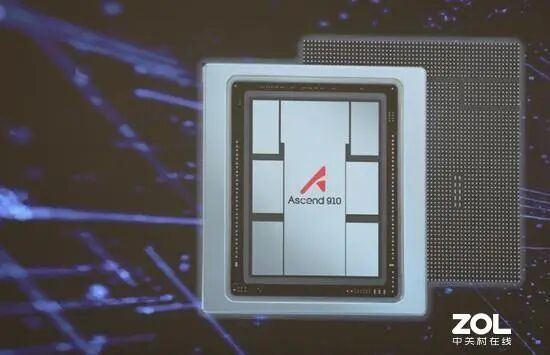
华为全联接大会2026,可能是近年来信息量最大的一场发布会。 汪涛首先亮出的,是昇腾960DT芯片。这颗芯片提前三个季度完成就绪,FP8算力达到2PFLOPS,FP4算力达到4PFLOPS,搭载288GB HBM高带宽显存,显存带宽达到9.6TB/s。单看参数,这已经进入了全球顶尖AI芯片的竞争区间。 更让人震撼的是超节点架构。4096张卡组成一个超节点,FP8算力达到8EFLOPS,HBM容量超过1PB。这意味着什么?意味着一个超节点,就能承载当前最大的万亿参数模型训练任务。而二层CLOS架构下最大可扩展到51.2万卡,结合多轨道拓扑更是可以达到百万卡级别——这是为未来十年准备的扩展能力。 | |||
 | |||
而华为给出的路线图更是激进:2028年昇腾970,2029年昇腾980,保持一年一代的节奏。这意味着华为不只是在追赶,而是在建立一个可预期的技术演进路径——对于开发者生态来说,这种确定性比任何参数都重要。  生态,才是真正的拐点 芯片参数可以追赶,但生态才是真正难啃的骨头。华为这一次给出的数据,确实配得上"拐点"二字。
这里面有两个数据特别值得注意:外部开发者占比61%,说明昇腾已经不再是华为"自己玩"的平台;PyTorch官方支持,意味着全球最主流的AI框架正式为中国算力平台背书。这是从"能用"到"好用"的质变。 日均新增合入代码超3万行——这个数字意味着整个社区的开发者每天都在真金白银地贡献代码,而不是简单地fork一份代码库了事。一个真正活着的开源社区,和一个"面子工程"之间的差距,就在这里。  灵衢协议:从芯片到系统的升维 如果说芯片是心脏,生态是血液,那么互联协议就是神经网络。 华为这次发布了灵衢互联协议,一举开源。这个协议统一了此前十余种互联协议的碎片化标准,将互联带宽从百GB级提升到TB级,RTT延迟从7微秒降至2微秒。这意味着,不同厂商的设备终于可以"说同一种语言"了。 系统工程的效果是惊人的:在由4K超节点组成的10万卡集群上,MFU(模型算力利用率)从20%提升至35%,相当于同样的硬件投入,有效算力提升了2.75倍。 配合Hi-ONE NPO光互联产品——业界首个量产NPO,单机架容量7.2T,功耗降低550kW——华为构建的是一个从芯片到互联、从单机架到超大规模集群的完整系统工程方案。
 汪涛在发布会上说了一句令人动容的话:"华为的核心使命是打造算力底座。我们把他们托得越高,中国AI竞争力越强。" 这不是一句客套话。华为选择不做应用层、不做模型层,只做最底层的算力基础设施——把舞台搭好,让上面的舞者尽情表演。这种战略定位,在当下浮躁的科技行业里,显得格外清醒。 | |||
| |||
故事的起点是一位名叫ferstar的博主。他对智谱推出的AI编程助手ZCode进行了一次逆向分析,结果发现了令人不安的事实:
事件曝光后,智谱紧急致歉,称该功能为"默认开启",并承诺将开源相关代码库、引入第三方安全审查。但问题在于:一个"默认开启"的功能,为什么不需要用户明确授权?对于编程助手这类工具来说,用户的代码就是身家性命。把身家性命交给一个没有退出机制的黑箱,这和把家门钥匙交给陌生人有什么区别?  不止智谱,全球AI行业集体"中招" 如果说智谱事件只是个案,那接下来的发现就让人不寒而栗了。 安全研究者cereblab对马斯克旗下xAI的Grok Build进行抓包分析,发现它会把用户整个项目打包上传到谷歌云存储——包括用户明确禁止读取的文件,以及未脱敏的密码信息。 而Anthropic的Claude Code被发现回传用户的位置和身份信息。Anthropic工程师随后确认,这是一次"有意实验"——但问题是:谁给了你"实验"用户数据的权力? 隐私政策的系统性风险 更深层的问题在Anthropic的隐私政策里。 这份政策已经历13次修订,每一次都在扩大数据使用的边界。现行版本中,有几条规定尤为刺眼:
请注意:连英伟达这样的美国本土科技巨头,都已经开始对Anthropic的数据安全产生警惕。这不是简单的"隐私泄露"问题,而是系统性的数据主权风险。 而最讽刺的是:目前的安全框架,没有一条规则约束厂商自身行为。所有的安全规范都在要求开发者、要求用户,却没有人来监管这些AI公司自己。 谁来审计AI Agent? 当我们为昇腾960的算力欢呼时,另一个问题正在悄然浮现:AI Agent的能力越强,数据安全风险就越大。 传统的软件是工具,你用它,它才动。但AI Agent不一样——它有自主性,会主动获取信息、主动执行操作。当它"主动"访问你的文件系统时,你的代码、你的密钥、你的商业机密,对它来说都是"可读的"。 ZCode事件暴露的不是某一家公司的问题,而是整个AI Agent行业在数据安全方面的系统性缺失。没有强制性的数据上传告知机制,没有用户可控的隐私开关,没有第三方审计标准,甚至连"默认开启"都需要用户自己去发现、去逆向、去曝光。 这不应该是2026年AI行业该有的样子。当我们把AI Agent放进代码仓库、放进企业内网、放进核心业务流程的时候,如果底层的数据安全机制没有跟上,那无异于在沙滩上建高楼。 | |||
 | |||
结语:算力底座要自建,数据安全也要自主可控 回到开头那枚硬币。 A面,华为用八年时间把昇腾从"能用"做到"好用",用开源协议、用PyTorch官方支持、用一年一代的路线图,告诉全世界:中国AI的算力底座,我们自己建。 B面,AI Agent行业用一次次的"默认开启"、"有意实验"告诉我们:如果你的数据不在自己手里,你就没有真正的安全。 这两面不是对立的,而是互补的。算力自主解决的是"卡脖子"问题,数据安全自主解决的是"被偷家"问题。前者我们已经看到了曙光,后者还是一片迷雾。 中国AI的下半场,拼的不只是算力,还有信任。而信任的前提,是把数据安全的主导权真正交回到用户手里。
— END — |