
使用OpenAI接口格式调用大模型
OpenAI 的接口格式并不是一个官方发布的“开放标准”,而是由行业实践推动形成的“事实标准”(De Facto Standard)。
它之所以被广泛采用,核心原因可以归结为以下几点:
1. 先发优势与生态锁定
OpenAI 是最早将大模型能力通过 API 产品化、标准化的厂商。它的接口定义简洁直观——一个 model 字段指定模型,一个 messages 数组承载对话历史,一个 stream 开关控制流式输出。 这种设计足够简单,任何大模型供应商只要对上这个接口格式,就能接入整个生态。
随着 ChatGPT 的爆发,围绕这套接口格式迅速形成了庞大的工具链和开发框架:
主流 AI 框架:LangChain、LlamaIndex、AutoGen 等默认对接 OpenAI 格式
开源推理引擎:vLLM、Ollama、LocalAI 等一发布就优先支持兼容模式
AI 客户端工具:几乎所有桌面端/网页端 AI 客户端都基于此格式设计
2. 零成本切换模型,避免厂商绑定
如果业务代码硬对接某家厂商的原生 API,一旦遇到服务商涨价、接口限流、服务不稳定等问题,想要切换备选模型,整体改动成本极高,甚至需要重构业务模块。
而基于 OpenAI 兼容协议开发后,上层业务只对接一套标准接口,底层可以灵活切换各类公有大模型、本地私有化模型,业务代码基本无需改动。
3. 解决行业接口碎片化痛点
据 2026 年 AI 应用开发行业调研数据显示,在 OpenAI 兼容协议普及之前:
超 68% 的开发者需为不同模型单独开发适配代码
35% 的 AI 项目迭代耗时消耗在接口调试、格式兼容、异常适配环节
各家大模型厂商的接口参数、请求格式、流式响应规则、错误码体系互不统一,形成严重的接口碎片化问题。 OpenAI 兼容协议的出现,相当于给整个行业提供了一套通用的"通信语言",让上层业务完全不用感知底层模型的厂商和类型。
4. 统一的能力抽象标准
OpenAI 格式不仅仅定义了请求/响应的数据结构,还标准化了一系列关键能力:
| 能力 | 说明 |
|---|---|
| Function Calling | 定义了工具调用的标准交互范式,让模型能"申请调用外部函数",这是构建 Agent 的基础 |
| 流式输出(SSE) | 统一了 Server-Sent Events 的数据格式,data: {...} 逐块推送,data: [DONE] 标识结束 |
| 参数控制 | temperature、max_tokens、top_p 等参数名称被行业沿用,语义一致 |
| 结构化输出 | 通过 JSON Schema 精确控制模型输出格式,提升数据可靠性 |
5. 当前格局与未来趋势
截至 2026 年,主流国产大模型(Qwen、Kimi、DeepSeek、智谱等)、开源推理框架(vLLM、Ollama)以及各大云厂商的 AI 平台(阿里云百炼、火山引擎等)均已全面兼容 OpenAI 格式。
不过值得注意的是,行业也在探索新的标准:
OpenAI Responses API:面向 Agent 场景的新一代交互抽象,将多次工具调用、多模态流建模为连续的 Items 序列
Open Responses:由 OpenAI 发起、Hugging Face 等开源社区支持的开放推理标准,旨在解决 Chat Completion 格式在 Agent 用例中的局限性
但截至目前,Chat Completions 格式仍然是事实上的主流标准。
安装OpenAI库
首先使用以下命令安装OpenAI的python库:
pip install openai
使用OpenAI接口格式调用本地大模型
from
openai
import
OpenAI

if
__name__
 ==
'__main__'
:

# 调用本地 Ollama —— 同样只改 base_url

client
 =
OpenAI
(
base_url
=
"http://localhost:11434/v1"
,
api_key
=
"ollama"
)

response
 =
client
.
chat
.
completions
.
create
(

model
=
"modelscope.cn/unsloth/Qwen3.5-2B-GGUF"
,

messages
=[{
"role"
:
"system"
,
"content"
:
"你是什么模型呢"
}],

stream
=
False

    )

print
(
response
.
choices
[
0
].
message
.
content
)其中第9行content的属性为对大模型对话中的输入文字,role属性在此处设置为了system;关于role的属性这里做个简单介绍,有四个角色:
| 角色 | 谁用它 | 作用 |
|---|---|---|
system | 开发者 | 设定模型身份、行为规则、回答风格(全局指令,通常放第一条) |
user | 用户 | 提出问题、发送指令 |
assistant | 模型 | 模型之前生成的回复(用于传递历史对话,让模型"记住"上下文) |
tool | 外部工具 | 函数调用后返回的执行结果 |
system:定规则,放开头,影响全篇语气和边界user:提需求,驱动对话,至少需要一条assistant:存历史,多轮对话时必须把模型上一轮的回复传回去,否则模型"失忆"tool:配合函数调用使用,tool_call_id必须与assistant消息里的tool_calls[].id严格对应
可以发现不同的角色对于大模型来说会影响不同的生成结果,因此在使用大模型对话设置提示词时,可以在里面带入角色信息,以提高生成答案的命中率。
使用OpenAI接口格式调用deepseek的api
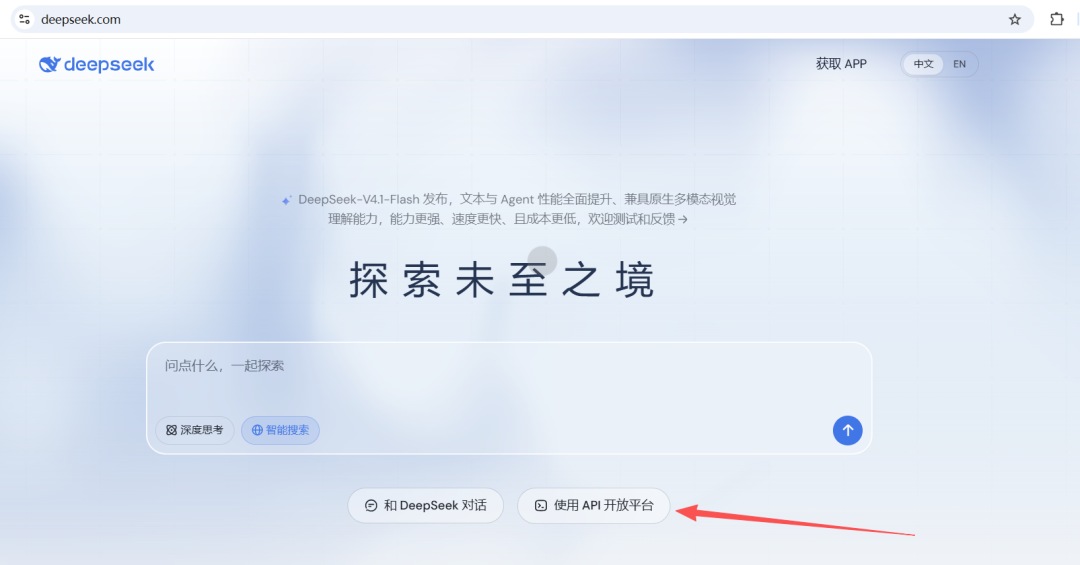
deepseek模型较大,本地部署需要花费巨大的算力,一般采用直接调用deepseek官网的api。首先需要前往deepseek官网(https://www.deepseek.com/),点击箭头之处
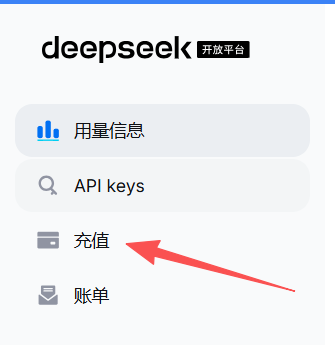
然后充值,建议充值0.5元测试即可
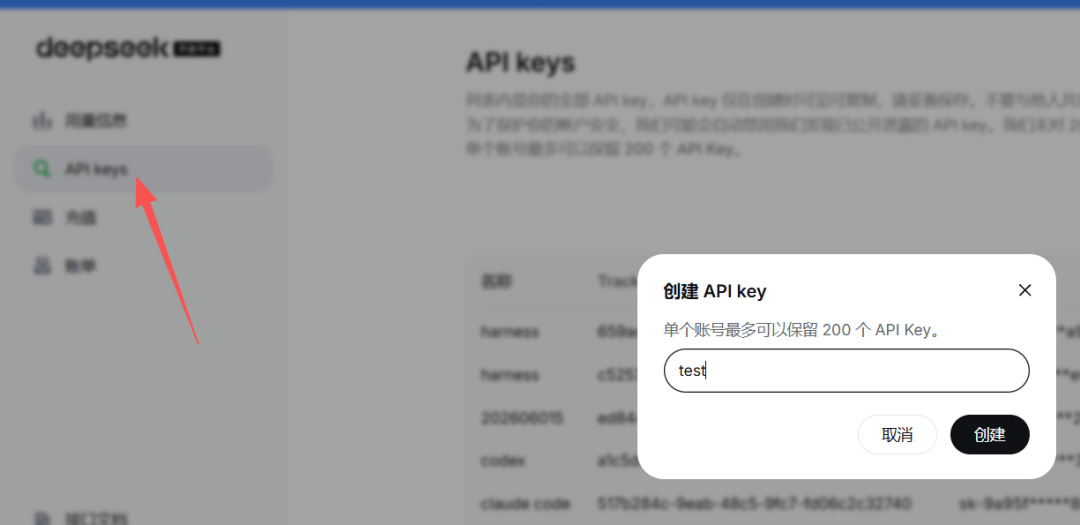
接着点击API keys,输入key的名称
点击创建之后会生成key的值
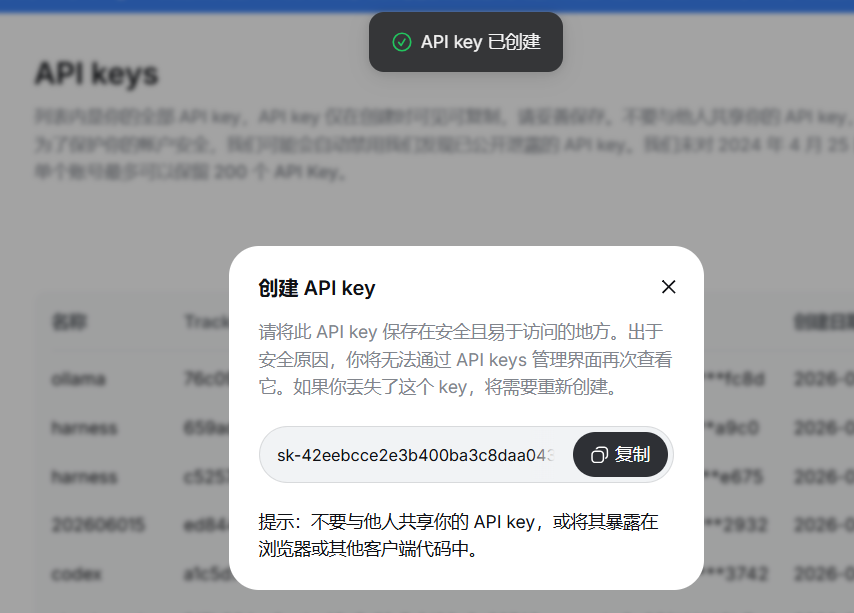
复制key的值。对上面的代码简单修改,修改后的结果如下:
from
openai
import
OpenAI

if
__name__
 ==
'__main__'
:

# 调用deepseek在线api —— 改 base_url 和 api key的值

client
 =
OpenAI
(
base_url
=
"https://api.deepseek.com"
,
api_key
=
"sk-42eebcce2e3b400ba3c8daa04349fc8d"
)

response
 =
client
.
chat
.
completions
.
create
(

model
=
"deepseek-v4-flash"
,

messages
=[{
"role"
:
"user"
,
"content"
:
"你是什么模型呢"
}],

stream
=
False

    )

print
(
response
.
choices
[
0
].
message
.
content
)
运行结果如下:

对比代码可以发现,改了三处:第一处是base_url的值,这是官方文档提供的接口路径;第二处是api_key的值,将刚刚复制的key的值粘贴到此处即可;第三处是model的值,官方提供2个值,分别是deepseek-v4-flash和deepseek-v4-pro,也就是常见的快速模式和专家模式。
好了,这次教会了大家使用OpenAI的接口格式调用大模型,在实际工程中,我们基本上使用OpenAI和 anthropic 的方式调用大模型的接口。