
使用 Python 和依赖图检测公开数据集中的目标泄漏
之前,我拿了一个公开的 CDC 数据集的五列数据给机器学习模型,让它预测同一文件中的第六列。模型跑出了 0.998 的 R² 分数,这几乎达到了真实模型能做到的最高精度。
这个分数看起来像成功了,但模型其实没学到多少真实世界的规律。因为 CDC 就是用前五项计算出了第六项,模型只是反推出了 CDC 的公式而已。
数据科学家把这个问题称为目标泄漏(target leakage),即喂给模型的输入数据中,以某种形式包含了答案本身。
这类泄漏在公开数据里特别难发现,因为大量公开数据本身就是由其他公开数据计算得出的。比如某个政府指数可能基于调查数据构建,而另一个指数又可能基于第一个指数计算得出。各机构会在方法论文档中说明这些计算逻辑,但数据目录极少将这些记录保存成计算机可校验的格式。
在本教程中,你将亲自编写这类记录,并构建一个小型 Python 工具来读取它。该工具的工作原理类似于包管理器中的依赖检查器:你告诉它要预测什么、打算使用哪些列,它就会拒绝任何位于目标变量推导路径上(无论是作为中间步骤还是作为源头)的列。
学完本教程后,你将能够:
使用实时的 CDC 数据和 scikit-learn 复现真实的泄漏案例
用一个名为 manifest 的小型 YAML 文件来描述数据集的构建来源
使用广度优先搜索(BFS)和深度优先搜索(DFS)遍历该依赖图
制作一个检查工具,遇到拼写错误、文件损坏或输入为空时能大声报错(fails loudly)
在每次代码推送时通过 GitHub Actions 自动运行该检查
目录
准备工作
跟着本文操作,你需要:
Python 3.10 或更高版本
对 pandas DataFrame 有基本了解
一个可以执行命令的终端
约 7 MB 的可用磁盘空间,用于存放 CDC 数据文件
先创建一个新项目文件夹,并在其中建立虚拟环境,这样这些库就不会和系统其他部分混在一起。然后安装本教程用到的三个库:
mkdir leak-tutorial
cd leak-tutorial
python3 -m venv .venv
source .venv/bin/activate
pip install pandas scikit-learn pyyaml
在 Windows 上,用 .venv\Scripts\activate 代替 source 那一行,并且在本文出现 python3 的地方改用 python。本教程的所有命令都要在 leak-tutorial 文件夹内执行。
本教程中你构建的每个文件都放在配套仓库 derives-from-tutorial 里,遇到卡壳时可以对照参考。
完整版工具托管在一个公开的 GitHub 仓库中,链接见文末。
用大白话解释关键术语
下面是本教程中反复出现的五个概念:
Target(目标变量):你希望模型预测的那一列。
Covariate(协变量):输入给模型、帮助它预测目标变量的列(很多人称之为特征)。
R²(决定系数):衡量模型预测值与实际值吻合程度的指标。得分 1.0 表示完全吻合,接近 0 则表示模型的解释力极弱。
Census tract(普查区):美国的小型地理区域,通常容纳约 4,000 人,规模大致相当于一个街区。
Cross-validation(交叉验证):一种公正的模型测试方法。将数据分成五份,用其中四份训练,剩下一份测试,循环轮换,直到每份数据都做过一次测试集。
第一步:亲眼看到泄漏
美国疾病控制与预防中心(CDC)发布了 Social Vulnerability Index(社会脆弱性指数,SVI)。应急规划人员用它来识别在洪水、热浪或疫情爆发期间可能需要额外援助的社区。
CDC 分层构建 SVI。起点是美国人口普查局主导的大型调查——美国社区调查(ACS)中的 16 个字段。每个字段都是一个百分比,例如贫困人口的占比,或无车家庭的占比。
CDC 将这 16 个字段归入四个主题,并在每个主题内对各个普查区进行排名。随后,它将四个主题排名合并为一个总体排名,即 RPL_THEMES。
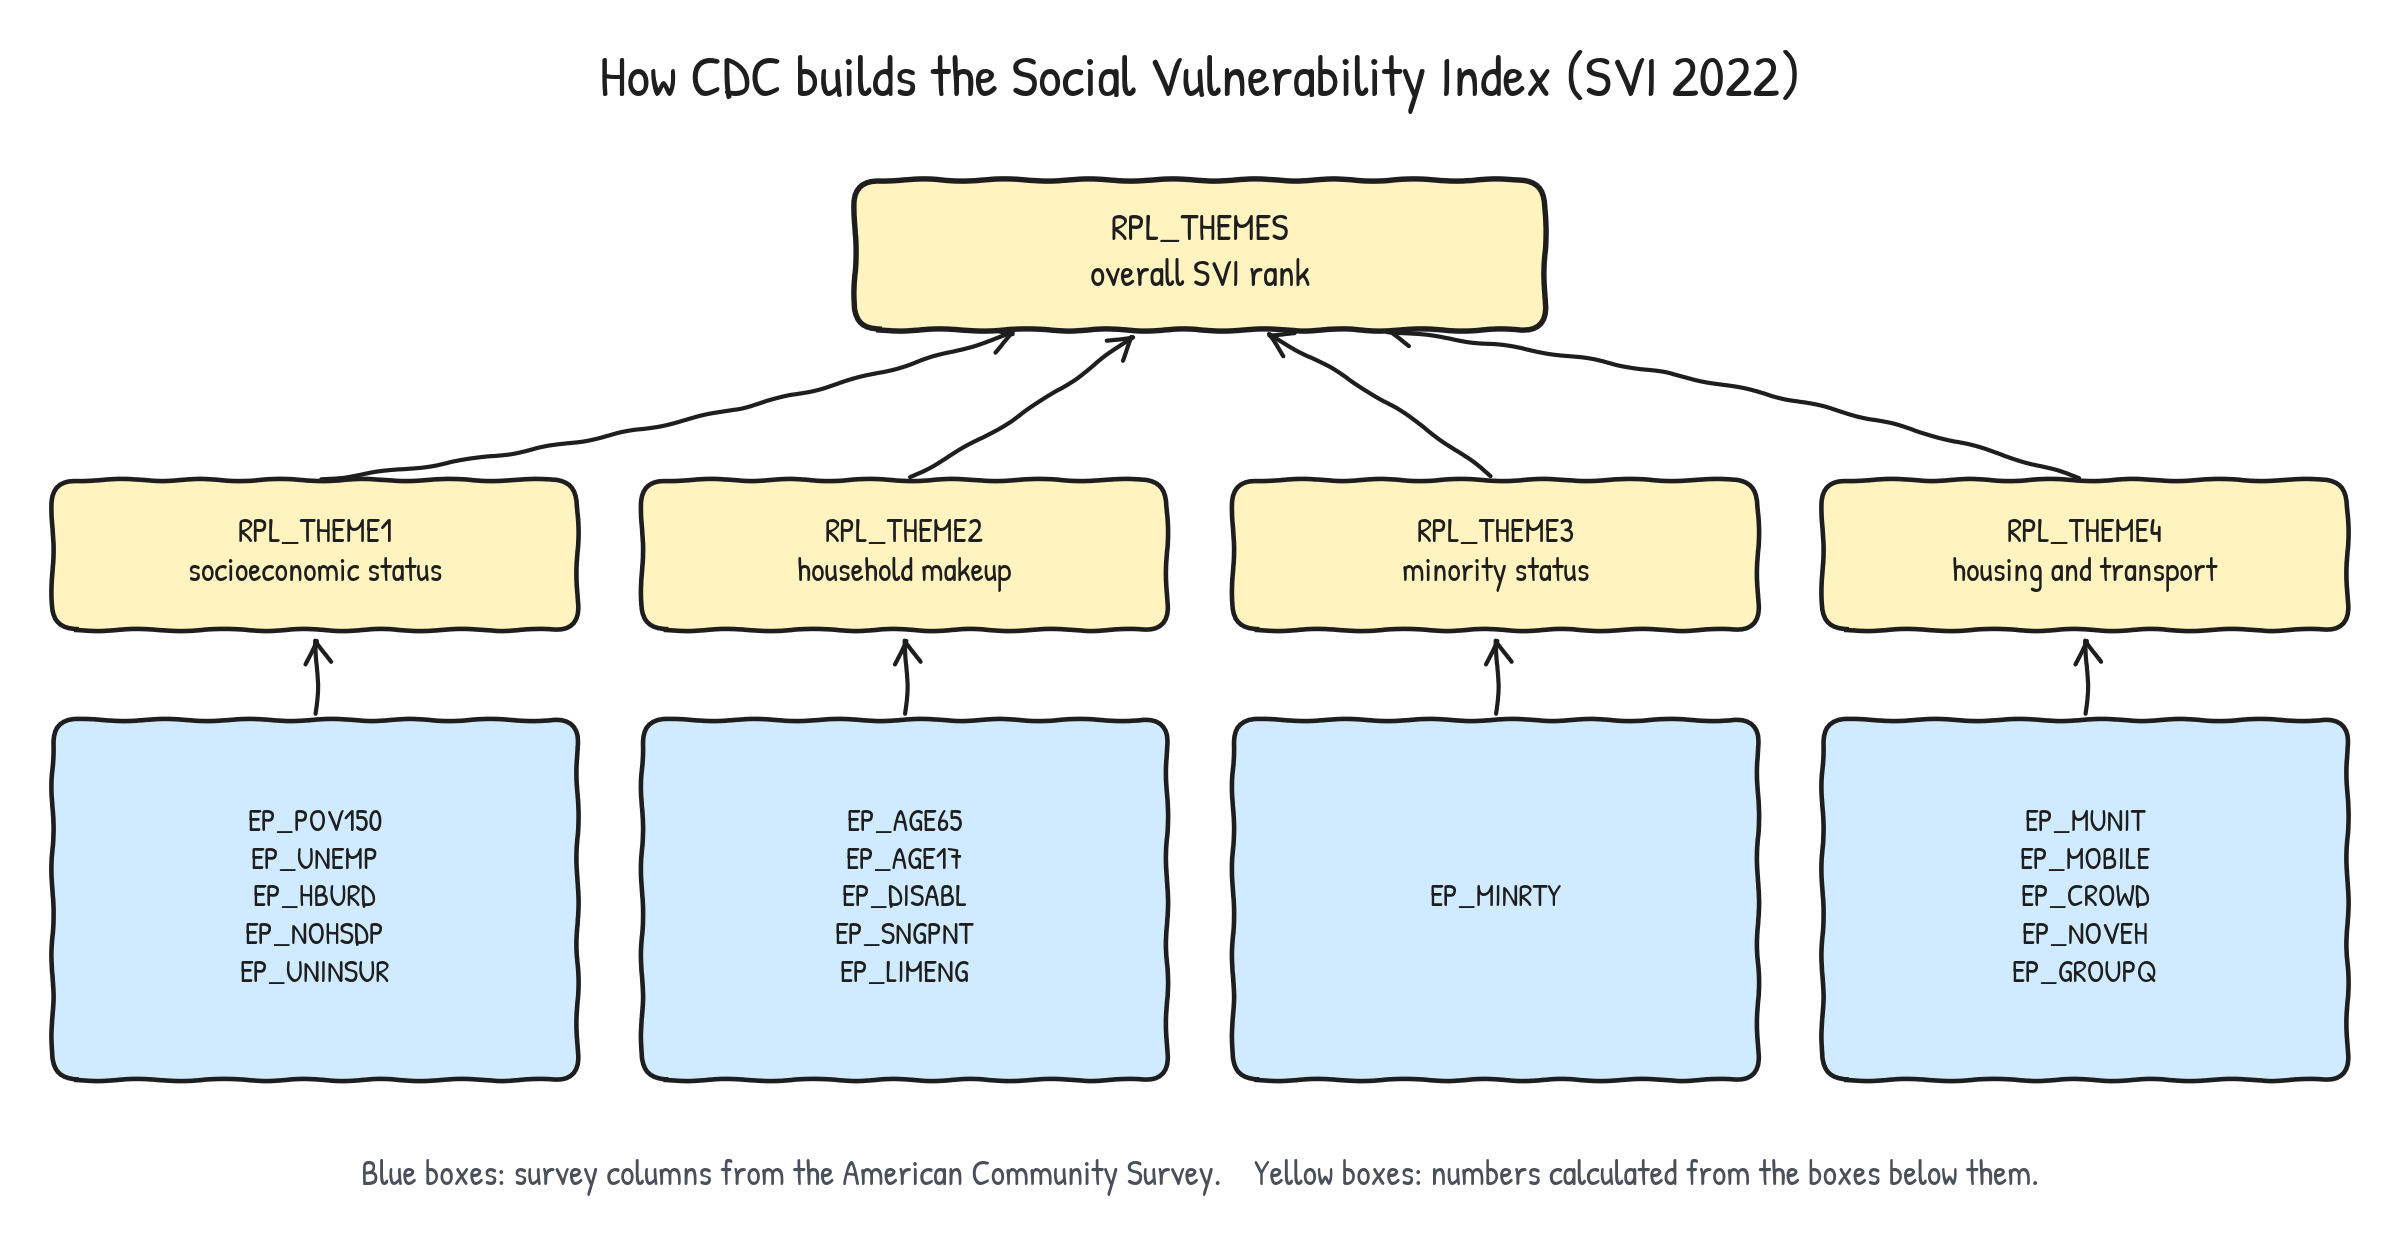
CDC 构建 SVI 的流程:16 个 ACS 调查字段汇入 4 个主题排名,4 个主题排名再汇入 1 个总体排名。每个黄色框都由下方的框计算得出。
本教程关心的关键细节在于:CDC 将原始 ACS 字段和最终排名放在同一个 CSV 文件中发布。这使得人们可以轻易同时获取两者,并将它们输入同一个模型。
下载加州数据文件:
curl -L -o California.csv https://svi.cdc.gov/Documents/Data/2022/csv/states/California.csv
这里使用 curl,是因为 macOS 上部分 Python 环境在下载文件时无法正确验证网站的安全证书。
创建一个名为 leak_demo.py 的文件:
"""leak_demo.py: 用构建该公开指数的列反推其数值。"""
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.model_selection import KFold, cross_val_score

# CDC 用 -999 表示缺失值,先把它替换成标准的空值。
df = pd.read_csv("California.csv", low_memory=False).replace(-999, float("nan"))

def score(inputs, target):
    data = df[inputs + [target]].dropna()
    model = HistGradientBoostingRegressor(random_state=0)
    folds = KFold(n_splits=5, shuffle=True, random_state=0)
    r2 = cross_val_score(model, data[inputs], data[target],
                         cv=folds, scoring="r2").mean()
    print(f"{target:<11}  由 {len(inputs)} 列生成  "
          f"tracts={len(data)}  R2 = {r2:.3f}")

# Theme 1 恰好由下面这 5 列构建而成。
score(["EP_POV150", "EP_UNEMP", "EP_HBURD", "EP_NOHSDP", "EP_UNINSUR"],
      "RPL_THEME1")

# EP_NOINT 也在同一个文件里,但 CDC 没把它编进指数。
score(["EP_NOINT"], "RPL_THEMES")
脚本流程如下:
读取 CSV 文件,把 CDC 的
-999标记转为空值。CDC 就是用-999来标识缺失数据的。score函数训练一个梯度提升模型——这是处理数值型表格数据的强基线方案——并用五折交叉验证计算 R² 。第一次调用用 CDC 构建 Theme 1 时所用的 5 列来预测 Theme 1。
第二次调用用
EP_NOINT来预测综合排名。EP_NOINT表示没有宽带互联网订阅的家庭占比。CDC 把这列放在同一份文件里,却没把它纳入指数。
运行:
python3 leak_demo.py
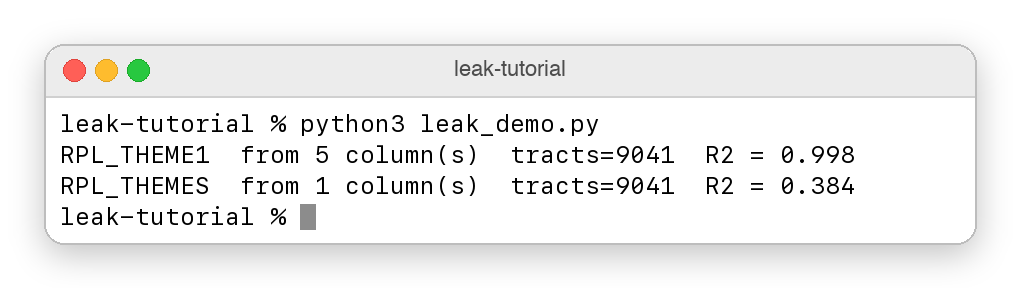
leak_demo.py 的输出。Theme 1 由 CDC 用于构建它的 5 列预测,R² 达到 0.998。综合排名由 CDC 未纳入指数的那一列预测,R² 为 0.384。
第一个分数是 0.998,说明模型几乎完美重建了 CDC 的 Theme 1。CDC 的公式是一套固定配方,模型手握全部原料。
第二个分数是 0.384。EP_NOINT 在文件里就排在索引旁边,它的分数反映的是两个相关指标之间普通关联的强度。
现在想象一篇论文声称预测社会脆弱性的 R² = 0.998。这个数字看起来像重大突破,其实只说明模型找到了 CDC 的配方。
本文的分数来自 scikit-learn 1.8.0,在 scikit-learn 1.3.2 到 1.9.0 版本间保留三位小数结果一致,你跑出来的结果应该也能对上。
第 2 步:理解公开数据为什么会泄露
SVI 这个例子容易发现,因为输入和索引在同一个文件里。大多数真实案例要隐蔽得多,因为数据链条会横跨多个机构。
这里有一个真实案例,涉及三个组织。FEMA 的 National Risk Index(NRI)包含一个社会脆弱性分数。根据 FEMA 的技术文档(1.20 版,2025 年 12 月),这个分数来自 Census Bureau 的 Community Resilience Estimates,而 Census Bureau 用 ACS 调查数据构建这些估计值。
也就是说,FEMA 的风险分数和某个 ACS 列可能处在同一条数据链的两端,尽管它们来自不同机构、不同网站。
要理解为什么计算机发现不了这一点,你需要知道一个数字可能带有的两种历史:
来源(Provenance)回答“这个数字从哪里来?”。比如,某个值来自
California.csv,而这个文件来自svi.cdc.gov。推导(Derivation)回答“这个数字是怎么算出来的?”。比如,Theme 1 是由五个 ACS 列计算得出的。
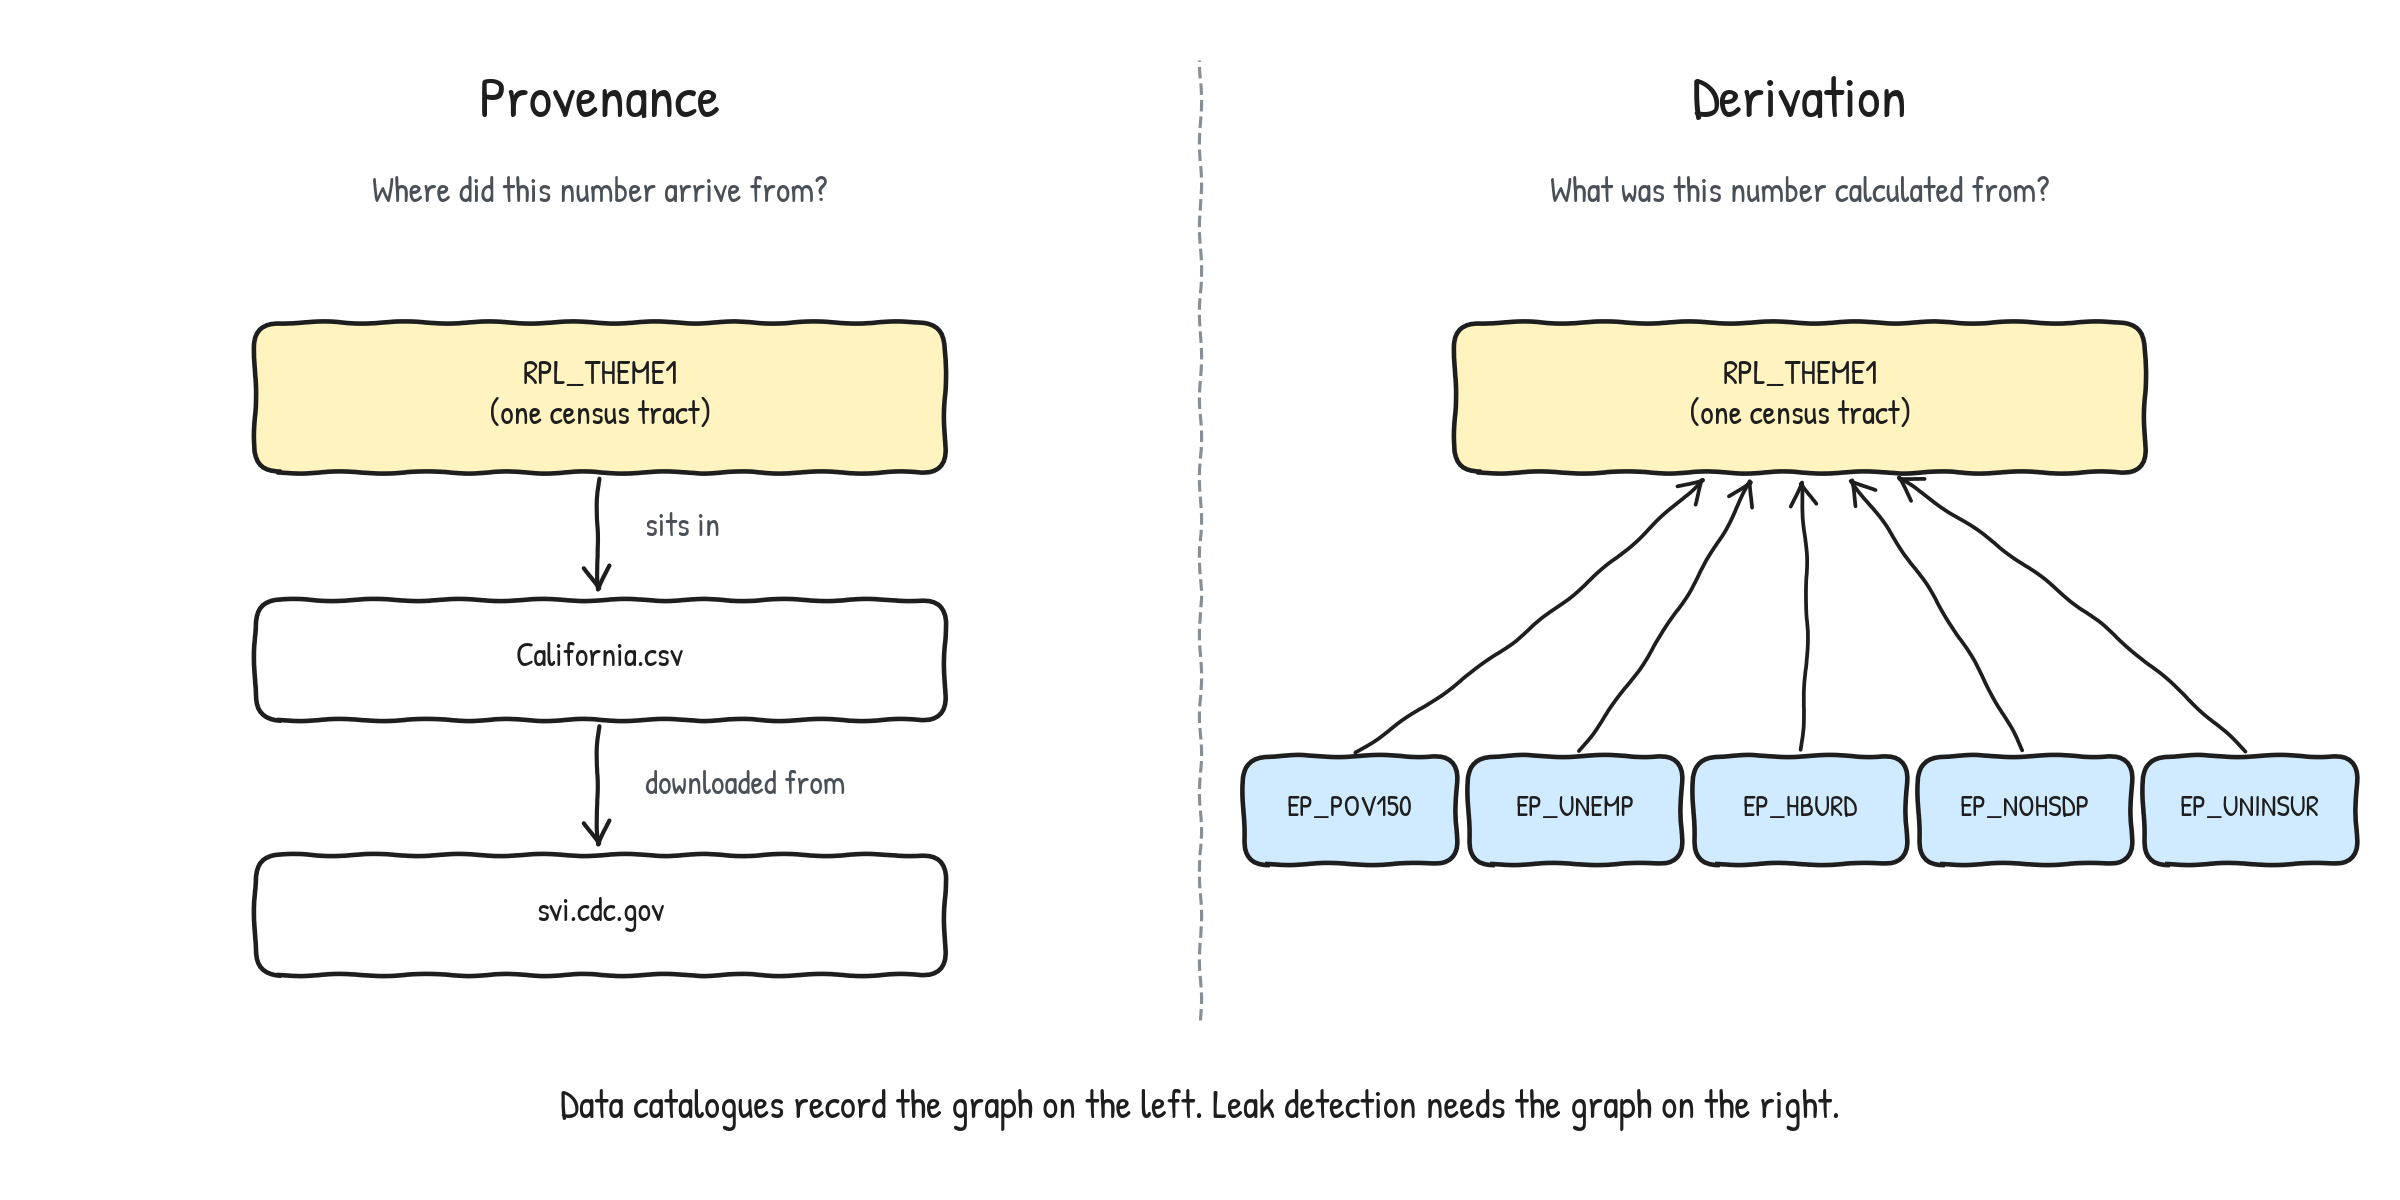
一个数字可能带有的两种历史。左图是来源,记录某个值来自哪个文件、哪个网站;右图是推导,记录 Theme 1 由哪五个 ACS 列计算而来。
大多数数据目录对溯源记录做得很好,Google 的 Data Commons 就是一个很好的例子:它把溯源定义为“导入的物理单元”,告诉你某个数字来自哪个文件。而衍生关系(derivation)通常只存在于那些为人类撰写的 PDF 方法论文档里。
因此,当自动化流水线搜索有用的协变量时,它可能会照单全收那些实际上构成了目标变量的列。流水线只看到高分,就会保留这些列。
步骤 3:借鉴包管理器的思路
软件开发者早就解决了一个非常类似的问题。
当你运行 pip install requests 时,pip 会读取 requests 依赖的包列表,再读取那些包依赖什么,依次向下遍历。由于每个依赖关系都白纸黑字写得很清楚,pip 可以在安装任何东西之前,提前发现树状结构中的任何潜在问题。
下面的图把包依赖树和数据领域的同类问题并排展示。
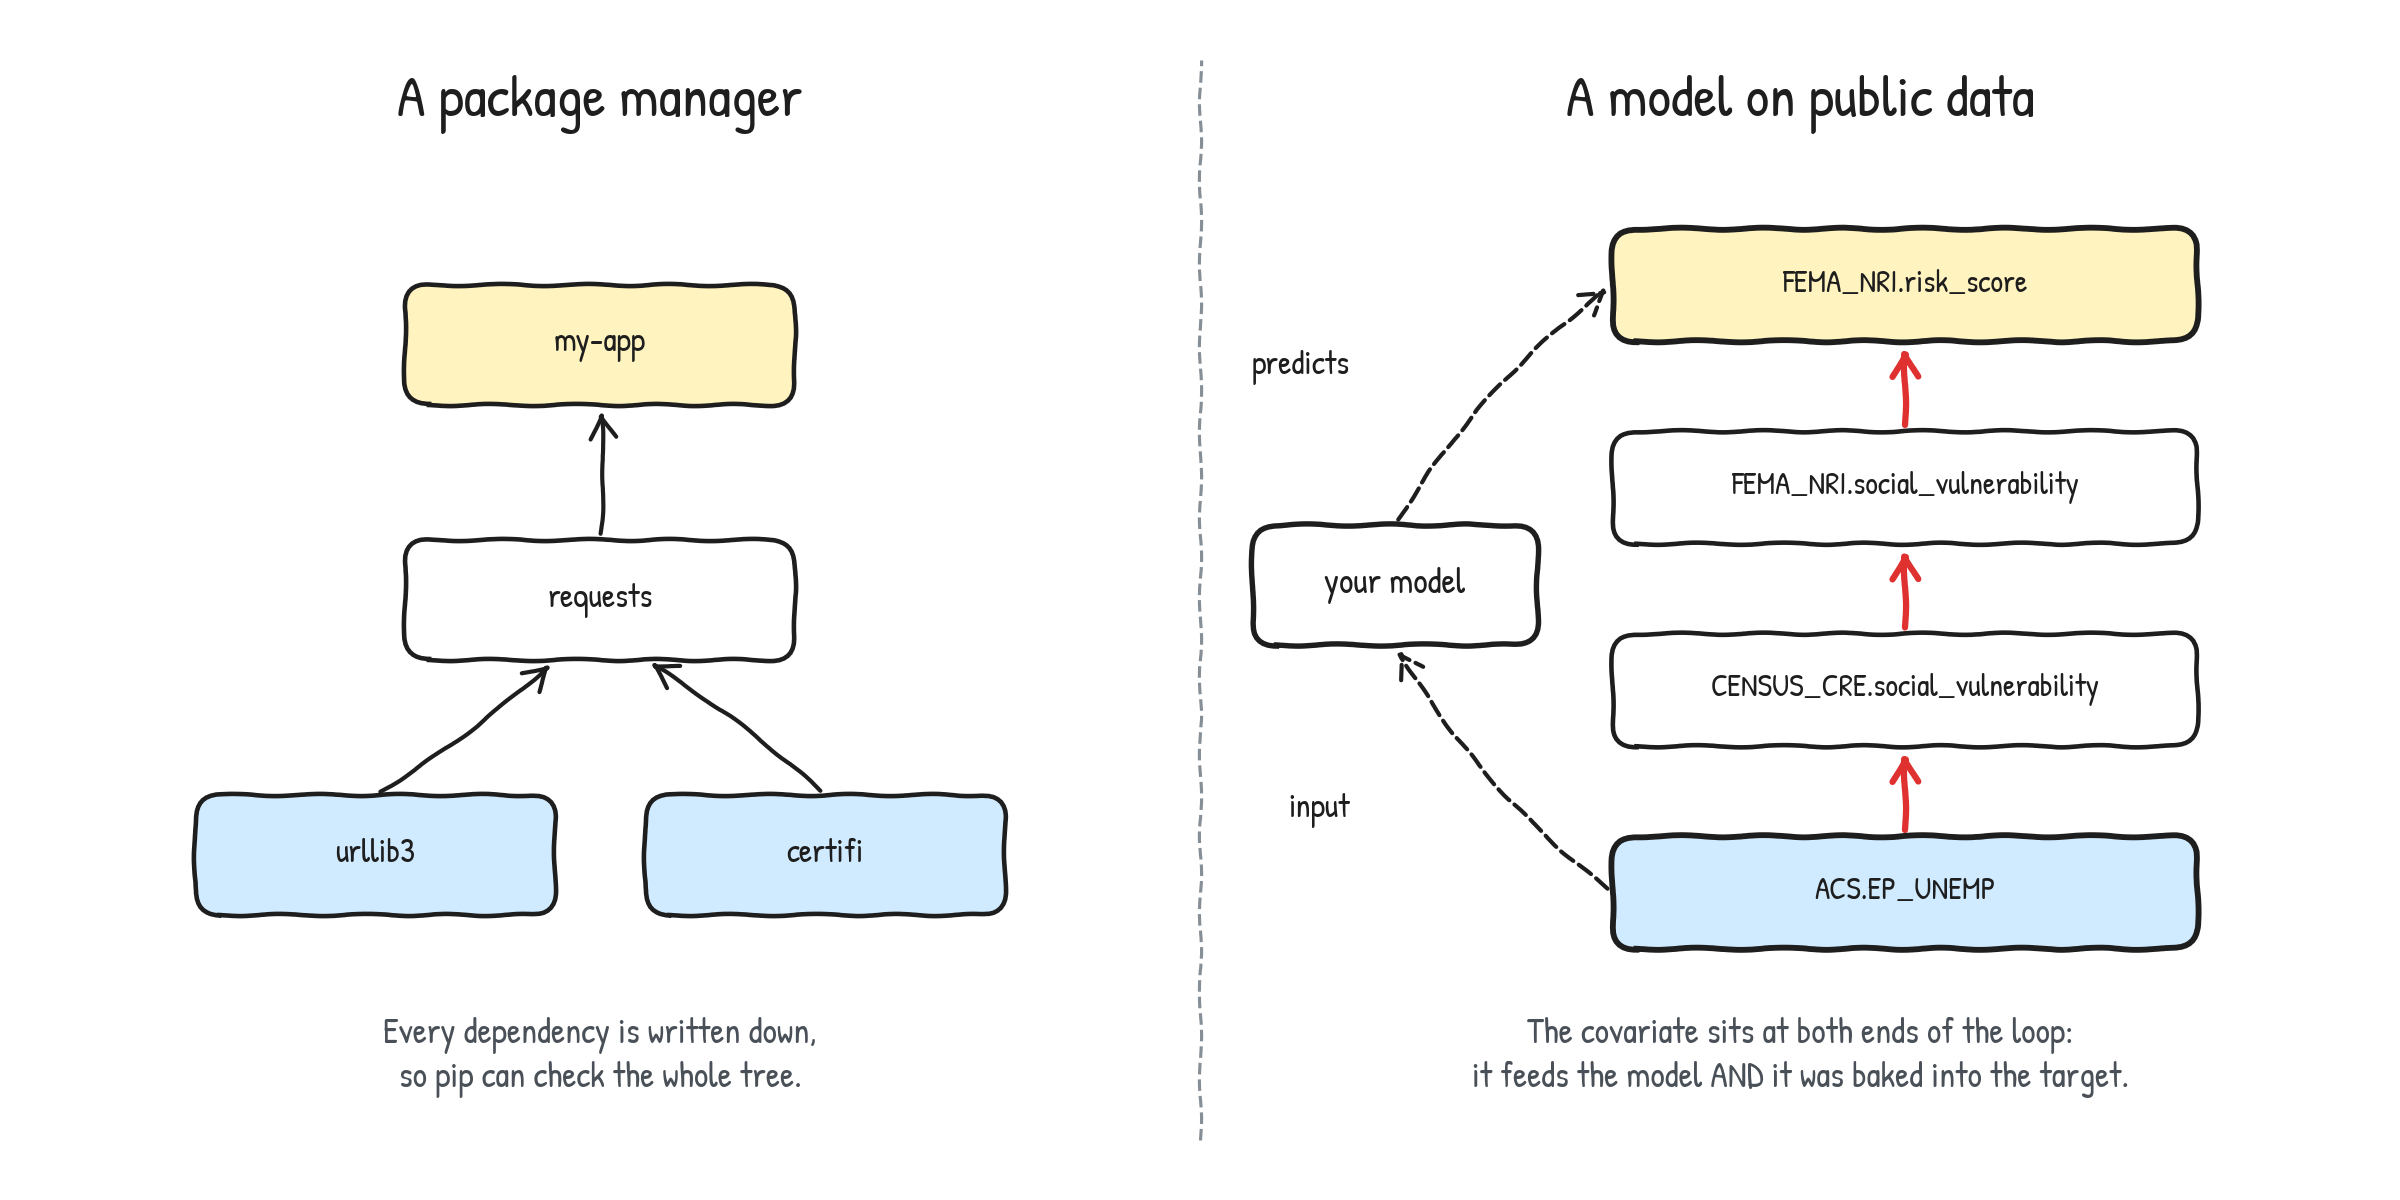
同样的结构,两次。左边是 pip 的依赖树: urllib3 和 certifi 汇入 requests,再汇入 my-app。右边是数据版本: ACS.EP_UNEMP 输入一个预测 FEMA_NRI.risk_score 的模型,而同一列还通过另外两个产品汇入该风险得分。
公开数据也需要同类的记录。在上面示意图的右半部分,ACS.EP_UNEMP(失业率)作为协变量进入模型。而同一列还向上穿过另外两个产品,进入了 FEMA_NRI.risk_score——也就是目标变量。这列数据同时出现在了循环的两端。
在计算机科学中,这类图被称为图(graph)。每个方框是一个节点,每条箭头是一条边。在数据图中,顺着箭头走总是向上、远离起点,因此该图是一个有向无环图(DAG)。所谓“无环”(acyclic),就是指箭头不构成任何循环。
全文中,每个箭头都由原料指向由其制成的产品。
两个族谱术语有助于描述图中的位置关系:
某节点的祖先是指从该节点沿箭头反向追溯能到达的所有元素,不限距离。ACS 各列是 SVI 的祖先。
某节点的后代是指从该节点沿箭头正向追溯能到达的所有元素。SVI 是 ACS 各列的后代。
因此,你的泄漏检查只需遵循一条简单规则:所有协变量都必须与目标的祖先和后代保持隔离。
步骤 4:编写依赖清单
清单(Manifest)是一个文件,用于列出所有产品及其构建来源。此处使用 YAML 格式,因为它便于人工阅读和编辑。
下面展示一个实际测量产品的示例:
ACS.EP_UNEMP:
  label: Unemployment rate
  measurementBasis: measured
  derivesFrom: []
derivesFrom: [] 中的空列表表示父节点为零,因为该产品直接来源于调查,未经过推导。
下面是由另一个产品构建的产品示例:
FEMA_NRI.social_vulnerability:
  label: FEMA National Risk Index, social vulnerability
  measurementBasis: composite
  derivesFrom:
    - {variable: CENSUS_CRE.social_vulnerability, relation: identity, confidence: documented}
derivesFrom 中的每一项对应图中的一条边,每条边包含三个事实属性:
variable存储父产品的名称,该名称必须与文件中其他位置定义的某个产品相匹配。relation描述父产品是如何被使用的。confidence记录你对这条边关系的确定程度。
这五种关系如下:
| relation | meaning |
|---|---|
component |
父产品是数学成分,例如求和中的一个数字 |
modelled_from |
父产品作为统计模型的输入 |
identity |
产品就是父产品,只是以新名称重新发布 |
poststratified_on |
父产品提供了人口权重 |
denominator |
父项是分数的分母,比如“每万人病例数”里的人口 |
以下是三个置信级别:
| 置信度 | 含义 |
|---|---|
certain |
公式已公开发布,或者输入和输出打包在同一个文件里 |
documented |
机构在自己的方法论文档中明确说明了这层关联 |
inferred |
文档强烈暗示了这层关联,但应视为暂时性结论 |
置信度字段比表面看起来重要得多。一个满是猜测的谱系图,只会重现它本来要解决的问题,所以每条边都应该注明背后的证据有多可靠。
每个产品还有一个 measurementBasis 字段:
| measurementBasis | 含义 |
|---|---|
measured |
直接统计或调查得出,比如人口普查计数 |
modelled |
由统计模型或机器学习模型生成 |
composite |
用固定的算术方式从其他产品计算而来 |
这个字段记录了公开数据目录通常忽略的一点:这个数字是数出来的还是预测出来的。人口普查计数和随机森林预测在电子表格里看起来一模一样,但它们是完全不同性质的证据。
接下来创建 mini-manifest.yaml,内容如下。这是完整清单的一个精简片段,包含 11 个来自真实美国数据基础设施的产品,每个产品只保留几条真实的边,以控制文件篇幅。
# derivation-manifest.yaml 的一小段,用于本教程。
schema: derives-from/0.2

products:

  # ---- 实测:直接计数或调查
  ACS.EP_POV150:
    label: 收入低于贫困线 150% 的人口
    measurementBasis: measured
    derivesFrom: []

  ACS.EP_UNEMP:
    label: 失业率
    measurementBasis: measured
    derivesFrom: []

  ACS.EP_NOVHEC:
    label: 无机动车辆家庭
    measurementBasis: measured
    derivesFrom: []

  SAT.chirps_rainfall:
    label: CHIRPS 卫星降雨量
    measurementBasis: measured
    derivesFrom: []

  NVSS.mortality:
    label: 死亡证明记录
    measurementBasis: measured
    derivesFrom: []

  # ---- 由其他产品构建
  CENSUS_CRE.social_vulnerability:
    label: 普查社区韧性估计值,社会脆弱性
    measurementBasis: modelled
    derivesFrom:
      - {variable: ACS.EP_POV150, relation: modelled_from, confidence: documented}
      - {variable: ACS.EP_UNEMP,  relation: modelled_from, confidence: documented}
      - {variable: ACS.EP_NOVHEC,  relation: modelled_from, confidence: documented}

  FEMA_NRI.social_vulnerability:
    label: FEMA 国家风险指数,社会脆弱性
    measurementBasis: composite
    derivesFrom:
      - {variable: CENSUS_CRE.social_vulnerability, relation: identity, confidence: documented}

  HVRI.bric:
    label: 社区基线韧性指标
    measurementBasis: composite
    derivesFrom:
      - {variable: ACS.EP_UNEMP, relation: component, confidence: documented}
      - {variable: ACS.EP_NOVHEC, relation: component, confidence: documented}

  FEMA_NRI.community_resilience:
    label: FEMA 国家风险指数,社区韧性
    measurementBasis: composite
    derivesFrom:
      - {variable: HVRI.bric, relation: identity, confidence: documented}

  FEMA_NRI.expected_annual_loss:
    label: FEMA 国家风险指数,预期年均损失
    measurementBasis: modelled
    derivesFrom: []

  FEMA_NRI.risk_score:
    label: FEMA 国家风险指数,综合风险得分
    measurementBasis: composite
    derivesFrom:
      - {variable: FEMA_NRI.expected_annual_loss, relation: component, confidence: certain}
      - {variable: FEMA_NRI.social_vulnerability, relation: component, confidence: certain}
      - {variable: FEMA_NRI.community_resilience, relation: component, confidence: certain}
第 5 步:构建 Linter
Linter(代码检查工具)会在问题造成实际损害前,读取并提示你潜在缺陷。常见的代码 linter(如 Flake8)用于分析源码,而本文的 linter 则负责检查你的 manifest(配置文件)和协变量列表。
创建一个名为 mini_lint.py 的文件。整个过程分六部分完成,最终代码不超过 200 行。
第一部分:加载 YAML 并拒绝重复键
"""mini_lint.py: refuse covariates that sit on a derivation path to or from the target."""
import argparse
import sys
from collections import deque
from itertools import combinations

import yaml

RANK = {"certain": 3, "documented": 2, "inferred": 1}
DETERMINISTIC = {"component", "identity", "denominator"}

def fail(message):
    """Exit code 2 means the manifest or the command itself is broken."""
    print(message, file=sys.stderr)
    sys.exit(2)

# ---------------------------------------------------------------- step 1
class StrictLoader(yaml.SafeLoader):
    """A YAML loader that stops on a repeated key."""

def refuse_duplicates(loader, node, deep=False):
    seen = {}
    for key_node, _ in node.value:
        key = loader.construct_object(key_node, deep=deep)
        line = key_node.start_mark.line + 1
        if key in seen:
            fail(f"manifest error: key {key!r} appears twice "
                 f"(line {seen[key]} and line {line})")
        seen[key] = line
    return loader.construct_mapping(node, deep=deep)

StrictLoader.add_constructor(
    yaml.resolver.BaseResolver.DEFAULT_MAPPING_TAG, refuse_duplicates)
RANK 将置信度描述转化为数值,使工具能够识别路径中最薄弱的环节。 DETERMINISTIC 则列举了纯算术关系。
fail 负责输出消息并以状态码 2 退出。教程稍后部分会解释为何必须将代码 2 与代码 1 严格区分。
这个 loader 处理了 YAML 的一个隐蔽陷阱:若同一区块中出现重复键,PyYAML 会静默保留最后一个值并丢弃第一个。在 manifest 场景下,这会导致产品的所有依赖边被彻底抹除,工具随之检测到零条路径,并轻易放行那些存在数据泄露的协变量。
refuse_duplicates 在 PyYAML 构建映射(即 Python 字典)时运行。它遍历每个键,记录其行号,一旦发现重复键立即终止程序。
第二部分:读取产品与边
# ---------------------------------------------------------------- step 2
def load(path):
    try:
        with open(path) as fh:
            products = yaml.load(fh, StrictLoader)["products"]
    except (OSError, yaml.YAMLError, KeyError, TypeError) as e:
        fail(f"manifest error: unable to read {path}: {e}")

    edges = {}
    for name, product in products.items():
        edges[name] = []
        for e in product.get("derivesFrom") or []:
            if RANK.get(e.get("confidence")) is None:
                fail(f"manifest error: {name} has an edge with "
                     f"confidence {e.get('confidence')!r}")
            edges[name].append((e["variable"], e["relation"], e["confidence"]))
    return products, edges
load 用严格加载器打开文件。读取过程中一旦出错,比如路径不对或 YAML 格式有问题,就调用 fail 报错退出。
接着它构建一个名为 edges 的字典,为每个产品名存储一组 (parent, relation, confidence) 元组。例如:
edges["FEMA_NRI.social_vulnerability"]
# [("CENSUS_CRE.social_vulnerability", "identity", "documented")]
同时它还会检查每个 confidence 值是否属于那三个允许的词。否则像 documneted 这种拼写错误就可能蒙混过关,到后面破坏排序逻辑。
第 3 部分:先校验 manifest,再使用它
# ---------------------------------------------------------------- step 3
def undefined_names(products, edges):
    mentioned = {parent for rows in edges.values() for parent, _, _ in rows}
    return sorted(mentioned - set(products))

def find_cycle(edges):
    state = {}

    def visit(node, stack):
        state[node] = "open"
        stack.append(node)
        for parent, _, _ in edges.get(node, []):
            if state.get(parent) == "open":
                return stack[stack.index(parent):] + [parent]
            if parent in state:
                continue
            cycle = visit(parent, stack)
            if cycle:
                return cycle
        stack.pop()
        state[node] = "closed"
        return None

    for node in edges:
        if node in state:
            continue
        cycle = visit(node, [])
        if cycle:
            return cycle
    return None
父节点名称中的拼写错误(例如把 HVRI.bric 写成 HVRI.brick)会导致边指向一个该文件实际没有的产品。遍历会在该死胡同处停止,之后所有的共变量看起来都是安全的。
undefined_names 收集所有边中提到的父节点,再减去已定义产品集合。剩余的就是拼写错误或遗漏添加的产品。
find_cycle 确保清单确实是一个 DAG。实际数据中产品不可能由自身构建,循环会导致路由查找无限打转。
该函数使用带两个标记的深度优先搜索。搜索进入节点时,将其标记为 open;完成该节点上方所有探索后,标记为 closed。如果搜索到达仍标记为 open 的节点,说明走了一个环,函数会返回该环以便查看。
Part 4: 遍历图
# ---------------------------------------------------------------- step 4
def ancestors(edges, node):
    """每个节点直接/间接构建自的所有产品。"""
    found = set()
    queue = deque([node])
    while queue:
        current = queue.popleft()
        for parent, _, _ in edges.get(current, []):
            if parent in found:
                continue
            found.add(parent)
            queue.append(parent)
    return found

def routes(edges, start, goal):
    """从 start 到 goal 的所有路径。第 3 步已排除循环,因此是安全的。"""
    found = []
    for parent, relation, confidence in edges.get(start, []):
        step = (parent, relation, confidence)
        if parent == goal:
            found.append([step])
        else:
            for rest in routes(edges, parent, goal):
                found.append([step] + rest)
    return found

def describe(start, route):
    chain = " -> ".join([start] + [parent for parent, _, _ in route])
    weakest = min(route, key=lambda step: RANK[step[2]])[2]
    arithmetic = all(rel in DETERMINISTIC for _, rel, _ in route)
    kind = "deterministic" if arithmetic else "statistical"
    return [chain, f"{kind}, weakest link: {weakest}"]
ancestors 基于广度优先搜索(BFS)。你可以想象一个排队叫号的场景:将起始商品放入队列,每轮取出队首商品,查找其父节点,并将尚未访问过的父节点追加到队尾。当队列为空时,found 集合中即包含了所有距离层级下的祖先节点。
found 集合还负责避免重复访问同一商品,因为许多商品往往共享相同的父节点,这点很关键。
ancestors 用于判断协变量是否位于上游,而 routes 则展示了具体路径。
routes 采用递归的**深度优先搜索**。对于 start 的每个父节点,检查其是否为目标;如果是,则这一单步构成一条完整路径。否则,函数递归调用自身以找到从该父节点到目标的所有路径,并将当前步骤前置到每一条结果中。
函数返回所有路径,这是有意为之。早期版本的完整工具仅报告最短路径,导致报告只展示跳数最少的路径,即便更长的路径拥有更强的证据支撑。
之所以这里递归是安全的,是因为第三部分已确认该图是有向无环图(DAG)。
describe 将路径转换为两行可读内容。第一行是名称链条;第二行说明该路径是 deterministic(每步均为算术运算)还是 statistical(链条中至少包含一个模型),并指出路径中最弱的置信度,因为链条的强度取决于最薄弱的环节。
第五部分:审计
审计环节在图中查找三种形态:
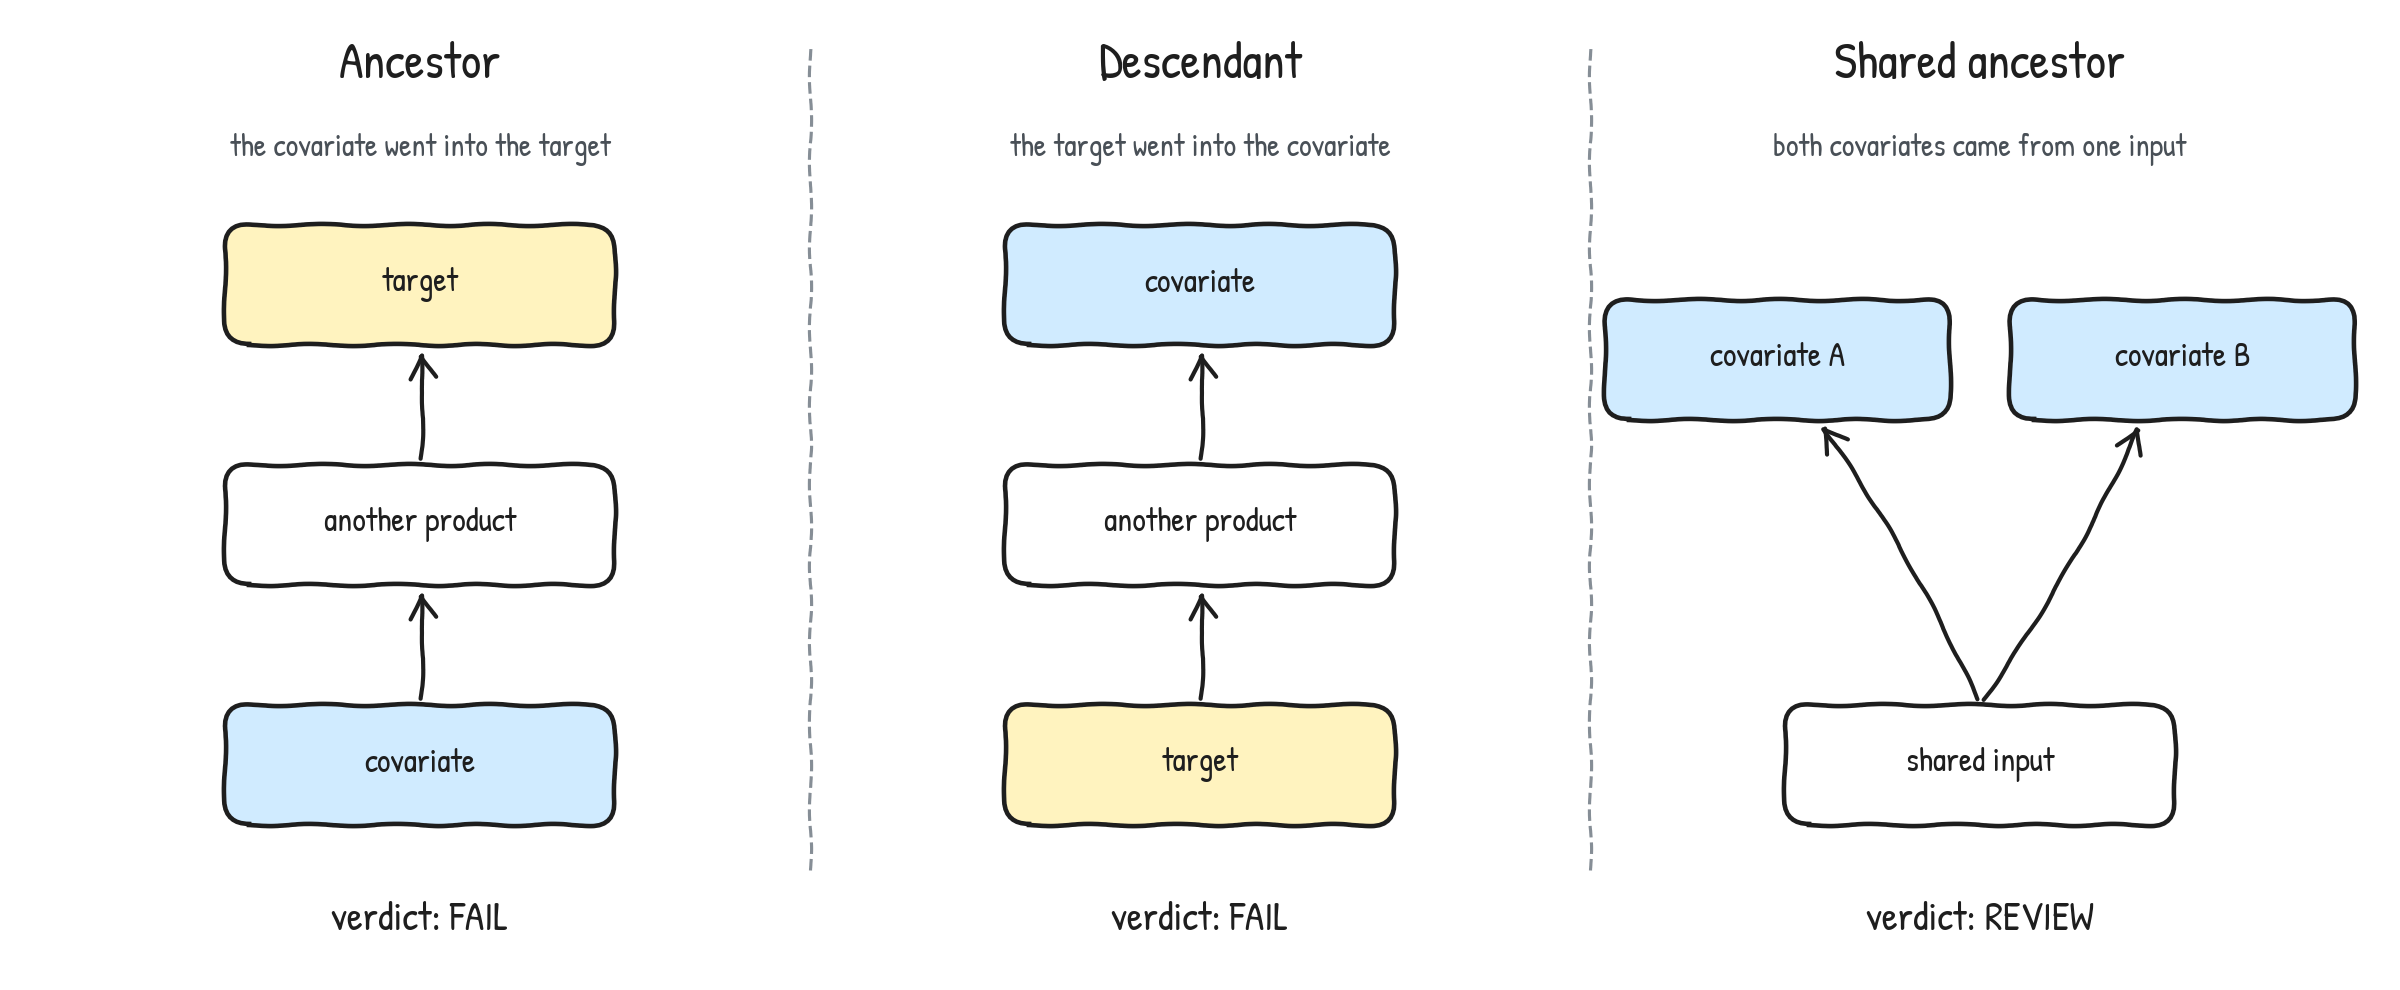
每个面板展示一种形态及其判定结果:指向目标的箭头(FAIL),指出目标的箭头(FAIL),以及两个协变量悬挂在同一共享输入上(REVIEW)。
祖先(Ancestor):这个协变量直接或通过其他派生产品参与了目标的构建。这是最典型的泄漏,所以工具将其标记为错误。
后代(Descendant):这个协变量是由目标派生出来的。用孩子反推父级,泄漏程度同样严重,所以这也是错误。
共同祖先(Shared ancestor):两个协变量来自同一个输入。这个问题相对温和,因为两者携带的信息有重叠,所以工具只给出警告,交由人工复核。
# ---------------------------------------------------------------- step 5
def audit(products, edges, target, covariates):
    findings = []

    unknown = [n for n in [target, *covariates] if products.get(n) is None]
    if unknown:
        return [("ERROR", f"unknown name: {n}", ["check the spelling"])
                for n in unknown]

    target_ancestors = ancestors(edges, target)
    for cov in covariates:
        if cov in target_ancestors:
            found = routes(edges, target, cov)
            details = [line for r in found for line in describe(target, r)]
            findings.append(("ERROR", f"{cov} is an ancestor of the target "
                                      f"({len(found)} route(s))", details))
        if target in ancestors(edges, cov):
            found = routes(edges, cov, target)
            details = [line for r in found for line in describe(cov, r)]
            findings.append(("ERROR", f"{cov} is a descendant of the target "
                                      f"({len(found)} route(s))", details))

    for a, b in combinations(covariates, 2):
        if a in ancestors(edges, b) or b in ancestors(edges, a):
            findings.append(("ERROR", f"{a} and {b}: one is built from the other", []))
        elif ancestors(edges, a) & ancestors(edges, b):
            shared = sorted(ancestors(edges, a) & ancestors(edges, b))
            findings.append(("WARN", f"{a} and {b} share ancestors", shared))
    return findings
审计首先做名称检查:如果协变量拼写有误,工具会立刻报错,因为清单之外的名字对它来说是完全未知的信息,硬要判断这个名字安全与否纯属猜测。
接着,它会一次性计算目标变量的所有祖先节点,然后逐一检验每个自变量是否包含在该集合中。同时,它也会计算每个自变量的祖先节点,以查看目标变量是否出现在其中——这正是识别下游变量(descendants)的方式。
最后,利用 itertools 模块中的 combinations 函数生成所有自变量对。如果其中一个自变量是由另一个构建的,则判定为错误;如果这一对自变量共享任何祖先节点,则发出警告。
第 6 部分:判定与退出码
# ---------------------------------------------------------------- step 6
def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--manifest", default="mini-manifest.yaml")
    parser.add_argument("--target", required=True)
    parser.add_argument("--covariates", nargs="+", required=True)
    args = parser.parse_args()

    products, edges = load(args.manifest)
    missing = undefined_names(products, edges)
    if missing:
        fail(f"manifest error: undefined names: {', '.join(missing)}")
    cycle = find_cycle(edges)
    if cycle:
        fail(f"manifest error: cycle: {' -> '.join(cycle)}")

    findings = audit(products, edges, args.target, args.covariates)
    severities = {severity for severity, _, _ in findings}
    if "ERROR" in severities:
        verdict = "FAIL"
    elif "WARN" in severities:
        verdict = "REVIEW"
    elif ancestors(edges, args.target):
        verdict = "PASS"
    else:
        verdict = "UNTRACED"

    basis = products.get(args.target, {}).get("measurementBasis", "unknown")
    print(f"target      {args.target}  [{basis}]")
    print(f"covariates  {', '.join(args.covariates)}")
    print(f"verdict     {verdict}\n")
    for severity, message, details in findings:
        print(f"  {severity:<5} {message}")
        for line in details:
            print(f"        {line}")

    sys.exit(1 if verdict == "FAIL" else 0)

if __name__ == "__main__":
    main()
main 函数读取命令行参数,加载清单文件,执行两项自检,随后运行审计流程。它将审计结果转化为以下四种判定之一:
| 判定结果 | 触发条件 | 退出码 |
|---|---|---|
FAIL |
存在至少一个错误 | 1 |
REVIEW |
仅包含警告 | 0 |
PASS |
无审计发现,且目标变量已记录祖先节点 | 0 |
UNTRACED |
零发现,且目标没有任何已记录的祖先 | 0 |
清单文件损坏或命令格式错误时,程序以退出码 2 结束。
PASS 和 UNTRACED 需要仔细甄别。PASS 表示工具遍历了真实的依赖树,并确认所有协变量都在树之外。UNTRACED 表示清单中针对该目标的依赖树为空,因此遍历步骤数为零。将这种情况称作通过,是对工具的过度美化,因此单独设立此状态名称。
退出码同样重要。退出码 1 表示检查已执行并发现泄漏;退出码 2 表示检查机制本身出现故障。CI 流水线必须区分这两种情况,因为发现泄漏意味着需要调整协变量,而清单文件损坏则意味着需要修复文件。
步骤 6:在真实案例中运行 Linter
案例 1:FEMA 风险评分
FEMA 的复合风险评分由预期年度损失乘以社区风险系数得出。该系数基于社会脆弱性评分和社区韧性评分构建,这两项评分又通过不同的机构回溯至 ACS 调查列。
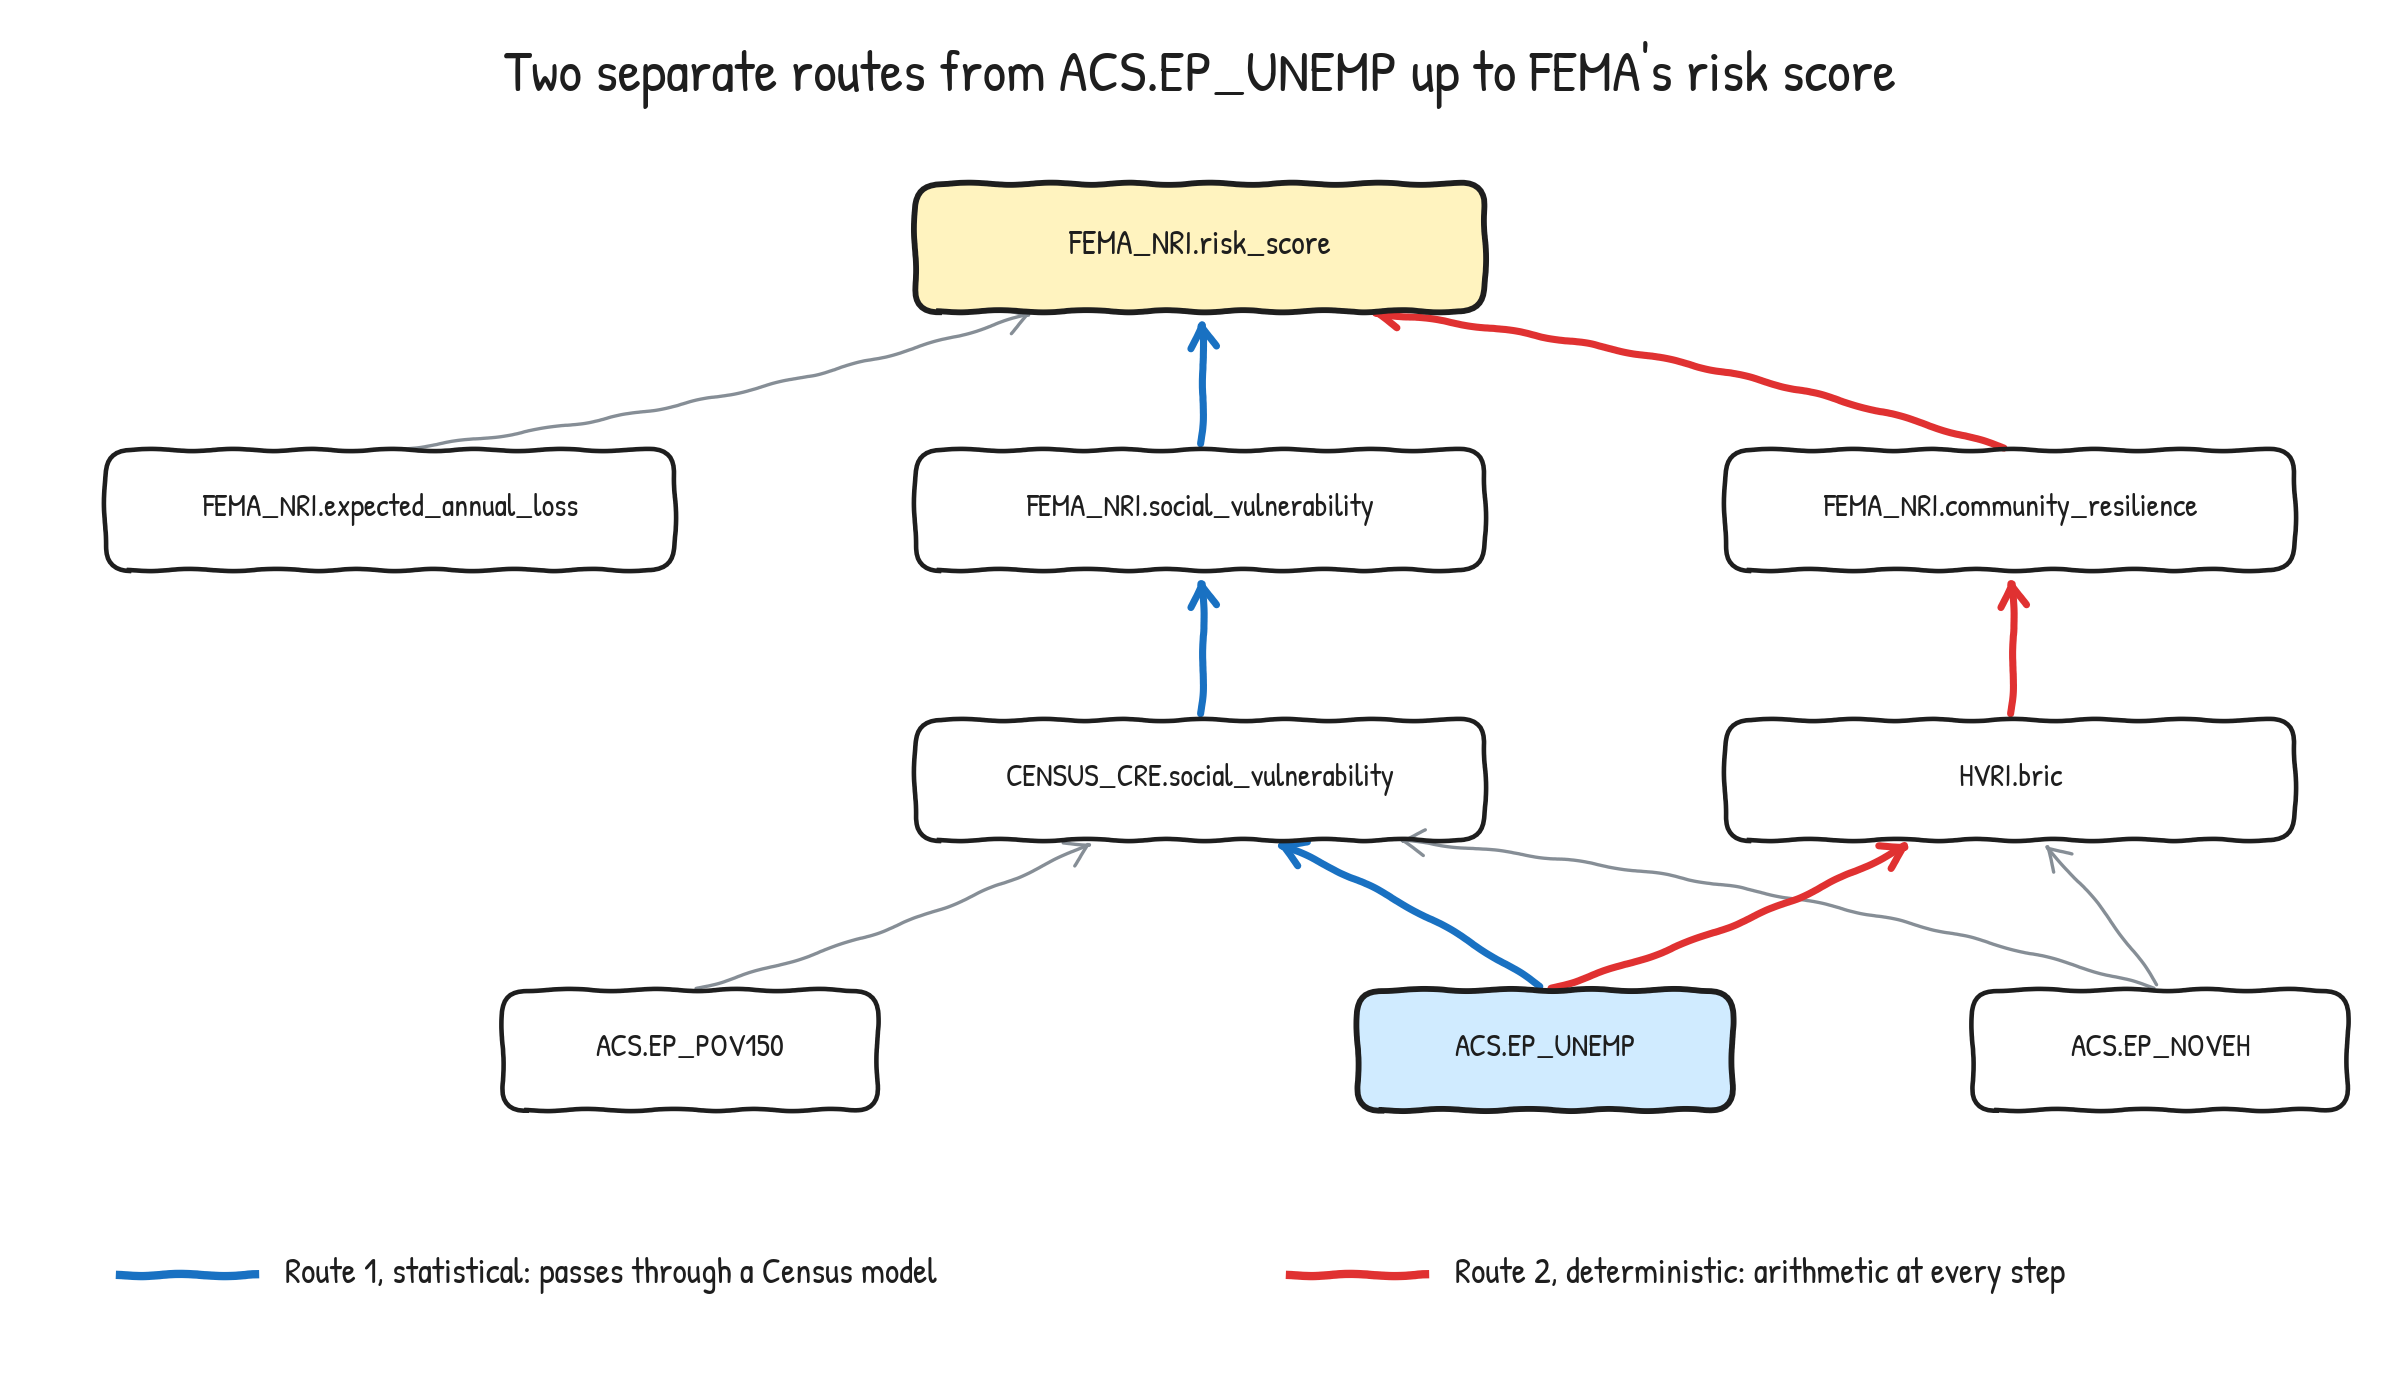
FEMA_NRI.risk_score 及其所有上游依赖项。图中展示了两条路径,分别以蓝色和红色绘制,均始于同一 ACS 失业率列:一条经由人口普查局的韧性估算,另一条经由 HVRI 的 BRIC 指数。
假设你希望使用贫困率和失业率来预测风险评分:
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates ACS.EP_POV150 ACS.EP_UNEMP
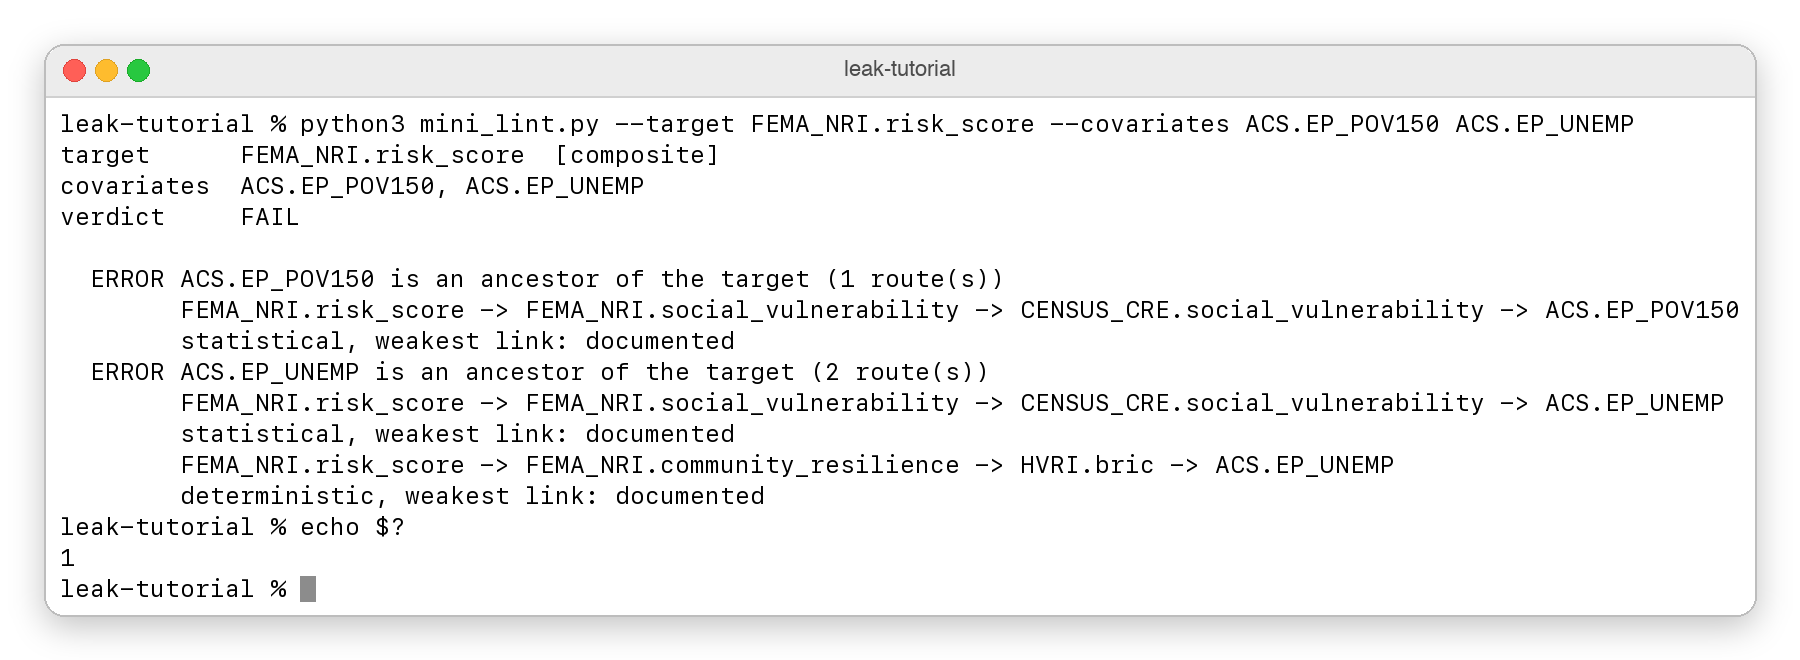
结论是 FAIL。贫困率通过一条路径到达目标,失业率则通过两条路径到达,一条是统计性的,一条是确定性的。
结论为 FAIL,退出码为 1。
ACS.EP_POV150 通过一条路径到达目标,ACS.EP_UNEMP 则通过两条路径。
第一条失业率路径经过 Census 模型,因此工具将其标记为统计性泄漏;第二条路径经过 HVRI 的 BRIC 指数,失业率是其中的直接组成成分,因此被标记为确定性泄漏。
你可以试着在一堆列名组成的表格里用肉眼追踪这两条路径,很快就能体会到图结构的价值。而图遍历不到一秒钟就能把两条路径都找出来。
案例 2:后代节点
现在反过来,假设你想用 FEMA 转载的 Census 评分作为协变量来预测 Census 评分本身:
python3 mini_lint.py --target CENSUS_CRE.social_vulnerability --covariates FEMA_NRI.social_vulnerability
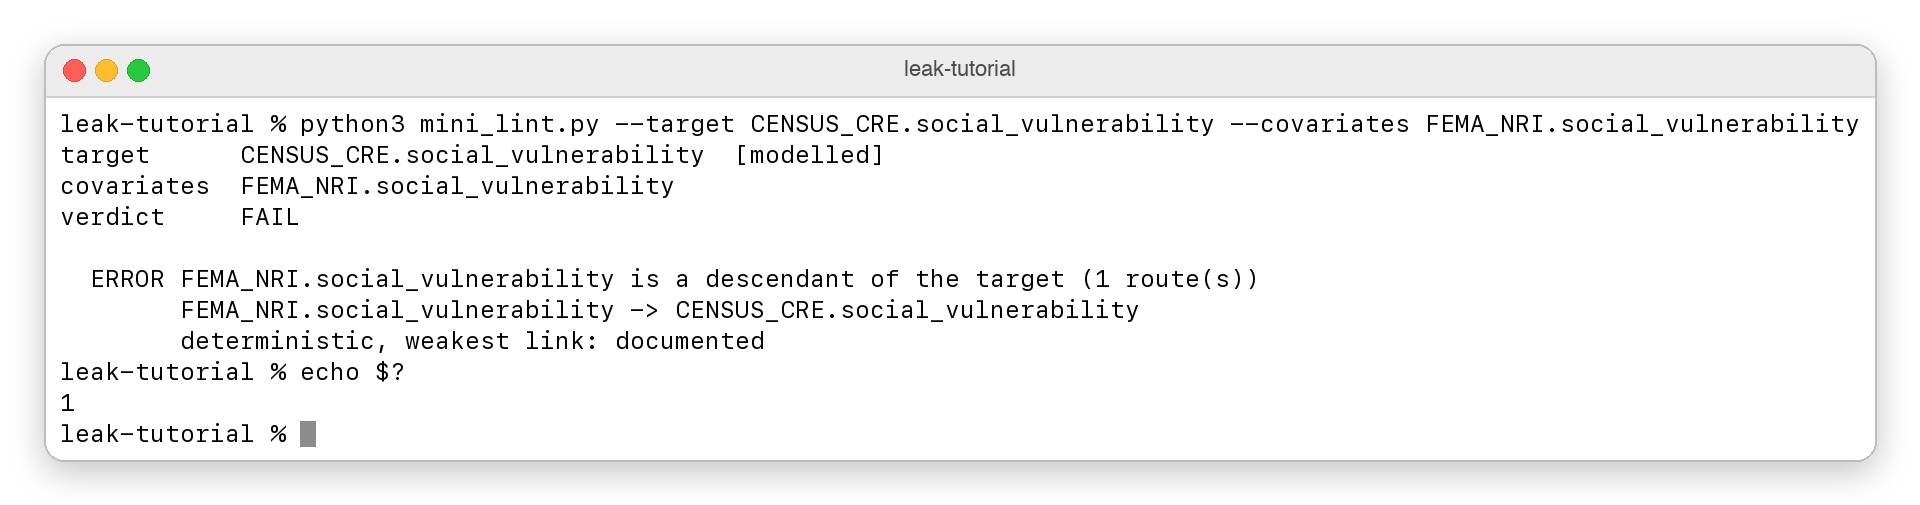
方向反转后的又一个 FAIL 案例。FEMA 转载的 Census 评分作为目标的后代节点,通过一条确定性路径与目标相连。
FEMA 的评分直接由 Census 评分构建而来,把它作为输入等于直接把答案交给模型。工具将其识别为后代节点。
案例 3:REVIEW、PASS 和 UNTRACED
下面三个用例的结果应该是干净的,或接近干净:
python3 mini_lint.py --target NVSS.mortality --covariates FEMA_NRI.social_vulnerability HVRI.bric
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates SAT.chirps_rainfall
python3 mini_lint.py --target NVSS.mortality --covariates SAT.chirps_rainfall
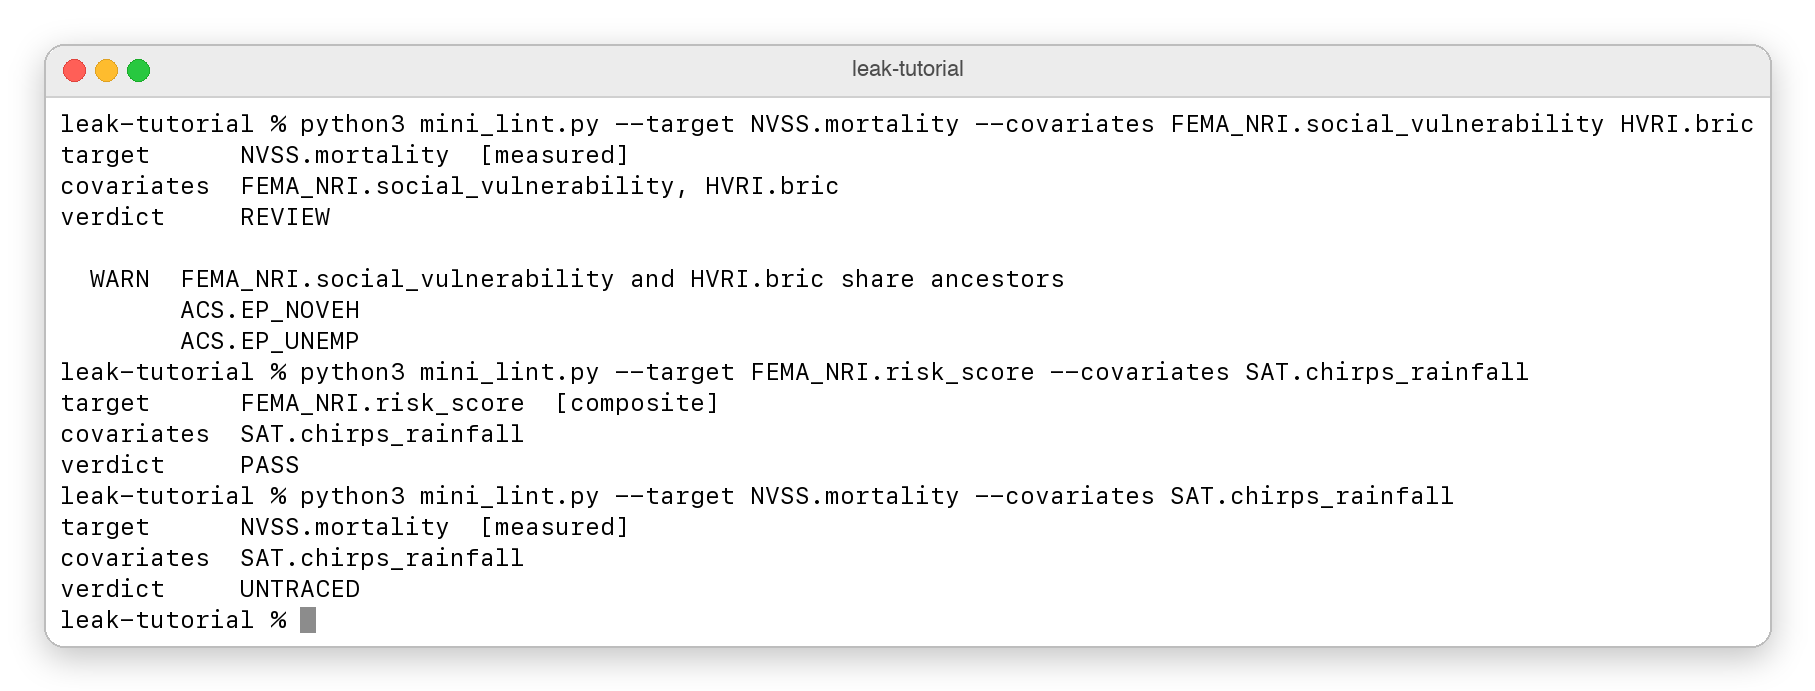
三次清理运行:共享两个 ACS 父节点的变量对返回 REVIEW,卫星降雨量对风险评分返回 PASS,列出父节点数为零的目标变量返回 UNTRACED。
第一次运行返回 REVIEW,因为两个协变量共享两个 ACS 父节点,在告知模型的信息上存在重叠。
第二次运行返回 PASS,因为风险评分有可追溯的族谱,而卫星降雨量位于该族谱之外。
第三次运行返回 UNTRACED,因为死亡证明记录是直接计数,没有列出任何父节点。
这些静默的结果与失败结果同样重要。如果检查工具对每个输入都报警,它就毫无用处,因此好的测试集必须包含应当通过的案例。
第 7 步:让 Linter 在遇到错误输入时明确报错
安全工具通过明确失败来赢得信任。对于泄漏检查器来说,最糟糕的结果是某个静默跳过工作的检查却返回绿色的 PASS。这种情况通常有三种成因。
陷阱 1:名称拼写错误
要尝试此操作,请将 mini-manifest.yaml 复制为 typo-manifest.yaml,并将 FEMA_NRI.community_resilience 条目中的 HVRI.bric 更改为 HVRI.brick。然后运行以下两条命令:
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates ACS.EP_POV15
python3 mini_lint.py --manifest typo-manifest.yaml --target FEMA_NRI.risk_score --covariates ACS.EP_UNEMP
两个拼写错误,两种退出码。拼写错误的协变量导致判定为 FAIL,退出码为 1;manifest 中拼写错误的父节点导致 manifest 错误,退出码为 2。
拼写错误的协变量(ACS.EP_POV15)导致判定为 FAIL,退出码为 1。manifest 中拼写错误的父节点(HVRI.brick)导致 manifest 错误,退出码为 2。两者都会在遍历发生前停止运行。
陷阱 2:重复的 YAML 键
再复制一份清单文件,命名为 sneaky-manifest.yaml,然后在 FEMA_NRI.risk_score 代码块的末尾追加一行:
derivesFrom: []
此时风险分数节点拥有了两个 derivesFrom 键。创建 peek.py 来查看标准的 PyYAML 如何处理这种情况:
import yaml

with open("sneaky-manifest.yaml") as fh:
    doc = yaml.safe_load(fh)

print(doc["products"]["FEMA_NRI.risk_score"]["derivesFrom"])
运行 peek.py,然后对同一文件执行 Linter:
python3 peek.py
python3 mini_lint.py --manifest sneaky-manifest.yaml --target FEMA_NRI.risk_score --covariates ACS.EP_UNEMP
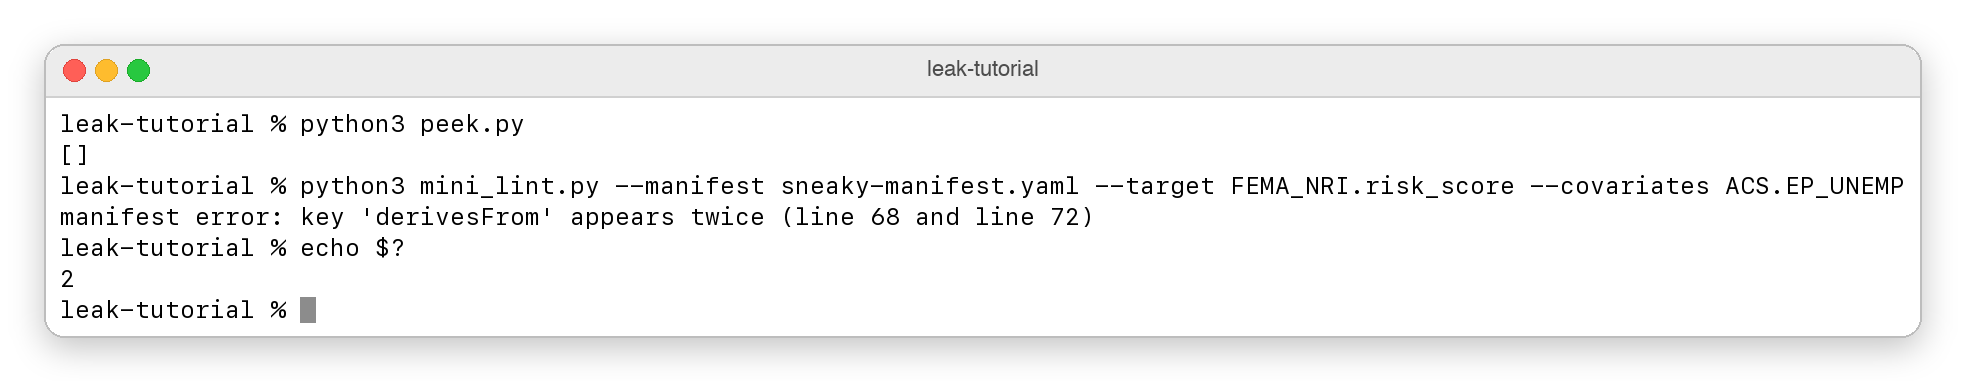
重复键的两种表现。yaml.safe_load 仅打印空列表且无任何提示,而严格加载器会指出重复键名、两次出现的行号,并以代码 2 退出。
标准的 yaml.safe_load 返回空列表,因为 PyYAML 保留第二个键,丢弃了三条真实的边,且没有发出任何警告。基于此加载器的 Linter 会发现零条路径,让所有存在泄漏的协变量顺利通过。
严格加载器以代码 2 终止,并定位到两处的行号。
陷阱 3:空协变量列表
第三个陷阱很容易被忽视。在 CI 中,你可能从文件或 Shell 变量构建协变量列表。如果该文件为空或变量名拼写错误,命令最终将没有任何协变量。
我早期版本的完整工具接受这种状况并打印 PASS,相当于对一个跳过所有检查工作的流程颁发了“健康证明”。
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates
空的 --covariates 列表现在会在 argparse 阶段就被拦下,尚未开始遍历,退出码为 2。
在 mini_lint.py 中,nargs="+" 告诉 argparse --covariates 至少需要一个值,而 required=True 则让这个参数本身成为必填项。这样一来,空列表会让流水线直接报错,退出码为 2。
第 8 步:在 CI 中自动运行检查
CI(持续集成)会在你每次推送代码时自动执行检查。下面这个 GitHub Actions 工作流会在每次 push 和 pull request 时运行 linter。把它保存为仓库中的 .github/workflows/lineage.yml,并确保仓库根目录下有 mini_lint.py 和 mini-manifest.yaml:
name: lineage-check

on: [push, pull_request]

jobs:
  lint-lineage:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v5
      - uses: actions/setup-python@v6
        with:
          python-version: "3.12"
      - run: pip install pyyaml
      - name: Check covariates against the target's lineage
        run: |
          python3 mini_lint.py \
            --target FEMA_NRI.risk_score \
            --covariates $(cat features.txt)
把协变量名称放进仓库根目录下的 features.txt 文件里,每行一个:
SAT.chirps_rainfall
$(cat features.txt) 会把这些名称填入命令。用当前这份文件,任务会通过并显示绿色。如果之后有人加入了泄露的协变量,比如 ACS.EP_UNEMP,任务会以退出码 1 结束并变红。如果有人不小心清空了 features.txt,argparse 会以退出码 2 结束,任务同样变红。
| 退出码 | 含义 | CI 结果 |
|---|---|---|
| 0 | 检查已运行,结果为 PASS、REVIEW 或 UNTRACED | 绿色 |
| 1 | 检查已运行,发现了泄露 | 红色 |
| 2 | manifest 损坏或命令格式有误 | 红色 |
main 的最后几行,让除 PASS 外的任何判定状态都返回代码 1。
配套仓库运行了这套完全一致的工作流,你可以在该仓库的 Actions 标签页上查看运行结果。
步骤 9:从我的错误中吸取教训
构建完整的 manifest 文件让我意识到,Linter 的质量完全取决于它所读取的依赖图的质量。我两次对 SVI 的理解都出现了偏差,且方向完全相反。这两个错误都源于同一种习惯:过度信任文件中的字段,而忽视了其背后的方法论。 错误 1: SVI 加利福尼亚版文件包含 24 个以EP_ 开头的字段,但 CDC 在计算指数时仅纳入了其中的 16 个。我最初构建 manifest 时将全部 24 个字段计入,甚至把 EP_NOINT(宽带订阅数)也列为指数的组成要素。尽管该字段确实存在于文件中,但鉴于 CDC 在排名中将其排除,我随即删除了这条依赖边。
错误 2: 随后我矫枉过正,将剩余 8 个未纳入排名的字段全部标记为随指数一同分发的“无关安全项”。然而,这 8 个字段中有 7 个是种族和民族相关字段。检查原始计数后发现,这 7 个字段之和恰好等于 E_MINRTY,且在全部 9,109 个普查小区(traces)中,最大差异为 0。
EP_MINRTY 是主题 3(Theme 3)的唯一输入,而主题 3 会馈入总体指数。
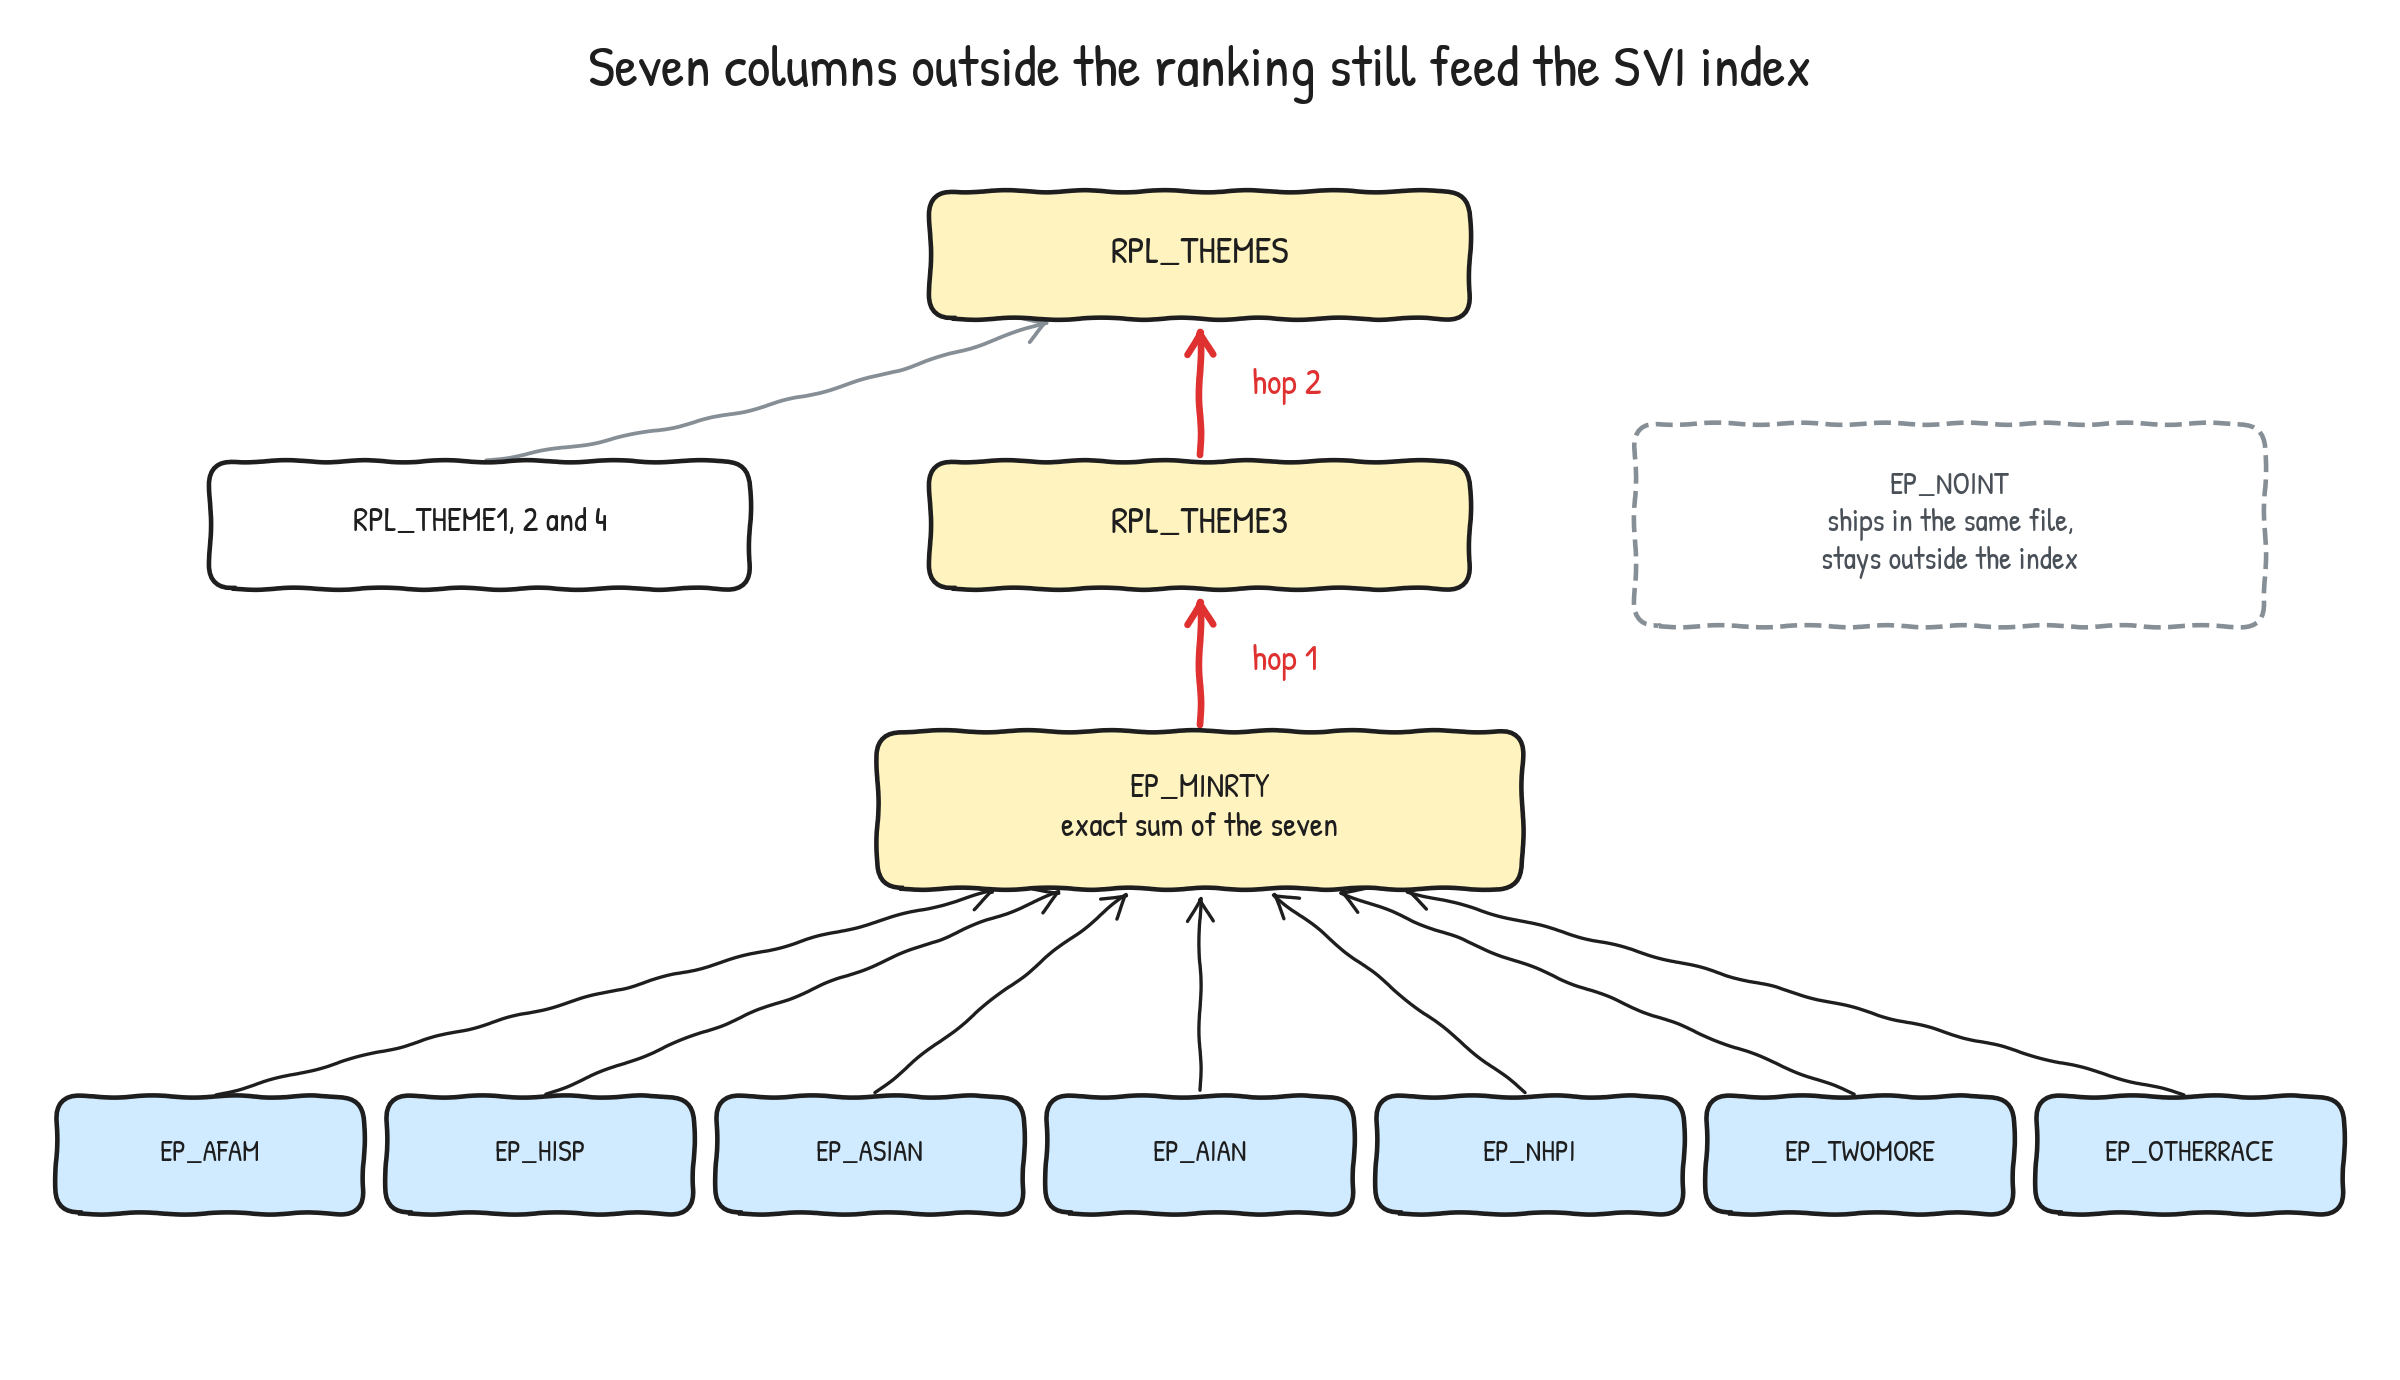
这 7 个字段并非无关项。它们的总和恰好等于 EP_MINRTY,该值向上馈入主题 3(跳 1),进而馈入总体指数(跳 2)。 EP_NOINT 位于虚线框中,随同一文件分发,但不属于指数的一部分。
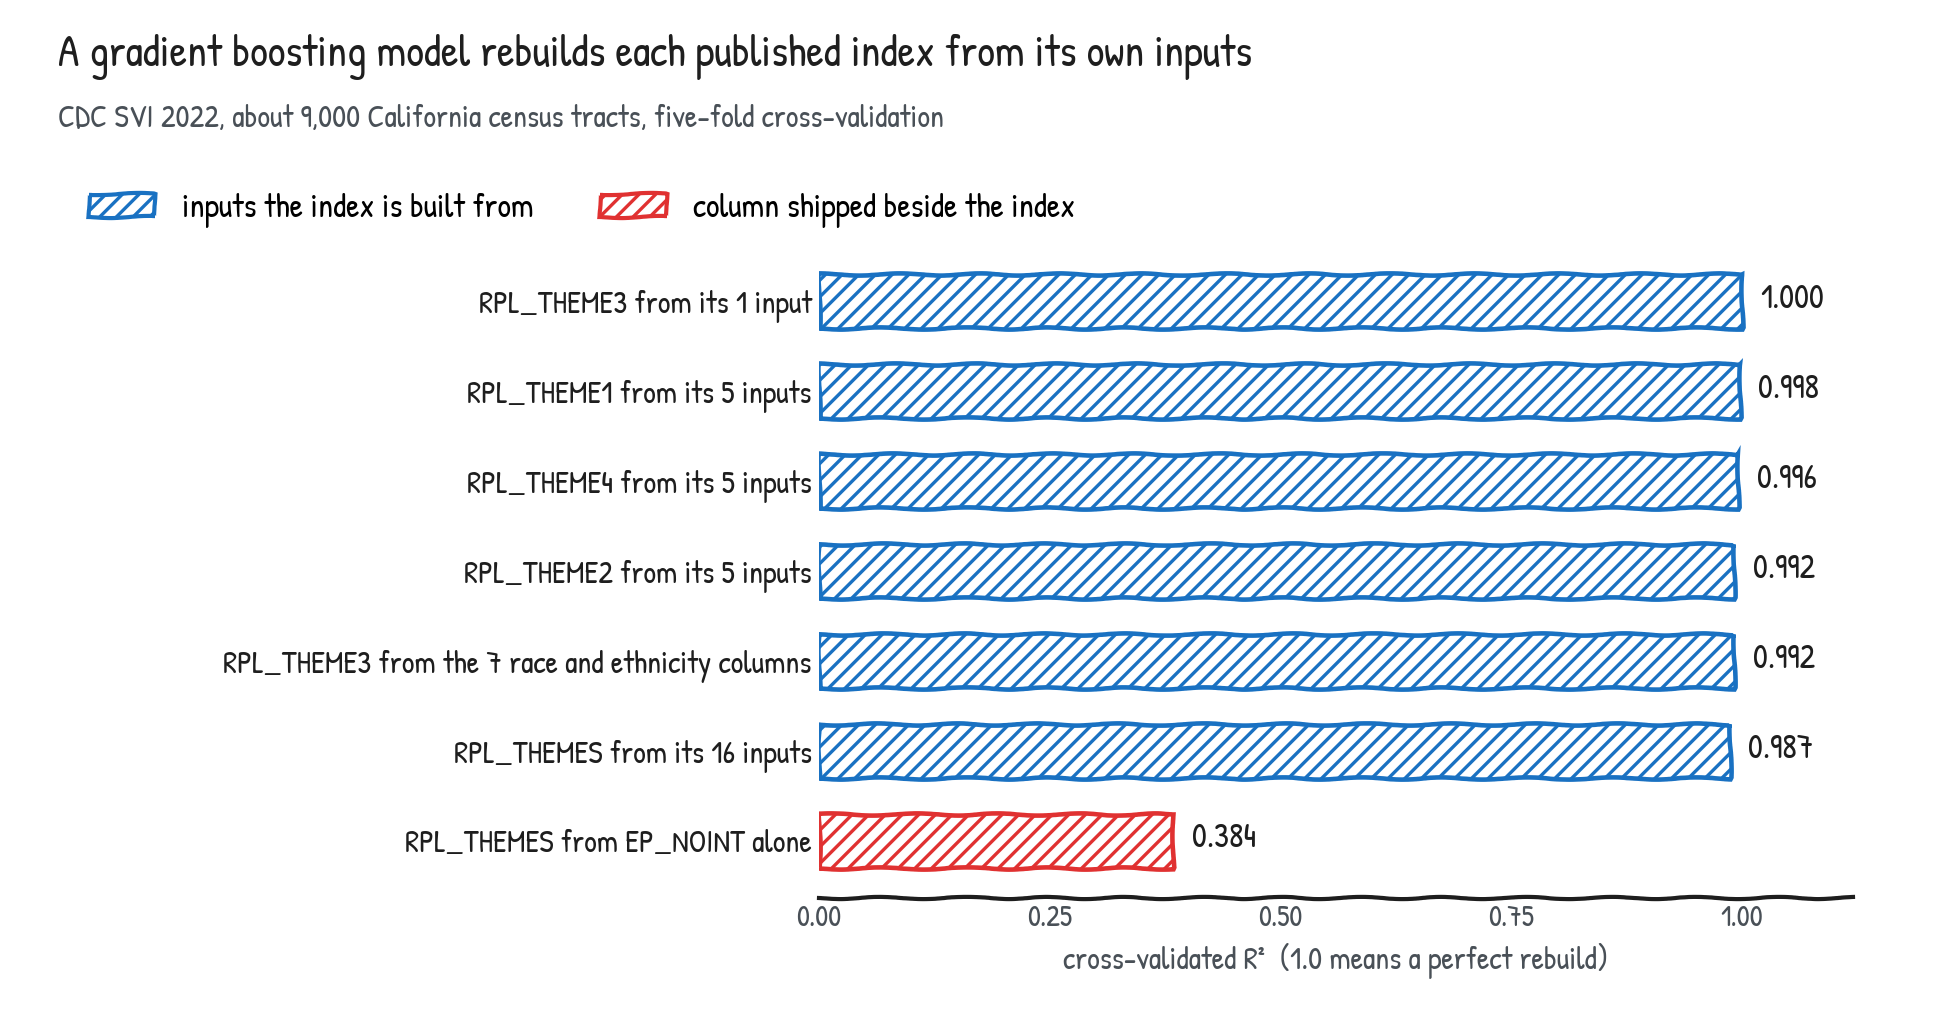
各产品的交叉验证 R² 值,由旁边列出的列进行预测。每个产品由其自身输入预测时的得分均不低于 0.987,而 EP_NOINT(仅与索引一同发布)仅为 0.384。
图表清晰地展示了差异:7 个人种和族裔列重建 Theme 3 的 R² = 0.992,而单独使用 EP_NOINT 预测整体索引仅为 0.384。
现在,在将任何列标记为安全之前,我遵循更严格的规则。我先阅读方法学部分,然后在数据中测试该关系。
完整的清单记录结果通过一个名为 coPublishedNonInputs 的字段,该字段列出与索引位于同一文件且不参与其计算的列。对于 SVI,EP_NOINT 是当前的唯一条目。
使用完整工具进一步探索
本教程中的迷你 linter 涵盖了核心思想。完整项目还增加了:
包含 60 个产品和 75 条推导边的清单,覆盖美国及全球数据,包括 CDC PLACES、FEMA 国家风险指数、WorldPop、AlphaEarth 卫星嵌入以及 WFP HungerMap LIVE
为每个带有边的产品编写书面证据笔记,并在之前的声明被证明错误时添加
correction字段--graph模式,打印整个推导图内置的八个真实审计案例套件
reproduce_svi.py脚本,对照实时 CDC 文件检查本文中的所有 R² 数值固定的 Dockerfile,确保数值可精确复现
要尝试:
git clone https://github.com/Adeniyikayodee/dependency_manifest.git
cd dependency_manifest
python3 lint_lineage.py
python3 lint_lineage.py --graph
python3 reproduce_svi.py
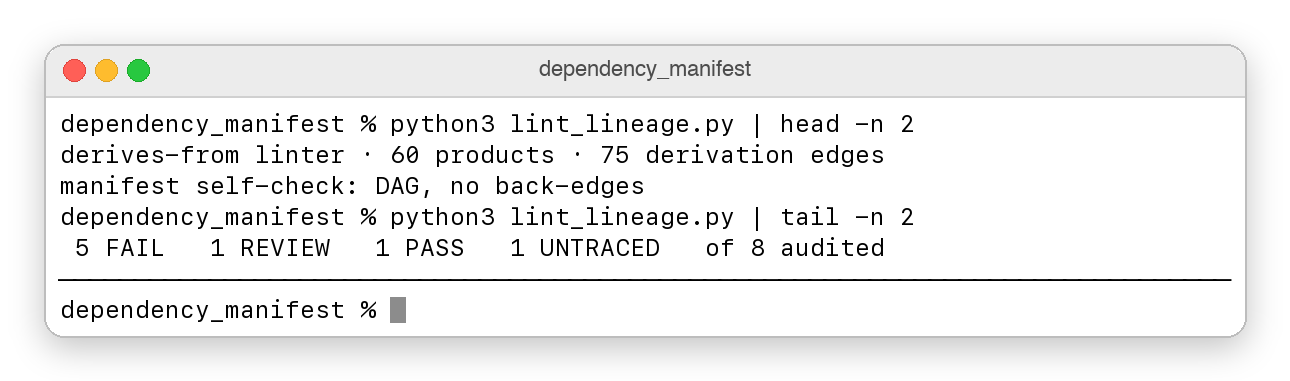
在完整清单上运行完整工具:60 个产品、75 条派生边,八项审计的结果是 5 项 FAIL、1 项 REVIEW、1 项 PASS 和 1 项 UNTRACED。
清单对自身的局限很坦诚。它只覆盖了全球约 400 多个官方综合指数中的 60 个,其中四条边仍标记为 inferred。对这个文件做的第一次审计发现了六个错误,而其中四个出在我原本已标注为 certain 或 documented 的边上。
最适合编写这类记录的其实是统计机构自己,因为它们已经在 PDF 文档里描述了自己的方法。只要在公共数据模式中新增两个字段 derivesFrom 和 measurementBasis,每个数据生产方就有地方存放它们早已掌握的信息。
如果你在使用公共数据,可以通过添加自己熟悉的产品,或者对照原始文档核查那些标记为 inferred 的边,来参与贡献。
结论
公共数据中的目标泄漏,往往隐藏在统计机构构建指数的配方里。模型只要重新发现其中一条配方,就能拿到接近满分的分数,而这个分数对现实世界几乎说明不了什么。
在本教程中,你完成了以下内容:
仅凭 CDC Theme 1 自带的五个输入列,就以 R² = 0.998 复现了它
区分了溯源(数字从哪里来)和派生(数字由什么计算而来)
编写了一个 YAML 清单,以关系和置信度记录派生边
构建了一个 linter,用广度优先搜索查找祖先,用深度优先搜索列出所有路径
让 linter 对拼写错误、重复 YAML 键、循环依赖和空的协变量列表都能报错终止
把检查接入 GitHub Actions,并设置了清晰的退出码
在信任公共数据上的高分之前,先问问自己:你的目标变量是怎么算出来的。把答案写下来之后,几行 Python 代码就能在你每次训练模型时自动检查它。
本教程的代码托管在 derives-from-tutorial 仓库,完整工具、manifest 文件及复现脚本位于主 dependency_manifest 仓库中。该项目已在 Zenodo 归档,DOI 为 10.5281/zenodo.22274757,采用 CC0 许可协议,您可自由使用。
资料来源
CDC/ATSDR 社会脆弱性指数:https://svi.cdc.gov/
FEMA 国家风险指数技术文档 v1.20(2025年12月):https://www.fema.gov/sites/default/files/documents/fema_national-risk-index_technical-documentation.pdf
人口普查局社区韧性估算值:https://www.census.gov/programs-surveys/community-resilience-estimates.html
CDC PLACES 方法论,《预防慢性病》(Preventing Chronic Disease),2022年:https://www.cdc.gov/pcd/issues/2022/21_0459.htm
Data Commons 数据模型:https://docs.datacommons.org/data_model.html