
当大模型都在追求“更会思考”,前OpenAI研究者却做了一个只负责判断的模型
今天看到一个刚发布的AI模型「Jev」,很有意思。所以虽然本人目前还在Waitlist中,但依旧迫不及待地收集了完整的信息与朋友们分享。
Jev背后的公司叫TypeSafe AI,创始人Diogo Almeida曾在OpenAI工作,参与过InstructGPT、RLHF等研究。简单说,他曾经参与的,恰恰是让大语言模型更懂人类指令、更会和人交流的那条技术路线,而这条路线后来也成为ChatGPT出现的重要基础。
但离开OpenAI之后,他开始做的事情,却有点像在往反方向走。
过去几年,整个行业都在努力让模型变得更会说、更会想、更会推理。模型可以写文章、写代码、调用工具,甚至花几分钟乃至更长时间思考一个复杂问题。Almeida却开始追问另一个问题:如果AI不是拿来聊天,而是真正嵌进软件系统里,我们真的需要它每次都想那么多、说那么多吗?
这个问题最终变成了Jev。
它想做的,是《思考,快与慢》里的“系统一”
TypeSafe把Jev这一类模型称为System One Models。这个名字直接来自丹尼尔·卡尼曼的《思考,快与慢》。
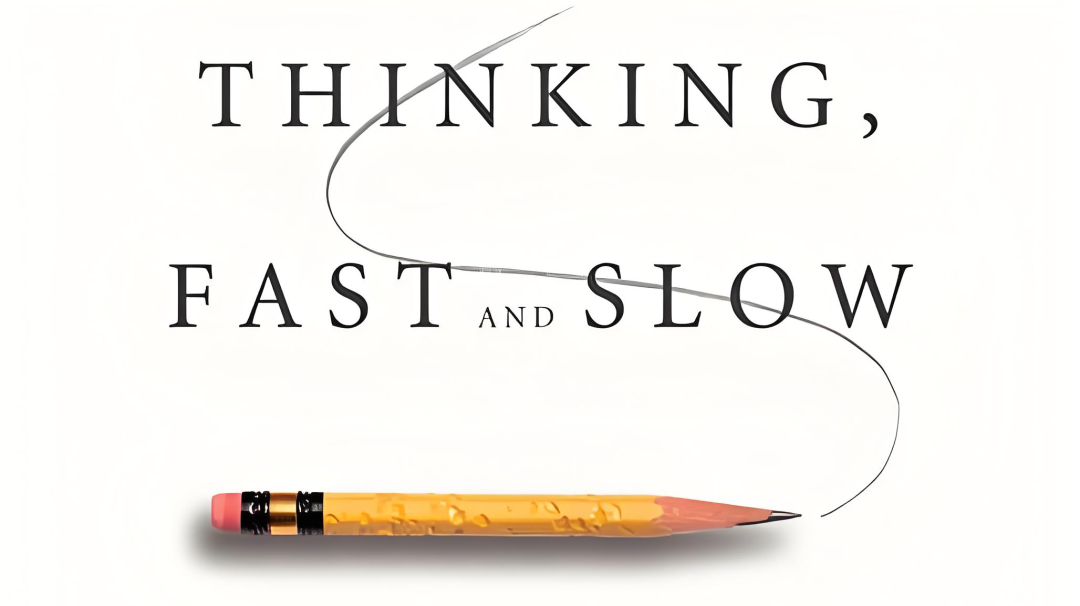
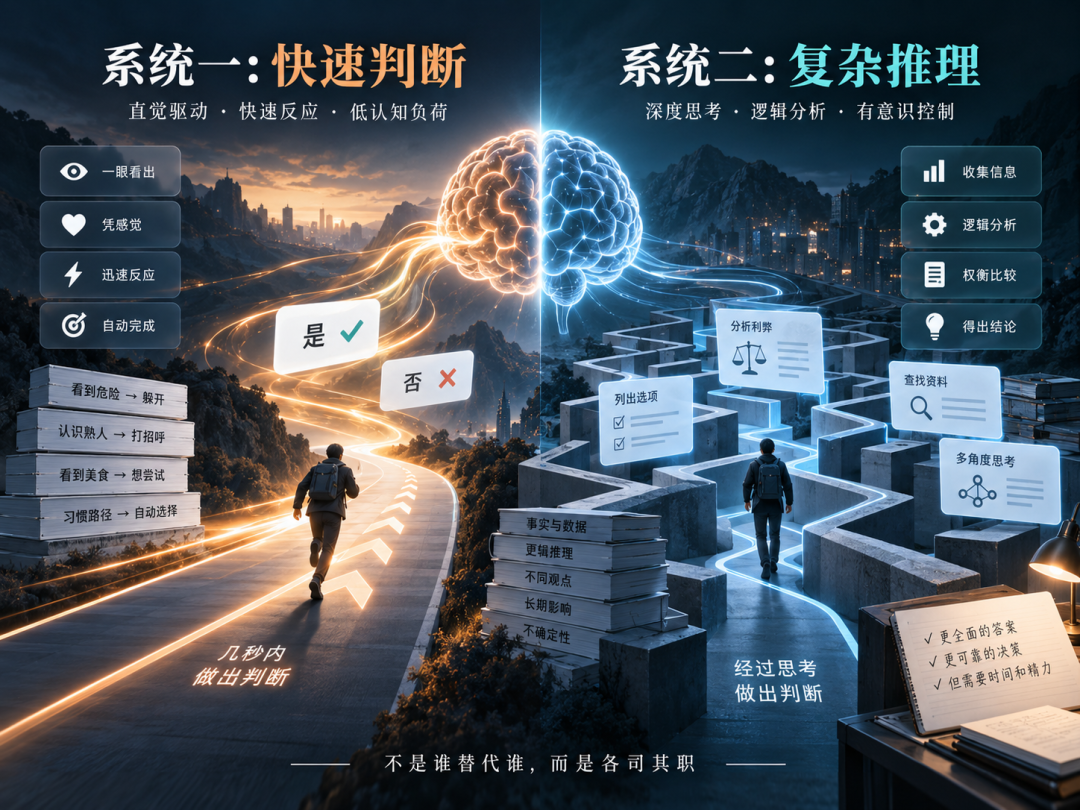
书里有一个非常著名的划分:人的思维可以粗略理解成两套系统。System 1快速、直觉,大量判断几乎瞬间完成;System 2则更慢,需要集中注意力、一步步推理。
今天最先进的推理模型,越来越像System 2。遇到复杂问题,可以长时间思考、拆解任务、调用工具,再一步一步得到答案。
而Jev刻意选择了另一边。它不追求复杂推理,也不追求生成一篇精彩的回答,而是专门做大量快速的语义判断。
比如有一封客户邮件:
“退款两个星期还没到账,再不解决我就取消会员。”
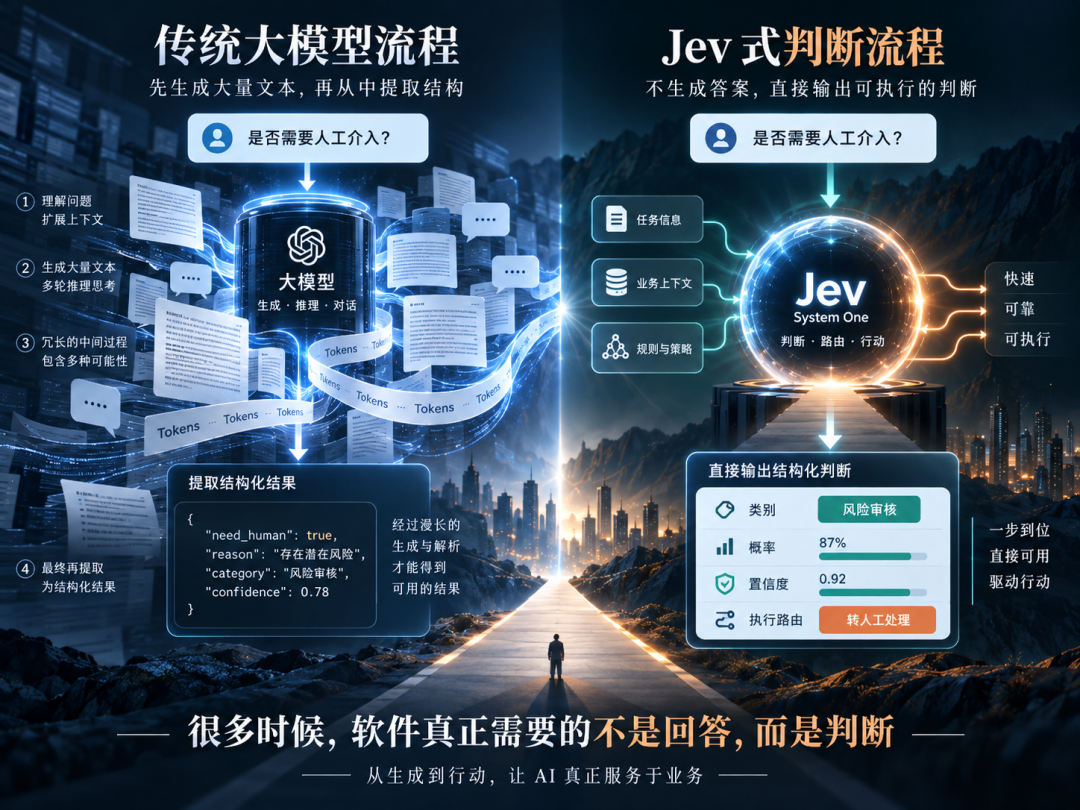
如果交给普通大模型,我们很可能写一个Prompt,让它分析客户意图、情绪、紧急程度、应该交给哪个部门,然后要求它最后按照JSON格式输出。
Jev的工作方式更直接。它可以判断:这是不是退款请求,概率94%;应该交给Billing的概率是86%;客户是否已经高度不满,概率是80%。
到这里就结束了。
它不需要再解释为什么,也不需要组织一段漂亮的自然语言。因为对于后面的软件系统来说,真正有用的从来不是那段话,而是这些判断结果。
这其实就是Jev最核心的设计:非结构化的信息进去,结构化、带概率的判断出来。
原来,我们一直让大模型干了不少“多余的活”
想想现在很多大模型的实际应用,会发现类似的事情非常多。
判断一封邮件是不是垃圾邮件,判断一条客服留言应该进入哪个队列,判断某段内容有没有风险,判断用户的问题应该调用哪个工具,判断检索出来的一段资料到底支不支持最终答案……这些事情都需要理解自然语言,所以传统代码很难解决。
但它们其实也并不需要一个会写诗、会写长文、会复杂推理的超级模型。
现在的常见做法,是先启动一个生成式大模型,让它阅读、理解、推理,再一个token一个token地生成答案,最后我们又要求它把答案压缩成几个JSON字段。
某种程度上,这就像为了回答一道判断题,先请人写一篇作文。
Jev干脆把“作文”这一层砍掉了。
这也解释了为什么它可以很快。普通大模型生成一段话,需要不断预测下一个token;而Jev根本没有长篇生成这一步。对于同一段输入,它还可以同时回答多个判断问题。
TypeSafe在自己的测试中展示了非常夸张的速度和成本优势。不过这些数字是在特别适合System One的任务中测出来的,不能简单理解成“Jev比GPT强几百倍”。真正值得关注的不是某个具体倍数,而是背后的逻辑:如果任务最终只需要一个判断,就没必要支付一次完整生成的成本。
但它又不是传统意义上的分类器
看到这里,很容易产生一个疑问:这不就是过去机器学习里的分类模型吗?
区别在于,传统分类器通常在训练的时候就把任务定死了。一个垃圾邮件分类器,就是专门判断垃圾邮件;要换成客户投诉分类,往往又需要准备数据、重新训练。
Jev更像一种“通用的判断模型”。
今天可以问它一段内容是正面、中性还是负面;明天可以让它判断风险是低、中还是高;后天又可以让它从Billing、Shipping、Account三个部门中选择一个。任务和选项都可以在运行时改变,而不需要为每一种判断重新训练一个模型。
所以我觉得一个非常容易理解的比喻是:
它像一个能够读懂自然语言的 。
传统程序擅长写:
但现实世界里还有大量条件无法这样精确表达,比如“这位客户是不是已经接近流失”“这段话是不是在隐晦地表达不满”“这个问题是不是已经严重到需要升级处理”。
这些事情,人通常一眼就能判断,但过去很难写成代码。
Jev想填的,恰恰就是这块空白。
更重要的是,它试图让“不确定”本身也变得可用
Jev还有一个我觉得非常关键的设计:它不只是告诉程序答案是什么,还会给出概率和置信度。
这听起来只是多了一个数字,实际上对软件系统很重要。
真实世界里的AI并不需要做到永远正确。一套系统完全可以规定:置信度非常高时自动执行,中等时再找另一个模型确认,置信度低时交给人工。
这样问题就从“AI会不会犯错”,变成了“AI能不能知道自己什么时候比较容易犯错”。
这也是TypeSafe特别强调概率校准的原因。他们设计了一套叫RLCD的训练方式,希望模型给出的80%、90%不只是模型随口报出来的“自信程度”,而是真正能够对应长期统计上的可靠性。
如果这一点能做好,意义其实很大。因为很多企业自动化真正缺的,不是一个永远不犯错的AI,而是一个能够把自己不确定的部分主动挑出来的AI。
一个更普通的例子,可能更容易理解它的价值
假设一家公司的产品每天收到几千条用户反馈。有人在报Bug,有人在提需求,有人在投诉,有人在询问使用方法,还有一些问题可能已经严重影响大量用户。
传统代码很难理解这些文字,于是现在很自然会想到用大模型。让模型读完每条反馈,再生成一份结构化结果:这是Bug还是需求,属于哪个模块,严重程度如何,要不要马上处理。
但仔细想想,这里面真正需要AI的其实只是前半段的“理解和判断”。
一旦知道它属于哪个模块、严重程度如何,后面的排序、统计、告警、建工单、派给谁,都应该由普通软件完成。
于是整个系统就可以形成一种很清晰的分工:代码负责计算和流程,Jev负责那些模糊的语义判断,真正复杂的问题再交给更强的推理模型。
这比“什么都丢给一个大模型”更像成熟的软件工程。
这可能也是Jev最有启发性的地方
过去两年,我们越来越习惯于一种AI架构:给大模型更多上下文、更多工具、更大的权限,然后让它自己判断下一步该做什么。
这就是今天很火的Agent。
它当然非常强大,但问题也随之而来。模型不只负责理解问题,还开始负责规划、选择工具、判断结果,甚至控制整个流程。系统越智能,也越难预测。
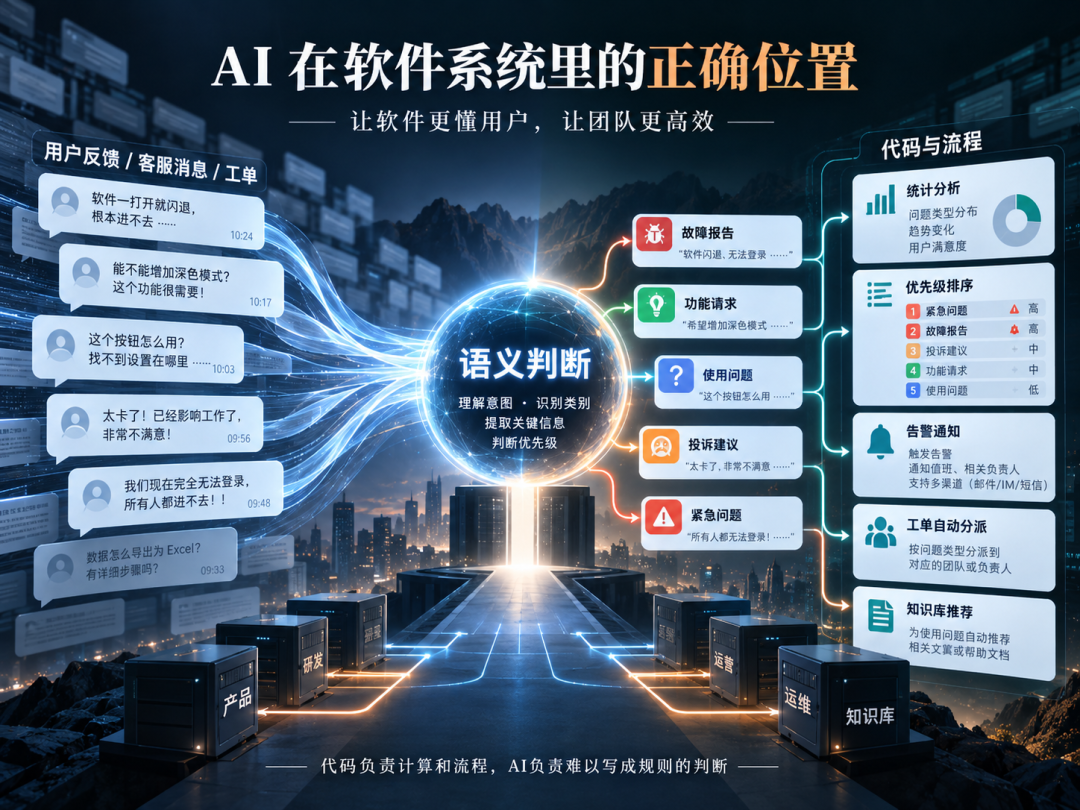
TypeSafe走的路线反而很保守:流程仍然应该掌握在代码手里,AI只负责传统代码无法可靠完成的那一小段判断。
这让我觉得,Jev真正值得关注的可能并不是“又出现了一个新模型”,而是它重新提醒了我们一件很朴素的事情:AI不一定非要成为整个软件系统的大脑。
成熟的软件从来不是靠一个万能函数完成所有事情。数据库做数据库擅长的事,搜索引擎做搜索,缓存做缓存,规则引擎做规则。
未来的AI也完全可能如此。
精确计算继续交给代码,快速语义判断交给System One模型,复杂推理交给Reasoning Model,需要和人沟通时,再调用生成式模型。
不同的智能,各司其职。
Jev未必成功,但这个问题值得记住
Jev现在还很早期。很多技术细节没有完全公开,官方公布的性能数据也需要更多第三方验证,中文以及专业领域里的实际效果更需要时间测试。
所以我并不想急着判断它会不会成为下一个明星模型。
但一个新技术真正有价值的地方,有时候并不是它这一代产品究竟有多强,而是它提出了一个此前容易被忽略的问题。
过去几年,大模型一直在努力学习如何像人一样思考、表达和交流。
Jev则换了一个角度:
如果AI最终是要成为软件的一部分,它或许并不需要每次都“回答问题”。很多时候,它只需要快速、可靠地做出一个判断。
这个方向看起来没那么炫酷。
但可能恰恰更接近AI真正大规模进入现实世界之后的样子。