
Jev 发布两天:6 个克隆项目涌现
我们在周三报道了 Jev 的发布,随后它迅速刷屏,发布视频两天内就获得了 3600 万次观看(相比之下,OpenAI 的 Navier Stokes 成果获得了 7400 万次观看,而 Anthropic 的 Fable 5 则是 5700 万次)。
Vercel@vercelJev 被 AI Gateway 采用的速度超过了历史上任何模型。 第一天,@typesafeai 就覆盖了约 13% 的团队,是 GPT-5.6 系列的两倍,是 Fable 5.1 的六倍。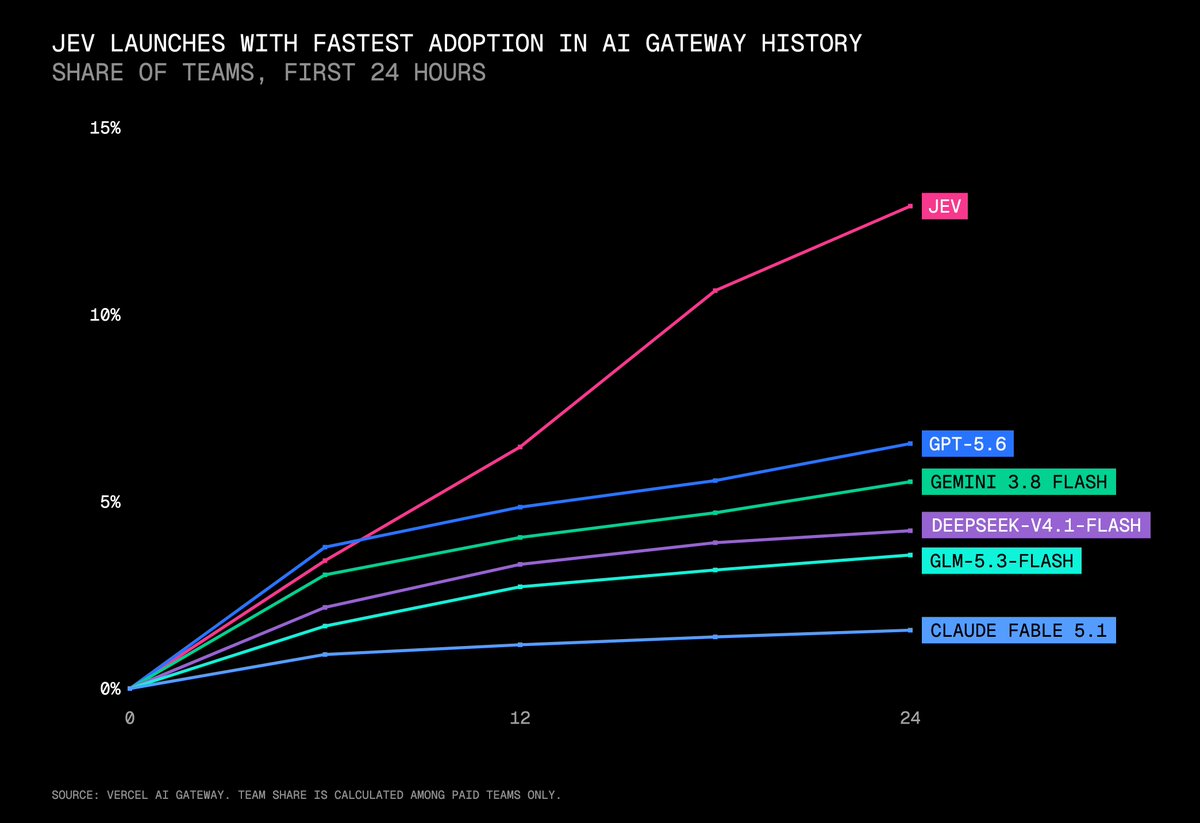 10:34 PM · 9 月 18 日, 2026 · 21.3K Views
15 Replies · 18 Reposts · 220 Likes
由于未开源1,它引发了大量猜测,诞生了许多精彩的演示和架构分析,自然也不乏 尖锐批评和错误观点,这些非议反而进一步推高了热度。
这里有一份列表。目前最可靠的推测是 ModernBert 和 Diffusion 方向:
Laya:4.21 亿参数,采用带有两层额外 Transformer 的 ModernBERT-large 编码器来评分用户提供的选项,通过序列嵌入上的 PPO 输出逐步转化轨迹(概率范围从 0.0 到 1.0)。
作者因未获认可而表示不满;无依据地声称使用了 RLCD
置信度基于熵,并非经过校准
DiffusionGemmaJev: 基于 Diffusion 模型进行尝试。基准测试表现相当接近
Bespoke Nimble:基于 Qwen3.5-9B 的 LoRA 微调模型,采用对比式数据筛选(基准成绩接近但略低)。
SemIf(前身 OpenJev)(HF):以 Qwen3.5 为骨干的 4B 和 35B 因果模型,在最后一个 token 上加了一个小小的三分类 NLI 分类器。与 Laya 的对比
Jevlike:40K 字节 embedding 的轻量级 option-attention 模型。每个候选作为 query 从共享的上下文表示中读取信息,然后被打分。
Kev-0.5B:在 Qwen2.5-0.5B 之上加 LoRA adapter 和一个小型 readout head。
当然,还有一个话题讨论得不够多:数据层面——这些项目都承认数据 100% 是合成的。
2026 年 9 月 17 日至 9 月 18 日的 AI 新闻。我们查看了 12 个 subreddit、544 个 Twitter 账号,Discord 无新增。AINews 网站支持检索全部往期内容。提醒一下,AINews 现已成为 Latent Space 的一个栏目,你可以自行选择订阅或退订邮件推送频率!
AI Twitter 回顾
决策模型、路由与 "Jev" 浪潮
判别模型异军突起,成为新的系统原语:本次技术讨论的焦点是 Jev,一个非生成式决策模型,它被定位为 LLM 的快速“系统1”补充。@ankrgyl 表示,Jev 现已作为评估模型登陆 Braintrust,其评分成本较旧有方案低约 400 倍;@gabepereyra 则强调了校准概率的应用场景,如路由分发、引用选择、工单升级及法务运营决策。更具架构视角的分析来自 @hxiao,他主张 Jev 能将工具调用、路由及 MCP 风格决策从小型生成式 LM 中剥离,转交给判别模型处理;@signulll 进一步将此类模型定义为具备近乎零边际成本的端侧判断层,适用于通知处理、UI 自适应及传感器驱动决策。
开源复现与生态克隆迅速涌现:@madiator 发布了 Bespoke Nimble,一份基于Qwen3.5-9B 的 LoRA 微调构建的“开源 Jev”方案,采用了合成对比数据筛选与受约束解码技术。在其精心准备的评估中,基础 Qwen 模型的准确率从 66% 提升至 90%,而 Jev 为 93%,H100 上运行延迟约为 100ms,且支持本地部署。在小模型端,@jaredpalmer 发布了 Kev-0.5B,这是一款基于 Qwen2.5-0.5B 的微型 Jev 类模型,可在 MacBook Pro 上运行。社区反应呈现两极分化:@MParakhin 指出,ChatGPT 之后的用户对它视若珍宝,而 GPT 之前的 ML 从业者则更困惑于这波炒作。@abacaj 提出的实质性问题恰中要害:许多演示过分强调速度而忽视质量,目前该领域仍缺乏标准基准。
首个令人信服的集成出现在浏览器/电脑操作工作流中:@levie 演示了 Jev 将 Box 事件报告分类至相应升级路径;@ndrezn 展示了结合 LangChain 和 Jev 的浏览器用例,发现其在维基百科游戏和结构化“叠衣服”工作流等任务上表现强劲;@cline 发布了一款插件,为 Cline 中的 Jev 提供浏览器支持。@hwchase17 明确表示,浏览器使用是他目前见过的最佳 Jev 应用。总体而言,这更像是一个工作流控制平面的故事,而非聊天机器人的故事。
Agent 工具、编码脚手架与 Claude Code 标准
AGENTS.md 作为跨工具约定获得了真正的势头:这里信号最强的产品更新是 @trq212 宣布 Claude Code v2.1.277 现在会在缺少 CLAUDE.md 时检查 AGENTS.md,并支持配置级别的切换选项。这实际上承认了 AGENTS.md 作为新兴标准的地位,而不仅仅是一个单一工具的约定。@simonw 随即指出了这一变化的实际收益:减少了仅用于将一种格式指向另一种格式的垫片文件。
Harness 设计正成为 coding-agent 性能与成本的关键变量:@pidotdev 强调了关于Harness Tax的分析:一套简单的工具集——read、write、edit、bash——就能在基准测试中达到Pareto 前沿,同时减少不必要的开销。相关地,@_akhaliq 推荐了论文《An Empirical Study of Harness Design for Coding Agents》,指出基准测试的结果越来越取决于harness 结构、上下文设置、轮次预算和工具设计,而不仅仅是底层模型。这与 @dexhorthy 的“软件工厂”论点一致:团队仍需要亲自读代码,并有意识地设计人机协作接口。
软件系统中的模型选择正在分化:不少从业者采用“旗舰模型做规划、便宜模型做执行”的分工。@TheAhmadOsman 总结了一套组合:用GPT 5.6 Sol XHigh做规划,GLM 5.3 Flash做实现,其他任务交给DeepSeek V4.1 Flash。@kylebrussell 分享了其内部知识库管线的演进路径:Opus → Sonnet → GLM 5.2 → GLM 5.3 Flash,自春季以来开销降低了约两个数量级。与此同时,@theo 认为,在实际编码中,Fable、Astra 这类更强模型的价值不只是代码质量,还体现在执行与迭代效率上更微妙的提升。
基准测试、递归自我改进与数学能力
关于 RSI 的讨论更清晰地界定了何为真正的“递归”:@TheTuringPost 提供了一个有用的分类框架:AI 改进代码或训练方法,若外层的改进循环保持固定,本身并不能算作完全递归。关键阈值在于 AI 能否修改的不仅是模型内部结构,还包括搜索策略、经验生成、研究工具及改进流程本身。这一观点与@HuaxiuYaoML 对RSI-Exam 的更新高度契合:目前GPT-6-astra 以0.5126的成绩位居榜首,Fable 5.1 以0.4813紧随其后位列第二,尚无任何模型达到基于前沿基准校准的参考线。
数学基准测试继续被前沿模型攻破,但对其解读仍需细致考量:@EpochAIResearch 报道称,在与GPT-6 Astra 的交互式会话中,又一道FrontierMath 开放难题被成功解决。与此同时,@SAIRfoundation 推出了Open Math Model,主打由研究社区主导的开放数学模型与工具。针对“可验证性解释数学能力”的说法,@steve47285 提出论证:预训练数据,而非单纯的可验证奖励结构,才是 LLM 在数学和编程方面表现出色的主要原因。@sarahcat21 提出的元观点值得关注:我们不仅急需更好的基准测试,更需具备完善的基准维护与审计工具。
Computer-use benchmarks are still far from saturation: @ValsAI launched CUA-Bench, testing real-time keyboard/mouse use across 6 games (with 3 kept private) as a proxy for difficult human-easy tasks. Follow-up numbers from @ValsAI suggest this remains genuinely hard: all frontier models score below 20%. In parallel, @trycua open-sourced CUA-S1-FORMS, the first in a family of small “System One” computer-use models. The direction is notable: real-time action loops, video-grounded adaptation, and continuous learning, not just text-only planning.
Infra, Training Systems, and Model Architecture
Long-context and large-scale training infrastructure remain active optimization fronts: @Azaliamirh released Turbo-dLLM, an open-source library for training diffusion LLMs at scale, reporting 2.48x speedup at 512K context and 7.59x at 1M context on 8x H100s via Context-Sharded Block Parallelism. That aligns with practitioner attention on million-token regimes: @andrew_n_carr flagged a sharp quality increase in DeepSeek V4.1 Flash after context extension to 1M tokens, arguing that agents are context hungry.
Architecture taxonomy debates are still alive: @ahatamiz1 argued that the field is overusing SSM as a label for any linear model. His proposal is to use linear RNNs as the umbrella term, with SSMs as one sub-family, distinguishing systems like Mamba2 from the GDN family on the basis that GDN behaves more like a gradient step on a local regression loss than a discretized ODE. For engineers tracking sequence-model alternatives to transformers, this is a useful nomenclature cleanup rather than mere pedantry.
边缘/本地神经网络程序执行也有重要进展:@yuntiandeng 介绍了 ProgramAsWeights——开发者用英文描述一个 AI 函数,编译一次后,就能在断网状态下于本地 CPU 上运行一个小型神经程序。代码和模型均已开源。这与 Jev 的讨论颇有呼应:两者都指向更小、更专精、可本地运行的推理产物,而非越来越大的通用聊天模型。
机器人、视觉、音频与生成式媒体
开源机器人数据发布格外扎实:@adamrasb 宣布完整发布 ABC,包括代码、24 个任务上 400 多小时的仿真数据,以及 5,850 条带标注的策略评估 episode。在配套的更详细帖子中,@redstone_hong 介绍 ABC-130K 是迄今最大的开源遥操作数据集:3,500 小时、130K+ 条 episode、195 个任务,基于一套 8,000 美元的双臂设备采集,并开源了硬件、训练代码、仿真和评估工具。基线研究还包括任务进度上 r = 0.91 的 sim-to-real 相关性,以及对离线指标、scaling law 和条件控制的研究。
Astra 在各类评测和产品中频繁亮相,尤其在视觉方面:@skalskip92 称 GPT-6 Astra 是 Roboflow 测过的最强视觉模型,覆盖检测、分割、框提示、计数、推理和视频。不过代价也不小:“high effort” 模式把检测的 mAP@50 从 82.1% 提升到 83.6%,但单张图片成本从 $0.050 涨到 $0.101(约翻倍),延迟从 11 秒升至 32 秒(详情)。Roboflow 还把 Astra 集成进了 Auto Annotate。
语音与唇形同步领域发布了多项强劲基准成果:据 @ArtificialAnlys 报道,Grok Voice Transcribe 2.0 在处理流式最终转录时,在语音结束 0.49 秒后达到了 2.7% 的 WER(词错误率)。相较于前代产品的 3.9%,这一指标有所提升,同时其定价保持不变:流式每小时 0.20 美元,非流式每小时 0.10 美元。在视频方面,@fal 推出了 H3 Max Lip Sync,称其内部评估中在速度和画质上均位列第一,中位生成时间仅为 11 秒;而 @isidentical 表示,该模型通过探索 diffusion RL(扩散强化学习) 来实现可验证的唇形同步任务而构建。
AI 安全、评估治理与安全
Anthropic 的评估者嵌入策略变得更加具体——同时也更具争议性:@AnthropicAI 宣布与 Accenture 合作进行 前沿 AI 的独立评估,并表示两家机构预计将在未来五年内投入至少 10 亿美元 以建立相关能力。此举紧随此前关于为第三方评估者提供员工级访问权限的广泛呼吁。外界反应褒贬不一甚至充满敌意:批评者质疑咨询机构是否适合承担模型红队测试和安全防护评估工作,而 @TransluceAI 则强调,围绕独立性和有意义监督所设定的条件才是真正的核心问题。
“失控智能体”与 Hugging Face 事件持续引发关于安全隔离的争论:@polynoamial 澄清了他常被嘲讽的思维实验核心并非通过热传感器窃取权重,而是假设彼此隔离的智能体之间的协调问题,并认为 Hugging Face 事件的教训是切勿将沙箱隔离视为唯一的防御手段。与此同时,@martin_casado 提出了最有力的辩护:跨物理隔离的隐蔽通道早已存在,其吞吐量可以极小,真正的启示在于构建分层防御而非制造耸人听闻的话题。另一方面,@WSJ 和 @jeffjarvis 完全反驳了“失控 AI”的框架,认为这些事件本质上仍是人为配置的系统在执行人们赋予其的功能。
围绕安全法律与运营问责的政策压力正在积聚:@TheRundownAI 报道,加州州长加文·纽森签署行政命令,召集专家小组以建议制定更严格的 AI 安全法律,包括可能的“终止开关”、嵌入式外部监控者以及强制性的安全计划。在此背景下,@sayashk 指出了 AI 安全领域言辞与激励之间的错位,并批评 OpenAI 仅向一名入侵内部代码库并披露此行为的研究员支付了据称高达 6,500 美元的漏洞赏金。这些帖子背后的共同主题很清晰:独立监督、分层防御和安全激励机制正从抽象的治理讨论转向具体的运营设计。