
Google DeepMind 推出 Dream-RSI:AI 智能体通过“梦回”过往搜索实现自我改进
Google 和 Deepmind 的研究人员开发出一种方法,能让 AI 智能体更高效地解决困难的搜索任务。它利用以往的搜索记录来测试新策略,无需重复昂贵的计算。
自我改进的 AI 智能体,未来有望自主发现新算法、数学问题的解法或更快的代码。它们的基本流程都一样:提出方案、评估结果、从中学习、再次尝试。经过成千上万次迭代,逐步逼近好结果。
面对复杂任务,搜索空间可能极其庞大。智能体必须不断决定:哪些方向值得深入、哪些值得并行尝试、哪些应该放弃。这个过程叫作探索,它往往决定了搜索是最终成功,还是白白浪费算力在错误思路上。
Google 和 Deepmind 的研究团队推出了 "Dream-RSI" 来改进这些决策。这个方法改变的是智能体的搜索方式,而不是底层 AI 模型。
现有方案处理探索主要有两种方式。固定搜索策略无法从经验中学习,智能体可能反复撞上同样的死胡同。在搜索过程中动态调整策略虽然灵活,但代价不小——判断一个策略是否有效需要大量尝试,而逐一测试各种备选方案意味着重复漫长而昂贵的运行。
重放过往搜索,让测试新策略的成本更低
研究人员的思路是:复用一次已完成搜索的数据,在智能体已经探索过的空间内测试其他策略。智能体在搜索过程中会记录自己的尝试及结果,这就为日后重放这些决策提供了数据。
研究人员把它比作在陌生地方找路:第一次去时,你会碰壁、绕路、好不容易才找到路线;但一旦脑子里有了地图,再规划另一条路线时,就不必把每个角落重走一遍了。
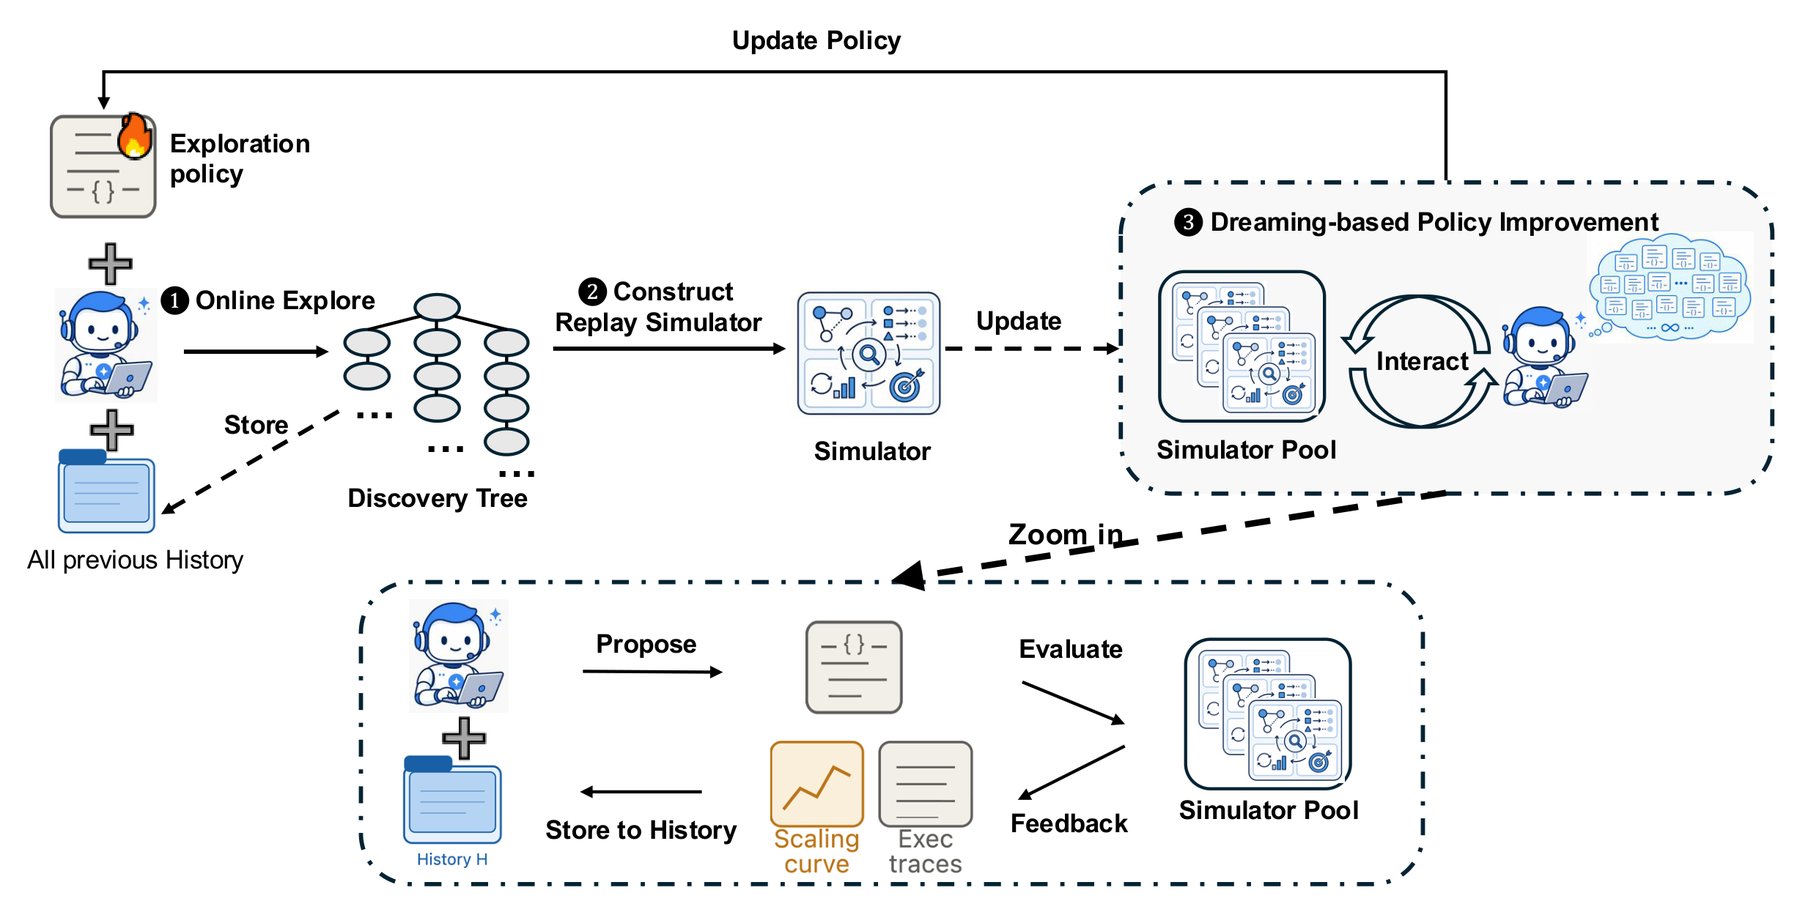
Dream-RSI 将该原则应用于记录的搜索历史。智能体不在实际运行中测试新策略,而是将其与存储的结果进行对比验证。这使其能够推断:如果最初选择其他方法,或放弃某些早期路径,结果会是怎样。在回放过程中,系统并非凭空创造全新的解决方案,而是在已记录的搜索树中测试不同的决策分支。
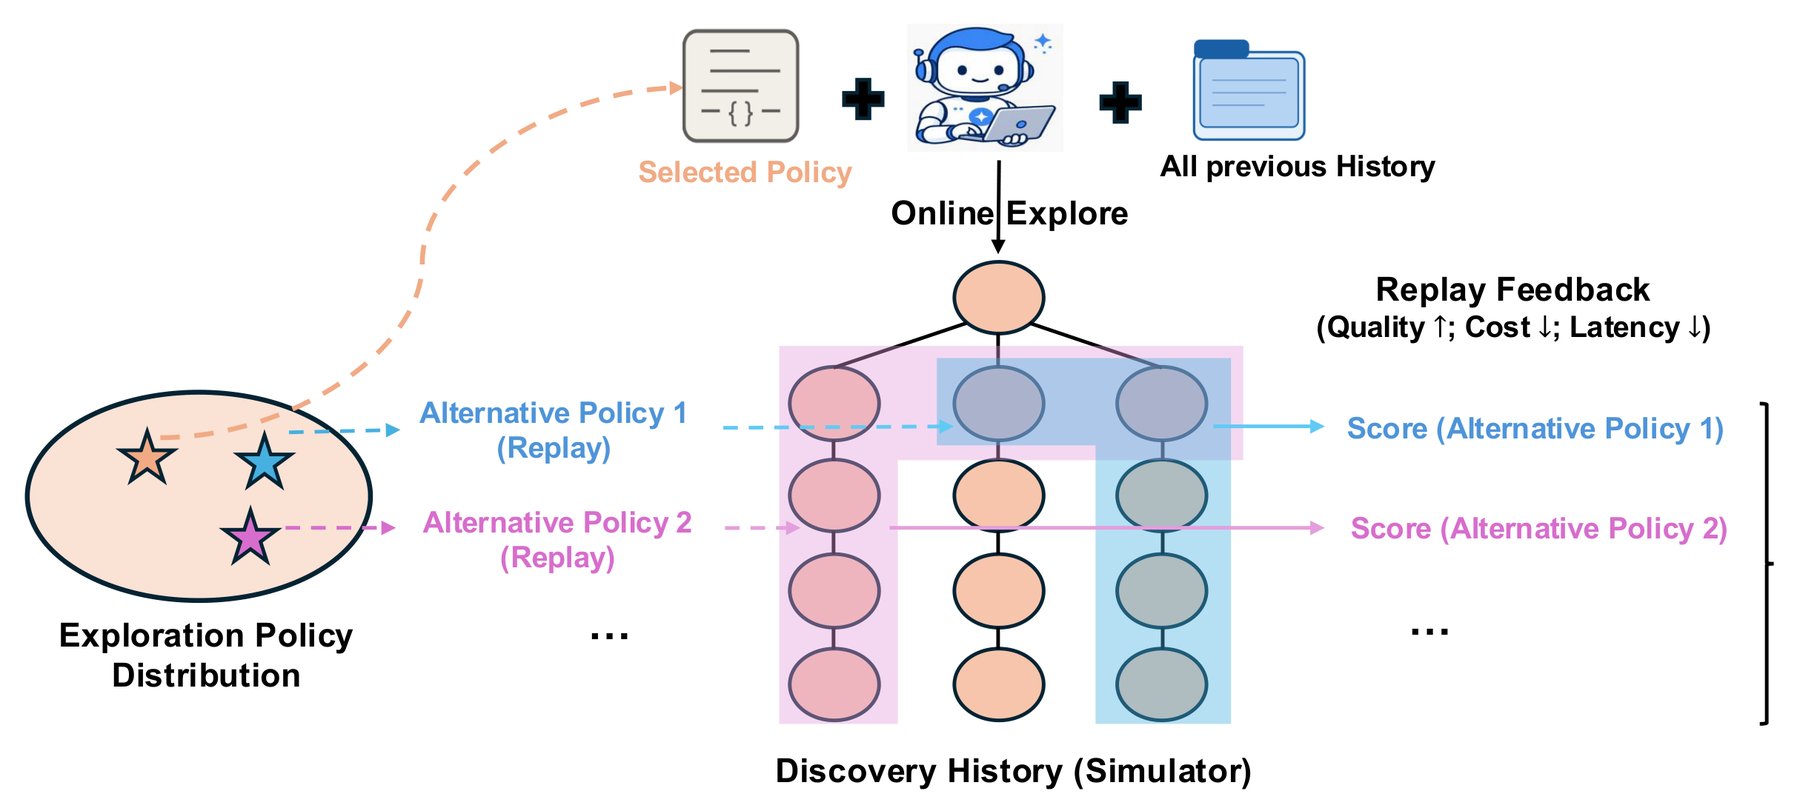
既然这些结果已存在,智能体便无需重新生成或评估解决方案,从而避开了实际运行所需的高昂计算开销。这使得测试新的搜索策略成本低得多。研究人员将这一过程称为“做梦”。智能体会模拟数千种变体,选出最优者,再将其应用于实际搜索。
该过程以循环方式重复。每次搜索结束后,智能体利用记录的结果测试更优策略,并将改进后的策略用于下一次实际运行。在整个循环中,只有搜索策略在变化,生成解决方案的模型保持不变。
Dream-RSI 以更少尝试找到更优解
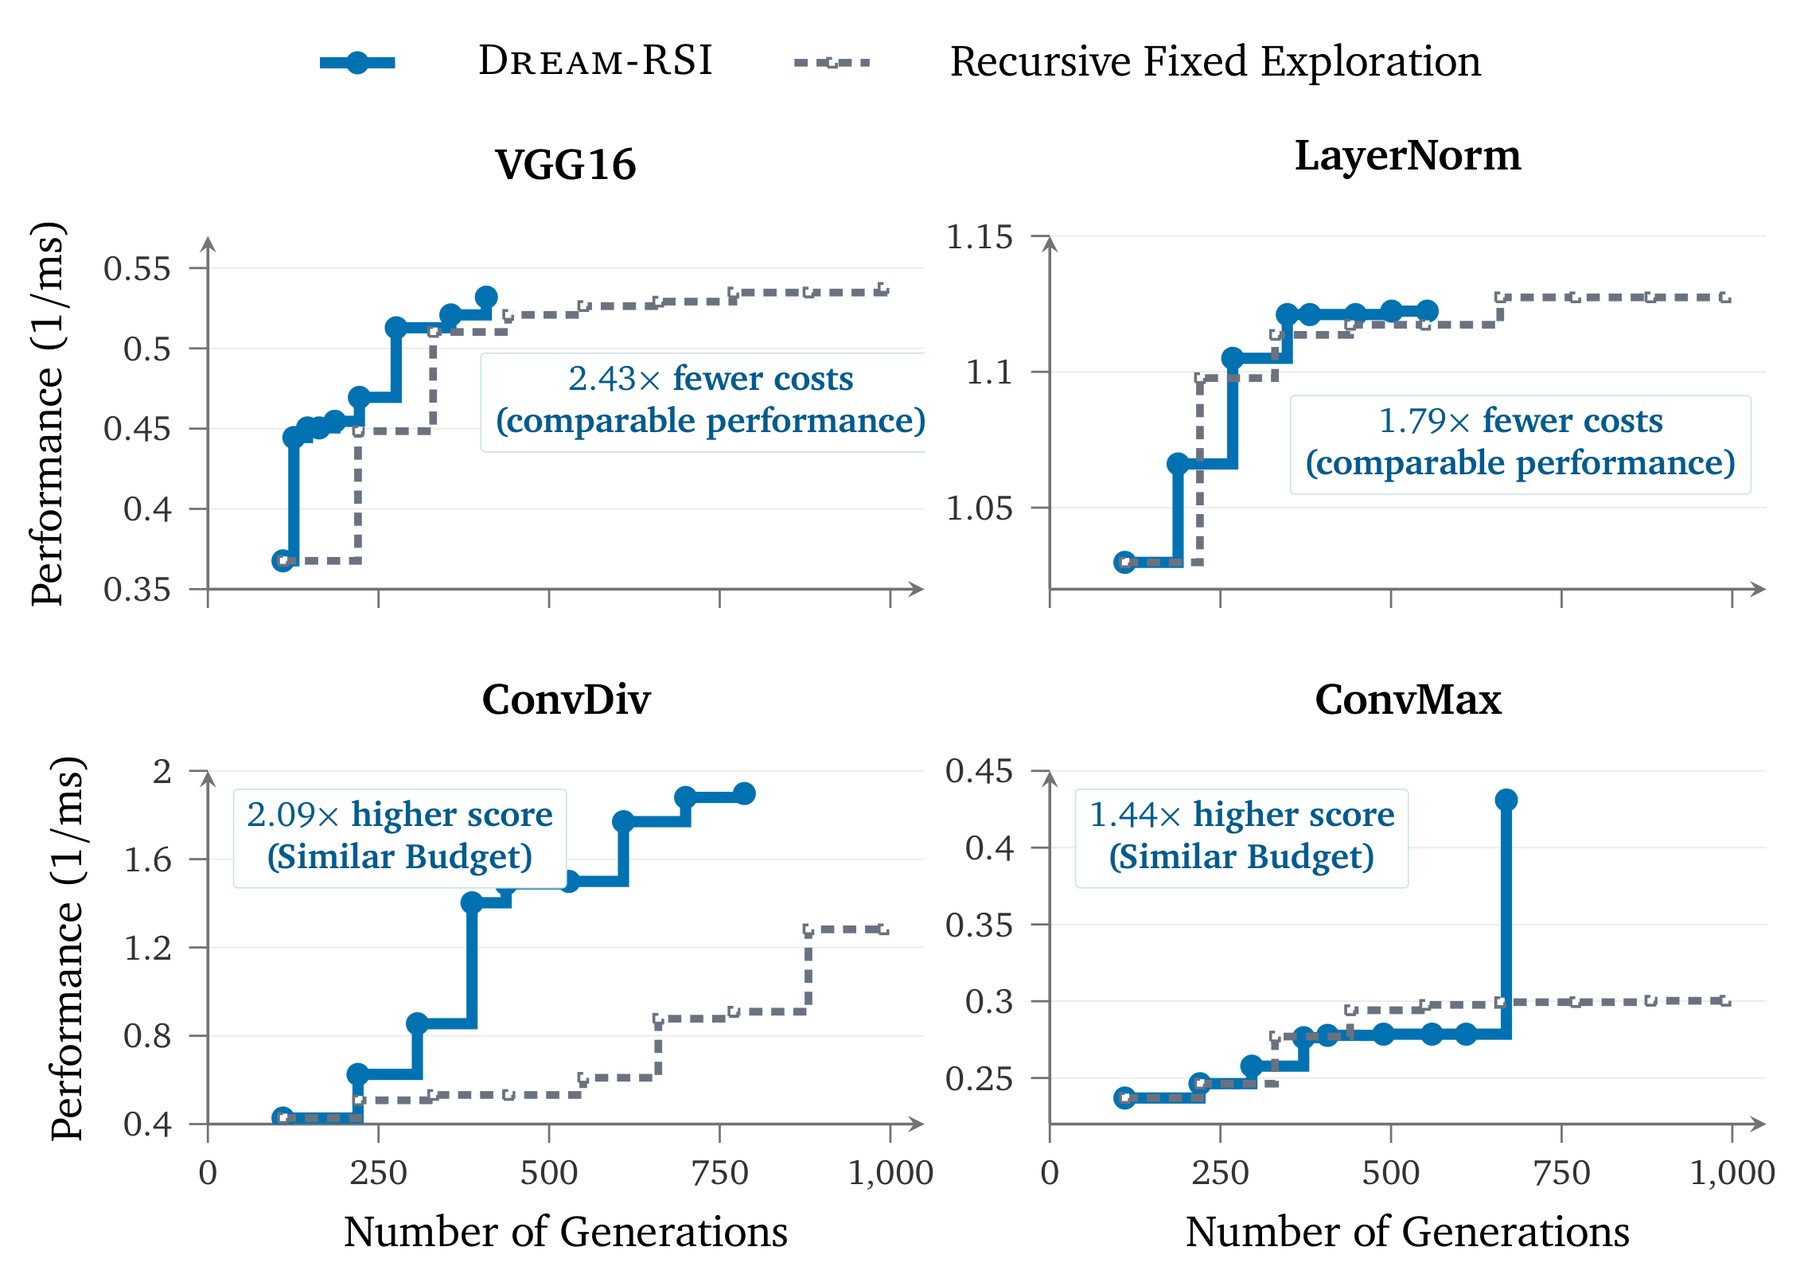
研究人员在八个任务、三个领域中测试了 Dream-RSI,分别搭配 Gemini 3.1 Pro 和 Gemini 3.7 Flash。每组对比实验均使用相同的初始条件,但采用固定的搜索策略作为基线。
其中一项任务要求系统编写速度最快的程序,用于基因学和金融领域常用的统计计算。Dream-RSI 生成的程序在所有六个测试数据集上均快于现有的 sklearn 和 glmnet 库。
在使用 Gemini 3.1 Pro 时,平均运行时间从 3,587 毫秒降至 2,931 毫秒,尝试次数也从 550 次减少到 317 次。Dream-RSI 还优于名为 SimpleTES 的竞品系统,后者需要 51,200 次运行,而 Dream-RSI 仅需 317 次。
数学优化任务和高效 GPU 内核编写任务也呈现相同规律,即在算力成本大幅降低的情况下取得可比或更优的结果。在两个 GPU 任务中,Dream-RSI 保持性能不变的同时,将运行次数最多减少了 2.43 倍。在另外两个任务中,它在相同预算内实现了最高 2.09 倍的性能提升。
显式指令可能限制探索
在后续分析中,研究人员测试了利用搜索历史的另一种方式:不是回放历史来测试策略,而是将其压缩成指令,告诉 agent 该去哪里搜索。
在一个 GPU 任务上,带这些指令的版本反而比不带指令的版本表现更差。研究人员认为,过于具体的方向会把搜索空间压缩得太窄,导致 agent 无法探索更广泛的方法。
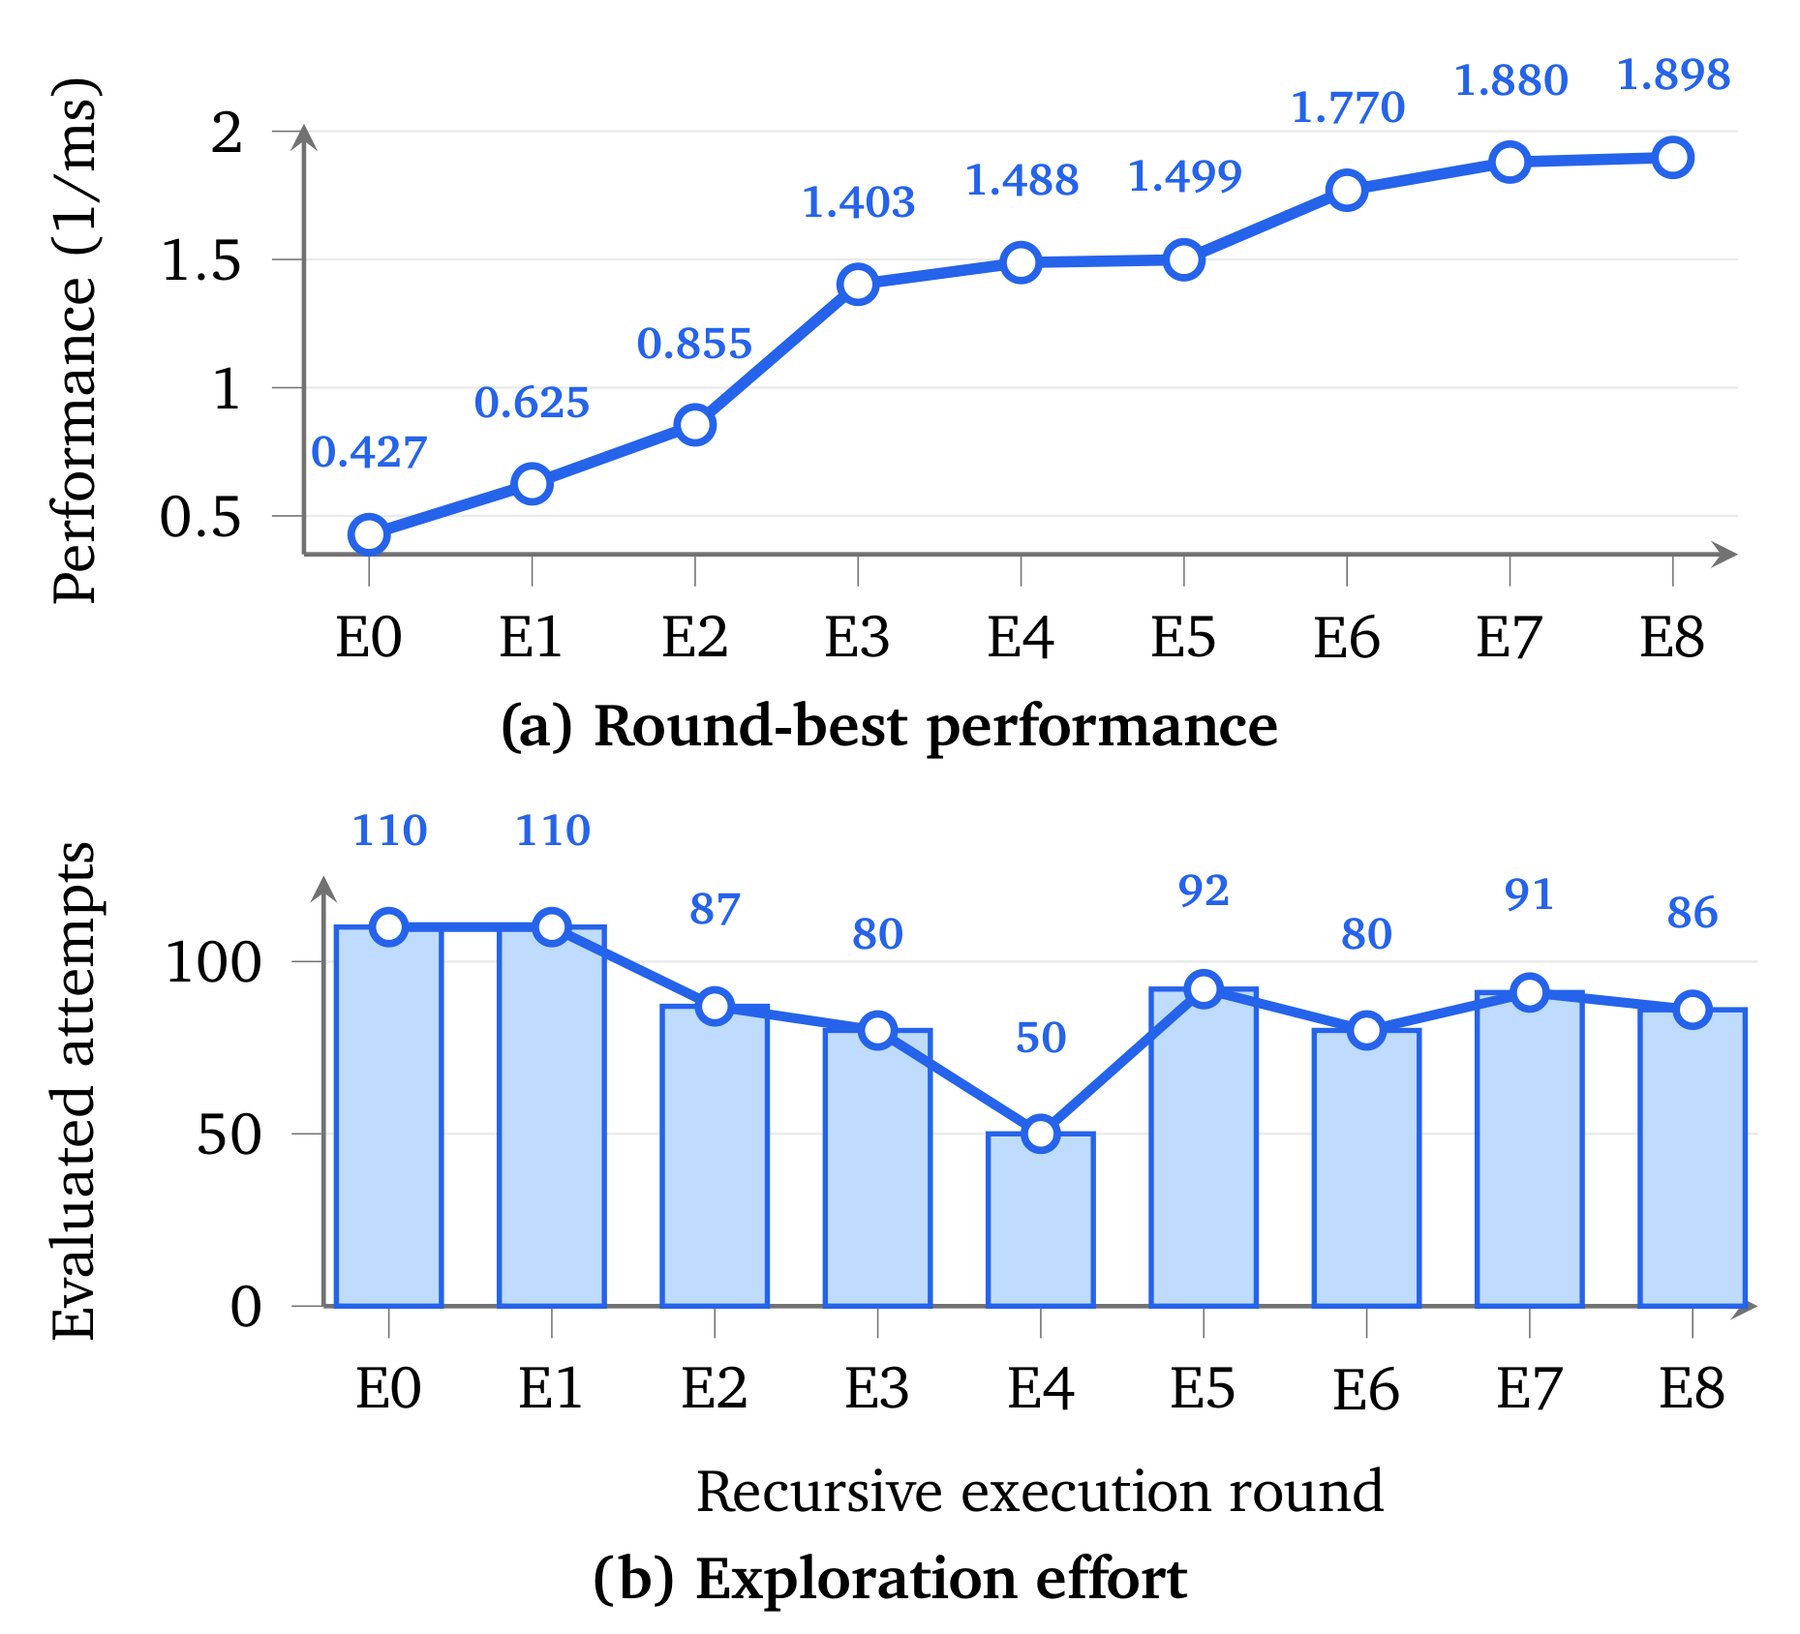
同一分析还展示了学习到的策略如何调节搜索力度:性能提升时,它会先减少尝试次数;当进展停滞时,它又会加大搜索力度,而这也带来了进一步的性能提升。研究人员已在 GitHub 上公开了代码和更多细节。
递归自我改进(Recursive self-improvement)近来受到越来越多的关注。这个领域的进展,也是 Anthropic CEO Dario Amodei 最近对 AI 研究提速发出警告的原因之一。
Google Deepmind 在 2025 年推出的 AlphaEvolve 采用的也是类似的基本原理:Gemini Flash 生成代码方案,Gemini Pro 分析这些方案,再由进化算法挑选最优版本。Dream-RSI 则更进一步,直接优化搜索策略本身。
AutoTTS 采用了类似思路,利用编码 agent 在模拟环境中搜索算法。这些算法决定语言模型何时开始、扩展或放弃推理路径。最终生成的方法在计算资源消耗更低的情况下,击败了手动设计的方法。
Google Research 最近介绍了另一种重用历史运行记录的方式:WikiSkill。该系统将失败与成功记录在 wiki 中,并将其转化为供 agent 复用的指令。Dream-RSI 的后续分析表明,在这类开放式搜索任务中,这类显式指令可能会限制探索空间。
Meta 走得更远,推出了 Hyperagents,允许 agent 重写控制其改进过程的机制本身。