
NAND天性“多产”,闪迪凭什么守80%毛利率?
本文来自微信公众号: 海豚研究 ,作者:海豚君
上篇《AI推理大爆发,“悲催”闪迪真有凤凰涅槃?》中,海豚君提到,闪迪甩掉传统机械硬盘包袱后,已全盘聚焦NAND闪存市场,精准吃到本轮行业回暖的红利。AI推理大爆发,“悲催”闪迪真有凤凰涅槃?
技术上,闪迪不盲目“死磕”层数,而是主攻横向微缩实现行业最高位密度、率先量产CBA键合架构提升能效,并联合首推专为AI推理定制的HBF(高带宽闪存),综合技术实力稳居NAND第一梯队。
叠加NAND行业起飞的风口,闪迪业绩爆发水到渠成。本篇继续深度拆解三个核心议题:
1)在AI浪潮席卷之前,NAND究竟是一个怎样的行业?
2)为什么NAND行业的供给总是陷入“减不掉”的怪圈?
3)同为存储基石,DRAM与NAND为何“同源不同命”?
以下是详细分析
一.在AI浪潮席卷之前,NAND究竟是一个怎样的行业?
把闪迪2019—2025年闪存业务拆成“量”与“价”两条线,会呈现制造业中极罕见的形态:
bit出货量从38 EB暴增至101 EB、六年大增166%;但每GB均价(ASP)从0.206美元跌至0.073美元、惨跌65%。最终闪存收入不升反降,从78.2亿美元微降至73.6亿美元、倒退6%。
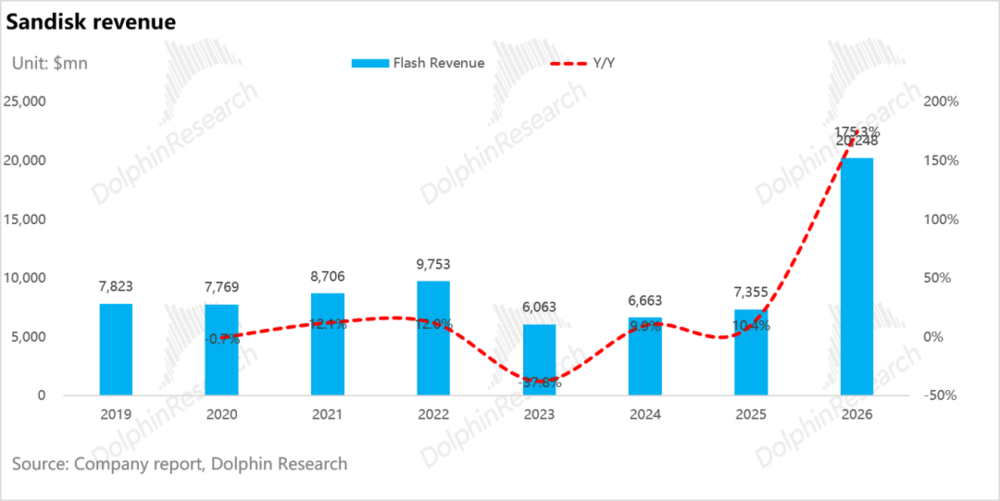
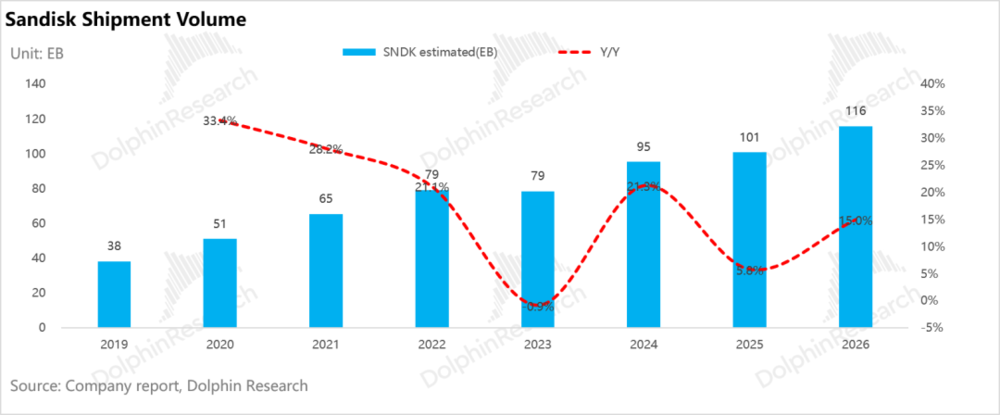
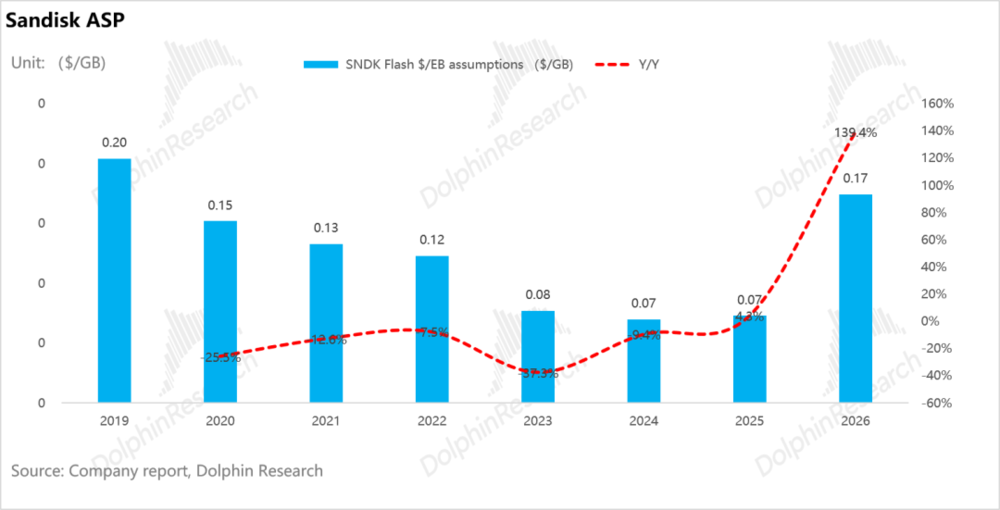
这揭示了NAND生意的残酷本质:“做大量”与“做大收入”之间一直没有稳定的正向关系——技术进步带来的成本下降几乎超额“赠送”给下游,制造端留不住降本溢价。
①下行周期:收入崩塌完全由价格驱动,销量仍在增长
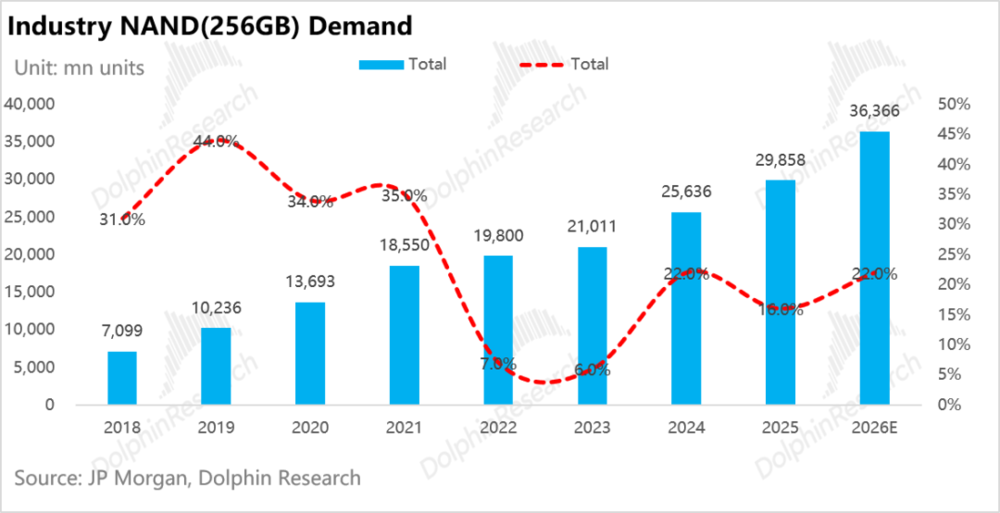
NAND下游需求在2018—2021年持续保持30%以上高增速(每年34%~46%),源于三重共振:
a.智能手机普及与容量升级——每代旗舰机存储容量翻倍,推动手机端NAND bit需求在2018—2021年间年均增长34%;
b.PC由HDD(Hard-disk drive,机械硬盘)全面转向SSD(solid-state drive,,固态硬盘(SSD)——SSD渗透率从约50%升至90%以上,2019—2021年客户端SSD bit需求连续三年增速超34%;
c.企业级SSD扩张——云厂商服务器SSD部署加速(标准服务器)。
但2022—2023年需求增速断档,骤降至仅6%~8%:
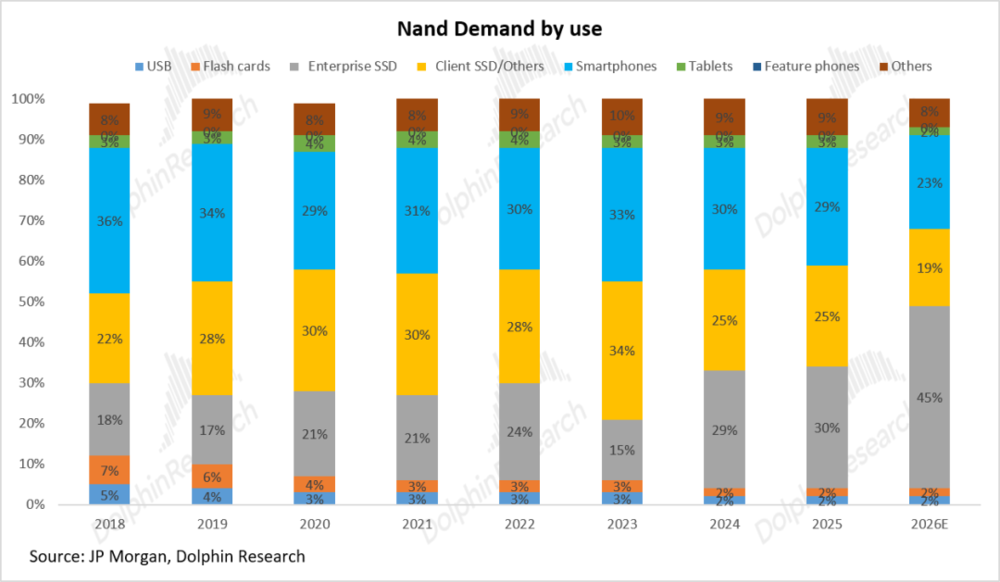
a.手机全面萎缩:作为最大单一终端(2023年约占bit需求33%),通胀与利率上行压制换机、叠加2021年疫情透支,手机端bit增速从2021年的46%骤降至2022年的2%,是最大拖累;
b.PC断崖回落:2020—2021年疫情居家办公需求透支了PC市场,2022年全球PC出货同比−12%,2023年继续−10%;
c.企业级SSD降温:标准服务器在2021年投资高峰后进入消化期,企业级SSD bit需求2022年增速从34%降至20%,2023年转为−33%,而当年AI服务器尚未形成足以对冲的增量。
d.库存牛鞭效应放大收缩:三大终端同时去库存,原厂库存从6周升至16周。更关键的是跌价预期自我强化——客户预期续跌而推迟采购、转为按需下单,订单萎缩又加速价格下跌、反过来验证预期,终端需求增长放缓至6%~8%,被放大为存储订单的剧烈波动。
以闪迪为例,2023年出货量基本持平,每GB均价与收入同比均降37.8%;同年行业收入约−37%、ASP−42%——收入跌幅完全由价格驱动,销量对下滑的“贡献”为零。
这与传统周期行业截然不同:钢铁、化工、航运下行期是需求萎缩→销量下滑、量价同向承压,靠减产匹配需求,使价格企稳;而NAND在最惨年份有减产动作,但出货量并未缩水、价格独塌近四成。
此阶段NAND呈现典型大宗商品属性:价格是市场博弈的结果,技术与成本优势无法转化为溢价、只体现为亏损幅度差异,价格跌幅完整吞噬了销量增长的成果。
2.为什么NAND行业的供给总是陷入“减不掉”的怪圈?
供给端当年确实执行了史无前例的深度减产:
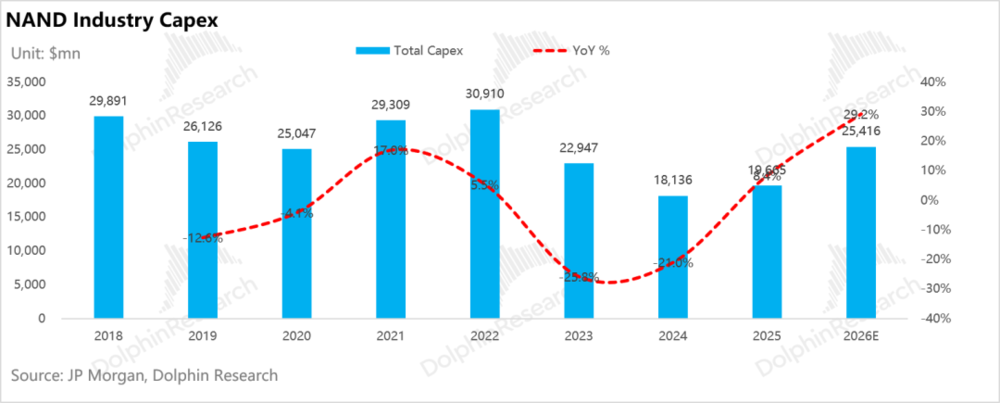
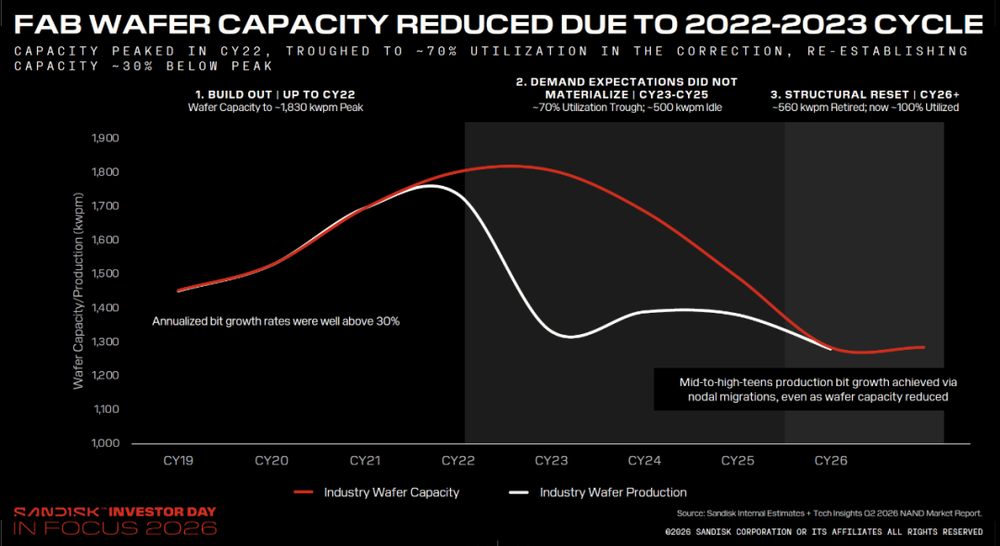
资本开支上,行业CapEx自2022年309亿美元峰值连降两年,2024年降至181亿美元谷底、累计收缩41%。
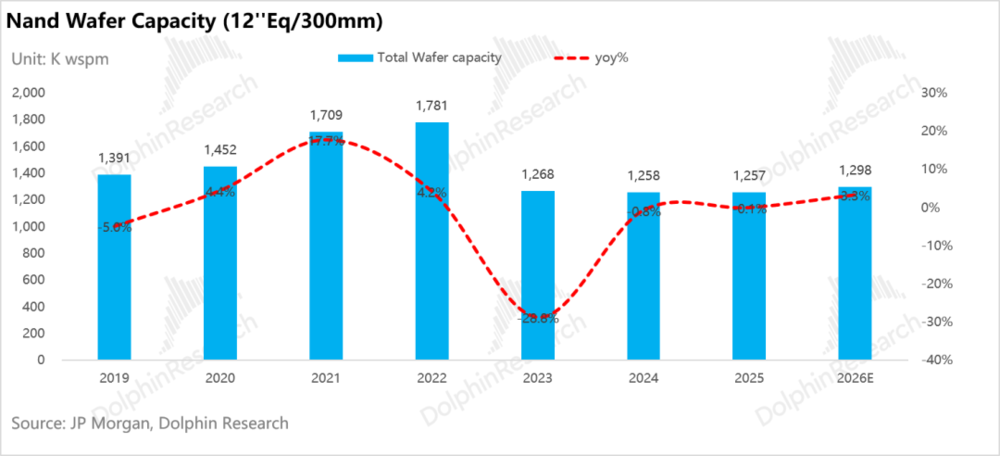
NAND晶圆的投片量上,自2022年178万片/月峰值,2023年单年回落至127万片/月、同比降28.8%;根据闪迪说法,回调期间,行业产能利用率一度跌至约70%、约50万片/月闲置。
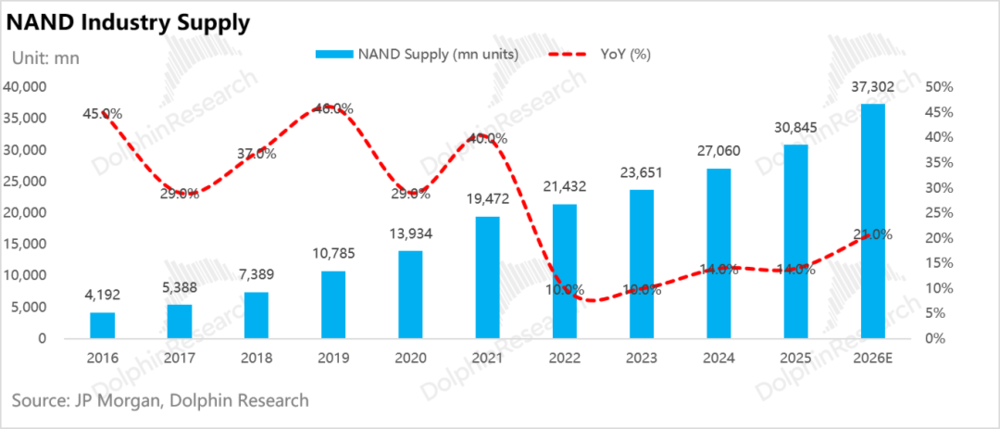
然而如此力度的减产并未换来供给收缩:2023年投片量(wafer)收缩约29%,bit供给却仍增长约10%。2016—2026年间NAND bit供给从未出现过任何一年负增长,即便2023年行业收入−37%、全行业亏损亦然。
NAND晶圆投片量缩减、bit产量增加,方向相逆背后,近40个百分点的落差,全部来自节点迁移的单位晶圆效率提升。而其根源是供给侧的一个固有属性:NAND的技术迭代本身就在持续制造产能过剩。
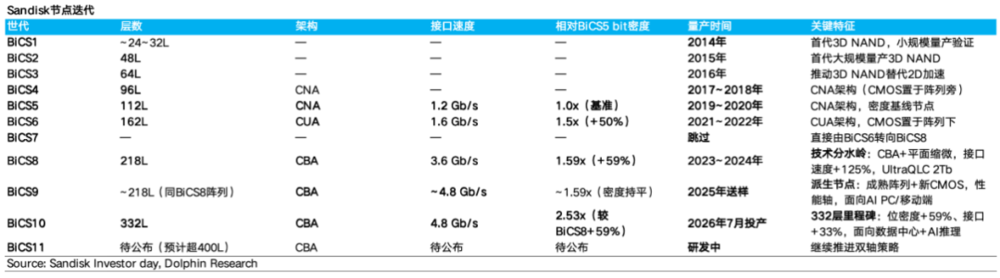
按闪迪披露,从BiCS5到BiCS11的五个节点,单位晶圆bit产出代际平均增幅54%、年化复合约27%,显著高于行业mid-to-high teens的长期需求增速。
换言之,厂商能削减的只是投片量,却无法削减每片晶圆自带的效率提升——这部分供给增长是“自动”的、与减产意愿无关。这正是NAND区别于钢铁、化工、航运的根本:后者可靠停产实现供给绝对收缩,NAND即便在最深低谷供给仍双位数增长。

那么,NAND为何能仅凭节点进步、在不加大资本开支与投片的情况下持续扩张供给?
关键在于厘清“单位晶圆bit产出”由什么驱动,该指标可分解为:
每片晶圆bit产出=存储孔密度×层数×存储阵列面积占比×每单元比特数
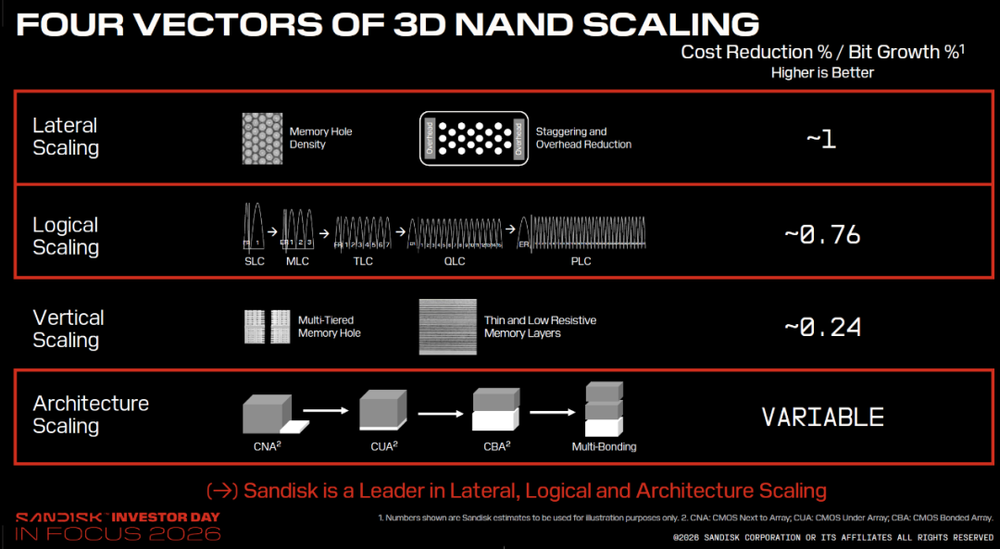
“逻辑缩放”和“架构缩放”基本走过一次就到头了;而“堆层数”和“横向缩小孔密度”才是NAND大厂每年老老实实拼技术、能持续带来单位晶圆bit产出增长的真正动力。
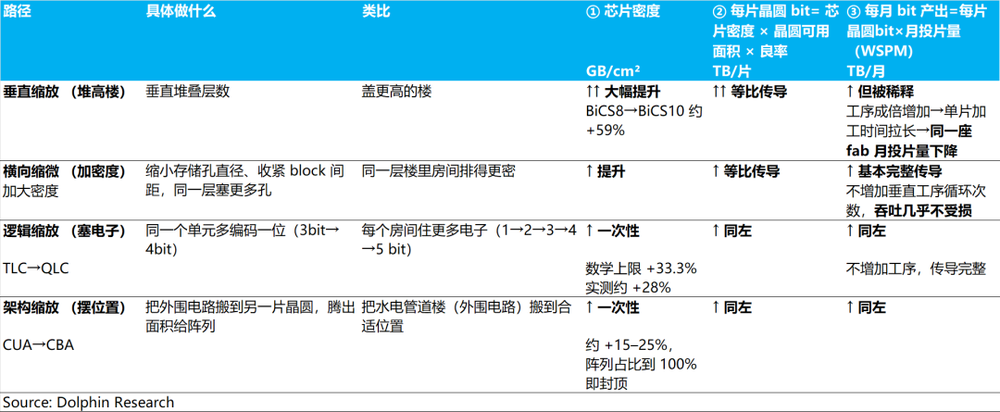
①逻辑缩放(TLC→QLC):一次性台阶,不构成持续增长来源
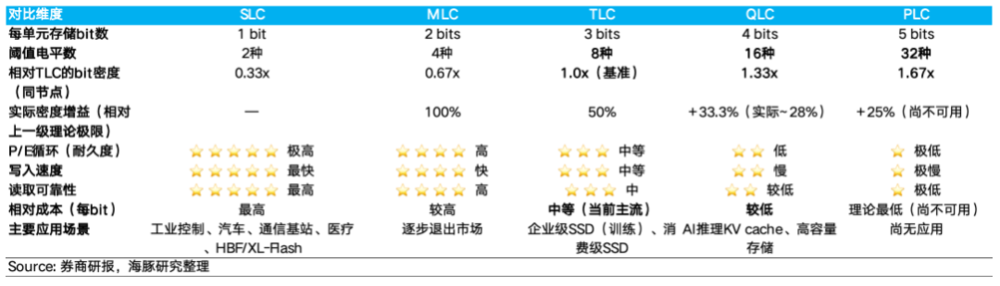
每个存储单元用阈值电压编码信息,从SLC(1 bit)到MLC、TLC(3 bit)、QLC(4 bit)——单元数与面积不变,仅靠多编码一位提升容量。每增加bit会提高存储容量。
代价同样明确:QLC需分辨16个阈值电平(TLC仅8个),噪声容限减半、写入变慢、耐久度约为TLC的三分之一;下一级PLC性能更差,闪迪也未给出时间表。
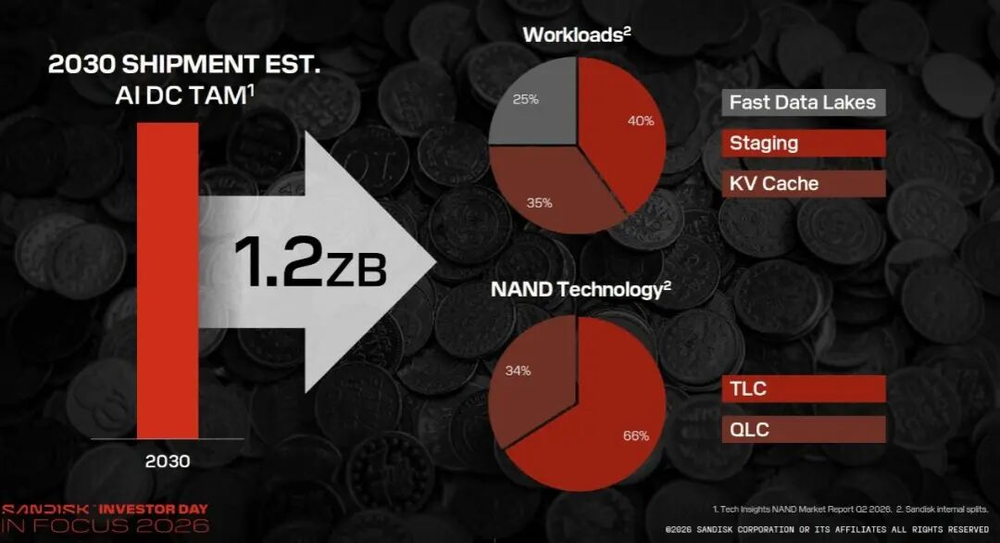
更关键的是这一杠杆结构上无法完整兑现——闪迪将TLC定位于高性能计算型eSSD(承载KV cache中调用频率不是那么高的数据),QLC用于大容量存储型eSSD(KV cache中很少用到的数据)。
闪迪预计2030年AI数据中心闪存TAM达1.2 ZB(相当于2026年全球出货总量),其中TLC占66%、QLC占34%。
换言之,即便最乐观情景下,五年后仍有2/3的bit需求属于TLC;若想在单元层面继续提密度只能等PLC,而PLC目前实用性都有问题。
②存储单元vs逻辑单元的摆放位置优化:同样是一次性收益,但价值不在密度
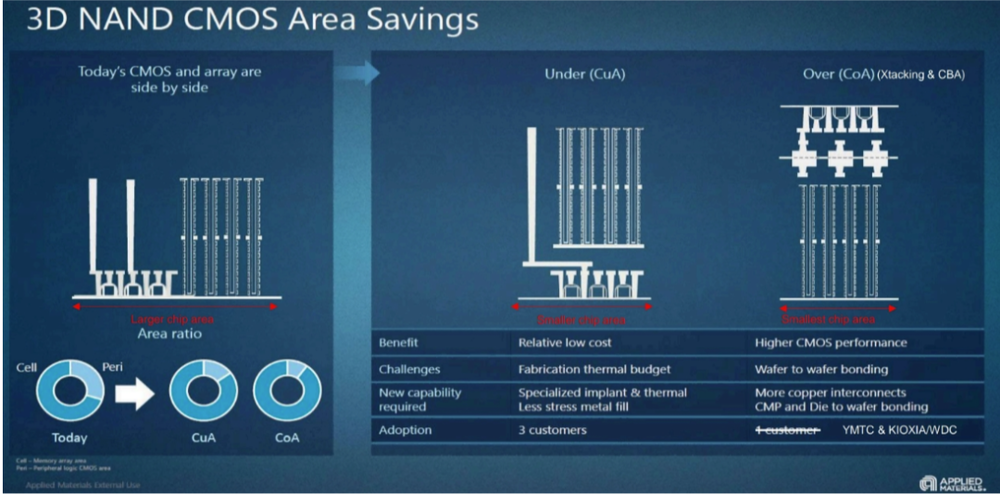
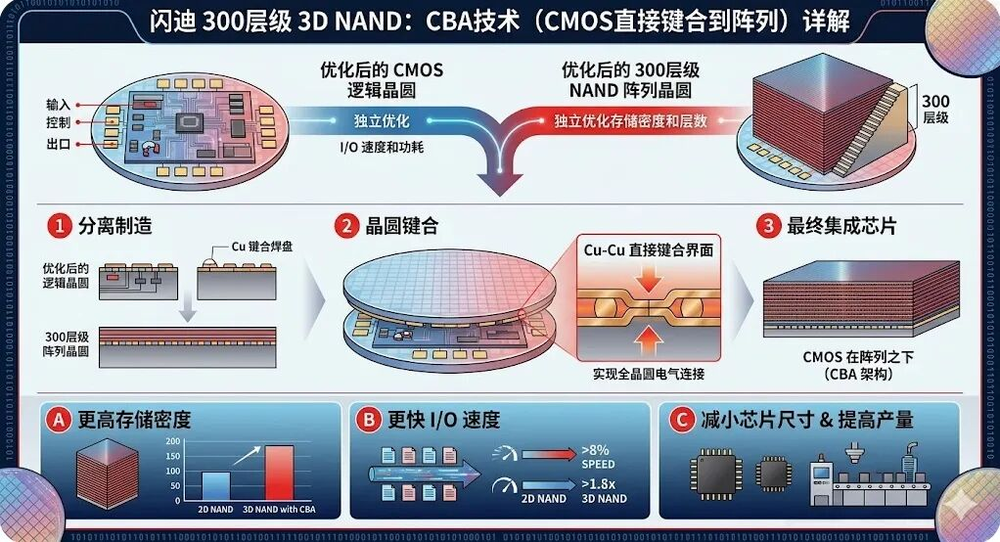
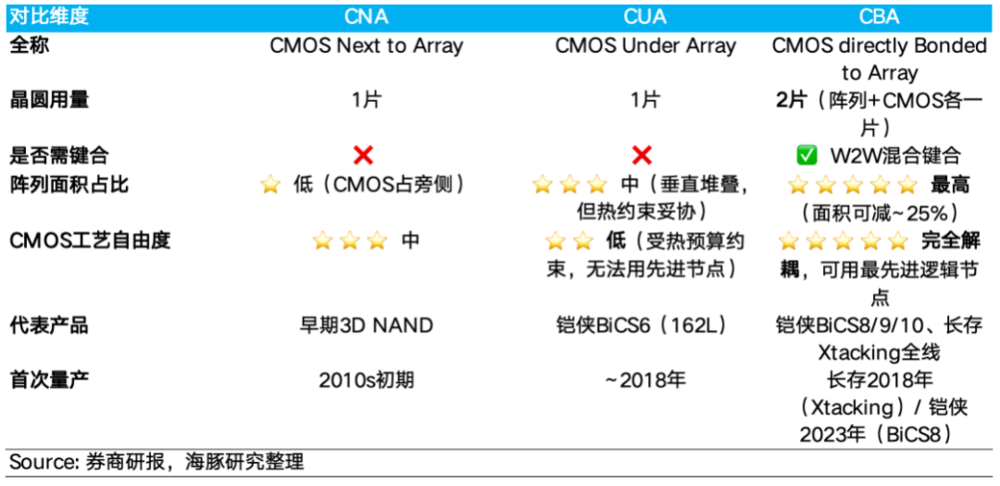
从密度看,CBA(CMOS bonded on Array,逻辑单元与存储单元直接铜铜键合)的本质是“一次性回收闲置空间”:NAND芯片由存储阵列与不存数据的外围逻辑单元(CMOS)组成,架构演进主线就是剥离这块“无效率面积”——从逻辑平行于阵列旁(CNA)、置于下方(CUA),到阵列与逻辑分置于两片晶圆、再经过铜-铜混合键合贴合(CBA)。
但空间回收有绝对上限:若逻辑原占面积20%、阵列占80%,完全移出后阵列占满100%、密度提升25%,此后再无面积可回收。长江存储类似架构曾实现约25%的面积缩减(等效密度+33%)。
但CBA对闪迪的真实价值不在密度,而在于提升性能:
铜铜键合后,逻辑单元和存储单元分别生产,独立处理后,逻辑单元CMOS可用更先进制程(由逻辑芯片代工厂生产),实现更高I/O速度与更低功耗。
产品上,相较BiCS8同规格2Tb QLC,只是把逻辑单元改为更先进制程后,BiCS9写/读带宽提升150%/75%、写/读能效提升85%/40%,且增量资本开支极小。
此外,CBA依托的混合键合与多晶圆堆叠同样是HBF的工艺基础——首代HBF阵列即基于闪迪首个CBA节点BiCS8。
③垂直缩放:没有单一硬性物理上限,但“经济上限”正快速逼近
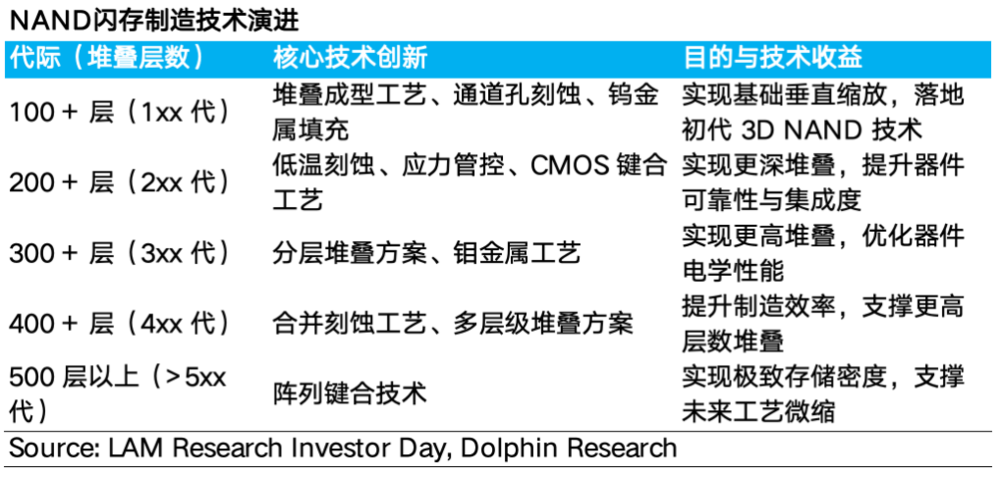
3D垂直堆叠是当前扩容最主流、最直接的路径,厂商已将最大化层数作为核心策略。虽无单一物理上限,但隐性代价与资本支出急剧攀升,受四重刚性制约:
a.产能稀释“陷阱”:层数激增使刻蚀、沉积工序成倍增加,设备固定下单片加工时间拉长、月投片能力下滑。从176层升至300层以上,单片容量虽增50%–60%,但因工序拉长,实际bits产量并没有50-60%这么高的增长;
b.多Deck的“工艺惩罚”:受沟道刻蚀深宽比限制,一次成型最高堆叠120–150层,超过就要做出新的一层(类似双层巴士的Deck),重新走一下刻蚀、接触、填充全套工序;
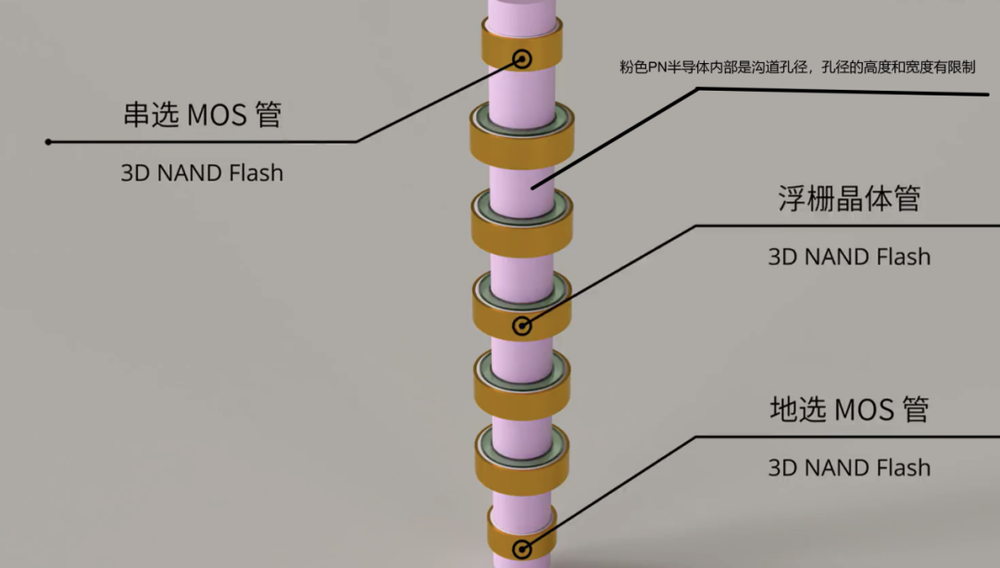
c.材料强制换代:做成两层“巴士”,也就是300层,传统钨丝电线电阻飙升、漏电失效,要转为钼金属,沉积与刻蚀设备投资(每万片月产能)就近乎翻倍;
d.500层以上的“阵列键合”与应力墙:到这个层数后氧化物材料容易变形,在往上走,就要走类似HBM那种硅片与硅片之间的堆叠,复杂骤然拉升。
换言之,500层以上“继续堆层”需要的是需键合能力作前提,而这恰是铠侠/闪迪自BiCS8起率先量产、已积累经验的领域。
④横向缩放:缩小存储孔径、收紧block间距:差异化价值最高的引擎
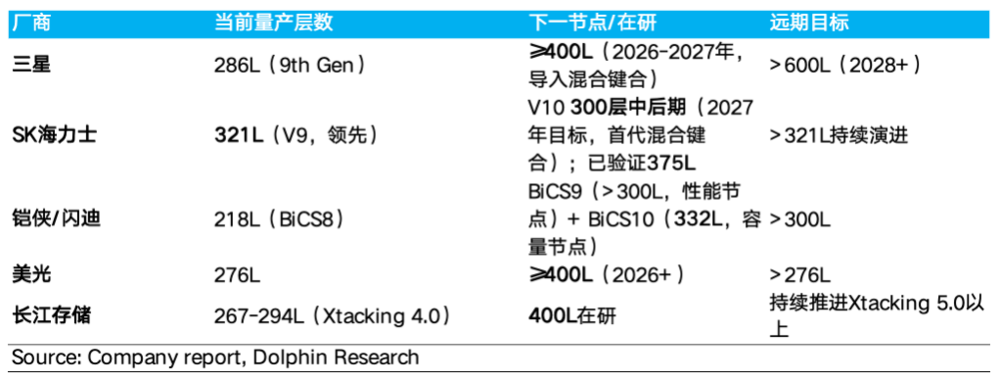
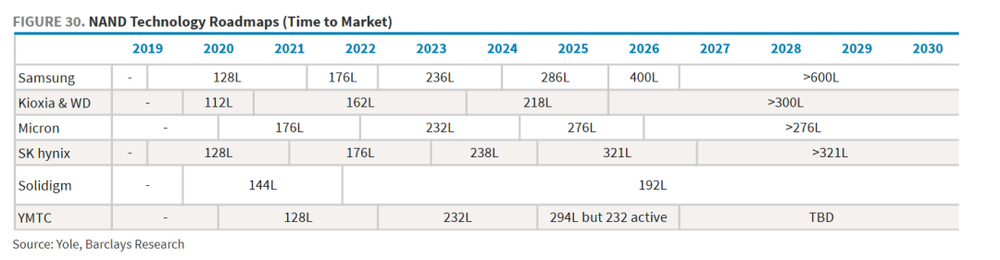
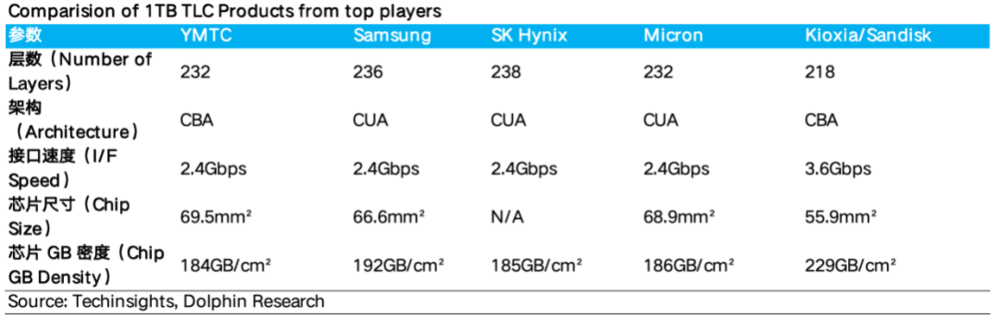
叠层数(如下图,层数加高)是三星和海力士的选择,因为它们在DRAM上积累了不少的经验,而在平面维度上加密存储单元+不同功能单元优化组合结构是铠侠/闪迪的方案。
横向加密的核心是刻蚀上搞事情(如下图,在一个平面上加更多的柱子),结果是铠侠/闪迪以全场最少的218层实现最高的229 GB/cm²密度,每层贡献密度较次优者高29%;芯片面积55.9 mm²也最小、较三星小16%,同片晶圆可多切约19%——层数虽低,密度与性能均未落后。
两种策略的本质差异在资本强度:三星、SK海力士以更多工序与设备换层数领先;铠侠/闪迪以更少层数实现更高密度、消耗更少工序与设备。
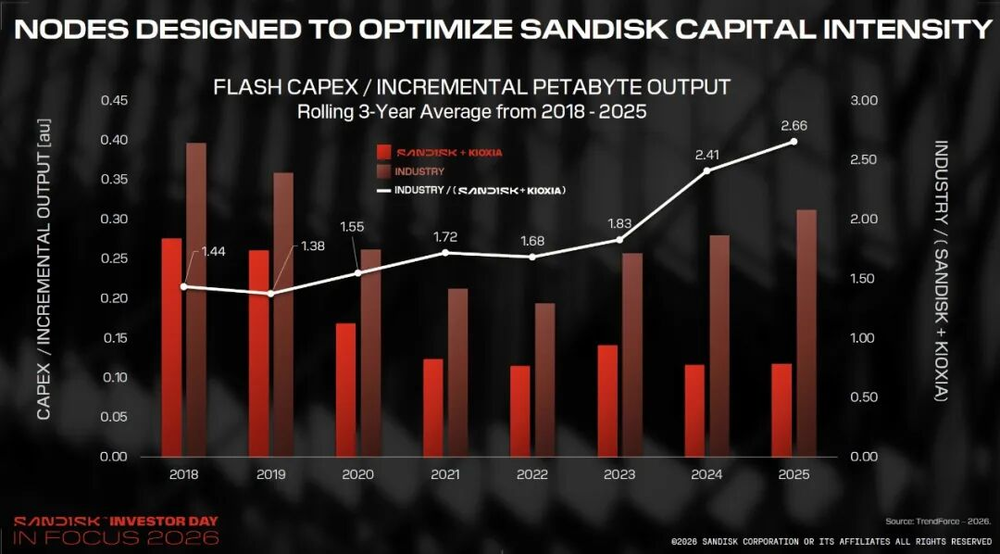
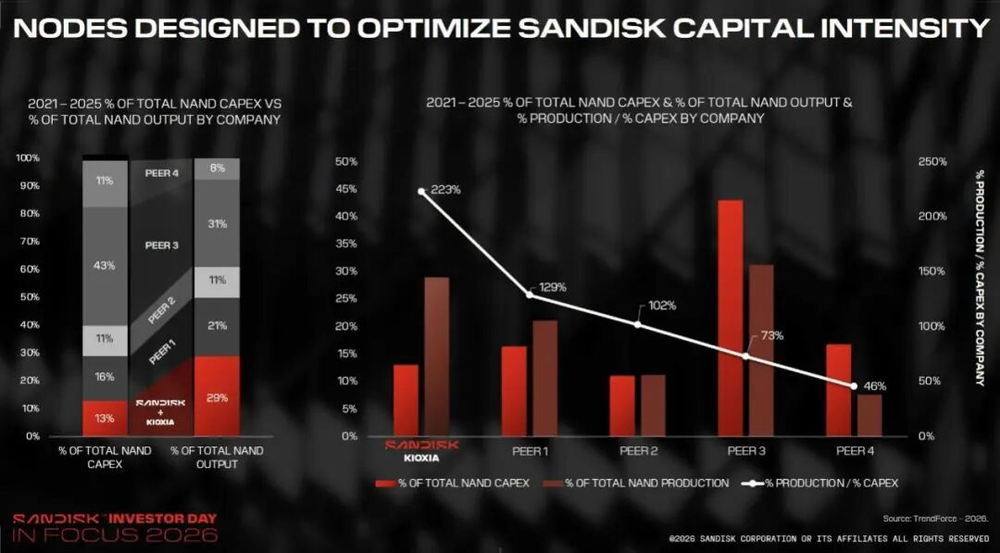
这直接体现在资本效率上:2025年行业平均每增量PB产出所需资本开支为闪迪与铠侠合资体系的2.66倍;2021—2025年双方以13%的行业资本投入产出了29%的行业bit。
3.同为存储基石,NAND与DRAM在供给端到底有何根本不同?
NAND与DRAM的供给扩张遵循两套完全不同的底层逻辑。这一差异并非源于策略,而由物理结构决定,并直接转化为资本强度与周期性的区别。
扩张供给仅两条路径:技术工艺迭代(提升单片bit容量,属存量升级)与增加晶圆投片量(新建洁净室、扩设备,属增量投入);前者资本消耗远低于后者。
而节点迁移的成效取决于存储密度还能多快提升,方向只有两个:
a.纵向——往上堆层,每层都装单元;
b.横向——让每个存储单元占地更小,同层塞进更多。
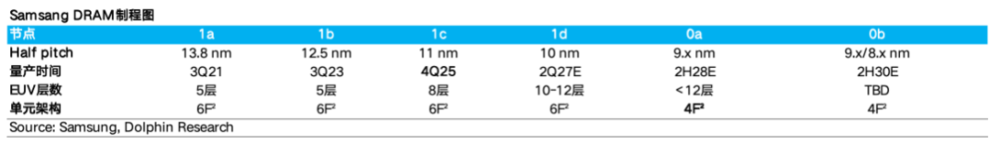
NAND两个方向都能走——既可堆层倍增密度,又可横向缩微;而DDR内存在同一晶圆底座上只剩横向一条路——其一个存储单元内除了一个晶体管,还有一个垂直深孔电容,无法像NAND那样“一次刻穿多层”低成本堆叠。
这决定了迁移的产出上限:DDR内存单代密度仅提升约10%(1b→1c已不足10%),NAND单代仍达50%–60%。故DDR内存仅靠迁移每年单位晶圆bit产出仅增约5%–10%、远不足以覆盖需求,缺口只能靠新建洁净室填补;NAND则相反,迁移本身的产出增量已能满足甚至超过需求。
为什么DRAM无法像NAND一样做垂直堆叠?
3.1.NAND 3D堆叠:靠“批量成型”与“串联共享”实现内生扩容
a.串联共享:NAND单元本质是可导通的晶体管,数百个串联在同一根垂直沟道、共享一条位线;读取某层时只需向非目标层施加导通电压(Pass Voltage)使其等效为导线,电流即可穿透读取目标。
b.批量成型:3D NAND制造类似“一次性浇筑”——先交替沉积数百层氧化物与氮化物,再以极高深宽比干法刻蚀(HAR Etch)一次打通全部叠层、填入沟道材料,数百个单元同步成型。
NAND单元不是“造”出来的、而是“交叉”出来的:每层沉积材料本身即一条字线、像刷墙一样均匀铺开、无需逐层定位器件;真正“创造”单元的动作只有把沟道柱刻穿——刻一次孔、300层同时得到300个单元。
其成本关键在工序结构不对称:层数提升增加的主要是沉积(重复、低成本),而定义沟道孔的光刻与刻蚀(高成本)次数并不随层数增长。
DRAM:受制于二维极限的重资产扩张宿命
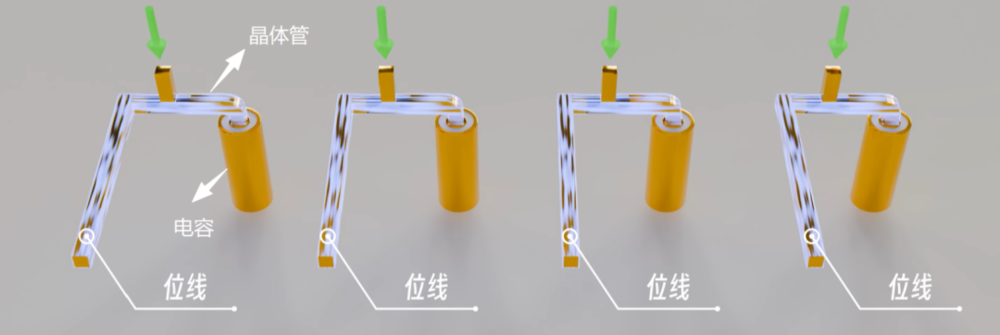
a.物理根因:电容不导通、单元无法串联
DRAM每单元由一个晶体管加一个深孔电容组成(1T1C),无法复制NAND的串联结构,因电容隔断直流电——相当于一道永远打不开的“墙”,串起来时电流连第一道墙都过不去。
NAND承担得起“逐个打开前序单元”的开销,还因它一次搬一大片(整页数KB、整块数MB)、开销被摊薄;而DRAM作为CPU工作内存必须精确取任意地址、延迟数十纳秒,没有摊薄的选项。
因此DRAM纵向无法共享位线——每增一层就需自底部多引一条。
b.HBM进一步放大了产能缺口
当横向微缩带来的单die容量进步放缓,为同时解决带宽与容量瓶颈,HBM应运而生,其本质是在有限封装面积内塞进更多容量与带宽(存储容量=单die容量×层数)。
但NAND与HBM的堆叠截然不同:
NAND是“在一颗芯片共用地基上,盖300-400层楼”——一次工序数百层同时成型,越堆越便宜、不额外占晶圆面积;
HBM是“把盖平房,再把每个平房带地基,一层层摞起来”——每栋单独盖、打孔、对准,越堆越贵,还成倍消耗晶圆产能。
在DRAM技术迁移每年仅提供5%–10%增量的背景下,HBM的兴起使缺口急剧扩大,其对晶圆产能的消耗有三重放大:
a.die更大——TSV硅通孔与复杂I/O电路需设置内存禁放区,减少可用存储面积,同容量下die面积较标准DDR显著增大;
b.多层堆叠消耗多颗die——单颗HBM由8~16层die堆成,需要消耗的die更多(类似盖楼层高需耗更多砖块)
c.综合良率结构性偏低——即便单颗die良率很高,堆叠后因切割和键合损耗和良率等问题,复合良率不对称下降
三者叠加,生产同等bit的HBM所耗晶圆产能约为标准DDR的2–3倍。
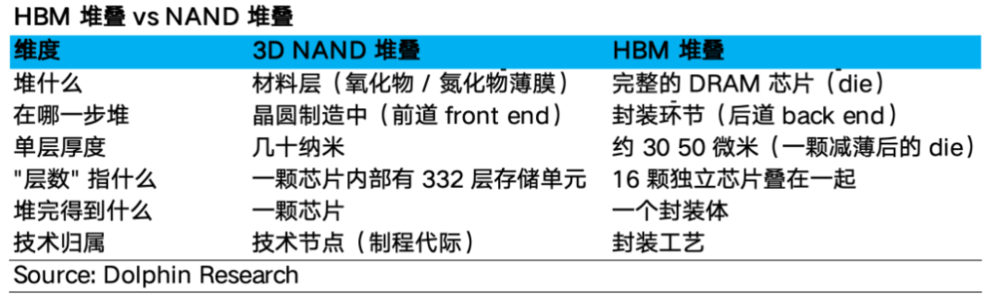
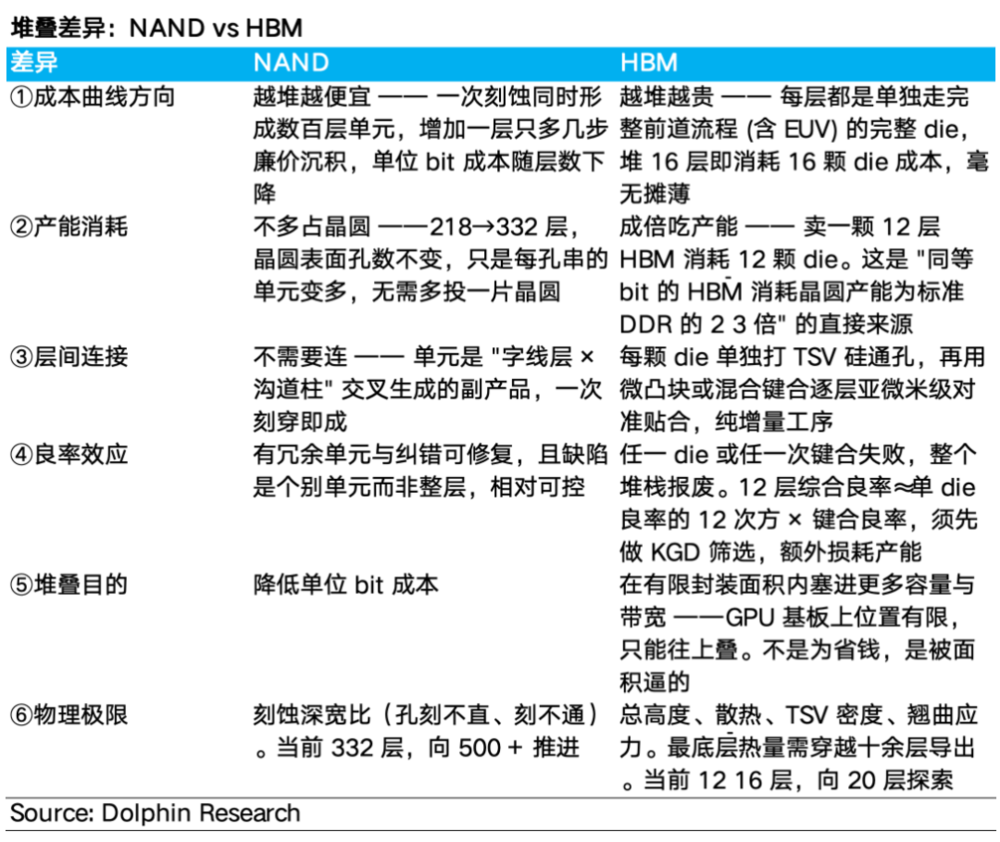
而缺口只能靠新建洁净室填补,这直接解释了2024—2026年DRAM与NAND在产能投资上近乎相反的局面:
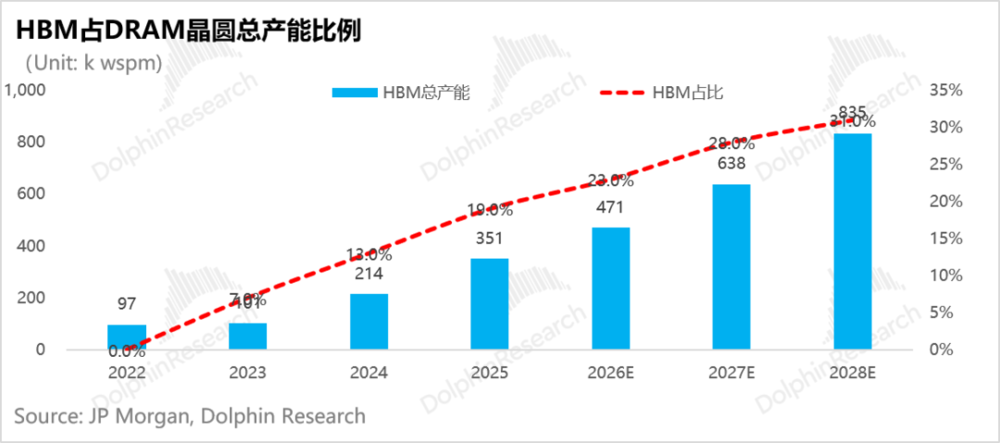
HBM挤占是本轮投资浪潮的核心:HBM占全球DRAM晶圆产能比重从2023年的7%升至2026年的23%,绝对产能由10万片/月扩至47万片/月、三年增逾三倍。
而HBM的产能效率远低于标准DRAM:其die面积约为三倍——一片晶圆可产1,500–1,800颗DDR,却仅产500–600颗HBM die,加之单颗需8~16层die堆叠、逐层消耗产能并叠加良率折损,有效bit产出效率显著更低。HBM每提升一点渗透率,都实质挤压标准DRAM产能。
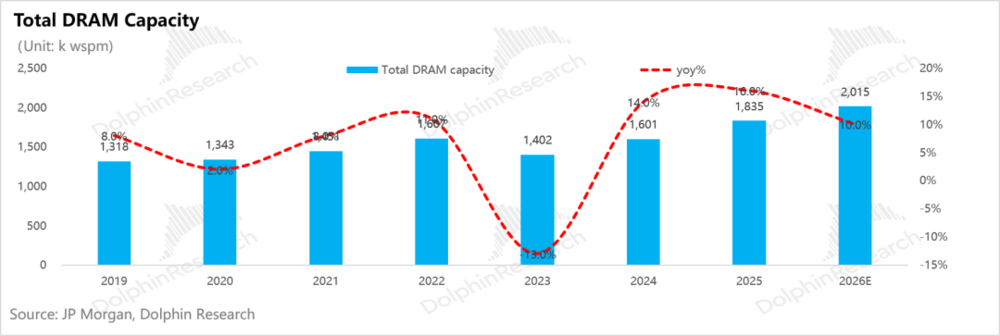
也因此DRAM资本开支持续攀升:由2023年308亿美元升至2026E 998亿美元(单年增速68%);全球DRAM产能在2023年−13%后转入扩张,由140万片/月增至2026E的202万片/月、较2022峰值高25%。
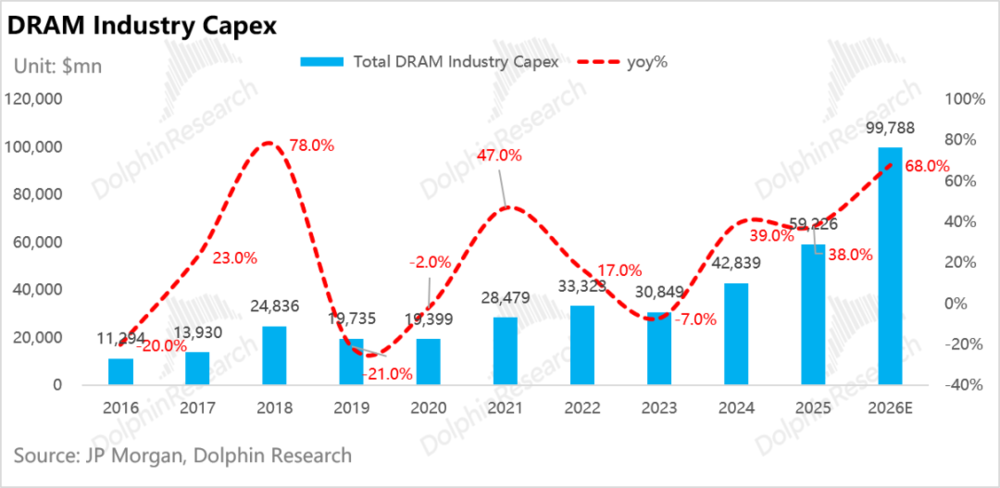
而NAND资本开支虽自2024年197亿谷底回升(2025+21%、2026+29%),2026年的254亿仍较2022年峰值低约18%。
2026年DRAM行业资本开支约998亿美元(三大原厂约877亿),同期NAND仅约254亿——DRAM近乎NAND的4倍。
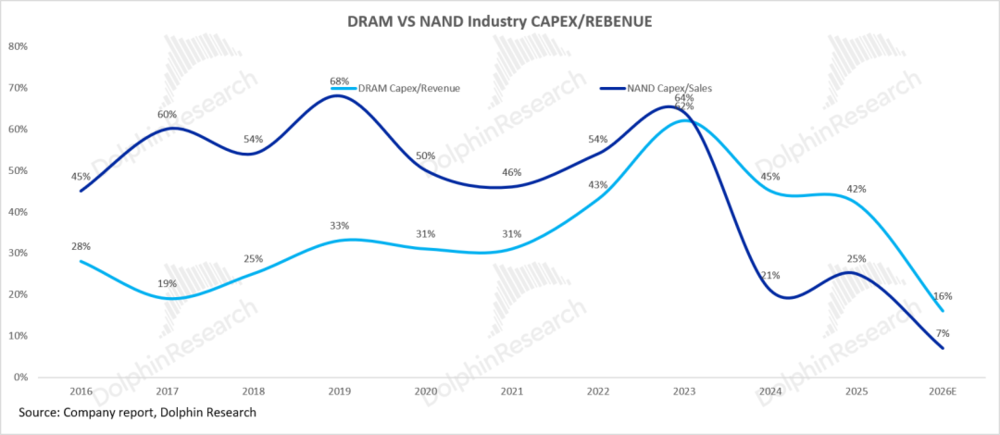
更具可比性的是资本强度:2026年DRAM资本开支/收入为16%、NAND仅7%,持续维持在DRAM一半以下,与闪迪“中低个位数”的长期指引吻合。
这本质是两种供给逻辑在同一周期的镜像:DRAM必须新建工厂才能多产HBM,NAND靠技术迁移即可满足需求增长。
4.DRAM与NAND为何“同源不同命”?
虽同属强周期行业,但底层物理结构的差异,最终在商业模式上造就两者截然不同的宿命:
a.周期方向的不对称:NAND下行更惨烈,DRAM调节更从容
NAND下行更惨烈——迁移“自带”供给增长,哪怕大幅削减CapEx,单片bit产出仍随层数堆叠惯性增加;尤其3D过渡期曾带来一次性跃升,使产能增速一度远超需求。
DRAM下行则相对温和:其迁移增速持续放缓且远低于需求,扩张高度依赖新增洁净室——只要削减CapEx就能在物理层面真实、迅速收紧供给。这使DRAM上行扩产更难,但下行更有抗跌底气。
b.定价权底座的差异:DRAM靠“物理护城河”,NAND靠“行业纪律”
DRAM(尤其HBM)的紧缺源于真实的物理产能限制与极高制造复杂度,厂商定价权极强;HBM依赖的TSV、先进键合形成显著差异化,迫使三大原厂将产能向HBM倾斜、进一步加剧标准DDR紧缺。
反观NAND,当前紧平衡高度依赖寡头之间的“默契”:闪迪主动将行业bit增速目标压制在约15%、而非历史上激进的30%以上。
这意味着行业内部仍蛰伏大量未释放的技术产能,无需巨额新增CapEx即可随时投放,构成上行周期极大的潜在弹性与不确定性。
一旦供应默契松动、或中国厂商加速扩产,NAND供过于求的达摩克利斯之剑随时可能落下。
c.现金流与资本回报的背离:NAND蜕变为“现金牛”
DRAM必须将经营现金流持续重资本再投资(新建一座先进厂投资已超200亿美元),而NAND资本开支主要用于存量产线的节点升级、而非扩产。
以闪迪为例,其长期指引极优:资本开支仅占营收中低个位数、调整后FCF(自由现金流)利润率约50%,且100%超额现金将通过回购返还股东。
尽管SK海力士2026年8月宣布40万亿韩元回购、标志DRAM巨头也在跟进股东回报,但其天然更高的资本强度,注定上超级行周期内现金流比不了轻资产的NAND。
综上,当NAND供给端能“自动”实现bit增长、而三大原厂又将真金白银优先砸向DRAM/HBM使NAND时,NAND供需变化要看:一是供给端其他原厂是否打破默契,转而在NAND上扩产;需求端AI持续拉高NAND的持续性如何?
那么,AI浪潮下,其他厂在NAND上是否真默契不扩产?下游需求带来怎样的结构性重塑?这波涨价超级行情还能飞多久?站在当前估值节点,涅槃后的闪迪是否仍有向上空间?
这些问题,海豚君将在下篇报告中一一拆解,敬请期待。