
毛小花 3小时前 · 2026-09-19 11:15:39 · 3 阅读
学习笔记(AI大模型)
——人生的不期而遇寥寥无几,而我和AI的缘分大抵是其中之一我从2017年开始研究机器学习、深度学习、计算机视觉、卷积神经网络,但到2021年被调到其他岗位,本以为脱离了“苦海”,没想到2024年又让我牵头负责数字化转型,到了2025年开始转战数智产业,而今我被安排负责数智化转型。巧不巧,兜兜转转又不期而遇了,就像曾经喝过的恋爱鸡汤:“是你的终究是你的”。这段时间以来,大模型三个字高频出现,虽然有些大致的了解,但深度不够,所以抽出时间再研究一下,做个记录。
三、什么是大模型呢?按照专业说法,所谓“大模型”是基于Transformer架构的神经网络模型。本质上,大模型是一个“预测器”,给它输入,由它预测输出。例如,你输入给它“太舒服了,今天天气真...”,那么它根据你所输入的信息,预测输出接下来的内容“真好”“真棒”“真给力”。当然,你的输入可以是多模态的,也就是说你的输入可以是语言、文字、图片、视频等等多种模式、多种形态的信息,它的输出也可以是多模态的——这就是多模态大模型。这个预测的能力听起来,好像比较简单但是要让计算机做到这一步,真是太不容易了,为此科学家们探索了几十年。
二、自然语言处理的三个阶段第一个阶段:N-gram时代,2010年以前。以符号推理和专家系统为主,主要依赖人工编写的规则。在自然语言处理(NLP)领域,则使用统计语言模型(SLM),如N-gram,它基于马尔可夫假设(预测下一个词时,不需要看整句话,只看前 N-1 个词就够了)预测下一个词,但序列变长时性能会急剧下降。N-gram可以通俗理解为:一种“看前几个词,猜下一个词”的统计接龙法。你说“今天”,它猜“天气”;你说“今天天气”,它猜“不错”。那为什么会猜“天气”呢,是因为给它的训练数据中,“今天”+“天气”的次数出现得最多。第二个阶段:RNN时代(2010年-2020年)。神经网络模型如RNN/LSTM的出现,能更好地处理序列数据并聚合上下文信息。但是RNN是按时间递归,像接力传话,必须一步步来,尤其是在训练时必须按时间步展开,第t步依赖第 t-1步,无法并行,长序列训练极慢。在这个阶段,RNN主要用来处理文本对话任务,而CNN(我所主要研究的内容)主要用来处理图像视觉任务。第三个阶段:Transformer时代(2017年至今)。2017年,Google发表《Attention Is All You Need》,提出了Transformer架构。它摒弃了RNN的循环结构,完全基于自注意力机制,能够并行处理整个序列,彻底解决了长距离依赖问题,成为现代大模型的基石。Transformer核心在于自注意力机制(Self-Attention)。自注意力机制核心在于:让每个词都“看看”其他词。传统文本处理像一条“流水线”,一个词接一个词顺序处理,每个词只能看到附近的词(第一阶段N-gram,第二阶段的RNN,都是如此)。但实际对话中,很多语义是跨距离传递的。例如“开心极了我今天,因为考试成绩很好”,“高兴”和“成绩”之间隔了好几个词,意思却紧密相连。自注意力的核心思想:处理每个词时,都让它去“看看”句子里的其他所有词。就像开会一样,轮到你发言时,不能只听隔壁同事说话,而要环顾会议室,听听所有人说了什么,综合所有人的发言,做出最好的回应。自注意力做的就是这件事:让每个“词”都参加“全体会议”,了解上下文的整体信息。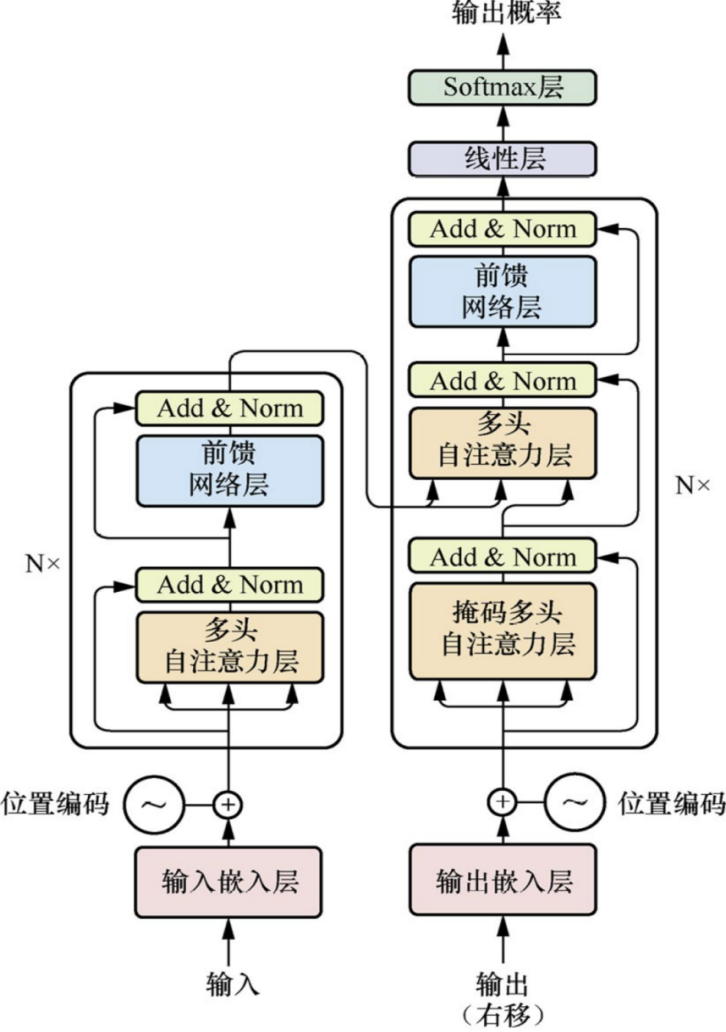 Transformer基本网络架构
三、Transformer的优势和局限一是并行计算。传统模型像流水作业,必须挨着一个词一个词处理。自注意力中所有词计算互不依赖,可以同时开工,极大提升训练速度。二是超距连接。传统模型中句子两端的词要“传话”需经过层层中间节点,信息容易衰减。自注意力让任何两个词直接“对话”,一步建立连接。三是可解释性。注意力权重可以可视化——你能直接看到模型在关注什么,相当于装了“注意力显微镜”,让神经网络模型具备了一定的可解释性。局限也很明显:计算量大。每个词都要和句子中所有词算一遍关系,复杂度是 O(n²)。句子越长,计算量平方级增长。因此,现在大家对算力资源需求几何增长。
五年多没有看网络结构了,有种功力散尽、修为尽失的感觉。打开曾经的网站,还能看到自己的简介,真是怀念以前在实验室折腾的时光。后面有时间,还要深度学习一下Transformer网络架构的细节内容。
三、什么是大模型呢?按照专业说法,所谓“大模型”是基于Transformer架构的神经网络模型。本质上,大模型是一个“预测器”,给它输入,由它预测输出。例如,你输入给它“太舒服了,今天天气真...”,那么它根据你所输入的信息,预测输出接下来的内容“真好”“真棒”“真给力”。当然,你的输入可以是多模态的,也就是说你的输入可以是语言、文字、图片、视频等等多种模式、多种形态的信息,它的输出也可以是多模态的——这就是多模态大模型。这个预测的能力听起来,好像比较简单但是要让计算机做到这一步,真是太不容易了,为此科学家们探索了几十年。
二、自然语言处理的三个阶段第一个阶段:N-gram时代,2010年以前。以符号推理和专家系统为主,主要依赖人工编写的规则。在自然语言处理(NLP)领域,则使用统计语言模型(SLM),如N-gram,它基于马尔可夫假设(预测下一个词时,不需要看整句话,只看前 N-1 个词就够了)预测下一个词,但序列变长时性能会急剧下降。N-gram可以通俗理解为:一种“看前几个词,猜下一个词”的统计接龙法。你说“今天”,它猜“天气”;你说“今天天气”,它猜“不错”。那为什么会猜“天气”呢,是因为给它的训练数据中,“今天”+“天气”的次数出现得最多。第二个阶段:RNN时代(2010年-2020年)。神经网络模型如RNN/LSTM的出现,能更好地处理序列数据并聚合上下文信息。但是RNN是按时间递归,像接力传话,必须一步步来,尤其是在训练时必须按时间步展开,第t步依赖第 t-1步,无法并行,长序列训练极慢。在这个阶段,RNN主要用来处理文本对话任务,而CNN(我所主要研究的内容)主要用来处理图像视觉任务。第三个阶段:Transformer时代(2017年至今)。2017年,Google发表《Attention Is All You Need》,提出了Transformer架构。它摒弃了RNN的循环结构,完全基于自注意力机制,能够并行处理整个序列,彻底解决了长距离依赖问题,成为现代大模型的基石。Transformer核心在于自注意力机制(Self-Attention)。自注意力机制核心在于:让每个词都“看看”其他词。传统文本处理像一条“流水线”,一个词接一个词顺序处理,每个词只能看到附近的词(第一阶段N-gram,第二阶段的RNN,都是如此)。但实际对话中,很多语义是跨距离传递的。例如“开心极了我今天,因为考试成绩很好”,“高兴”和“成绩”之间隔了好几个词,意思却紧密相连。自注意力的核心思想:处理每个词时,都让它去“看看”句子里的其他所有词。就像开会一样,轮到你发言时,不能只听隔壁同事说话,而要环顾会议室,听听所有人说了什么,综合所有人的发言,做出最好的回应。自注意力做的就是这件事:让每个“词”都参加“全体会议”,了解上下文的整体信息。
Transformer基本网络架构三、Transformer的优势和局限一是并行计算。传统模型像流水作业,必须挨着一个词一个词处理。自注意力中所有词计算互不依赖,可以同时开工,极大提升训练速度。二是超距连接。传统模型中句子两端的词要“传话”需经过层层中间节点,信息容易衰减。自注意力让任何两个词直接“对话”,一步建立连接。三是可解释性。注意力权重可以可视化——你能直接看到模型在关注什么,相当于装了“注意力显微镜”,让神经网络模型具备了一定的可解释性。局限也很明显:计算量大。每个词都要和句子中所有词算一遍关系,复杂度是 O(n²)。句子越长,计算量平方级增长。因此,现在大家对算力资源需求几何增长。
五年多没有看网络结构了,有种功力散尽、修为尽失的感觉。打开曾经的网站,还能看到自己的简介,真是怀念以前在实验室折腾的时光。后面有时间,还要深度学习一下Transformer网络架构的细节内容。
原始来源: 毛小花