
如何将 RECIST 线转化为 3D 肿瘤分割掩码
放射科医生可以通过在 CT 扫描上画一条穿过肿瘤的直线来标注肿瘤。而要生成完整的 3D 分割,则需要在肿瘤出现的每个切片上都进行勾画,这要耗时得多。
本教程介绍 Lumina 的工作原理。它是一个只需 CT 扫描加一条 RECIST 线,就能生成所标注肿瘤的 3D 分割掩码的系统。
Lumina 是为 FLARE 2026 泛癌症分割挑战赛 开发的。该系统的设计要求是:在 CPU 上运行,内存限制 8 GB,推理时间限制 60 秒。
本教程将涵盖塑造最终系统的关键设计决策、实现细节和实验。
我们将涵盖的内容:
-
- ...
准备 CT 扫描和 RECIST 标记。
将 RECIST 线编码为额外的网络输入。
将图像裁剪并重采样到统一网格。
用 3D 分割网络预测肿瘤概率图。
优化概率图并将其转换为二值掩膜。
控制 CPU 推理,确保整个案例在运行时间和内存限制内完成。
Python
NumPy
PyTorch
基础卷积神经网络。
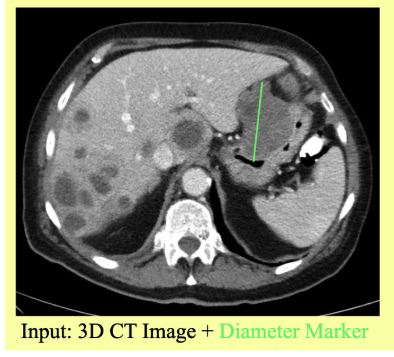
体素是像素的三维对应物。在 CT 扫描中,每个体素代表一小块组织体积。
RECIST 标注线告诉模型需要分割哪个肿瘤,随后模型预测该肿瘤的三维范围。
这使得分割任务更具针对性,因为模型无需识别扫描中所有可能的肿瘤。
Lumina 流程概览
完整流程包含多个阶段。我们从一幅 3D CT 扫描和一条标记特定肿瘤的 RECIST 线开始,然后将该线转换为额外的输入通道,对图像进行裁剪和重采样,最后将三个通道送入 3D 分割网络。
网络输出概率图,经重采样、阈值处理和连通域筛选后,得到最终的 3D 肿瘤掩膜。
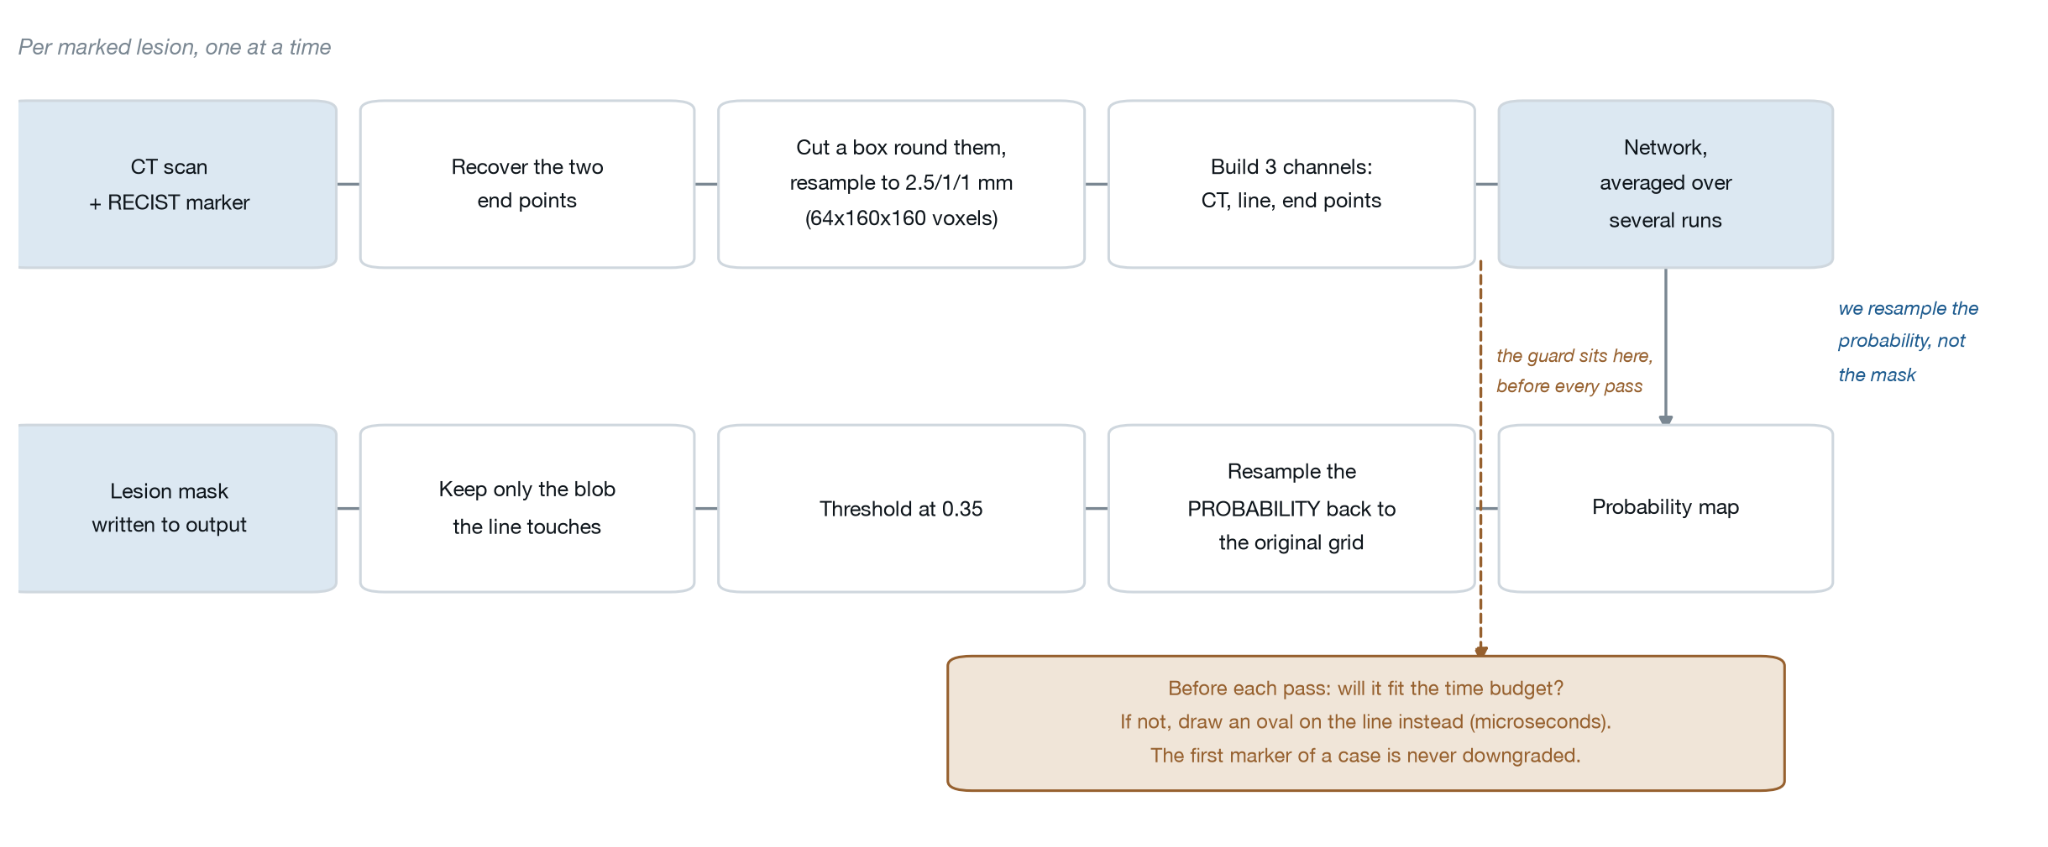
主要阶段包括:
前置知识
如果你熟悉以下内容,会更容易理解本教程:
无需深入的医学背景知识,教程会在介绍相关概念时解释医学成像原理。
实现基于 NumPy、SciPy、PyTorch 和 MONAI(一个基于 PyTorch 的医学影像框架)。
第 1 步:编码前检查数据
我们的数据以
.npz文件形式提供,这是 NumPy 的压缩数组格式。每个文件包含如下字段:
imgs       # CT 扫描,一个 3D 数组
recist     # 标记线,形状相同,每个肿瘤对应一个整数
spacing    # 体素之间的间距(毫米)
origin     # 扫描在扫描仪坐标系中的位置
direction  # 扫描的旋转方式
gts        # 真值分割标注(仅训练文件有)
在搭建模型之前,我们先检查了图像数值、数组形状和空间元数据。
其中有两个细节尤为重要。
扫描图像已经做过亮度调整
CT 扫描仪通常以 Hounsfield 单位(HU)存储图像。水约为 0 HU,骨骼则可超过 1000 HU。
而在本数据集中,扫描图像已被转换到固定的 0–255 范围,原始的 HU 值并不可得。
这意味着我们无法对原始值做常规的 CT 窗宽窗位处理,只能改为测量所提供数据的强度分布。
比如,有 53.4% 的体素值恰好为 0,对应身体外的空气。
坐标顺序很关键
spacing数组按(X, Y, Z)存储,而 NumPy 数组的索引顺序是(Z, Y, X)。如果混用这两种约定,空间测量就可能出错。
我们在输入边界处做了一次坐标转换,内部统一使用
(Z, Y, X)约定:def _to_zyx(vec3, order): vec3 = np.asarray(vec3, dtype=float).ravel() if order == "xyz": return vec3[::-1].copy() # (x, y, z) -> (z, y, x) if order == "zyx": return vec3.copy() raise ValueError(f"unknown geometry_order {order!r}")这里的重要经验是:在设计预处理流程之前,先多检查几个文件。
检查内容包括:
数组形状
强度范围
体素间距
坐标约定
元数据
可用的标注
不要想当然地认为数据会遵循其他 CT 数据集或教程中的约定。
第 2 步:把 RECIST 线转换为网络输入
神经网络接收的是一组输入通道,CT 扫描提供第一个通道,接下来我们要把 RECIST 线表示成网络可用的形式。
我们使用了三个通道:
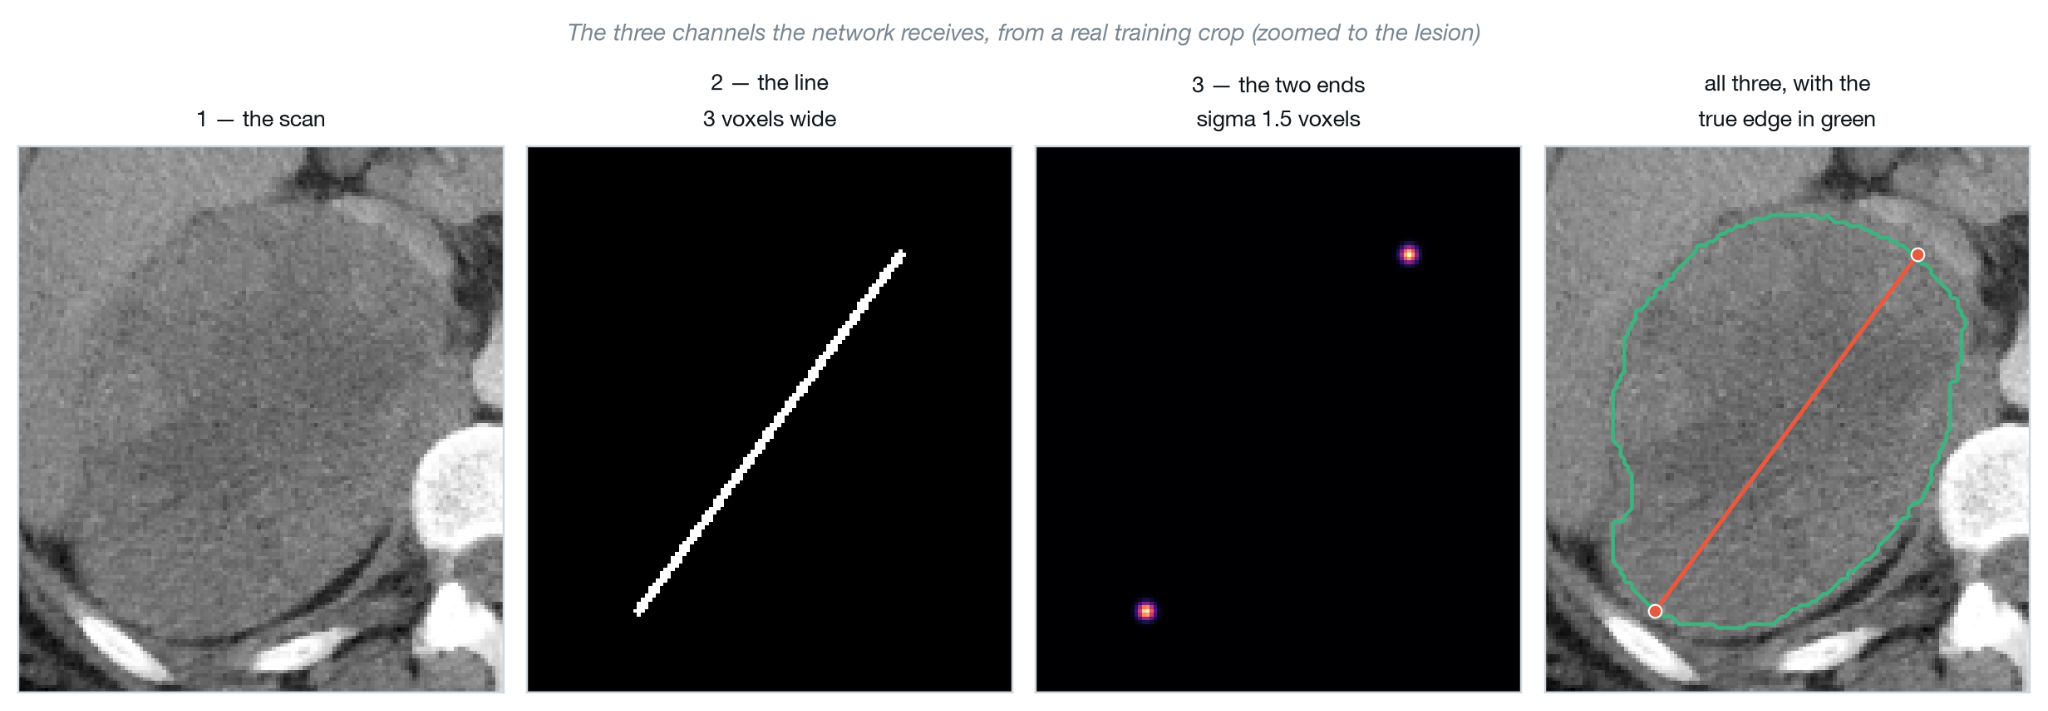
CT 扫描图像
RECIST 测量线,线宽为 3 体素
端点热图,每个端点周围叠加高斯分布
两个端点定义了测量直径的长度,并为网络提供了 RECIST 测量的位置和尺寸信息。
端点信息通过高斯函数表示。每个高斯分布在端点附近取值较高,并随距离增加逐渐衰减。
def _endpoint_heatmap(endpoints_zyx, shape, sigma):
    d, h, w = (int(s) for s in shape)
    heat = np.zeros((d, h, w), dtype=np.float32)

    rad = max(1, int(np.ceil(3 * sigma)))
    two_s2 = 2.0 * sigma * sigma

    for z0, y0, x0 in np.asarray(endpoints_zyx, float):
        zc, yc, xc = int(round(z0)), int(round(y0)), int(round(x0)))

        zl, zr = max(0, zc - rad), min(d, zc + rad + 1)
        yl, yr = max(0, yc - rad), min(h, yc + rad + 1)
        xl, xr = max(0, xc - rad), min(w, xc + rad + 1)

        zz, yy, xx = np.mgrid[
            zl:zr, yl:yr, xl:xr
        ].astype(np.float32)

        g = np.exp(
            -((zz-z0)**2 + (yy-y0)**2 + (xx-x0)**2) / two_s2
        )

        np.maximum(
            heat[zl:zr, yl:yr, xl:xr],
            g,
            out=heat[zl:zr, yl:yr, xl:xr]
        )

    return heat
高斯值仅在每个端点周围的小区域内计算。
当
sigma = 1.5时,距离端点几个体素后数值已接近零。若在整个体数据上计算高斯分布,会造成不必要的计算开销。以所需分辨率绘制测量线
同时,根据网络所需的分辨率,从两个端点重新绘制 RECIST 测量线。
我们不先在一种分辨率下生成线条,再随图像一起缩放。因为缩放细线可能导致线条变细甚至断裂。从端点重新绘制可确保提示信息与图像分辨率保持一致。
步骤 3:将所有肿瘤对齐到统一网格
CT 扫描的体素间距可能各不相同。
例如,同一扫描序列中的切片厚度可能不同,不同扫描之间切片厚度差异也可能很大。因此,相同数量的体素所代表的物理尺寸在不同扫描中会有所差异。
对于每一个标记的肿瘤,我们会生成一个固定大小的裁剪区域,并将其重采样至固定的体素间隔。
我们的配置如下:
target_spacing: [2.5, 1.0, 1.0]     # 每个体素的毫米数:z, y, x
crop_size:      [64, 160, 160]      # 体素数量:z, y, x
面内尺寸对应的物理视野范围为:
160 × 160 mm因此,网络接收到的输入是保持一致的
64 × 160 × 160。我们使用源自训练数据的目标间隔。2.5 mm 的切片间隔接近于训练集中切片间隔的中位数。
我们使用 160 mm 的裁剪尺寸,这是基于训练数据中病灶大小的分布确定的。该尺寸覆盖了病灶尺寸的 99 分位数。
强度归一化
我们还使用从训练裁剪区域计算出的统计数据,对 CT 强度值进行归一化:
intensity_mean: 96.88
intensity_std: 79.00
归一化公式为:
image = (image - 96.88) / 79.00这些统计数据仅使用训练数据计算。
验证集和测试集使用相同的数值。我们不会从验证集或测试集重新计算这些统计数据,因为这会导致那些数据集中的信息影响预处理过程。
对于 Lumina,训练数据的统计均值
96.88,标准差79.00。我们将这些值存储在配置文件中,并在训练、验证和推理阶段使用相同的预处理。步骤 4:构建 3D 分割网络
这里,我们将使用 MONAI 中的 DynUNet。
DynUNet 是一种基于 nnU-Net 思想的 3D U-Net 架构,支持可配置的网络深度、卷积核、步长和残差连接。
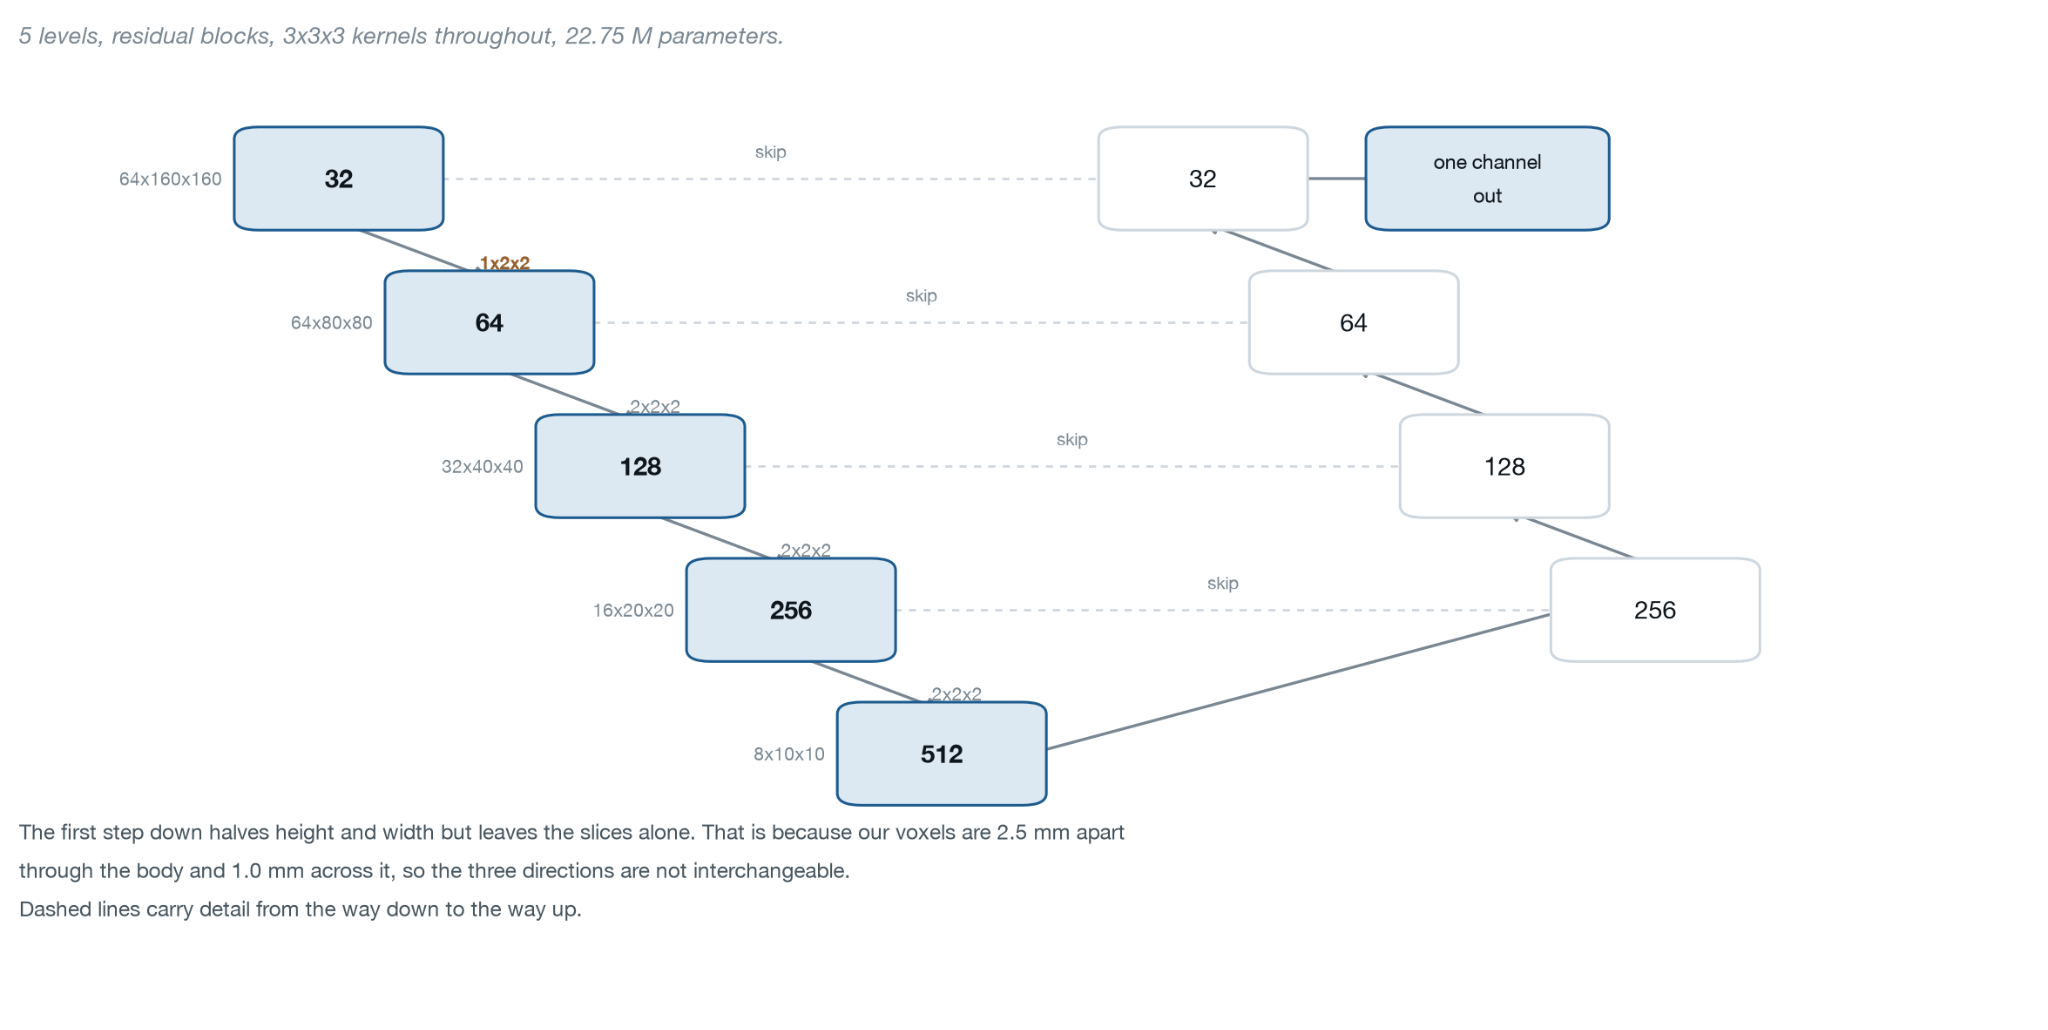
U-Net 主要有两个部分。
编码器逐渐降低空间分辨率,同时学习越来越高层的特征。
解码器随后恢复空间分辨率,生成分割图。
跳跃连接把编码器的精细空间细节传递给解码器,帮助它在生成最终分割时恢复肿瘤边界。
Lumina 的网络接收三个通道:
CT
RECIST 线
端点热图。
模型配置如下:
from monai.networks.nets import DynUNet # 5 levels; the first downsample skips z (see below). kernels = [[3, 3, 3]] * 5 strides = [[1, 1, 1], [1, 2, 2], [2, 2, 2], [2, 2, 2], [2, 2, 2]] model = DynUNet( spatial_dims=3, in_channels=3, # CT + line + endpoint blobs out_channels=1, # one probability per voxel kernel_size=kernels, strides=strides, upsample_kernel_size=strides[1:], filters=features, res_block=True, )strides列表是配置中的关键部分。我们的体素各向异性:层间距为 2.5 mm,而层内间距只有 1.0 mm。如果在每一级都对三个维度同时下采样,层间细节会丢失得太快。因此我们在第一次下采样时保持 z 维不变,这样能在三个方向上都保留有用信息。Lumina 的主要设计工作集中在输入表示、预处理、训练策略、后处理以及 CPU 推理行为上。
第 5 步:使用包含边界信息的损失函数
训练时,网络需要一种方式来衡量预测结果与真实分割之间的差异,这个衡量指标就是损失函数,网络通过调整权重来降低损失。
Lumina 组合了两种常见的损失:Dice 损失和二元交叉熵(BCE)。
Dice 损失
Dice 损失关注预测肿瘤区域与真实区域之间的重叠程度。
当我们希望预测区域的整体大小和形状与参考分割一致时,它非常有用。
二元交叉熵
二元交叉熵在体素级别工作。对每个体素,网络会预测一个 0 到 1 之间的概率。
真实值的定义为:
体素属于肿瘤时为 1
若体素属于背景,则为 0。
当网络预测概率与真实值存在差异时,BCE 会对网络施加惩罚。
例如,若某肿瘤体素的预测概率接近
1,惩罚力度较小;若网络确信该肿瘤体素为背景,惩罚力度则较大。我们将两种损失相加进行组合:
loss = dice_loss + bce_loss这两项提供不同的训练信号:
Dice 损失:鼓励良好的区域整体重叠度。
BCE:鼓励单个体素预测的准确性。
引入边界信息
Dice 和 BCE 对病灶边界未给予特殊处理。
这很关键,因为分割结果可能具有较好的整体重叠度,但边界仍不准确。
Lumina 通过以下两项指标进行评估:
Dice,衡量区域重叠度
NSD(归一化表面 Dice),衡量指定距离内的表面一致性
官方挑战赛的容差为 1 mm。
为向网络提供额外的边界信息,我们引入了边界带损失项。
通过对目标掩膜进行膨胀和侵蚀操作,我们在真实表面周围创建一个薄带区域:
shell = dilate(target) & ~erode(target)

loss = (
    dice_loss
    + bce_loss
    + 0.5 * bce_loss_on(shell)
)
因此,这三项损失各自承担不同的角色:
Dice 损失:整体区域重叠度
BCE:体素级预测准确度
边界带损失:对病灶表面附近体素的额外关注。
额外的边界项权重设为 0.5。
比较不同边界损失
MONAI 还提供了基于距离变换公式的
HausdorffDTLoss。我们可以比较不同方法在训练过程中的计算成本:
损失函数 每步耗时 Dice + 交叉熵 7 ms 本文方法(边界带) 203 ms MONAI HausdorffDTLoss 957 ms Hausdorff 距离损失的高效实现依赖
cupy库,但该库无法在我们的训练环境中构建。其 CPU 版本的计算开销则大得多。我们的边界带方法基于最大池化的形态学运算,计算成本更低。
引入边界项后,大肿瘤的 Dice 系数提升了
0.0136。在小肿瘤上,结果好坏参半:15 个病例改善,13 个病例恶化。第 6 步:将概率图转换为分割掩膜
分割网络输出一个概率图。图中每个体素包含一个 0 到 1 之间的值,表示该体素属于肿瘤的概率。接下来,我们将把这个概率图转换为最终的 3D 分割掩膜,分三步进行:
将概率图重采样回原始 CT 网格。
应用阈值生成二值掩膜。
保留与 RECIST 连线关联的连通区域。
重采样概率图
预处理阶段,我们将 CT 图像裁剪并重采样至
64 × 160 × 160的固定体素尺寸。因此,网络是在这个处理后的网格上生成预测结果的。在生成最终掩膜前,需将概率图重采样回原始 CT 图像的网格。
prob_original = resample_to_original_grid(
    probability_map,
    original_image
)
我们在阈值化之前执行此操作,以便在原始网格上对概率值进行插值。这样能更准确地表示最终边界。
应用阈值
网络为每个体素输出
0到1之间的概率值。我们使用0.35的阈值将概率图转换为二值分割掩膜。mask = prob_original >= 0.35概率大于等于
0.35的体素被视为预测肿瘤的一部分,其余体素则作为背景。0.35这一阈值是在 Lumina 的验证实验中选定的,属于最终推理流程的一部分。保留与 RECIST 连线相连的肿瘤区域
阈值化后的掩膜中可能包含小的不连通区域。其中一些区域可能并不属于肿瘤。
由于我们知道肿瘤标记的位置,就可以用 RECIST 线来筛选出相关的连通域。
components = connected_components(mask)

tumor_mask = select_component(
    components,
    recist_line
)
我们保留与 RECIST 线相交的连通域,作为最终的肿瘤分割结果。
如果阈值化后没有任何连通域与 RECIST 线相交,就退而求其次,选择距该线中点最近的连通域。
这些操作的顺序很重要:
Probability map
      ↓
Resample to original CT grid
      ↓
Apply threshold (0.35)
      ↓
Connected-component selection
      ↓
Final 3D tumor mask
为什么要在阈值化之前重采样?
我们在阈值化之前对概率图重采样,这样概率值就能在原始 CT 网格上进行插值。开发过程中我们也试过先阈值化再重采样,但那样做等于对已经二值化的 mask 做插值,会在病灶边界产生细微变化。
而先处理概率图,可以在插值过程中保留更多信息,让最终分割获得更精确的边界。
最终得到的是一个与原始 CT 扫描对齐的 3D 二值 mask,可以直接用于评估或可视化。
第 7 步:加速 CPU 推理并保证结果一致性
CPU 和内存限制直接影响推理方案的设计。
为了满足挑战赛的资源约束,我们采用了多种技术手段。
固定线程数
CPU 计算在不同线程数下运行时,可能产生微小的数值差异。
在
0.35这样的分割阈值附近,概率值哪怕极小的变化都可能影响某个体素是否被纳入最终 mask。因此我们显式设置了 PyTorch 的线程数:
torch.set_num_threads(8)每次运行使用相同的线程配置,有助于保证推理过程可复现。
控制推理次数
我们使用 ensemble,因为综合多个模型 pass 的预测能提升分割效果。
这个 ensemble 融合了来自不同输入的预测,包括图像的翻转版本,以及一个单独训练的 SegResNet 模型。
病灶数量可能因扫描而异。若每个病灶采用四次推理,那么五个病灶的扫描就需要运行 20 次模型,这可能会超出挑战赛的运行时间限制。
因此,我们为每次扫描设定了最大推理次数,并根据标记的病灶数量动态调整该次数。
简化逻辑如下:
want = max(
    1,
    min(len(members) + 1, cap // max(len(ids), 1))
)
肿瘤数量 每肿瘤推理次数 1 4 2 3 3 2 超过 3 1 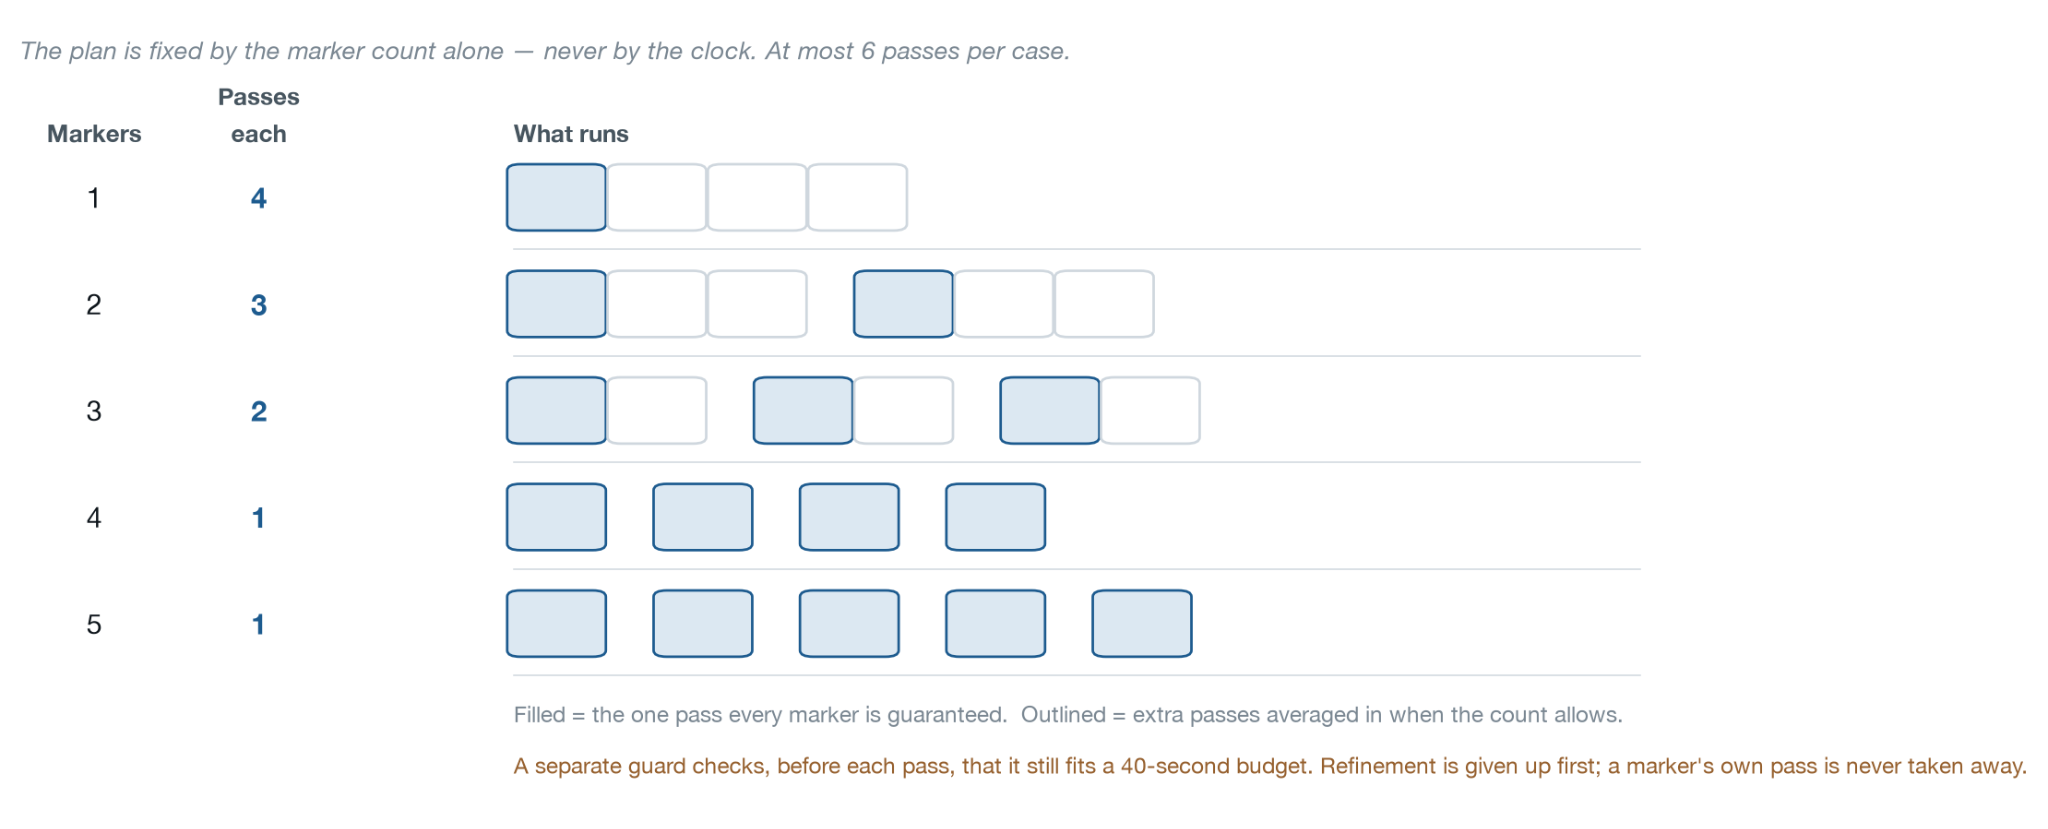
推理计划根据标记数量在开始前确定。这确保了计算量可预测,并避免结果受执行过程中剩余时间波动的影响。
实测结果如下:
设置 得分 无集成 0.7242 上限 4 0.7324 上限 6 0.7361 无上限(始终 4 次) 0.7410 无限制的集成策略得分最高,但无法满足运行时约束。上限为 6 的策略在保留大部分集成收益的同时,将推理时间控制在限制范围内。
处理单个失败案例
处理多个案例时,单个案例失败不应阻断整个流水线。
若案例无法处理,系统生成空掩膜并记录错误,随后继续处理剩余案例。
即使个别案例出现问题,也能确保整批任务完成。
实验结果
在 217 个隐藏测试扫描上,Lumina 取得:
Dice: 0.7619
NSD: 0.6094
NSD 数值采用官方 1 mm 容差 标准。
单案例推理中位耗时为 20.3 秒,观察到的最慢耗时为 31.8 秒。
8 GB 容器内峰值内存占用为 2.22 GB。
Docker 镜像大小约为 559 MB。
定性结果
边界清晰的大病灶
第一个示例是一个体积为 272.9 cm³ 的大病灶,指标如下:
DSC:0.961
NSD:0.850
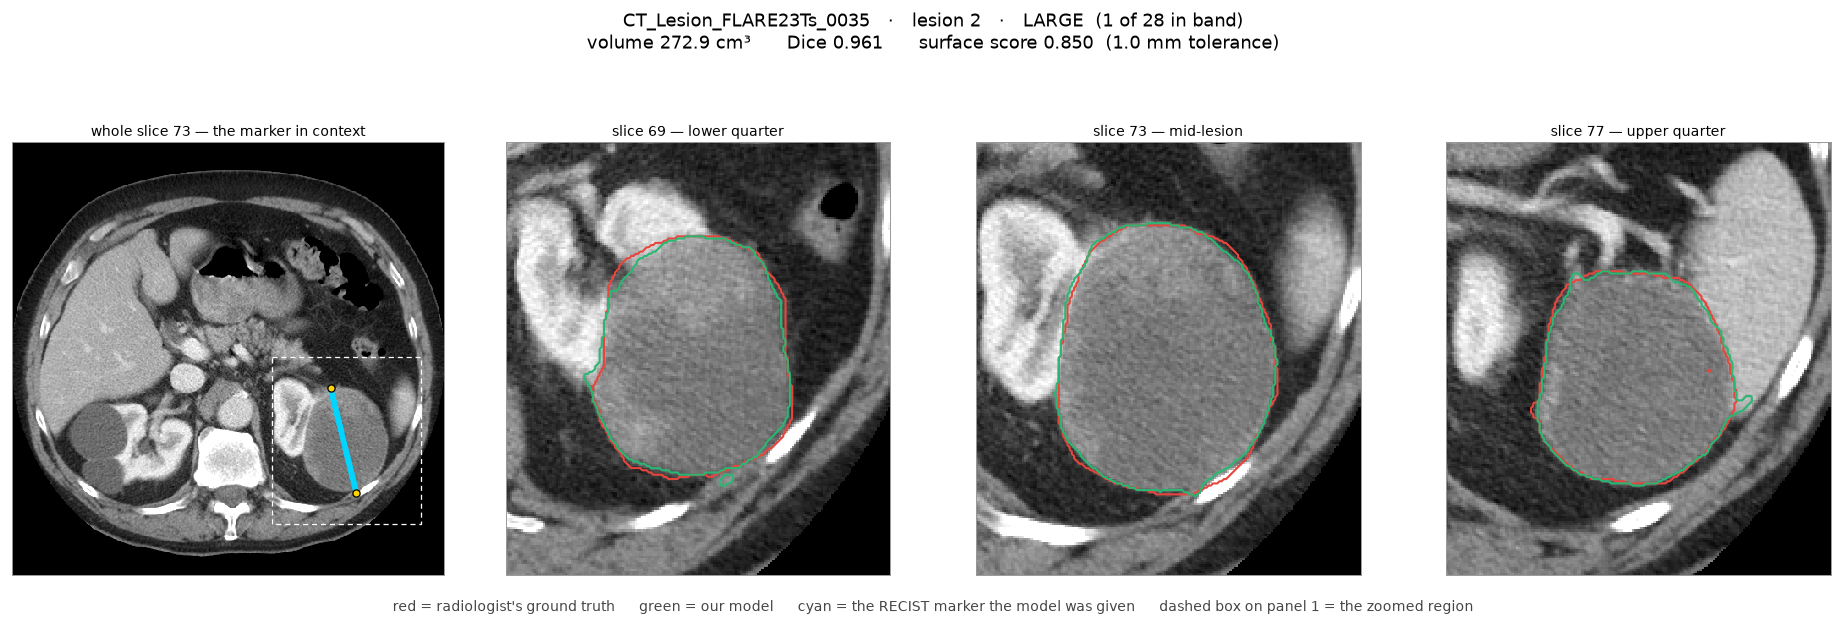
该病灶边界清晰,与周围脂肪组织的界面分明。
在病灶可见范围内,预测轮廓紧贴参考边界。
边界模糊的中等病灶
第二个示例是一个体积为 28.4 cm³ 的中等病灶,指标如下:
DSC:0.563
NSD:0.114
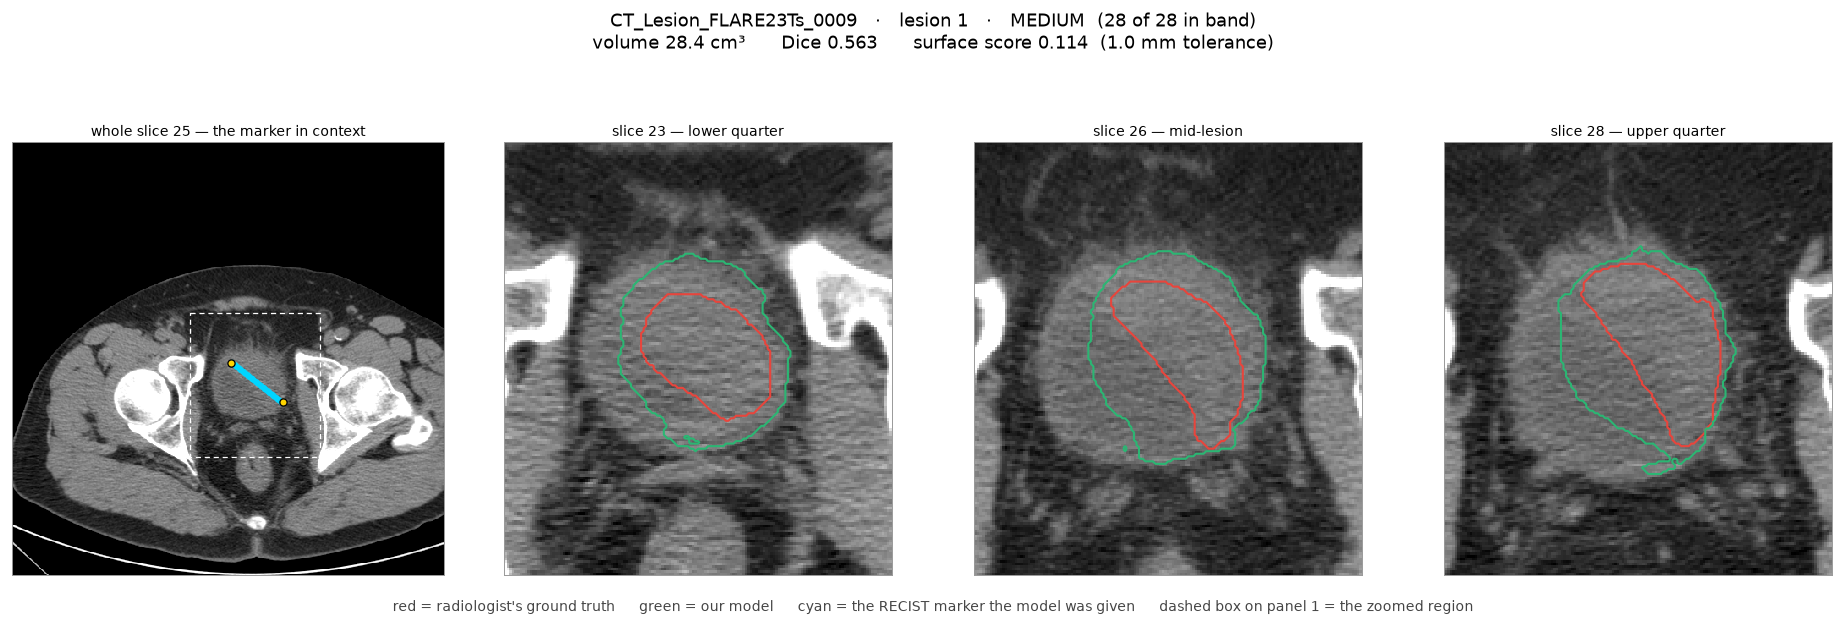
预测区域明显大于参考标注。
放射科医师审查指出,此类病例中参考边界本身可能存在不确定性。因此,低数值评分本身并不足以证明预测轮廓在临床上不可接受。
放射科医师审查结果
我们还邀请放射科医师共同审查了 30 个病灶,以深入理解 Lumina 产生的错误类型。
审查发现,病灶大小并非影响分割效果的唯一因素。
边界清晰的病灶通常更容易分割,而边缘模糊或与周围组织外观相似的情况则更具挑战性。
主要错误类型包括:
欠分割:遗漏部分病灶。
过分割:将周围组织误纳入。
边界错误:预测轮廓未能贴合模糊或浸润性边缘。
审查还表明,数值指标应与可见的病灶边界结合解读。
在某些情况下,参考边界本身难以界定。因此,低分并不一定意味着预测轮廓在临床上不可接受。
这与困难病灶中观察到的较低表面精度一致——在这种病灶上,边界的微小差异就会对 NSD 产生很大影响。
三条适用于其他项目的经验
1. 让验证数据具有代表性
验证集应能反映最终系统实际面对的数据分布。
我们的内部验证集来自训练数据,其中位肿瘤体积为 814 mm³。
而竞赛评分集的中位肿瘤体积高达 16,805 mm³,大得多。
这一差异影响了一些改进在开发过程中的表现。
例如,边界损失在内部验证集上连续多个 epoch 几乎没有提升;但在包含更大病灶的公开验证分布上,它的效果却更有用。
如果某项改进针对的是数据分布的特定部分,那么验证集中就应体现这部分分布。
2. 量化预处理的极限
160 mm 的裁剪范围是 Lumina 中的一个重要设计选择。
一些大病灶超出了这个视野范围。
在调整裁剪大小之前,我们测量了裁剪和重采样引入的误差。
方法是把 ground-truth 掩码跑一遍同样的裁剪加重采样流程,然后测量由此得到的表面分数。
对于大病灶,几何上限是 0.9699 NSD,而模型达到了 0.5353 NSD。
这说明预处理流程对病灶表面的保留是相当不错的,剩余的差距并不能归咎于预处理。
我们还尝试了几种扩大视野的方法,包括:
重叠切片(tiles)
自适应缩放
更大的裁剪范围
这些改动都没有提升最终分数。
量化预处理的上限,让我们得以把后续开发精力集中在模型和推理流程上。
3. 记录每个数字的来源
模型开发涉及大量配置值:
阈值
裁剪大小
体素间距
损失权重
采样权重
Ensemble 设置
运行时限
每个值都应有明确的依据。
比如,要记录:
测量对象是什么
使用了哪个数据集
测量发生的时间
测试了哪些备选方案
最终选择该数值的理由
这样做有助于后续复现实验和理解设计决策。
结论
Lumina 证明仅凭单条 RECIST 线即可从 CT 扫描中重建肿瘤的三维范围。
该系统结合了基于提示的输入通道、固定物理裁剪、3D DynUNet、边界感知训练、基于概率的后处理以及受控的 CPU 推理。
在 217 个留置病例上,Lumina 在官方 1 mm 容差下实现了0.7619 的 Dice 分数和0.6094 的 NSD。
其中位推理时间为20.3 秒,峰值内存占用为2.22 GB,使系统保持在挑战的约束范围内。
实验还表明,边界精度仍是需要改进的重要领域,尤其是对于体积较大且边界定义不清的病灶。
几何上限分析显示,裁剪和重采样流程很好地保留了病灶表面,这意味着进一步的改进应聚焦于分割精度和鲁棒性。
总体而言,Lumina 展示了一种切实可行的方法,在满足严格计算约束的同时,将二维 RECIST 测量值转换为三维病灶分割。