
开发者借助 AI 将 DLSS 5 移植至 Intel 核显,Arc 140T 实现 360p 10 帧神经渲染
GitHub 上出现了一个新项目,名字直白地叫“dlss-nr-on-intel”,它声称能提供一项关键功能:将NVIDIA 的 DLSS 5 神经渲染移植到 Intel 的 Xe 架构上。具体来说,这位 ID 为“Uzbekunknown”的作者聚焦于将该技术移植到其 Lunar Lake 系统中的 Intel Arc 140V 核显,并似乎取得了成功——至少从输出效果来看,它与其他硬件上 DLSS 5 的表现相当接近。
除了 DLSS 5 神经渲染技术本身,AI 也是该项目的核心驱动力。Uzbekunknown 在致谢中提到了 Anthropic 的 Claude 和 OpenAI 的 GPT-6 Astra 为代码做出的贡献,并表示它们“提供了机器、二进制文件和指导,并做出了决策”,而 AI 智能体则完成了其余所有工作。有趣的是,作者还提到“笔记中故意保留了一些误入歧途的记录”,其中包括一个不存在的幻觉驱动 Bug,该 Bug 实际上影响了开发过程的三个阶段。
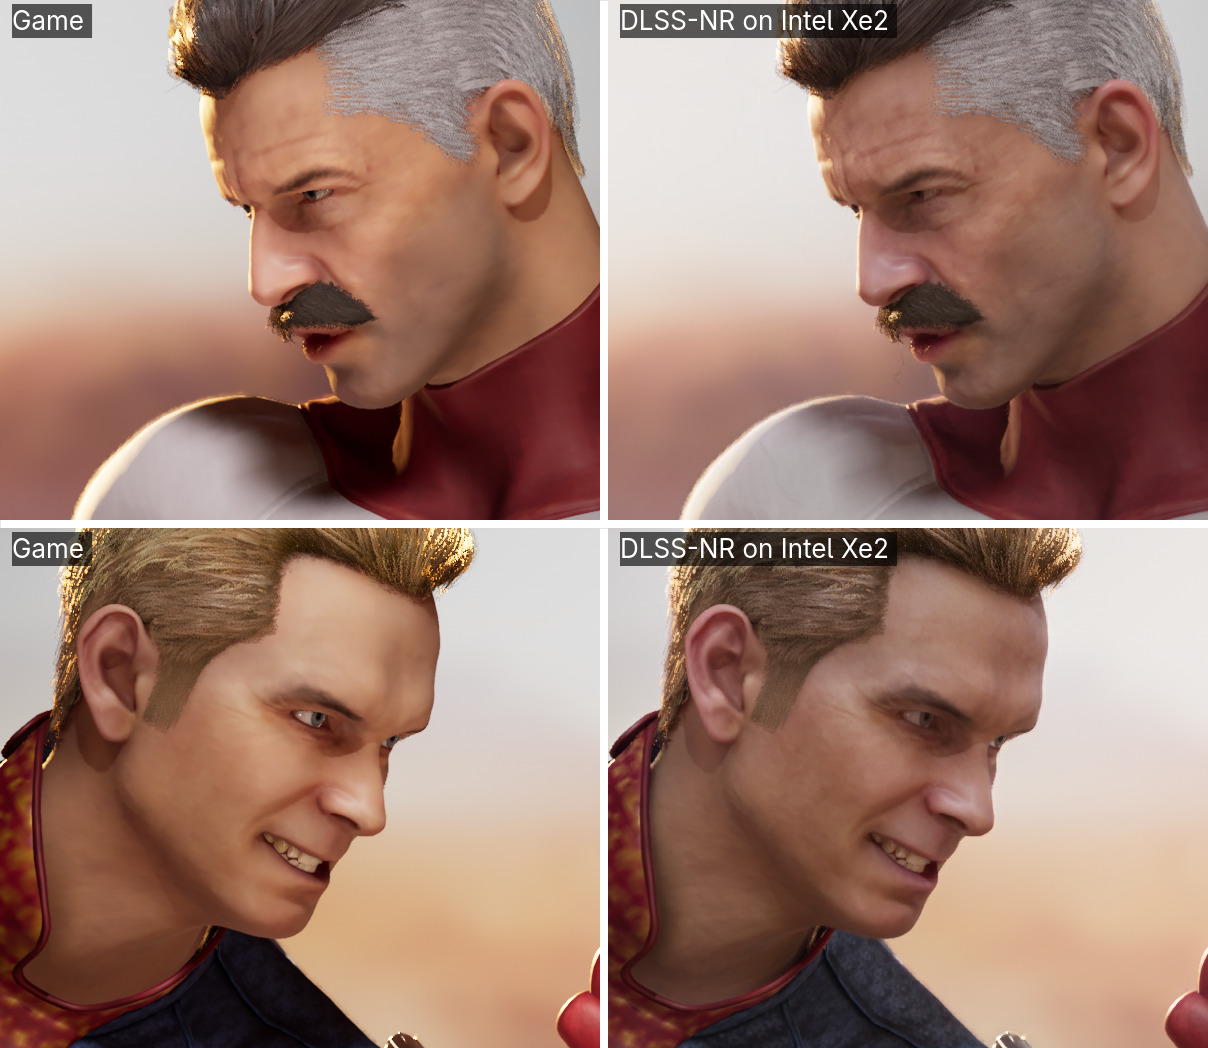
最终成果并非像许多其他 hack 方案那样只是 DLSS 5 DLL 的外壳封装,而是完整重实现了 DLSS 5 所用的 71 层 U-Net 结构,并通过名为 Vulkan 扩展 VK_KHR_cooperative_matrix,在 Intel Xe XMX 单元上运行。由于 Xe2 不支持 FP8,整个过程均采用 FP16 运算搭配 FP32 累加。你可以通过任何支持 Vulkan 输出结果的接口运行该模型,用户展示了三款格斗游戏的概念验证结果:《死或生 5 最后一轮》、《铁拳 7》 和 《真人快打 1》。

性能并不理想。在 640x360 分辨率下运行十年前的 《铁拳 7》,对于性能强劲的 Intel Arc 140V 核显本应是轻而易举的任务,但加载该模型后帧率仅约 10.5 FPS。需要注意的是(作者也提到了这一点),DLSS 5 的性能几乎完全取决于游戏的输出分辨率,因此要想在这类有限硬件上配合这种效率较低的方案实现接近实时的帧率,就必须将分辨率降到非常低的水平;显然,DLSS 5 处理流程本身 在 Arc 140V 上以全高清分辨率运行耗时约 412 毫秒,这意味着即使游戏渲染是瞬间完成的,最大帧率也仅为约 2.4 FPS。
不过它确实能跑起来,这才是最令人印象深刻的地方。作者对三款测试游戏效果的分析,我并不完全认同:他认为《真人快打1》在 DLSS 5 输出下丢失了细节,虽然从数据上看可能如此,但在我眼里画面反而显得更精细了。DLSS 5 NR 模型是专门为照片级写实效果训练的,这在《真人快打》和《铁拳》上效果不错,但对走动漫风格化路线的《死或生》就没那么理想——模型反而让角色显得更老、观感更差。
该项目目前仅支持 Linux,因此对大多数读者来说实用性有限。不过 Reddit 用户 /u/arielcasari 表示,他计划"将其移植到 Windows",并会在 /r/IntelArc 子版面上发布相关结果。如果你也想动手试试,可以前往开发者的 GitHub 仓库。请务必仔细阅读 Readme.MD,因为该项目开放了 Nvidia DLSS 5 的全部控制参数,想要获得尚可的效果,你得对这些参数有基本了解。