
再省100TB内存
Cloudflare 的规模大到即使在这里工作多年,依然让人觉得不真实。我们在全球拥有数千台服务器、PB 级的内存和数百万个 CPU 核心,而且全都被压榨到极限。资源虽然庞大,终究有限,而每个服务都要跑在每个节点上,容不得半点浪费。
在这个规模下,任何微小的改进都会被成倍放大,所以哪怕只是每次 1% 的优化也值得庆祝。而有些小改动累积起来效果更惊人:这篇文章将讲述我们如何通过对单个算法的小幅修改,大幅降低了一个基于 Pingora 的服务的内存占用,从而在全球范围内回收了超过 100TB 的内存——这还是在 DNS 团队上个月省下 100TB 内存的基础上。
拒绝浪费
在团队之间维持公平的资源分配并不容易,大型组织尤其如此。Cloudflare 靠出色的 Performance 团队的不懈努力来保障这种平衡。
这个故事始于 Ivan 提交的一个工单,他发现:Pingora Backend Router 中 pingora-ketama 占用内存过多。具体来说,我们的内部负载均衡服务 Pingora Backend Router(没错,就叫 PBR)使用的内存远超预期——问题出在与 pingora-ketama 相关的数据结构上,这是我们的一个处理一致性哈希的开源库。
要讲清楚我们如何解决这个内存滥用问题,得先弄明白什么是一致性哈希、为什么 PBR 要用它、以及它为什么这么吃内存。过程中我们还会学点 Rust,甚至一点数学。
一致性哈希
一致性哈希是一种广泛使用的技术,用于将任务分布到多台服务器上,且在增删服务器时无需进行大规模调整。内部我们利用它根据 URL 将可缓存请求路由到特定服务器。这使得我们只需在每个数据中心存储一份文件副本,并为定位每个文件提供了稳定的方法。我们曾在 此、此、此 以及 此 文章中提及过该系统,但让我们花些时间详细讲解一下该算法的原理、使用场景及其工作机制。
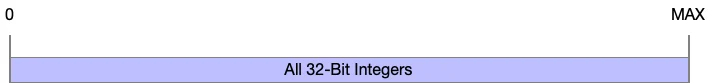
一致性哈希的核心概念在于:尽管哈希函数可以接受任何类型的输入,但其输出限制为单个无符号整数(根据哈希函数的不同,可能是 32、64 或 128 位)。这让我们能够以一致性的方式将任务与服务器相互关联。关于一致性哈希的大多数讨论,都会引导人们将该输出空间想象为一个连续的圆形环,其最大值会回绕到零。这种描绘方式便于可视化,但可能让本不复杂的整数区间概念显得更晦涩。在我们的讨论中,我们将哈希函数的 32 位输出表示为一条数轴。
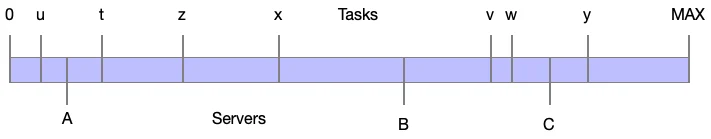
假设我们有一组服务器 A、B 和 C,以及一组任务 t-z。我们可以基于它们代表值(如服务器的 IP 地址或任务的缓存键)的哈希值,将它们映射到数轴上。
现在,将任务分配给服务器只需找到每个任务左侧最近的那台服务器。我们可以通过着色来表示与每台服务器关联的哈希区域。请注意,服务器 C 覆盖的范围会回绕到数轴的起点,这就是人们认为哈希值存在于一个“环”中的原因。
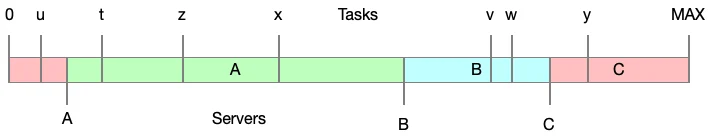
这就是全部了。从基础层面来看,一致性哈希就是这样简单——但很快你会发现,还有优化空间。注意到我们的例子中服务器 A 覆盖的区间显著大于 B 或 C。这是问题所在,因为服务器处理的请求比例与其在数轴上的区间大小成正比。理想情况下,我们希望确保每个服务器拥有相等的区间大小,但由于哈希值本质上是随机数,我们不得不从 统计学角度来谈论区间的大小。😨
数学与推论
首先:别慌。我保证 不会骗你,而且我们会安然保持在初学概率论的范畴内。当讨论统计分布时,有两个主要因素能帮助我们以有用的方式量化不确定性:期望值和标准差。用(过度)简化的术语来说,期望值给了我们一个分布测量的中心点,而标准差则告诉我们大多数测量值可能有多接近这个中心点。
对于一致性哈希,我们可以计算 N 个服务器中任意一个服务器所关联区间的分数大小的这些因素。(关于公式来源的细节将在后面说明)。
$$m \begin{align*} \text{Exp} &= \frac{1}{N} \\ \text{SD} &= \frac{1}{N}\sqrt{\frac{N-1}{N+1}} \end{align*} m$$用具体数字来说,假设有 100 个服务器。上述公式给出:
也就是说,每台服务器负责的区间长度平均约为总量的 0.99%,大部分区间的长度会落在期望值的 1% 以内。乍一听不错,但别忘了这是占总长度的 0.99%。要看误差相对目标大小的比例,得用标准差除以期望值,这个指标叫做变异系数。
多加几个哈希会怎样?
一致性哈希的简单是把双刃剑。它容易理解和实现,因为所有东西都被映射到同一条数轴上、彼此容易关联,但任何改进也必须能落到这条数轴上。也就是说,解决一致性哈希的问题只有一条路:加更多哈希。与其说它是“金锤子”(拿着锤子看什么都像钉子),不如说它是一颗金钉子——它把所有工具都变成了锤子。
要解决负载不均的问题,我们可以给每台服务器分配多个哈希,而不是只用一个。背后的数学稍后再讲,但直觉上不难理解:虽然单个区间的标准差很大,但把一堆区间加在一起,总大小就会趋于平均。还是用前面图中三台服务器的例子,给每台服务器随机再加两个哈希点,可以看到各服务器的负载确实变得更均衡了。
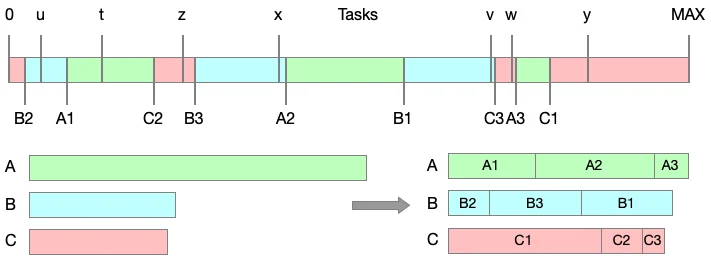
诚然,这是一个有些牵强的例子。系统的随机性意味着,给每个服务器额外增加两个哈希值能带来多大的性能提升并不确定,但直觉上我们能理解,将更多哈希片段合并计算通常会带来更均匀的分布。求和中的每个片段都有机会去平衡其他片段。也许某个片段太短,也许某个片段太长。这本质上就是大数定律所揭示的现象……显而易见的问题是,这仅适用于大数场景。在 NGINX 中,每个服务器的基础哈希数量被硬编码为 160,而 Pingora 默认也使用相同的值。这里暂时不展开计算过程,但如果回到之前 100 台服务器的例子,若每服务器使用 160 个点而非仅 1 个点,变异系数(可视作误差范围)会从约 99% 降至约 8%,这是一个巨大的改进。
如果增加更多哈希值会怎样?
上文提到,通过为每个服务器增加固定数量的哈希值,可以改善工作负载在各服务器间的分布均匀度。但假设我们不希望均匀分配负载呢?以 Cloudflare 为例,部分服务器的存储空间多于其他服务器,因此让分配给某台服务器的请求数量与其磁盘空间成比例会更合理。实现这一目标的方法之一是采用 ketama 算法。这个命名略显古怪,因为该算法是以其最早实现所在的库命名的,而这个库的名字……嗯,大家可以自己去搜索一下 😶🌫️。
该算法的核心在于:对于任意两台服务器 $m S_1m$ 和 $mS_2m$,若希望由 $mS_1m$ 处理的请求量是 $mS_2m$ 的 $mw\timesm$ 倍,那么分配给 $mS_1m$ 的哈希数量就必须是 $mH_1 = w\times H_2m$。这就允许我们为每台服务器设定一个“权重”,从而按比例调节其关联的哈希数量。不过,这并不能替代上文提到的恒定缩放因子。那个因子仍需存在,以设定最低误差阈值,而误差往往在最轻权重的服务器上显现。就我们而言,由于希望基于存储空间分配负载,因此可以直接使用磁盘空间作为权重,这正是 Pingora 团队多年来一直在做的。而在公司中那些对计算资源要求更高的场景下,权重则可能基于 CPU 或 GPU 的数量来设定。
如果我们再增加更多哈希值怎么办??
我们需要解决的最后一个问题是:目前我们假设任何服务器都能处理任何请求,但现实中并非如此。合规性要求或已启用的缓存特性意味着只有部分服务器能处理特定请求。遗憾的是,不同于之前,我们无法通过向同一哈希环中添加更多哈希来解决这个问题。我们必须引入全新的哈希环,不仅如此,几乎每一种特性组合都需要一个独立的专用哈希环!
基于组合关系的重复机制是指数级爆炸的典型根源。在我们这种情况下,几种不同的特性组合导致了 $m2^\text{handful} = \text{dozens}m$ 个独立的一致性哈希环。因此,大家可能已经猜到了,Ivan 发现的“内存占用过高”现象(在某些情况下达到 6GB)正是源于为了支持所有必要功能而生成的大量哈希值,且这些哈希值必须保存在内存中。那我们该如何是好呢?存储优化
一次重大改进来自 Zaidoon,他对我们用于在 PBR 中存储哈希的 结构体 提出了一个见解。该结构体如下所示:
struct Point {
    hash: u32,
    index: u32,
}
struct PointV2 {
    hash: u32,
    index: u16,
}
可惜 Rust 没这么好对付。像上面那样改小索引的位数,并不会减少内存占用。这是因为 Rust 有对齐规则,要求结构体在内存中的大小是其最大(或“对齐要求最高”)字段的倍数。这里哈希是最大的字段,占四个字节,所以 Point 存入内存时大小必须是 $mN \times 4m$,最小也就是八个字节。
好在业界有一些成熟的绕过办法。你(也就是我)可能想用 #[repr(packed)],但这个方案争议不小,理由也很充分。一个更安全但可读性差些的做法是把哈希和索引存成原始字节数组,再通过 getter 来访问。两种方式编译出来的结果是一样的。
struct Point([u8; 6]);

impl Point {
   fn hash(&self) -> u32 {
	u32::from_ne_bytes(self.0[0..4].try_into().unwrap())
   }

   fn index(&self) -> u16 {
	u16::from_ne_bytes(self.0[4..6].try_into().unwrap())
   }
}
这个简单(虽然啰嗦)的改动,把一致性哈希的内存占用直接砍掉了整整 25%!想做得更好,我们就得重新回到数学部分,大家坐稳了,最后一段冲刺来了。
少用几个哈希会怎样?
你可能已经注意到,我们给出的标准差公式只适用于每台服务器仅使用一次哈希的情形。推导每台服务器使用 $m k m$ 次哈希时的公式并不简单,大多数文献只提供近似值或渐近界限,但我们不一样。我虽然算不上统计学家,但从小跟着学微积分的妈妈长大(嗨,妈妈!),所以我想求出精确的数值。完整的推导过程见这篇补充文章,下面是结论。
$$m \text{Exp}_k = \frac{1}{N}, \text{SD}_k=\sqrt{\frac{(k+1)}{N(kN+1)}-\frac{1}{N^2}} m$$要观察增加哈希次数如何提升精度,我们需要再次考察变异系数。
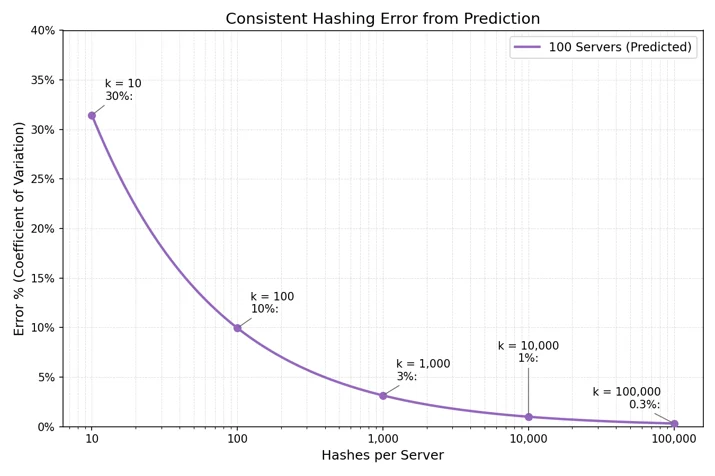
我那些漂亮的数学推导之所以成立,前提是假设哈希分布在一个连续的环上。但在实际应用中,我们使用的是 32 位数字作为哈希值,这些数字存在碰撞的可能性,且随着哈希数量增加,碰撞概率会出人意料地迅速上升(参见生日悖论)。碰撞之所以重要,是因为在理想情况下,每个哈希值都会为关联服务器处理的请求量和分布做出贡献,而碰撞意味着部分贡献被随机丢弃,从而引入不可预测的误差。如果我们对比使用 32 位哈希的模拟结果与预测误差率,可以发现对于拥有 2048 台服务器的数据中心,当每台服务器的哈希数量在 10,000 到 100,000 之间时,误差率会显著增加。
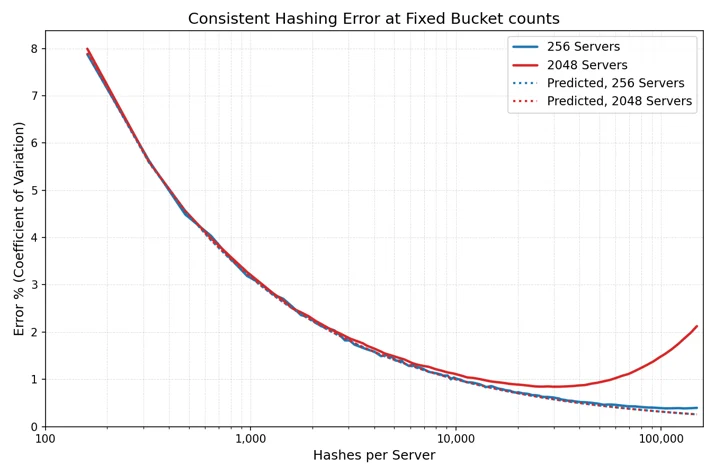
归根结底,虽然这个发现听起来不太美妙,但对我们计划回收内存而言却是绝佳的机遇。既然有了数学模型支持,我们确定可以将每台服务器生成的哈希数量减少90%,而不会造成任何显著误差。于是,我们便开始着手执行这一方案。
迁移而不“熔毁”源站
还有一个问题:更换 hash ring 会改变部分可缓存请求的路由去向。即使新 ring 更好,如果让整个网络一次性切换,几乎所有缓存内容都会瞬间失效,一次内存优化就会变成源站流量的末日式暴涨。
所以我们没有做全局一刀切。在过渡期间,PBR 在内存里同时保留了两个版本的可缓存负载均衡器:旧的 ketama ring 和新的更小的 ring。每个请求都通过我们现有的迁移框架来决定由哪个 ring 选择后端。这样发布决策对每个请求 hash 都是稳定的,也提供了干净的回滚路径——一旦发现异常,只需让新请求走回旧 ring,无需重新部署 PBR。
随后我们按层次逐步推进迁移:先在少量用于验证的数据中心上线,再逐步扩大到更大的数据中心组,最后才推向全球其他地区。
关键在于我们独立控制了两个维度:多少流量使用新 ring,以及这些流量允许流向哪里。如果只是简单的全局百分比发布,缓存抖动会同时扩散到所有地方。按数据中心划分的发布方式把影响范围控制在局部,也更容易判断变更是否真的安全。
迁移期间,我们持续监控后端选择追踪、ring 版本计数、PBR 连接错误、进程内存、启动时间、缓存行为以及源站流量。当迁移达到 100% 后,我们移除了临时的旧 ring 路径,大功告成!
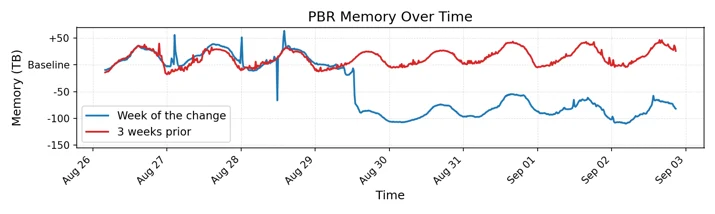
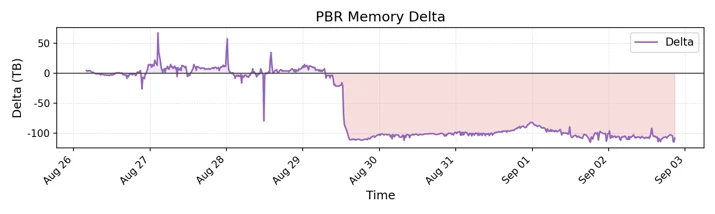
上图对比了变更当周 PBR 的内存用量与几周前的数据,以及两者的差值。图中急剧下降的那一天,就是带有大号(已不再使用的)hash ring 的 PBR 版本彻底下线的时间。从差值看,结果令人满意:我们的改动减少了 100TB 内存占用!
亲自试试吧
本贴讨论的所有改动现已以(暂未宣传的)cargo feature 形式发布在 pingora-ketama crate 中。v2 ring 采用了压缩存储格式、更快的排序方法,并支持调整每个节点的基准哈希数量。由于开发重点在于稳定性和可控性,v1 ring 与 pingora ketama 过去使用的版本完全一致,库也支持同时运行两个版本,并按请求粒度动态选择使用哪一个。
除了尝试上述字面意义上的一致性哈希优化外,更希望你从中获得启发:深入审视自己的系统,看看哪些看似“简单”或“显而易见”的决策其实藏着可优化的空间——只要你愿意钻数据。你可能无法用 Rust 解决所有问题,但数学是通用的。