
走走停停下一站 1小时前 · 2026-09-19 00:45:21 · 2 阅读
物理AI与世界模型
物理AI(PhysicalAI)是指具备在真实物理环境中感知、理解、推理与执行能力的智能系统,其典型载体包括人形机器人、自动驾驶及工业自动化等。物理AI模型相比传统多模态大模型(LLM),关键区别在于需融入对物理世界的理解、预测与生成能力。预训练阶段需引入世界模型效果,后训练阶段需融入仿真器生成的轨迹、链路数据及手部操作数据,使模型具备动作规划与自主数据生成能力。物理AI的技术路线正沿着“VLA(视觉-语言-行动)模型”与“世界模型”两条主线协同演进。VLA模型实现了从感知、语言理解到物理动作的端到端统一,使机器人具备了在复杂环境中执行任务的基础能力。世界模型则通过对环境动态的预测性表征,为VLA提供前瞻模拟与虚拟验证能力,弥补其在长程规划和分布外泛化上的不足。未来物理AI将是VLA与世界模型的深度闭环,VLA负责实时决策与执行,世界模型环境推演与规划验证,共同推动物理AI从数字环境走向真实场景的规模化落地。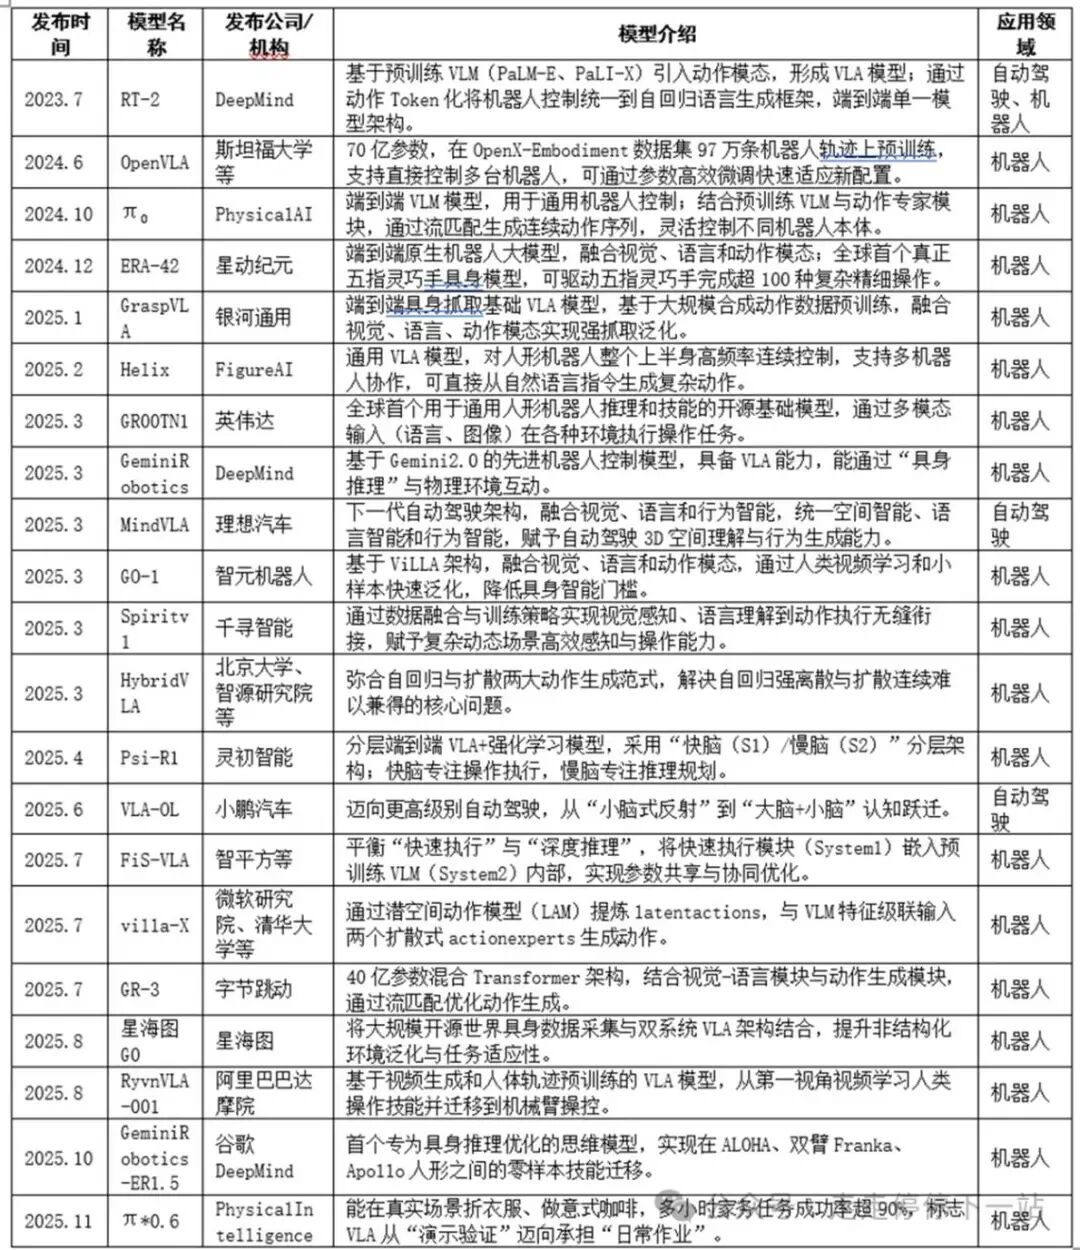
 物理规律学习:目前没有显式预测物理规律,而是通过海量视频数据隐式学习。视频本身遵循物理规律,模型在特征层面(隐空间)学习映射关系,不单独表达重力、摩擦力等。主流范式不显式重建空间或预测未来视频,而是在隐空间学习物理规律,例如OpenAI前团队创立的AM Lab就在隐空间学习。隐空间指特征层面,基于Transformer架构,所有token之间计算attention权重,学习当前token与未来token的关系。视频中的物理规律隐含在特征中,模型正确预测动作即代表学到了规律,但不显式输出具体物理参数。目前主流世界模型没有单独向量预测物理量。研究层面有将杨氏模量等显式预测的工作,但小众,因为无法scale。VLA vs World Model:VLA:输入语言和图像,输出语言规划与动作,特定任务成功率极高,但泛化性较差,特定任务、特定场景的展示与表演。World Model(WA):输入语言和图像,输出动作+对未来状态的预测。泛化性天生强于VLA,适合做行动预测(小脑),但整体能力更偏“小脑”,对世界的理解与规划(大脑能力)不强。端到端为主流:VLA和WA目前并行、竞争,均为主流方向。端到端路线基于大数据、大模型,解决了传统模块化系统模块间信息损失大、规则多、成本高的问题,是未来主趋势。双系统架构(System1&System2):未来主流趋势或为“双系统”架构。System1(C1/小脑):负责快速行动预测(Action)。System2(C2/大脑):负责对世界/语言的理解、规划及空间认知,目前存在欠缺。例如,在家庭场景中,先由“大脑”接收语言指令做规划,再将具体指令下发给“小脑”(WA)执行。技术路线未收敛:当前存在多种架构,目前主流技术路线尚未收敛,模型层面未来竞争激烈。端到端(适合自动驾驶)、高层推理+底层动作双系统架构(适合机器人)、VLA+扩散模型动作生成策略(主要用于实验室demo,如叠衣服、双臂协作)、视觉模型+策略模型。
VLA模型
VLA模型突破了将视觉、语言和动作视为独立领域的局限,并显著提升了机器人在复杂环境中的泛化与推理能力。受Transformer架构大语言模型启发,其概念于2021—2022年间被提出,而2023年Google DeepMind推出的RT-2(Robotic Transformer2)则将感知、推理与控制整合于同一架构,把机器人控制视为一个自回归序列预测任务。技术实现上,VLA在视觉-语言模型(VLM)的基础上引入“action token”,将机器人电机指令(如关节角度、移动距离)进行数值化或符号化编码,使模型能够从视觉、语言与机器人轨迹数据中联合学习。这一方法显著提升了机器人在未见物体、新语言指令以及非结构化环境中的泛化与多步推理能力。在架构设计上,典型的VLA模型融合三个核心模块:视觉编码器(如CNN或ViT)、语言模型(如LLM或Transformer)以及策略模块或规划器。当前VLA模型的性能虽已逼近技术极限,但从仿真环境迁移到真实物理世界时,仍然面临泛化能力不足等挑战。自2023年以来,VLA模型发展迅猛,性能已接近当前技术体系下的天花板。尽管VLA在封闭或相似环境中表现卓越,其在真实物理世界中的迁移部署仍面临一系列挑战,其中泛化能力不足是关键挑战之一。当面对全新任务或不熟悉的任务变体时,模型性能往往出现大幅下滑。这种局限性本质上源于模型对狭窄训练分布的过拟合,以及对多样化任务表征的接触不足。因此,行业亟需精心构建的、平衡且全面的领域特定数据集。世界模型
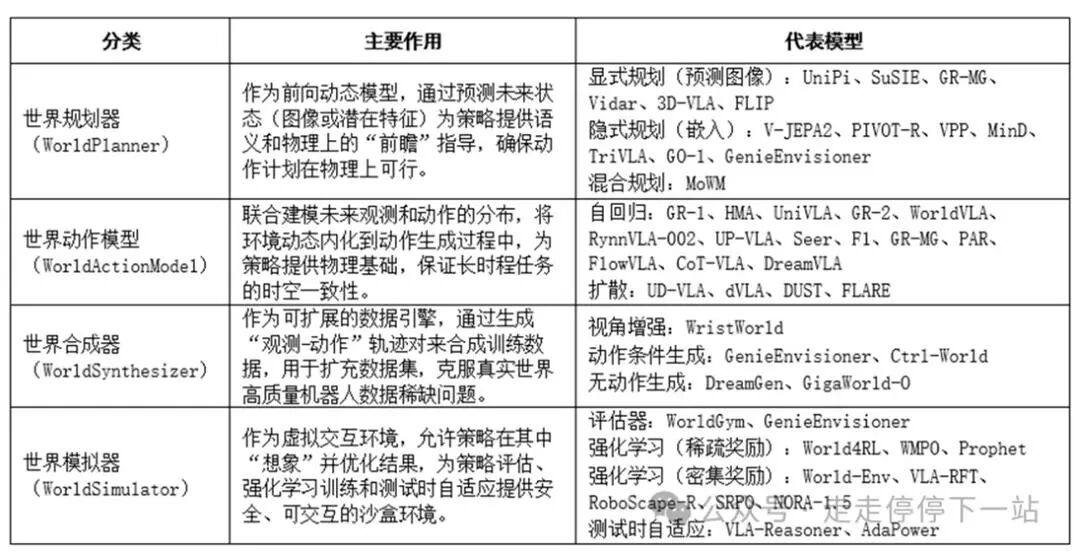
VLA模型是当前观测直接映射出动作,缺乏对周边环境以及未来状态演化的显式推理。这一局限在复杂物理环境中尤为突出,当任务涉及长时程规划、多步推理或不确定性下的决策时,纯反应式VLA往往因累积误差和缺乏前瞻而表现不佳。世界模型是一种对环境动态的预测性表征,能够根据当前状态与候选动作,预测未来一系列状态的演化轨迹。它为VLA提供了环境动态的“内嵌物理引擎”。VLA可借助世界模型提前模拟动作的物理后果、验证计划可行性,并在虚拟环境中进行安全训练与数据增强。世界规划器:作为前向动态模型,通过预测未来状态(图像或潜在特征)来为策略提供语义上和物理上的“前瞻”指导,确保动作计划在物理上可行。物理规律学习:目前没有显式预测物理规律,而是通过海量视频数据隐式学习。视频本身遵循物理规律,模型在特征层面(隐空间)学习映射关系,不单独表达重力、摩擦力等。主流范式不显式重建空间或预测未来视频,而是在隐空间学习物理规律,例如OpenAI前团队创立的AM Lab就在隐空间学习。隐空间指特征层面,基于Transformer架构,所有token之间计算attention权重,学习当前token与未来token的关系。视频中的物理规律隐含在特征中,模型正确预测动作即代表学到了规律,但不显式输出具体物理参数。目前主流世界模型没有单独向量预测物理量。研究层面有将杨氏模量等显式预测的工作,但小众,因为无法scale。VLA vs World Model:VLA:输入语言和图像,输出语言规划与动作,特定任务成功率极高,但泛化性较差,特定任务、特定场景的展示与表演。World Model(WA):输入语言和图像,输出动作+对未来状态的预测。泛化性天生强于VLA,适合做行动预测(小脑),但整体能力更偏“小脑”,对世界的理解与规划(大脑能力)不强。端到端为主流:VLA和WA目前并行、竞争,均为主流方向。端到端路线基于大数据、大模型,解决了传统模块化系统模块间信息损失大、规则多、成本高的问题,是未来主趋势。双系统架构(System1&System2):未来主流趋势或为“双系统”架构。System1(C1/小脑):负责快速行动预测(Action)。System2(C2/大脑):负责对世界/语言的理解、规划及空间认知,目前存在欠缺。例如,在家庭场景中,先由“大脑”接收语言指令做规划,再将具体指令下发给“小脑”(WA)执行。技术路线未收敛:当前存在多种架构,目前主流技术路线尚未收敛,模型层面未来竞争激烈。端到端(适合自动驾驶)、高层推理+底层动作双系统架构(适合机器人)、VLA+扩散模型动作生成策略(主要用于实验室demo,如叠衣服、双臂协作)、视觉模型+策略模型。数据瓶颈:核心矛盾与数量级差异
数据是最大瓶颈,语言模型是算力密集型,而具身智能是数据驱动型:当前真实机器人数据最宝贵、精度最高,但获取成本极高(占用空间、机器、时间、人力)。目前行业没有一家公司拥有100万小时高质量仿真数据。仿真数据虽为跳板,但前期建模门槛高。从0到当前,物理AI数据量差至少一千倍量级。预计若每年补齐一个量级,产业约需2-3年达到类似GPT-3那种通用性与“涌现”时刻。数据金字塔结构:第一层(海量互联网数据),只能训练World/WLM部分,对Action帮助有限;第二层(生成式仿真数据):通过世界模型(3D/VideoWorldModel)进行场景泛化,可实现1:1000甚至1:10000的泛化,高效生成海量高价值数据;第三层(传统物理仿真):如大量人工手调物理参数,适合抓放等刚体任务,但对复杂柔性操作(如叠衣服)无能为力;第四层(人类操作数据):2025年流行UMI(手持夹爪),2026年最火的是Ego(头部带摄像头,双手空手操作),Ego数据量增速最快,但纯视觉定位偏差约1厘米,无法用于精细任务(如一毫米偏差),主要用于大模型预训练;第五层(真机数据),精度最高,但获取效率低,成本高。数据飞轮:实现数据飞轮需达到百万级机器人部署量,才能像自动驾驶一样回流各种真实数据,目前尚未达到此阶段。最缺的是带动作、结果、物理反馈的交互数据(场景状态、目标指令、视觉流、工作轨迹、成功/失败标签、异常原因),而非单纯图像数据。OpenAI重启具身智能,在全球高价买断异构数据,意图建立数据壁垒。产业壁垒
数据是核心壁垒:拥有百万级高质量数据且算法不拉垮的团队,可建立核心级别壁垒。算法:对创新有深度认知的顶级算法团队是中期壁垒,特别是长时序任务规划,需实现十步以上任务,要求状态记忆、错误检测、自动恢复、任务重规划、局部失败不崩溃。仿真:将sim-to-realgap趋近于零的仿真路线(如银河通用)。需解决物理仿真准确性、仿真参数校准、后训练/强化学习适应真实世界。场景落地能力:与政府、产业方关系密切或自带产业需求的团队有优势。当前做“大脑”的公司最缺真实场景。不能看封闭环境(固定位置/物体)下的表现,这是传统机器人已解决的问题。必须看开放环境下的随机性,也就是泛化能力,需应对新物体、光照、背景、任务、动态干扰。资金与算力(GPU):模型迭代速度取决于融资金额与GPU数量。本体-模型协同:硬件能力决定模型上限,需具备跨本体迁移能力。产业链与价值判断
第一层算力与芯片(GPU、端侧芯片、边缘计算、训练集群)。第二层核心零部件(减速器、力传感器、电池,以传感器为核心)。第三层数据与仿真(仿真引擎生成虚拟数据)。第四层模型与系统(VLM模型、世界模型、小脑模型、机器人OS/中间件)。端侧芯片国产端侧芯片厂商受益确定性最高;数据与仿真工具目前市场价值尚小,但机器人领域大量依赖英伟达等国外产品,国产仿真工具公司有发展机会;核心零部件中的灵巧手、传感器公司偏硬件,爆发性增长有待下游拉动;模型层面技术路线未收敛,竞争激烈。原始来源: 走走停停下一站