
x86 模拟的顽疾
欢迎阅读本站的第一篇专题文章。这篇文章要谈的是 x86 模拟中一个长期存在的难题,它影响到我们模拟的每一个应用。归根结底,就是一个影响深远的术语:模拟 x86 Total Store Ordering 内存模型(x86-TSO)。
ARM 定义的弱序内存模型上模拟这种内存模型,问题涉及多个方面。本文会把这些问题和我们的解决(或暂时无法解决)的办法逐一讲清楚。泡杯热饮、备点零食,慢慢看吧——这篇文章可不短。
x86-TSO 到底是什么?
在深入探讨如何绕过 x86 内存模型问题之前,我们需要先弄清楚它到底是什么。内存模型是一组规则,定义了系统中内存访问彼此之间的关系。这些规则规定了在单线程或多线程环境下,加载(load)和存储(store)指令如何相互作用。硬件实现了多种主流内存模型,但今天我们重点关注两种:ARM 的宽松(或弱)一致性模型,以及 x86 的总存储顺序(Total-Store-Ordering, TSO)一致性模型。这两种模型基本上处于频谱的两个极端:ARM 最为宽松,允许大量的硬件优化;而 x86 最为严格,强制执行一个非常强的一致性模型,留给优化的空间很小。在讨论内存模型时,需要注意一致性和原子性之间的区别。虽然两者相关,但并不相同,也并非在所有情况下都有保证。
解释不同内存模型差异的最佳方式,是从 x86 的处理机制入手。由于 TSO 规则非常严格,程序员可以假设:一旦发生内存存储,该数据将立即在系统内所有其他处理器间具有一致可见性。这也意味着,当一个内存加载发生时,逻辑上位于它之前的所有存储操作都已完成,或者至少已经可见。这符合程序员的预期:写入内存后,数据在写入的那一刻即变为可见,这种直觉易于编程理解。存储操作有效地决定了加载操作的可见顺序,模型名称也由此而来。具体运作机制还有些细微差别,但理解核心概念时并非必要。
ARM 采用的弱内存模型(weak memory model)在运作机制上略显反直觉。默认情况下,ARM 使用的普通内存读写操作在系统内的多个处理器之间并不严格保持一致性(coherent)。这种设计允许 CPU 在大多数时候更高效地运行。当一条存储指令执行后,该内存位置所在的缓存行(cacheline)并不会立即对其他处理器可见。这是因为让其他核心的缓存失效,或者允许它们窥探(snoop)另一处理器的缓存,在硬件上代价高昂;不立即同步可以节省宝贵的功耗并提升效率。与之相关的是,如果一个处理器从其他处理器已写入的内存位置读取数据,并不保证这次读取能获取到最新的值。这听起来似乎会引发多线程应用中的严重问题?较老版本的 ARM(ARMv7 及更早版本)使用内存屏障(memory barrier)指令来确保执行顺序,但这会带来显著的性能损耗。
为了解决这种一致性限制,ARM 引入了 load-acquire(带获取的加载)和 store-release(带释放的存储)内存指令。用 C++ 的术语来说,这两者分别对应 std::atomic 中的 memory_order_acquire 和 memory_order_release 定义。在 ARM 的术语体系中,这些指令严格来说 并不 被视为原子操作,但程序员们常将二者混为一谈。FEX 项目也直接使用 atomic-load 和 atomic-store 来指代相同含义!通常情况下,区分这两个概念并不重要,但在讨论这些话题时,保持术语的严谨性可能更好。
这类指令的主要用途是强制规定此类内存指令之间的执行顺序。ARM 将这种模式称为“Release 一致性即顺序一致性”(Release Consistency is sequentially consistent, 简称 RCsc)模型。无需深入细节,其核心思想是:load-acquire 指令必须按顺序被观察到,不能发生重排序;store-release 指令同样如此,且需满足“屏障先于执行”(barrier-ordered-before)语义。这一模型消除了早期 ARM 架构版本中所需的、代价高昂的内存屏障指令。
ARMv8.0-a 的朴素开端
这就是我们在 ARMv8.0-a 上模拟 x86-TSO 内存模型时的起点:把所有 x86 内存加载指令转换成 ARM 的 load-acquire 指令,把 x86 内存存储指令转换成 store-release 指令。这样一来,FEX 的内存语义实际上和 x86 一致了——尽管比必要的严格程度要高,因为 ARM 指令集里没有能精确匹配这种行为的中间选项。可以想见,用这类指令模拟 TSO 的代价极其高昂,我们的微基准测试就能证明这一点。毕竟 ARM CPU 的设计初衷,可没料到这些相对少见的 acquire/release 指令会突然占据执行指令的绝大多数。
先从简单的情况入手,用一个对硬件相当友好的微基准测试:没有刁钻的边界情况,只是最常见的内存访问方式。这样可以得出理想情况下的基准数据。
我们来拆解一下这张图,它能说明不少有趣的问题。每台机器上的 Load 和 Store 两列代表基准性能,也就是硬件理应达到的水平。这些测试并不追求榨干各系统的内存带宽,而是让每种操作做等量的工作。再看 acquire-load 的结果:五个被测 CPU 里,有三个的性能因为使用 acquire-load 而明显受损!另外还可以看到,AmpereOne 的 release-store 指令成绩远低于其他结果,M1 的 Acquire/LRCPC 加载指令也明显低于基准水平。
AmpereOne 的结果尤其凸显了这条老路能有多糟。这些指令从来就不是为这种用法设计的。为了模拟 x86 而给每次加载都用 acquire-release 语义,实际上给 ARM CPU 带来了非常严格的限制:加载指令之间完全不能再乱序执行。所以当每秒有数百万条这样的指令在流水线里时,性能不好也就在意料之中了。但在 ARMv8.0-a 上我们只有这一种指令可用,别无选择。虽然 Cortex-X4 和 Cortex-X925 对这类指令的表现非常出色,但从 Oryon-3 的成绩可以看出,它已经降低了这类指令的优化优先级。
接下来该怎么办?
让我们仔细看看 LRCPC 加载指令,这是从 ARMv8.3 开始强制要求的支持。该扩展在 ARM 指令集架构中新增了一系列加载指令,并在 ARM 原有的 RCsc 内存模型之上引入了新的内存模型。这个新的“Release Consistency processor consistent (RCpc)”内存模型正是我们一直期待的!该扩展的设计源于 x86 模拟的需求,预计在实际硬件上得到广泛应用。从图表可以看出,几乎所有平台的 LRCPC 加载指令在性能上都与常规加载指令相当。
随着 ARM 新版本强制要求支持这一扩展,内存性能问题基本上得到了解决。至少从该微基准测试的结果来看是这样的。一旦 FEX 检测到该扩展,将完全停止使用 Acquire-Load 指令,转而使用 LRCPC 加载指令。但那个 Apple M1 的结果是怎么回事……?
这里必须称赞一下 Apple 解决这个问题的思路。他们的 Apple Silicon 处理器直接加入了对 x86-TSO 内存模型的支持。开启这个 CPU 特性后,普通的 load/store ARM 指令会改变行为,以符合 x86 的要求。他们之所以走这条路,是因为清楚在全面转向 ARM 生态后,需要在自己的硬件上提供高性能方案。这也是为什么在他们硬件上,LRCPC load 指令其实就是 acquire-load 指令的别名——因为他们的 x86 模拟器根本不用这些指令!由于硬件直接实现了 x86 内存模型,只需用普通的 load/store 指令即可,从我们的微基准测试结果也能看出,性能开销几乎可以忽略不计。公平地说,这种全局 TSO 模式切换确实有一些性能影响,只是在这个测试中体现不出来。等 FEX 在 Asahi Linux 上检测到这个 CPU 特性后,我们也会启用它,从而"免费"获得性能提升。有人可能会担心:在 x86 模拟代码和原生 ARM 代码之间跳转时,ARM 代码会因为所有访问都变成 TSO 而承受不必要的开销。这个担忧有道理,但在模拟环境下执行的 ARM 原生代码占比几乎为 0%。作为开发者,你不会在意 1% 的内存访问慢了 10%,你真正在意的是 99% 的访问只有"理想性能"的 15%(正如 AmpereOne 的测试结果所示)。
补充一点:我们认为 TSO 模式是在平台上实现高性能 x86 模拟的最佳路线,因为它能保证每条内存访问指令的行为都符合预期。官方的 FEAT_LRCPC 扩展接连出了三个版本、每次都只是打补丁,恰恰说明了这一点。
- FEAT_LRCPC - 提供基础的 GPR TSO load 指令
- FEAT_LRCPC2 - 为 TSO load 指令增加小偏移立即数支持
- FEAT_LRCPC3 - 提供基础的向量和基于栈的 TSO load & store 指令
即便有了上述三种扩展指令,要完美模拟所有边缘情况仍然困难重重,不如硬件直接提供 TSO 开关来得干脆。我们预计随着时间推移,会出现更多扩展版本,以修复本文后文将讨论的一些额外问题。
我以为访问内存是最简单的部分?
在上一节中,我们对 ARM 硬件还算客气,遵循底层硬件的对齐要求,以此作为性能基准。然而,一旦开始模拟 x86,我们立刻撞上一个显而易见的大难题。你最喜爱的 x86 应用根本不在乎内存对齐!它们随心所欲地访问内存,跨越缓存行粒度,执行未对齐的原子操作。想想那些对齐问题的例子,这些游戏全都在这么干。这个问题严重到我们要给它起个专门的名字:split-lock(分裂锁)。它影响之大,连 Linux 内核都会捕获这种事件并因此降低游戏性能!导致许多玩家不得不折腾内核参数来避免这种降速!
不过我们先不深入讨论完整的 split-lock 情况,让我们从一个不关心对齐的环境中,单纯分析 load-store(加载-存储)指令开始。x86 对程序员做出了一些保证:如果你执行 load-store 操作,且它位于一个缓存行内部,那么该操作既是原子的,也符合前文描述的一致性模型。但为了稍微照顾硬件开发者,如果 load-store 确实跨越了缓存行,数据就不再是原子的,其他线程会看到并处理这种撕裂(tear)。因此程序员需要小心,普通的 load-store 并不等于 split-lock。
用 load-acquire/store-release 指令来模拟这些基础内存访问的问题在于,ARMv8.0 要求所谓的自然对齐。这意味着无论访问的数据尺寸是多少,其在内存中的偏移量必须与数据尺寸相匹配。例如,对于 8 字节的访问,其偏移量必须是 0、8、16、24 等。这对原生 ARM 应用来说没问题,但如果我们违反了自然对齐要求会发生什么?在 ARM 架构中,这意味着该指令会触发对齐错误。硬件会验证对齐要求是否得到满足,如果未满足,CPU 就会出错。这通常会导致崩溃,但 FEX 进行了特殊处理。
在 FEX 的 JIT 机制内部,我们会跟踪那些用于模拟 x86 load-store 的内存 load-store 指令。当某个 load-store 指令可能引发对齐错误时,代码中会存在一个所谓的补丁点。对于 load-store 指令,这表现为在 load-store 之前或之后的一个 NOP 指令。当在这些补丁点处发生对齐错误时,FEX 会捕获该错误,将代码从 load-acquire/store-release 指令修补为普通的等效 load-store 指令,并在该指令周围添加数据内存屏障。然后继续执行!
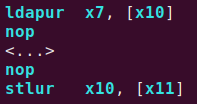
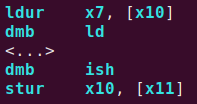
修补前与修补后
之前讨论过的关于 ARMv8.0-a 添加的那些花哨的 load-acquire、store-release 指令?当对齐行为不匹配时,我们会立即回退到经典的内存屏障指令。我们之前的图表没有显示这种糟糕的情况,所以让我们引入一些新数据。
哦,这数据量不小,需要仔细筛选。虽然再次看到在模拟 TSO 时硬件与“最优”路径差距之大是件好事,但这不是我们在这里关心的重点。值得注意的是,这个微基准测试显示常规 load/store 在对齐和非对齐情况下差别不大,因此我们只计算了二者的平均值。我们将移除 x86 CPU 数据和 ARM 列中的常规 load-store 数据,因为这些不是 FEX 的常见路径。这样,我们能更有针对性地查看非对齐内存访问在模拟下造成多大损害。
现在数据图合理多了,我们从左到右依次看看各个平台的表现。
AmpereOne
这个结果挺有意思:对齐和未对齐的加载指令性能基本相当,差异在误差范围内。也就是说,即使未对齐加载会受到数据内存屏障的惩罚,CPU 也能轻松消化。考虑到它的性能比其他平台低不少,也可能是这个基准测试的瓶颈根本不在加载上。
相比之下,存储这边就算不做未对齐操作也不太好看,在图上几乎看不见!未对齐存储会带来约 8.5% 的性能损失,但因为起点本来就很低,很难察觉。要知道,普通存储指令在这个测试里能跑出约 28GB/s,反差非常明显。
唯一能得出的结论是:Ampere 是针对某些服务器级负载做优化的,行为和消费级硬件不太一样。这是个有意思的数据点,但我们的用户一般不会在这类硬件上跑游戏。
Cortex-X4
这是一款非常主流的 CPU 核心,用在高通骁龙 8 Gen 3 上。为了不让图上的数据太挤,我们只测了 SoC 中的这一个核心。市面上有大量掌机搭载这颗芯片,所以它是个很值得关注的对象。作为榜单上唯一的手机 SoC,这颗核心的表现出乎意料地好。整体来看,它的表现符合预期,图中趋势也和下一代 Cortex 核心一致。
这颗 CPU 的要点在于:对齐加载和存储性能都不错,分别约为 11.5GB/s 和 6.7GB/s。有意思的是一旦要处理未对齐的 loadstore,性能就明显下滑——DMB 指令带来的惩罚在加载和存储两端差不多,都在这个基准测试里损失约 50%。
这似乎说明该 CPU 能同时维持相当数量的 LRCPC-release loadstore 在执行中,因此遇到 DMB 指令时损失更大,但还不至于引发灾难性的性能问题。只是因为对齐问题就损失 50%,这个成绩算不上理想。
Cortex-X925
继 X4 之后,我们再看看 DGX Spark 及其搭载的 X925 核心。这不仅是一代更新的 ARM CPU 核心,其所在系统的内存带宽也大幅提升,从之前的 76.8GB/s 跃升至 273GB/s。这意味着我们甚至能取得与 X4 相当的结果,只是图表上的数值略微高一些。有趣的是,非对齐访问带来的性能损耗与 X4 几乎一致。虽然看起来 store 操作恢复得稍快一点,可能是因为更快的内存起了帮衬作用。这里没有什么意外,各代之间保持了持续且一致的相近性能。
Oryon-3
这款 CPU 核心设计是 Qualcomm 刚发布的。Linux 支持仍在开发过程中,但它已经展现出强劲的实力。实际上,最引人注目的结果来自一个事实:对齐的 LRCPC-load 指令性能竟然追平了普通 load!这意味着,对于行为良好的应用程序,我们通常可以预期获得满血性能。这种优势延续到 release-store 指令上,它们也相当有本事,尽管没有完全追平普通 store,仅达到了 68% 的带宽。这绝对不算差的表现。
这款 CPU 同样无法逃脱非对齐 LRCPC-release loadstore 的惩罚。load 方面的性能损耗大致与 Cortex-X925 的 ~70% 相当,可能是因为 Snapdragon X2 Elite 也拥有巨大的带宽。但 store 方面情况稍显糟糕,性能仅约为 43%。即便存在这些非对齐访问的性能打击,该平台实际上仍比 Cortex 系列的对齐访问更快。
这个平台有个奇怪之处,它被宣传为拥有“完全相干的 96KB 6-way L1 缓存,采用 64B 相干粒度”。按我们的解读,这暗示非对齐访问应该会受到小得多的性能影响。有意思……先记在心里。
Apple M1
这是我们必须重点讨论的部分。这是一个改变游戏规则的时刻,堪称 ARM 领域的“苹果时刻”。它向所有人证明,ARM 不仅可行,甚至可能更快。图表中的这些数字令人惊叹,这是苹果将 TSO 内存模型直接嵌入硬件的结果。在这里,我们没有使用 LRCPC-release 访问,而是直接启用了他们的 TSO 特性,结果对齐版本与非对齐版本的性能基本持平。存储操作可能只有 5% 的性能损失?与图表上的其他设备相比,这几乎可以忽略不计。这主要归因于非对齐访问不再需要回溯插入 DMB 指令,硬件直接处理即可。
对我们而言,这就是在 ARM 上认真对待 x86 模拟的意义所在。它清楚地表明,苹果在意客户在运行原生和模拟软件时拥有良好的体验。他们看到了问题,并直接解决了它,让问题彻底消失。话虽如此,当 确实 启用 TSO 模式时,性能确实会受到影响。与上一张图表相比,它仅达到常规存储性能的 76%,而加载性能基本持平;鉴于整体性能大幅提升,这种代价是可以接受的。
关于非对齐 LRCPC/释放访问的总结
在结束这一部分之前,我们需要谈谈所有这些厂商都支持的一项性能改进。这是 ARM 推出的一项名为 FEAT_LSE2 的扩展,所有测试平台都实现了它。我们之前提到过,acquire/LRCPC/release 内存访问需要自然对齐,否则会招致 CPU 抛出对齐错误的惩罚。ARM 确实考虑到了这个问题,并实施了这项扩展,它不仅有助于 x86 模拟(也可能对其他工作负载有益),还放宽了 acquire/LRCPC/release 加载和存储指令的对齐要求,甚至 也 放宽了读写原子操作的对齐要求!
听起来不错,但残酷的现实是:这对 x86 模拟的性能提升微乎其微。这个扩展只是放宽了对齐要求,允许在 16 字节粒度内进行非对齐内存访问。任何跨越这 16 字节边界的访问仍然会触发对齐错误。而 x86 应用程序根本不在乎内存访问是否对齐,非对齐访问会遍布整个 cacheline。在 x86 上,只有读-改-写(RMW)原子操作才会尽量避免跨越 cacheline!
所以感谢这份努力,心意领了,但确实无济于事。既然已经聊到这里了,我们不妨深入看看这些 RMW 原子操作吧?
糟糕,这些原子指令是什么?
和大多数现代指令集一样,x86 支持原子内存操作。这类指令能以原子方式对内存中的数据执行 ALU 运算,不会让任何中间状态暴露出来。用 x86 的说法,它操作的内存既保持原子性又保持一致性,而 ARM 则允许你选择只保证原子性,或者同时保证原子性和一致性。前面我们简单提到过,原子地操作数据和数据的一致性其实是两回事。这有什么区别呢?
此前我们讨论 x86 内存模型时,主要关注的是读写操作对其他处理器的可见性及其引发的缓存一致性问题。而我们对这些内存访问的原子性要求避重就轻。在 x86 架构中,读写操作 通常 即使非对齐也能原子性地完成。这意味着,如果你写入 8 字节数据,同时另一个线程在竞争条件下读取这 8 字节,它绝不会看到写入前和写入后数据混合的撕裂现象。而在 ARM 架构中,这些原子性保证 显著 较弱:执行非对齐存储指令时,ISA 规范对于读取到数据 撕裂 的情况毫无保证。庆幸的是,对于 自然 对齐的读写指令,ARM 有一个名为 “单拷贝原子性” 的规范,保证这类访问不会出现撕裂。还有一个好消息;之前提到的 FEAT_LSE2 扩展?它实际上将单拷贝原子性保证延伸到了 16 字节粒度内的 任意 非对齐访问!不足之处在于,x86 对整个缓存行范围内的访问都提供单拷贝原子性保证,所以这个扩展仍然没有完全解决问题,只是减少了出现问题的次数。
关于原子性和一致性的差异就说到这里。实际的原子指令在哪里?它们起什么作用?从 ARMv8.1-a 开始,我们的 ISA 增加了行为上主要匹配 x86 原子指令的指令。让我们直接列出完整清单,以展示它们在 JIT 编译器中如何直接映射。
| x86 | ARMv8.1-a |
|---|---|
| LOCK DEC | ldaddal |
| LOCK INC | ldaddal |
| LOCK NEG | ??? |
| LOCK NOT | ldeoral |
| LOCK ADC | ldaddal |
| LOCK ADD | ldaddal |
| LOCK AND | ldclral |
| LOCK OR | ldsetal |
| LOCK SBB | ldaddal |
| LOCK SUB | ldaddal |
| LOCK XADD | ldaddal |
| LOCK XOR | ldeoral |
| LOCK BTC | ldclralb |
| LOCK BTR | ldeoralb |
| LOCK BTS | ldsetalb |
| LOCK CMPXCHG | casal |
| CMPXCHG8B | caspal |
| CMPXCHG16B | caspal |
看看这份清单,它列全了 18 个原子 RMW(读-改-写)操作,并且它们基本可以直接映射到某些 ARM 指令上。我们可以先忽略其中那个比较存疑的指令,因为它在实际工作负载中很少被用到,深入讨论它只会让我们陷入不必要的细节泥潭。两套架构之间似乎存在非常清晰的 1:1 映射关系,事情就此结束了吗?这就是 x86 模拟的有趣之处:即便我们有这些对应的指令,也不意味着我们可以直接接线而无任何问题。我们花了大量篇幅讨论非对齐访问如何严重拖累普通加载和存储的性能,同样的问题也适用于 RMW 原子操作!
在这张图表中,我们关注的是单条原子指令,其内存地址落在某个缓存行内的某处。如果把全部 18 种原子操作的数据都放进来,这些信息量只会比现在更加 overwhelming(不堪重负)。所有这些原子操作的行为大致相当,因此列出它们显得多余,对我们这里要讨论的内容也没有实质影响。这也是本帖中第一张使用对数刻度的图表,所以阅读时请务必注意,最快和最慢结果之间的性能差异大约达到了 1000 倍量级。
先来看图表中的 x86 Zen 处理器;这些是我们模拟应当努力达到的基准结果。我们可以看到,如果访问完全包含在一个缓存行内,那么指令的延迟都是 1.44ns。这可以用 x86 的“原子缓存行”或“一致性缓存行”来解释:只要非对齐的原子操作保持在同一个缓存行内,其成本大致相同。这是 x86 一项极其强大的特性,数十年来一直得到支持,游戏甚至会在毫无察觉的情况下重度依赖它。x86 中最突出的结果是最后一个,它跨越了 64 字节粒度,耗时约 660ns!这是一个惊人的慢速结果,比其他结果慢了约 458 倍,因为此时硬件终于启用了拆分锁定(split-locks)。
这里得先提一下 Chips and Cheese 在我们准备撰写本文时发布的一篇文章。他们深入剖析了为什么这些 split-lock 会慢得如此夸张,如果你还不了解它的工作原理,很值得一读。特别要指出的是,x86 的 split-lock 需要维持 x86-TSO 的原子性和一致性要求,即使数据跨越 cacheline,也绝不会出现撕裂(tearing)。这有点离谱,后面我们会详细解释。
再来看 ARM 处理器,先从自然对齐的延迟数据说起。可以看到,所有平台的表现都还不错,但即便是最新一代的核心,也远远追不上 x86。我们最快的 ARM 平台延迟也是 x86 的约 3 倍;这会直接影响游戏性能,不过通常不是直接瓶颈,所以很难精确量化影响有多大。再看下一个数据点:由于 ARM 规范对非对齐原子操作的定义方式,16 字节粒度和 64 字节粒度跨越的结果在大多数 ARM 平台上大致相当,因此可以合并来看,FEX 也把它们当作与 x86 split-lock 相同的问题处理。
我们反复提到 split-lock 问题,但 FEX 到底是怎么模拟它的,又为什么这么慢?可能有人会问:“Apple M1 不是已经在硬件上支持 x86-TSO 了吗,为什么还是慢?”还记得我们之前提到过 FEAT_LSE2 在 16 字节粒度内支持非对齐内存访问吗?这些 split-lock 操作恰好撞上了同样的对齐问题,而且慢得多。FEX 无法把这些指令回补丁成一条 DMB 操作,所以每次执行都会触发一次 alignment-fault。这意味着每当有 split-lock 操作执行时,都要走一遍 内核 -> 用户态信号处理函数 -> 内核 -> 回到原代码 的流程——每—次—都是。内核态和用户态之间的切换在任何平台上都不便宜,而每秒成千上万次切换,开销会迅速累积。这就是为什么在 ARM 上模拟这个特性会慢得如此可怕。
不过,如今有一款 ARM 平台实际上部分解决了这个问题。高通引入的 Oryon-3 CPU 核心带来了他们宣传的“一致性缓存行(coherent cachelines)”特性,我们在微基准测试中观察到了这一点。与 x86 类似,只要原子内存访问发生在 64 字节缓存行内部,其性能就能与天然对齐版本持平!这是巨大的进步,意味着该 CPU 在功能支持上已经与 x86 持平,直到需要跨缓存行操作时才会落后。我们需要称赞高通实现了这一特性,因为它解决了 x86 模拟中关于 split-locks(拆分锁)的主要性能和正确性问题。不过,硬件仍不支持 64 字节的 split-locks,因此在这种情况下我们依然会回退到 FEX 模拟路径。
接着看苹果的结果;尽管他们不知为何在硬件中添加了 x86-TSO 内存访问支持,却像 Oryon 那样忽略了实现完整的非对齐缓存行原子操作。他们本应预见到这种边缘情况并加以实现,但这只是推测。这就是为什么即使开启了 TSO 硬件开关,跨越 16 字节粒度的行为依然与其他平台相同。
你可能还会注意到图表中另一个小数据怪癖。在这个基准测试中,Cortex-X4 的结果带有一个星号,其非对齐原子操作的延迟远低于那些更新发布的 CPU。它设法将延迟控制在约 209 纳秒,而 X925 的延迟高达 1060 纳秒;这是 5 倍的性能提升!这是怎么做到的?这其实是我们在测试的平台上搭载的一些“独门秘技”,该平台当然是 Valve Steam Deck。由于 Valve 关心现有游戏库的性能,他们随机器附带了一个由一位 FEX 开发者编写的内核补丁。该补丁允许 Linux 内核自身处理非对齐原子操作,无需与 FEX 和用户态进行那套缓慢的交互,从而实现大幅加速。如果其他平台希望在内核中引入此补丁,我们建议直接采用,FEX 会自动开始使用它。
既然提到了内核干预,我们就得聊聊 FEX 中 split-lock 仿真为何在准确性上存在欠缺,这主要受限于硬件本身。要正确实现 x86 这一强制性特性,每当发生 16 字节或 64 字节的 split-lock 时,唯一的应对方式就是让内核来实现该功能。目前,FEX 对此采用的是“尽力而为”的策略,在某些情况下这会导致数据撕裂。回想一下,我们之前说过 x86 上的 split-lock 永远不会撕裂,对吧?即便是拥有“一致性缓存行”的 Oryon-3,目前也尚未解决这一问题。
为什么说 split-lock 是强制性的?
在当今的 ARM 硬件上,以高性能方式实现 split-lock 仿真其实非常困难。一种朴素的实现方案是使用全局互斥锁,每当发生 split-lock 时,确保在执行操作前获取该互斥锁。这意味着任何参与的 split-lock 操作都必须经过这个互斥锁。这种做法在正确性上没有问题,除了一个例外:任何对齐的原子操作都不属于 split-lock,因此不会参与此过程。由于 split-lock 仿真代码需要实现为两个 64 位比较交换操作,且每一半都跨越粒度边界,即便存在非参与的原子操作,我们仍可能发生数据撕裂。一个简单的例子是:一个线程不断修改缓存行中间的一个原子变量,而另一个线程仅修改其中一半的整数。起初这听起来像是为了举例而生造的,但实际上存在行为完全一致的无锁 链表 实现!取决于对齐线程正在修改哪一半,split-lock 代码中的第一个或第二个 CAS 操作会失败。如果第一个 CAS 失败,这是安全的,代码可以重试;但如果第二个 CAS 失败,则意味着数据已经撕裂,我们除了祈祷它不会破坏数据或导致崩溃外别无他法。这完全取决于来宾应用所使用的算法,因此我们无法控制。
还有一种完全行不通的方案:让内核追踪所有共享内存的进程和线程,当某个线程需要模拟 split-lock 时,内核暂停所有与之共享内存的进程,单独完成这个 split-lock,然后再恢复整个系统。这种做法的性能完全不可接受。应用和游戏可能每秒执行成千上万次 split-lock,频繁暂停整个系统带来的性能损失会严重到连原生 x86 都远远不如。
如果要保证 split-lock 模拟的正确性,FEX 就需要某种形式的硬件支持。当然,这并不是说所有原子操作都要像 x86 那样支持 split-lock——那同样不现实。好消息是,ARM 其实有一个恰好能满足需求的扩展,叫做Transactional Memory Extension(事务内存扩展)。它允许代码在事务区域内执行若干操作,然后原子性地提交;如果提交失败,直接重试即可。那这个扩展的问题在哪?ARM 已官方弃用它,而且从未有硬件真正实现过。这或许反而是好事——x86 上的同类扩展问题层出不穷,最终在许多平台上都被禁用了。
所以要正确模拟 split-lock,还得另寻他法。针对一个我们认为同时满足 FEX 和 ARM 厂商需求的方案,我们的想法是:让 128 位 CASP 指令获得一种特殊能力——当它的两个 64 位部分恰好横跨原子粒度边界时(低 64 位一部分、高 64 位一部分),只有在这种情况下指令不触发对齐错误,而是尝试执行 CAS 操作。这是可行的,因为 x86 的非对齐原子操作最多只有 64 位,所以这两半始终能被我们的这一次操作完整覆盖。
你可能会问:“这跟硬件直接支持拆分锁相比,好在哪里?” 这个想法很有道理,我们需要谨慎措辞来描述这一操作。对于 x86 架构,原子操作必须始终成功且不产生撕裂读。而在我们的模拟方案中,可以让 ARM 的 CASP 指令安全地失败,然后重试。CAS 操作的一大优势就在于此:它可能因任何原因失败,但必须再次尝试。该指令还会返回从内存加载的数据,从而让程序获取最新的内存状态。这是一个重要区别,意味着 FEX 可以无限次重试 CAS 操作,直到最终成功!这是 ARM LL/SC 架构的一大好处,基本使得这种方案可行。一个棘手的地方是,硬件确实需要在某个时刻保证向前推进,但由于其他原因,硬件本身已具备支持这种机制的能力,所以完全可行!CAS 指令新增的唯一故障模式纯粹是:在执行完整操作之前,其中一条缓存行被另一个核心获取。即使硬件仍需多达数千个周期来保证向前推进,这也基本符合 x86 的行为。
我们认为,这是在 ARM 平台上模拟 x86 拆分锁的最佳前进方向,但我们不是硬件架构师,只能抱怨并希望有人能为我们解决这个问题。我们就在此打住关于拆分锁的讨论,接下来探讨另一个有趣的问题。
等等,非缓存内存也需要能工作吗?
在进入主题之前,我们需要厘清“uncached”这个术语,因为在不同语境下它可能有多种含义。本文主要关注游戏场景,因此采用 Vulkan 的术语体系。Vulkan 中定义了 VK_MEMORY_HOST_CACHED_BIT,表示该内存会被宿主机 CPU 缓存。我们关注的是缺少该标志的情况,即“uncached”。从内存子系统的角度来看,情况比想象中更复杂。特别是当内存位于 GPU 上且通过 PCIe 连接时,若内存被标记为“uncached”,通常(但并非总是)会同时获得 VK_MEMORY_HOST_COHERENT 标志。这意味着,由于内存具有不可缓存的特性,CPU 和 GPU 之间始终共享一致的内存视图。
对于 CPU 而言,这类内存通常有三种映射方式。申请“cached”内存时,通常对应 Write-back(写回)类型,这也是常规内存映射的类型。“uncached”映射则可能是 Write-Combine(写合并)或“Strong Uncacheable”。由于“Strong Uncacheable”在用户态应用程序中几乎不存在,因此我们在此可以忽略。因此,实际可用的内存类型主要限定为 WB(cached)和 WC(uncached)两种。游戏通常使用 cached 内存作为暂存缓冲区,而在直接向 GPU 传递数据时,则使用 uncached 内存。
很多游戏引擎的代码里都有这样一条硬性规定:如果不提供 uncached 缓冲区类型的支持,有些引擎根本跑不起来。这背后的根源在于 UMA 系统(如 APU)与 PCIe 独显之间的行为差异。UMA 系统通常可以分配同时具备缓存、一致性和 GPU 可见性的内存,而 PCIe GPU 无法保证这一点,所以游戏开发者要么用一个 staging buffer 异步把数据拷贝到 GPU,要么用“uncached”内存,小心翼翼地通过 PCIe 把数据一点点搬到 GPU 上。由于 PCIe 在 PC 游戏中太普遍了,有些引擎干脆连 UMA 专属的代码路径都不写,一律走 uncached 方案!
铺垫了这么多,现在大家应该明白 uncached 对我们意味着什么了。接下来看看几款 UMA 架构的 Snapdragon 平台上缓存内存的速度基准测试,好建立一个正常情况下的性能基线。
无论是 Steam Frame 还是 Snapdragon X2 Elite,结果都相当不错。正如预期,Oryon-3 平台的内存带宽更高,图表中的成绩也相应更高,但两者都达到了每秒几十 GB 的水平。这张图给“正常的”write-back 内存性能树立了一个很好的基准。下面再看看 uncached 的成绩,对比一下性能差距。
这里出现了一些奇怪的现象,所以这张图又得用对数坐标。先说好消息:由于 uncached 内存缓冲区是 write-combine 的,我们可以看到 ARM 平台上普通写入操作的成绩和缓存基准基本持平。这是因为 write-combine 内存使用了所谓的 write combine buffers(WCB),它会极其短暂地暂存一个 cacheline 的数据,让 write-combine 可以按 cacheline 为单位突发写入。有意思的是,Zen 4 的 WCB 似乎比不过缓存写入,但考虑到这些数据本来就要走 PCIe 总线,这点差距应该无伤大雅。
现在来看看这里最令人头疼的结果。先从容易解释的开始:在所有测试平台上,写合并(write-combined)内存的加载带宽都惨不忍睹。如果以 Zen 的性能作为基准,ARM 的常规加载指令虽然略胜一筹,但 LRCPC 加载指令的表现反而更差。这是为什么?这是写合并内存机制的一个怪癖:由于它不经过缓存,为了维持语义正确性,每次加载指令都必须直接访问系统内存。在此基础上再叠加 LRCPC 加载,只会让问题雪上加霜。但这其中最糟糕的,还得是存储性能——与 Zen 的存储性能相比,差距堪称毁灭性,基本上直接一票否决。带宽最高相差 816 倍!受此性能断崖影响,《Hollow Knight: Silksong》和《Subnautica 2》等游戏的运行帧数甚至不到 1FPS。
正如上文所述,当系统配备 PCIe 显卡时,游戏必须使用非缓存内存来向 GPU 传递数据。在拥有独立 PCIe 显卡的平台上模拟 x86 游戏时,我们陷入了毫无胜算的困境,性能必然大幅下滑。还记得 ARM 之前引入的 FEAT_LRCPC1/2/3 扩展系列吗?其初衷正是为了改进 x86 内存模型的模拟效果。然而,当我们遇到这些扩展尚未支持的边缘用例时,就会发生上述情况。所有这些扩展都新增了用于按 x86-TSO 内存模型语义加载内存的指令,但没有一个能解决以 x86-TSO 语义向写合并内存进行存储的问题。自 ARMv8.0-a 起,我们的存储指令始终使用常规的 store-release 指令,完全不考虑底层内存类型。FEX 应对这一问题的唯一办法,就是在问题出现时选择性关闭 TSO 模拟。因此,配备 PCIe 显卡的 x86 模拟平台体验将始终劣于 UMA 架构。除非未来出现 FEAT_LRCPC4 或类似扩展来解决这一问题,否则局面难以改变。
对于使用 UMA 架构的用户,你们有福了。我们找到了一种提升游戏性能的技巧:既然平台支持缓存一致的 CPU 和 GPU 组合,视频驱动可以始终使用缓存缓冲区,从而彻底避开这一问题。NVIDIA 在其 Tegra 平台上已经实现了这一点,骁龙平台自 Adreno 600 级别 GPU 起便提供支持,许多 Mali 平台同样具备此能力。我们有一个 Adreno Turnip 补丁,确保当 FEX 运行时,支持该特性的平台绝不会触及非缓存内存。有趣的是,Asahi 用户由于硬件带有 TSO 位,在野外环境中自然就不会遇到这个问题,但要在该平台上接入 PCIe GPU 则完全是另一回事。还有一个怪癖:ARM 平台上的 Radeon GPU 会将所有写合并(write-combine)内存隐藏起来,改以写回(write-back)模式运作,这个话题留待日后详述。
展望更光明的未来
读完这篇长文后,希望你对模拟 x86-TSO 内存模型所面临的诸多挑战有了更深入的理解。我们最初以 ARMv8.0 作为最低规格标准,而硬件在过去几年间取得了令人叹为观止的惊人进步。尽管架构层面并非所有边缘案例都已解决,但整个生态系统似乎在认真致力于改善最坏情况。各家厂商正在解决问题的部分环节,推动兼容性向前发展。也许十年后回顾此刻,我们会为当下遇到的问题发笑,同时享受那些永远不会有 ARM 移植版的高质量 x86 游戏。无论最终在何处游玩,都要让 PC 游戏生态的遗产延续下去。
写于 2026 年 9 月 17 日