
EP225:为什么 Git 回退(Revert)会导致冲突?
金鱼其实是个被误解的家伙。它们其实能记好几个月,而不是几秒钟。相比之下,你的 Agent 在上下文窗口填满的那一刻,就把所有事情都忘了。
说实话,你的 Agent 记忆力还不如一条金鱼。这是及格线。借助合适的基础设施,这条线并不难突破。
这个系列会通过五次 15 分钟左右的直播,基于 Redis Iris 搭建一个具备上下文感知能力的应用,每次解决一个关键缺口:
第一场: 搜索(9 月 16 日)
第二场: Agent 记忆(9 月 23 日)
第三场: 上下文检索(9 月 30 日)
第四场: 语义缓存(10 月 7 日)
第五场: 完整构建上下文感知应用及实际用例(10 月 14 日)
本周系统架构回顾:
为什么 Git Revert 会导致冲突?
每个工程师都该知道的 12 个 Claude Code 特性
对称加密与非对称加密
负载均衡器的 7 个关键用例
缓存系统会出哪些错?
ByteByteGo Live 上线
为什么 Git Revert 会导致冲突?
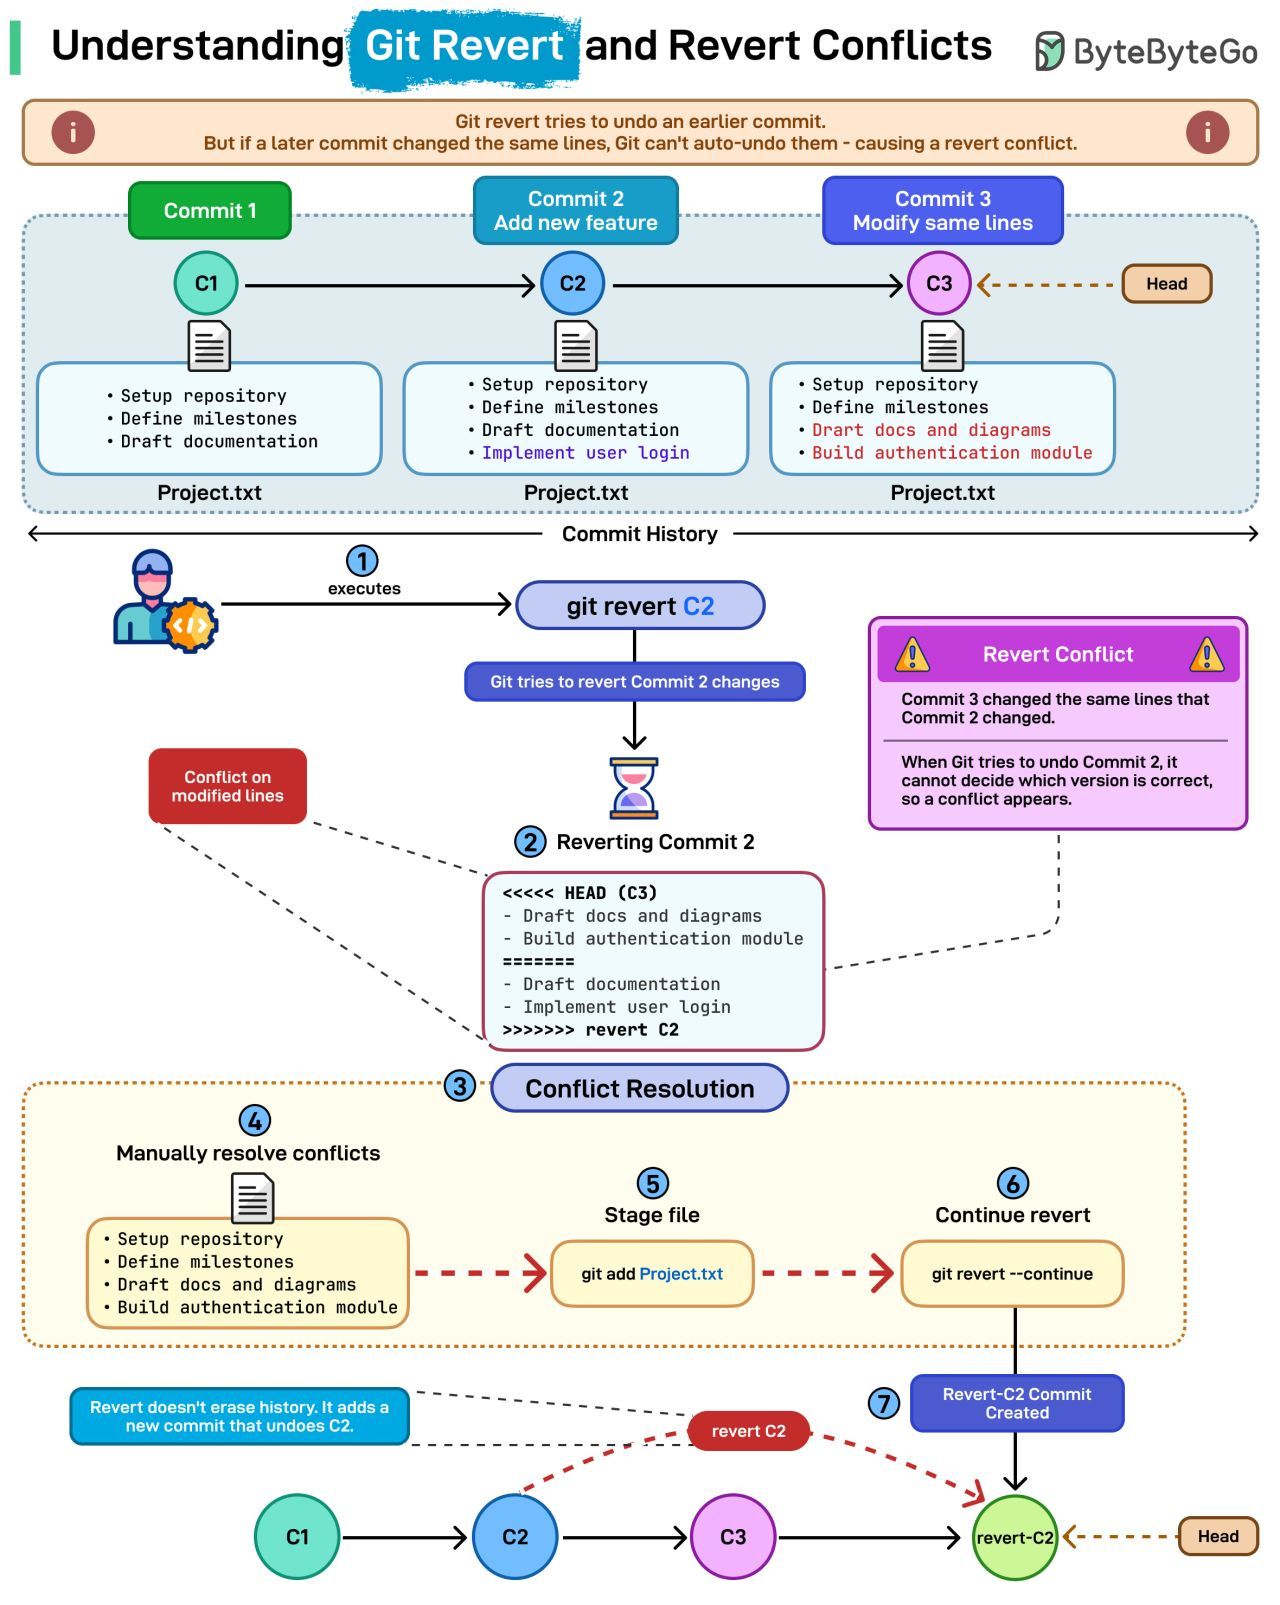
git revert 乍一看很直白,但它抛出冲突时就不简单了。以下是冲突产生的原因。
git revert 究竟做了什么:与 reset 不同,revert 不会重写历史。相反,它创建一个新提交,用来撤销之前某次提交的变更。这样能保持历史干净、可追溯,且对共享分支是安全的。
为什么会产生撤销冲突:当你试图回退某个提交时,如果后续提交修改过同一部分代码,冲突就会随之出现。
结合上图的例子:
提交 C2 添加了新功能
提交 C3 修改了这些相同的行
此时撤销 C2 会与 C3 的修改发生冲突
Git 无法判断哪个版本是正确的,因此触发了撤销冲突。
如何解决:
1. 运行 git revert C2
2. Git 遇到冲突时会暂停
3. 手动修复文件
4. 暂存修改
5. 继续撤销流程
Git 随后会创建一个新提交,在彻底撤销 C2 的同时保留 C3 的内容。
现在轮到你:你曾在最糟糕的时刻遭遇过撤销冲突吗?当时是如何解决的?
每个工程师都应了解的 12 项 Claude Code 功能
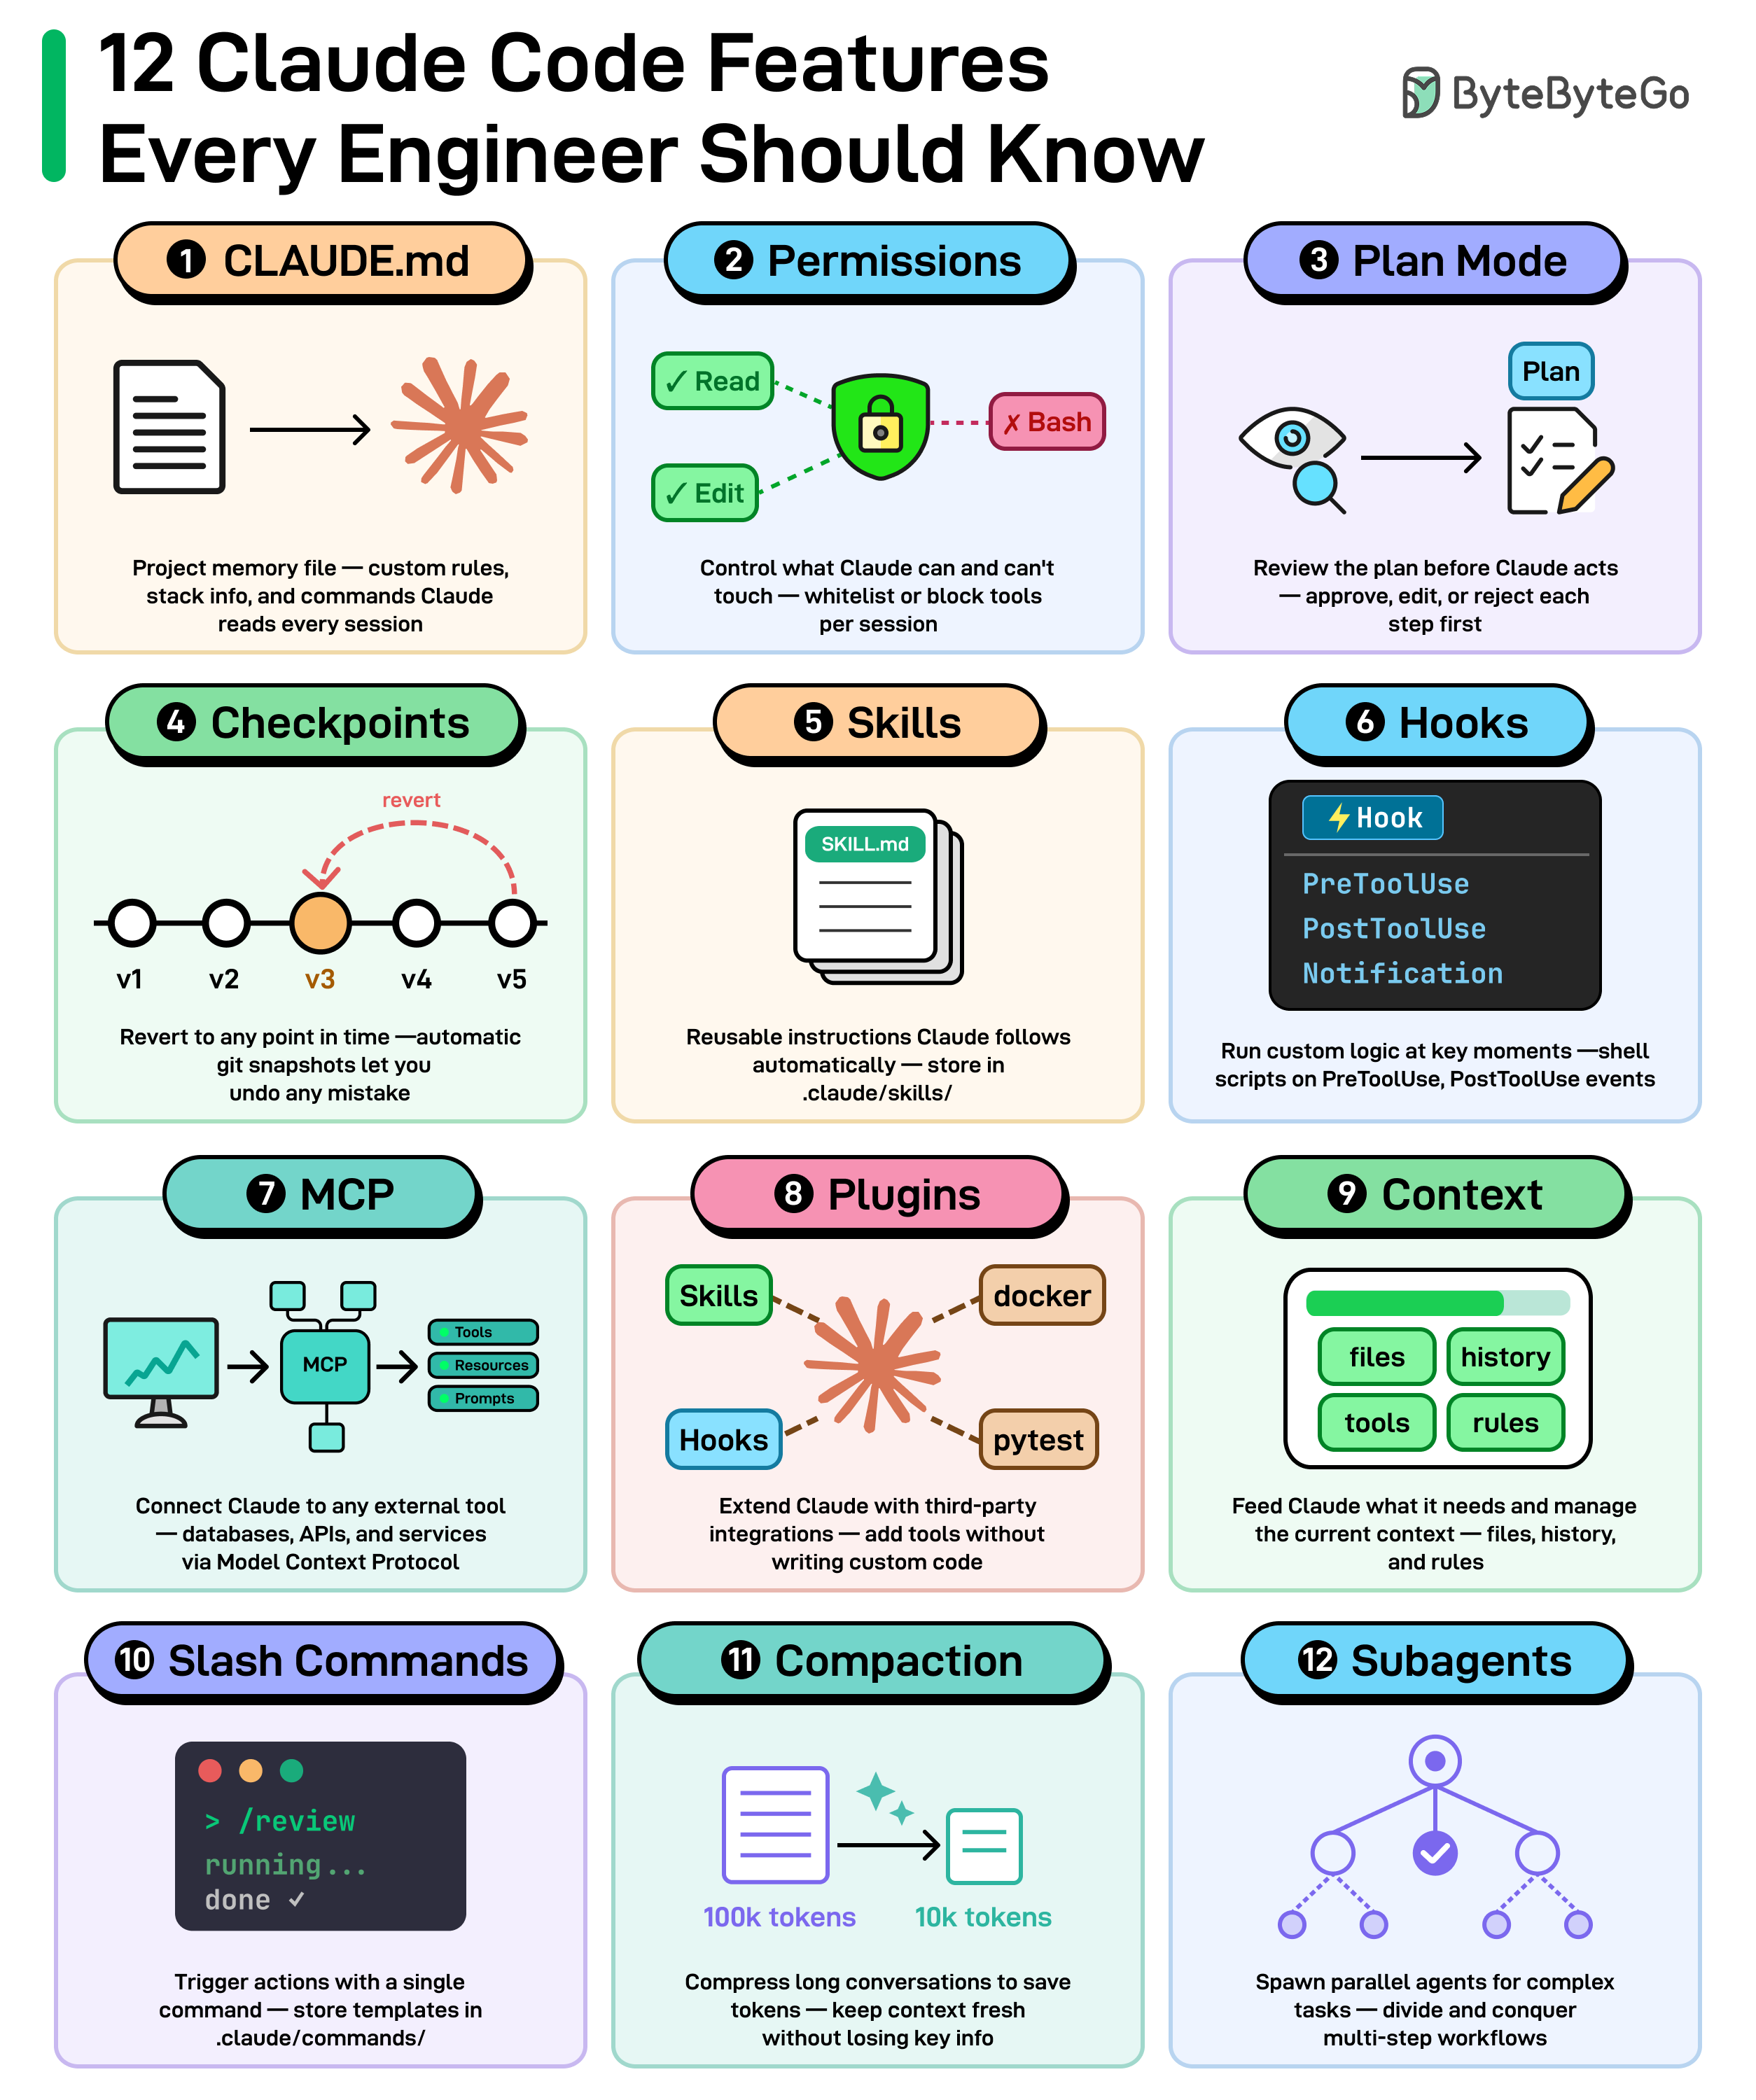
CLAUDE.md:项目记忆文件,用于定义自定义规则和约定。Claude 会在每次会话开始时读取它。
权限:控制 Claude 可以或不可以使用的工具。
计划模式:Claude 先规划再行动。你可以先审查计划,再执行任何代码变更。
检查点:自动为项目创建快照,以便在出问题时快速回退。
技能:Claude 自动遵循的可复用指令文件。
钩子:在 PreToolUse 或 PostToolUse 等生命周期事件上运行自定义 shell 脚本。
MCP:将 Claude 连接到数据库和第三方服务等外部工具。
插件:通过包含技能、MCP 和钩子的第三方集成来扩展 Claude。
上下文:向 Claude 提供所需信息,并使用 /context 管理当前上下文窗口。
斜杠命令:为高频任务创建快捷方式。输入 / 即可从已保存的命令中选择。
压缩:压缩长对话以节省 token。
子代理(Subagents):为复杂任务并行派生多个代理,把大型多步骤工作流拆分后同时运行。
轮到你了:你最常用 Claude Code 的哪个功能?还有什么功能你希望出现在这份清单里?
对称加密 vs. 非对称加密
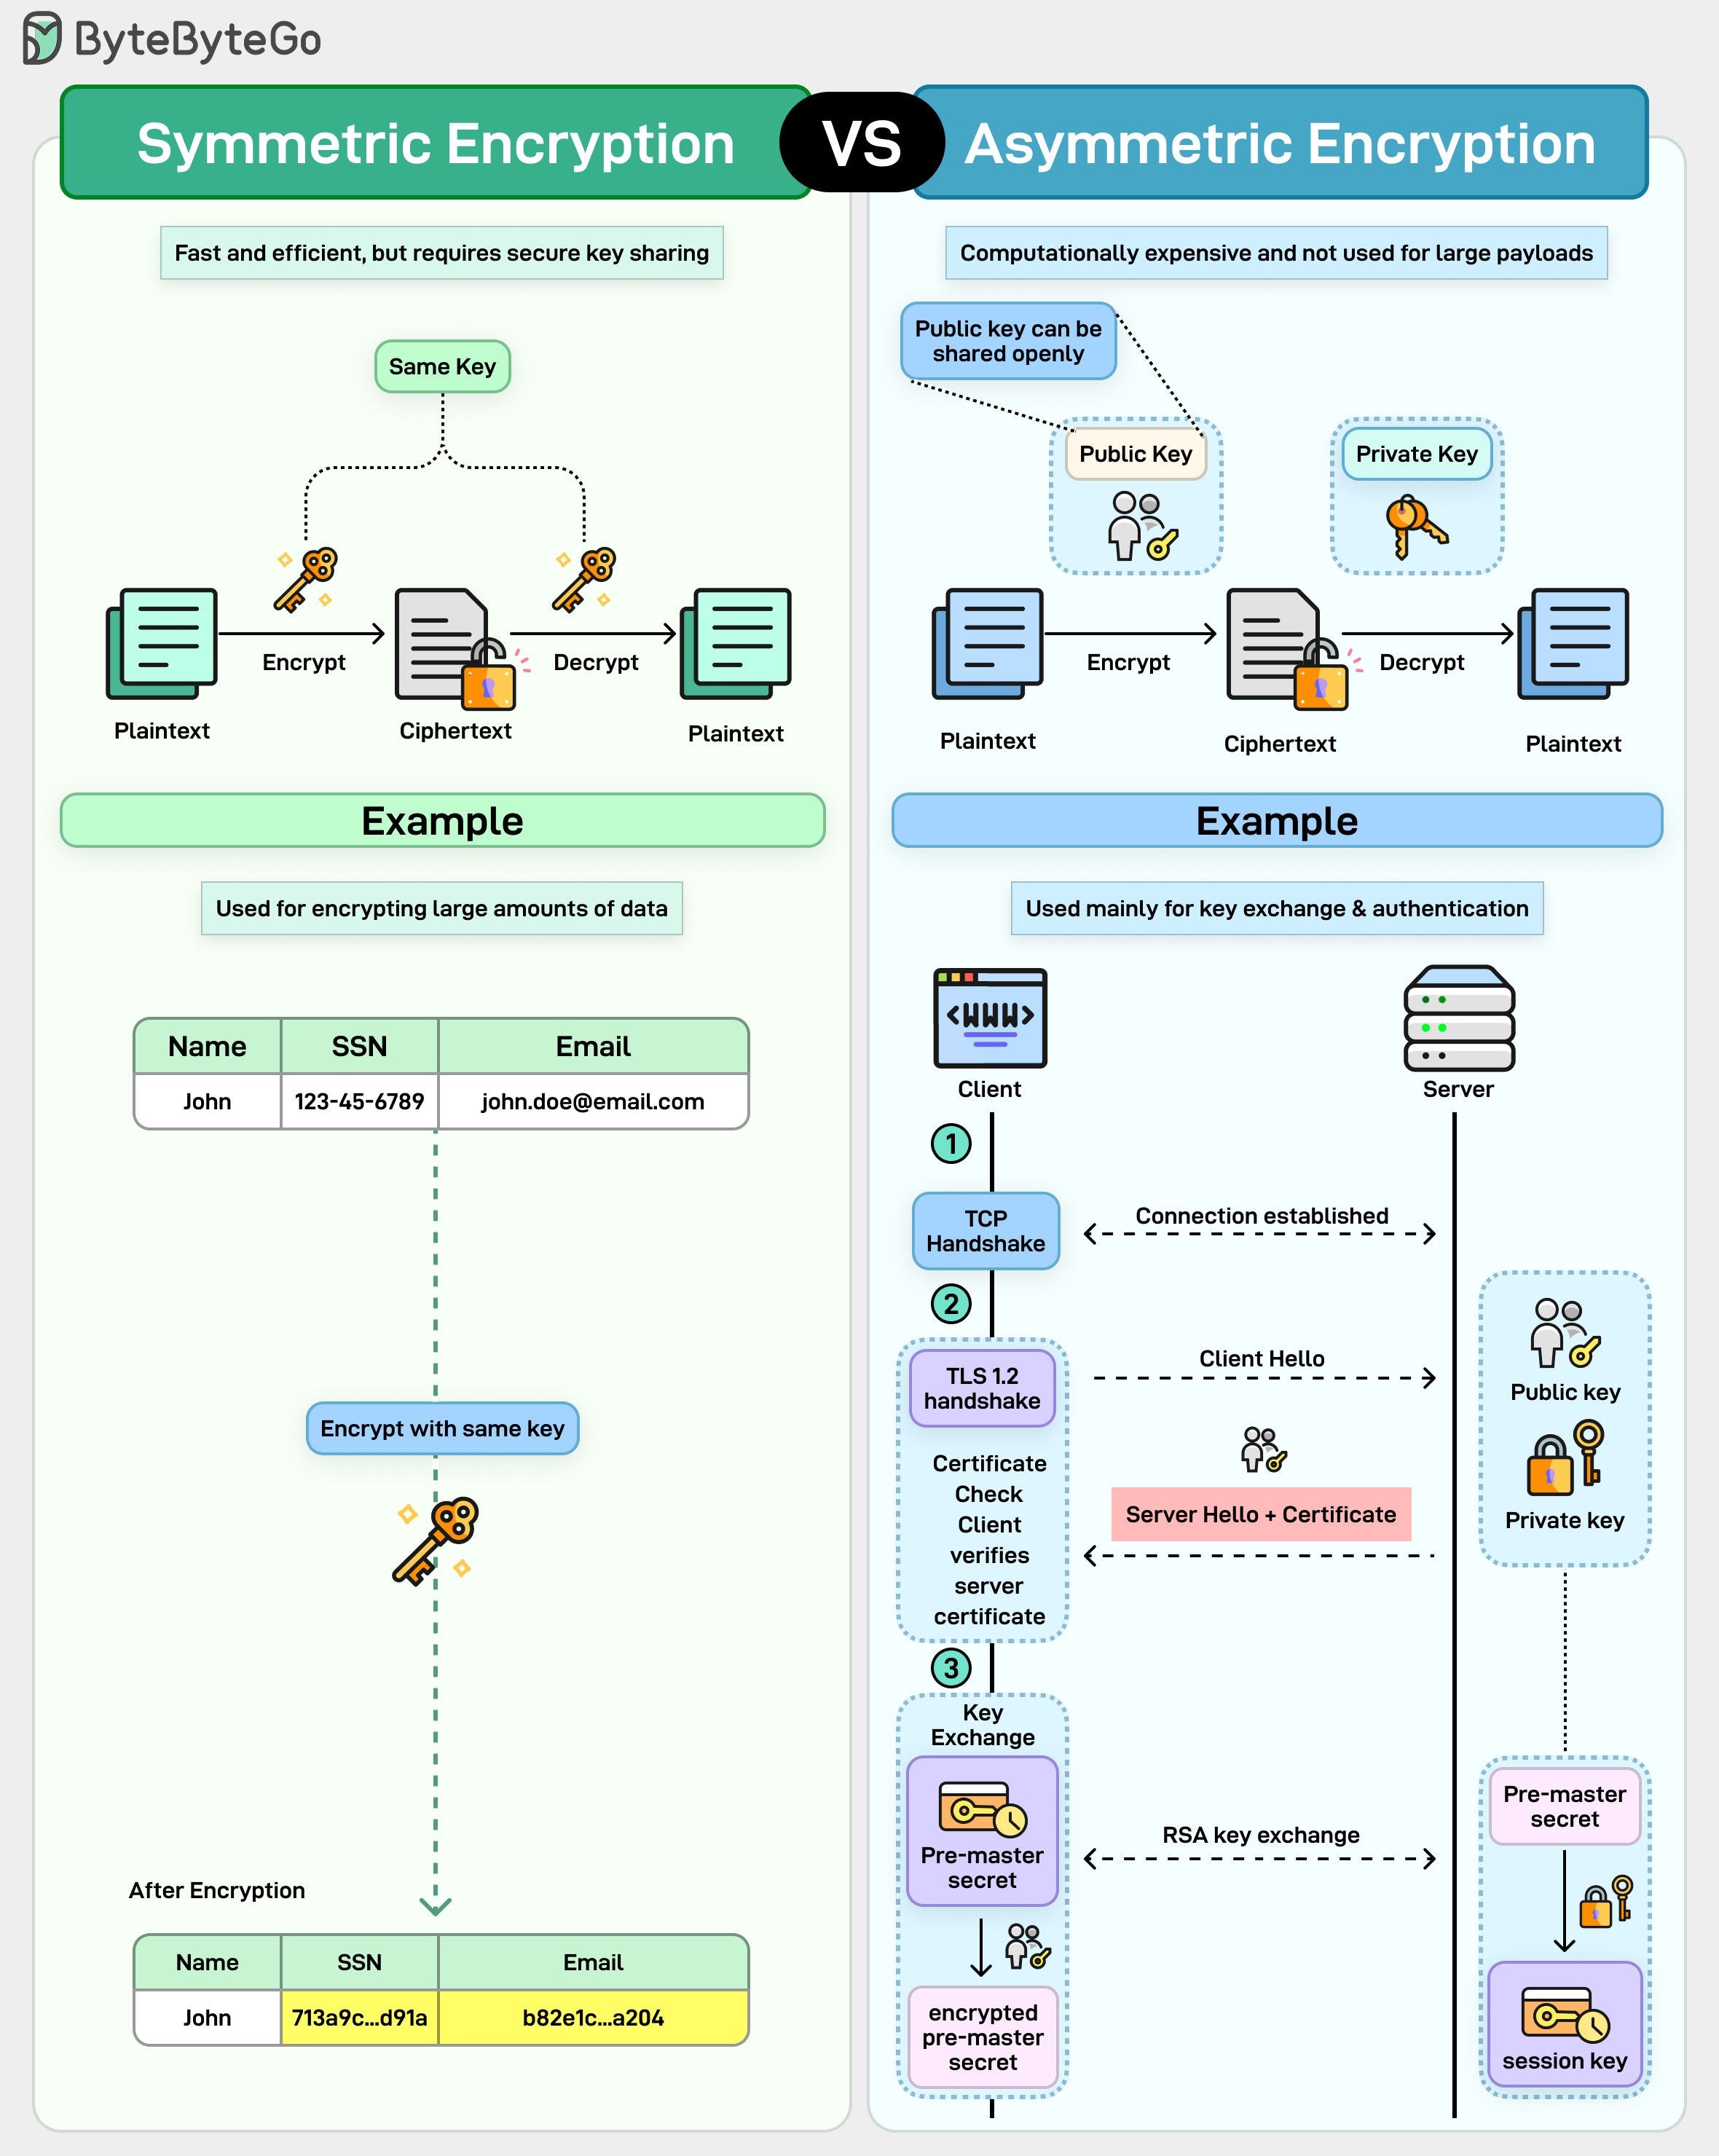
对称加密和非对称加密经常放在一起讲,但它们解决的是完全不同的问题。
对称加密只使用一把共享密钥,加解密用的是同一把钥匙。它速度快、效率高,非常适合处理大量数据,所以常用于加密文件、数据库记录和消息载荷。
但问题在于密钥分发:通信双方必须事先持有这把密钥,而如何安全地传递它是个难题。非对称加密使用一对密钥:公钥可以分发给任何人,私钥则自己保管。用公钥加密的数据,只能用私钥解密。
这样就省去了事先安全传递密钥的麻烦,但也有代价——它速度慢、计算开销大,不适合加密大数据量。
因此,非对称加密通常用于身份认证、鉴权和密钥交换,而不是批量数据加密。
轮到你了:在系统设计中,你见过关于加密最常见的误解是什么?
负载均衡器的 7 个关键使用场景
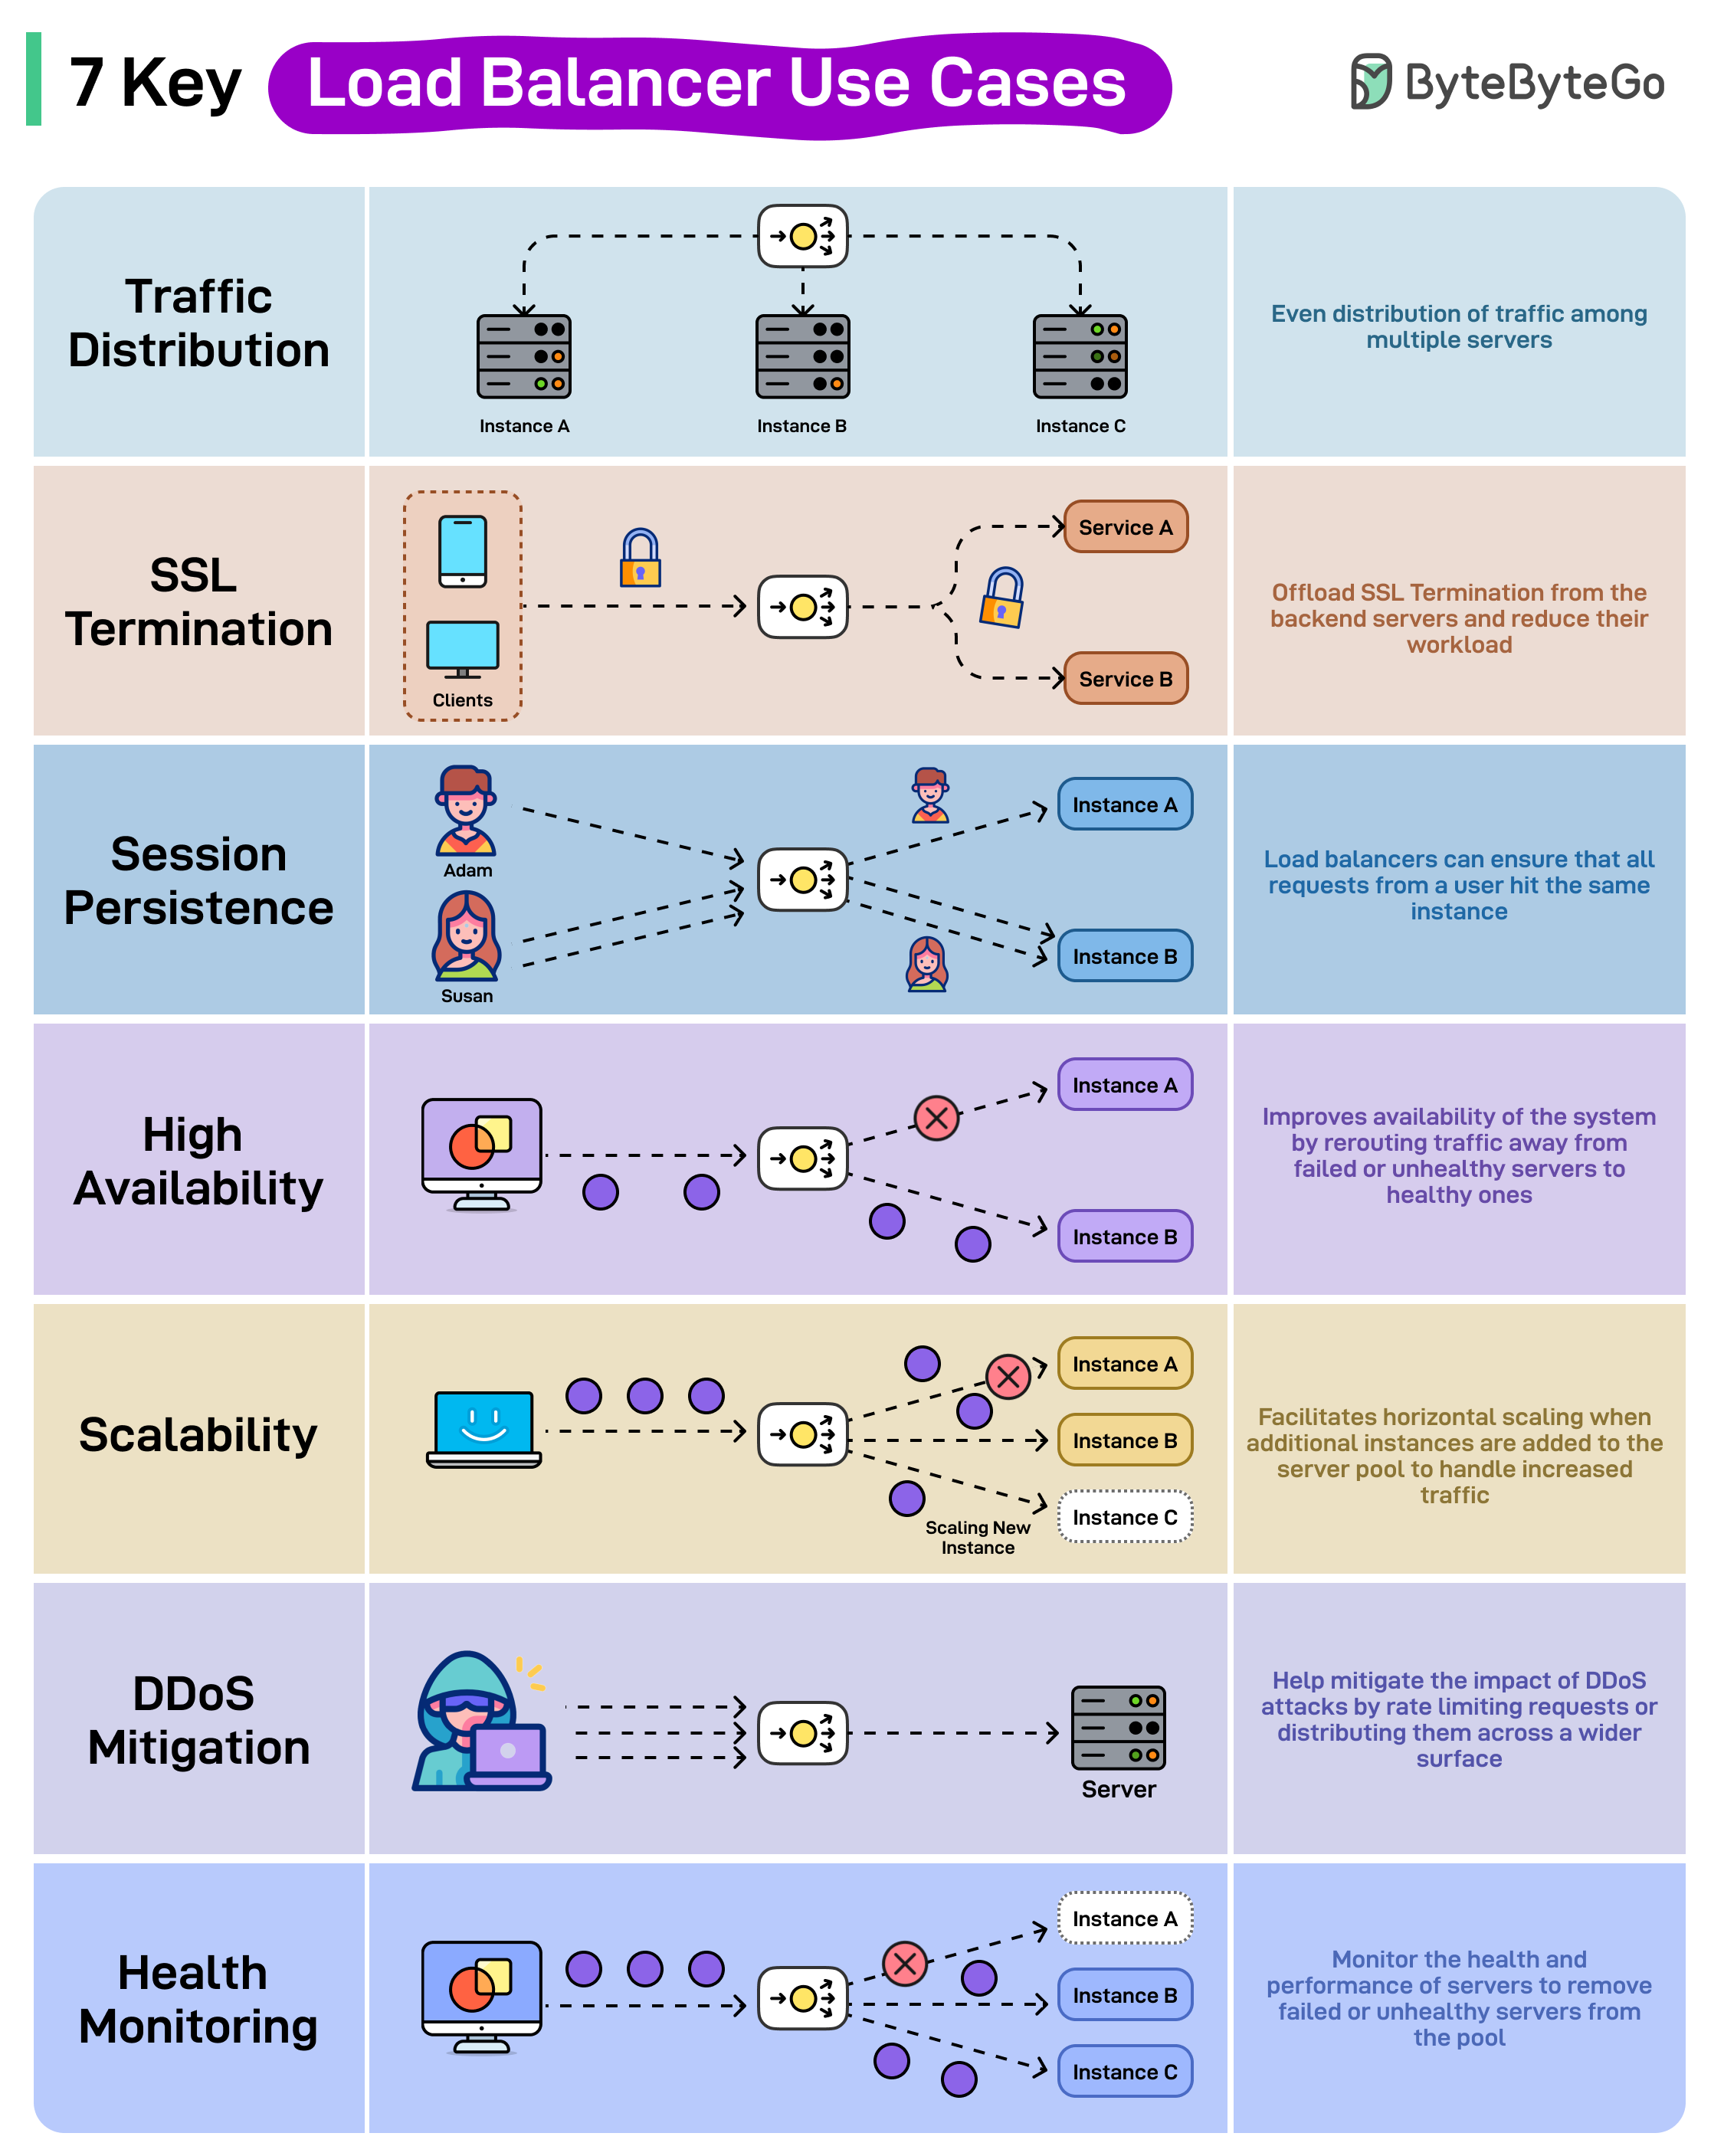
流量分发:负载均衡器有助于在多个服务器实例间均匀分配流量。
SSL 终结:负载均衡器可以承接后端服务器的 SSL 终结任务,从而减轻其负载。
会话持久性:确保来自同一用户的所有请求都指向同一实例,以维持会话状态。
高可用性:通过将流量从故障或不健康的服务器重定向到健康服务器,提升系统可用性。
可扩展性:当服务器池中新增实例以应对流量增长时,负载均衡器支持横向扩展。
DDoS 缓解:通过限制请求速率或将流量分散到更广泛的范围,减轻 DDoS 攻击的影响。
健康监控:监控服务器实例的健康状况和性能,并将故障或不健康的实例从池中移除。
轮到你了:你会往这份清单里补充哪些其他负载均衡器使用场景?
缓存系统哪里容易出问题?
下图展示了缓存出错的四种典型场景及其解决方案。
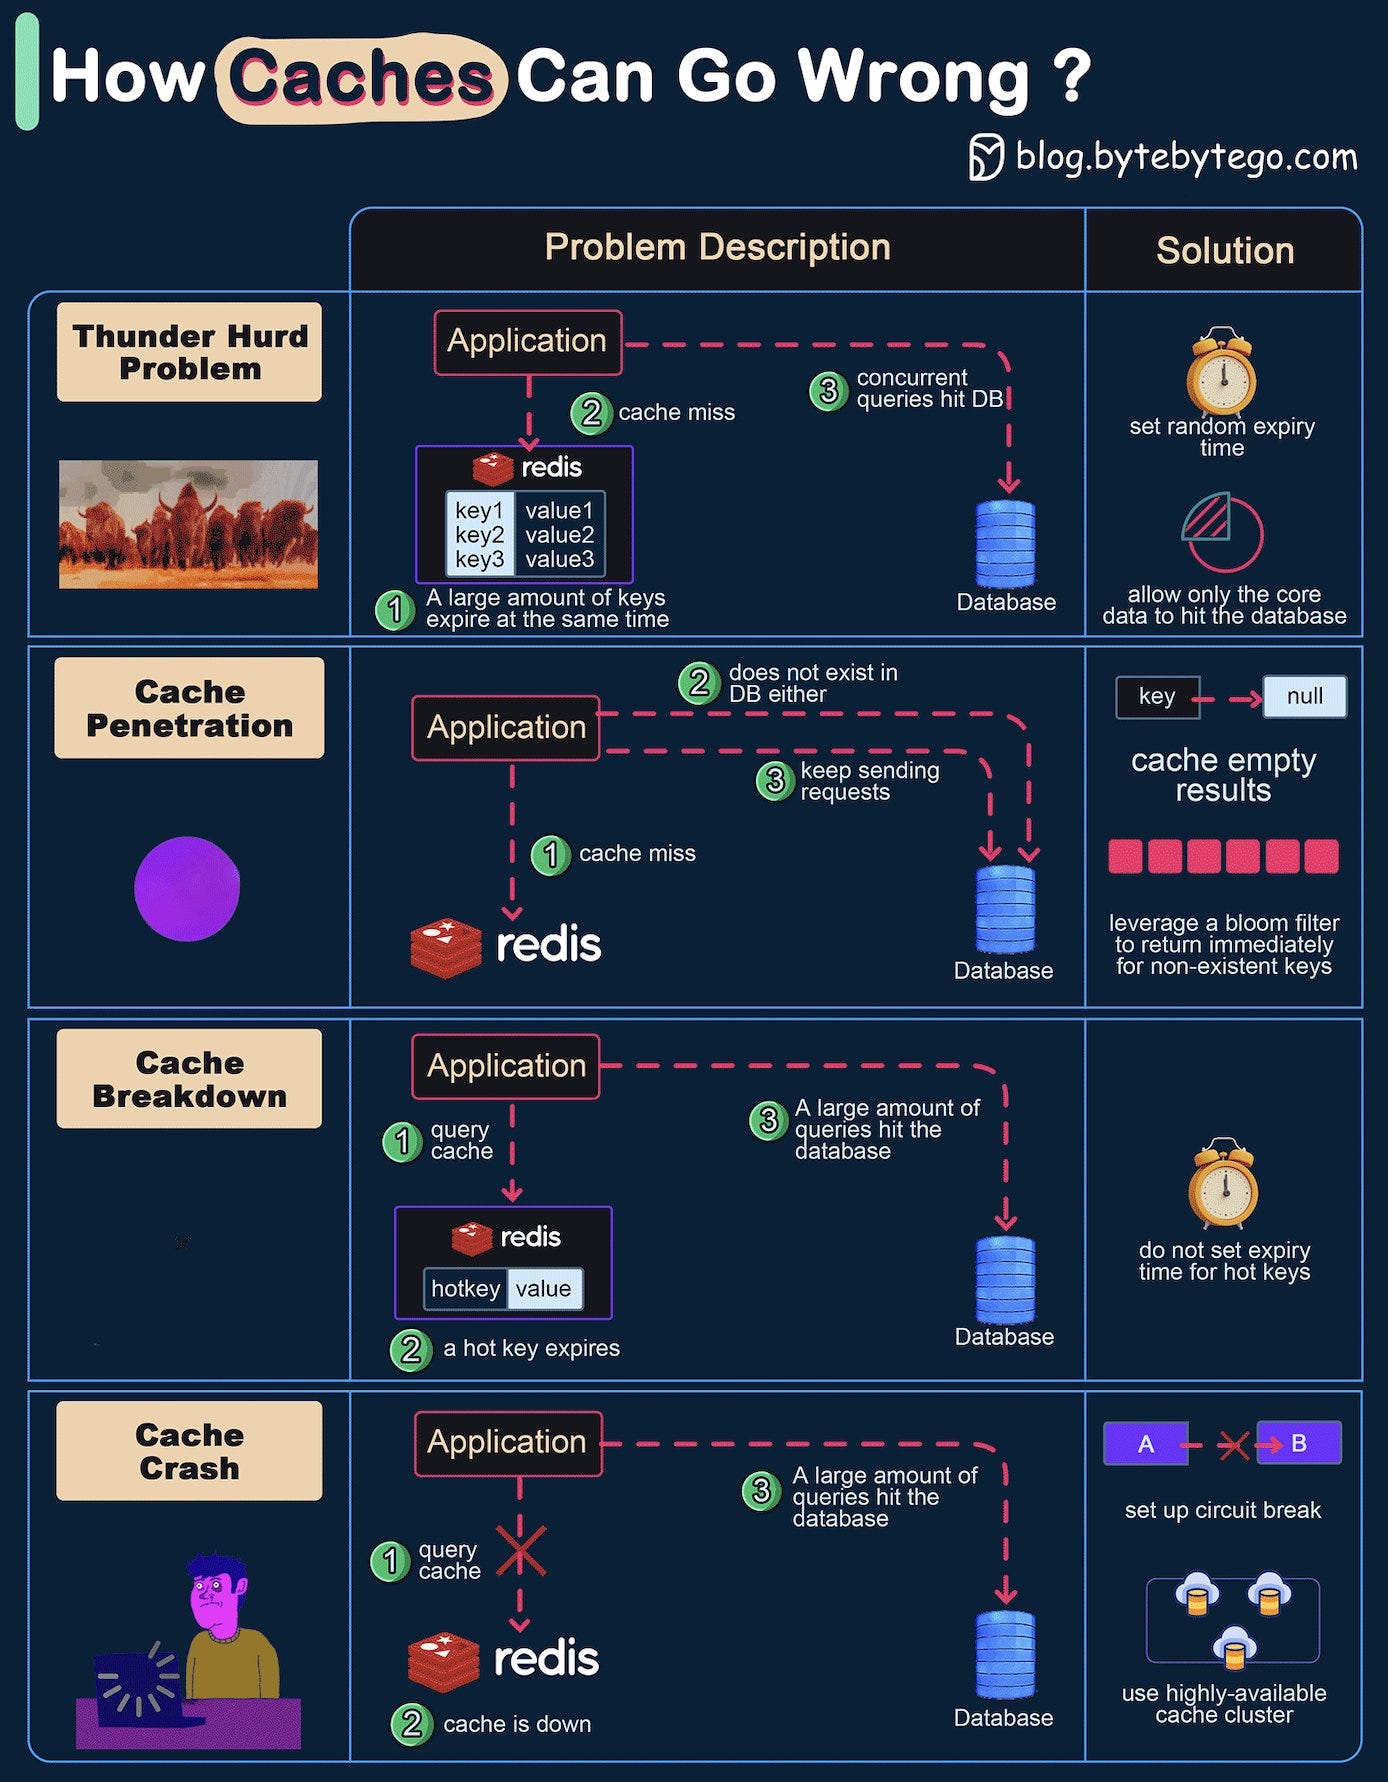
惊群问题
当缓存中大量键同时过期时,查询请求会直接打到数据库,导致数据库过载。
两种缓解该问题的方法:一是在配置中加入随机数,避免为这些键设置相同的过期时间;二是仅允许核心业务数据访问数据库,在缓存恢复之前,阻止非核心数据访问数据库。缓存穿透
当键在缓存和数据库中均不存在时,就会发生缓存穿透。应用无法从数据库获取相关数据来更新缓存。这个问题会给缓存和数据库都带来很大的压力。
对此有两种解决方案。一是为非存在的键缓存 null 值,避免请求直达数据库。二是使用布隆过滤器(bloom filter)预先检查键是否存在,如果键不存在,就可以避免请求直达数据库。缓存击穿
这与羊群效应(thunder herd problem)类似。当某个热点键(hot key)过期时,大量请求会直接打到数据库。
由于热点键占据了 80% 的查询量,我们不为它们设置过期时间。缓存雪崩
当缓存整体宕机,所有请求都会涌向数据库,这就形成了缓存雪崩。
解决此问题有两种方法。一是设置熔断器(circuit breaker),当缓存宕机时,应用服务既不能访问缓存,也不能访问数据库。二是为缓存搭建集群,以提升缓存的可用性。
轮到你了:你在生产环境中遇到过这些问题吗?
推出 ByteByteGo Live
大多数在线课程都无法学完(完成率约为 4%)。而直播课程(Live cohorts)的完成率约为 40%,高出大约 10 倍。直播课程是唯一真正让人学完的课程。
因此,我们即将推出 ByteByteGo Live。课程安排如下:
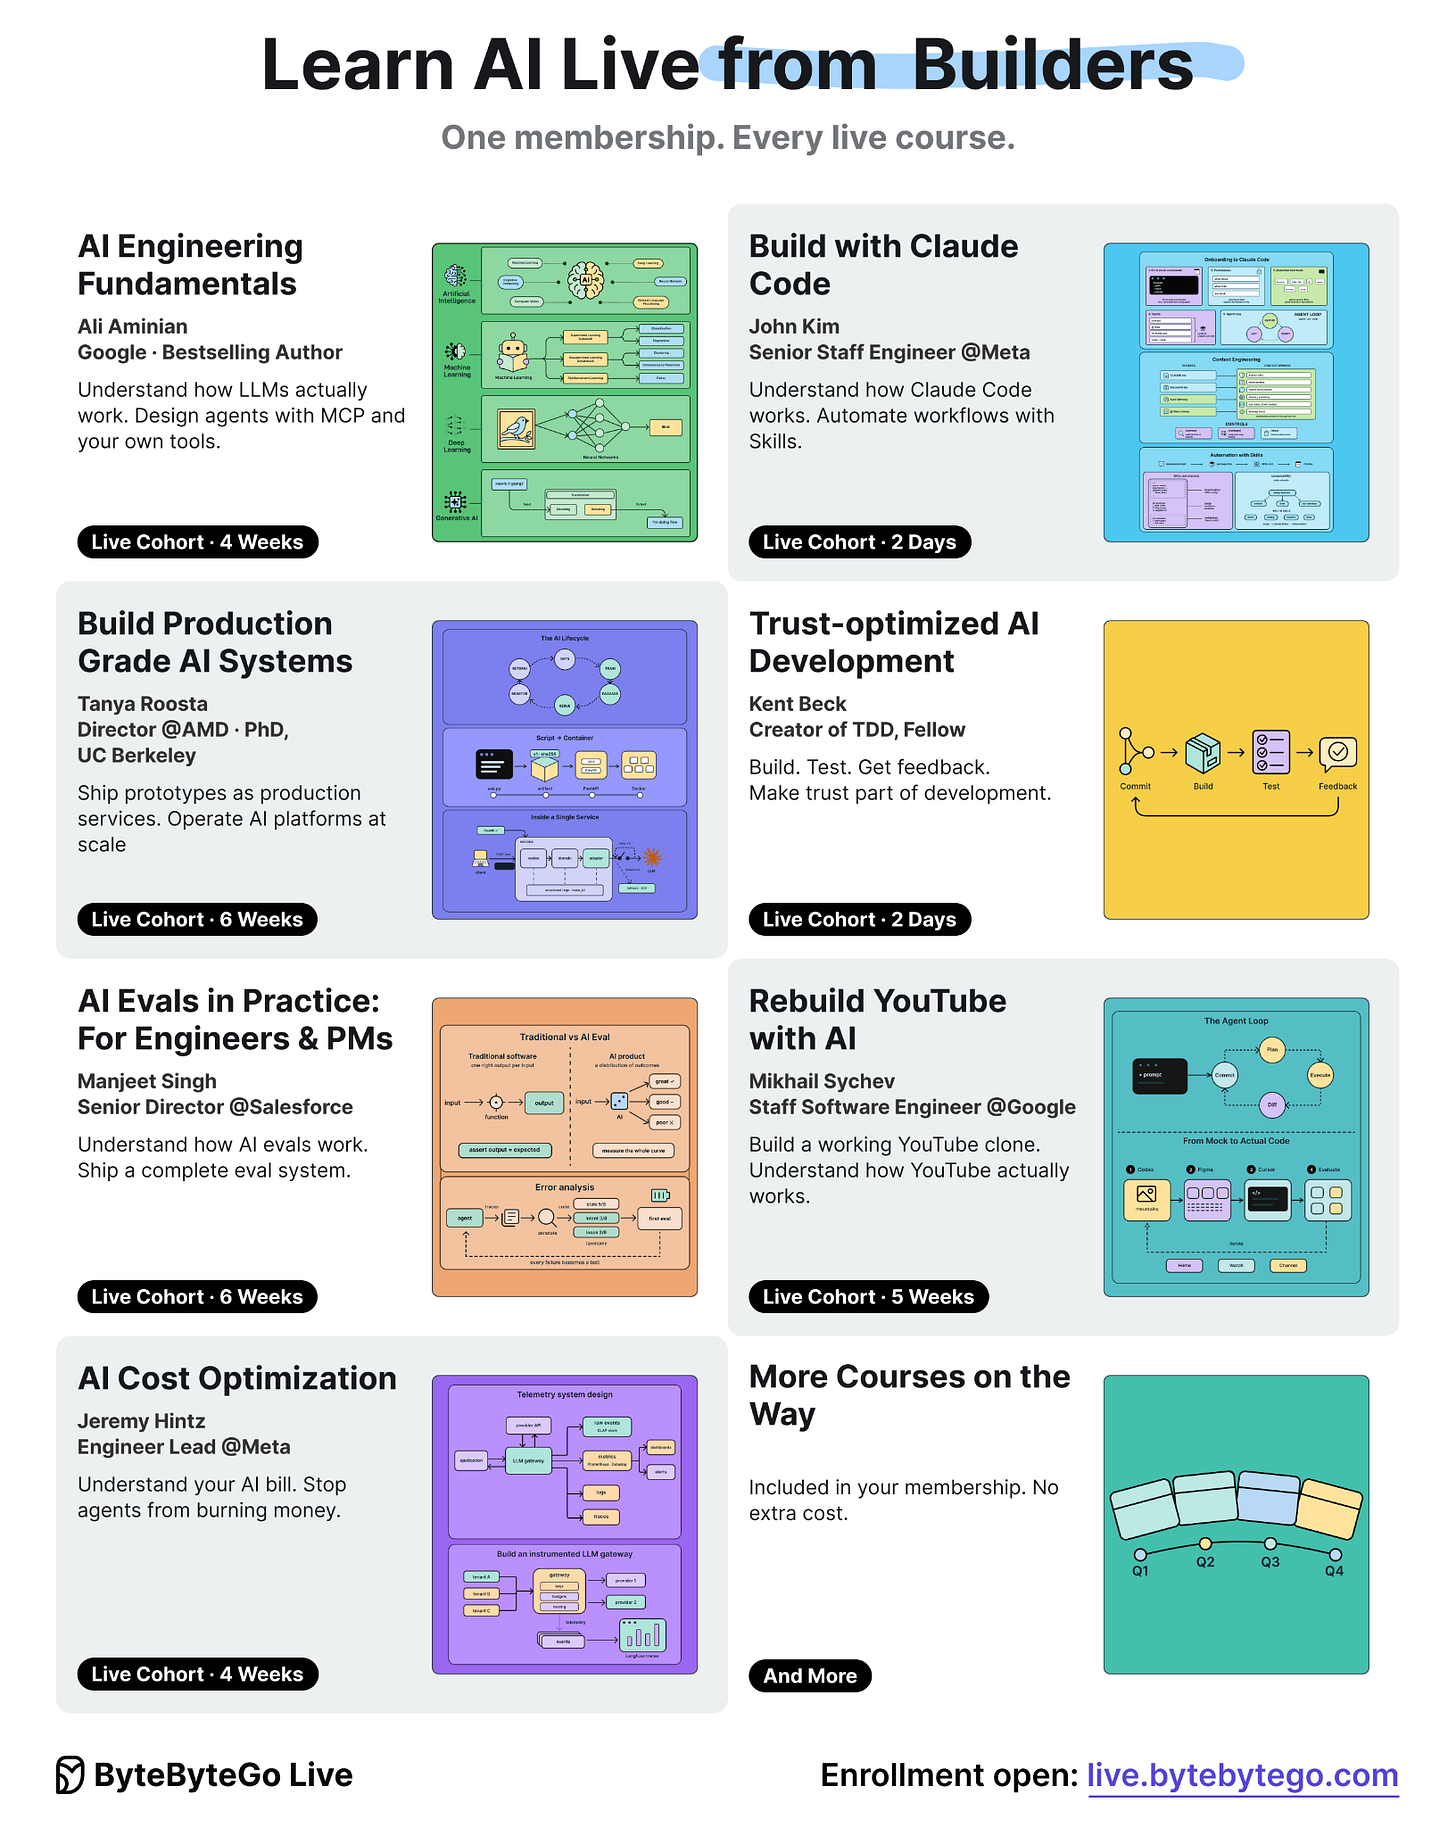
使用 Claude Code 构建(讲师:John Kim,Meta 高级 Staff Engineer,几天后开课)
构建生产级 AI 系统(讲师:Tanya Roosta,AMD 总监,UC Berkeley 博士)
AI 工程基础(讲师:Ali Aminian,Google,畅销书作者)
AI 评估实战(Manjeet Singh,Salesforce 高级总监)
AI 成本优化(Jeremy Hintz,Meta 工程负责人)
重建 YouT