
金刚王 20小时前 · 2026-09-17 22:36:41 · 4 阅读
Transformer之AI大模型基础(代码分享)
作者已经从R转到python了,小伙伴们以后我们可以一起学习讨论人工智能方向的问题。今天还是干活,给大家分享一下机器学习中的Transformer相关代码。Transformer 是谷歌团队在 2017 年 6 月提出的一个经典模型。它不再使用传统的 CNN 和循环神经网络(RNN),而是改用自注意力机制和前馈网络。Transformer 还加了一个位置编码模块:用向量来表示每个词在句子中的位置信息,相当于给输入补上了“顺序信息”。模型会把输入向量分别乘上三个不同的权重矩阵,得到查询向量(Query)、键向量(Key)和值向量(Value)。有了这三个向量,就能实现自注意力。多头注意力机制则让模型可以同时关注不同位置上的信息。自注意力机制会对输入特征做非线性变换,因此能更好地抓住特征之间的内在联系。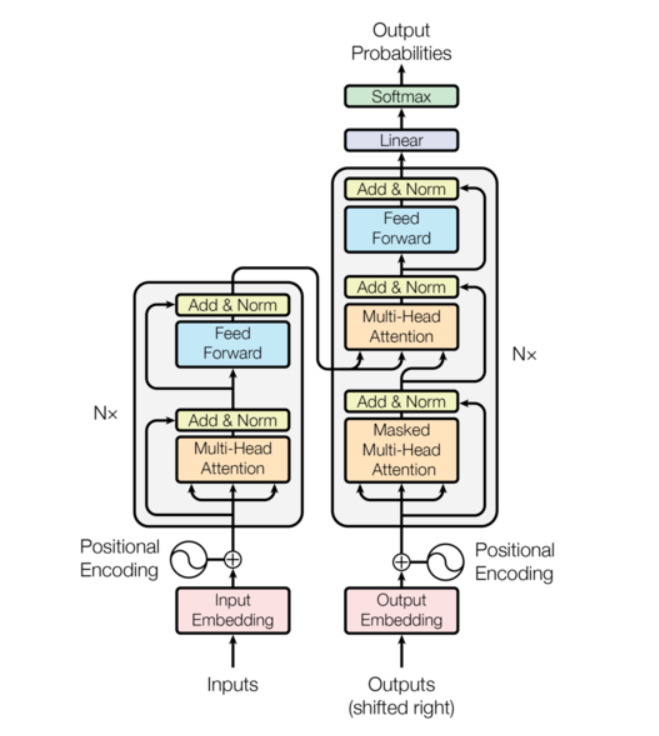
1. Deep learning methods for oral cancer detection using Raman spectroscopy. https://doi.org/10.1016/j.vibspec.2023.103522.2. https://nlp.seas.harvard.edu/annotated-transformer/
简单说就是:Transformer 丢掉了老式的 CNN 和 RNN,靠“自注意力 + 前馈网络”来处理序列;再加位置编码记住词序,用 Query、Key、Value 算注意力,用多头注意力同时看不同地方,从而更好地理解词与词之间的内在关系。比较抽象,我也觉得很抽象,理解起来比较难,下面是代码分享:
import math
import copy
import torch
import torch.nn as nn
import torch.nn.functional as F

def create_fixed_positional_encoding(dim, max_len=5000):
    pe = torch.zeros(max_len, dim)
    position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1)
    div_term = torch.exp(torch.arange(0, dim, 2).float() * -(math.log(10000.0) / dim))
    pe[:, 0::2] = torch.sin(position * div_term)
    pe[:, 1::2] = torch.cos(position * div_term)
    return pe.unsqueeze(0)

class EmbeddingsWithPositionalEncoding(nn.Module):
    def __init__(self, vocab_size, dim, dropout=0.1, pe_type='fixed', max_len=5000):
        super().__init__()
        self.embed = nn.Embedding(vocab_size, dim)
        self.dim = dim
        if pe_type == 'fixed':
            pe = create_fixed_positional_encoding(dim, max_len)
            self.register_buffer('pe', pe)
        elif pe_type == 'learned':
            self.pe = nn.Parameter(torch.zeros(1, max_len, dim))
        else:
            raise ValueError(f"Unknown pe_type: {pe_type}")
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        token_embedding = self.embed(x) * math.sqrt(self.dim)
        positional_encoding = self.pe[:, :x.size(1)]
        return self.dropout(token_embedding + positional_encoding)

class LayerNorm(nn.Module):
    def __init__(self, dim, eps=1e-5):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(dim))
        self.bias = nn.Parameter(torch.zeros(dim))
        self.eps = eps

    def forward(self, x):
        mean = x.mean(-1, keepdim=True)
        std = x.std(-1, keepdim=True)
        return self.weight * (x - mean) / (std + self.eps) + self.bias

class FeedForward(nn.Module):
    def __init__(self, embed_dim, dropout=0.1, bias=True):
        super().__init__()
        self.linear1 = nn.Linear(embed_dim, 4 * embed_dim, bias=bias)
        self.linear2 = nn.Linear(4 * embed_dim, embed_dim, bias=bias)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        return self.linear2(self.dropout(F.relu(self.linear1(x))))

class MultiHeadAttention(nn.Module):
    def __init__(self, embed_dim, num_heads, dropout=0.1, bias=True):
        super().__init__()
        assert embed_dim % num_heads == 0, "embed_dim must be divisible by num_heads"
        self.head_dim = embed_dim // num_heads
        self.embed_dim = embed_dim
        self.num_heads = num_heads
        self.scaling = self.head_dim ** -0.5
        self.q_proj = nn.Linear(embed_dim, embed_dim, bias=bias)
        self.k_proj = nn.Linear(embed_dim, embed_dim, bias=bias)
        self.v_proj = nn.Linear(embed_dim, embed_dim, bias=bias)
        self.out_proj = nn.Linear(embed_dim, embed_dim, bias=bias)
        self.dropout = nn.Dropout(dropout)
        self.attn_score = None

    def forward(self, query, key, value, mask=None):
        bsz, seq_len, embed_dim = query.size()
        assert embed_dim == self.embed_dim
        assert key.size() == value.size()

        q = self.q_proj(query).view(bsz, -1, self.num_heads, self.head_dim).transpose(1, 2)
        k = self.k_proj(key).view(bsz, -1, self.num_heads, self.head_dim).transpose(1, 2)
        v = self.v_proj(value).view(bsz, -1, self.num_heads, self.head_dim).transpose(1, 2)

        scores = (q @ k.transpose(-2, -1)) * self.scaling
        if mask is not None:
            mask = mask.unsqueeze(1)
            scores = scores.masked_fill(mask == 0, float('-inf'))

        attn = F.softmax(scores, dim=-1)
        attn = self.dropout(attn)
        self.attn_score = attn

        values = attn @ v
        values = values.transpose(1, 2).reshape(bsz, seq_len, embed_dim)
        return self.out_proj(values)

class EncoderLayer(nn.Module):
    def __init__(self, embed_dim, num_heads, dropout=0.1, pre_norm=True):
        super().__init__()
        self.self_attn = MultiHeadAttention(embed_dim, num_heads, dropout)
        self.ff = FeedForward(embed_dim, dropout)
        self.norm_self_attn = LayerNorm(embed_dim)
        self.norm_ff = LayerNorm(embed_dim)
        self.dropout = nn.Dropout(dropout)
        self.pre_norm = pre_norm

    def forward(self, x, mask):
        if self.pre_norm:
            norm_x = self.norm_self_attn(x)
            x = x + self.dropout(self.self_attn(norm_x, norm_x, norm_x, mask))
            norm_x = self.norm_ff(x)
            x = x + self.dropout(self.ff(norm_x))
        else:
            x = self.norm_self_attn(x + self.dropout(self.self_attn(x, x, x, mask)))
            x = self.norm_ff(x + self.dropout(self.ff(x)))
        return x

class Encoder(nn.Module):
    def __init__(self, embed_dim, num_layers, num_heads, dropout=0.1, pre_norm=True):
        super().__init__()
        self.layers = nn.ModuleList(
            [EncoderLayer(embed_dim, num_heads, dropout, pre_norm) for _ in range(num_layers)]
        )
        self.norm = LayerNorm(embed_dim)

    def forward(self, x, mask):
        for layer in self.layers:
            x = layer(x, mask)
        return self.norm(x)

class DecoderLayer(nn.Module):
    def __init__(self, embed_dim, num_heads, dropout=0.1, pre_norm=True):
        super().__init__()
        self.self_attn = MultiHeadAttention(embed_dim, num_heads, dropout)
        self.cross_attn = MultiHeadAttention(embed_dim, num_heads, dropout)
        self.ff = FeedForward(embed_dim, dropout)
        self.norm_self_attn = LayerNorm(embed_dim)
        self.norm_cross_attn = LayerNorm(embed_dim)
        self.norm_ff = LayerNorm(embed_dim)
        self.dropout = nn.Dropout(dropout)
        self.pre_norm = pre_norm

    def forward(self, x, memory, src_mask, tgt_mask):
        if self.pre_norm:
            norm_x = self.norm_self_attn(x)
            x = x + self.dropout(self.self_attn(norm_x, norm_x, norm_x, tgt_mask))
            norm_x = self.norm_cross_attn(x)
            x = x + self.dropout(self.cross_attn(norm_x, memory, memory, src_mask))
            norm_x = self.norm_ff(x)
            x = x + self.dropout(self.ff(norm_x))
        else:
            x = self.norm_self_attn(x + self.dropout(self.self_attn(x, x, x, tgt_mask)))
            x = self.norm_cross_attn(x + self.dropout(self.cross_attn(x, memory, memory, src_mask)))
            x = self.norm_ff(x + self.dropout(self.ff(x)))
        return x

class Decoder(nn.Module):
    def __init__(self, embed_dim, num_layers, num_heads, dropout=0.1, pre_norm=True):
        super().__init__()
        self.layers = nn.ModuleList(
            [DecoderLayer(embed_dim, num_heads, dropout, pre_norm) for _ in range(num_layers)]
        )
        self.norm = LayerNorm(embed_dim)

    def forward(self, x, memory, src_mask, tgt_mask):
        for layer in self.layers:
            x = layer(x, memory, src_mask, tgt_mask)
        return self.norm(x)

def create_causal_mask(size):
    attn_shape = (1, size, size)
    causal_mask = torch.triu(torch.ones(attn_shape), diagonal=1).type(torch.uint8)
    return causal_mask == 0

class Generator(nn.Module):
    def __init__(self, embed_dim, vocab_size):
        super().__init__()
        self.final_proj = nn.Linear(embed_dim, vocab_size, bias=False)

    def forward(self, x):
        return self.final_proj(x)

class Transformer(nn.Module):
    def __init__(
        self,
        src_vocab_size,
        tgt_vocab_size,
        embed_dim,
        num_layers,
        num_heads,
        dropout=0.1,
        pre_norm=True,
        pe_type='fixed',
        max_len=5000,
        tie_embeddings=False,
    ):
        super().__init__()
        self.src_embed = EmbeddingsWithPositionalEncoding(src_vocab_size, embed_dim, dropout, pe_type, max_len)
        self.tgt_embed = EmbeddingsWithPositionalEncoding(tgt_vocab_size, embed_dim, dropout, pe_type, max_len)
        self.encoder = Encoder(embed_dim, num_layers, num_heads, dropout, pre_norm)
        self.decoder = Decoder(embed_dim, num_layers, num_heads, dropout, pre_norm)
        self.generator = Generator(embed_dim, tgt_vocab_size)
        self.tie_weights = tie_embeddings
        self.reset_parameters()
        if tie_embeddings:
            self.src_embed.embed.weight = self.tgt_embed.embed.weight
        self.generator.final_proj.weight = self.tgt_embed.embed.weight

    def reset_parameters(self):
        for p in self.parameters():
            if p.dim() > 1:
                nn.init.xavier_uniform_(p)
        nn.init.normal_(self.src_embed.embed.weight, mean=0.0, std=self.src_embed.dim ** -0.5)
        nn.init.normal_(self.tgt_embed.embed.weight, mean=0.0, std=self.tgt_embed.dim ** -0.5)

    def encode(self, src, src_mask):
        return self.encoder(self.src_embed(src), src_mask)

    def decode(self, tgt, memory, src_mask, tgt_mask):
        return self.decoder(self.tgt_embed(tgt), memory, src_mask, tgt_mask)

    def forward(self, src, tgt, src_mask, tgt_mask):
        memory = self.encode(src, src_mask)
        return self.decode(tgt, memory, src_mask, tgt_mask)

    @property
    def device(self):
        return next(self.parameters()).device

def create_model(
    src_vocab_size,
    tgt_vocab_size,
    embed_dim=512,
    num_layers=6,
    num_heads=8,
    dropout=0.1,
    pre_norm=True,
    pe_type='fixed',
    max_len=5000,
    tie_embeddings=False,
    device=None,
):
    model = Transformer(
        src_vocab_size=src_vocab_size,
        tgt_vocab_size=tgt_vocab_size,
        embed_dim=embed_dim,
        num_layers=num_layers,
        num_heads=num_heads,
        dropout=dropout,
        pre_norm=pre_norm,
        pe_type=pe_type,
        max_len=max_len,
        tie_embeddings=tie_embeddings,
    )
    if device is not None:
        model = model.to(device)
return model1. Deep learning methods for oral cancer detection using Raman spectroscopy. https://doi.org/10.1016/j.vibspec.2023.103522.2. https://nlp.seas.harvard.edu/annotated-transformer/
原始来源: 金刚王