我们如何将 CDN 元数据查找延迟降低 91%
Copy link to headingCDN 如何找到正确的路由
请求中的路径并不总是与实际提供内容或函数的路径一致,两者由框架的路由规则关联起来。例如,对/blog/hello-world 的请求可能会解析到动态路由 /blog/[slug],而对该页面 React Server Component payload 的请求则可能解析到 /blog/[slug].rsc。CDN 在应用这些规则时,可能需要检查多个目标路径才能找到正确的响应。
这些路由由框架在构建时描述。借助 framework-defined infrastructure,应用代码声明哪些输出是静态的、哪些需要 Functions、哪些响应可以缓存或重新生成。框架将这些意图转换为 Build Output API 输出,Vercel 再据此生成 CDN 读取的路由元数据。
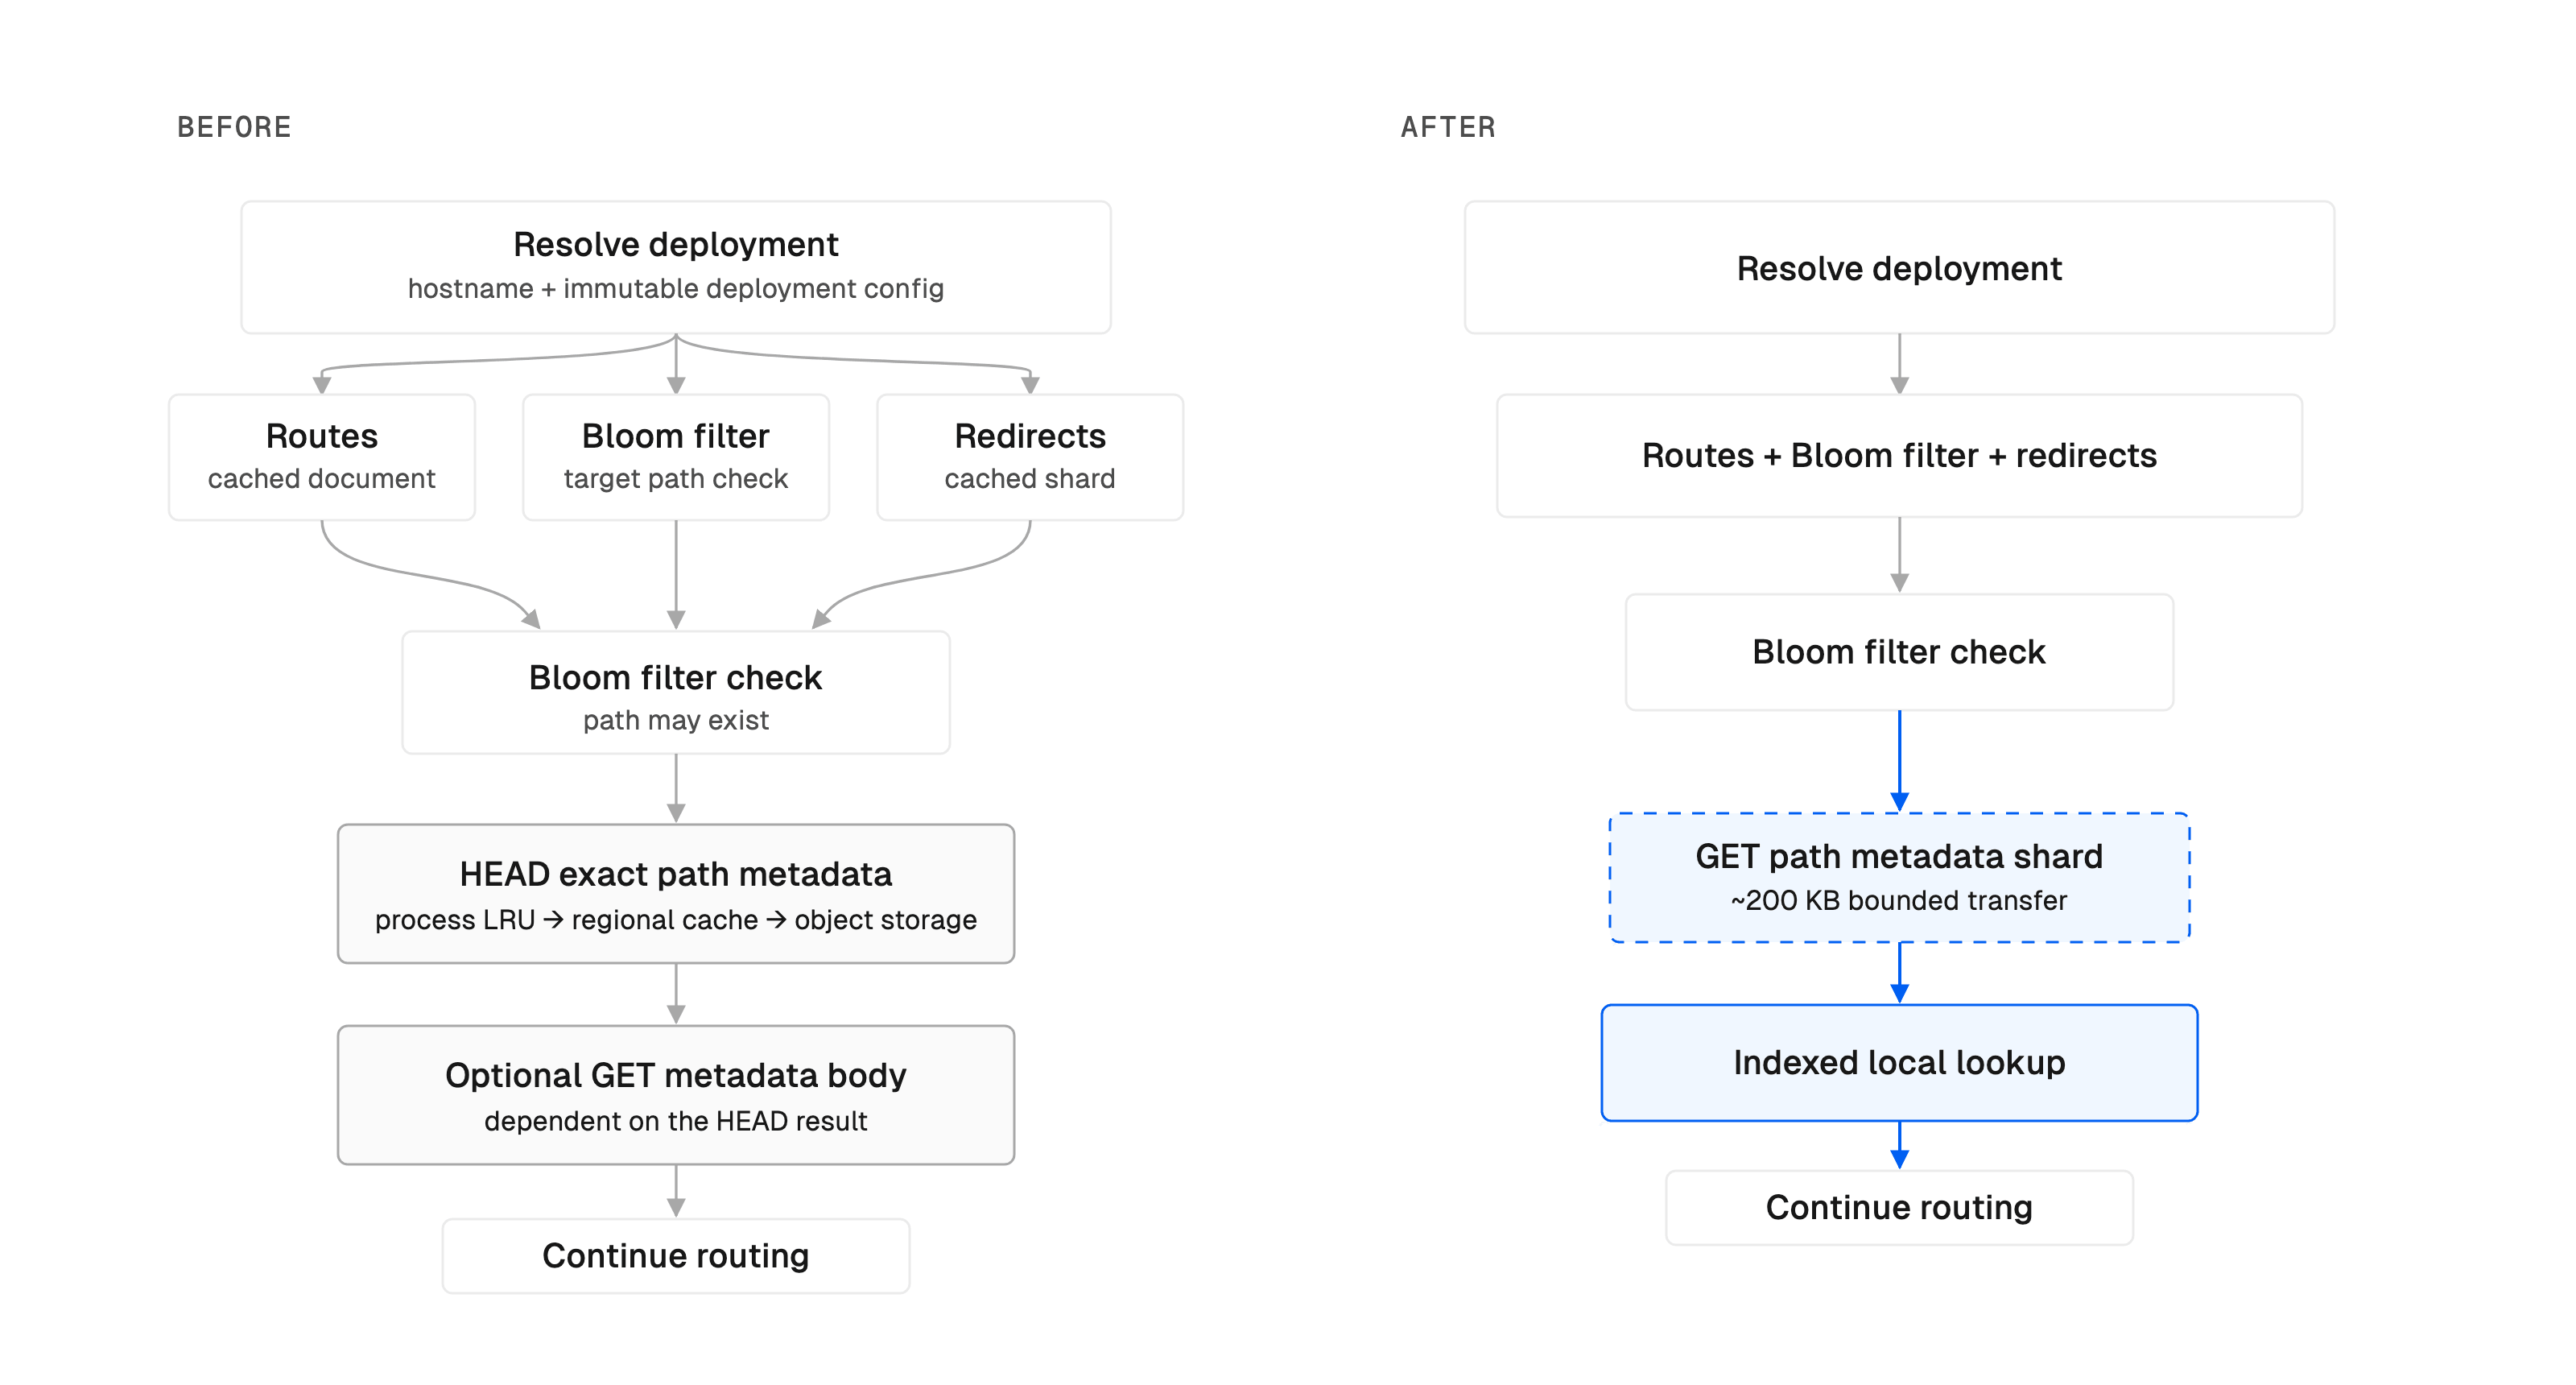
请求到达时,CDN 需要确定哪些目标路径存在并获取其元数据。我们在全局路由中引入的 布隆过滤器(Bloom filters)可以排除那些确定不存在的路径。其余路径需要进行精确的元数据查找。
最初,我们将每个目标路径的元数据存储为独立的对象。CDN 独立获取并缓存这些对象。这种方式适用于部署不频繁的小型项目。但每次新部署都会创建一套新的缓存键,导致首次查找每条路径时都会出现缓存未命中。
Copy link to heading按组获取元数据
为了减少缓存未命中,我们将多条路径的元数据分组存储在称为分片(shards)的文件中。我们限制每个分片的大小,以控制查找时所需获取的数据量。获取一个分片会将其中所有路径的元数据放入缓存,后续对这些路径的查找便可复用缓存数据。
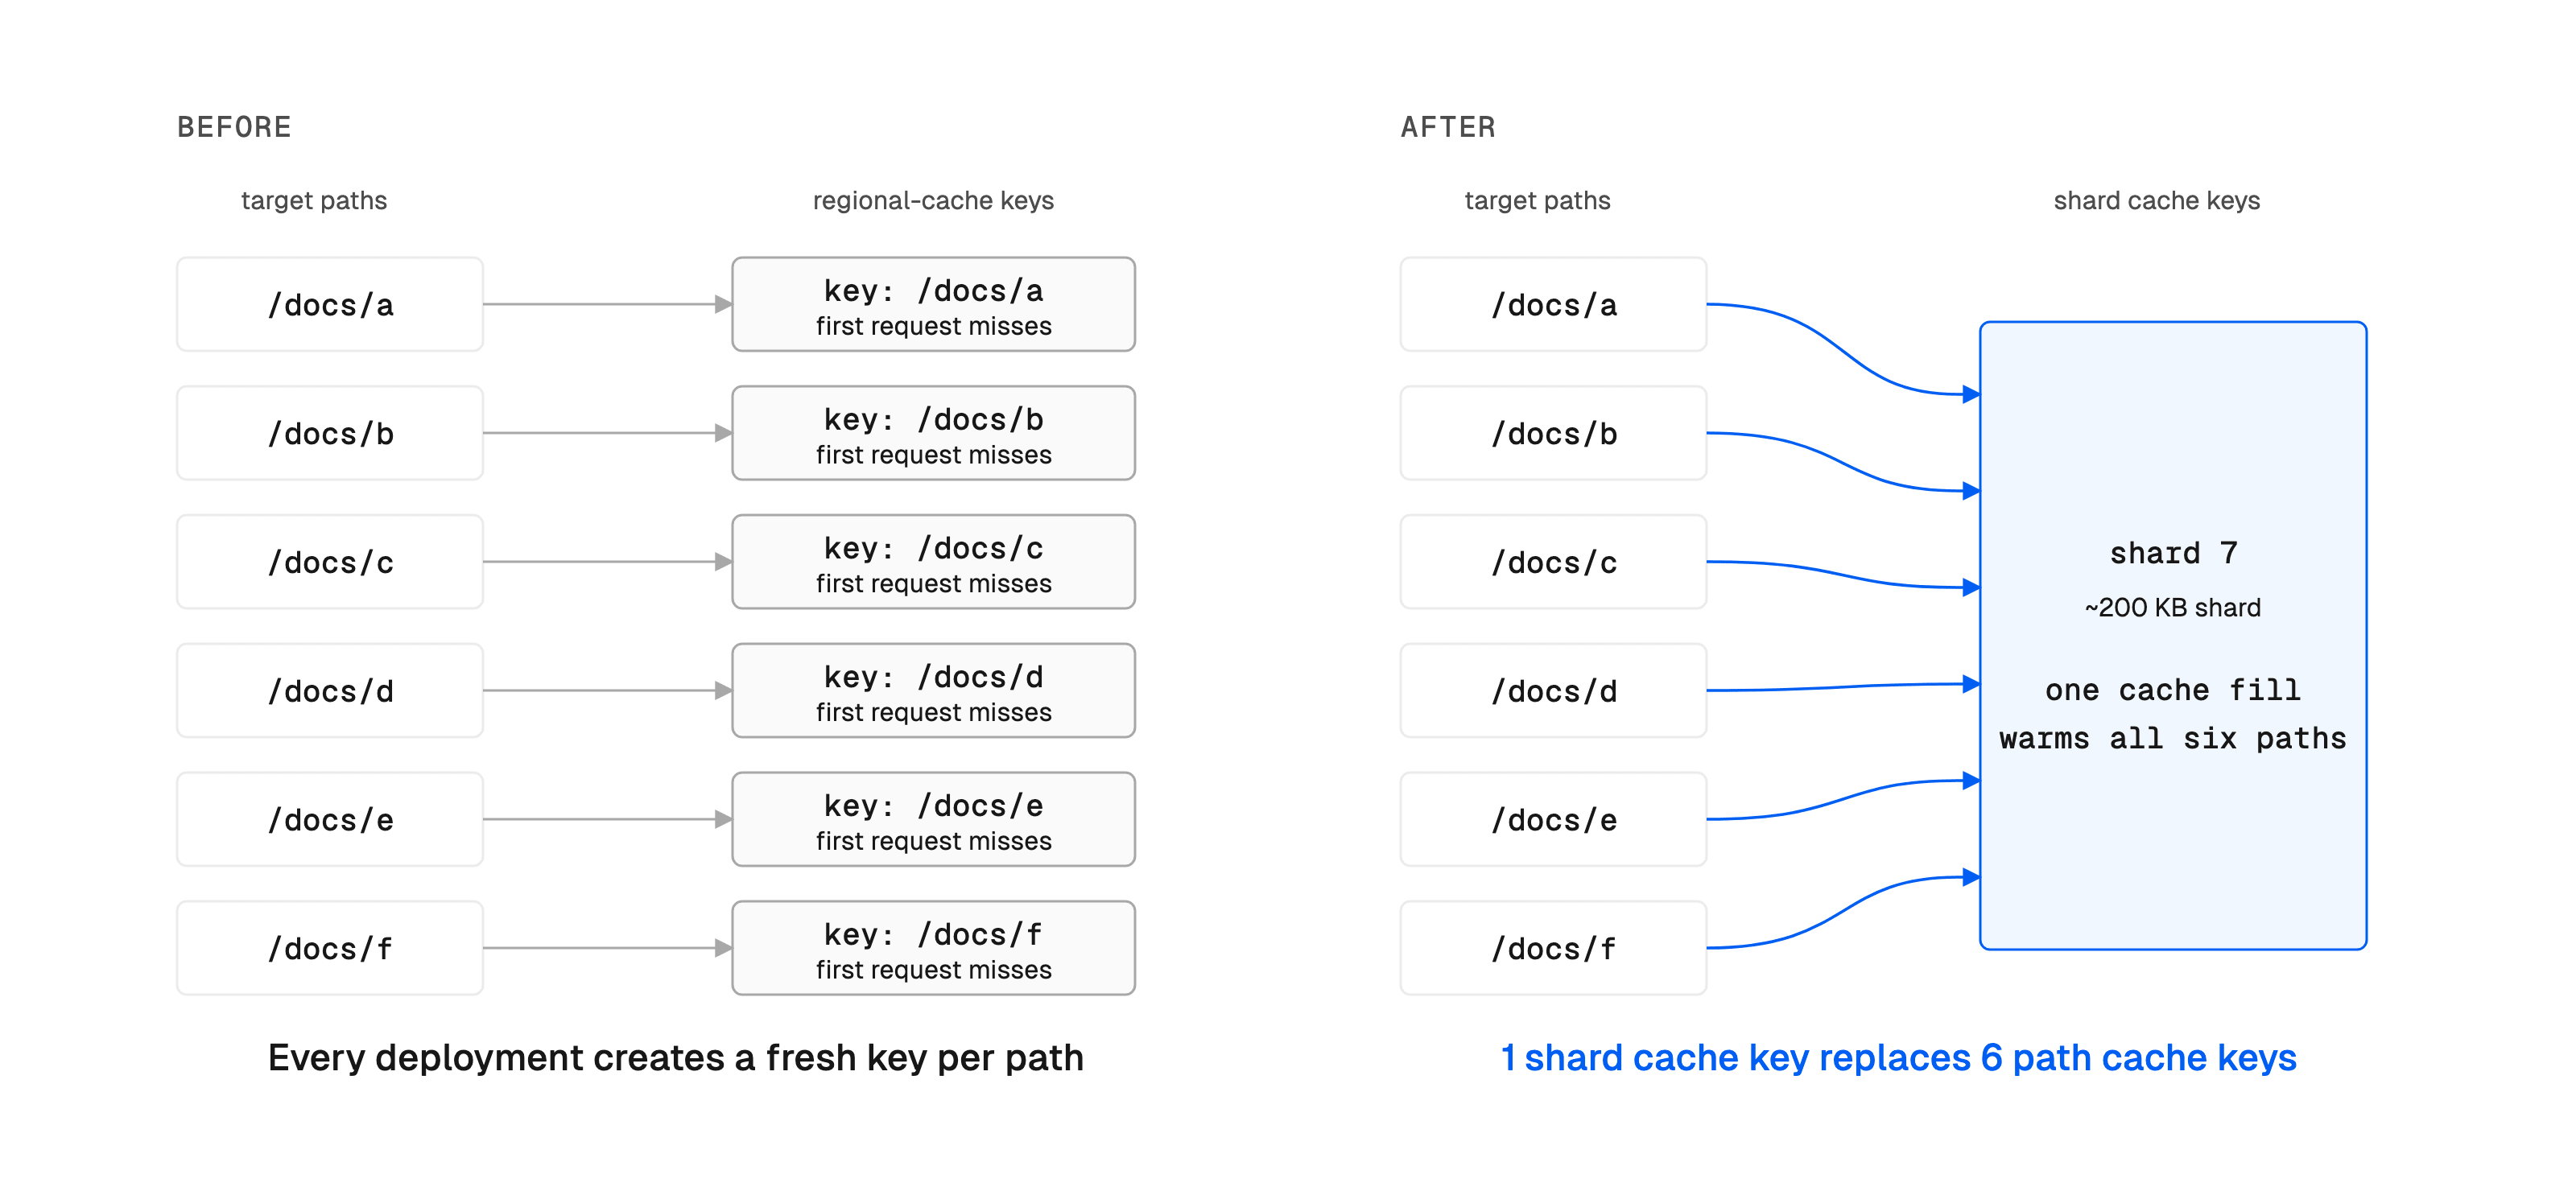
每个分片还包含一个索引,使 CDN 无需解码、解压或解析其他条目,即可定位单条路径的元数据。这样,每次获取能预热多条路径,而每次查找仅解析所需的记录。
复制标题链接取更多数据,少解析内容
我们使用 JSONL 布局来构建分片,这种布局在 Vercel 其他大型路由数据集中已有应用。JSONL 每行存储一个 JSON 值。我们借鉴了 批量重定向 中经过排序、交替出现的键值对记录,以及最初为 Bloom 过滤器 构建的、可直接寻址的 Base64 数据结构。
我们将数据布局与查找结构分离,以便每种工作负载都能按需选择特性:
支持随机访问、可检查的有序键值 JSONL 记录
可选的内置索引,用于低开销的二分查找
支持基于偏移量解码的嵌入 Base64 数据
控制传输和缓存成本的有界分片
每个分片以交替的 JSONL 记录形式存储经过排序的目标路径及其元数据。内置索引记录了每个条目的起始位置,使路由过程可以直接跳转至该位置。这些位置以固定宽度指针的形式存储。每个指针都是六位 Base64 字符的整数倍,因此无需先解析索引行的 JSON 或解码完整的 Base64 字符串,即可就地解码任意单个指针。
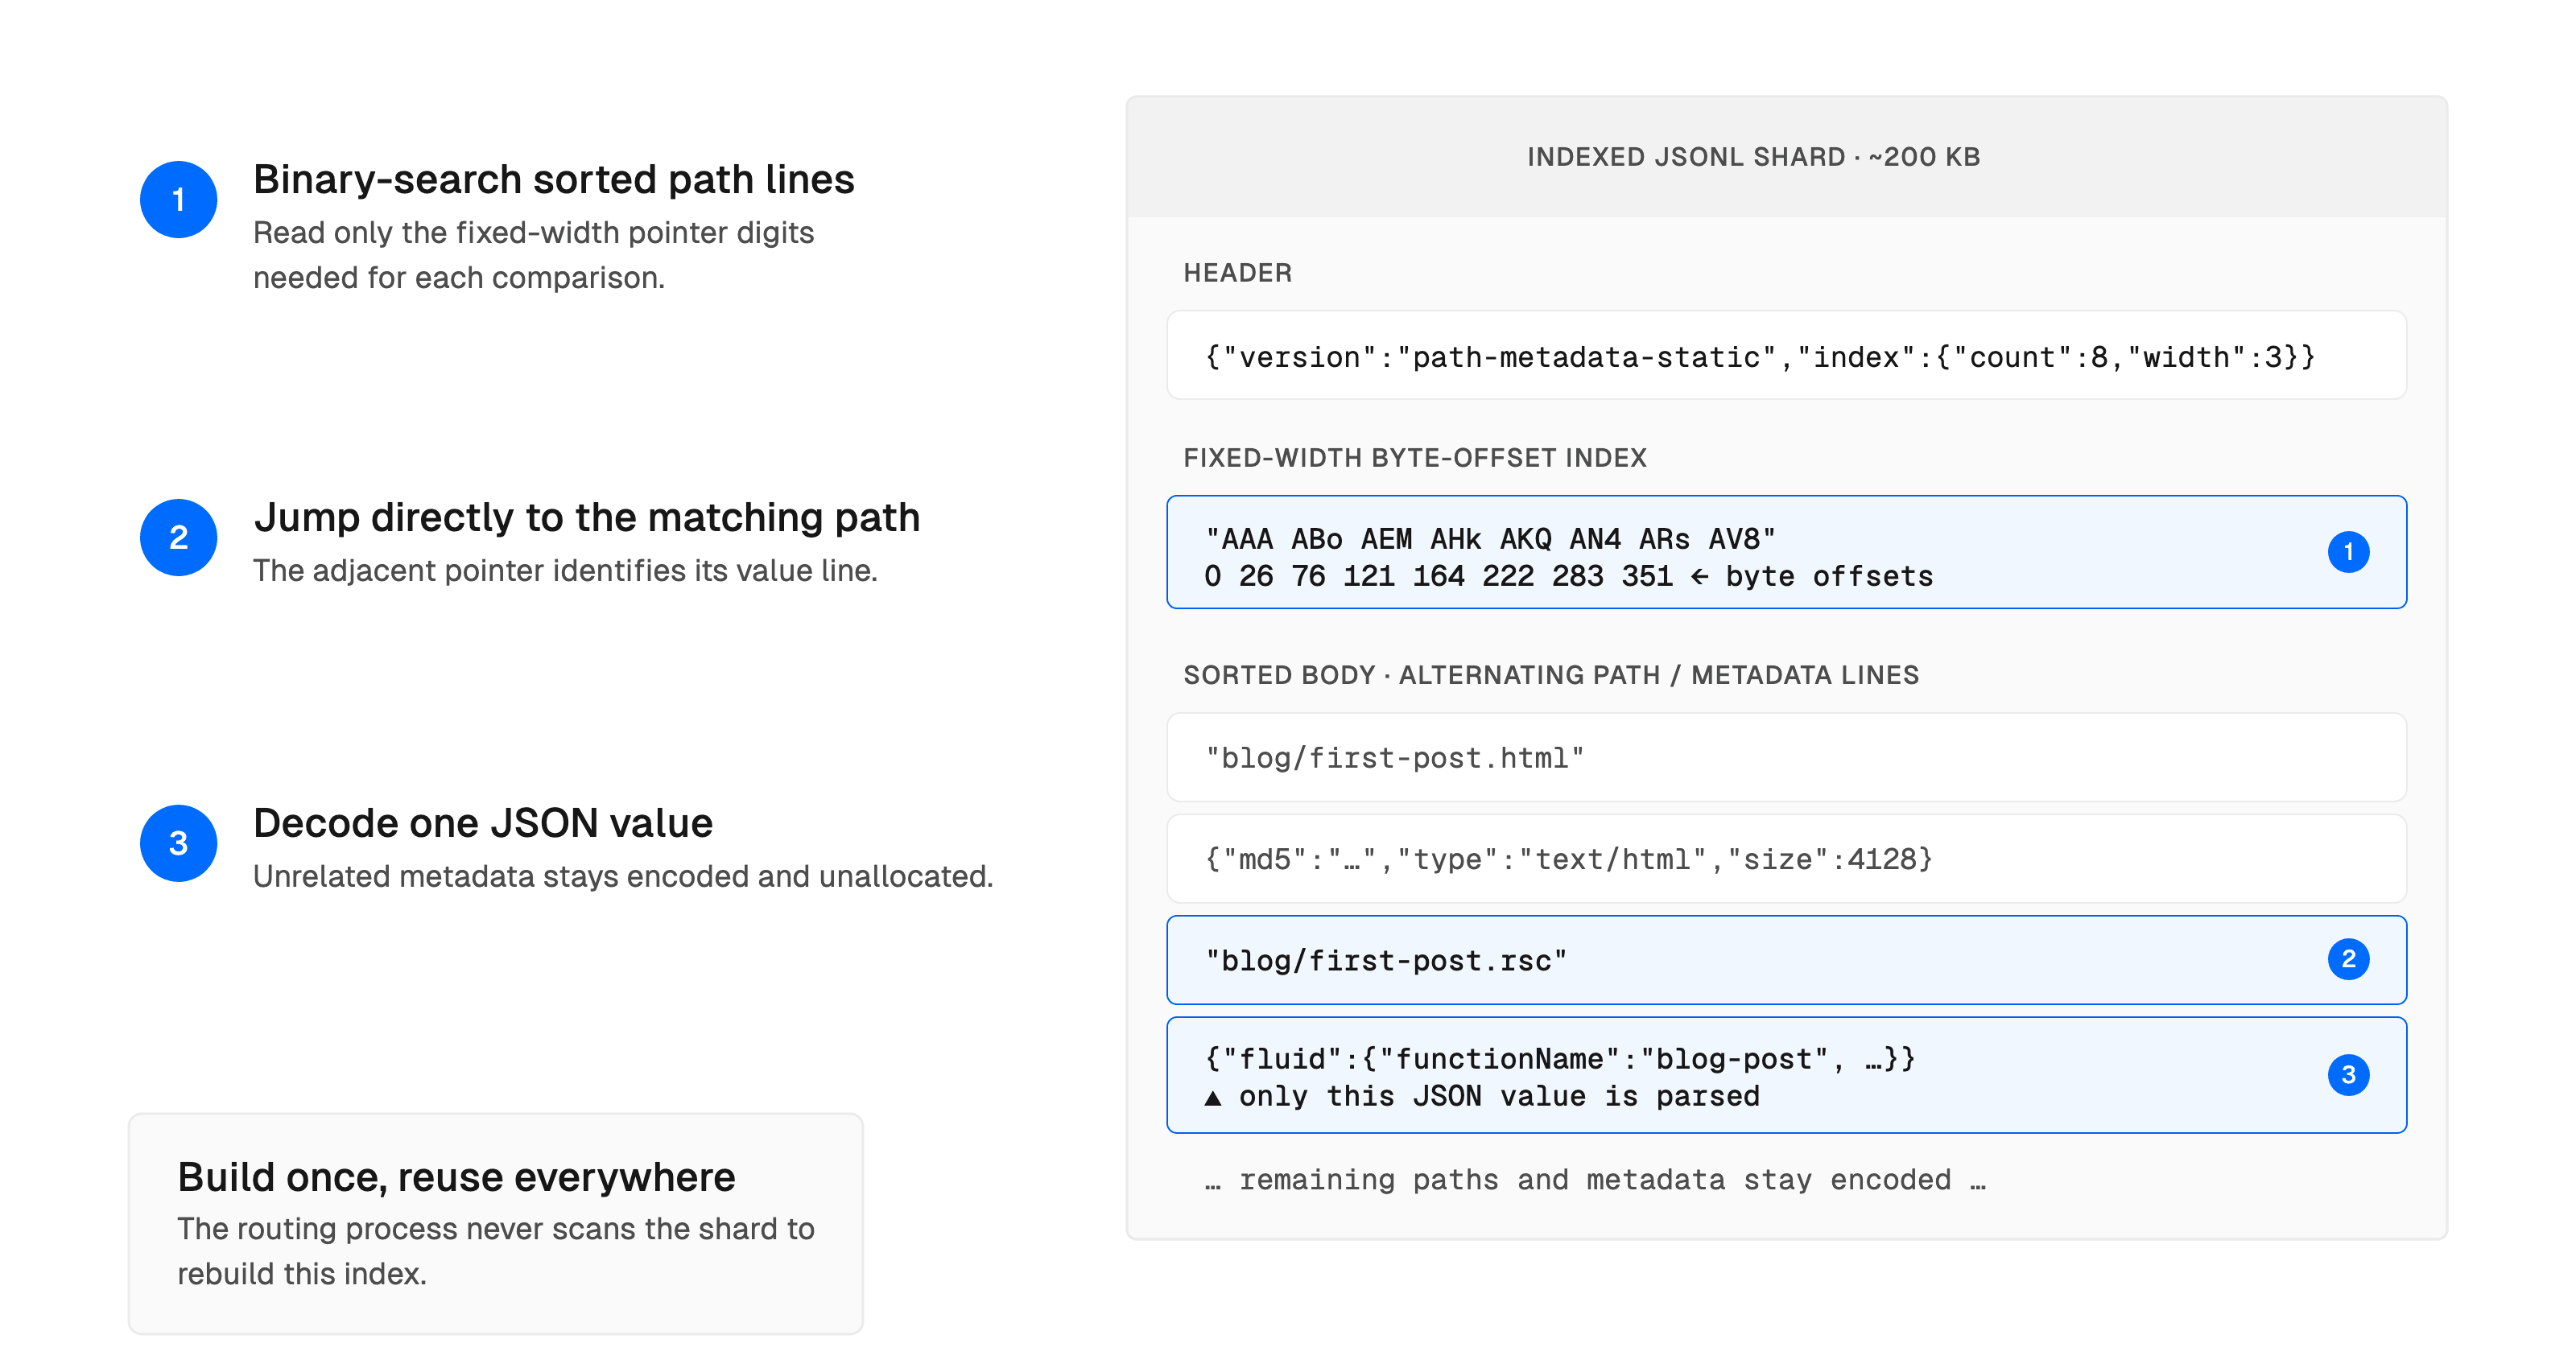
和 Bulk Redirects 一样,部署的第一次元数据请求就已经确定了某个路径所在的分片,所以选择分片不会带来额外的往返开销。
在分片内部,路由进程借助索引指针对编码后的路径做二分查找,找到一条路径只需 O(log n) 次指针读取和字符串比较。匹配成功后,再解析下一行的元数据值,分片的其余部分完全不用碰。
Copy link to heading在生产环境中寻找合适的分片大小
我们最初希望大多数部署的路径元数据能放进单个分片。由于索引加二分查找让解析成本很低,所以一开始我们用的是数 MB 大小的分片。
大分片只有在能就近缓存时才有意义。每个路由进程在内存中维护一个小型 LRU(最近最少使用)缓存存放近期用过的分片,后面还有一层由同区域所有进程共享的更大缓存。按我们的设想,每个部署只有几个分片,LRU 大部分时候都能命中,足以抵消传输较大分片的成本。
但测试发现,区域级缓存的命中率确实很高,LRU 命中率却很低——因为请求被分散到了区域内的许多进程上。传输数 MB 的分片,成本也比预期高。
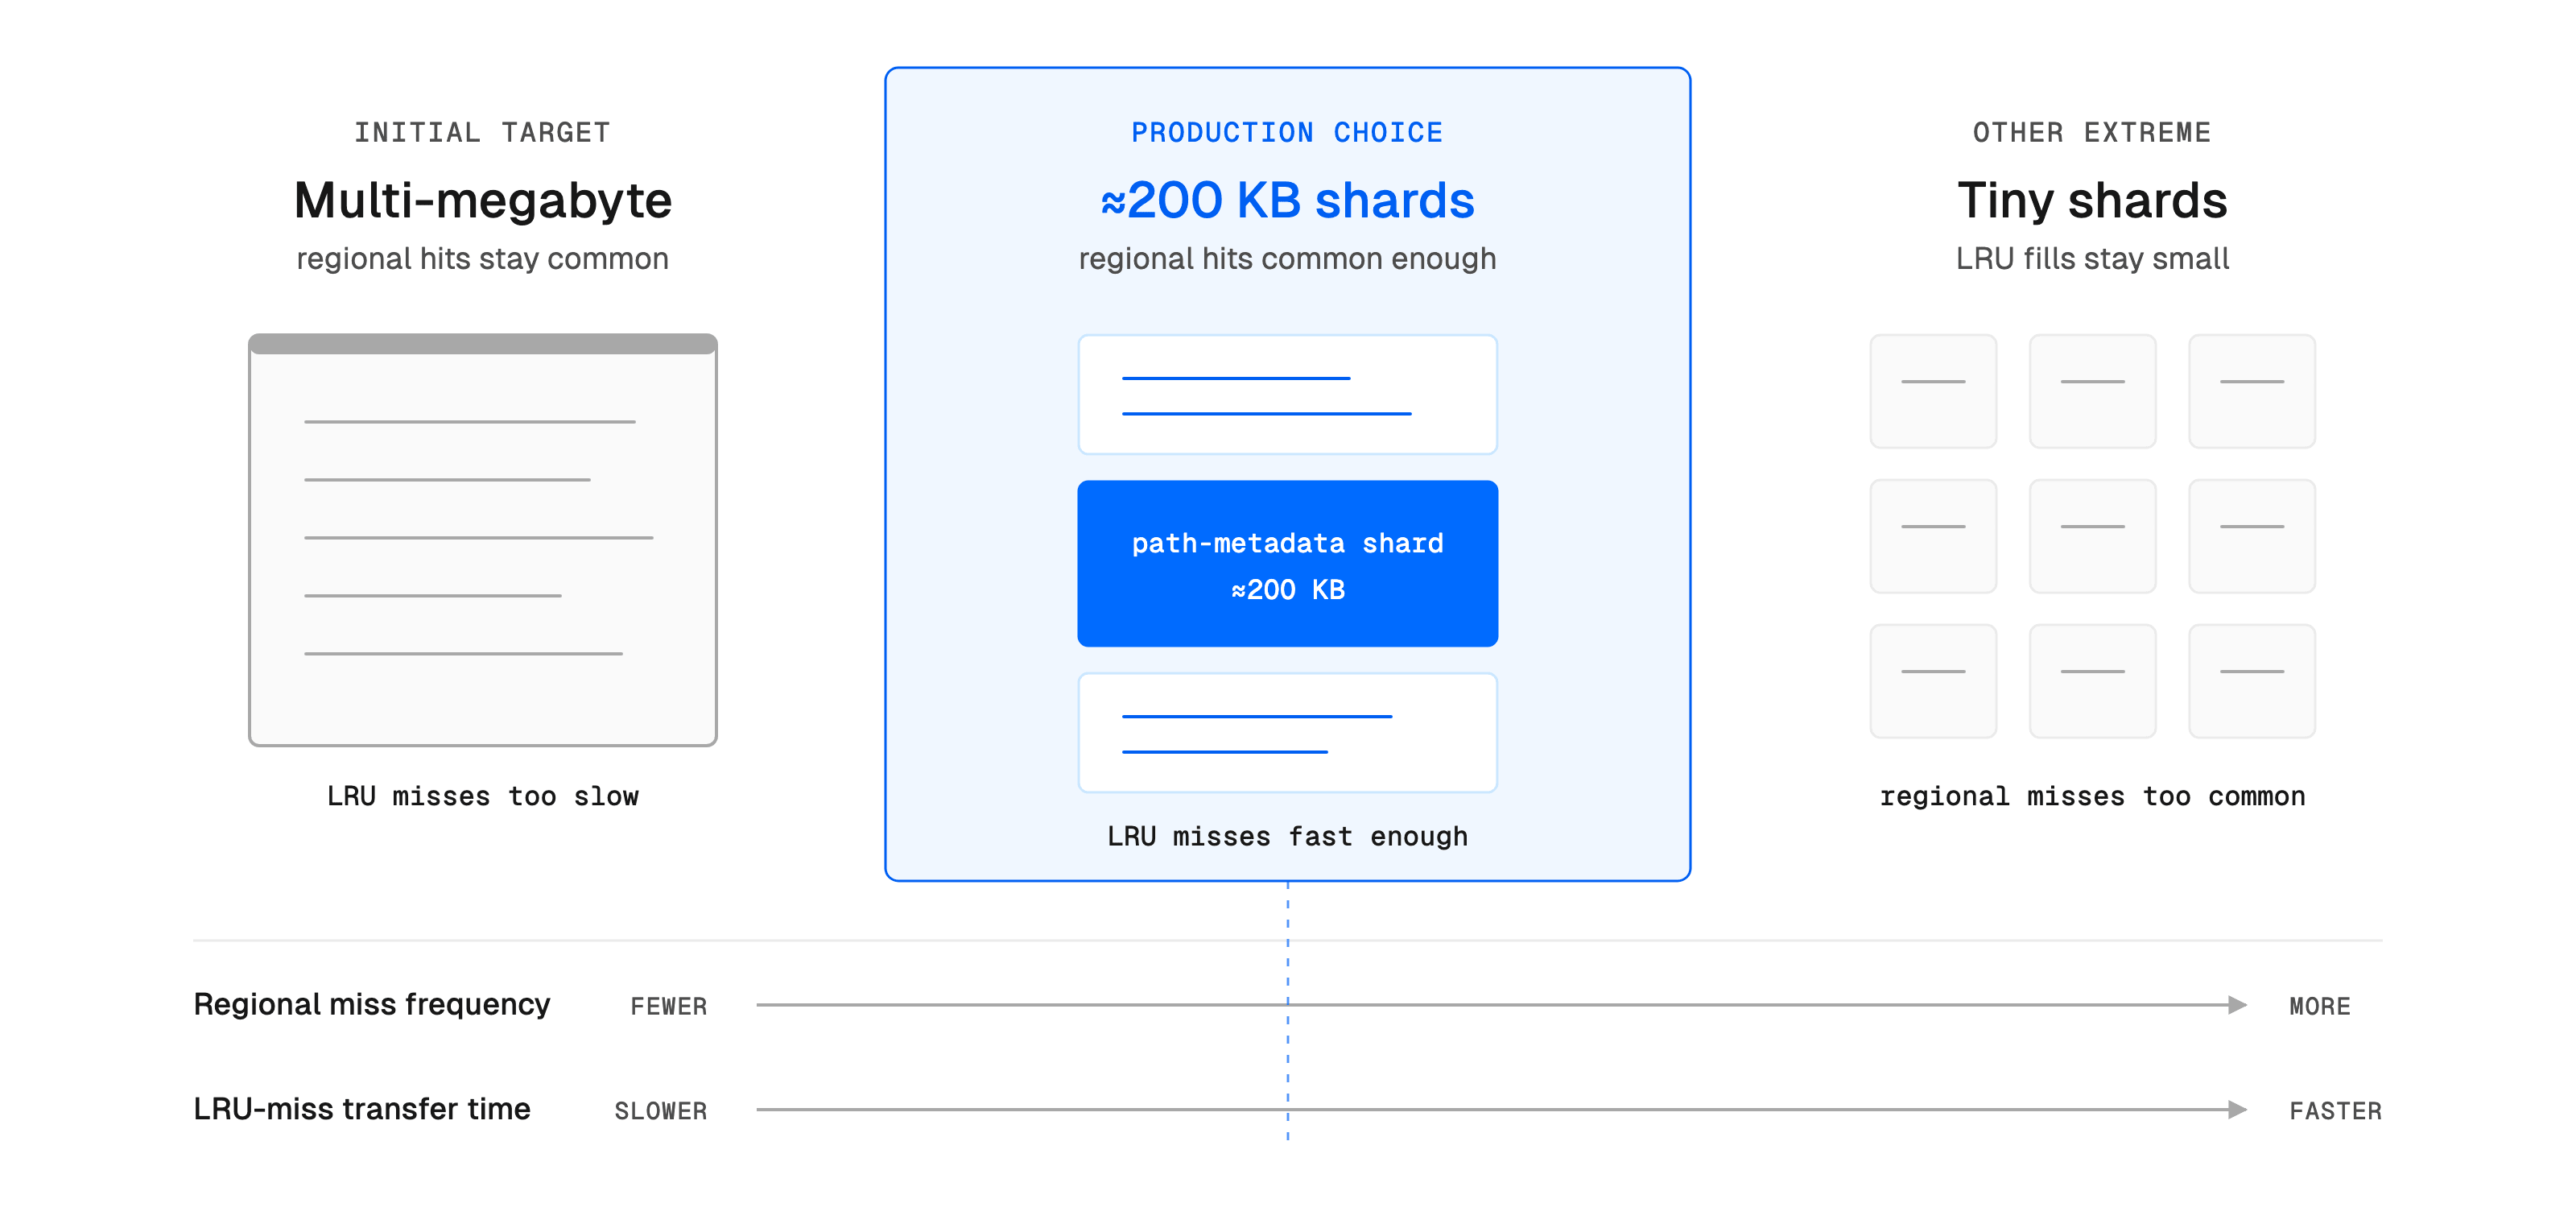
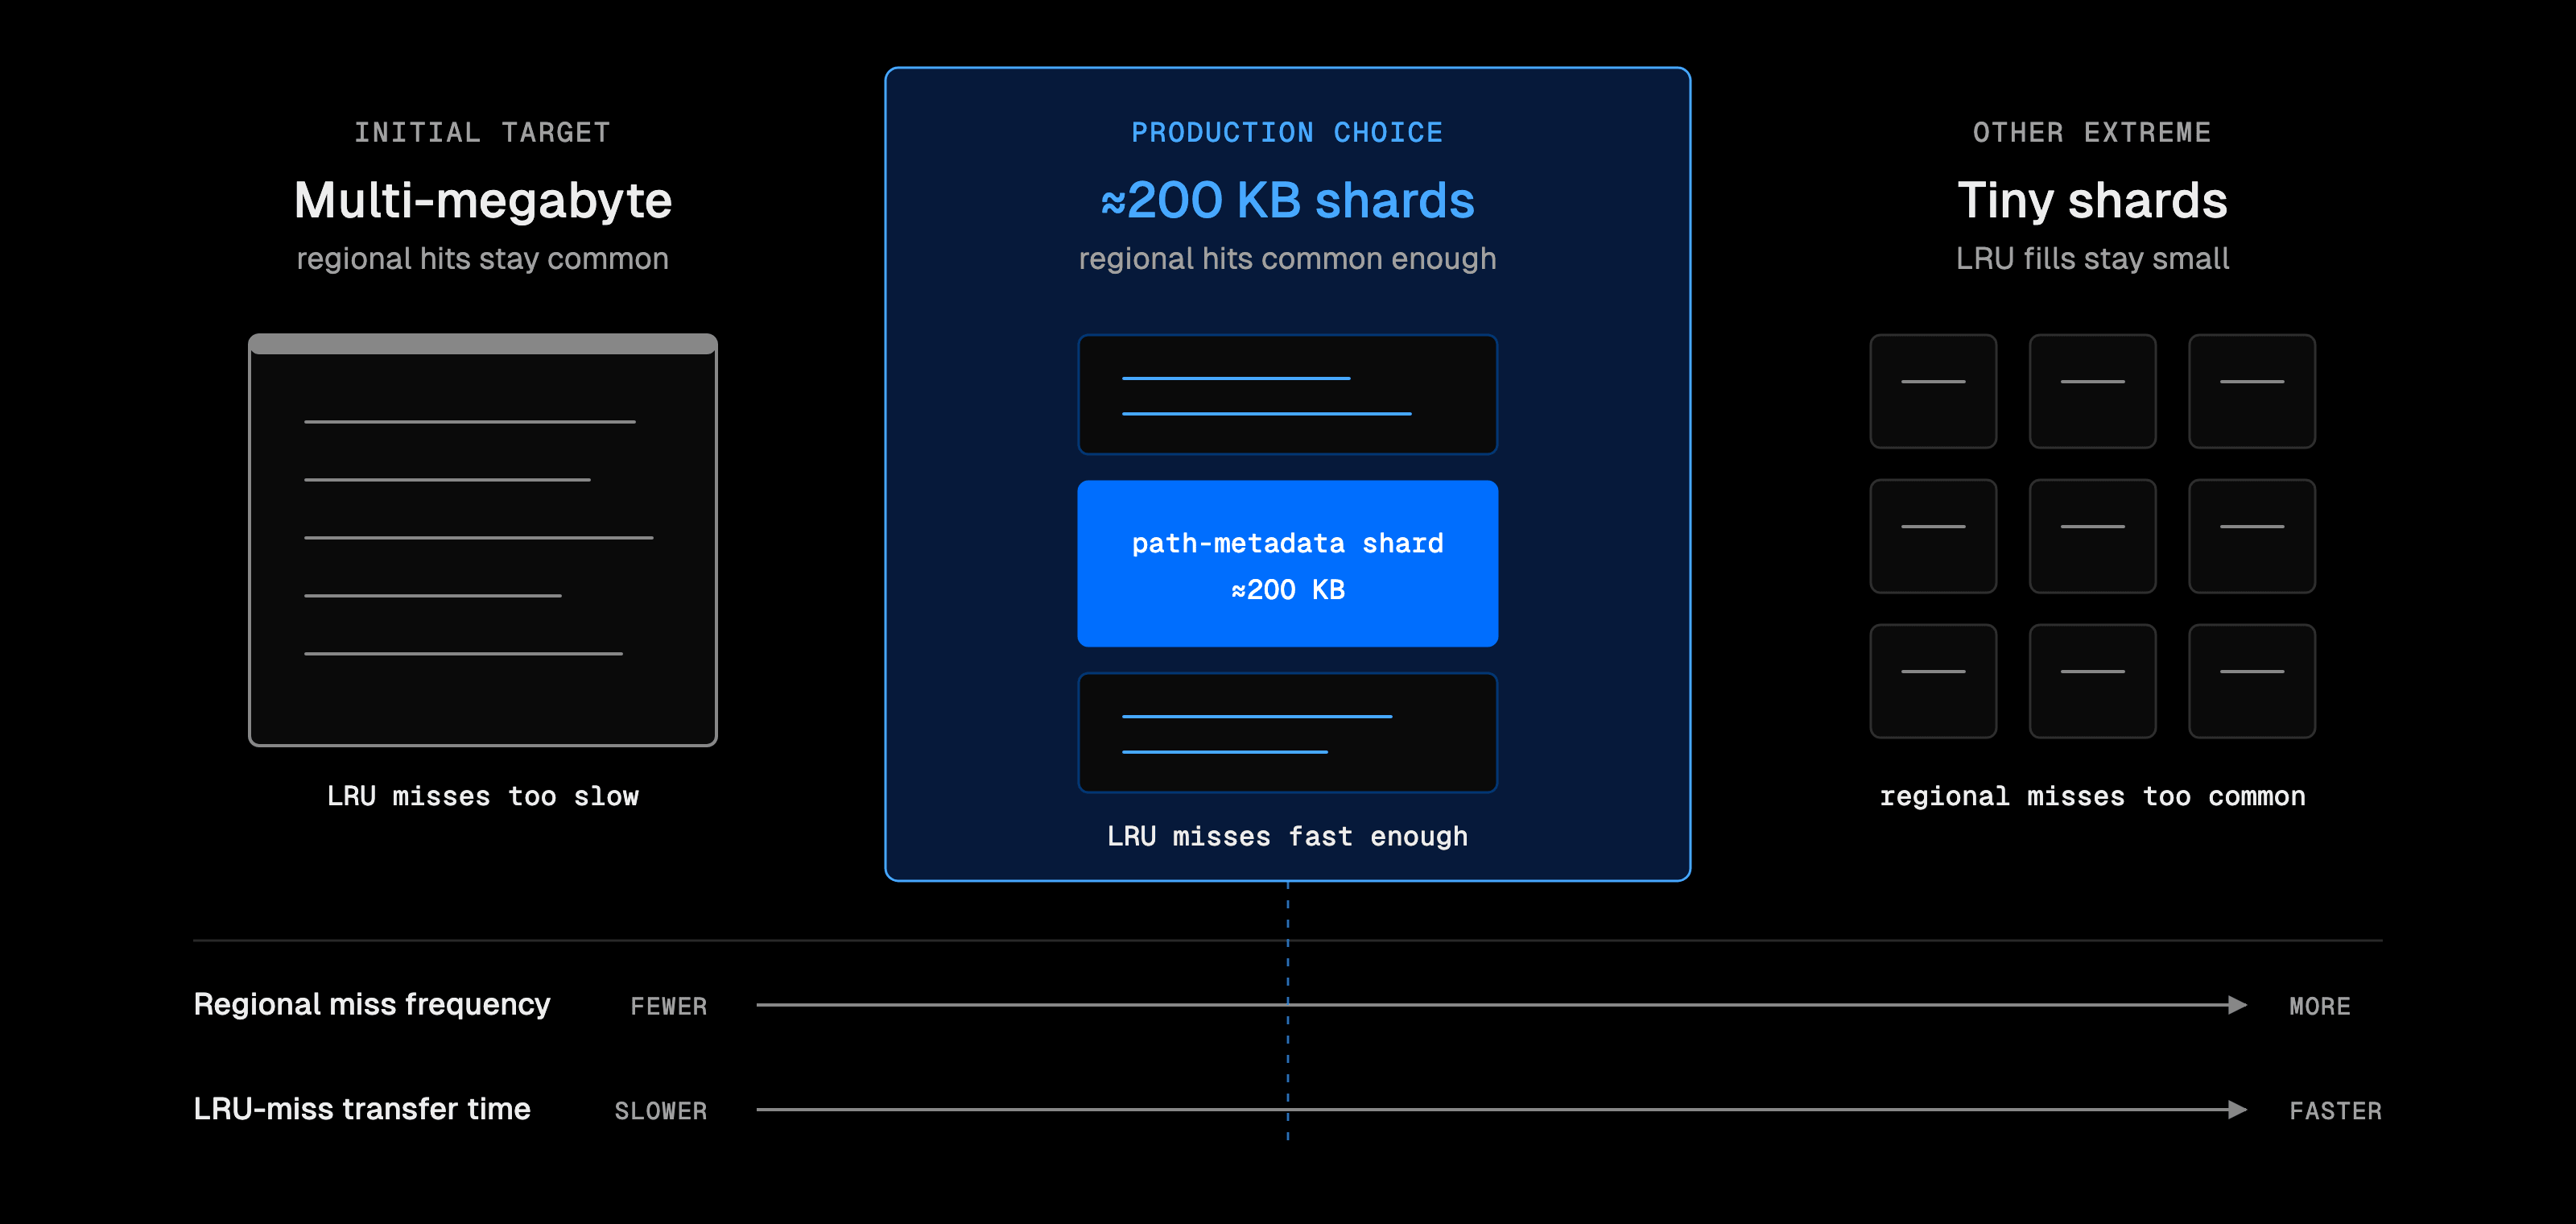
我们最终确定分片大小约为 200 KB,这既保证了较高的区域缓存命中率,又使 LRU 未命中的回填成本较低。
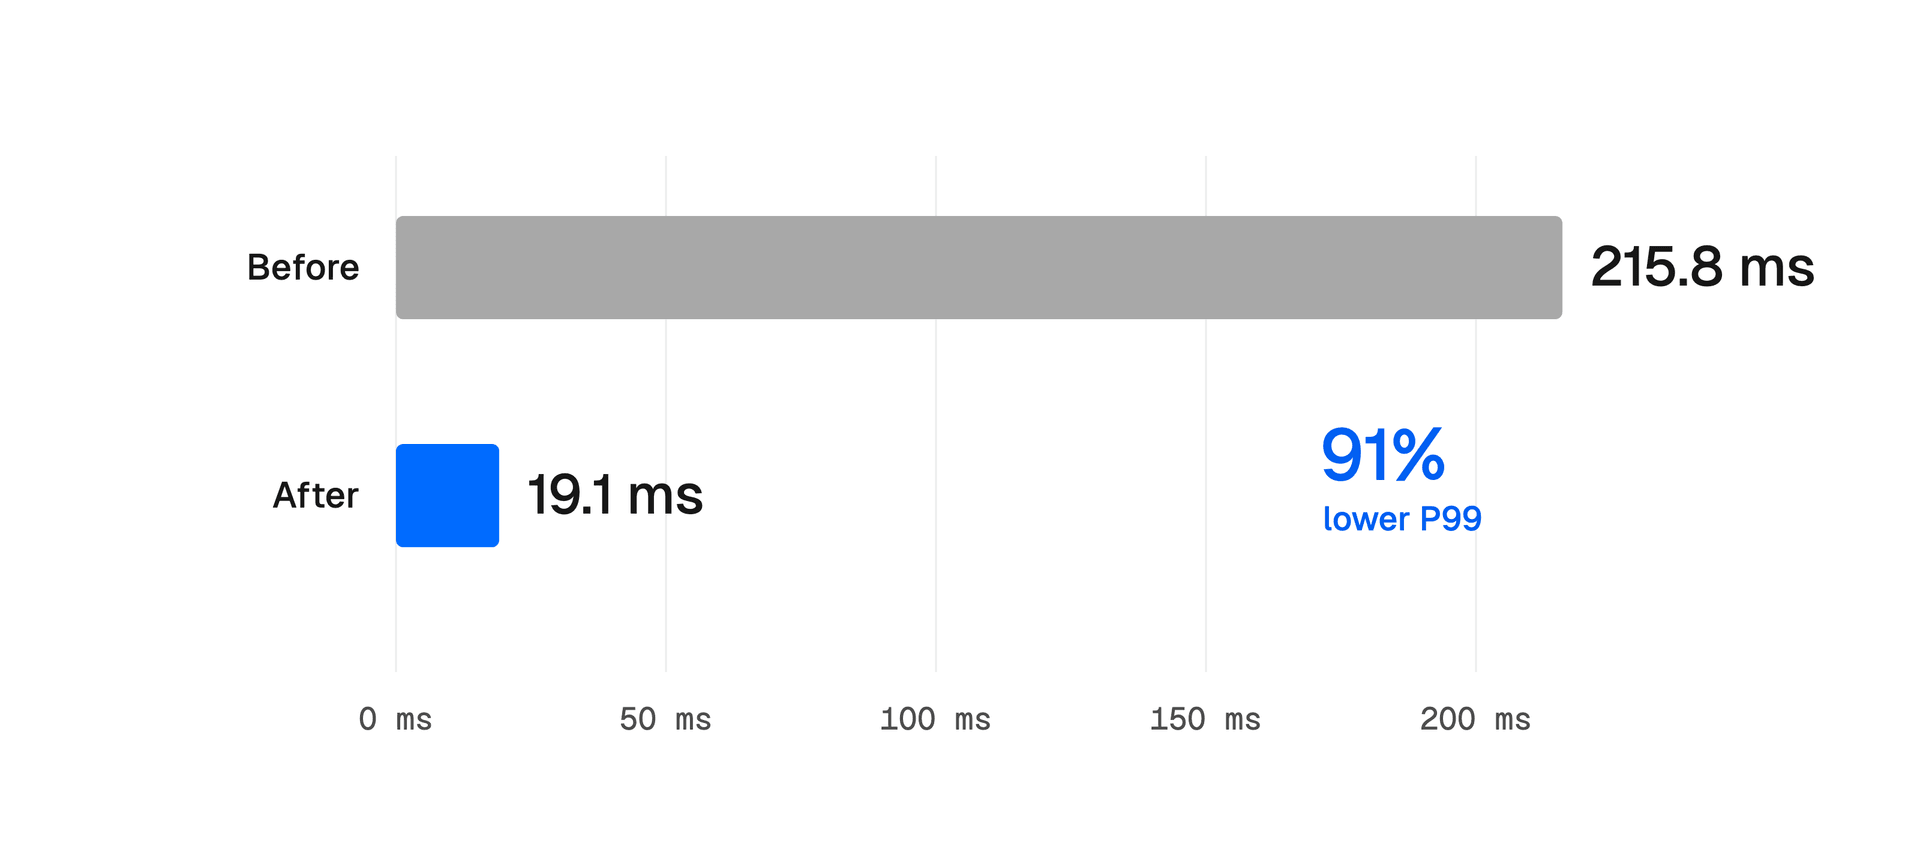
生产环境测量显示,平均延迟和 P99 延迟均有所降低:
元数据查找指标 | 优化前:逐路径元数据 | 优化后:索引分片 | 改进幅度 |
|---|---|---|---|
P99 延迟 | 215.8 ms | 19.1 ms | 降低 91% |
平均延迟 | 8.59 ms | 1.81 ms | 降低 79% |
标准差 | 44.9 ms | 19.0 ms | 降低 58% |
基于 2026 年 8 月 5 日至 12 日的生产流量测量。
复制标题链接进一步缩小分片并不值得进行部署
减少每个分片中的条目数量虽降低了传输成本,但会增加分片数量。我们还评估了在不增加分片数量的前提下,通过更紧凑地编码相同条目来缩小分片的方法。我们测试了三种方案:
对排序后的路径进行前缀编码,使其仅存储与前一条目不同的部分。
将分片拆分为 JSONL 文档以去重元数据。
使用更紧凑的自定义序列化格式。
离线仿真同时衡量了编码后的体积与查询开销。
每种方案都能生成更小的分片,但仿真结果显示延迟的改善幅度有限。我们认为,对于这次迁移,额外投入在编码、兼容性和发布上的成本并不划算。将来如果有其他业务需要更高的索引或压缩收益,再考虑引入分片方案。
```