
DeepSeek-V4.1-Flash发布:更智能、更快、更高效
🚀 重磅推出 DeepSeek-V4.1-Flash:更智能、更快速、更高效。
🔹 这是全新架构家族中体型最小的模型,原生支持视觉理解。
🔹 在更强能力、更快推理、更高吞吐量的基础上,可扩展至更大的模型。
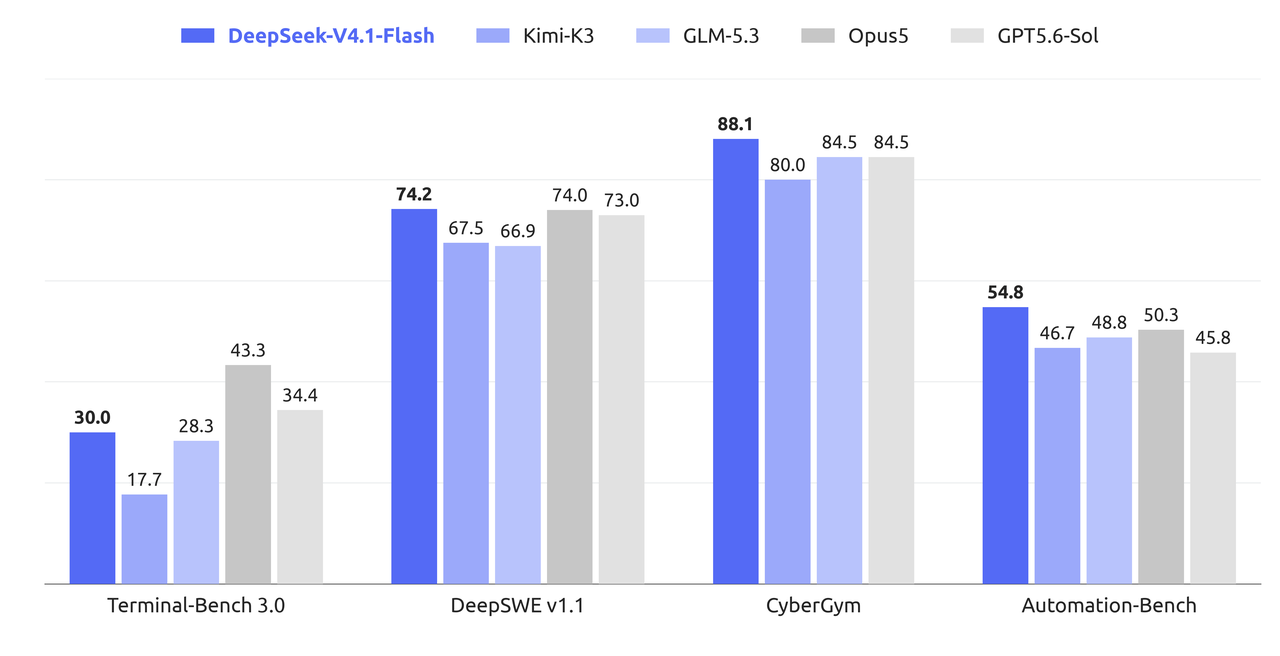
🧠 非对称架构:更强智能,更低成本。
🔹 552B 参数的 MoE。
🔹 全新 Causal Encoder–Decoder 架构:输入仅需激活 8B 参数,输出仅需 16B。
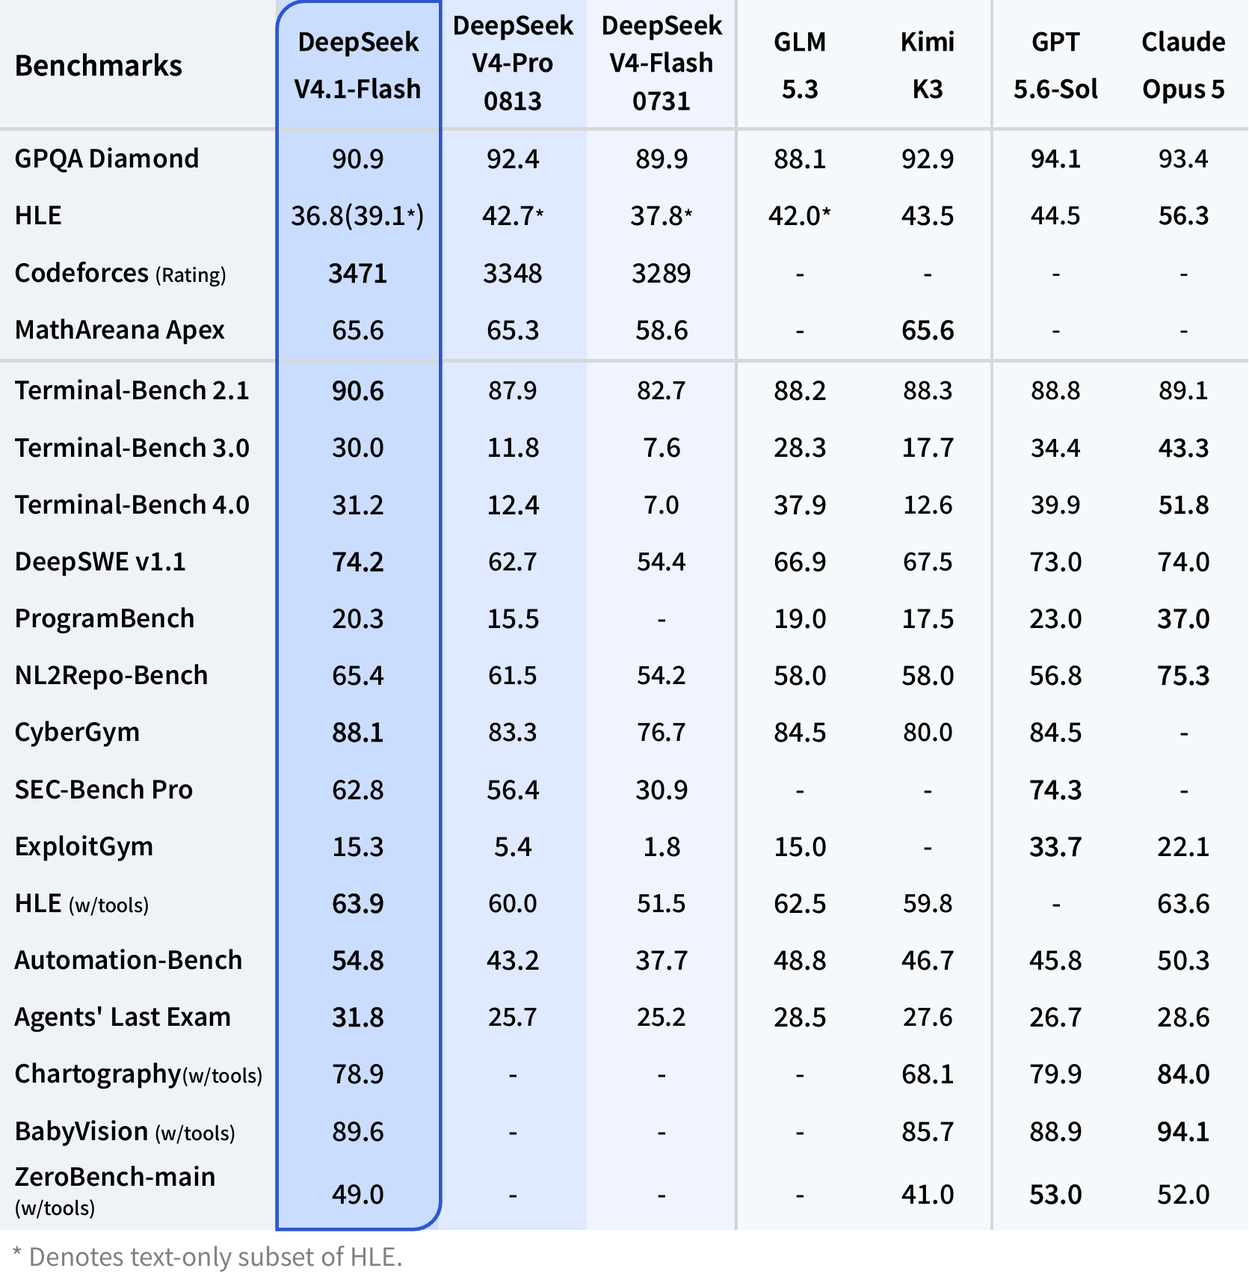
🔹 新的预训练方法 + 更大规模的 RL 后训练,让基准成绩超越包括 DeepSeek-V4-Pro 在内的旗舰模型。
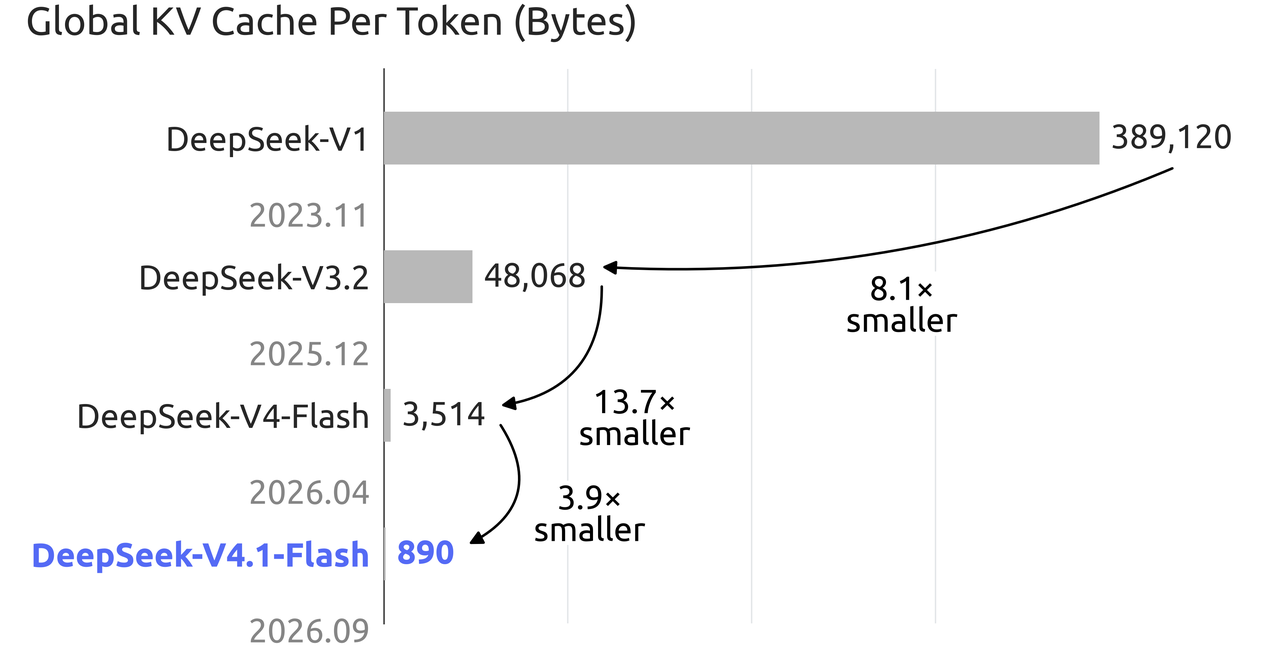
💾 更小的 KV cache,更大的节省。
与上一代相比,V4.1-Flash 的 KV cache 只需要:
🔹 1/4 的 HBM
🔹 1/8 的 SSD 存储空间
缓存命中费用在 Agent 成本中往往占比很高,压缩缓存能显著降低这部分开销。
⚡ V4.1-Flash 现已上线 DeepSeek API,原生支持多模态。
将模型设置为 deepseek-flash 即可使用。
🔹 V4-Flash 与 V4-Flash-Vision-Exp 已退役。为保证兼容性,deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 将临时路由到 V4.1-Flash。
🔹 多方测试显示,V4.1-Flash 在性能、成本、速度和总运行时长上全面领先 V4-Pro,我们正逐步下线 V4-Pro。
🔹 自 2026 年 9 月 14 日 04:00 UTC 起,所有 deepseek-v4-pro 请求将路由至 V4.1-Flash,并按 V4.1-Flash 费率计费,直至 V4.1-Pro 上线。
🤝 官方合作伙伴 WorkBuddy(含 CodeBuddy)与 OpenCode 现已全面支持 V4.1-Flash,欢迎体验!
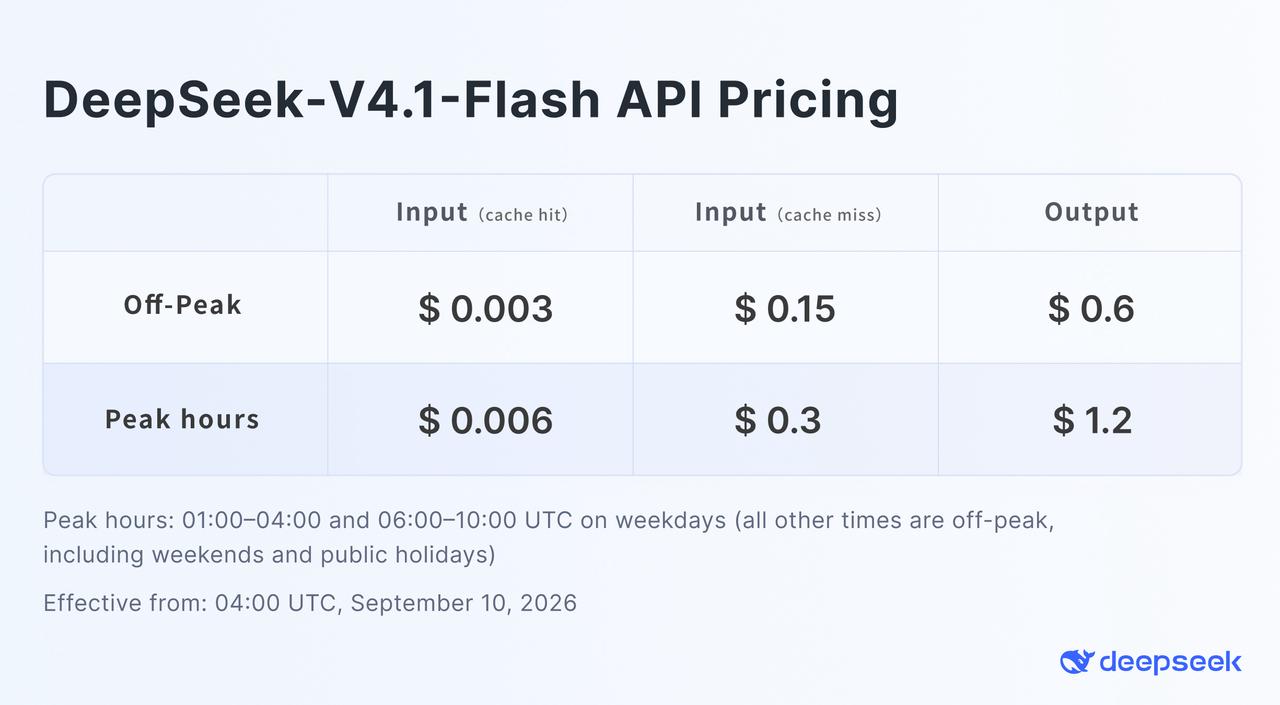
💰 更高效的架构,更低的 API 价格。
V4.1-Flash 让我们能以更低成本服务更多用户,我们也将这部分节省回馈给你。
🔹 继续采用峰谷定价来平衡需求。
🔹 非高峰时段费率是高峰时段费率的一半。建议将弹性工作负载安排在非高峰时段执行,以降低成本。
🔹 新定价将于 2026 年 9 月 10 日 04:00 UTC 生效。
🌐 支持开源,扩展部署选项
我们将与开源社区紧密合作,完善 V4.1-Flash 的推理支持,并探索更多部署方式。
如果您正规划基于 2,000 块 GPU 及存储集群的大规模部署方案,欢迎与我们洽谈。
🔹 模型:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
🔹 论文:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf