
TensorRT Edge-LLM 在 Jetson AGX Thor 上跑 MLPerf Edge Agentic 基准测试快 6.4 倍
AI 智能体正从云端数据中心走向汽车、机器人等边缘设备。与仅能回应单次提示的聊天机器人不同,智能体需通过一系列步骤完成任务:选择工具、评估结果,并在不断变长的对话中持续进行推理。
这一工作流对边缘推理提出了新要求。模型必须快速生成 Token,高效处理冗长的共享历史,并在有限的功耗和内存约束下生成有效的工具调用。
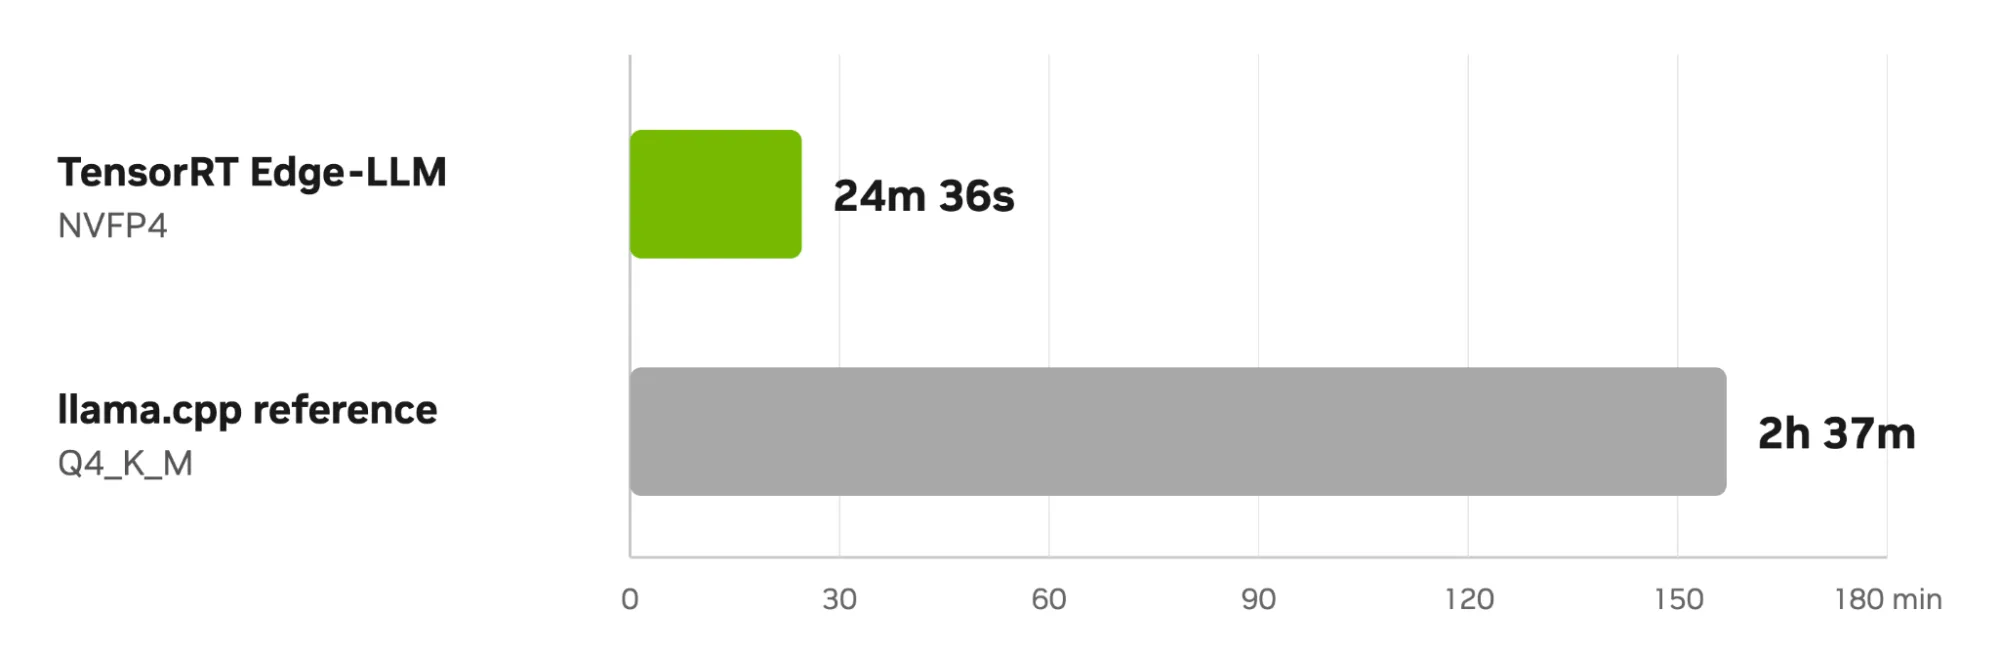
在 MLPerf Inference v6.1 Edge Agentic 基准测试中,NVIDIA TensorRT Edge-LLM 在单块 NVIDIA Jetson AGX Thor 开发套件上运行了 Qwen3.6-27B 模型。系统实现了 52.33 tokens/s 的生成速度,并以 24 分 36 秒完成包含 1,007 轮次的高负荷任务,比 llama.cpp 参考提交所需的 2 小时 37 分钟快了 6.4 倍。该结果采用了 NVFP4 量化、基于树的 Multi-Token Prediction(MTP)以及 KV Cache 复用技术。
MLPerf 如何衡量端到端智能体 AI 性能
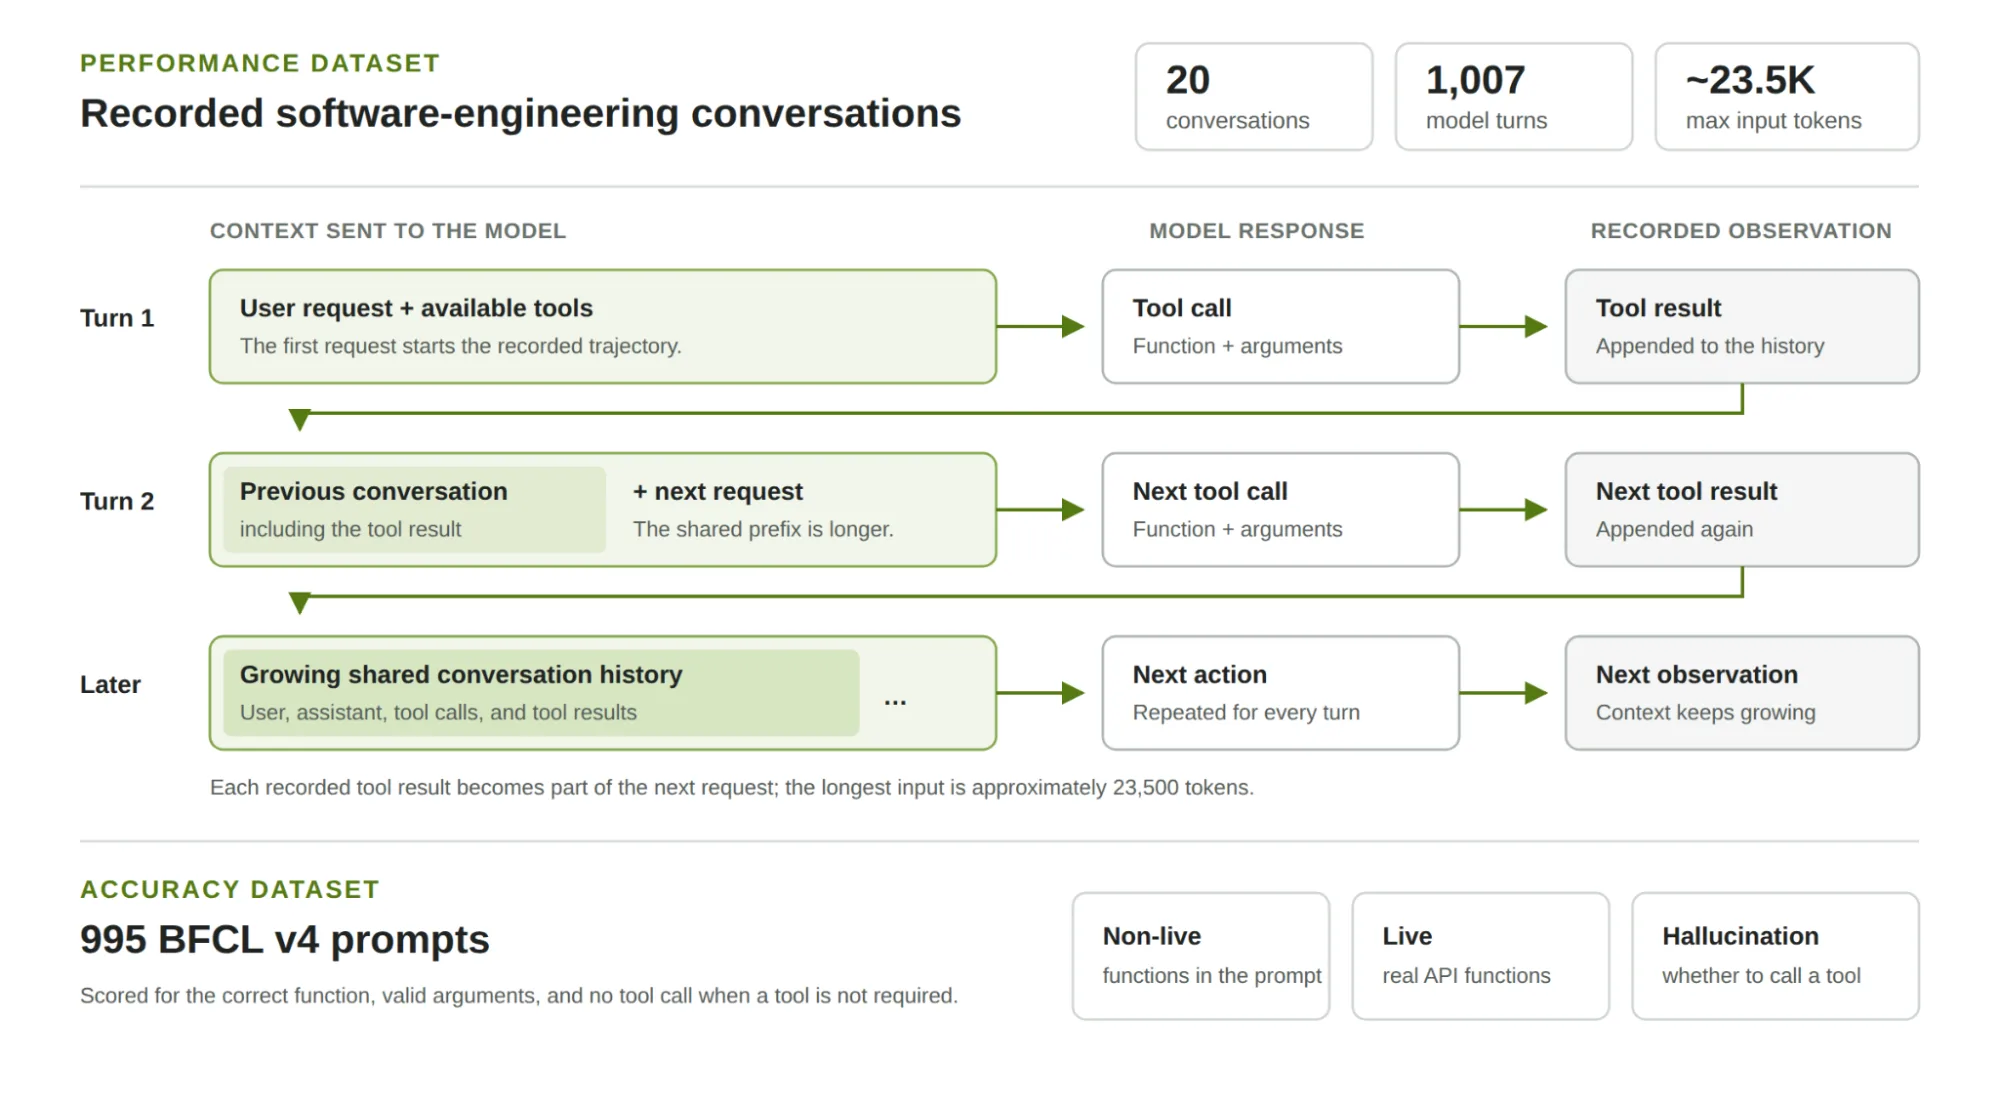
MLPerf Edge Agentic 通过两个阶段衡量兼容 OpenAI 接口的模型端点:性能阶段和精度阶段。
性能阶段重放录制的软件工程智能体轨迹。模型接收用户请求,生成工具调用,观察工具结果,并延续同一对话。工作负载包含 20 段对话和 1,007 个生成轮次。随着轮次增加,输入长度不断增长,最终达到约 23.5K tokens,这使得长上下文处理成为测量的重要组成部分。同时,基于 Intersection over Union(IoU)的 inline accuracy 也被纳入测量,以确保性能阶段正确运行了智能体。
精度阶段使用 Berkeley Function Calling Leaderboard(BFCL)v4 提示,仅采用单轮模式且关闭推理功能,以在边缘设备上平衡精度与评估耗时。它评估模型是否能选择正确的函数、生成有效参数,并在无需工具时避免调用工具。
MLPerf Edge Agentic 基准测试在 Jetson AGX Thor 上的结果
TensorRT Edge-LLM 的提交方案采用 Qwen3.6-27B 模型,在配备 128 GB 统一内存的单台 Jetson AGX Thor 开发者套件上运行,处于 SingleStream 模式,电源模式设置为 MAXN。
| 指标 | 结果 |
|---|---|
| 输出吞吐量 | 每秒 52.33 个 token |
| 首个 token 延迟中位数 | 247.12 毫秒 |
| 每个输出 token 延迟中位数 | 14.68 毫秒 |
| BFCL 总体准确率 | 87.94% |
表 1。MLPerf v6.1 NVIDIA Edge Agentic 提交结果摘要
MLCommons Edge Agentic 示例也发布了在 Jetson AGX Thor 上运行的 llama.cpp 参考基准测试,该测试使用 Q4_K_M 量化的 Qwen3.6-27B 模型,完成时间为 2 小时 37 分钟。相比之下,TensorRT Edge-LLM 方案仅需 24 分钟 36 秒即可完成该工作负载,耗时缩短至原来的 1/6.4(即快 6.4 倍)。
利用 NVFP4 量化加速 Qwen3.6-27B 推理
众所周知,边缘平台上的小批量 LLM 解码主要受 DRAM 带宽限制。缩小权重和激活值的尺寸可以降低内核的内存占用,从而提升解码性能。
提交的 Qwen3.6-27B 模型对权重和激活(包括语言模型头)使用 NVFP4,KV cache 使用 FP8。NVFP4 是一种 4 位浮点格式,由 Jetson AGX Thor 上的 NVIDIA Blackwell GPU 支持。TensorRT Edge-LLM 通过优化的 kernel 加速量化模型,同时保持 MLPerf 要求的精度。
更小的模型表示也为 128 GB 统一内存腾出了更多空间,可用于长上下文、投机解码状态和应用负载。开发者可以直接从已发布并校准好的 Qwen3.6-27B NVFP4 checkpoint 起步。部署团队既可以使用现成的量化 checkpoint,也可以先在任意开发系统上完成一次后训练量化,再部署模型。
跨 agent 轮次复用 KV cache
agent 轨迹中的每个新请求都包含之前的大部分对话内容,外加一条新的模型响应或工具结果。如果不做复用,模型每一轮都必须重新 prefill 共享的历史,开销随对话增长而不断增加。
TensorRT Edge-LLM 会识别可复用的 prompt 前缀,并恢复其缓存的 attention KV 页面。由于 Qwen3.6 采用混合模型架构,运行时还会恢复继续正确执行所需的循环状态和部分 KV 页面状态,然后只对对话中新增的后缀做 prefill。
KV cache 和循环状态的复用减少了整个 agent 轨迹中重复的长上下文计算。这一优化与基于树的 MTP 相辅相成:cache 复用降低了生成开始前的开销,而 MTP 减少了生成过程中目标模型的执行步数。
在这项工作负载上,约 96% 的 prompt token 通过热 cache 提供服务。整个过程中,运行时只需要对 1360 万 prompt token 中的约 50 万做 prefill。
利用基于树的 multi-token prediction 加速 LLM 推理
标准的自回归解码每次模型调用只生成一个 token。Multi-token prediction 使用 draft model 预测若干个未来 token,再由目标模型一并验证。近期的模型通常都会训练并随主模型一起发布官方的 MTP 权重。
除了传统的线性 MTP,TensorRT Edge-LLM 还实现了基于树的 MTP。运行时不再仅保留一个预测续文,而是将高概率候选组织成树状结构。目标模型在一次前向传播中验证这些候选,运行时则采纳匹配路径。若多个候选被接受,系统可一次性推进多个 token 的生成。
启动服务器时,可调整草稿参数。MLPerf 服务器配置使用 8 个草稿步骤,每个草稿深度取 top-2 候选,并采用 16 节点的验证树。基于树的验证对函数调用非常有用,因为工具名称、JSON 语法和常见参数结构往往具有可预测性,而多分支结构可保留单个参数值的可能替代项。相比 3 步草稿的线性 MTP,树状 MTP 在此工作负载中可额外获得约 40% 的解码性能提升。
如何运行 MLPerf Edge Agentic 基准测试
本次提交使用的实现位于 TensorRT Edge-LLM 的 release/0.9.1-mlpinf 分支。该分支包含模型导出设置、TensorRT 引擎构建命令、服务器配置以及 MLPerf 客户端配置
1. 克隆 TensorRT Edge-LLM 并初始化其子模块。
git clone --branch release/0.9.1-mlpinf \
  https://github.com/NVIDIA/TensorRT-Edge-LLM.git
cd TensorRT-Edge-LLM
git submodule update --init --recursive
2. 下载经过校准的 NVFP4 检查点。
huggingface-cli download \
  centml/Qwen3.6-27B-NVFP4-W4A4-mlpinf \
--local-dir "$WORK/Qwen3.6-27B-NVFP4-W4A4-mlpinf"
3. 遵循 mlperf/README.md 构建 TensorRT Edge-LLM,使用树状 MTP 接口导出检查点,并构建基础与草稿 TensorRT 引擎。
$VENV/bin/python -m tensorrt_edgellm.scripts.export \
  "$WORK/Qwen3.6-27B-NVFP4-W4A4-mlpinf" \
  "$WORK/onnx" \
--mtp-tree-base --skip-visual
4. 启动兼容 OpenAI 的 TensorRT Edge-LLM 服务器。
export REPO="$PWD"
export VENV=/path/to/venv-edgellm-export
export WORK=/path/to/mlperf-artifacts
bash mlperf/serve_edgellm.sh
5. 克隆 MLCommons 端点测试框架,安装其 BFCL 依赖,更新 mlperf/config.yaml 中的模型和分词器路径,然后运行基准测试。
git clone https://github.com/mlcommons/endpoints.git
cd endpoints
python3.12 -m venv .venv
source .venv/bin/activate
pip install -e ".[dev,bfcl]"

inference-endpoint benchmark from-config \
--config "$REPO/mlperf/config.yaml"
提供的配置以 temperature 0、seed 42 运行性能和准确性阶段,并禁用推理(reasoning),并发度设为 1。使用 --accuracy-only 选项可仅运行 BFCL 准确性阶段。有关数据集和客户端配置的更多信息,请参阅 MLCommons Edge Agentic 示例。
要查看所有提交的完整 MLPerf Inference v6.1 结果,请参见 MLCommons 的 公告。有关服务器级 Vera Rubin 性能,请参见 NVIDIA Vera Rubin NVL72 在 MLPerf Inference v6.1 首秀中提供领先性能。
致谢
本工作由 NVIDIA 的 TensorRT Edge-LLM、ModelOpt、Jetson 和 MLPerf 团队共同贡献,特别感谢 Zihao Kong、Xiang Guo、Yoco Xiao、Qikai Li 和 Ashwin Nanjappa。感谢 MLCommons 社区开发 Edge Agentic 基准测试和端点框架。