
Hacker News 5小时前 · 2026-09-17 04:09:23 · 4 阅读
向量化且可移植的高性能 Quicksort 算法
今天我们开源了一套代码,其排序速度约为 C++ std::sort 的十倍,性能优于现有的专用架构最优算法,同时具备跨所有现代 CPU 架构的可移植性。下文将详细阐述我们是如何实现这一目标的。
首先补充一些背景知识。当前业界存在一种向列式数据库发展的趋势:它们将同一列的所有值连续存储,而非像传统方式那样先存储一条记录的所有字段(即“行”)再存储下一条记录。这种布局在过滤和排序操作上效率更高,而这两者正是 SQL 查询的核心组件;因此,我们专注于这种数据布局。
鉴于排序算法已被研究得相当透彻,我们如何还能发现十倍的性能提升?答案在于 SIMD/向量指令。这些指令能够在单条指令中对多个独立元素并行执行操作。例如,在使用 AVX-512 指令集时可一次性处理 16 个 float32 值,而在 Arm NEON 架构上则一次处理四个值: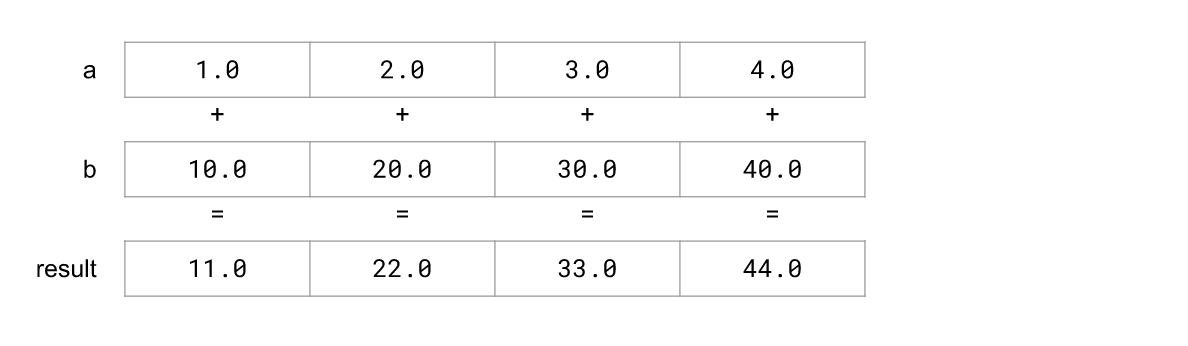
如果你对 SIMD 已经有所了解,可能听说过它被用于超级计算机、机器学习中的线性代数运算、视频处理或 JPEG XL 等图像编解码器。但如果 SIMD 操作仅涉及独立元素,而排序又需要重新排列相邻数组元素,这两者之间该如何调和?
假设我们有一种专门用于排序的机制,例如针对 256 个元素数组。那么,用于排序更大数组的 Quicksort 算法主要包括两个步骤:首先将数组划分为两个子数组——一部分小于“基准”值(理想情况下是中位数),其余部分更大;然后递归处理,直到子数组大小不超过 256 个元素,再使用这种专用机制完成排序。由于划分阶段占据了大部分 CPU 时间,如果我们能用 SIMD 加速它,就能获得高效的排序算法。
幸运的是,现代指令集(Arm SVE、RISC-V V、x86 AVX-512)包含一条适合划分的特殊指令。给定一组关于每个元素是否小于基准的布尔输入(是/否),这条“压缩存储”指令仅将对应输入为“是”的元素连续写入内存。我们可以对布尔值取反,再次应用该指令,从而将元素写入另一个分区。这种策略已被用于一款 基于 AVX-512 的 Quicksort 中。但对于没有压缩存储指令的指令集(如 AVX2)该怎么办呢?先前的研究 已经展示了如何用置换指令来模拟该功能。
我们在这些技术的基础上进一步改进,实现了首个可移植至三大架构、共六类指令集的向量化 Quicksort,其性能甚至优于此前的架构专用排序算法。我们的实现采用了 Highway 的可移植 SIMD 函数,因此无需为每个平台重新实现约 3,000 行 C++ 代码。Highway 会在可用时使用压缩存储指令,否则使用等效的置换指令。与之前的 先进技术(仅支持 32 位整数)不同,我们支持 16 到 128 位的全范围输入。
尽管我们只有一份可移植的实现,却在 AVX2、AVX-512(Intel Skylake)和 Arm NEON(Apple M1)上都达到了创纪录的速度。在 Apple M1 上排序一百万个 32/64/128 位数字,吞吐率可达 499/471/466 MB/s。在 3 GHz 的 Skylake(AVX-512)上,速度为 1123/1119/1120 MB/s。有趣的是,AVX-512 比 AVX2 快 1.4-1.6 倍——无需额外投入就能获得这样的提速,相当划算(Highway 会自动检测 CPU 支持哪些指令,并选用最优方案)。在 AVX2 上我们实测 798 MB/s,而此前针对 AVX2 优化的最优方案只有 699 MB/s。相比之下,标准库在同一 CPU 上只有 58/128/117 MB/s,也就是说按数字类型不同,我们实现了 9-19 倍的加速。
过去,排序一直被认为是一项昂贵的操作。单核 CPU 就能以 1 GB/s 的速度排序,会解锁哪些新的应用场景和能力,我们对此很感兴趣。采用 Apache2 许可的源代码已在 Github 上发布(如有疑问或建议,欢迎提 issue),我们的论文对实现方案(包括针对 256 个元素的特殊情况处理)做了详细的说明和评估。
作者:Jan Wassenberg – Brain 计算机架构研究团队
首先补充一些背景知识。当前业界存在一种向列式数据库发展的趋势:它们将同一列的所有值连续存储,而非像传统方式那样先存储一条记录的所有字段(即“行”)再存储下一条记录。这种布局在过滤和排序操作上效率更高,而这两者正是 SQL 查询的核心组件;因此,我们专注于这种数据布局。
鉴于排序算法已被研究得相当透彻,我们如何还能发现十倍的性能提升?答案在于 SIMD/向量指令。这些指令能够在单条指令中对多个独立元素并行执行操作。例如,在使用 AVX-512 指令集时可一次性处理 16 个 float32 值,而在 Arm NEON 架构上则一次处理四个值:


如果你对 SIMD 已经有所了解,可能听说过它被用于超级计算机、机器学习中的线性代数运算、视频处理或 JPEG XL 等图像编解码器。但如果 SIMD 操作仅涉及独立元素,而排序又需要重新排列相邻数组元素,这两者之间该如何调和?
假设我们有一种专门用于排序的机制,例如针对 256 个元素数组。那么,用于排序更大数组的 Quicksort 算法主要包括两个步骤:首先将数组划分为两个子数组——一部分小于“基准”值(理想情况下是中位数),其余部分更大;然后递归处理,直到子数组大小不超过 256 个元素,再使用这种专用机制完成排序。由于划分阶段占据了大部分 CPU 时间,如果我们能用 SIMD 加速它,就能获得高效的排序算法。
幸运的是,现代指令集(Arm SVE、RISC-V V、x86 AVX-512)包含一条适合划分的特殊指令。给定一组关于每个元素是否小于基准的布尔输入(是/否),这条“压缩存储”指令仅将对应输入为“是”的元素连续写入内存。我们可以对布尔值取反,再次应用该指令,从而将元素写入另一个分区。这种策略已被用于一款 基于 AVX-512 的 Quicksort 中。但对于没有压缩存储指令的指令集(如 AVX2)该怎么办呢?先前的研究 已经展示了如何用置换指令来模拟该功能。
我们在这些技术的基础上进一步改进,实现了首个可移植至三大架构、共六类指令集的向量化 Quicksort,其性能甚至优于此前的架构专用排序算法。我们的实现采用了 Highway 的可移植 SIMD 函数,因此无需为每个平台重新实现约 3,000 行 C++ 代码。Highway 会在可用时使用压缩存储指令,否则使用等效的置换指令。与之前的 先进技术(仅支持 32 位整数)不同,我们支持 16 到 128 位的全范围输入。
尽管我们只有一份可移植的实现,却在 AVX2、AVX-512(Intel Skylake)和 Arm NEON(Apple M1)上都达到了创纪录的速度。在 Apple M1 上排序一百万个 32/64/128 位数字,吞吐率可达 499/471/466 MB/s。在 3 GHz 的 Skylake(AVX-512)上,速度为 1123/1119/1120 MB/s。有趣的是,AVX-512 比 AVX2 快 1.4-1.6 倍——无需额外投入就能获得这样的提速,相当划算(Highway 会自动检测 CPU 支持哪些指令,并选用最优方案)。在 AVX2 上我们实测 798 MB/s,而此前针对 AVX2 优化的最优方案只有 699 MB/s。相比之下,标准库在同一 CPU 上只有 58/128/117 MB/s,也就是说按数字类型不同,我们实现了 9-19 倍的加速。
过去,排序一直被认为是一项昂贵的操作。单核 CPU 就能以 1 GB/s 的速度排序,会解锁哪些新的应用场景和能力,我们对此很感兴趣。采用 Apache2 许可的源代码已在 Github 上发布(如有疑问或建议,欢迎提 issue),我们的论文对实现方案(包括针对 256 个元素的特殊情况处理)做了详细的说明和评估。
作者:Jan Wassenberg – Brain 计算机架构研究团队
原始来源: Hacker News